Presentazione di Scribe v3 e v3 Live, i nostri modelli Speech to Text più accurati
- Scritto da
- Min Kim
- Pubblicato
AscoltaAscolta questo articolo
I prodotti basati sull'audio iniziano con una trascrizione: appunti delle riunioni, agenti vocali, doppiaggio, documentazione clinica e archivi di trasmissioni che raccolgono contenuti di decenni. Ottenere subito una trascrizione corretta è importante, perché ogni errore si ripercuote a valle, dove costa molto di più correggerlo.
Ma l'audio del mondo reale è complesso. Può trattarsi di più persone che parlano una sopra l'altra in una riunione, di un cliente in una strada trafficata che fa una pausa a metà frase o di una chiamata al supporto in cui nessuna delle due persone parla nella propria lingua madre.
Oggi ElevenLabs lancia due nuovi modelli Speech to Text progettati proprio per queste condizioni:
- Scribe v3, per audio registrato, commette il 27% di errori di parole in meno rispetto a Scribe v2 in 102 lingue e offre le etichette dei parlanti più accurate tra tutti i modelli che abbiamo testato,
- Scribe v3 Live è la variante a bassa latenza per l'audio in tempo reale e commette il 43% di errori in meno rispetto a Scribe v2 Realtime. Include inoltre per la prima volta la diarizzazione dei parlanti (identifica chi ha detto cosa) e un rilevamento dei turni di parola migliorato.
Scribe v3 Live è disponibile da oggi in ElevenAgents. Entrambi i modelli sono disponibili anche in ElevenAPI, dove il passaggio da Scribe v2 richiede una modifica di una sola riga all'ID del modello.
Il feedback che ha dato forma a Scribe v3
Scribe ha gestito centinaia di milioni di ore di trascrizione per app di appunti delle riunioni, contact center, strumenti di documentazione clinica e agenti vocali. In tutti i casi d'uso, i team che lo utilizzavano continuavano a chiedere le stesse cinque cose.
I team che lavorano su riunioni e presa di appunti volevano una diarizzazione migliore negli scambi rapidi e con tre o più parlanti. I team che sviluppano agenti vocali hanno segnalato che un timer di silenzio interrompe i chiamanti quando fanno una pausa a metà frase o rallentano per leggere un numero. I team che creano prodotti live rinunciavano all'accuratezza in favore della velocità, perché il tempo reale offriva prestazioni sensibilmente peggiori rispetto al batch. I clienti in India volevano che l'hindi fosse accurato quanto l'inglese, anche quando i chiamanti passano dall'una all'altra a metà frase. E molti volevano un maggiore controllo sull'output, dai numeri scritti come “123” a elenchi di termini chiave sufficientemente lunghi per un catalogo prodotti o un elenco di nomi di farmaci.
Etichette dei parlanti, rilevamento dei turni e maggiore controllo sull'output
Diarizzazione affidabile anche in una stanza affollata
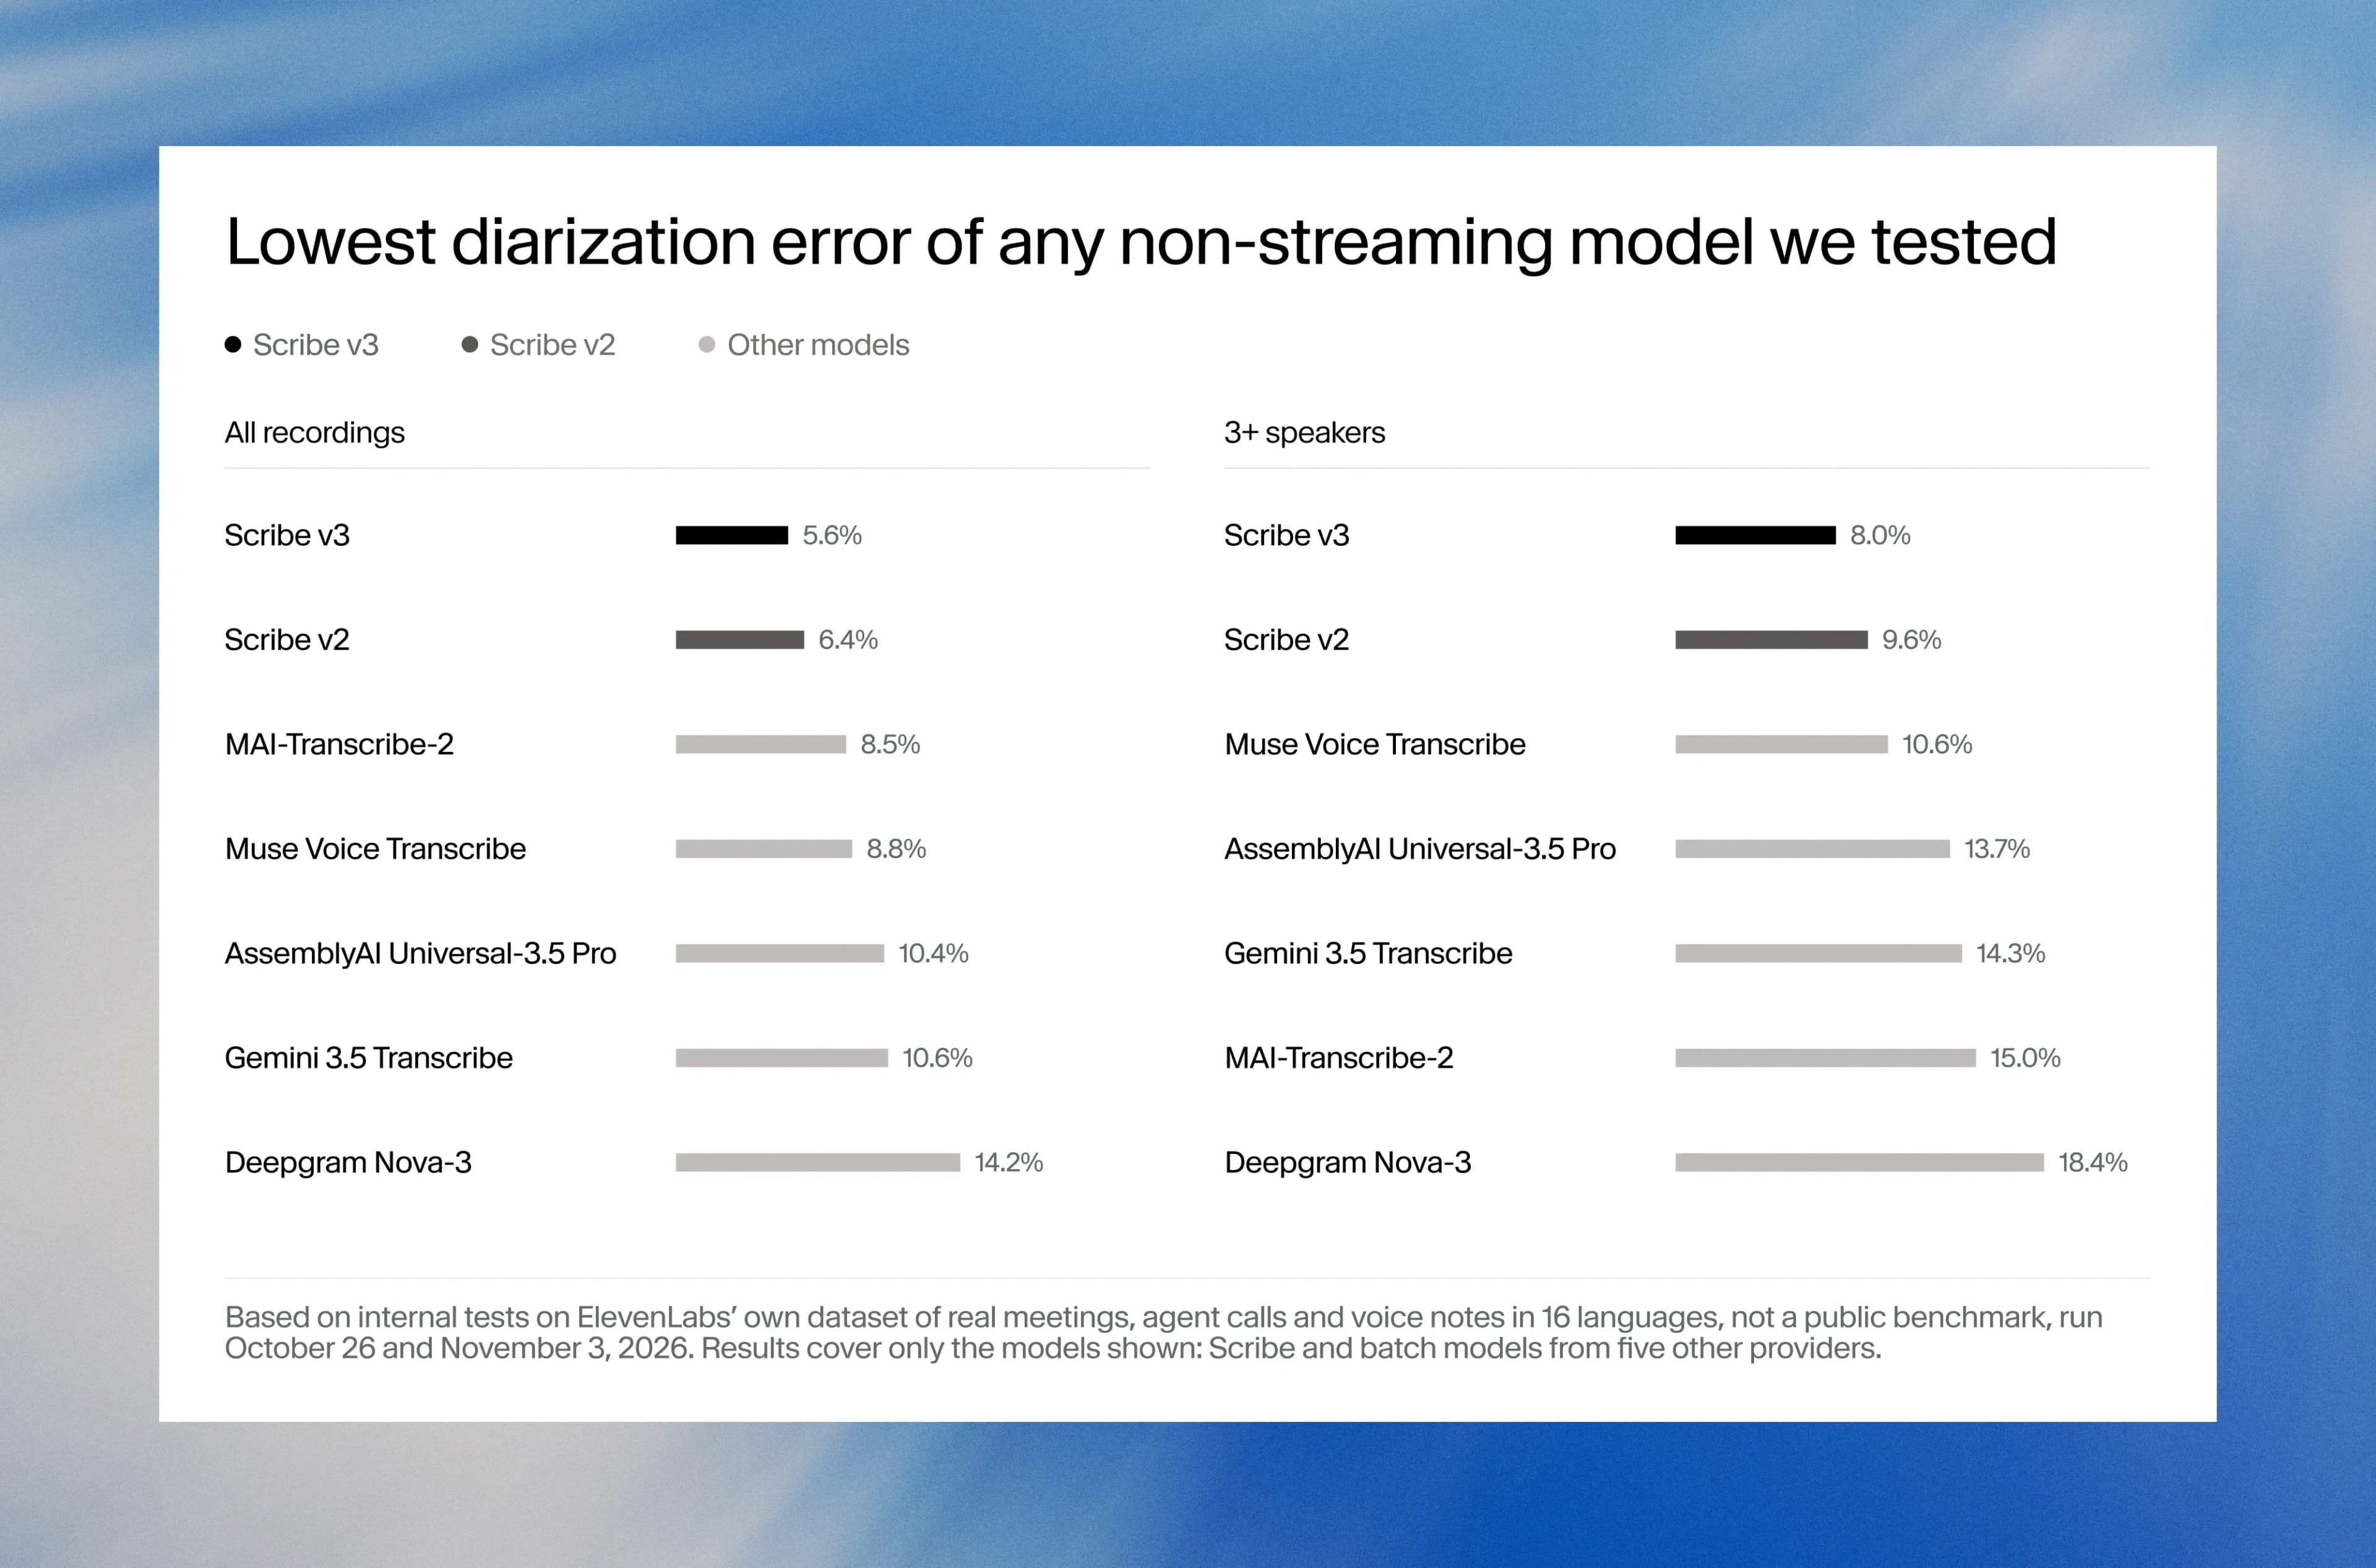
In una trascrizione di una riunione, identificare il parlante corretto è importante quanto riportare le parole corrette. Scribe v3 commette il 17% di errori di diarizzazione in meno rispetto a Scribe v2 nelle registrazioni con tre o più parlanti, ovvero quelle in cui la maggior parte dei modelli esistenti fallisce. Scribe v3 Live introduce inoltre per la prima volta la diarizzazione nella trascrizione in tempo reale, con il 39% di errori di diarizzazione in meno rispetto al secondo miglior modello in tempo reale che abbiamo testato.
Rilevamento dei turni che ascolta la conversazione
Per rendere naturali le conversazioni, gli agenti vocali devono prevedere con precisione quando un parlante ha finito di parlare. I sistemi tradizionali di gestione dei turni lo fanno in base ai periodi di silenzio. Ma il silenzio da solo impone un compromesso: impostare una soglia breve può interrompere chi fa una pausa a metà frase, mentre una lunga fa sembrare lento un agente. Scribe v3 Live utilizza il contesto della conversazione oltre all'audio, così un chiamante che fa una pausa a metà di un numero non viene interrotto. È lo stesso rilevamento dei turni già usato da ElevenAgents, ora disponibile in ElevenAPI.
Maggiore controllo su lingue, terminologia e formattazione
Scribe v3 può dedurre indicazioni sulle lingue che una registrazione potrebbe contenere e ti consente di scegliere se restituire i numeri in cifre o in lettere. Il keyterm prompting accetta fino a 1.000 termini che sai compariranno, come nomi di brand, acronimi e gergo tecnico, mentre le modifiche alla trascrizione applicano regole di formattazione scritte in inglese semplice, come “scrivi ogni data nel formato YYYY-MM-DD”.
Scribe v3 Live aggiunge una modalità multilingue per le conversazioni che cambiano lingua a metà frase. Aggiunge anche una libreria di termini chiave per vocabolari troppo ampi per un elenco. Mentre il keyterm prompting copre i termini che sai compariranno, la libreria di termini chiave ne contiene migliaia che potrebbero comparire e il modello la consulta solo quando rileva una probabile corrispondenza.
Come si posiziona Scribe v3
ElevenLabs ha valutato entrambi i modelli rispetto a Scribe v2, Scribe v2 Realtime e altri popolari modelli Speech to Text, assegnando a ciascuno un punteggio sugli stessi dataset. L'accuratezza multilingue è stata misurata su una versione interna del benchmark FLEURS, che testa parlato letto, breve e pulito in 102 lingue. FLEURS non può misurare la diarizzazione, poiché ogni clip ha un solo parlante, quindi abbiamo anche creato un nostro dataset di riunioni reali, chiamate con agenti e note vocali in 16 lingue. Lo renderemo open source a breve.
Diarizzazione dei parlanti
Scribe v3 ha il più basso tasso di errore di diarizzazione tra tutti i modelli che abbiamo testato, con il 12% di errori in meno rispetto a Scribe v2 nel complesso e il 17% in meno nelle registrazioni con tre o più parlanti.
Accuratezza della trascrizione multilingue
Riportiamo il tasso di errore delle parole (WER) insieme al WER semantico, che conta un errore solo quando cambia il significato della trascrizione.
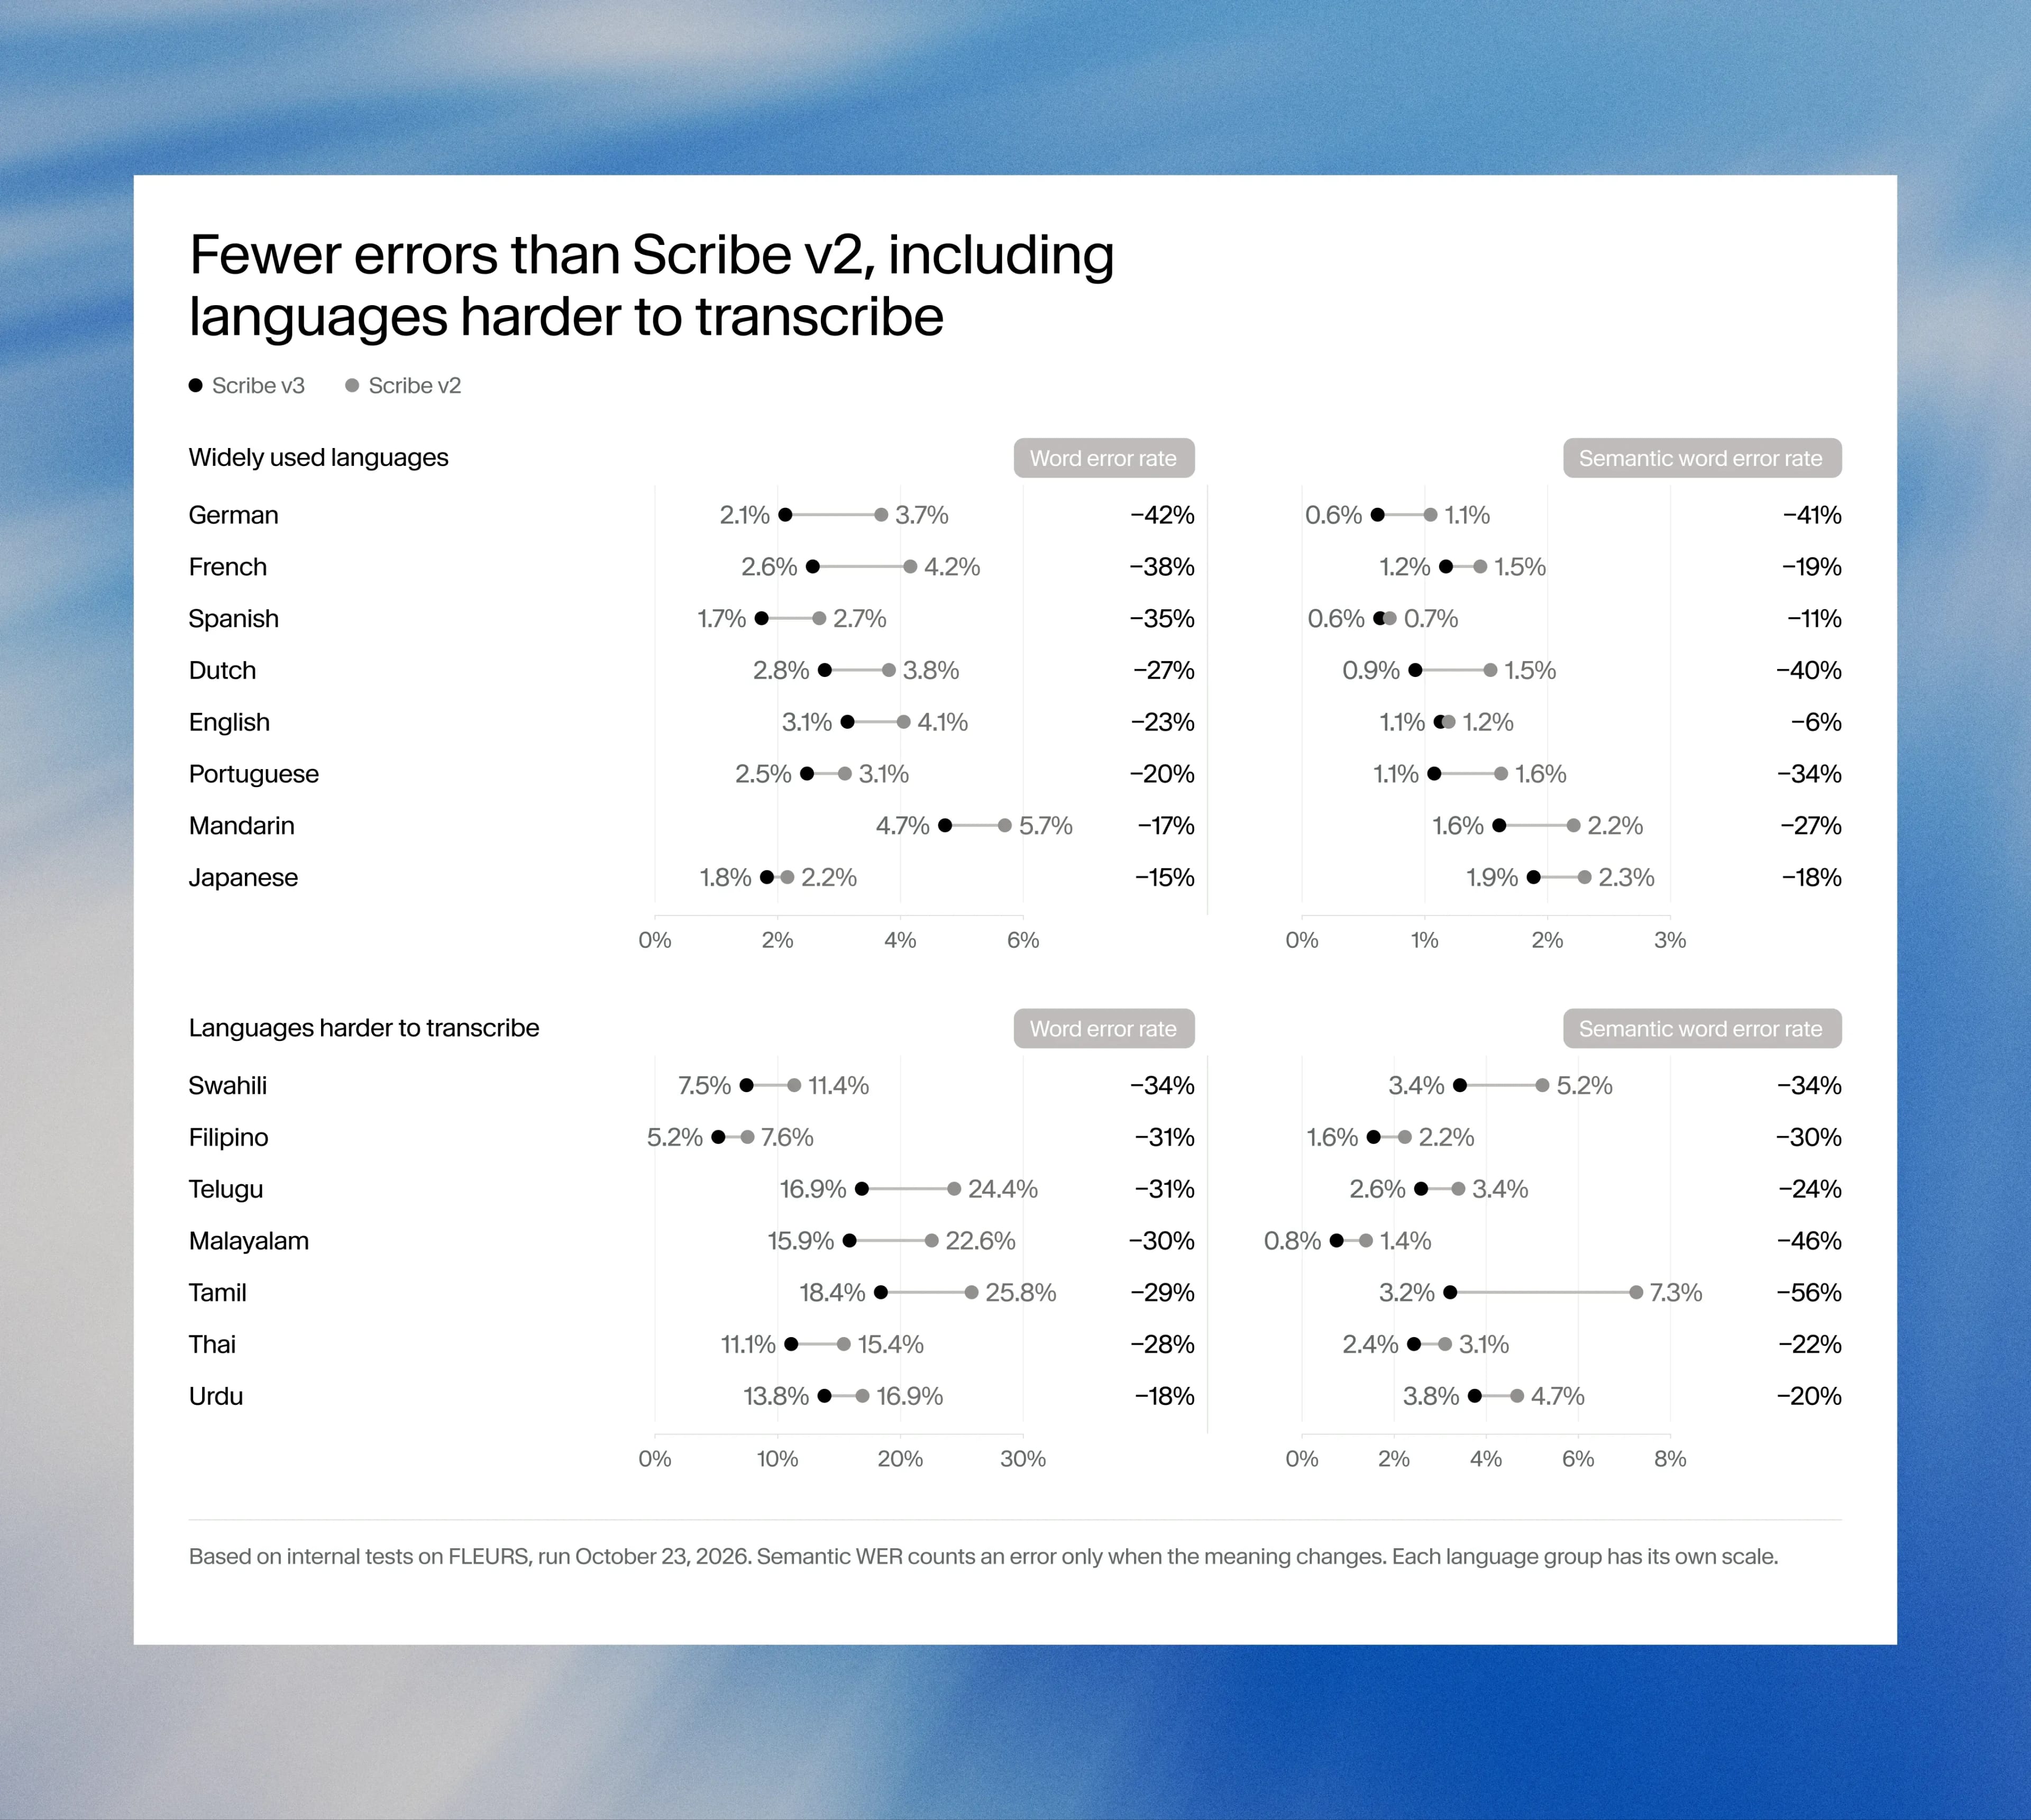
Nelle 102 lingue di FLEURS, Scribe v3 riduce il WER del 27% rispetto a Scribe v2 e migliora in ogni lingua testata. Nelle lingue più facili da trascrivere, il tedesco migliora del 42%, lo spagnolo del 35% e l'inglese del 23%. I miglioramenti sono maggiori nelle lingue più difficili da trascrivere: lo swahili registra un calo del 34%, il tamil del 29% e il thailandese del 28%.
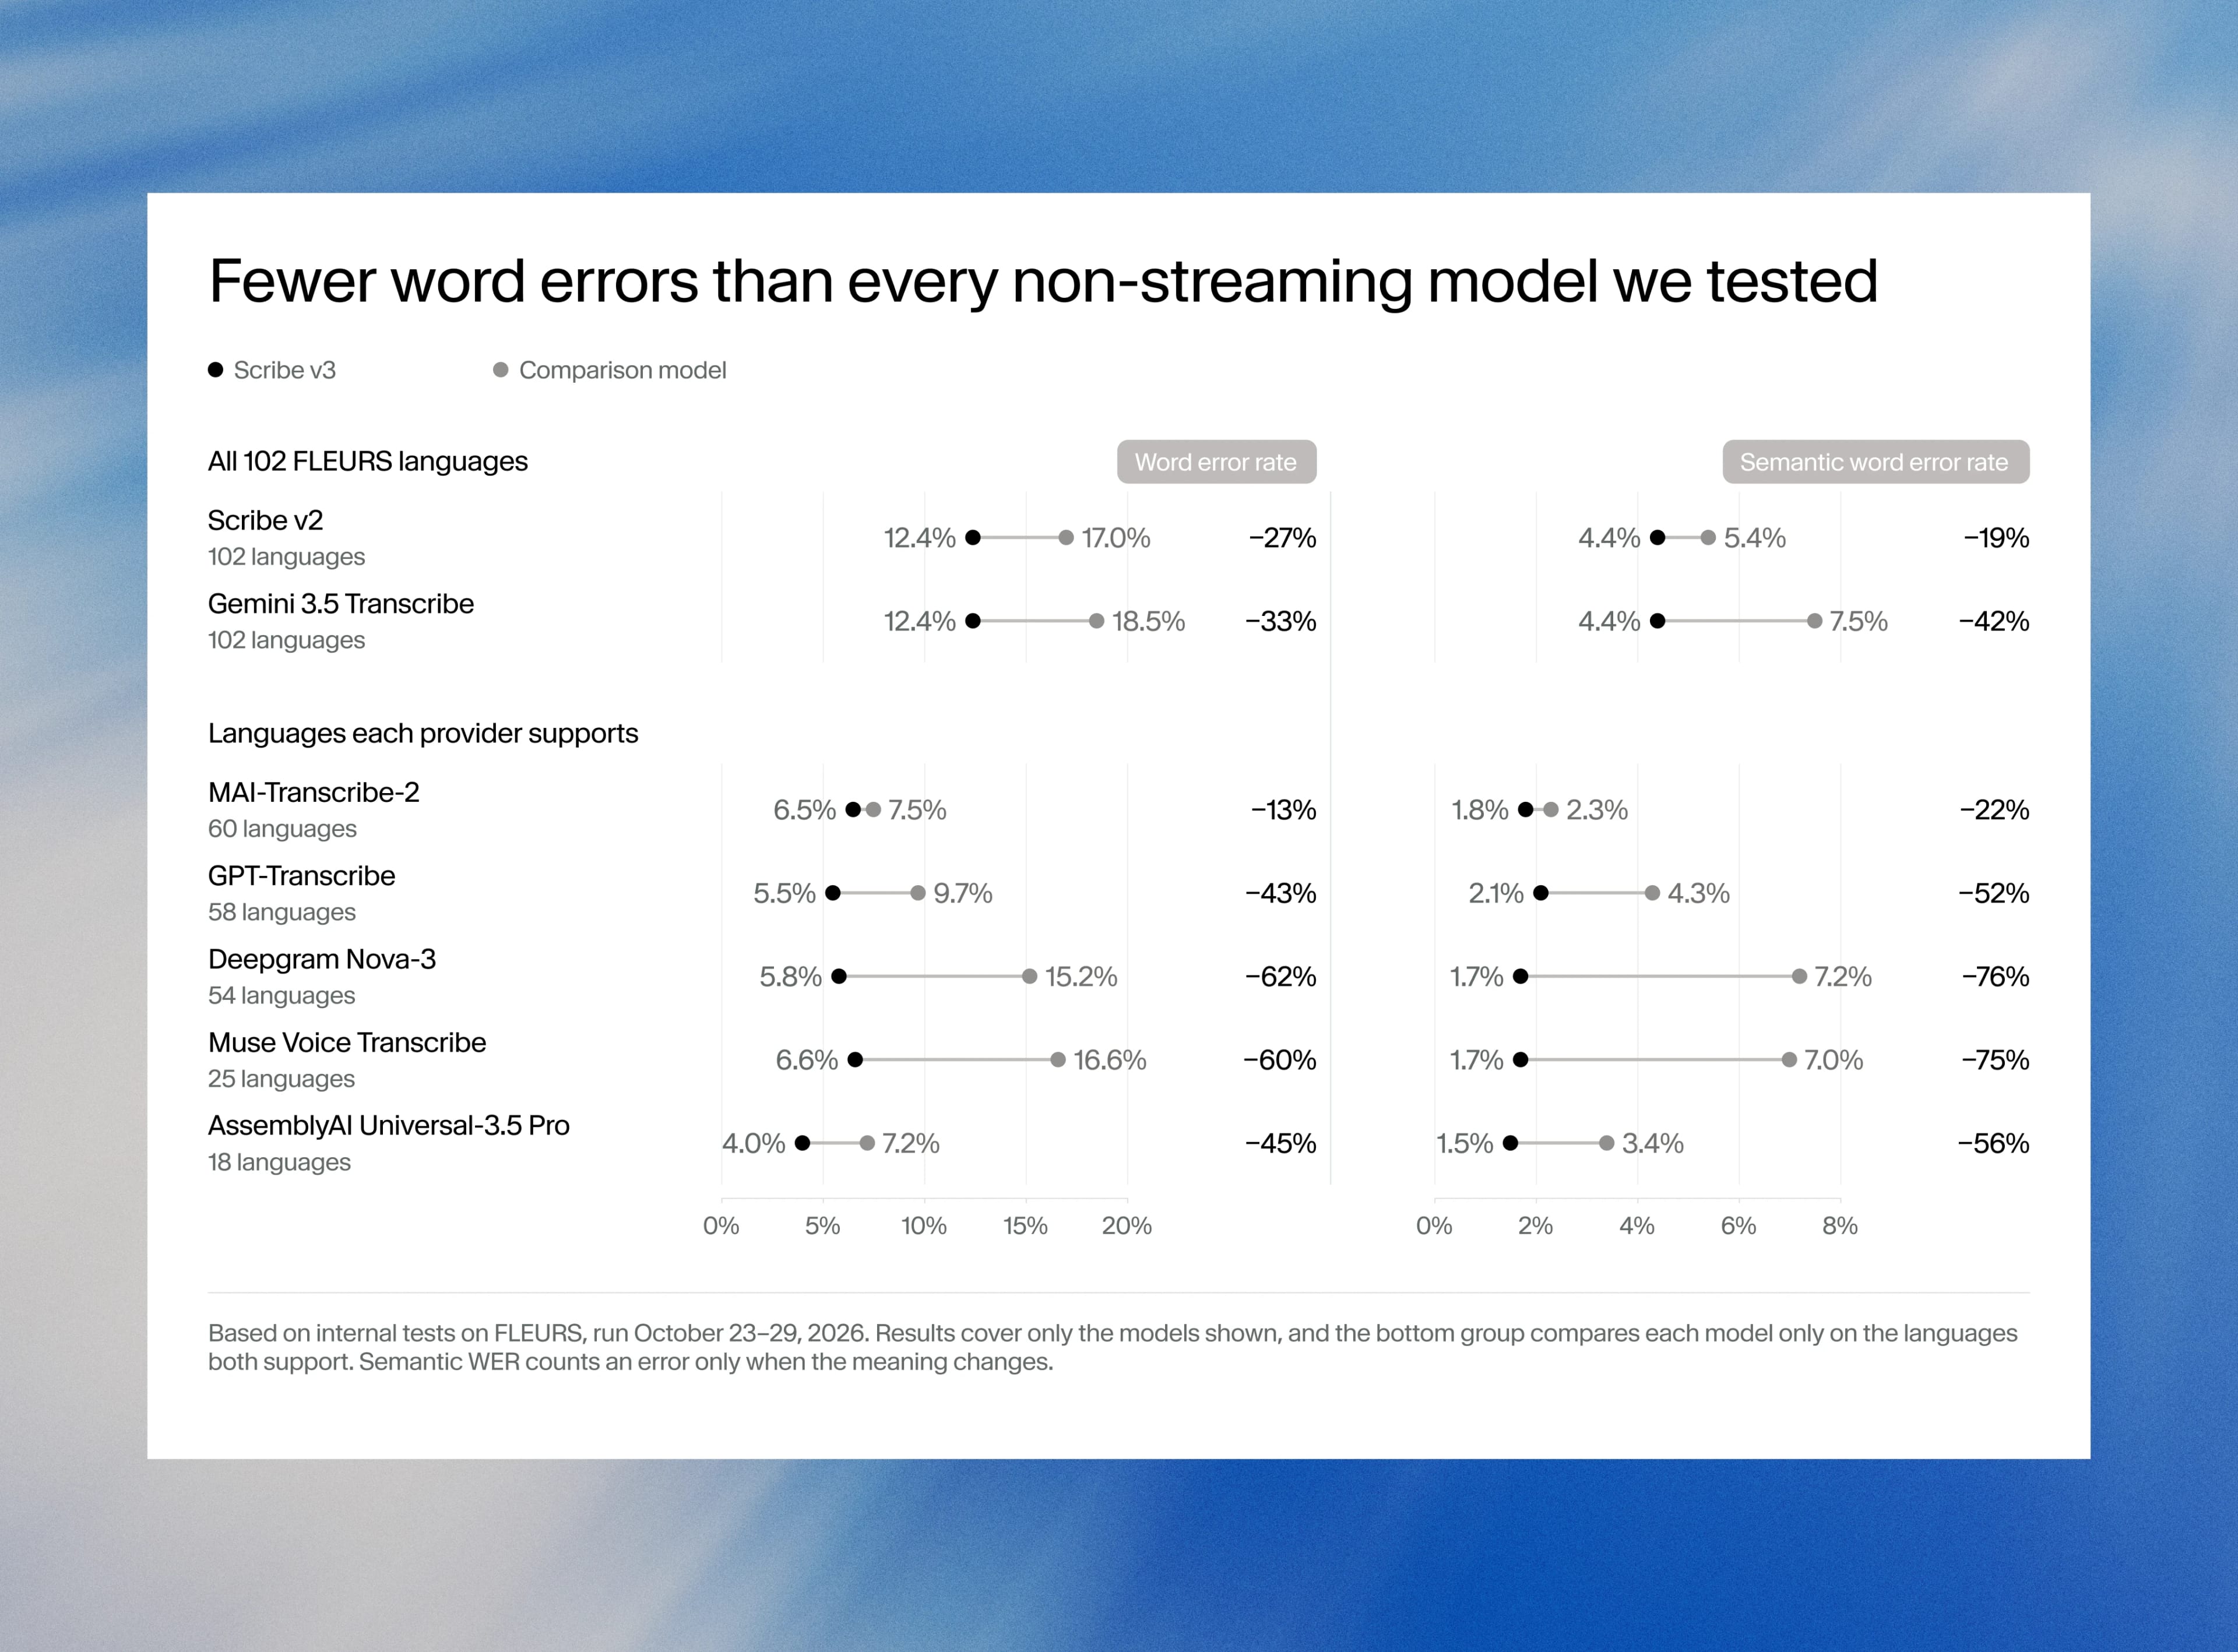
Scribe v3 commette inoltre meno errori di parole di qualsiasi altro modello batch, ovvero non in streaming, che abbiamo testato, confrontando ciascuno nelle lingue supportate da entrambi i modelli.
Diarizzazione dei parlanti in tempo reale
Nella porzione in inglese del nostro dataset reale in 16 lingue, Scribe v3 Live ha un tasso di errore di diarizzazione del 3,1%, rispetto al 5,9%-7,3% degli altri modelli in tempo reale che abbiamo testato.
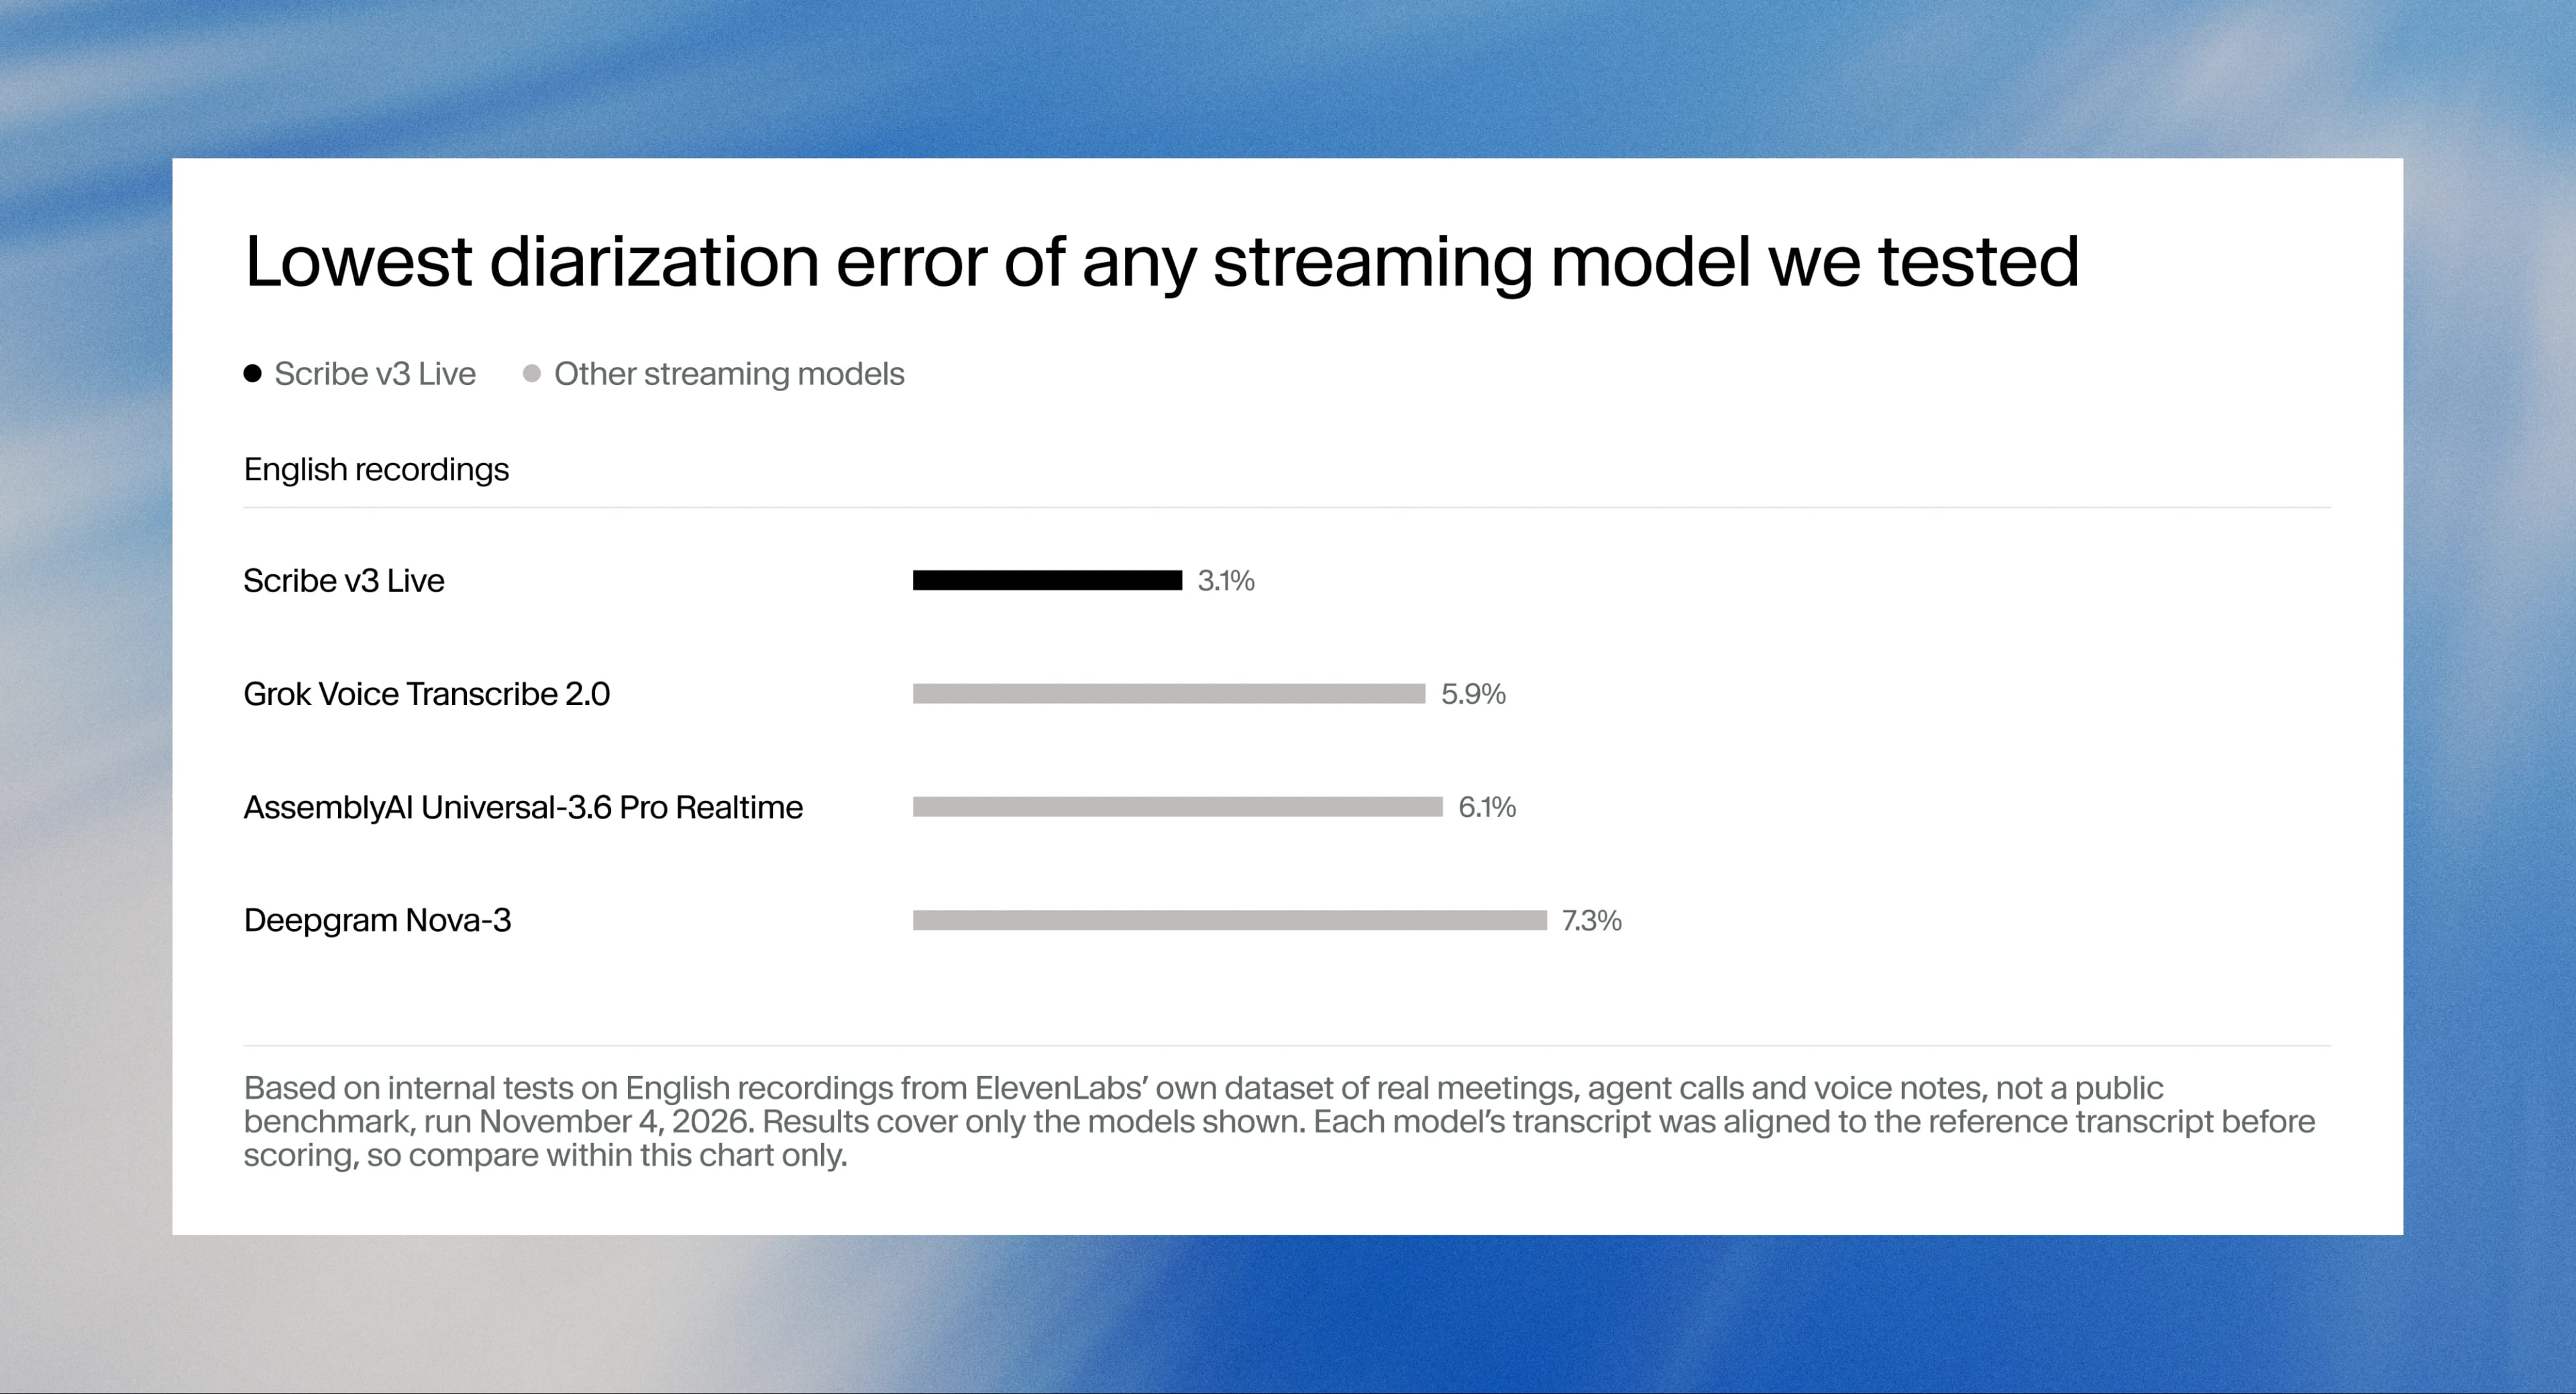
I punteggi standard di diarizzazione conteggiano anche gli errori di trascrizione, come le parole omesse, e i modelli in tempo reale omettono più parole rispetto ai modelli batch. Per misurare solo se ogni parola fosse stata attribuita al parlante giusto, abbiamo allineato la trascrizione di ciascun modello al riferimento prima della valutazione. Questo riduce il tasso di errore di ogni modello, quindi questi risultati non sono confrontabili con i risultati di diarizzazione batch riportati sopra.
Accuratezza multilingue in tempo reale
Per i modelli in tempo reale consideriamo innanzitutto il WER semantico. Un modello in streaming scrive il testo prima di aver ascoltato l'intera frase e ciascun fornitore formatta numeri, punteggiatura e maiuscole in modo diverso durante il processo. Il WER standard conta queste differenze come errori anche quando il significato è lo stesso, quindi il WER semantico è il confronto più equo.
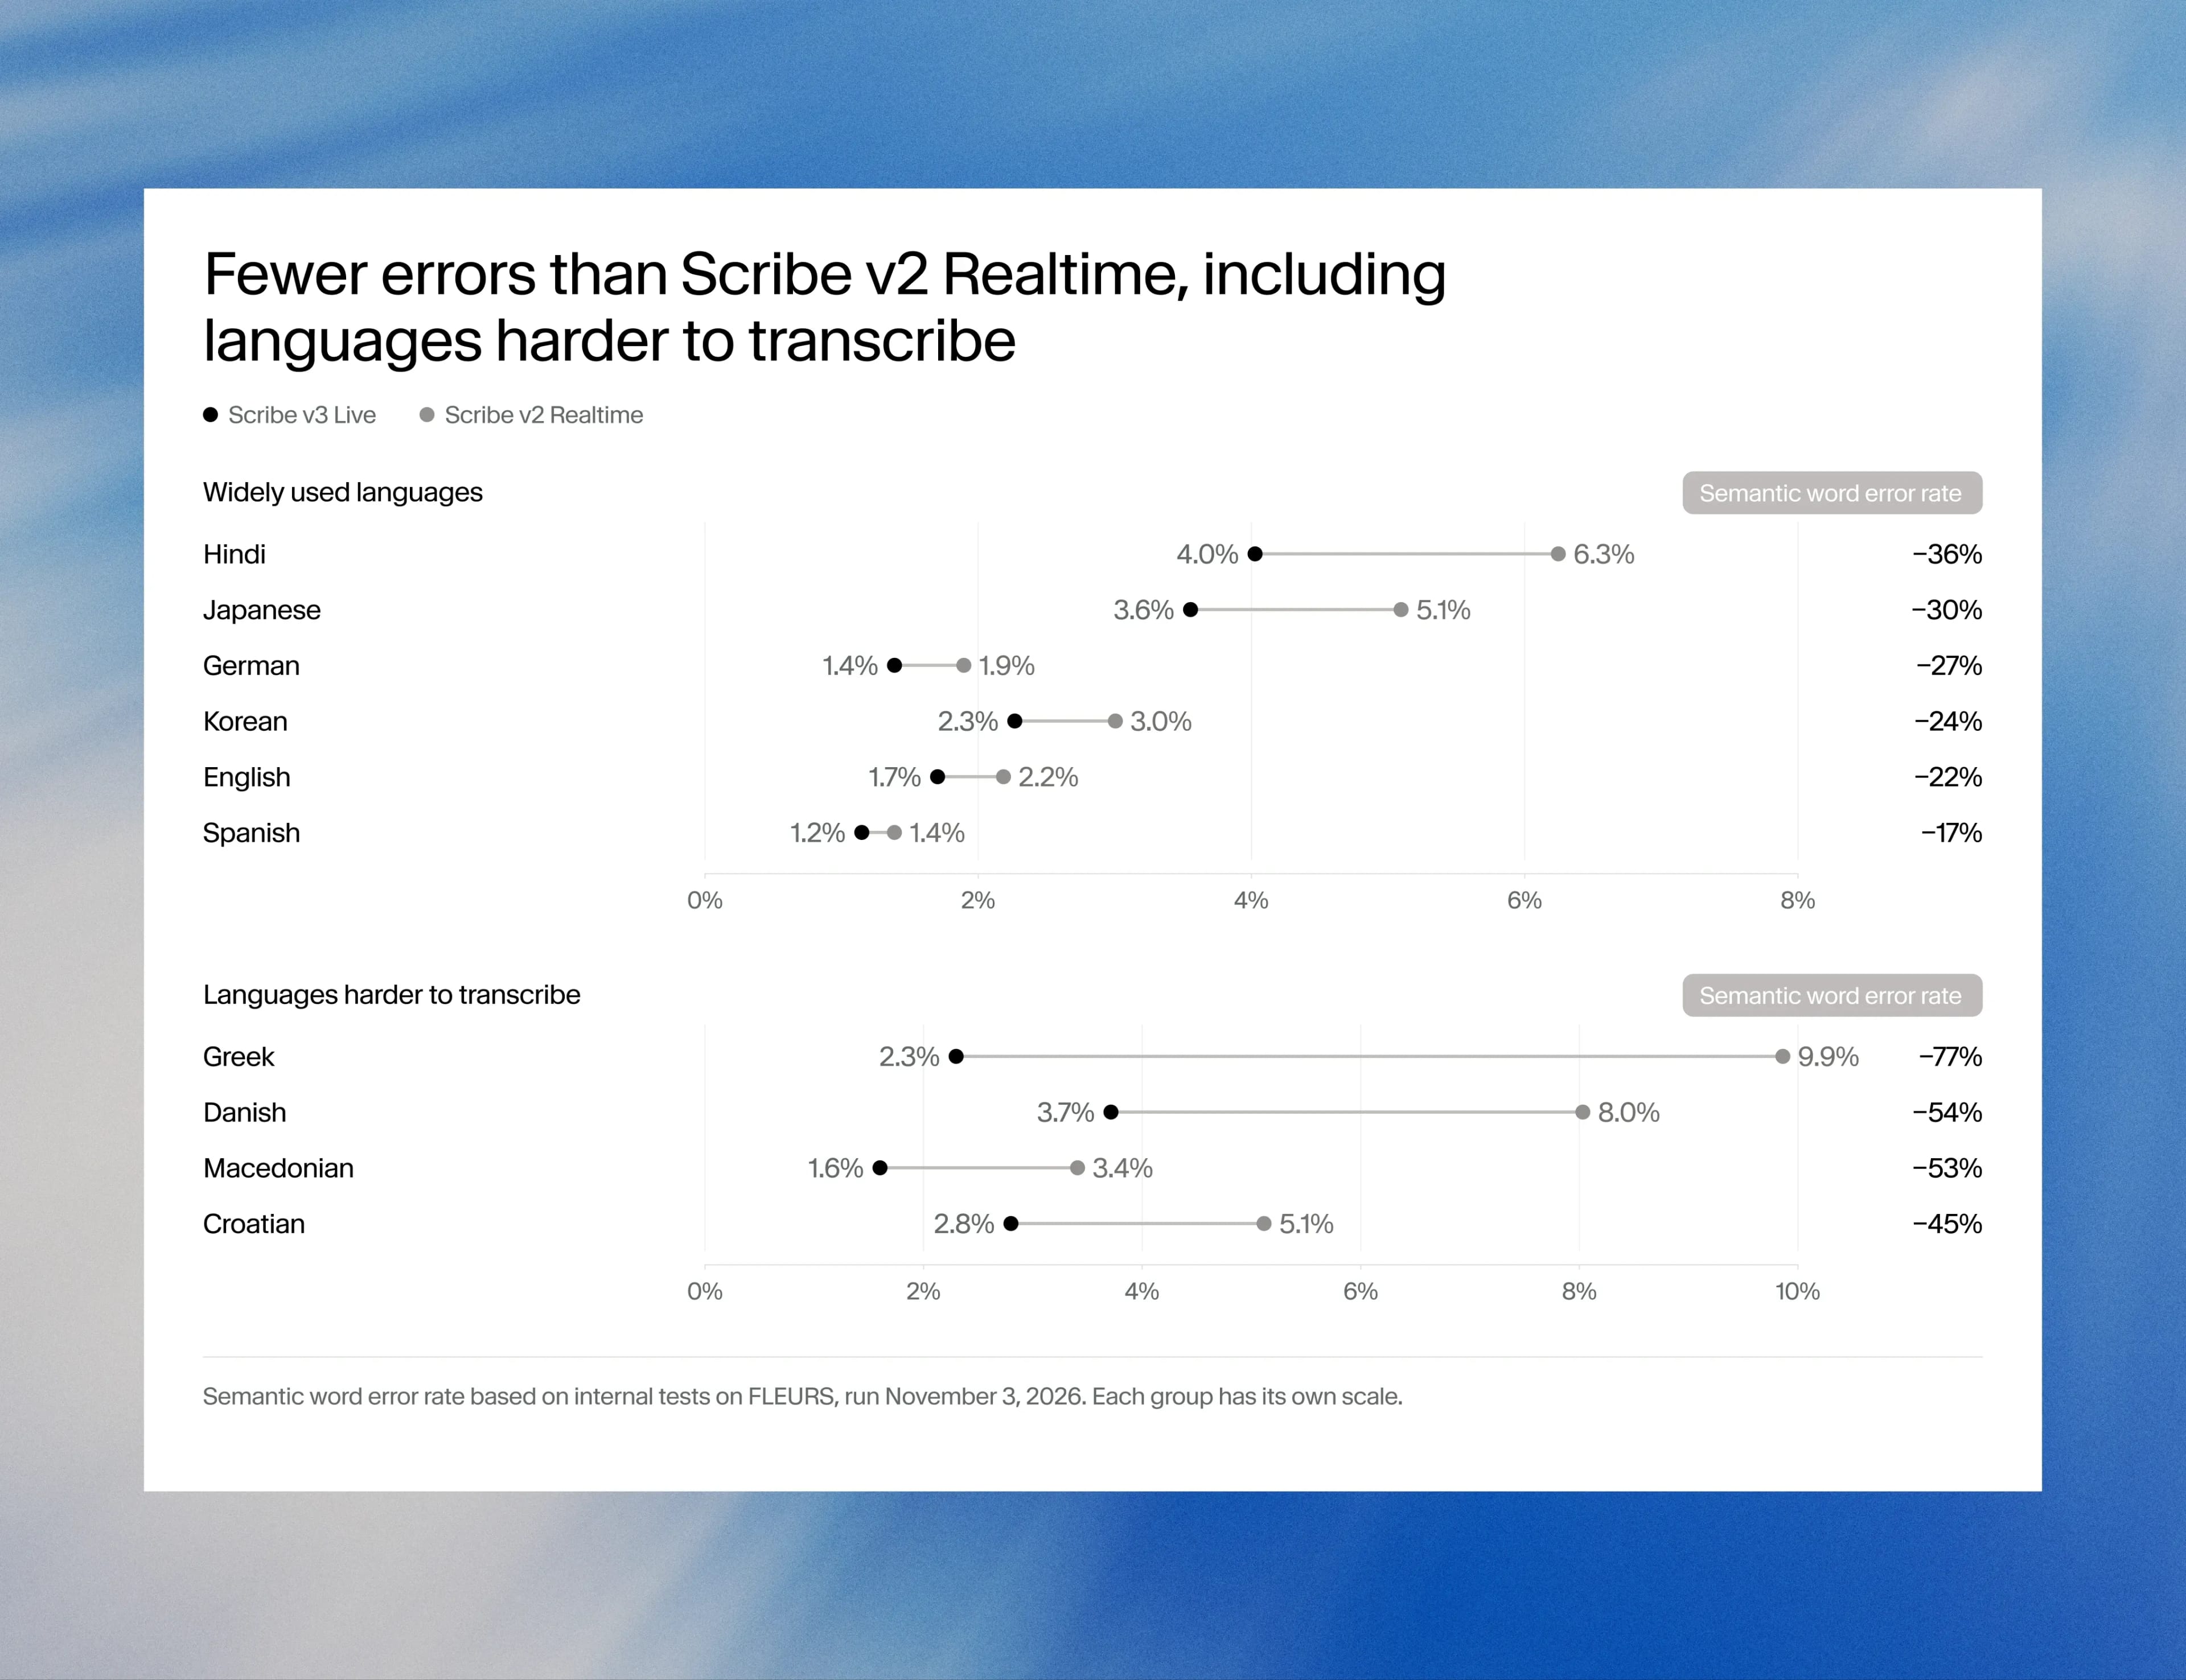
Nelle 102 lingue, Scribe v3 Live riduce il WER semantico del 43% e il WER del 31% rispetto a Scribe v2 Realtime. Migliora in ogni lingua e ha un tasso di errore inferiore a quello di qualsiasi altro modello in tempo reale che abbiamo testato.
I miglioramenti sono maggiori nelle lingue in cui la trascrizione in tempo reale era rimasta indietro: il greco migliora del 77%, il danese del 54% e il croato del 45%, mentre l'hindi migliora del 36%.
Una nota sul metodo: abbiamo valutato ogni lingua singolarmente prima di calcolare la media, quindi tutte le 102 lingue hanno lo stesso peso. Molti risultati pubblicati aggregano tutte le clip in un unico punteggio, che tende a produrre valori più bassi; pertanto, i risultati misurati in modi diversi non sono direttamente confrontabili.
Quanto valgono pochi punti di accuratezza
Ogni lancio di un modello è accompagnato da percentuali, incluso questo, e sulla carta è difficile capire cosa significhino pochi punti in scenari reali. Una riunione di un'ora a 150 parole al minuto conta circa 9.000 parole, quindi la differenza tra un tasso di errore delle parole del 4% e uno del 2% è di 180 parole errate, tre per ogni minuto in cui qualcuno ha parlato. L'errore di diarizzazione si misura in tempo anziché in parole, quindi nella stessa riunione ogni punto equivale a 36 secondi di parlato attribuito al nome sbagliato.
Il costo di questi errori dipende da dove si verificano. Nella trascrizione di un podcast, una parola sbagliata è un refuso, ma in una chiamata sui risultati finanziari “quindici” interpretato come “cinquanta” finisce nel modello di un analista. Gli errori tendono inoltre a concentrarsi in nomi, numeri, acronimi e gergo tecnico, ovvero proprio le parole che un riepilogo o un agente deve riportare correttamente.
Ottenere il risultato giusto al primo tentativo in ElevenAgents
Gli agenti vocali ne risentono più di tutti, perché una singola cifra interpretata male può far fallire la verifica che avvia la chiamata. Eneco, che fornisce energia a oltre 2 milioni di abitazioni e aziende nei Paesi Bassi, gestisce il proprio agente vocale su ElevenAgents e ha testato Scribe v3 Live prima del lancio. Nelle chiamate reali dei clienti, l'agente ha riconosciuto correttamente i codici postali olandesi al primo tentativo il 40% più spesso e i numeri civici il 15% più spesso.
“ElevenLabs è un vero partner per Eneco. Insieme ai suoi forward deployed engineer, stiamo lavorando per migliorare ulteriormente il nostro agente vocale”, ha dichiarato Ruud Huigsloot, Senior Product Manager di Eneco. “È fantastico vedere risultati significativi già in questa fase iniziale e siamo entusiasti di continuare a collaborare.”
Progettati per le aziende
Scribe v3 e Scribe v3 Live vengono eseguiti negli Stati Uniti per impostazione predefinita e sono offerti in ambienti isolati nell'UE, in India e a Singapore per i clienti enterprise con requisiti di residenza dei dati. Zero Retention Mode elimina audio e testo non appena una richiesta viene completata. Entrambi i modelli sono coperti dai nostri programmi SOC 2, ISO 27001 e PCI DSS Livello 1, sono idonei per HIPAA con un Business Associate Agreement e sono disponibili per il deployment privato.
Inizia oggi
Scribe v3 Live è disponibile in ElevenAgents e sia v3 sia v3 Live sono le opzioni predefinite nell'app ElevenLabs. Registrati per provarli.
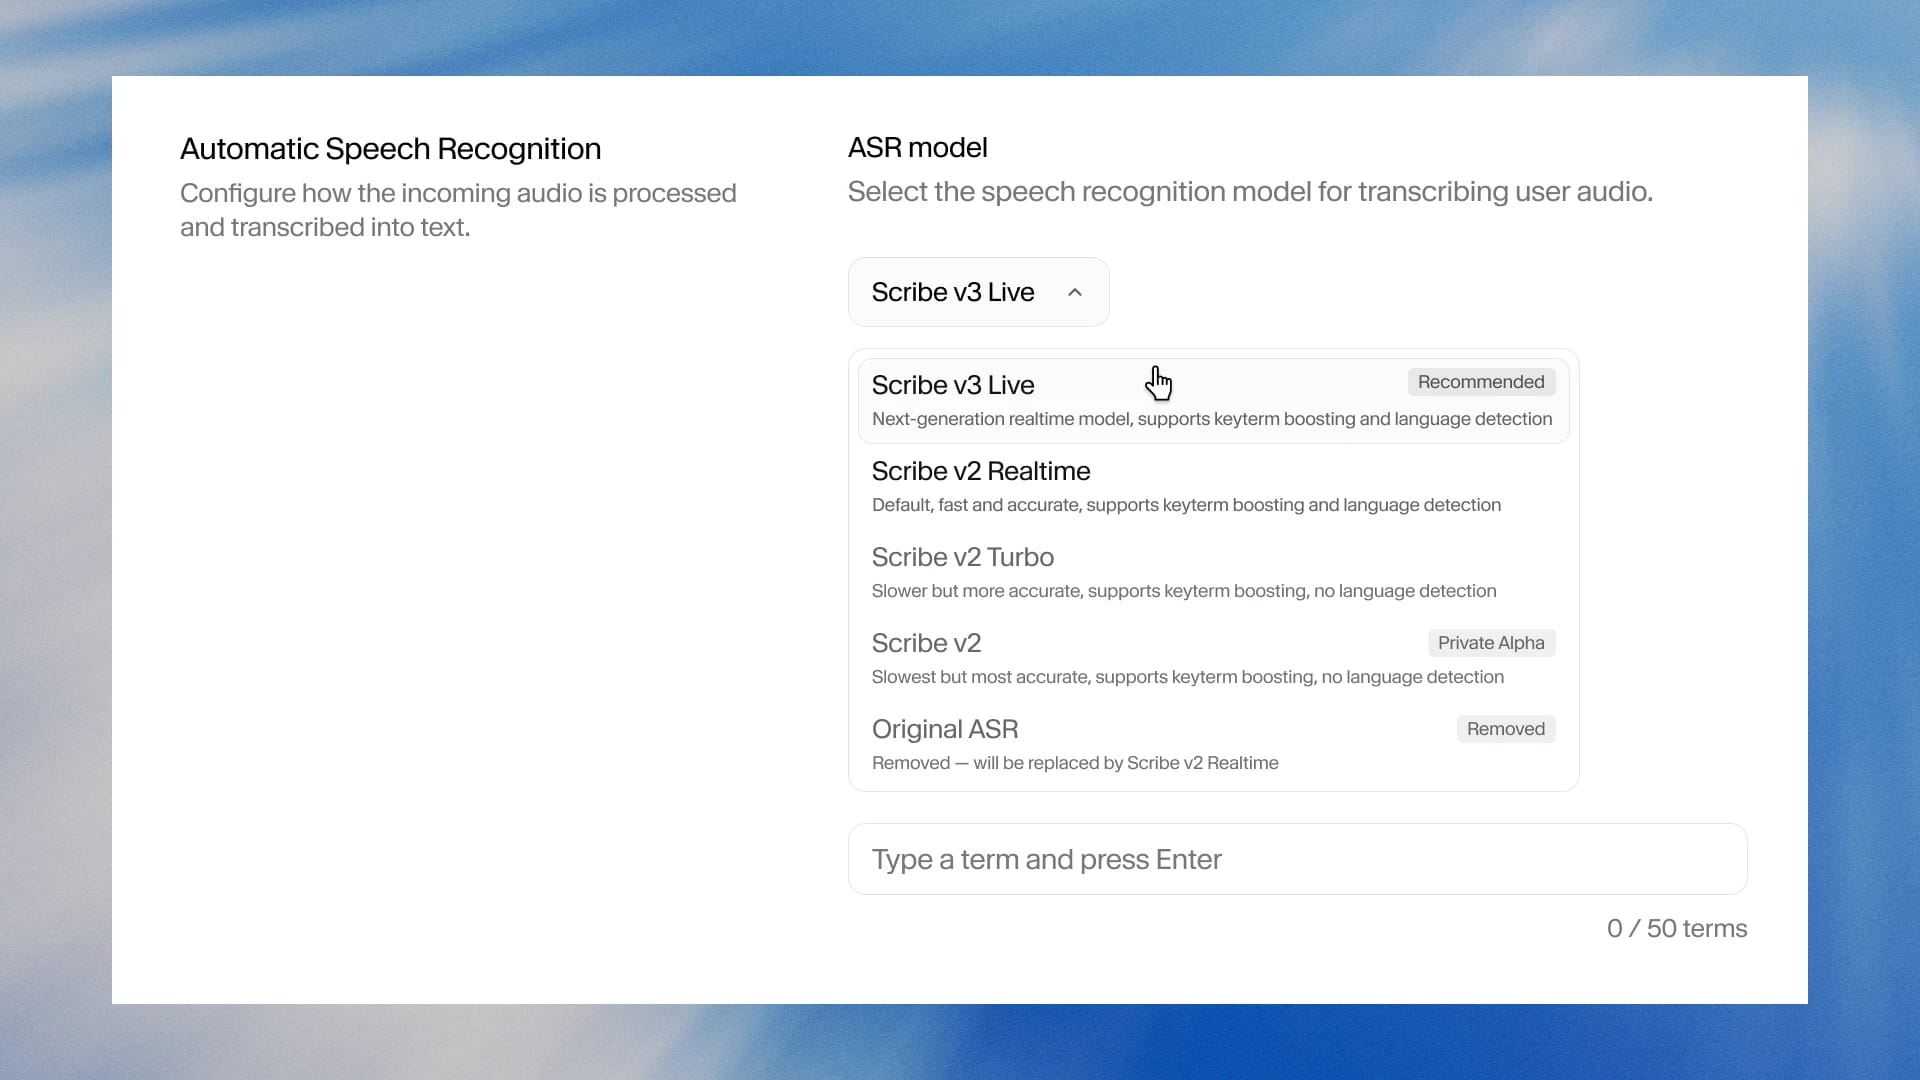
Entrambi i modelli sono disponibili da oggi anche in ElevenAPI. Le integrazioni esistenti si aggiornano modificando l'ID del modello in scribe_v3 o scribe_v3_live.
Per i team sanitari, rilasciamo inoltre una versione di Scribe v3 Live ottimizzata per le conversazioni mediche in ElevenAgents.
Min fa parte del team Growth di ElevenLabs e si occupa di ElevenAPI e delle soluzioni On-Prem/On-Device. In precedenza, ha guidato il product marketing in Stainless come seconda assunzione GTM e, prima ancora, è stato tra i primi PMM di WorkOS, dove ha seguito lanci, enablement, contenuti e crescita.