टेक्स्ट टू स्पीच तकनीक कैसे काम करती है: टेक्स्ट से प्राकृतिक आवाज़ तक
- लेखक
- Jack Limebear
- प्रकाशित
सुनेंइस आर्टिकल को सुनें
टेक्स्ट टू स्पीच (TTS) तकनीक लिखे हुए शब्दों को बोले गए ऑडियो में बदलती है। सिस्टम पहले समझता है कि टेक्स्ट में क्या कहा गया है और उसे कैसा सुनाई देना चाहिए, फिर एक AI मॉडल ऑडियो बनाता है।
शुरुआत में, TTS इंजन टेक्स्ट इनपुट को नॉर्मलाइज़ करता है और उसे गणितीय टोकन और वेक्टर रिप्रेज़ेंटेशन में बदलता है, जिन पर कंप्यूटर सिस्टम काम कर सकता है। फिर मॉडल इन गणितीय संरचनाओं को ध्वनि के डिजिटल रिप्रेज़ेंटेशन में और आखिर में ऑडियो आउटपुट में बदलता है।
इस लेख में, हम जानेंगे कि अलग-अलग टेक्स्ट टू स्पीच टूलिंग कैसे काम करती है और जनरेटिव AI न्यूरल स्पीच सिंथेसिस की नवीनतम पीढ़ी अब तक की सबसे प्राकृतिक आवाज़ कैसे देती है।
सारांश
- टेक्स्ट टू स्पीच सिस्टम लिखे हुए शब्दों को दो चरणों में ऑडियो में बदलते हैं। वे टेक्स्ट को टोकन या भाषा के गणितीय रिप्रेज़ेंटेशन में बदलते हैं। फिर वे टोकन को एक ध्वनिक रिप्रेज़ेंटेशन में बदलते हैं, जो ध्वनि के रूप में आउटपुट होता है।
- नए न्यूरल TTS इंजन प्राकृतिक लगने वाली आवाज़ बनाने के लिए AI मॉडल इस्तेमाल करते हैं। बिज़नेस टीमें इन्हें कंटेंट बनाने, सबटाइटलिंग और कस्टमर सपोर्ट एजेंट्स को चलाने के लिए इस्तेमाल करती हैं।
- प्रनंसिएशन डिक्शनरी और फोनेटिक टैगिंग, TTS आउटपुट को यथासंभव प्राकृतिक बनाने और तकनीकी शब्दों व नामों का सही उच्चारण सुनिश्चित करने के दो तरीके हैं।
- एक टेक्स्ट टू स्पीच API आपको बिज़नेस ऐप्लिकेशन को उच्च-गुणवत्ता वाली वॉइस जनरेशन से जोड़ने देता है।
TTS क्या है? टेक्स्ट टू स्पीच तकनीक कैसे काम करती है
टेक्स्ट टू स्पीच लिखे हुए टेक्स्ट का विश्लेषण करके, हर शब्द को कैसे सुनाई देना चाहिए यह तय करके, और फिर बोले गए ऑडियो को बनाने के लिए न्यूरल मॉडल व वोकोडर—दोनों का इस्तेमाल करके काम करती है।
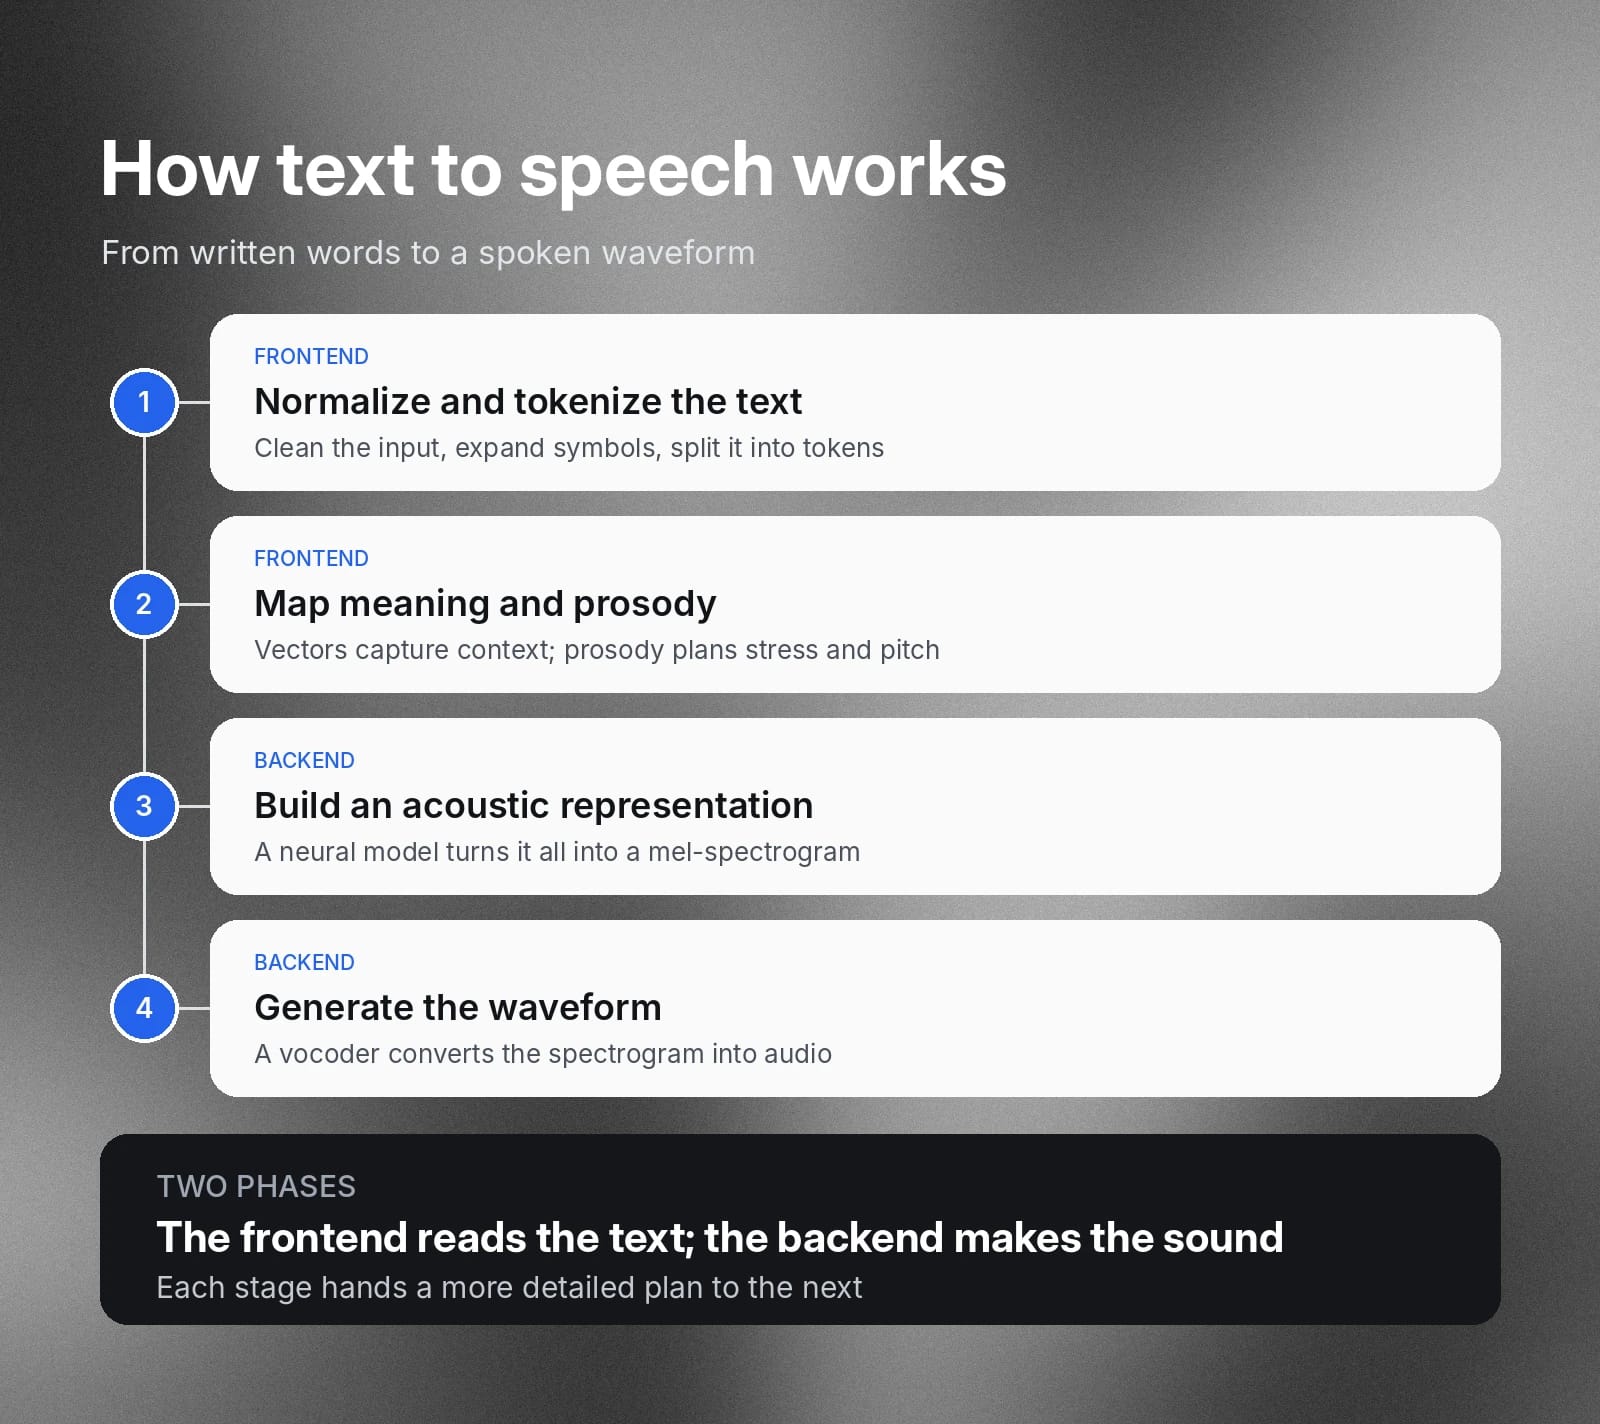
मोटे तौर पर TTS दो चरणों में बंटा है:
- फ्रंटएंड: सिस्टम टेक्स्ट को ऐसे गणितीय रूप में बदलता है, जिस पर TTS इंजन काम कर सके।
- बैकएंड: सिस्टम पहले चरण का आउटपुट लेता है और उसे आवाज़ को मॉडल करने वाली वेवफ़ॉर्म में बदलता है।
आइए, TTS के काम करने के इन घटकों को विस्तार से समझते हैं।
टेक्स्ट नॉर्मलाइज़ेशन और भाषाई विश्लेषण
TTS प्रक्रिया का पहला चरण नेचुरल लैंग्वेज प्रोसेसिंग (NLP) है: रॉ टेक्स्ट इनपुट को साफ़ करना, टोकनाइज़ करना और उसके अर्थ की अस्पष्टता दूर करना। यह टेक्स्ट को टोकन में बांटता है—लिखित भाषा की ऐसी अलग-अलग इकाइयाँ, जिन पर TTS इंजन काम कर सकता है। एक टोकन पूरा शब्द, “सबवर्ड” इकाई या विराम चिह्न हो सकता है।
टेक्स्ट में अक्सर पूरे शब्दों के अलावा संक्षिप्त रूप और संख्याओं जैसे प्रतीक होते हैं। TTS इंजन को यह भी तय करना होता है कि इन्हें कैसे बोला जाए। उदाहरण के लिए, TTS इंजन “$11” को पढ़कर “eleven dollars” की ध्वनियों में बदलता है।
अर्थ और प्रोसोडी
प्रोसोडी आवाज़ की पिच और लय है, जो TTS को प्राकृतिक बनाती है। टेक्स्ट प्रोसेस करते समय इंजन प्रोसोडिक जानकारी की एक लेयर भी बनाता है, जो टेक्स्ट पर बल और स्वराघात में बदलाव मैप करती है, ताकि आवाज़ अधिक प्राकृतिक लगे।
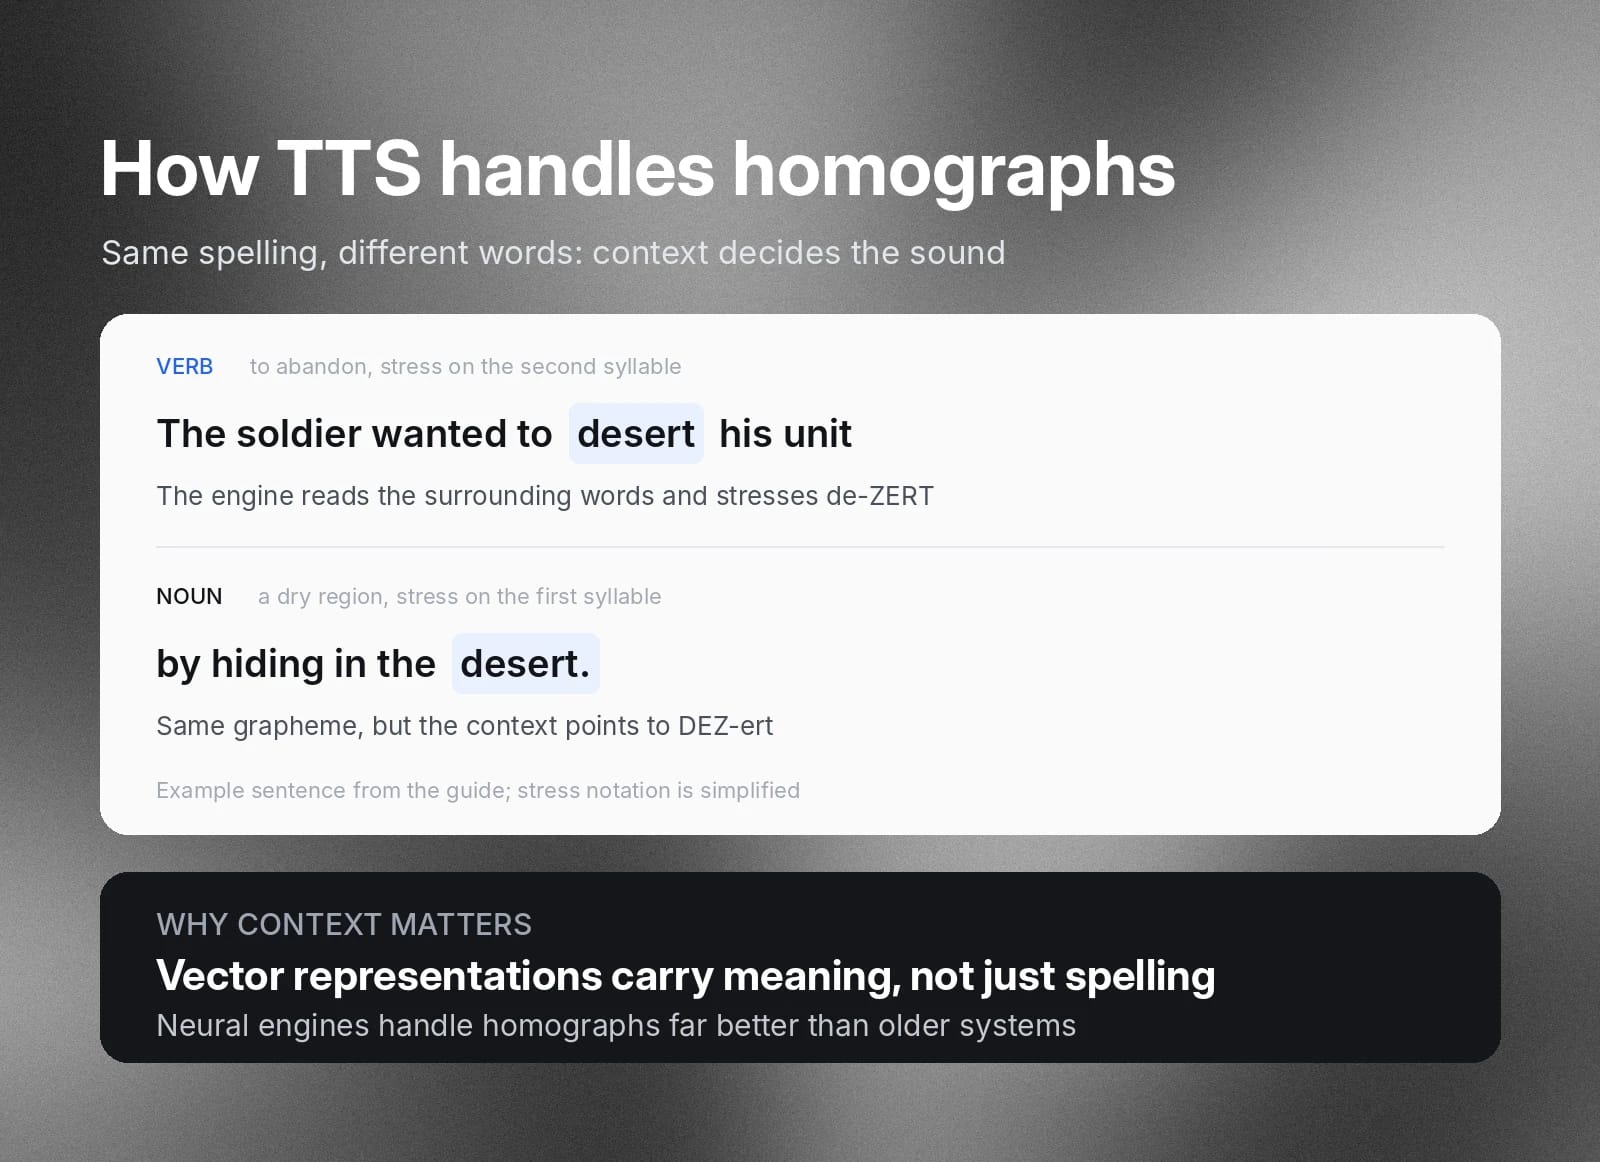
TTS इंजन को संदर्भ के आधार पर टेक्स्ट टू स्पीच उच्चारण भी बदलना होता है। वह यह जानकारी वेक्टर रिप्रेज़ेंटेशन के रूप में इकट्ठा करता है—ऐसा संख्यात्मक डेटा, जो शब्दों और वाक्यांशों के बीच अर्थगत समानता को मैप करता है। इसे X-Y ग्राफ़ की तरह समझें, जहां एक लाइन कई अलग-अलग बिंदुओं के आधार पर प्लॉट होती है, लेकिन दो से कहीं अधिक आयामों में मैप की जाती है।
एक खास उदाहरण होमोग्राफ़ हैं। होमोग्राफ़, यानी अलग-अलग शब्द जिनकी वर्तनी एक जैसी होती है, को कभी-कभी अलग तरह से बोलना पड़ता है। TTS इंजन को बोलते समय हर शब्द के लिए सही स्वराघात और बल पहचानना होता है। उदाहरण के लिए, वाक्य "The soldier wanted to desert his unit by hiding in the desert.” में ग्रैफीम “desert” का उच्चारण कैसे किया जाए।
देखें कि Eleven v4 इस उदाहरण को कैसे जीवंत बनाता है।
ध्वनिक मॉडलिंग और वेवफ़ॉर्म (स्पीच) सिंथेसिस
TTS इंजन टोकनाइज़ की गई जानकारी और कॉन्टेक्स्टुअल वेक्टर लेता है, जो अब संख्यात्मक डेटा हैं, और उन्हें एक ध्वनिक रिप्रेज़ेंटेशन में बदलता है, जैसे मेल-स्पेक्ट्रोग्राम। इसमें अलग-अलग फ़्रीक्वेंसी, ऊर्जा स्तर और वे ध्वनियां शामिल होती हैं जिन्हें मस्तिष्क भावना के रूप में समझता है। पहले इस काम के लिए कई अलग-अलग सिस्टम इस्तेमाल किए जाते थे, लेकिन आज न्यूरल मॉडल सबसे प्रभावी विकल्पों में हैं।
आखिरी चरण में वोकोडर इन स्पेक्ट्रोग्राम को ऐसे ऑडियो में बदलता है जिसे इंसान आवाज़ के रूप में पहचानते हैं। इस प्रक्रिया को वेवफ़ॉर्म जनरेशन कहा जाता है।
TTS व्यवहार में कैसे काम करता है: एक उदाहरण
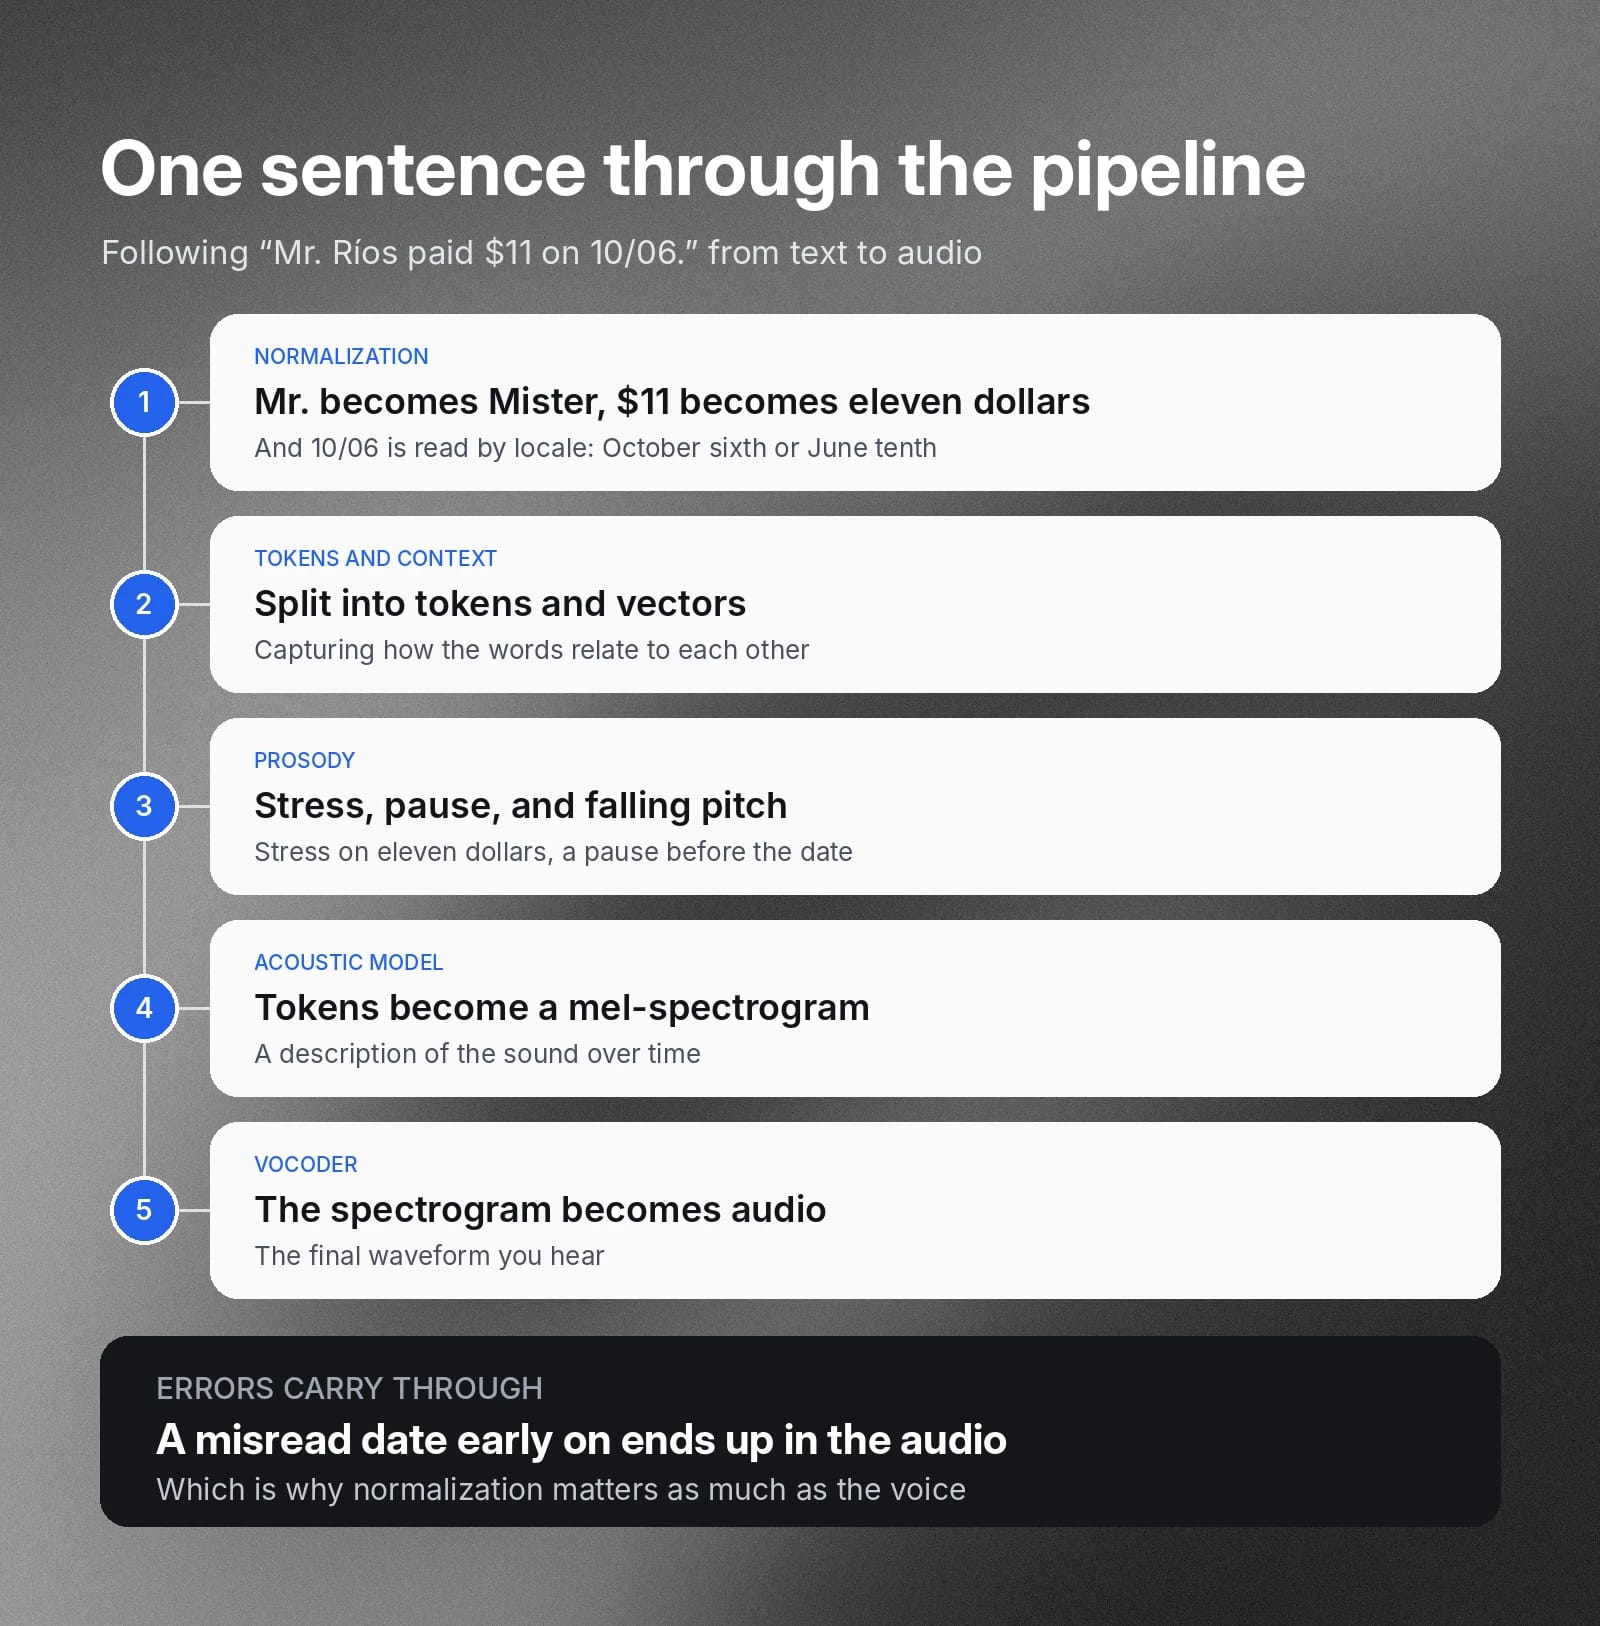
TTS के चरण एक साथ कैसे काम करते हैं, यह देखने का सबसे आसान तरीका है कि एक वाक्य को पूरी पाइपलाइन से गुज़रते हुए देखें।
यह टेक्स्ट लें: “Mr. Ríos paid $11 on 10/06.”
- नॉर्मलाइज़ेशन: इंजन “Mr.” को “Mister” में बदलता है, “$11” को “eleven dollars” के रूप में पढ़ता है और लोकेल व संदर्भ के आधार पर तय करता है कि “10/06” का अर्थ “October sixth” है या “the tenth of June।”
- टोकनाइज़ेशन और संदर्भ: साफ़ किए गए टेक्स्ट को टोकन में बांटा जाता है और ऐसे वेक्टर में बदला जाता है जो शब्दों के आपसी संबंधों को दर्शाते हैं।
- प्रोसोडी: इंजन “eleven dollars” पर बल देता है, तारीख से पहले छोटा विराम जोड़ता है और वाक्य के अंत में पिच को नीचे ले जाता है।
- ध्वनिक मॉडल: न्यूरल मॉडल टोकन और प्रोसोडी प्लान को एक मेल-स्पेक्ट्रोग्राम में बदलता है, जो समय के साथ ध्वनि का वर्णन करता है।
- वोकोडर: वोकोडर स्पेक्ट्रोग्राम को उस अंतिम ऑडियो वेवफ़ॉर्म में बदलता है जो आप सुनते हैं।
हर चरण अगले चरण को अधिक विस्तृत प्लान देता है। इसलिए पाइपलाइन में शुरू की गलतियां, जैसे तारीख को गलत पढ़ना, अंतिम ऑडियो तक पहुंच जाती हैं।
न्यूरल टेक्स्ट टू स्पीच अधिक मानवीय क्यों लगती है?
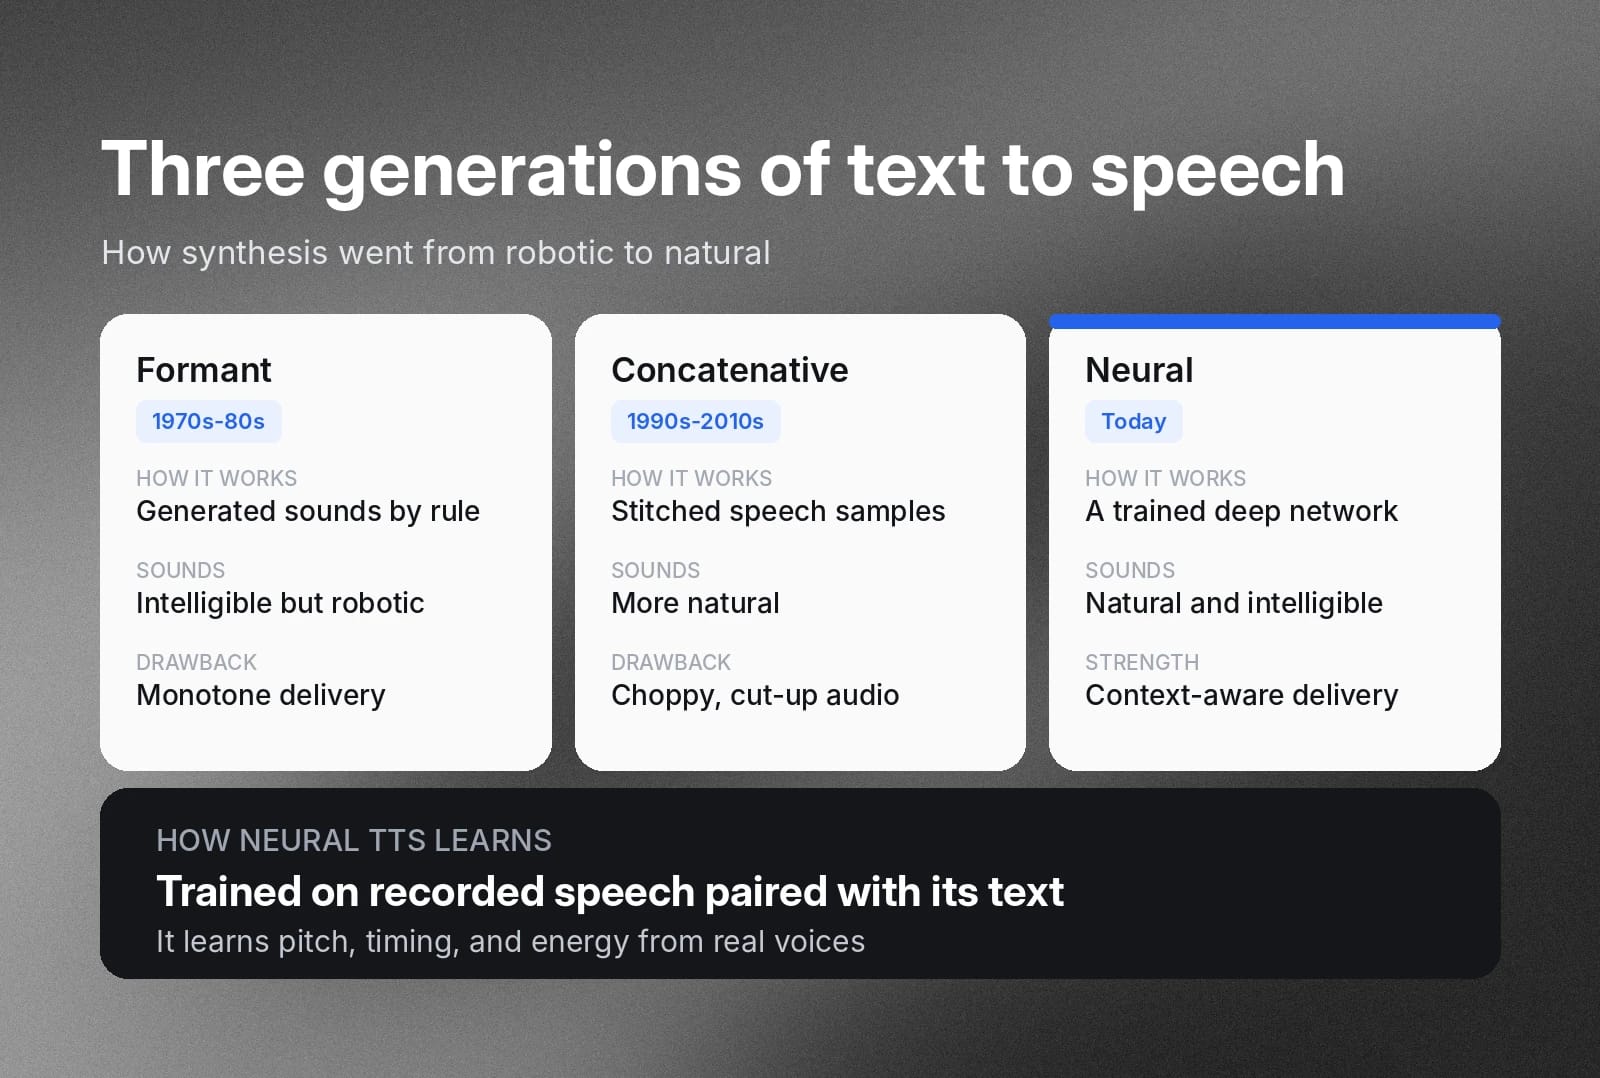
न्यूरल स्पीच सिंथेसिस प्राकृतिक और स्पष्ट आवाज़ बनाने में बेहतरीन है—ये वे दो गुण हैं जिनसे इंजीनियर TTS इंजनों का मूल्यांकन करते हैं। न्यूरल TTS, टेक्स्ट इनपुट से आवाज़ बनाने के लिए डीप न्यूरल नेटवर्क (DNN) को ट्रेन करके काम करता है। DNN को संबंधित टेक्स्ट के साथ जोड़ी गई रिकॉर्ड की हुई आवाज़ की बड़ी मात्रा पर ट्रेन किया जाता है।
न्यूरल स्पीच सिंथेसिस इंजन एंटरप्राइज़-ग्रेड TTS का केवल नवीनतम संस्करण हैं। इनसे पहले कमर्शियल सिंथेसिस तकनीक की दो पीढ़ियां आईं।
1970 और 80 के दशक में फॉर्मेंट सिंथेसिस प्रमुख तरीका था। रनटाइम आउटपुट के लिए मानव आवाज़ के सैंपल लेने के बजाय, यह आवाज़ को मॉडल करने वाली सिंथेटिक ध्वनियां बनाता था। यह समझने योग्य था, लेकिन एकरस और रोबोट जैसा सुनाई देता था.
1990 के दशक से लेकर 2010 के दशक तक कॉनकैटेनेटिव सिंथेसिस प्रमुख रहा और यह पुराने फॉर्मेंट सिस्टम से अधिक प्राकृतिक सुनाई देता था। गणितीय नियमों के आधार पर टोन बनाने के बजाय, ये मानव आवाज़ के छोटे सैंपल को जोड़ते, यानी कॉनकैटेनेट करते थे। ये सिस्टम नॉर्मलाइज़ किए गए टेक्स्ट को ध्वनियों से मिलाने के लिए भाषाई लुकअप टेबल का इस्तेमाल करते थे, फिर एक विशाल लाइब्रेरी या “कॉर्पस” से लिए गए जुड़े हुए स्पीच ऑडियो की छोटी इकाइयां आउटपुट करते थे। फॉर्मेंट इंजन की आवाज़ से अधिक प्राकृतिक होने पर भी, कॉनकैटेनेशन आवाज़ को टूटा-टूटा बना सकता है।
AI वॉइस जनरेटर और टेक्स्ट टू स्पीच में क्या अंतर है?
“AI वॉइस जनरेटर” मार्केटिंग में अक्सर टेक्स्ट टू स्पीच सहित कई तरह की वॉइस तकनीकों के लिए इस्तेमाल किया जाने वाला शब्द है। टेक्स्ट टू स्पीच खास तौर पर उन सिस्टम को कहा जाता है जो लिखे हुए टेक्स्ट को इनपुट के रूप में लेते हैं, उसके अर्थ और प्रोसोडी को मॉडल करते हैं और ऑडियो वेवफ़ॉर्म आउटपुट करते हैं।
AI वॉइस जनरेटर परस्पर जुड़ी वॉइस तकनीकों का एक पूरा इकोसिस्टम हैं, जिसमें TTS और वॉइस डिज़ाइन, वॉइस क्लोनिंग, और वॉइस स्टाइल ट्रांसफ़र जैसे अन्य जनरेटिव सिस्टम शामिल हैं। हालांकि मार्केटिंग में इसे अक्सर टेक्स्ट टू स्पीच के समानार्थी रूप में इस्तेमाल किया जाता है, लेकिन AI वॉइस जनरेटर को जनरेटिव वॉइस टूलिंग की व्यापक श्रेणी के नाम के रूप में समझना बेहतर है, जिसका TTS एक हिस्सा है।
कंटेंट, एक्सेसिबिलिटी और सपोर्ट के लिए टेक्स्ट टू स्पीच का इस्तेमाल कैसे करें
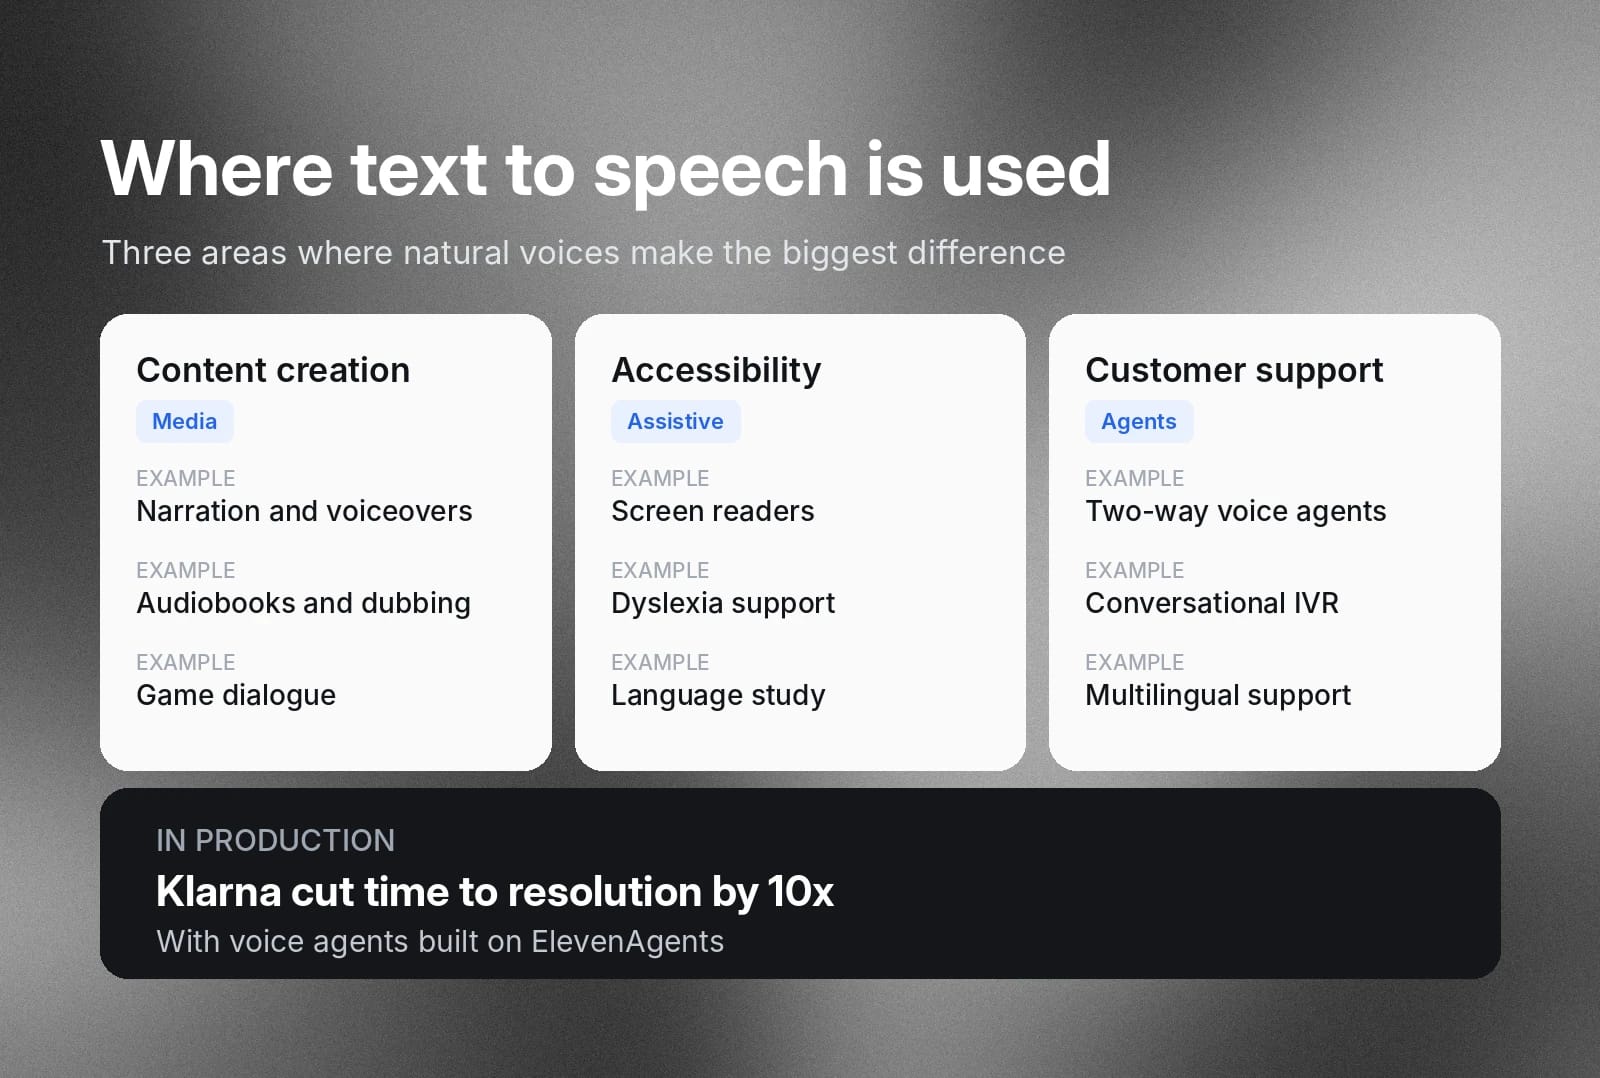
टेक्स्ट टू स्पीच मॉडल दुनिया भर में निजी और व्यावसायिक, दोनों क्षेत्रों के वर्कफ़्लो का अहम हिस्सा बन गए हैं।
टेक्स्ट टू स्पीच के कुछ प्रमुख उपयोग यहां दिए गए हैं।
कंटेंट निर्माण
टेक्स्ट टू स्पीच टूलिंग बड़े पैमाने पर मीडिया प्रोडक्शन की लागत कम करने और नैरेशन व पोस्ट-प्रोडक्शन पिकअप के लिए स्टूडियो में लगने वाला समय घटाने में मदद कर सकती है।
उदाहरण के तौर पर इस्तेमाल:
- नैरेशन
- वॉइसओवर
- डबिंग
- ऑडियोबुक प्रोडक्शन
- गेम डायलॉग
उदाहरण के लिए, TAP ने शैक्षिक कंटेंट को बड़े पैमाने पर पहुंचाने के लिए ElevenLabs TTS का इस्तेमाल किया भारत भर के स्कूलों में।
एक्सेसिबिलिटी
टेक्स्ट टू स्पीच सबसे व्यापक रूप से इस्तेमाल की जाने वाली सहायक तकनीकों में से एक है, क्योंकि इससे लोग लिखित कंटेंट को सुनकर समझ सकते हैं। प्राकृतिक आवाज़ श्रोता की भागीदारी बढ़ाती है और लंबे कंटेंट को सुनते समय मानसिक थकान कम करती है।
सामान्य TTS एक्सेसिबिलिटी उपयोगों में शामिल हैं:
- स्क्रीन रीडर: स्क्रीन रीडर और TTS से पूरे पेज को ज़ोर से पढ़ें।
- डिस्लेक्सिया और साक्षरता सहायता: पढ़ने के सत्रों के साथ TTS आवाज़ जोड़कर पढ़ने का बोझ कम करें।
- कम दृष्टि और अंधापन: स्क्रीन रीडर इंटरफ़ेस एलिमेंट और पेज कंटेंट को ज़ोर से पढ़ते हैं, ताकि लोग स्क्रीन देखे बिना सॉफ़्टवेयर और वेबसाइट नेविगेट कर सकें।
- संज्ञानात्मक और ध्यान संबंधी अंतर:टेक्स्ट सुनने से लंबे दस्तावेज़ पढ़ने का प्रयास कम हो सकता है और ध्यान बनाए रखना आसान होता है।
- सीखना और भाषा अध्ययन: छात्र नए शब्दों का सही उच्चारण सुनते हैं और यात्रा या पढ़ाई के दौरान पाठ्यपुस्तकें सुन सकते हैं।
स्क्रीन रीडर संपूर्ण एक्सेसिबिलिटी टूल हैं, जो स्क्रीन पर मौजूद बटन और मेन्यू समेत हर चीज़ का वर्णन करते हैं। रीड-अलाउड टूल मुख्य रूप से कंटेंट को बोलने पर ध्यान देते हैं, आमतौर पर साथ-साथ चलने वाली हाइलाइटिंग के साथ। इनमें अधिक प्राकृतिक आवाज़ों का फ़ायदा होता है, क्योंकि लोग इन्हें लंबे समय तक इस्तेमाल करते हैं।
कस्टमर सपोर्ट
एजेंटिक इंटरैक्शन कर सकने वाले LLM के साथ जोड़ने पर न्यूरल स्पीच सिंथेसिस उच्च-गुणवत्ता वाला ग्राहक अनुभव दे सकता है। ElevenAgents जैसे प्लेटफ़ॉर्म वॉइस लेयर को स्पीच रिकग्निशन, LLM और कनेक्टेड टूल्स के साथ जोड़ते हैं, जो एजेंट को कॉलर की ज़रूरत समझने और प्राकृतिक आवाज़ में जवाब देने देते हैं।
ElevenAgents से बने एजेंट फ़ोन, वेब, WhatsApp, ईमेल और SMS पर काम करते हैं, ताकि ग्राहक अपनी बात दोहराए बिना अलग-अलग चैनल पर बातचीत जारी रख सकें। उदाहरण के तौर पर इस्तेमाल:
- द्विदिश वॉइस AI एजेंट: नॉलेज बेस से सवालों के जवाब देकर या ग्राहकों को रिफ़ंड या खरीदारी जैसे खास फ़्लो में रूट करके लाइव बातचीत संभालते हैं।
- इंटरैक्टिव वॉइस रिस्पॉन्स (IVR) सिस्टम: पुराने ‘सेल्स के लिए 3 दबाएं’ मेन्यू ट्री को ऐसी बातचीत से बदलें, जिसमें आपके ग्राहक स्वाभाविक रूप से बोल सकें।
- बहुभाषी सपोर्ट: एक ही एजेंट सेटअप से ग्राहकों को उनकी अपनी भाषा में सेवा दें।
उदाहरण के लिए, Klarna ने ElevenAgents के साथ समाधान तक पहुंचने का समय 10 गुना कम किया
टेक्स्ट टू स्पीच इंजन उच्चारण को कैसे नियंत्रित करते हैं?
आधुनिक न्यूरल स्पीच सिंथेसिस इंजन बहुत प्राकृतिक लगने वाली आवाज़ बना सकते हैं, लेकिन मानव भाषा जितनी व्यापक, गहरी और गतिशील चीज़ में एज केस हमेशा रहेंगे। आप अपनी जनरेट की गई आवाज़ में लहजे, स्लैंग या क्षेत्रीय उच्चारण बनाए रखना चाह सकते हैं। हो सकता है कि आप ऐसे उद्योग के लिए ऑडियो बना रहे हों, जहां तकनीकी शब्दों के विशिष्ट उच्चारण होते हैं। या आप बस चाहते हों कि आपके ब्रांड नाम का उच्चारण बहुत खास और एक जैसा हो।
प्रनंसिएशन डिक्शनरी और फोनीम ओवरराइड
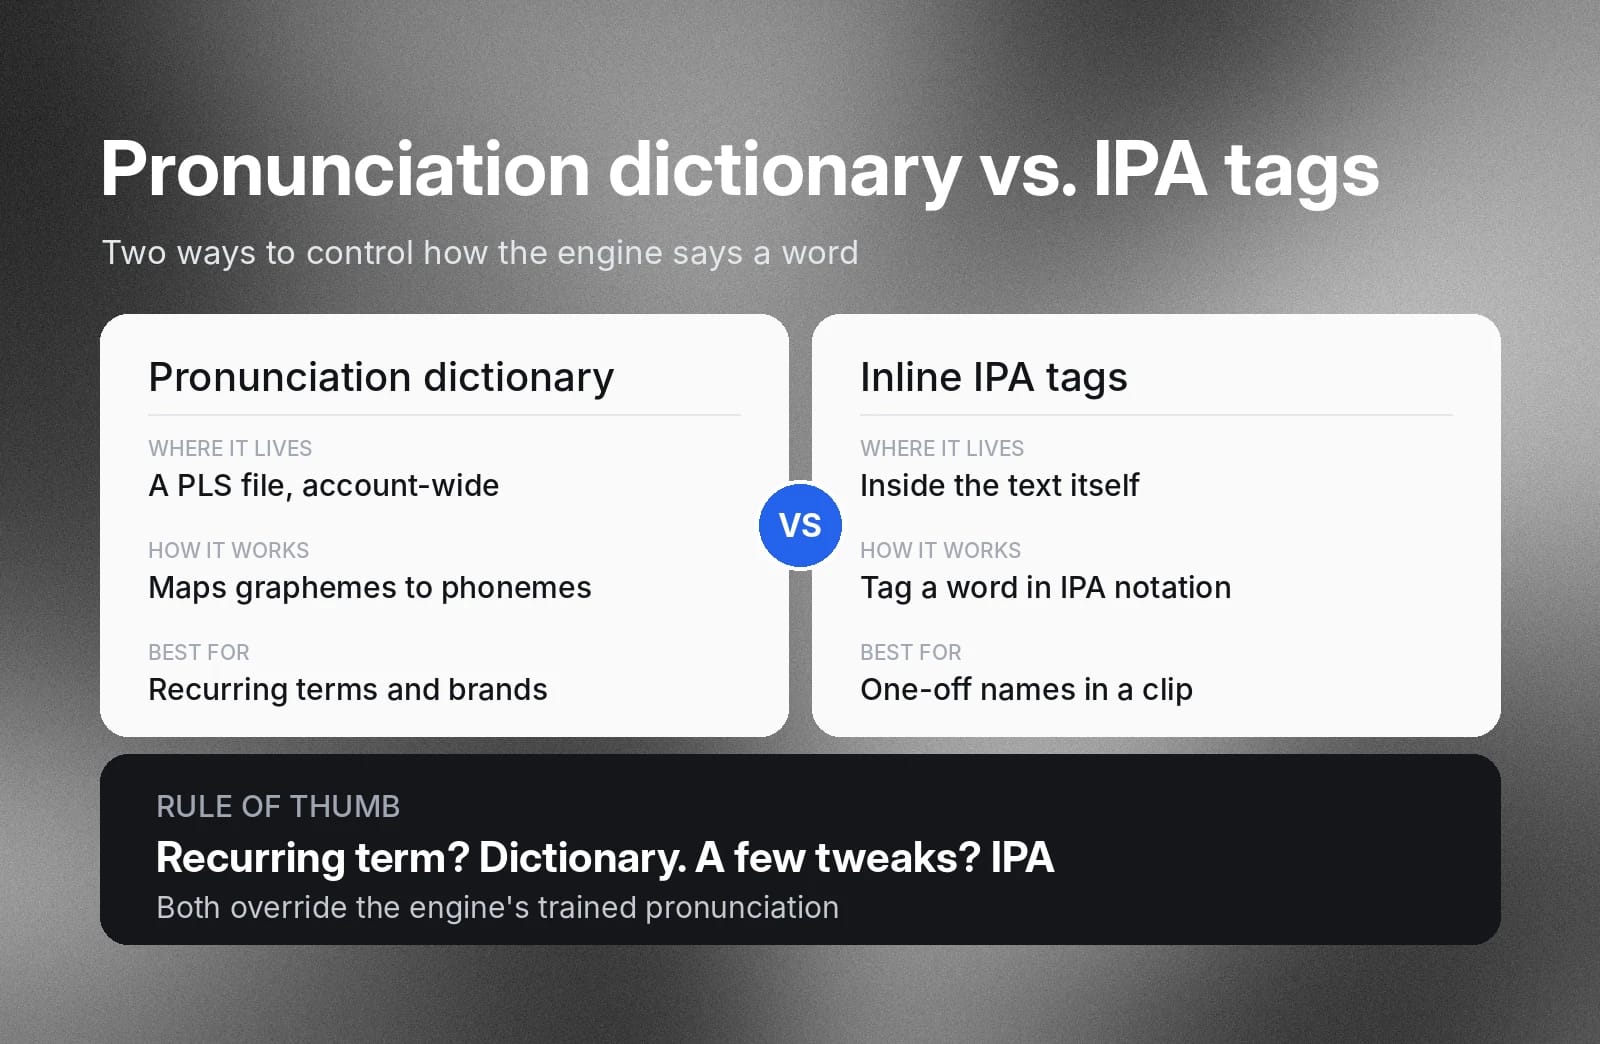
ElevenLabs के ElevenAPI में एक प्रनंसिएशन डिक्शनरी शामिल है, जिससे आप इंजन के बोलने का तरीका कस्टमाइज़ कर सकते हैं। आप W3C-स्टैंडर्ड Pronunciation Lexicon Specification (PLS) फ़ाइल में एक डिक्शनरी बनाते हैं, जो ग्रैफीम (टेक्स्ट में प्रतीक) को फोनीम (ध्वनियों में बांटे गए बोले गए शब्द) से मैप करती है। जब TTS इंजन सूचीबद्ध ग्रैफीम में से किसी एक को पाता है, तो वह अपने प्रशिक्षित उच्चारण को ओवरराइड करता है और डिक्शनरी से फोनेटिक उच्चारण इस्तेमाल करता है।
आप ElevenAPI में प्रनंसिएशन डिक्शनरी बनाना प्रनंसिएशन डिक्शनरी का उपयोग डॉक्यूमेंटेशन में सीख सकते हैं।
नेटिव IPA और फोनेटिक प्रॉम्प्टिंग
कुछ TTS मॉडल टेक्स्ट इनपुट में सीधे एम्बेड किए गए इनलाइन प्रनंसिएशन टैग भी पहचान सकते हैं। इसलिए पूरे अकाउंट के लिए डिक्शनरी बनाने के बजाय, अगर आप सिर्फ़ एक या दो ऑडियो क्लिप में उच्चारण बदलना चाहते हैं, तो आप टेक्स्ट में शब्दों को मानक IPA नोटेशन का इस्तेमाल करके टैग कर सकते हैं। उदाहरण के लिए, अगर आप कोई ऑडियोबुक रिकॉर्ड कर रहे हैं और किसी काल्पनिक किरदार के नाम का खास तरीके से उच्चारण चाहते हैं।
टेक्स्ट टू स्पीच की सामान्य चुनौतियां और उनके समाधान
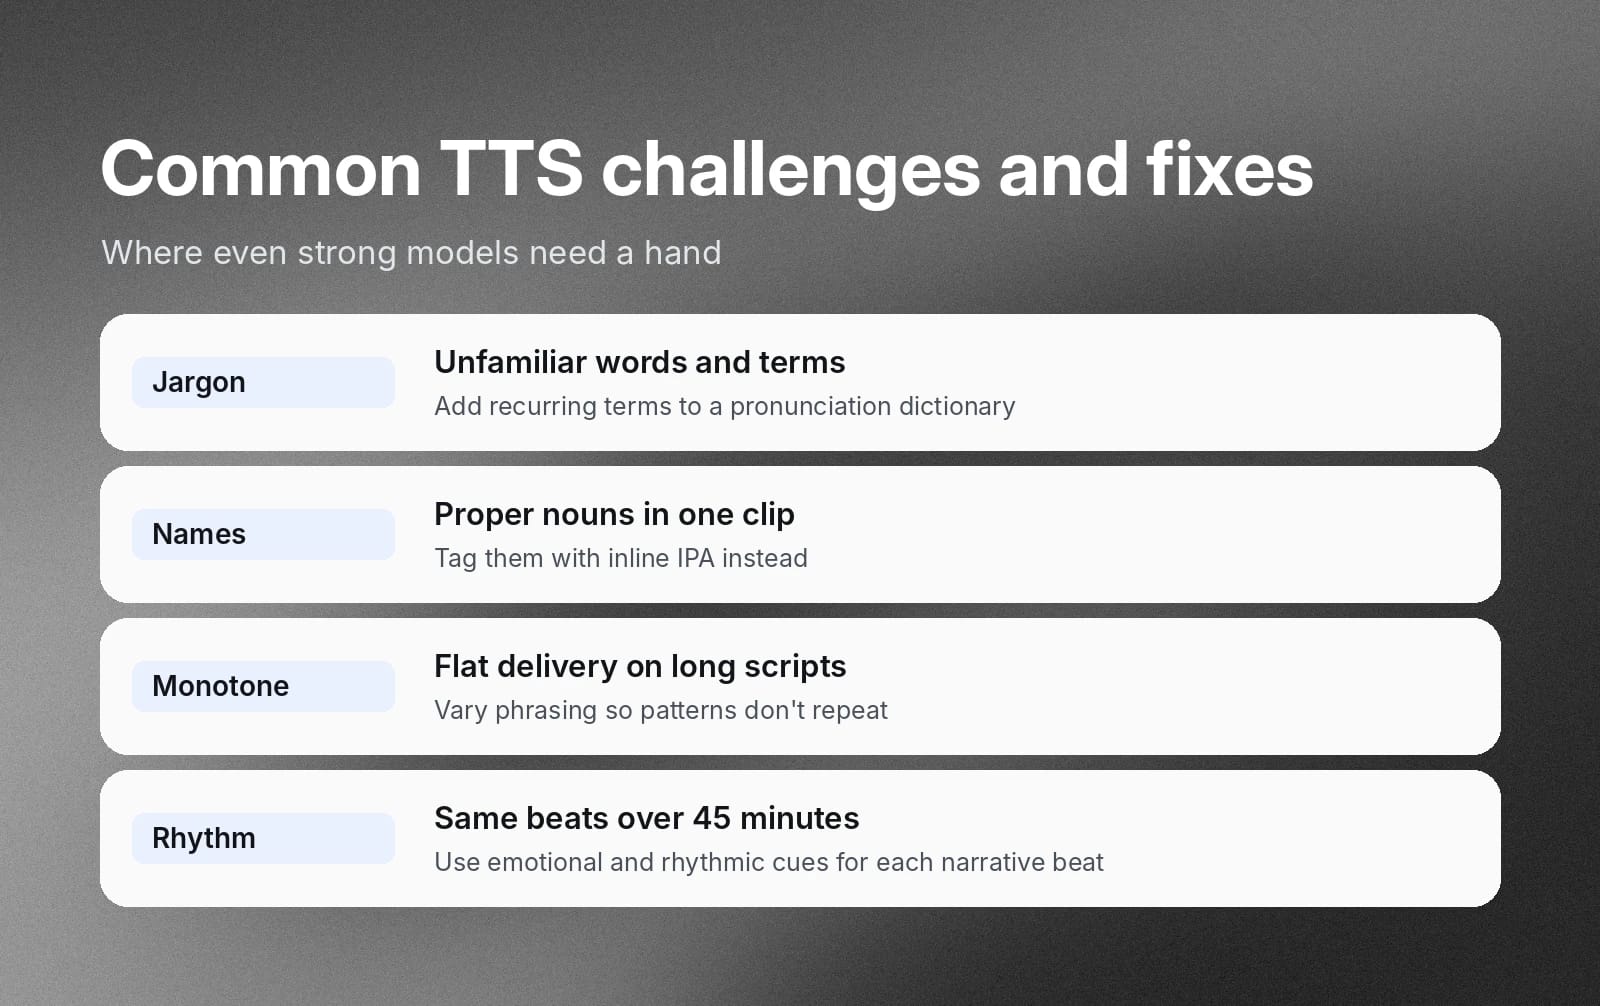
सबसे सक्षम TTS मॉडल भी मानव भाषा की बारीकियों से जूझ सकते हैं। दो सबसे आम समस्याएं हैं नए शब्दों का गलत उच्चारण और एकरस आवाज़। इन्हें ऐसे हल करें।
अपरिचित शब्दों, तकनीकी शब्दावली और व्यक्तिवाचक संज्ञाओं का गलत उच्चारण
TTS इंजन अपने ट्रेनिंग डेटा में ग्रैफीम और फोनीम के मैपिंग के आधार पर अनुमान लगाते हैं कि नॉर्मलाइज़ किए गए टेक्स्ट का उच्चारण कैसा होना चाहिए। वे अपने देखे गए टेक्स्ट और संदर्भ के आधार पर सबसे अच्छा अनुमान लगाते हैं। लेकिन, जैसा कि हमने पिछले सेक्शन में बताया, ऐसे कई एज केस होंगे जहां आप किसी चीज़ का बहुत खास तरीके से उच्चारण चाहते हैं।
इन एज केस के लिए प्रनंसिएशन डिक्शनरी या टारगेटेड IPA टैग आपके सबसे अच्छे टूल हैं। अगर कोई शब्द बार-बार आता है और आप उसका एक जैसा उच्चारण चाहते हैं, तो डिक्शनरी सबसे अच्छा समाधान है। अगर आपको सिर्फ़ कुछ शब्दों में खास बदलाव करने हैं, तो फोनेटिक IPA टैग इस्तेमाल करें।
एकरस डिलीवरी
ये समस्याएं लंबे स्क्रिप्ट को प्रोसेस करते समय अधिक आम होती हैं, जहां एक ही शब्द या वाक्यांश बार-बार बोले जाते हैं। इंजन की सिंथेसाइज़ की गई आवाज़ 10 सेकंड के साउंडबाइट में शानदार लग सकती है, लेकिन 45 मिनट के लेक्चर में वही रटा-रटाया उच्चारण और लय सुनना श्रोता को जल्दी थका देता है।
अपने स्क्रिप्ट में वाक्यांशों में बदलाव करें और समय-समय पर उच्चारण बदलने के लिए फोनेटिक टैग का सोच-समझकर इस्तेमाल करें। स्पीच आउटपुट को अधिक गतिशील बनाएं के लिए भावनात्मक और लय संबंधी संकेत इस्तेमाल करें, ताकि वह कहानी के अलग-अलग बीट्स के साथ ऊपर-नीचे हो।
टेक्स्ट टू स्पीच API के साथ प्राकृतिक वॉइस अनुभव बनाएं
छोटे ऑडियो क्लिप बनाने के लिए हल्के वेब टूल बहुत अच्छे हो सकते हैं, लेकिन वे बड़ी बिज़नेस ज़रूरतों के लिए अच्छी तरह स्केल नहीं होते। अगर आप हर मिनट हज़ारों ग्राहक इंटरैक्शन मैनेज करना चाहते हैं या उच्च-गुणवत्ता वाला लंबा ऑडियो कंटेंट बनाना चाहते हैं, तो आपको अधिक मजबूत TTS टूलिंग की ज़रूरत होगी।
ElevenAPI जैसी टेक्स्ट टू स्पीच API आपको अपने सॉफ़्टवेयर को सीधे न्यूरल स्पीच सिंथेसिस मॉडल से जोड़ने देती है। आप एजेंट या अन्य उद्देश्यों के लिए बड़े पैमाने पर मांग के अनुसार ऑडियो बनाने के लिए REST रिक्वेस्ट या पर्सिस्टेंट WebSockets इस्तेमाल कर सकते हैं।
टेक्स्ट टू स्पीच API रिक्वेस्ट कैसे काम करती है
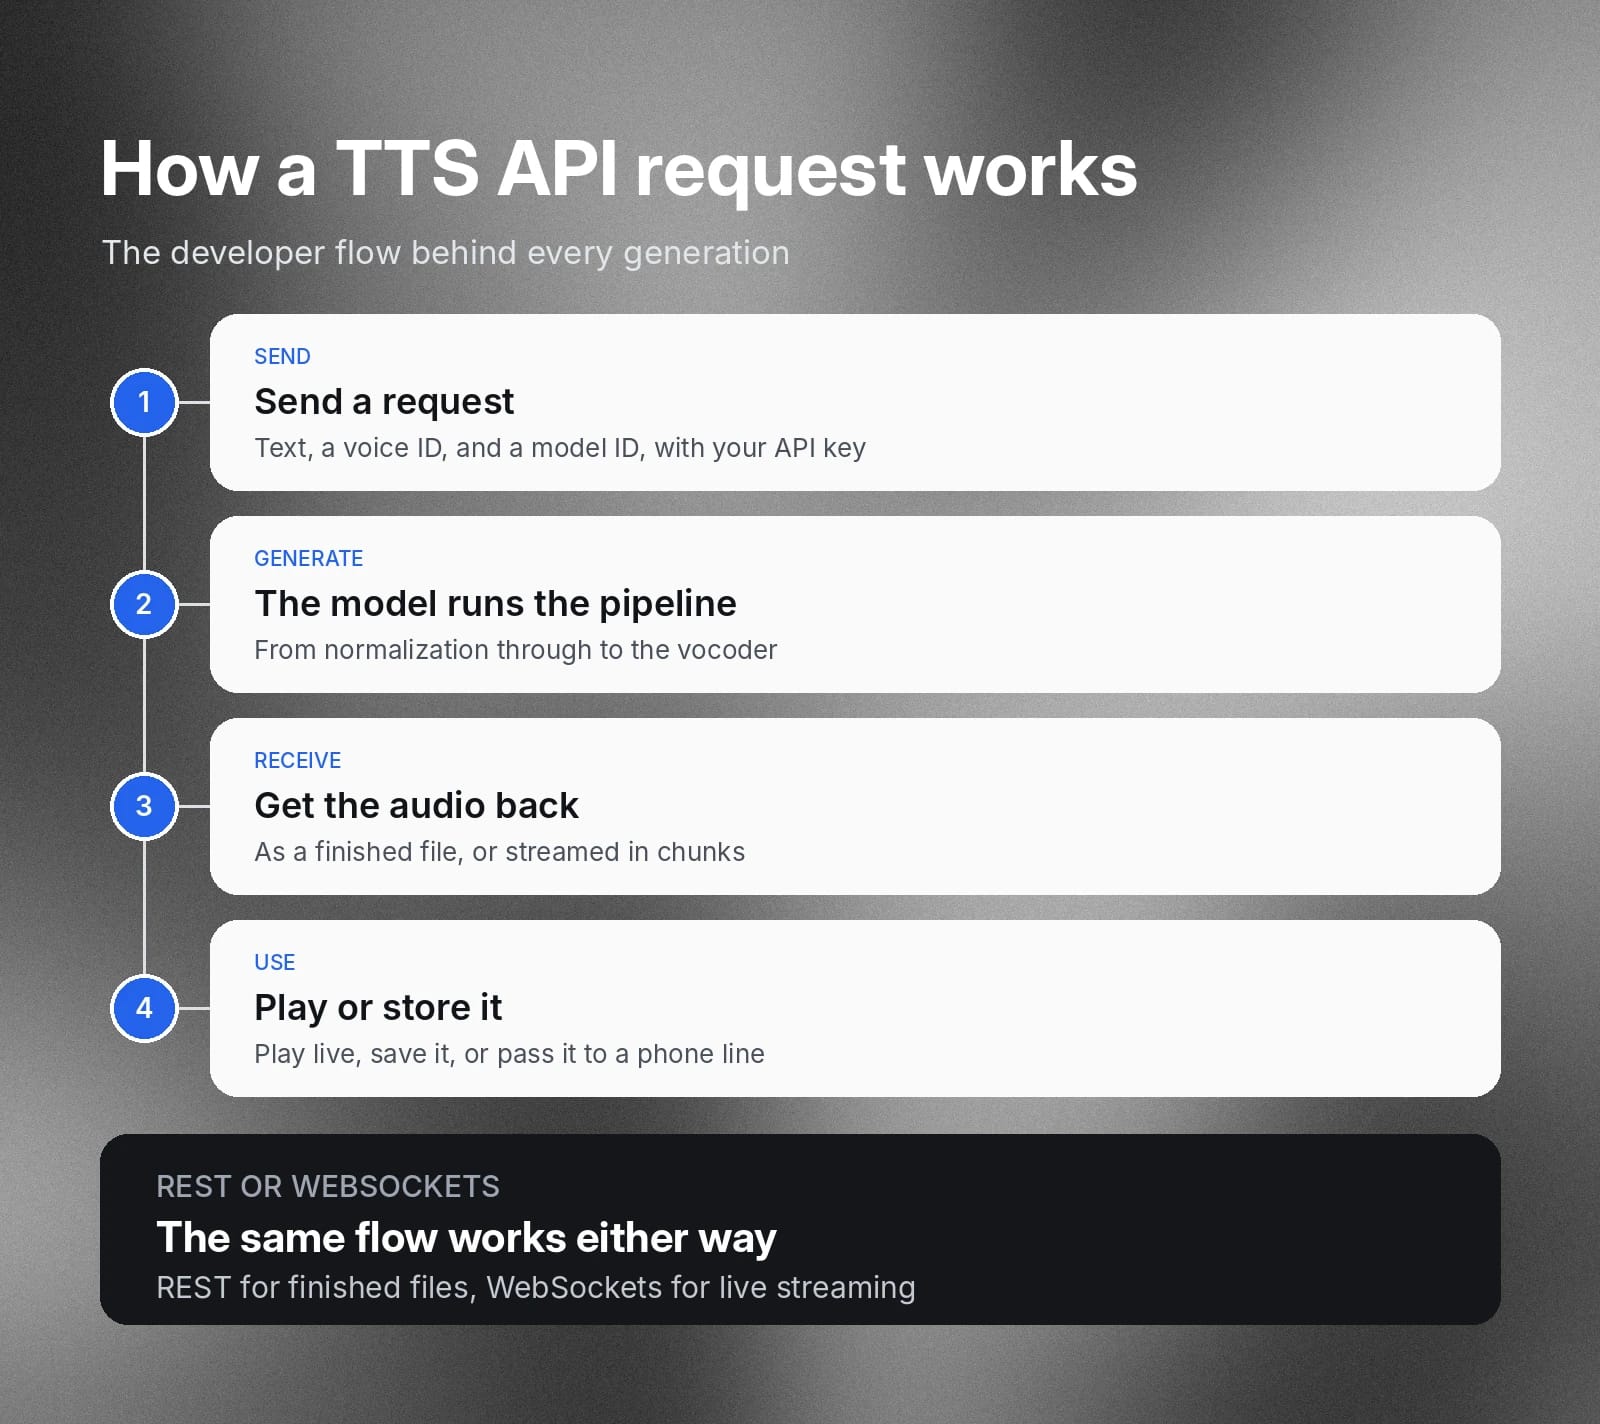
हालांकि मॉडल जटिल हैं, डेवलपर फ़्लो को समझना और उससे शुरुआत करना आसान है।
ElevenAPI का उपयोग करके, आप अपने ऐप्लिकेशन में टेक्स्ट टू स्पीच इंटीग्रेट कुछ ही मिनटों में कर सकते हैं:
- रिक्वेस्ट भेजें: आपका ऐप्लिकेशन आपकी API कुंजी के साथ टेक्स्ट, वॉइस ID और मॉडल ID को API पर भेजता है।
- जनरेट करें: मॉडल ऊपर बताई गई पाइपलाइन चलाता है, नॉर्मलाइज़ेशन से लेकर वोकोडर तक।
- ऑडियो पाएं: API तैयार ऑडियो फ़ाइल लौटाती है या उसे हिस्सों में स्ट्रीम करती है, ताकि जनरेशन पूरी होने से पहले प्लेबैक शुरू हो सके।
- चलाएं या स्टोर करें: आपका ऐप्लिकेशन ऑडियो को लाइव चलाता है, सेव करता है या फ़ोन लाइन जैसे किसी दूसरे सिस्टम को भेजता है।
तैयार फ़ाइलों के लिए REST या लाइव स्ट्रीमिंग के लिए WebSockets इस्तेमाल करने पर यही फ़्लो लागू होता है, और नीचे बताए गए SDK आपके लिए इन कॉल को रैप करते हैं।
डेवलपर के लिए आर्किटेक्चर संबंधी विचार
आपके उपयोग के मामले के आधार पर, आपको प्रोसेसिंग स्पीड, ऑडियो फ़िडेलिटी, नेटवर्क लेटेंसी व प्रोटोकॉल और इंटीग्रेशन क्षमताओं के बीच संतुलन बनाना पड़ सकता है।
लेटेंसी बनाम फ़िडेलिटी
कन्वर्सेशनल एजेंट को प्राकृतिक सुनाने के लिए, आपका लक्ष्य पहले ऑडियो तक लगभग 100ms का समय होना चाहिए, यानी नेटवर्क और TTS इंजन तक लेटेंसी कम से कम हो। यहां ध्यान इस बात पर है कि इस सीमा के भीतर आपके एजेंट के आर्किटेक्चर से कितनी गुणवत्ता का ऑडियो आउटपुट मिल सकता है।
इसके उलट, पॉडकास्ट या लेक्चर जैसे लंबे ऑडियो बनाते समय लेटेंसी कम मायने रखती है। लेटेंसी घटाने के बजाय, आपको उच्च-फ़िडेलिटी आउटपुट को अधिकतम करना चाहिए।
स्ट्रीमिंग प्रोटोकॉल
आपके API कनेक्शन के लिए इस्तेमाल होने वाले प्रोटोकॉल भी लेटेंसी और परफ़ॉर्मेंस को प्रभावित कर सकते हैं। WebSockets असली द्विदिश ऑडियो स्ट्रीमिंग की सुविधा देते हैं, यानी आप पूरी फ़ीड रेंडर होने का इंतज़ार करने के बजाय टेक्स्ट के हिस्सों को एक-एक करके प्रोसेस कर सकते हैं। TTS इंजन बाद के हिस्सों को प्रोसेस करता रहे, तब भी पहले हिस्सों से प्लेबैक शुरू हो सकता है।
SDK
ElevenAPI जैसी एंटरप्राइज़-ग्रेड टेक्स्ट टू स्पीच API, पूरी सॉफ़्टवेयर डेवलपमेंट किट (SDK) Python और TypeScript/JavaScript के लिए, साथ ही REST API भी देती हैं, ताकि आप नया आर्किटेक्चर जल्दी तैयार कर सकें। अपनी डेवलपर टीम के इंटीग्रेशन ओवरहेड को घटाने के लिए इनका उपयोग करें।
टेक्स्ट टू स्पीच के लिए ElevenAPI के साथ शुरुआत करें
एक अग्रणी स्पीच मॉडल से प्राकृतिक TTS सिंथेसिस आपके एजेंट और ऑडियो प्रोडक्शन के लिए वह उच्च-गुणवत्ता वाला ऑडियो आउटपुट देता है, जो श्रोताओं को जोड़े रखता है। चाहे आप ग्राहक वर्कफ़्लो को सपोर्ट करने के लिए उच्च-गुणवत्ता वाला कन्वर्सेशनल एजेंट चाहते हों या अपने ऐप्लिकेशन में TTS बनाना चाहते हों, ElevenLabs के पास समाधान है।
आज ही ElevenAPI, के साथ अपना उच्च-फ़िडेलिटी ऑडियो बनाकर शुरुआत करें या ElevenAgents.
अक्सर पूछे जाने वाले सवाल

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।