
Integración de la API de Texto a Voz: streaming, procesamiento por lotes y reintentos
- Publicado
- Última actualización
EscucharEscucha este artículo
Integrar una API de Texto a Voz es sencillo… una vez que tomas algunas decisiones concretas: qué modo de transferencia usar, cómo elegir un modelo y un formato de salida, cómo hacer streaming, cómo procesar grandes volúmenes sin superar tu límite de concurrencia, cómo almacenar en caché y reintentar para no pagar nunca dos veces por generar el mismo audio y cómo comparar el tiempo hasta el primer byte con otro proveedor.
Para ayudarte a integrar una API de Texto a Voz, hemos desglosado cada una de estas decisiones de arquitectura y qué hacer en cada caso. Esta guía te ayudará a integrar la API de Texto a Voz de ElevenLabs y a escalar, con fragmentos de código que puedes copiar en producción para ponerte en marcha.
Para conocer en profundidad los conceptos mencionados aquí, consulta nuestras guías sobre cómo entender el streaming de audio, cómo optimizar la latencia y la visión general de los modelos de ElevenLabs.
Resumen
- Hay una única ruta de API de Texto a Voz de ElevenLabs a la que puedes acceder de tres formas: conversión por lotes, streaming HTTP y WebSocket stream-input.
- En HTTP, cada solicitud en curso cuenta para tu límite de concurrencia, mientras que en WebSocket solo cuenta la generación activa.
- Limita el paralelismo justo por debajo del límite de tu plan y almacena en caché un hash de cada parámetro que afecte a la salida para no facturar nunca dos veces el mismo texto.
- Reintenta los errores 429 y 5xx con backoff exponencial y jitter completo para reducir el ritmo antes de alcanzar el límite de concurrencia.
Tres formas de integrar la API de Texto a Voz
Hay una única ruta de Texto a Voz, pero la forma de integrarla determina tu latencia, complejidad y coste.
La misma llamada POST /v1/text-to-speech/{voice_id} funciona de tres maneras, y cada una se adapta a una tarea ligeramente distinta. Aquí tienes un desglose de las tres formas de integrar la API de Texto a Voz:
- El procesamiento por lotes (convert) es la integración más sencilla: envías una solicitud y recibes una respuesta de audio. Es la opción menos compleja y tiene el mayor tiempo hasta el primer audio, ya que se sintetiza el clip completo antes de que recibas ningún byte.
- El streaming HTTP (stream) mantiene la misma solicitud, pero divide la respuesta en fragmentos: añades /stream a la ruta, llamas al método stream y el audio se devuelve como una respuesta fragmentada. El código es casi idéntico y la latencia percibida es mucho menor.
- El WebSocket (stream-input) mantiene una conexión persistente: envías texto de forma incremental y recibes fragmentos de audio a medida que se generan. Está diseñado para agentes interactivos y para canalizar la salida de un LLM a voz a medida que produce tokens, antes de terminar la frase.
El streaming no hace que el modelo genere audio más rápido; el tiempo de inferencia no cambia. Lo que cambia es cuándo recibes el primer fragmento: se envía antes de que termine el clip completo, por lo que la espera percibida por el usuario es menor aunque el trabajo total sea el mismo.
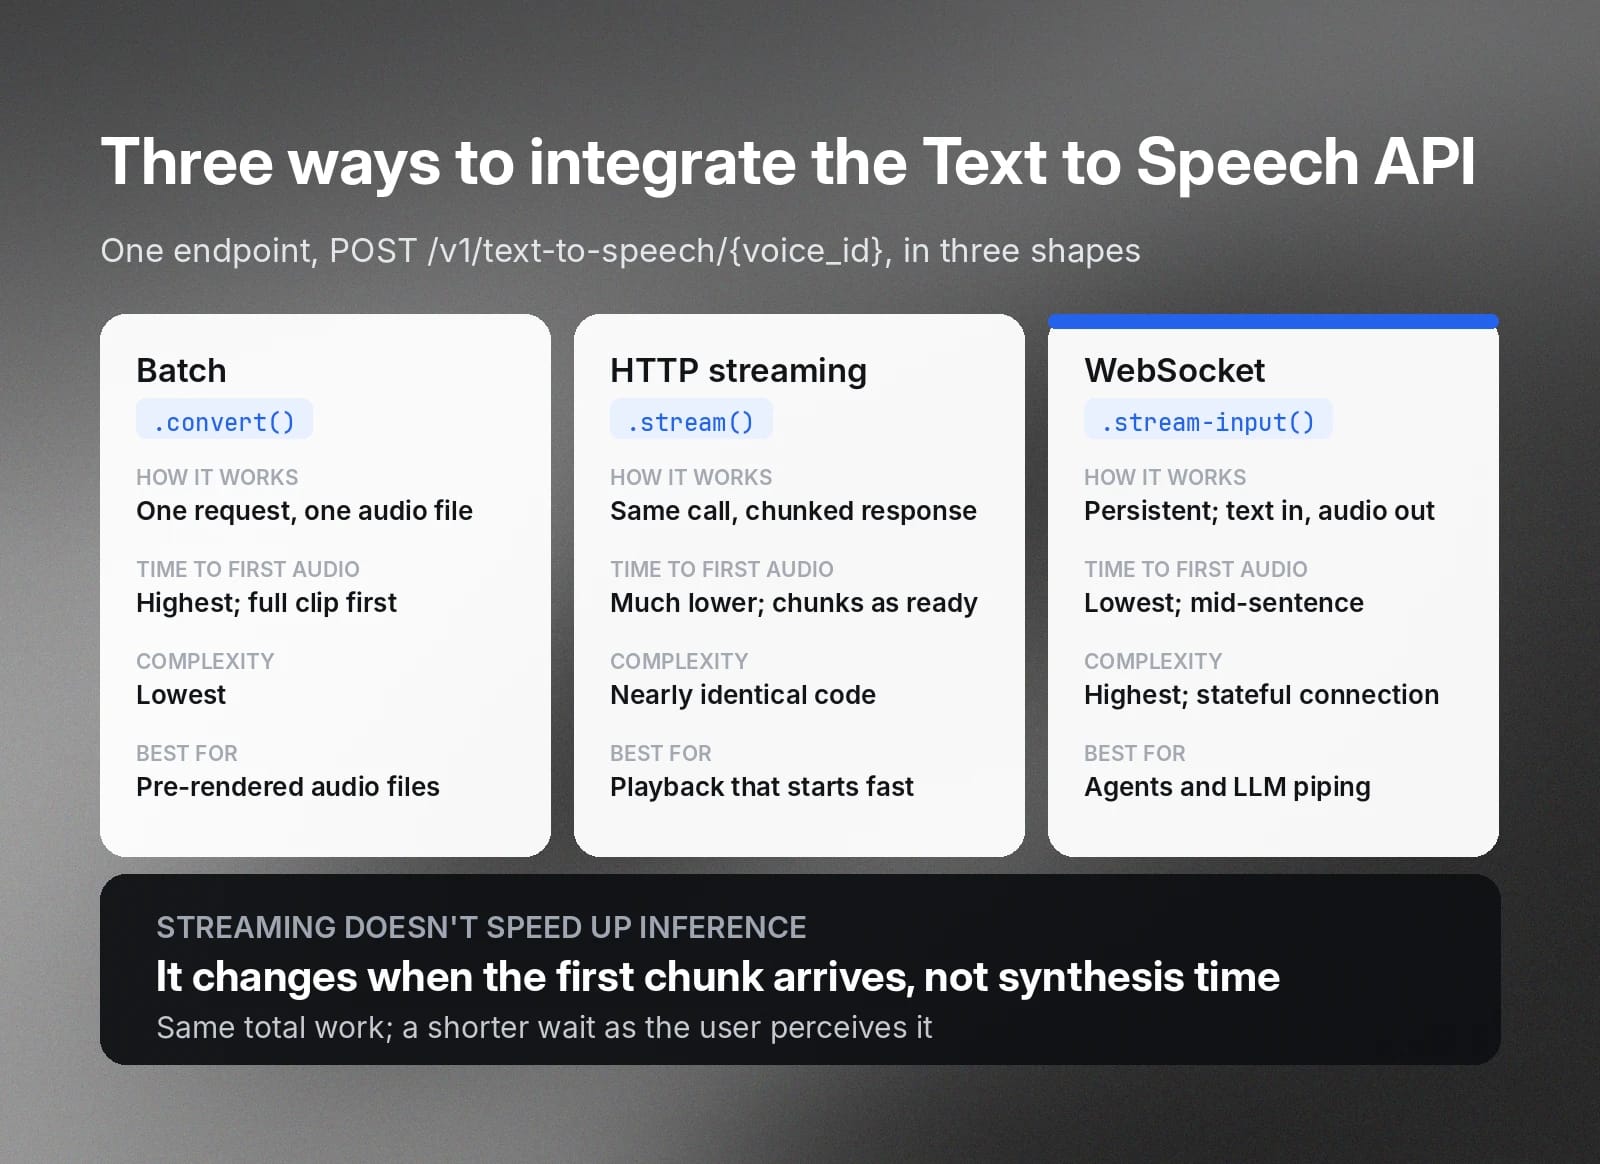
Tabla de decisión: lotes frente a streaming frente a WebSocket
Al decidir entre estos tres métodos, debes tener en cuenta varios factores.
Como guía rápida: elige lotes para la generación sin conexión, streaming HTTP para texto conocido que un usuario está esperando y WebSocket para agentes y conversión de LLM a voz en directo.
La tabla siguiente desglosa las ventajas e inconvenientes en las dimensiones importantes a escala.
En HTTP, ya sea por lotes o streaming, cada solicitud en curso cuenta para el límite de concurrencia de tu plan durante toda su duración. En WebSocket, solo cuenta el tiempo en que el modelo genera audio activamente; un socket abierto pero inactivo prácticamente no cuesta nada.
Para un agente de voz en cascada que mantiene una conexión abierta durante toda una conversación, pero solo genera audio en los turnos del agente, esta diferencia es grande y es el principal motivo para usar WebSockets al crear agentes. El protocolo completo está documentado en la guía de WebSocket de Texto a Voz en tiempo real.
Elegir un modelo y un formato de salida
Dos decisiones determinan el audio que recibes de la integración de tu API de TTS. La primera es el modelo, que define la calidad y la velocidad. La segunda es el formato de salida, que establece el contenedor, la tasa de bits y la frecuencia de muestreo.
Acertar con ambas desde el principio hará que todo lo que viene después, como la latencia y la compatibilidad con telefonía, encaje correctamente.
Modelos
Ofrecemos varios modelos de Texto a Voz. No están ordenados de mejor a peor; cada uno plantea ventajas e inconvenientes distintos.
Como referencia, la cifra de ~75 ms corresponde a la inferencia del modelo en condiciones representativas, sin incluir la latencia de red ni de la aplicación. Aumenta con entradas más largas y bajo carga. Mide siempre desde tu aplicación, no a partir de una cifra de referencia.
Los modelos Flash son más pequeños y usan aproximaciones más agresivas para reducir el tiempo de inferencia. Eleven v4 y Multilingual v2 son modelos más grandes que dedican más tiempo por carácter a producir resultados más ricos.
Para tiempo real o agentes, usa eleven_flash_v2_5; es la opción multilingüe con menor latencia. Para narración, audiolibros o locuciones de marketing, usa eleven_multilingual_v2 si buscas alta fidelidad estable o eleven_v4 si necesitas la máxima expresividad y variedad emocional.
Cuando la pronunciación sea importante, como en números de teléfono, fechas o divisas, normaliza los números tú mismo en tu aplicación antes de que el texto llegue a la API. Escribe la forma hablada que quieras.
Normalizarlo tú mismo mantiene una pronunciación predecible entre modelos y evita depender de valores predeterminados específicos del modelo que podrían cambiar.
Formato de salida
El parámetro output_format controla el contenedor, la frecuencia de muestreo y la tasa de bits del audio que recibes. Los valores que más usarás son:
Ajustes de voz
Los siguientes ajustes controlan cómo se reproduce el habla generada:
- Stability: controla la consistencia frente a la expresividad. Los valores más bajos producen un habla más variada y expresiva, mientras que los más altos producen una entonación más estable y predecible.
- SimilarityBoost: controla en qué medida la salida se ajusta a la voz de referencia.
- Style: exagera el estilo natural de habla de la voz al aumentarlo.
- useSpeakerBoost: mejora el parecido con el hablante original a costa de un pequeño aumento de latencia.
- Speed: ajusta el ritmo de la entonación respecto al valor predeterminado de 1.0.
De estos ajustes, Stability suele tener el mayor impacto en la calidad percibida. Los valores más bajos producen resultados más expresivos pero menos consistentes, mientras que los más altos priorizan la consistencia y la previsibilidad.
Al elegir una voz, la combinación con menor latencia es Flash junto con un clon de voz instantáneo o una voz predeterminada; los clones de voz profesionales suenan muy bien, pero añaden una sobrecarga por generación que debes tener en cuenta.
A lo largo de esta guía, el ID de voz de ejemplo es JBFqnCBsd6RMkjVDRZzb (George).
Integración de streaming (HTTP y WebSocket)
En esta sección abordamos el núcleo práctico de la integración de una API de Texto a Voz. Cubrimos la instalación del SDK, la apertura de un stream y el consumo de audio a medida que llega. La ruta HTTP cubre la mayoría de las reproducciones web y de apps, mientras que la ruta WebSocket cubre agentes y salida de LLM en directo.
Ambas opciones asumen que tienes inicializado el cliente de ElevenLabs que aparece a continuación.
La ruta de streaming abre un stream y consume fragmentos a medida que llegan. voiceId es el primer argumento posicional, seguido de un objeto de opciones con claves camelCase (modelId, outputFormat, voiceSettings):
Para la variante WebSocket, conéctate a wss://api.elevenlabs.io/v1/text-to-speech/{voice_id}/stream-input, envía un primer mensaje con tus ajustes de voz y un espacio inicial; después, envía mensajes de texto a medida que estén disponibles y lee las tramas JSON de respuesta, cuyo campo audio contiene fragmentos codificados en base64.
Procesamiento por lotes y límites de concurrencia para alto rendimiento
La integración de alto rendimiento se rige por la concurrencia, que es el número de solicitudes que generan audio en el mismo instante. Cada plan tiene un límite por familia de modelos.
Cada plan incluye un límite de concurrencia distinto:
- Free: 4 solicitudes Flash simultáneas.
- Starter: 6 solicitudes Flash simultáneas.
- Creator: 10 solicitudes Flash simultáneas.
- Pro: 20 solicitudes Flash simultáneas.
- Scale y Business: 30 solicitudes Flash simultáneas; los límites de Enterprise son personalizados.
Los límites de Multilingual v2 son aproximadamente la mitad de los anteriores.
Un pool limitado reduce este problema al restringir cuántas solicitudes se ejecutan a la vez:
Establece MAX_CONCURRENCY ligeramente por debajo del límite de tu plan, en lugar de exactamente en él. Ese margen absorbe cualquier otro tráfico que comparta la misma clave y te mantiene por debajo del umbral que devuelve un 429.
Límites de caracteres y división de textos largos
Cada modelo limita los caracteres que acepta en una única solicitud. Cualquier integración para contenido largo debe dividir el texto y volver a unir el audio.
Estos son los límites de caracteres por solicitud para cada modelo:
- Flash v2.5: acepta hasta 40.000 caracteres por solicitud.
- Flash v2: acepta hasta 30.000 caracteres por solicitud.
- Multilingual v2: acepta hasta 10.000 caracteres por solicitud.
- Eleven v3: acepta hasta 5.000 caracteres por solicitud.
- Eleven v4: acepta hasta 10.000 caracteres por solicitud.
Cualquier texto más largo debe dividirse en varias solicitudes. Intenta dividirlo en los límites de las frases para que la prosodia se mantenga entre fragmentos.
Genera los fragmentos en orden y concatena el audio. En narraciones largas donde cada fragmento es independiente, las dos piezas encajan directamente: pasa la salida de splitText al pool limitado de arriba y deja que se encargue del resto.
Almacenamiento en caché e idempotencia
La salida de Texto a Voz es lo bastante determinista como para que volver a generar el mismo texto con la misma voz, modelo y ajustes sea un desperdicio. Almacena el resultado en caché con una clave basada en un hash de las entradas que afectan al audio, y esa misma clave sirve como token de idempotencia en los reintentos.
Así puedes hacer ambas cosas.
La regla que hace que esto funcione es que todos los parámetros que cambian el audio deben estar en la clave, incluidos outputFormat y los ajustes de voz. Si lo haces correctamente, la misma clave sirve como token de idempotencia. Cuando un cliente reintenta una solicitud que ya se ha completado, devuelves los bytes almacenados en caché en lugar de generarlos de nuevo.
Gestión de errores y límites de tasa (429)
Un cliente de producción necesita reintentos con backoff y jitter, además de una gestión que varíe según el código de estado, porque algunos fallos merece la pena reintentarlos y otros no.
La tabla siguiente asigna a cada estado la acción adecuada y la sección explica por qué un 429 es un límite flexible, no una barrera infranqueable.
Un 429 no es una barrera infranqueable, y conviene conocer el mecanismo. Cuando superas el límite de concurrencia, las solicitudes se ponen primero en cola por prioridad, lo que normalmente añade unos 50 ms. Solo recibes un 429 si después de eso sigues superando la capacidad.
La respuesta también incluye las cabeceras current-concurrent-requests y maximum-concurrent-requests, que muestran tu margen disponible en tiempo real, para que puedas consultarlas y reducir el ritmo antes de alcanzar el límite.
Si necesitas más margen en lugar de un mejor comportamiento de reintento, mejora tu plan. Clientes Enterprise pueden solicitar límites superiores a través de su gestor de cuenta.
Comparar la latencia y el tiempo hasta el primer byte
La latencia depende de tu región, tu entrada y la carga actual, lo que significa que la única cifra de latencia en la que merece la pena confiar es la que hayas medido en tu propio entorno.
Esta sección te proporciona el tiempo hasta el primer byte (TTFB) para la ruta de streaming de Flash, y está estructurada para que puedas aplicar el mismo banco de pruebas a otro proveedor y compararlos en condiciones idénticas.
Considera esto una metodología, no un resultado publicado. Una sola ejecución no garantiza nada.
Estas son algunas advertencias importantes al comparar la latencia de una integración de API de Texto a Voz:
- Incluye el viaje de ida y vuelta de red: el TTFB depende de tu ubicación y del clúster más cercano del proveedor, así que ejecuta la prueba desde donde suelen ejecutarse tus servidores.
- Descarta una ejecución de calentamiento: la primera solicitud en una conexión fría es más lenta y puede sesgar tus cifras.
- Mantén fijas las entradas: la longitud de la entrada, la voz, el modelo y la carga influyen en el resultado, así que mantenlos idénticos entre proveedores.
- Informa de una distribución: las cifras varían entre ejecuciones, así que publica la mediana y el p95 en lugar de un único valor.
Con todo esto en cuenta, ya estás listo para comparar el rendimiento.
Para comparar con otro proveedor, escribe una función con la misma estructura. Después ejecuta ambas mediante un pequeño runner que descarte una llamada de calentamiento, tome unas 20 muestras temporizadas y espaciadas para que no interfieran entre sí, e informe de la mediana y el p95 en milisegundos.
Una comparación justa depende de controlar las variables.
Ejecuta ambos proveedores desde la misma máquina y red, idealmente desde un servidor de la región en la que realmente despliegas y no desde un portátil con una conexión doméstica. Usa el mismo texto de entrada y mantén el audio corto para que la inferencia del modelo domine la cifra en vez de la duración de generación. Informa de la mediana y el p95 en muchas ejecuciones, porque una sola medición es ruido.
Ten en cuenta que el TTFB en la internet pública incluye entre 20 y 200 ms de viaje de ida y vuelta de red que no tienen nada que ver con el modelo. Damos servicio desde clústeres de Norteamérica, Europa y el Sudeste Asiático, y dirigimos las solicitudes al más cercano; por ello, ubica tu cliente de prueba en consecuencia o estarás comparando principalmente la distancia al centro de datos.
Puntos clave para integrar tu API de Texto a Voz
Una integración de API de Texto a Voz para producción se reduce a unas pocas decisiones importantes.
Si aciertas con ellas, todo lo demás encaja:
- Elige el modelo según la tarea: usa Flash v2.5 para cualquier caso interactivo y un modelo de mayor fidelidad como Multilingual v2 o Eleven v4 para generación sin conexión, donde la latencia importa menos.
- Usa streaming siempre que un usuario esté esperando: usa streaming HTTP para texto conocido y un WebSocket para agentes, para que el tiempo de inactividad no consuma tu presupuesto de concurrencia.
- Limita el paralelismo al límite de tu plan: limita las solicitudes simultáneas justo por debajo del límite de tu plan y almacena en caché un hash de todos los parámetros que afecten a la salida para no facturar nunca dos veces el mismo audio.
- Reintenta 429 y 5xx con backoff exponencial y jitter completo: reduce el ritmo ante errores 429 y 5xx con jitter completo, y consulta las cabeceras de concurrencia para saber lo cerca que estás del límite.
- Divide los textos largos en los límites de las frases: divide en los límites de las frases dentro del límite de caracteres de cada modelo para que la prosodia se mantenga entre fragmentos.
Si quieres profundizar aún más, consulta la guía práctica de streaming, el concepto de streaming de audio, la autenticación y los tokens de un solo uso para el uso del lado cliente.
Crea tu integración de Texto a Voz con ElevenAPI
Después de leer esta guía, tienes todos los patrones que necesitas para una integración de API de Texto a Voz en producción. Con streaming, procesamiento por lotes, almacenamiento en caché, reintentos e incluso comparativas de rendimiento, ya puedes ponerla en funcionamiento.
Empieza por conocer más sobre la API de Texto a Voz o regístrate para hacer hoy tu primera llamada con ElevenAPI.
Preguntas frecuentes sobre la integración de la API de Texto a Voz

Tadas Petra es Developer Relations Engineer y ayuda a desarrolladores a crear con la suite de productos de ElevenLabs. Además, es fundador de Hungrimind, una plataforma de formación para desarrolladores. Antes fue Lead Developer Advocate en Agora e instructor en Zero To Mastery.



