

Dokumentacja ElevenLabs
Poznaj dokumentację i przewodniki po integracji z ElevenLabs
Zacznij z pomocą agenta kodującego. Nie potrzebujesz wcześniej konta ani klucza API.
Wklej to do Claude Code, Cursor lub Codex. Narzędzie zaloguje cię lub utworzy konto, utworzy klucz i doda SDK do projektu.
Zobacz, jak to działa, albo przeczytaj kod źródłowy polecenia onboard, aby sprawdzić, co dokładnie przekazuje twojemu agentowi.
Jak działa ElevenLabs?
ElevenLabs zapewnia infrastrukturę głosową AI: zamianę tekstu na mowę, zamianę mowy na tekst, klonowanie głosu, agentów głosowych i generatywne audio. Możesz korzystać z niej na cztery sposoby, dla różnych odbiorców.
ElevenCreative to aplikacja webowa no-code, w której twórcy, producenci i montażyści generują nałożone głosy, muzykę, dubbing i projekty studyjne bezpośrednio w przeglądarce.
ElevenAgents to platforma do projektowania i obsługi agentów głosowych, z wizualnym kreatorem dla osób nietechnicznych oraz pełną kontrolą programistyczną dla deweloperów.
ElevenAPI udostępnia każdą funkcję przez interfejs REST z oficjalnymi SDK dla Pythona i TypeScript, dzięki czemu deweloperzy mogą osadzać głos we własnych aplikacjach i workflow.
Reception.ai to gotowa do wdrożenia telefoniczna recepcjonistka AI dla małych i średnich firm, która odbiera połączenia, umawia wizyty i zarządza codziennymi zadaniami z jednego panelu.
Wybierz ścieżkę
ElevenCreative
Dowiedz się, jak korzystać z ElevenCreative dzięki przewodnikom krok po kroku
ElevenAgents
Dowiedz się, jak tworzyć, uruchamiać i skalować agentów z ElevenLabs
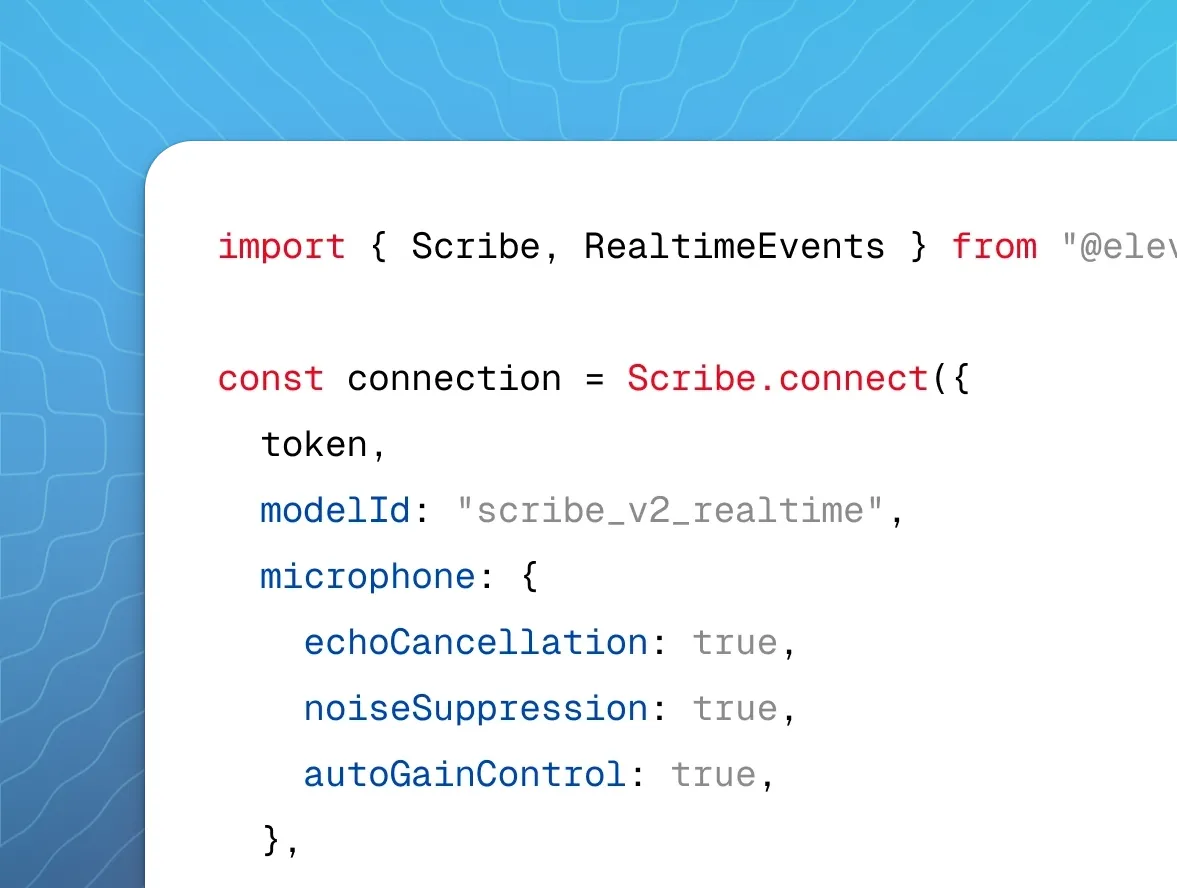
ElevenAPI
Dowiedz się, jak integrować API ElevenLabs na przykładach i w samouczkach
Podstawowe pojęcia
Głosy to persony mowy używane do generowania audio. Każdy głos ma unikalny identyfikator — na przykład JBFqnCBsd6RMkjVDRZzb — który wybierasz w panelu lub przekazujesz w żądaniach API. ElevenLabs udostępnia bibliotekę ponad 10 000 głosów. Możesz też sklonować głos z nagrania audio lub wygenerować go na podstawie opisu tekstowego.
Modele określają jakość, opóźnienie i obsługiwane języki generowanego audio. eleven_v4 tworzy najbardziej ekspresyjne wyniki w ponad 90 językach. eleven_v4_turbo jest przeznaczony do użycia w czasie rzeczywistym, ze średnim opóźnieniem inferencji około 100 ms. Każda funkcja — zamiana mowy na tekst, muzyka, efekty dźwiękowe — ma własny dedykowany model. Zobacz Którego modelu użyć?, aby wybrać odpowiedni.
Jak działa rozliczanie?
Kredyty to wspólna dla wszystkich produktów jednostka zużycia. Zamiana tekstu na mowę kosztuje jeden kredyt za znak tekstu wejściowego. Inne operacje są rozliczane za sekundę przetworzonego audio. Kredyty odnawiają się co miesiąc, a niewykorzystane przechodzą na maksymalnie dwa miesiące. Pełny cennik znajdziesz na stronie cen.
Jeśli chcesz korzystać z API bez miesięcznej subskrypcji, Pay As You Go pozwala opłacić z góry saldo, które jest pobierane podczas korzystania z ElevenLabs — po wykorzystaniu kredytów subskrypcyjnych.
Gotowe do produkcji
Jak szybka jest zamiana tekstu na mowę ElevenLabs?
Eleven Flash v2.5 generuje audio z opóźnieniem inferencji modelu około 75 ms, a Eleven v4 Turbo ze średnim opóźnieniem około 100 ms. Scribe v2 Realtime zwraca częściowe transkrypcje w około 150 ms. Te wartości nie obejmują opóźnień aplikacji i sieci, więc czas, po którym użytkownicy usłyszą audio, będzie dłuższy. Informacje o opóźnieniach wyjaśniają, co obejmują te wartości, a Optymalizacja opóźnień pokazuje, jak skrócić opóźnienie end-to-end.
Jak ElevenLabs radzi sobie ze skalą?
Twój plan określa, ile żądań może być przetwarzanych jednocześnie. Limit współbieżności nie jest limitem równoczesnych rozmów: orientacyjnie limit 5 zwykle obsługuje około 100 jednoczesnych transmisji audio, zależnie od używanych głosów i zastosowania. Plany Enterprise mają wyższe limity. Limity dla poszczególnych planów i wskazówki dotyczące testów obciążeniowych znajdziesz w artykule Współbieżność i priorytet.
Kontrole Enterprise
- Wdrożenia prywatne uruchamiają ElevenAgents, Text to Speech i Speech to Text na twoim własnym koncie chmurowym, więc tekst, audio i transkrypcje pozostają w twojej sieci.
- Rezydencja danych przechowuje dane w odizolowanych środowiskach w UE, Indiach lub Singapurze zamiast w domyślnej lokalizacji w USA. To funkcja Enterprise.
- Obszary robocze centralizują rozliczenia, wspólne zasoby, dostęp zespołu i zarządzanie kluczami API. Obszary robocze Enterprise dodają SSO przez SAML 2.0 lub OIDC oraz dzienniki audytu działań administracyjnych w schemacie OCSF.
Wygeneruj pierwsze audio
Zainstaluj SDK, ustaw klucz API jako zmienną środowiskową i przekonwertuj tekst do pliku MP3 jednym żądaniem. Jeśli wolisz, by konfigurację wykonał twój agent kodujący, zobacz Konfiguracja z agentem kodującym.
Wygeneruj i zapisz audio
Uruchom skrypt poleceniem python example.py lub npx tsx example.mts, a następnie otwórz output.mp3. Aby zrobić to samo w terminalu, użyj CLI ElevenLabs:
Przewodnik startowy ElevenAPI szczegółowo omawia to samo żądanie, w tym konfigurację CLI i odtwarzanie audio przez głośniki.
Co mogę stworzyć z ElevenAgents?
ElevenAgents łączy rozpoznawanie mowy, wybrany przez ciebie LLM, zamianę tekstu na mowę i obsługę zmian tur w jednego agenta głosowego, którego konfigurujesz w panelu lub przez SDK.
- Obsługa klienta: odpowiadaj na pytania na podstawie własnej dokumentacji, dołączając do agenta bazę wiedzy.
- Linie telefoniczne: połącz numer Twilio przez natywną integrację, aby obsługiwać połączenia przychodzące i wychodzące, lub podłącz obecny system telefoniczny przez trunking SIP.
- Kampanie wychodzące: wykonuj wiele połączeń wychodzących naraz dzięki połączeniom wsadowym.
- Strony i aplikacje: osadź agenta obsługującego głos i tekst za pomocą widżetu.
Przewodnik startowy ElevenAgents pokazuje, jak stworzyć pierwszego agenta end-to-end.
Którego modelu użyć?
Zacznij od swojego zastosowania. Każdy identyfikator modelu poniżej to wartość przekazywana jako model_id w żądaniach API.
Więcej zastosowań znajdziesz w artykule Wybór odpowiedniego modelu, a pełne specyfikacje w dokumentacji modeli.
† Bez opóźnień aplikacji i sieci. Zobacz Informacje o opóźnieniach.