Webinar-Zusammenfassung: Geben Sie Ihrem Text-Chatbot eine menschlich klingende Stimme
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Chat-Agenten gehören heute zum Standard-Software-Stack von Unternehmen. Die meisten Unternehmen nutzen einen oder entwickeln einen. Weniger klar ist jedoch, was passiert, wenn Nutzende lieber einfach sprechen möchten.
Stimme verändert die Interaktion auf eine Weise, die über reine Bequemlichkeit hinausgeht. Nutzende drücken Frustration, Dringlichkeit und Verwirrung über ihren Ton aus – Informationen, die Text vollständig verliert. Ein Kunde, der „Meine Bestellung ist noch nicht angekommen“ schreibt, und ein Kunde, der es hörbar besorgt sagt, senden unterschiedliche Signale. Ein Agent, der nur das Transkript lesen kann, arbeitet nur mit der Hälfte der Informationen.
Die Frage, die sich die meisten Teams heute stellen, ist nicht, ob sie Stimme hinzufügen sollen, sondern wie sie das tun können, ohne alles neu aufzubauen, was bereits funktioniert.
Im Live-Workshop: Geben Sie Ihrem Text-Chatbot eine menschlich klingende Stimme erklärten Paul Asjes (Developer Experience), Bhargavi Bhatt (Customer Experience) und Fergal Burnett (Product Marketing, ElevenAPI) die technischen Anforderungen beim Hinzufügen von Stimme zu einem bestehenden Agenten und wie eine funktionierende Integration tatsächlich aussieht.
Warum die Entwicklung mit Stimme schwieriger ist, als sie wirkt
Eine der zentralen Herausforderungen ist das Sprecherwechsel-Management. Menschen erkennen anhand von Intonation, Rhythmus und Kontext, wann jemand zu Ende gesprochen hat. Die Sprachaktivitätserkennung (der Standardansatz) erkennt jedoch nur Stille.
Das Ergebnis ist oft ein System, das jede Pause als Aufforderung zum Sprechen versteht: Es unterbricht, fällt Nutzenden mitten im Gedanken ins Wort und behandelt natürliche Zögern, als wären es vollständige Sätze.
Technisch funktioniert es, im Gespräch jedoch nicht.
Kontext ist die andere Hälfte des Problems. Den Gesprächsverlauf bei jedem Turn an ein LLM zu übergeben, ist notwendig, aber nicht ausreichend. Dieselben Worte können je nach Art des Vortrags etwas anderes bedeuten – „Mir geht es gut“ mit Erleichterung gesagt und „Mir geht es gut“ frustriert gesagt ergeben dasselbe Transkript, aber eine andere Interaktion. Ein Sprachsystem, das diese Dimension ignoriert, klingt immer leicht unpassend – unabhängig davon, wie leistungsstark die einzelnen Modelle sind.
Hinzu kommt der Engineering-Aufwand. Teams, die ihre eigene Sprachorchestrierung betreiben, müssen Logik für Sprecherwechsel, Unterbrechungen und Latenzprofilierung dauerhaft warten. Das ist kein einmaliger Entwicklungsaufwand.
So fügen Sie einem bestehenden Agenten Stimme hinzu
Der sauberste Ansatz ist eine duale WebSocket-Architektur.
- Eine Verbindung besteht zwischen Client und ElevenLabs API, eine weitere zwischen Ihrem Server und der ElevenLabs API.
- Nutzende sprechen in ihr Mikrofon. Das Audio wird an die ElevenLabs API gesendet, dort transkribiert und an Ihren Server weitergeleitet.
- Ihr Server übergibt dem LLM den vollständigen Gesprächsverlauf, den er von der ElevenLabs API erhält. Die gestreamte Antwort wird zur Audiosynthese zurückgesendet.
- Das kann beginnen, bevor das LLM die Generierung abgeschlossen hat – so bleibt die First-Byte-Latenz niedrig.
Der zentrale Integrationspunkt ist die Methode onTranscript , die am Ende jedes Turns ausgelöst wird und den vollständigen Gesprächsverlauf an das LLM übergibt.
Ein contextualUpdate zu Beginn der Sitzung übernimmt alles, was im Textteil des Gesprächs passiert ist, bevor Nutzende zur Stimme wechseln. So kann ein einzelner Agent über beide Modalitäten hinweg arbeiten, ohne Kontext zu verlieren.
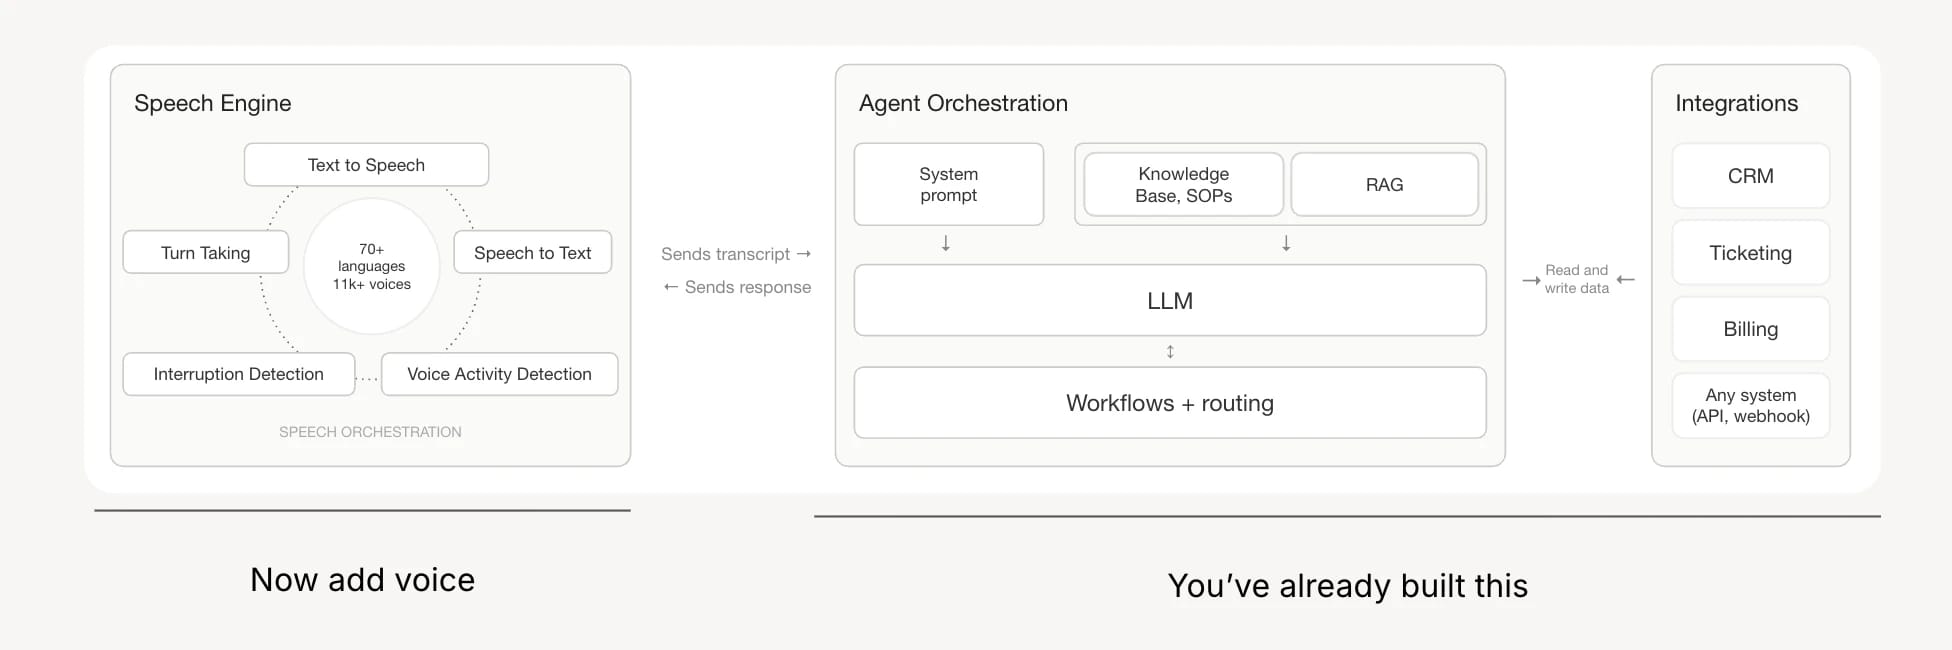
Einige wichtige Punkte für die Entwicklung:
- Die Wahl des LLM ist bei Stimme wichtiger als im Chat. Modelle für tiefgreifendes Reasoning erzeugen Pausen, die im Audio als unnatürliches Zögern wirken – selbst bei höherer Antwortqualität. Für Echtzeit-Stimme gewinnen schnellere Modelle bei der wahrgenommenen Qualität fast immer.
- Für Audio ist WebRTC besser als WebSockets. WebRTC bietet integrierte Echo- und Rauschunterdrückung, was besonders auf Mobilgeräten oder in lauten Umgebungen wichtig ist. Bei WebSockets für den Audiotransport müssen Sie das selbst umsetzen.
- Bitten Sie Nutzende nicht, eine Sprache auszuwählen. Das unterbricht den Gesprächsfluss. Die Sprache in den ersten Sekunden der Sprachaufnahme zu erkennen und festzulegen, ist ein besseres Muster. Es ermöglicht auch einen reibungslosen Wechsel, ohne dass Nutzende etwas tun müssen.
- Trennen Sie Ihr Sprecherwechsel-Modell von Ihrem LLM. Das LLM entscheiden zu lassen, wann Nutzende zu Ende gesprochen haben, erhöht bei jedem Turn Latenz und Kosten. Ein dediziertes Sprecherwechsel-Modell erledigt das schneller und genauer und sollte als eigene Komponente in der Architektur behandelt werden.
Wie viel Infrastruktur Sie selbst betreiben sollten
Die richtige Antwort hängt davon ab, was bereits vorhanden ist. Wenn Sie einen funktionierenden Chat-Agenten haben, ist das Hinzufügen einer Sprachschicht – bei unverändertem LLM, Orchestrierung und Geschäftslogik – meist der schnellste Weg mit dem geringsten Risiko.
Sie bauen nichts neu auf. Sie ergänzen etwas, das bereits funktioniert, um eine Audiooberfläche.
Wenn die Anforderungen Telefonie, Verwaltung von Bereitstellungskanälen, integrierte Tests und Analysen umfassen, ist es sinnvoll, mehr vom Stack einer Voice-Agent-Plattform zu überlassen. Die beiden Ansätze schließen sich nicht aus: Teams können mit einer schlanken Sprachschicht beginnen und Plattformfunktionen ergänzen, wenn der Anwendungsfall reift.
Demo: Stimme zu einem bestehenden Chatbot hinzufügen
Diese Demo zeigt eine Person, die sich mitten in einem Gespräch mit einem textbasierten Chatbot für Reiseplanung befindet und nach Empfehlungen für Stadtviertel und Essen für eine Reise nach Japan fragt.
Das haben wir behandelt:
- Der Chatbot wurde um eine Sprachschicht erweitert, ohne Änderungen am zugrunde liegenden Agenten.
- Die Person wechselte mitten im Gespräch vom Tippen zum Sprechen – der Agent behielt den vollständigen Kontext über beide Modalitäten hinweg.
- Die Person sprach Niederländisch; der Agent erkannte den Sprachwechsel automatisch.
- Als der Agent unterbrochen und mitten im Satz gebeten wurde, wieder zu Englisch zu wechseln, tat er das – und beendete die Antwort ungefragt mit einem leichten niederländischen Akzent.
- Während des gesamten Gesprächs ermöglichte die Unterbrechungserkennung der Person, dem Agenten auf natürliche Weise ins Wort zu fallen, ohne dass er seinen Turn beendete.
Warum das wichtig ist:
Die Demo zeigte keinen speziell entwickelten Voice-Agenten. Sie zeigte einen bereits funktionierenden Text-Agenten mit einer ergänzten Sprachschicht. Kontextverarbeitung, Spracherkennung und Verhalten bei Unterbrechungen kamen alle aus der Sprachschicht – der zugrunde liegende Text-Agent blieb unverändert.
Die vollständige Sitzung ansehen
Sehen Sie sich das vollständige Webinar hier an.
Paul ist Teil des Developer Growth Teams bei ElevenLabs in Valencia, Spanien. Er arbeitet als Developer Experience Engineer mit Schwerpunkt auf Advocacy und Tools für die Plattform. Vor ElevenLabs leitete er Developer Relations bei Stripe, war für Developer Experience bei WorkOS zuständig und entwickelte mehrere Jahre Full-Stack-Webanwendungen sowie Entwickler-Tools.