Stream entwickelt multimodale KI-Agenten mit ElevenLabs
- Verfasst von
- Fergal Burnett Small
- Veröffentlicht
AnhörenArtikel anhören
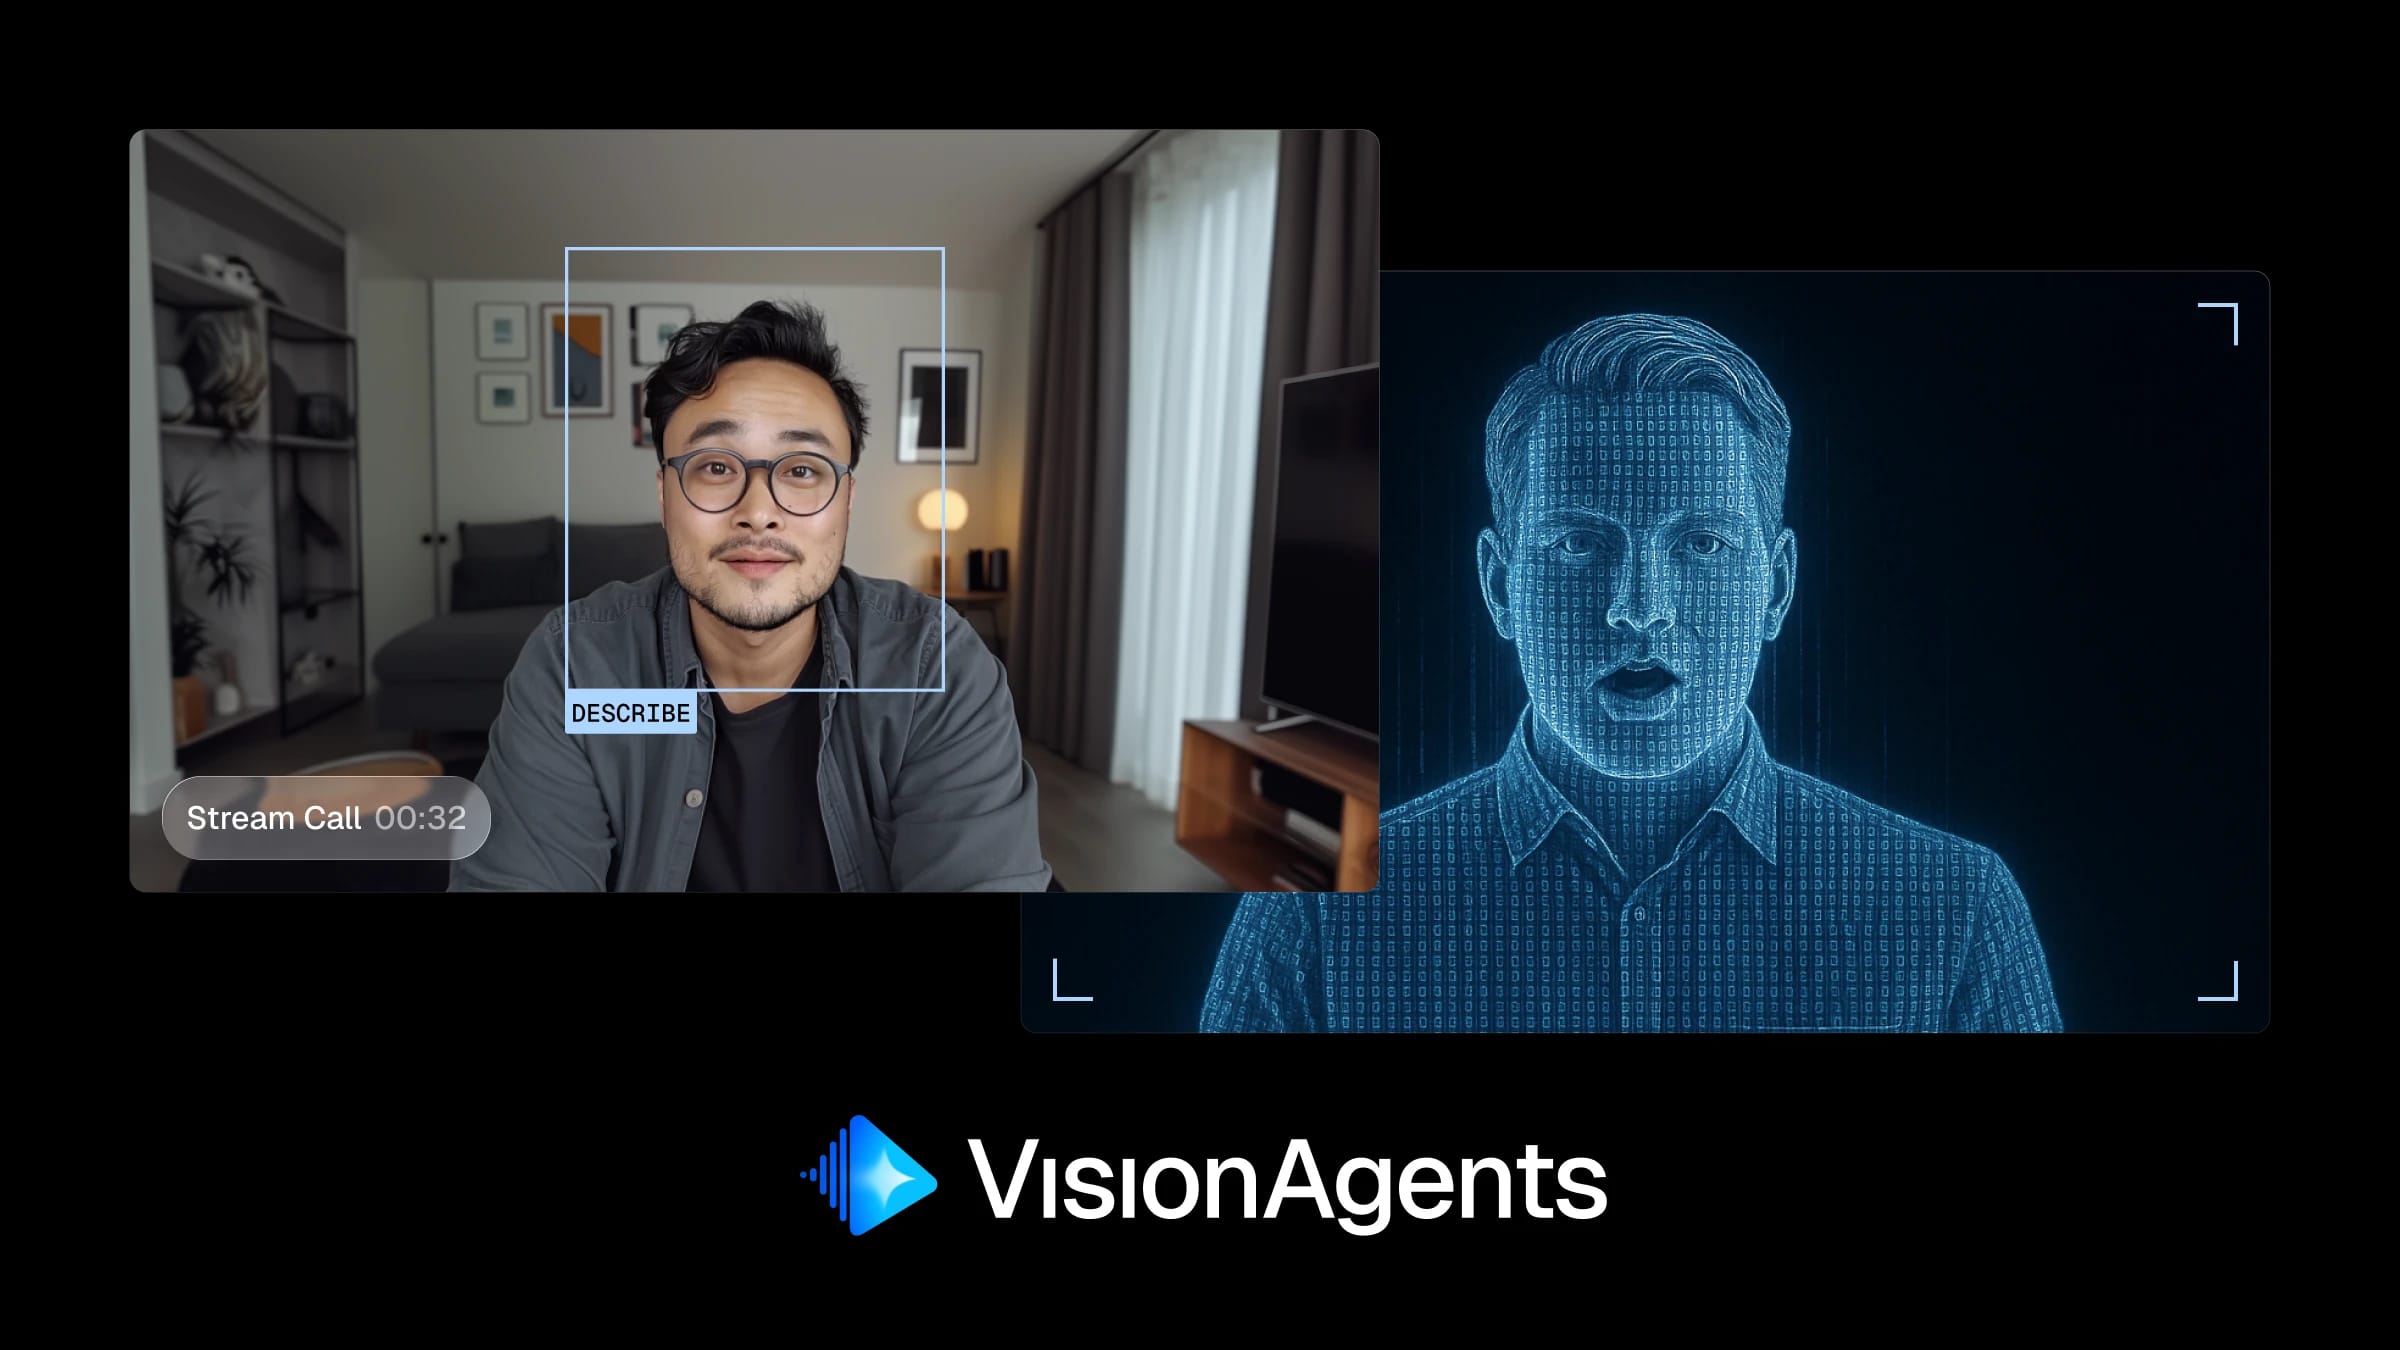
Stream hat Vision Agents vorgestellt – ein Open-Source-Framework, mit dem Entwickler multimodale KI-Erlebnisse mit geringer Latenz entwickeln können, die Echtzeitvideo, Audio und Konversation verbinden. Das Framework integriert ElevenLabs Text to Speech, um ausdrucksstarke, reaktionsschnelle Stimmen bereitzustellen, die eine nahtlose Interaktion zwischen Nutzern und KI-Systemen ermöglichen.
Multimodale Agenten in Echtzeit ermöglichen
Vision Agents gibt KI die Fähigkeit, in Echtzeit zu sehen, zu hören und zu reagieren. Das Framework basiert auf Streams Video- und Audio-SDKs und bietet Entwicklern eine Grundlage mit geringer Latenz, um multimodale Agentenerlebnisse zu prototypisieren und bereitzustellen.
Bei der Bewertung von Text-to-Speech-Anbietern entschied sich Stream aufgrund der marktführenden Qualität und einfachen Integration für ElevenLabs. ElevenLabs ist jetzt die primäre Sprachoption für Streams Nutzer.
„Mit ElevenLabs konnten wir leistungsstarke Text-to-Speech-Funktionen schnell und einfach in unser SDK integrieren. So können Agents in Echtzeit mit ausdrucksstarken Stimmen auf Nutzerfragen oder auf das reagieren, was sie sehen.“ – Neevash Ramdial, Director of Marketing, Stream
Schnelle, zuverlässige und entwicklerfreundliche Integration
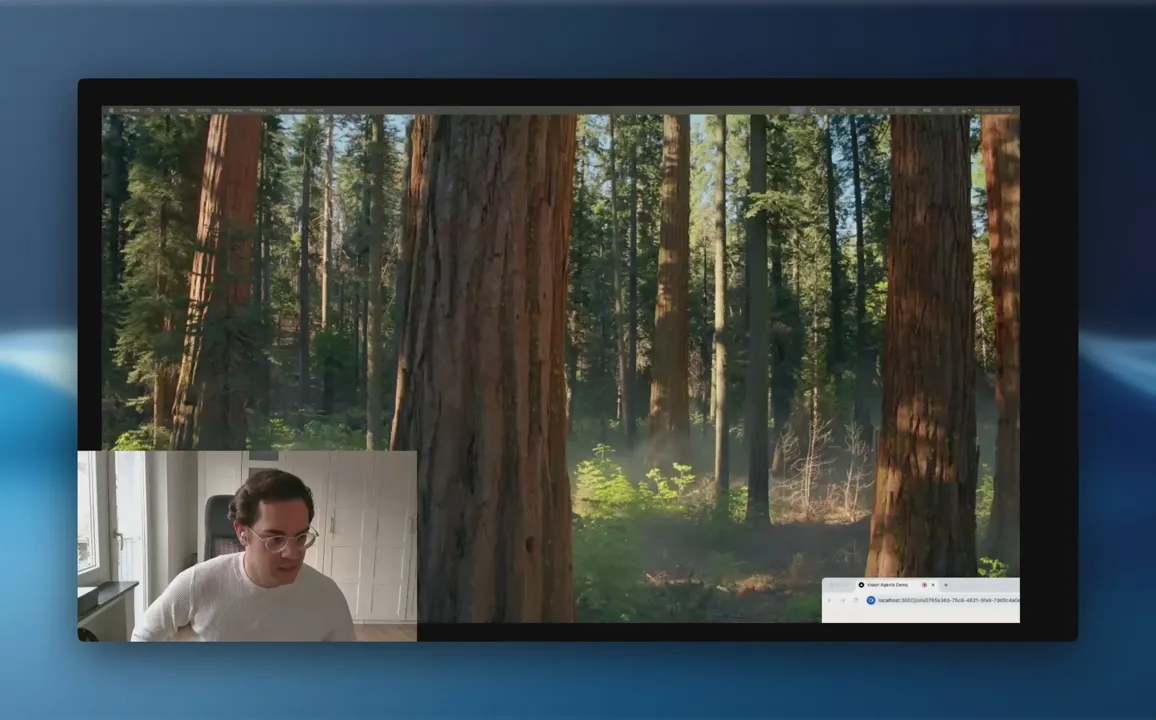
Stream integrierte ElevenLabs innerhalb weniger Tage in die gesamte Codebasis. Entwickler können damit ihren Vision Agents mit minimaler Konfiguration lebensechte Sprachausgabe hinzufügen. Die Integration bietet jetzt:
- 10-mal schnellere Einrichtung – Die Vorintegration mit ElevenLabs reduziert die Einrichtungszeit für Sprache von 400 auf nur 40 Codezeilen.
- Leistung mit geringer Latenz – Die schnelle Stimmgenerierung von ElevenLabs sorgt in Kombination mit Streams globalem Edge-Netzwerk für Reaktionsfähigkeit, die natürlich und menschlich wirkt.
- Skalierbares Entwicklererlebnis – Die SDKs von Stream vereinfachen das Erstellen, Testen und Bereitstellen multimodaler Agenten.
Die Zukunft multimodaler KI gestalten
Streams Vision Agents zeigen, wie ElevenLabs-Modelle die Möglichkeiten multimodaler KI erweitern. Durch die Kombination visuellen Verständnisses mit Text to Speech können Entwickler Agenten erstellen, die nicht nur sehen, sondern auch mit nahezu menschlicher Sprachgewandtheit sprechen und zuhören.
Möchten Sie mit Text to Speech entwickeln? Kontaktieren Sie uns hier.
Fergal arbeitet im Growth-Team und bringt unsere Forschung und Produkte zu den Nutzerinnen und Nutzern.