Eleven Realtime: Natürliche Sprachagenten einfacher entwickeln
- Verfasst von
- Min Kim
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Einen natürlich klingenden Sprachagenten zu entwickeln, erfordert heute viele Entscheidungen. Sie müssen einzelne Komponenten wie Spracherkennung, Spracherkennung bei Sprachaktivität, Sprecherwechsel, das zugrunde liegende LLM und Text to Speech auswählen. Diesen Stack zu entwickeln, ist ein Projekt für sich. Damit alle Komponenten gut zusammenarbeiten, sind zusätzliche Tests und Optimierungen nötig.
Eleven Realtime ist eine neue Klasse von Speech to Speech-Modellen, die diese Hürden beseitigt. Jedes Modell ist ein vollständiger Sprachagent, optimiert für unterschiedliche Anwendungsfälle. Beide unterstützen mehr als 90 Sprachen und können jede der über 17.000 Stimmen in der ElevenLabs-Bibliothek nutzen:
Heute veröffentlichen wir:
- Eleven Realtime v1 Mini für natürliche Gespräche zu niedrigen Kosten. Die beste Wahl für KI-Assistenten, Lehrkräfte und interaktive Charaktere. Für die meisten Anwendungsfälle ausreichend.
- Eleven Realtime v1 Max für komplexe Aufgaben. Ideal für Kundensupport, Lead-Qualifizierung und mehrstufige Workflows, bei denen der Agent einem Prozess folgen und einzelne Schritte durchdenken muss.
Warum wir Realtime-Modelle entwickelt haben
Sie sollten kein Konfigurationsexperte werden müssen, um einen natürlich klingenden Sprachagenten zu entwickeln. Damit sich ein Agent richtig anfühlt und klingt, sind viele kleine, nuancierte Entscheidungen nötig: etwa wie lange er nach einer Pause vor der Antwort warten soll, wie er reagiert, wenn Nutzer ihn unterbrechen, und wie Stimme, Prompts und Modell zusammenwirken. In ElevenAgents können Sie all diese Einstellungen anpassen.
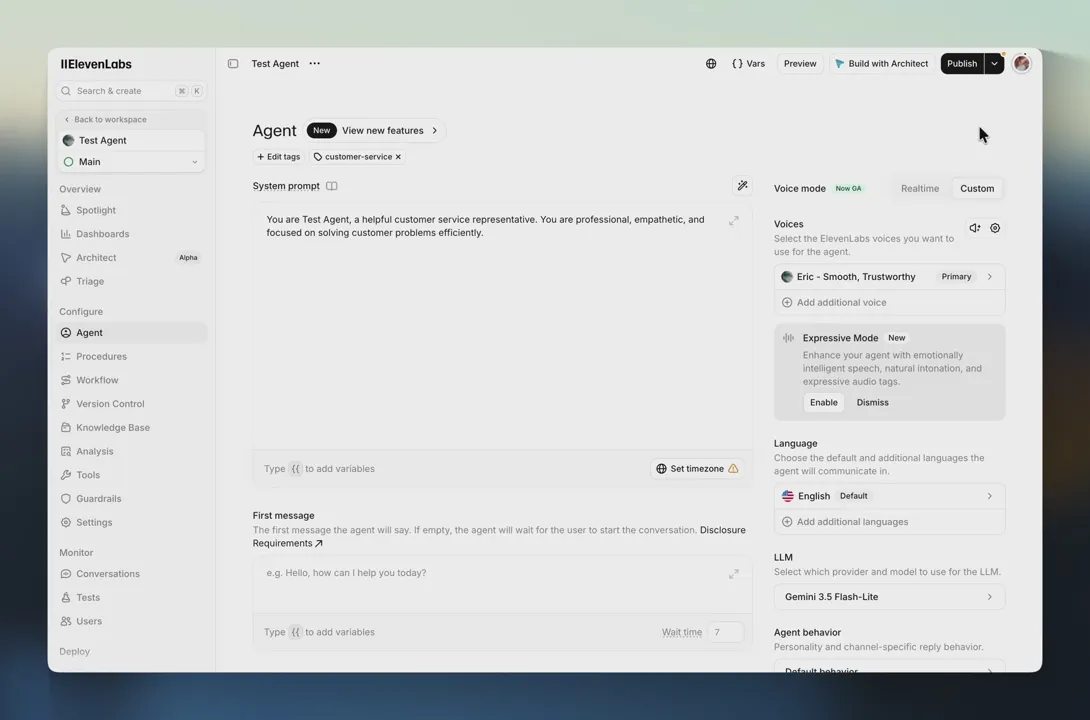
Dasselbe gilt für Entwickler, die bereits eine Realtime API nutzen. Unsere API ist mit der Realtime API von OpenAI kompatibel. Um Eleven Realtime zu testen, müssen Sie daher nur den Endpoint und Modellnamen in Ihrem bestehenden Code ändern.
Auf kaskadierter Architektur aufgebaut
Eleven Realtime basiert auf einer kaskadierten Architektur aus den oben beschriebenen Komponenten, die Ende zu Ende optimiert ist. Wir nennen sie Speech to Speech-Modelle, denn genau das erhalten Sie: Audio rein, Audio raus, eine Modell-ID und ein System, das auf denselben Leaderboards wie Fusion- und Duplex-Modelle gemessen werden kann.
Fusion-Modelle setzten zunächst den Maßstab dafür, wie natürlich sich ein Sprachagent anfühlen kann. Eine kaskadierte Architektur bedeutete dagegen höhere Latenz bei jeder Übergabe und Komponenten, die nie aufeinander abgestimmt wurden. Realtime beseitigt diesen Kompromiss. Die Optimierung, die zuvor Ihr Projekt war, ist bereits erledigt.
Die kaskadierte Architektur bietet auch praktische Vorteile im Produktionseinsatz, weil jeder Schritt Text erzeugt. Sie sehen, was der Agent gehört hat und was er sagen wollte. So können Sie ein falsch verstandenes Wort von einer falschen Entscheidung unterscheiden. Dieser Text ermöglicht es ElevenAgents auch, Schutzmechanismen und die Schwärzung personenbezogener Daten auf einen Realtime-Agenten anzuwenden.
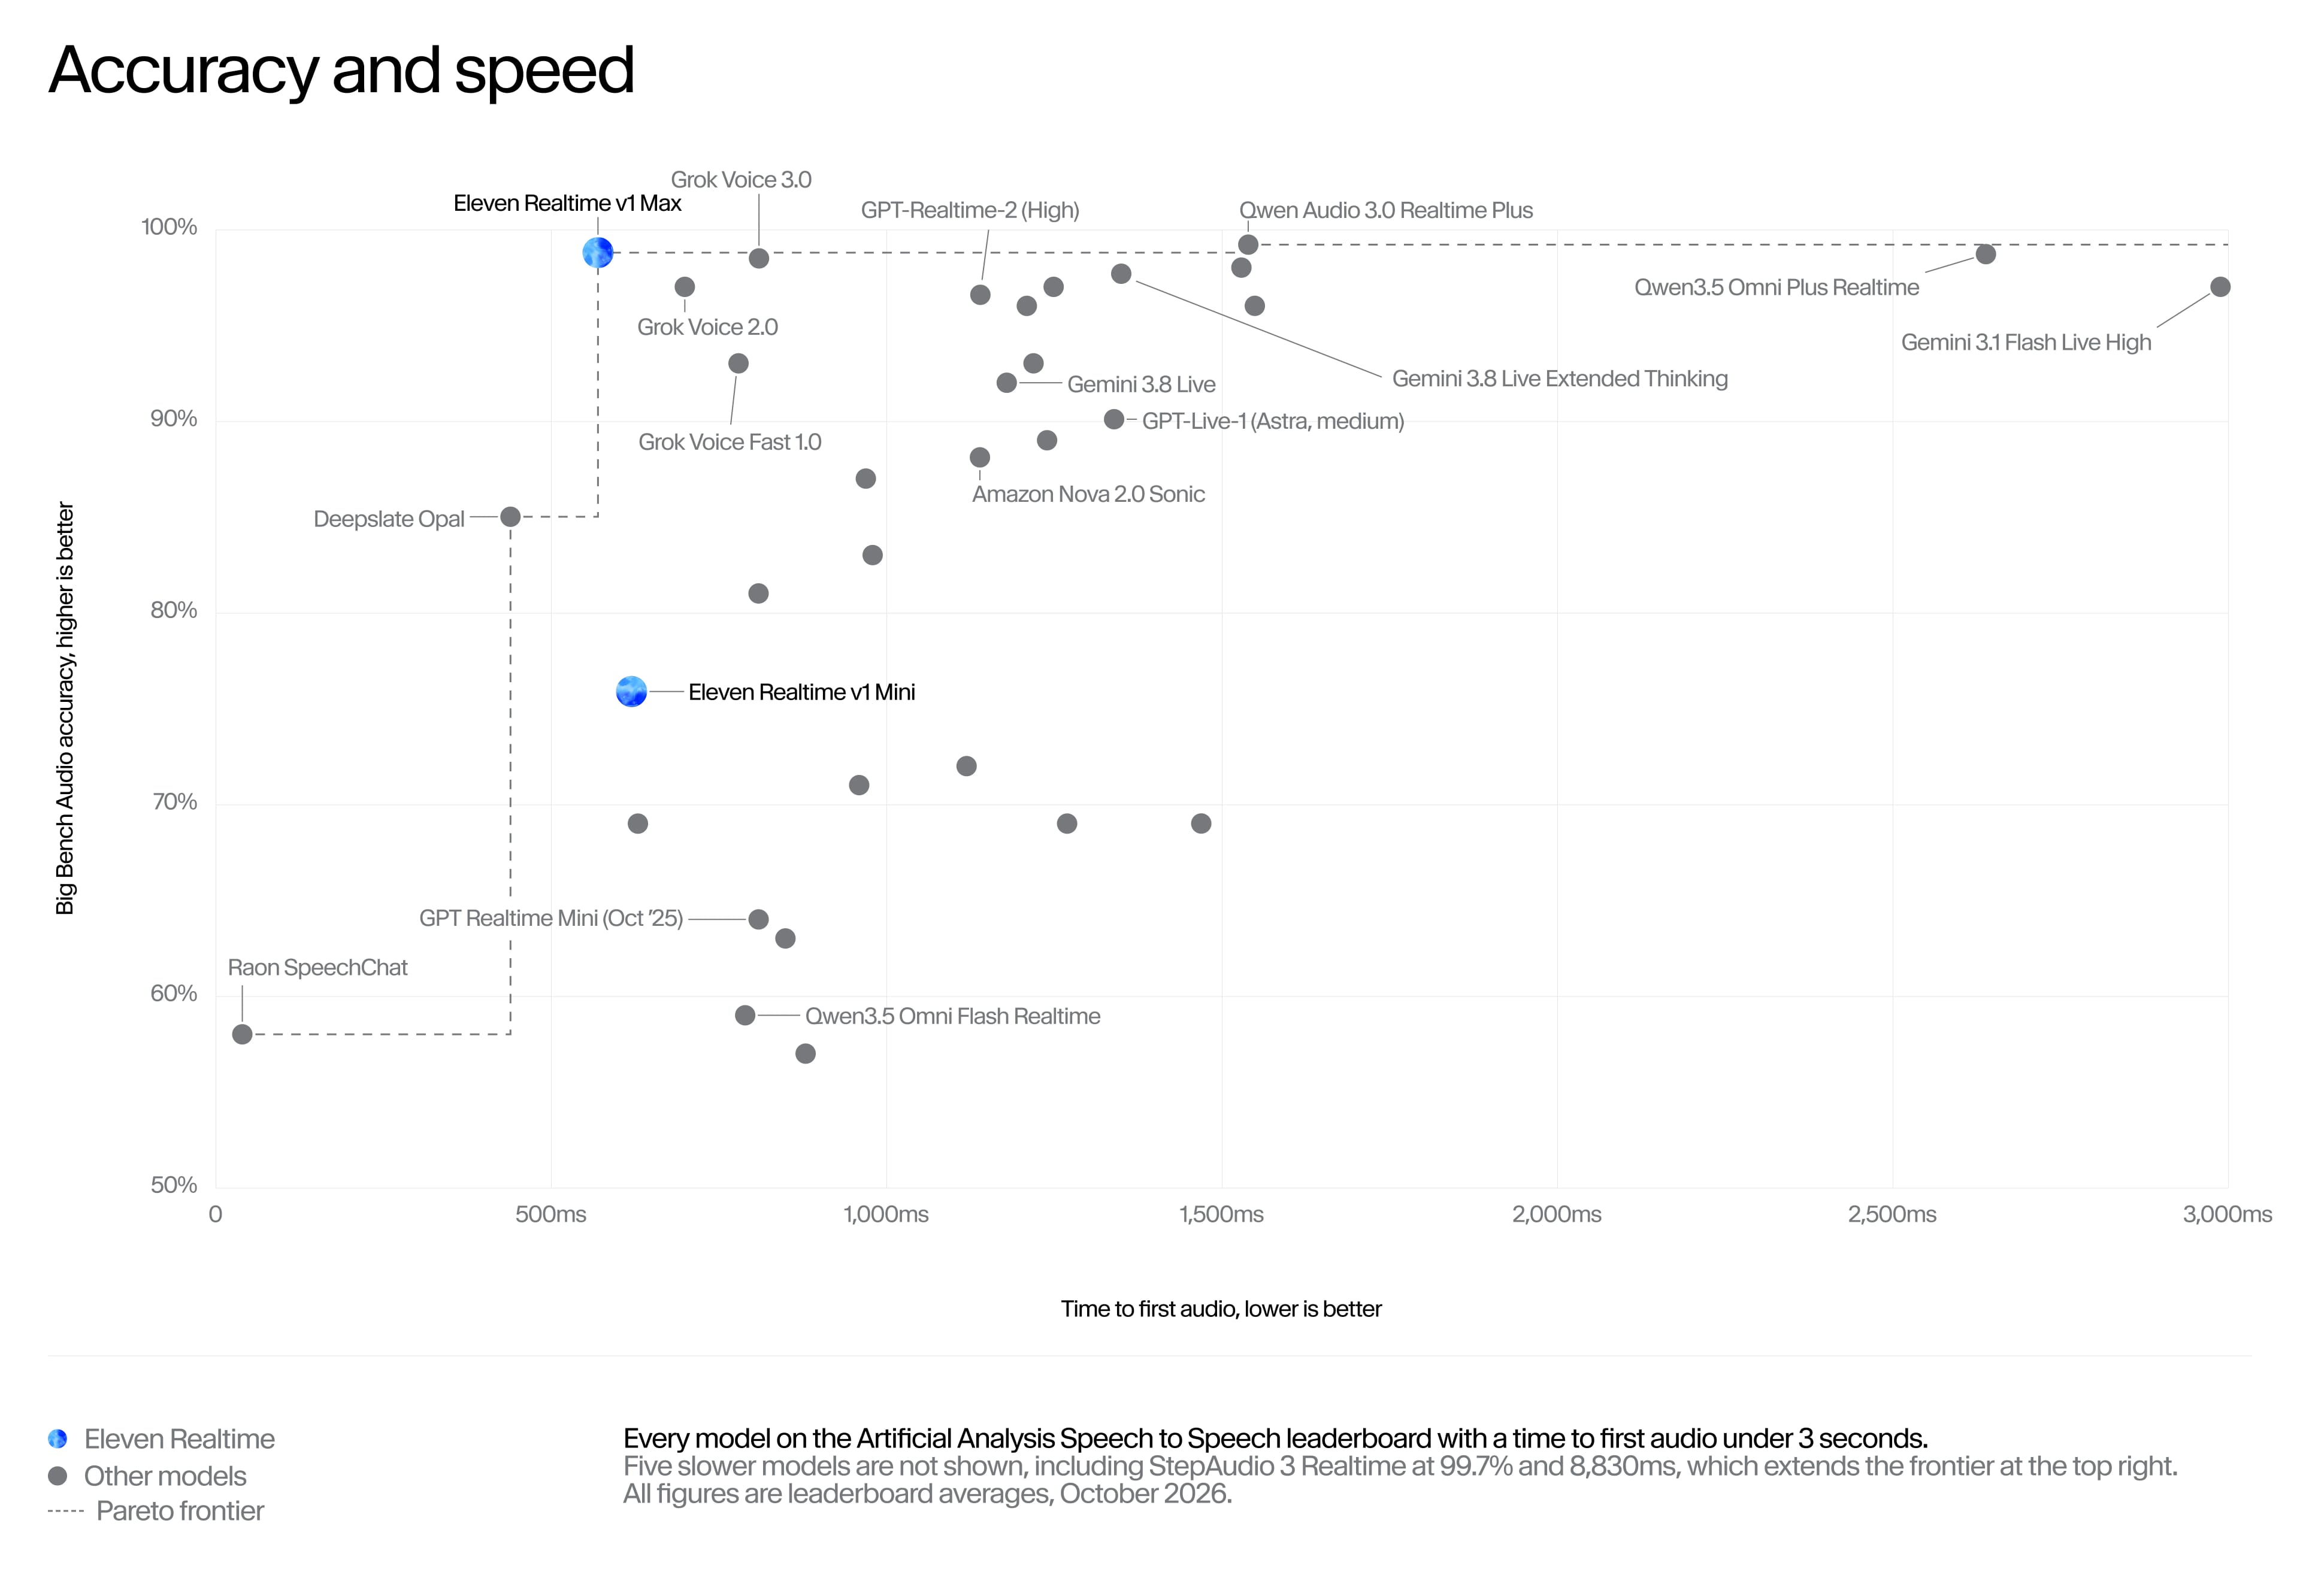
Die folgenden Benchmarks zeigen, ob dieser Kompromiss wirklich verschwunden ist. Bei der Gesprächsdynamik erreichen beide Modelle dieselbe Leistungsklasse wie Fusion-Modelle. Bei Genauigkeit und Geschwindigkeit zusammen ist kein Modell auf dem Artificial-Analysis-Leaderboard zugleich schneller und genauer als v1 Max.
Leistung im Vergleich
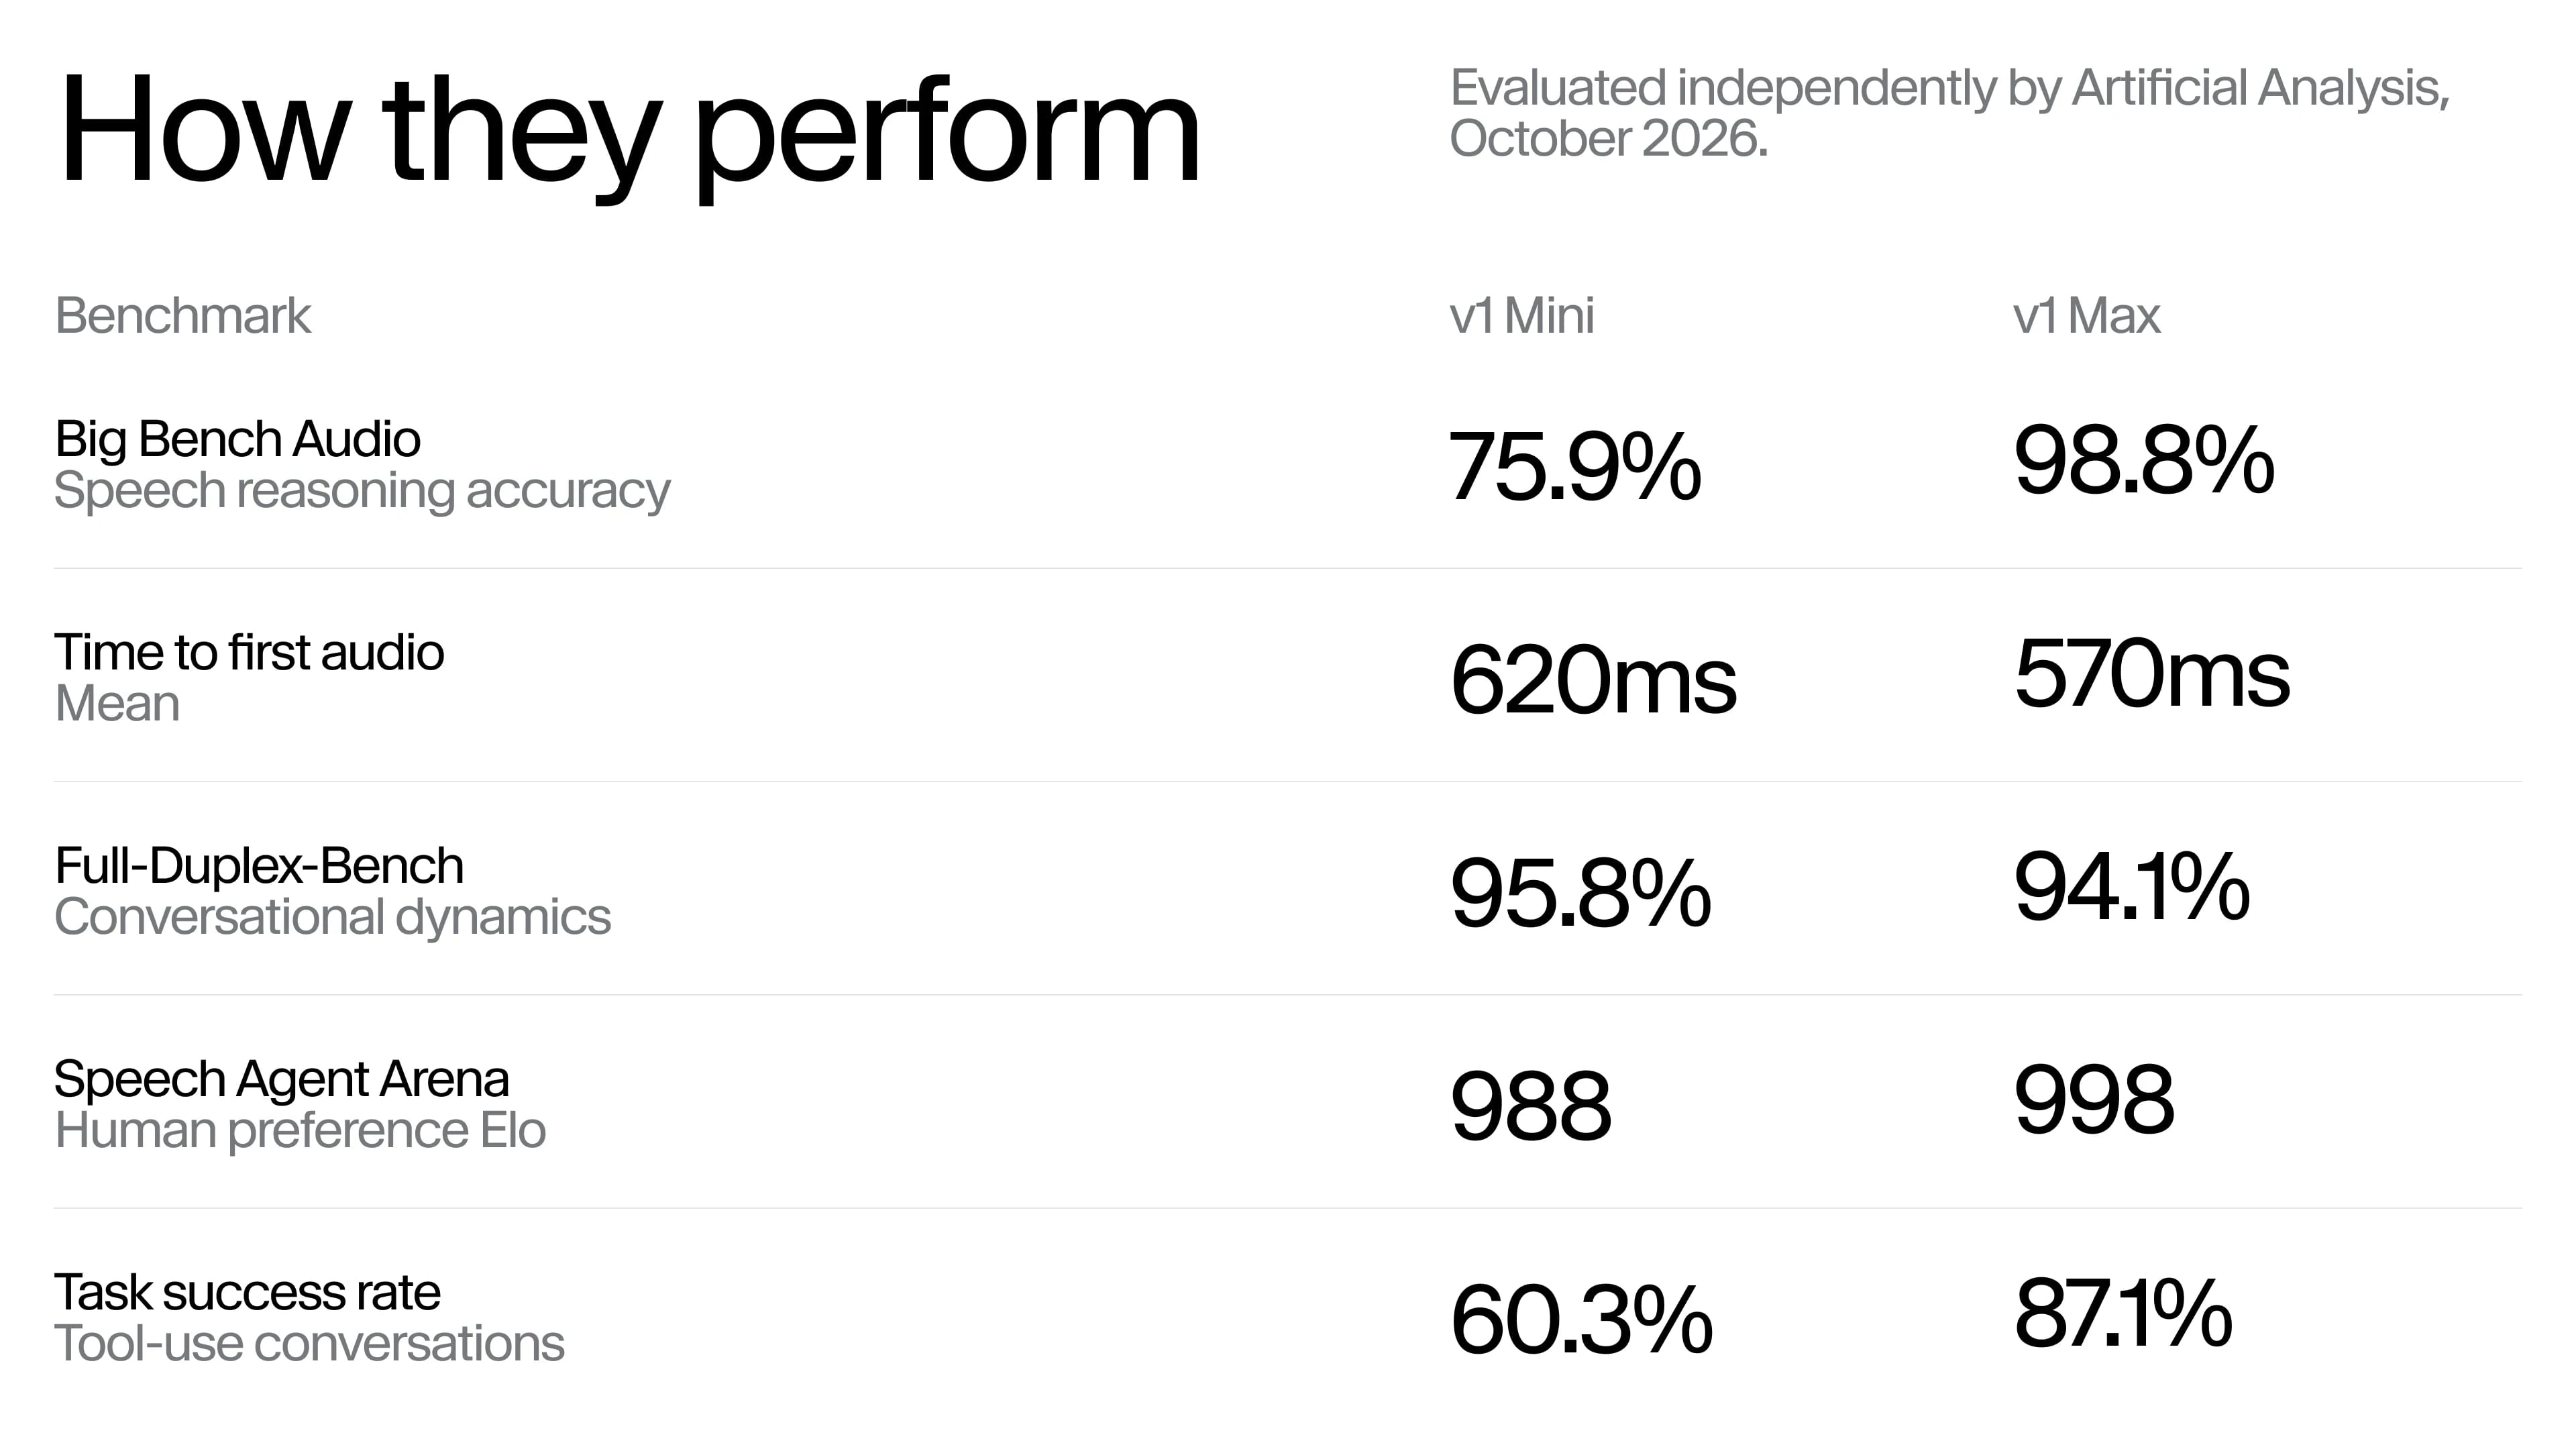
Artificial Analysis hat beide Modelle unabhängig in drei öffentlichen Benchmarks bewertet: Big Bench Audio für sprachbasiertes Schlussfolgern, Full-Duplex-Bench für Gesprächsdynamik und Speech Agent Arena für menschliche Präferenzen und Aufgabenerfolg.
Sprachbasiertes Schlussfolgern
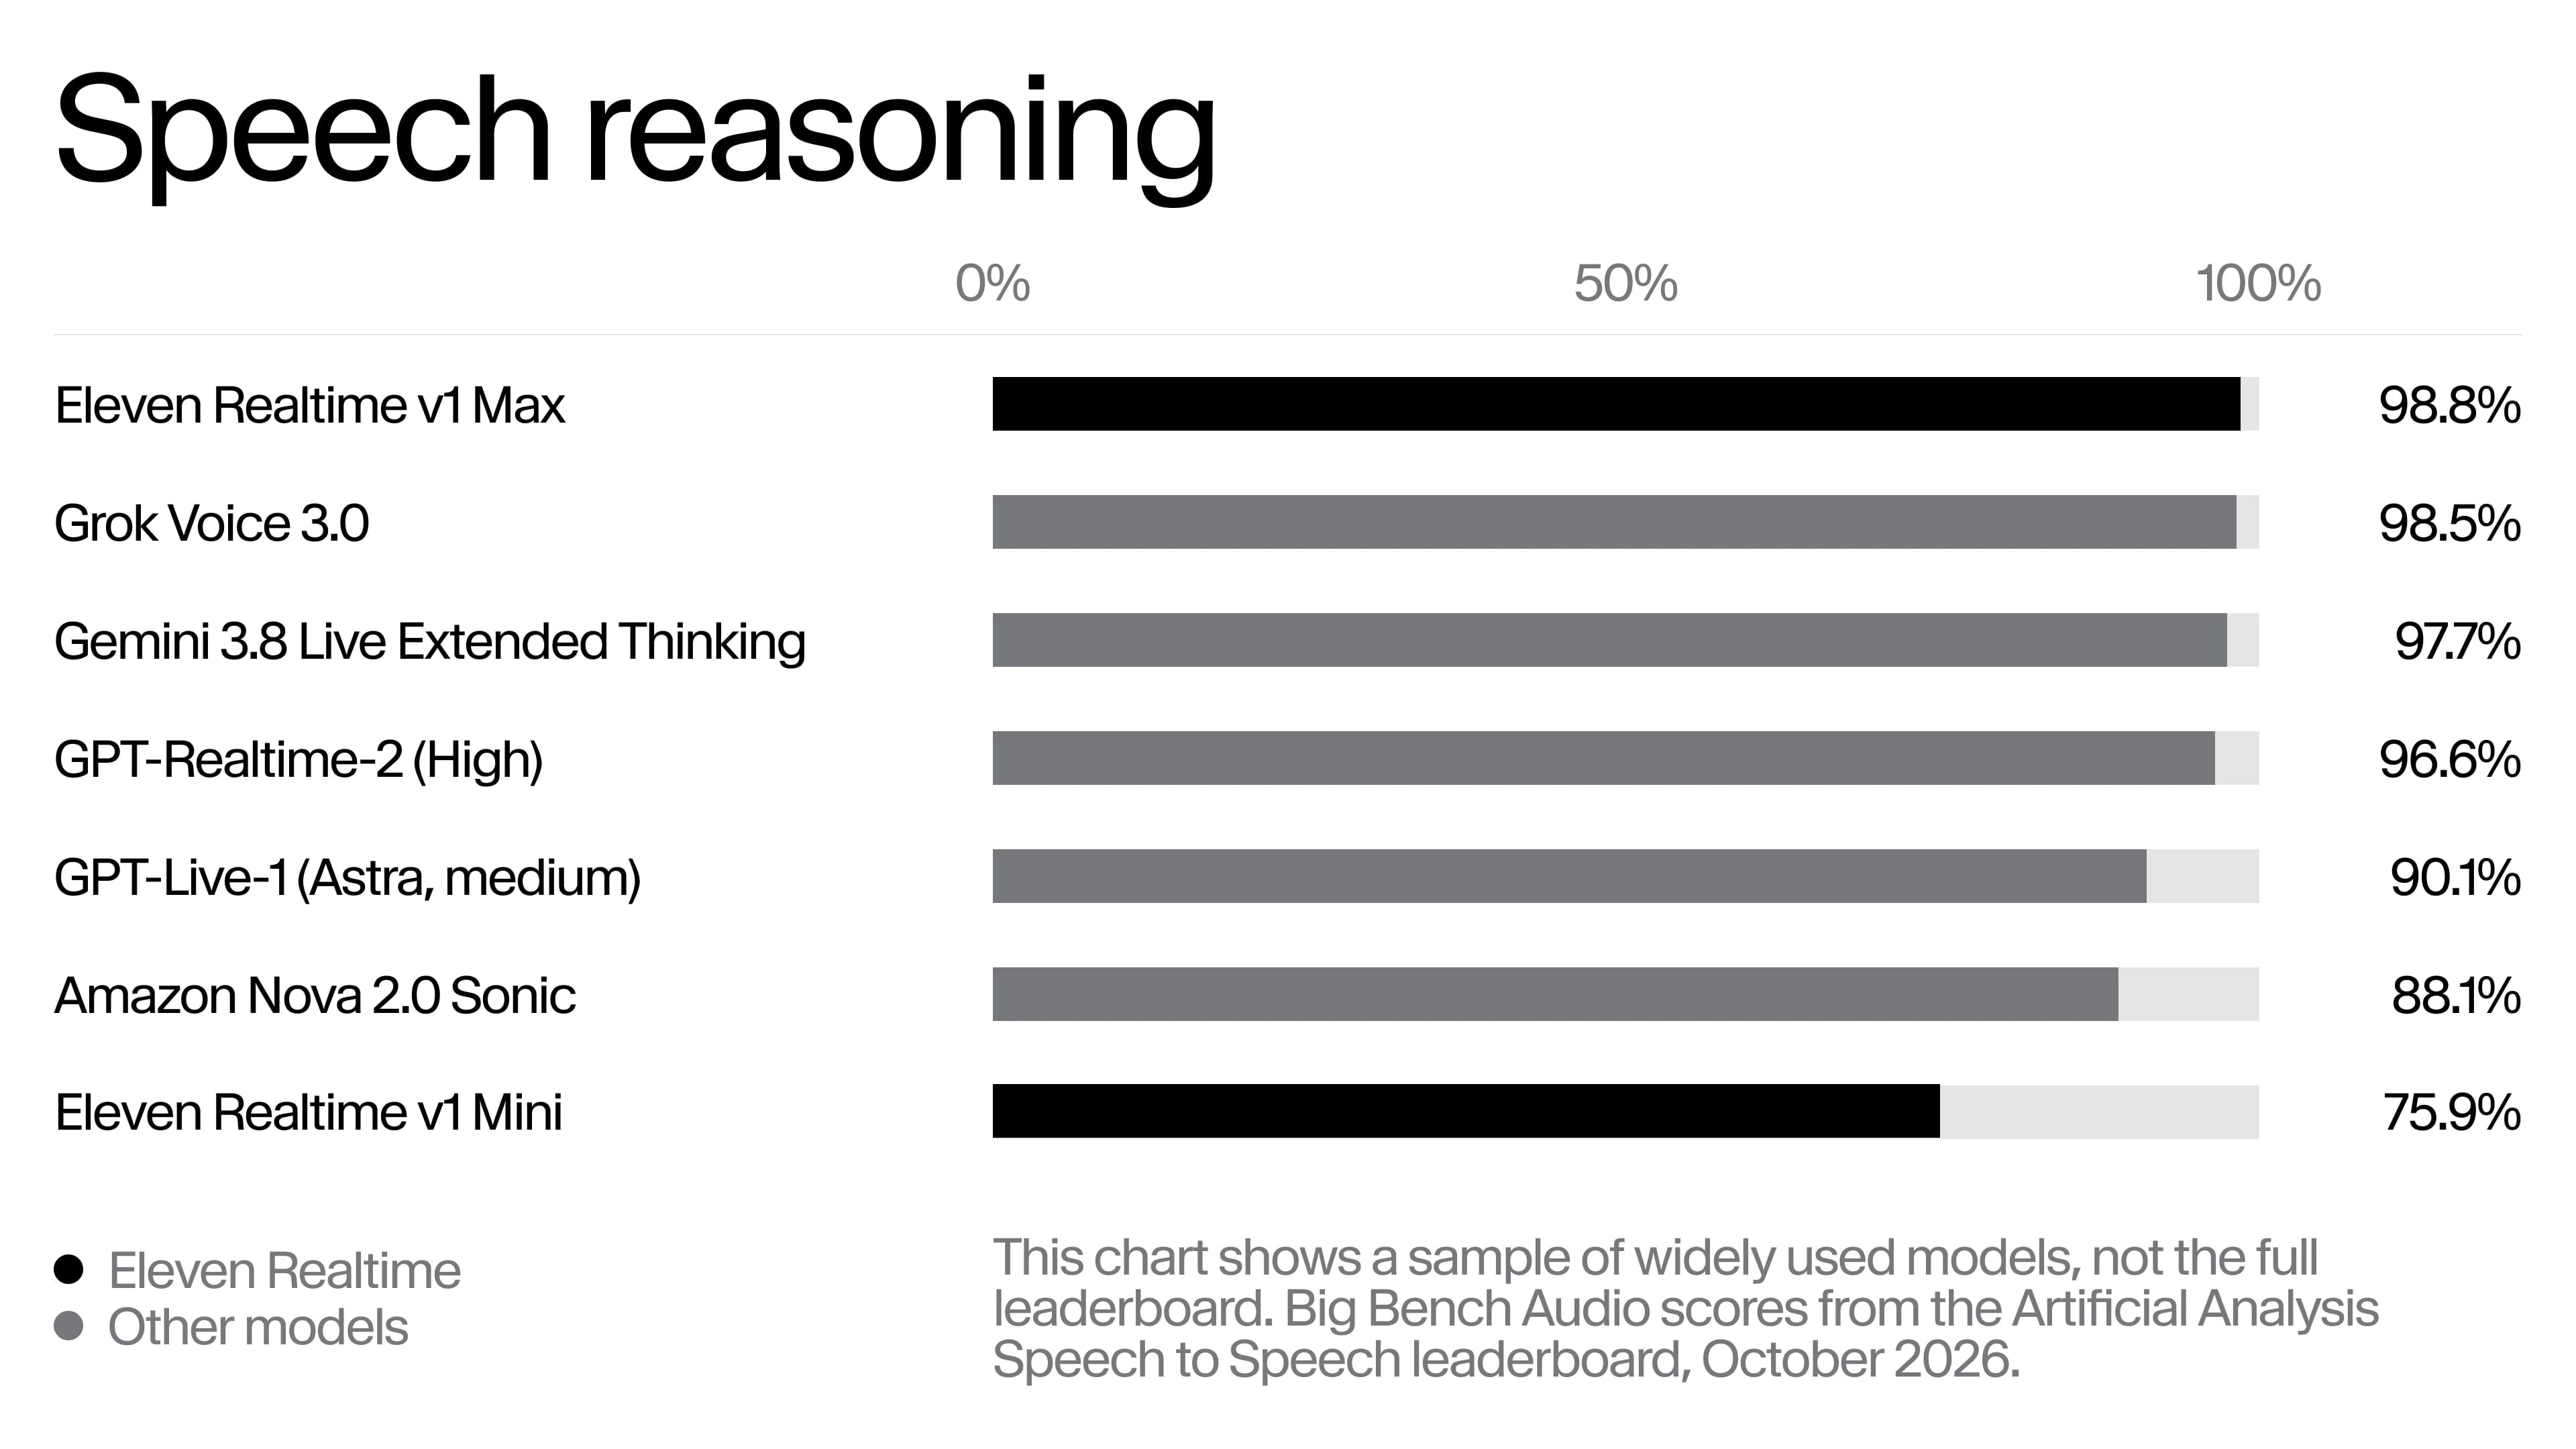
Big Bench Audio stellt 1.000 Denkaufgaben per Sprache und bewertet die gesprochene Antwort. Realtime v1 Max beantwortete 98,8 % der Fragen korrekt, v1 Mini 75,9 %.
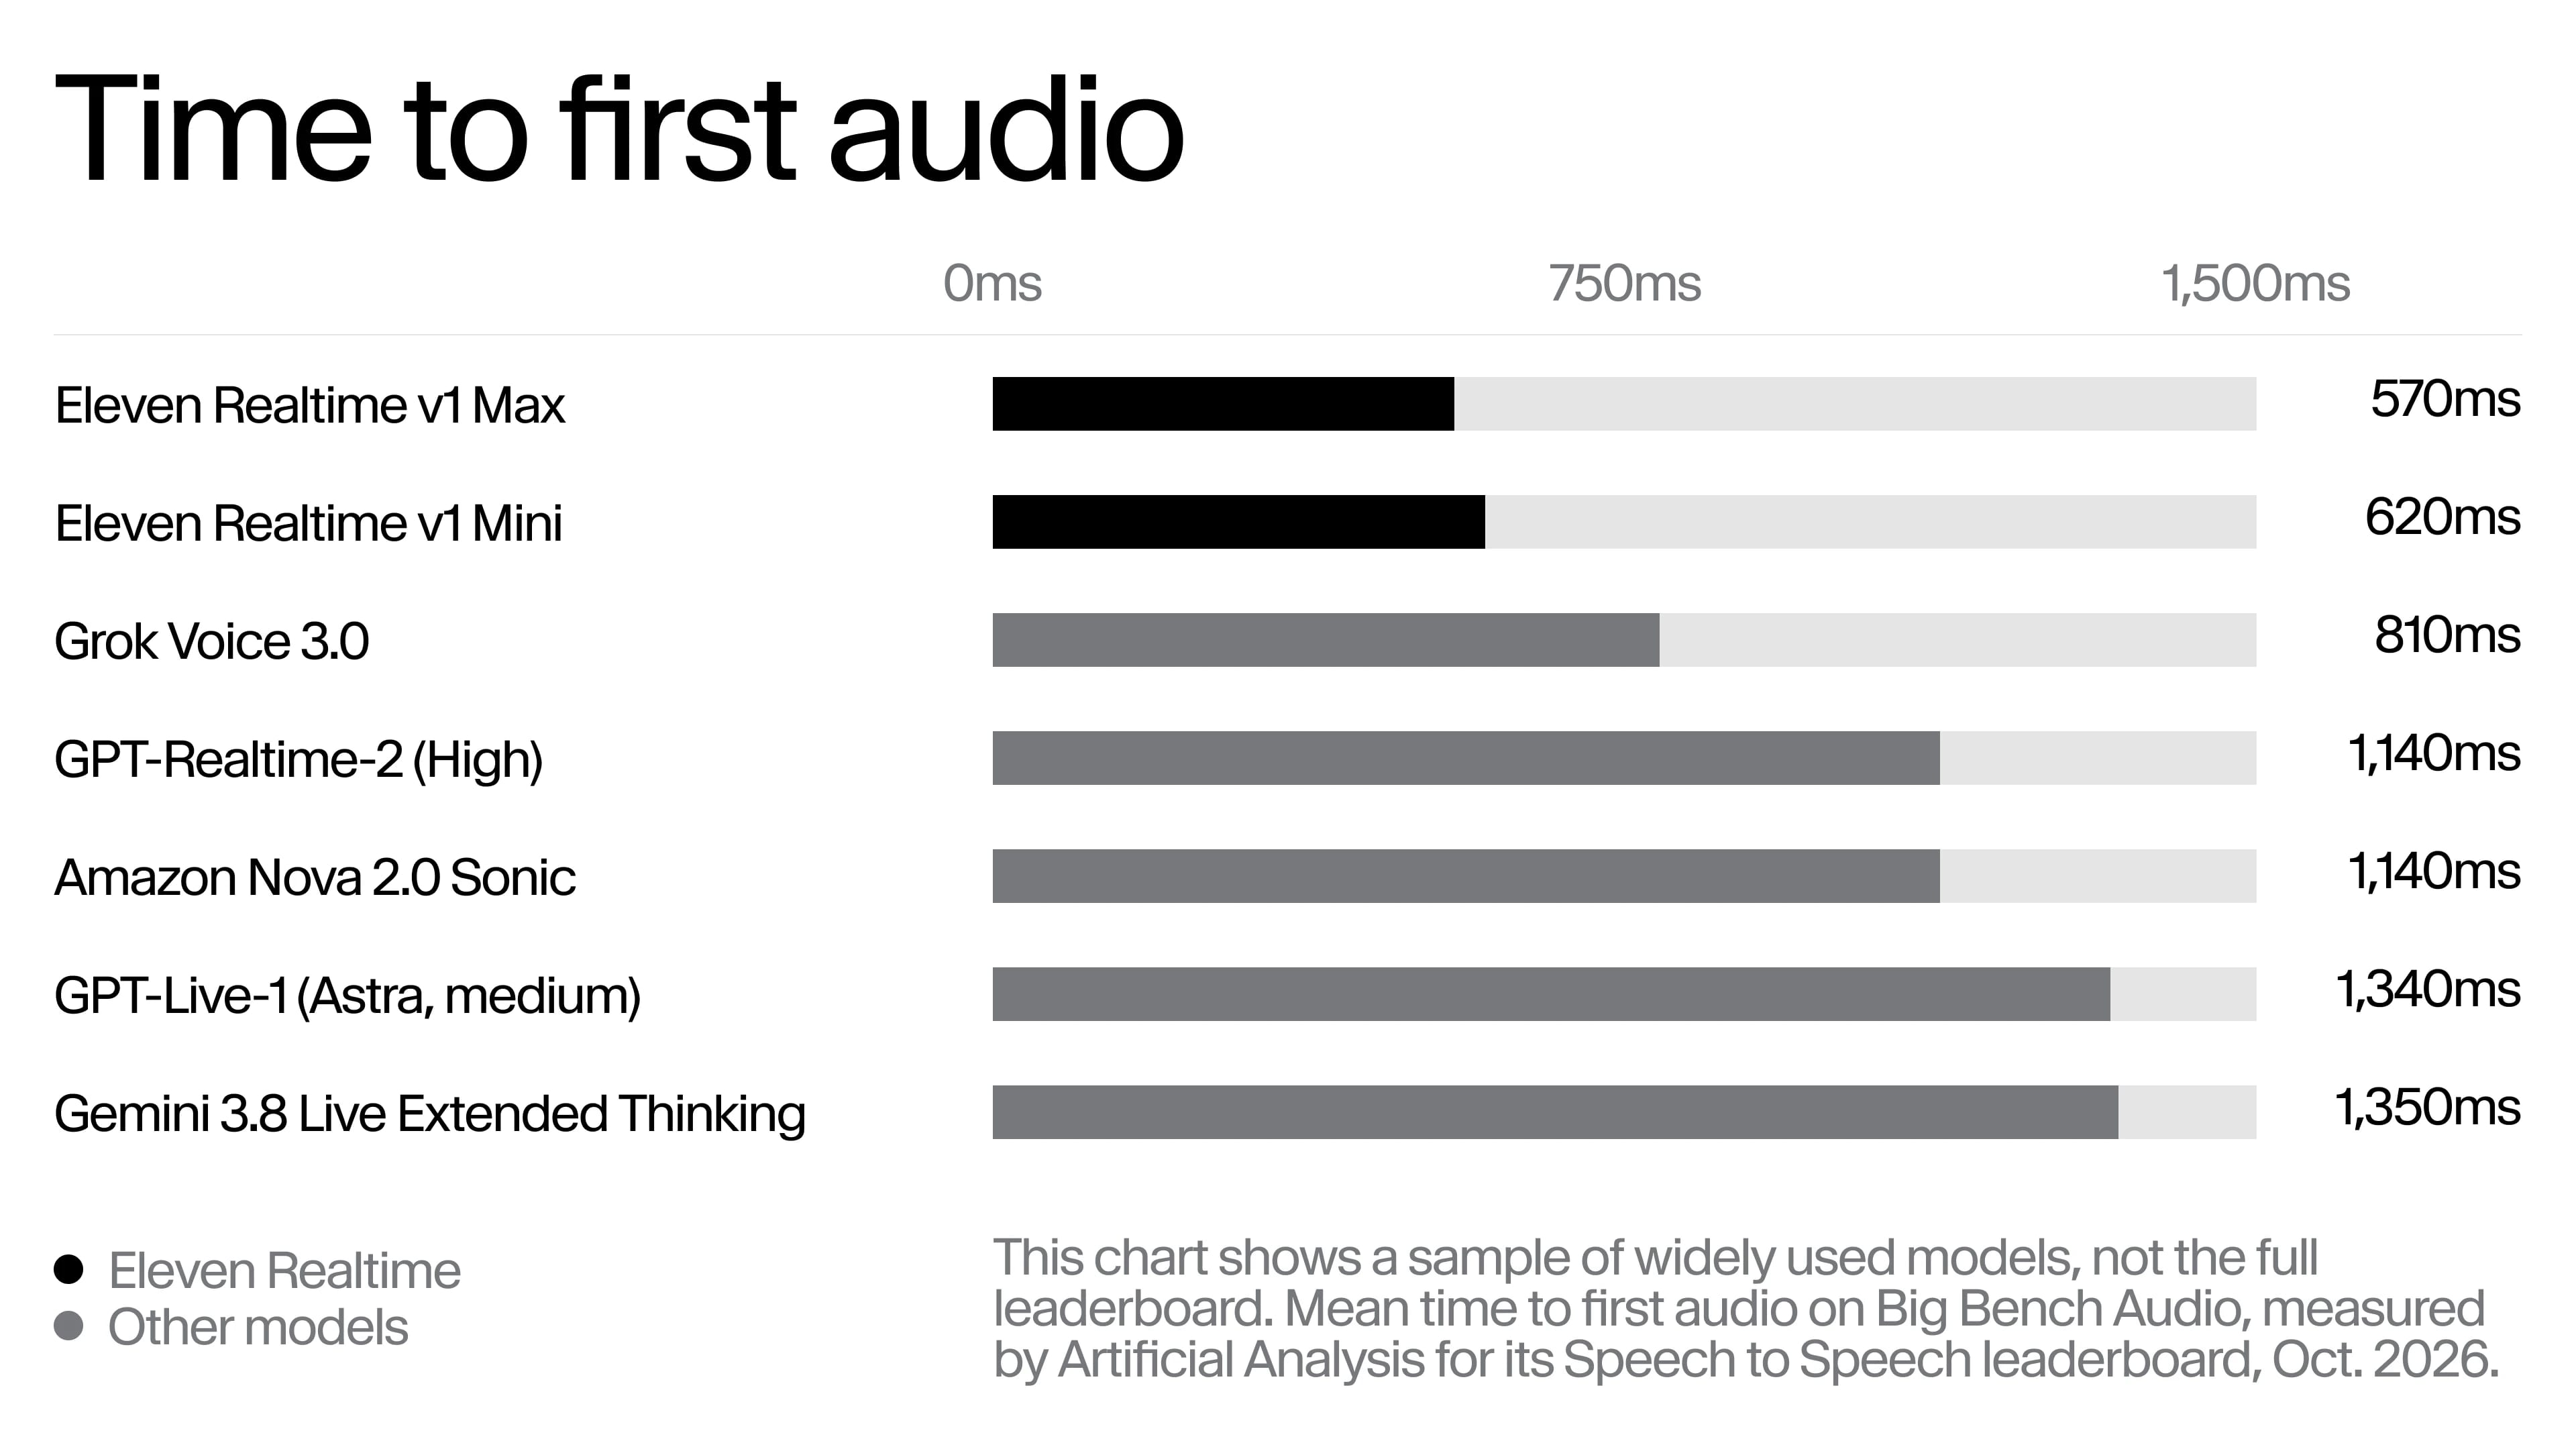
Geschwindigkeit
Big Bench Audio stellt 1.000 Denkaufgaben per Sprache und bewertet die gesprochene Antwort. V1 Max beginnt im Durchschnitt nach 0,57 Sekunden zu sprechen, v1 Mini nach 0,62 Sekunden.
Die Pareto-Grenze für Genauigkeit und Geschwindigkeit
Genauigkeit und Geschwindigkeit gelten meist als Kompromiss. Die Modelle mit den höchsten Werten bei Big Bench Audio brauchen am längsten für ihre Antwort, während die schnellsten deutlich an Genauigkeit verlieren. v1 Max überzeugt bei beiden Kennzahlen.
Gesprächsdynamik und menschliche Präferenzen
Bei Full-Duplex-Bench, der Pausen, Sprecherwechsel, Unterbrechungen und Rückmeldesignale testet, erzielt v1 Mini 95,8 % und v1 Max 94,1 %. In der Speech Agent Arena, in der Menschen zwei Modelle in blinden Live-Gesprächen vergleichen, erreichte v1 Max 998 und v1 Mini 988 Punkte. Bei Aufgaben mit Tool-Nutzung erledigte v1 Max 87,1 % und v1 Mini 60,3 %. Deshalb empfehlen wir Max für Anwendungsfälle mit intensiver Tool-Nutzung.
Erste Schritte
In ElevenAgents (empfohlen)
Erstellen Sie einen Agenten oder öffnen Sie einen bestehenden und wählen Sie im Dropdown ein Realtime-Modell aus. Anschließend stehen Ihnen alle Funktionen von ElevenAgents für den Betrieb von Agenten in Produktion zur Verfügung. Dazu gehören Telefon-, Web-, WhatsApp- und CCaaS-Kanäle, Workflows, eine Wissensdatenbank, Schutzmechanismen, Tests und Monitoring.
Weitere Details finden Sie in der ElevenAgents-Dokumentation.
Über die Realtime API
Wenn Sie bereits eine Integration mit der Realtime API von OpenAI haben, können Sie Eleven Realtime am schnellsten testen, indem Sie Ihren Code behalten und nur sein Ziel ändern. Die Realtime API verbindet sich über WebSocket und folgt den OpenAI-Realtime-Spezifikationen. Das SDK von OpenAI funktioniert daher unverändert.
Die Realtime API verbindet sich nur über WebSocket. Eine WebRTC-Integration muss daher zuerst auf WebSocket umgestellt werden. Sie läuft außerdem getrennt von ElevenAgents. Wenn Sie also Kanäle, eine Wissensdatenbank oder andere Plattformfunktionen benötigen, setzen Sie von Anfang an auf ElevenAgents.
Der Migrationsleitfaden beschreibt die Schritte und die Unterschiede zur API von OpenAI.
Min arbeitet im Growth-Team bei ElevenLabs und verantwortet ElevenAPI sowie On-Prem/On-Device. Zuvor leitete er als zweiter GTM-Mitarbeiter das Produktmarketing bei Stainless. Davor war er als früher PMM bei WorkOS tätig und verantwortete dort Produkteinführungen, Enablement, Inhalte und Wachstum.