Probleme mit der Text-to-Speech-Genauigkeit beheben
- Verfasst von
- Jack Limebear
- Veröffentlicht
AnhörenArtikel anhören
Obwohl sie mit riesigen Sprachdatensätzen trainiert werden und zuverlässig hochauflösendes Audio erzeugen können, können die meisten Text-to-Speech-Modelle (TTS) Wörter dennoch falsch aussprechen oder andere Sprachprobleme haben. Falschaussprachen entstehen, wenn eine TTS-Engine auf Wörter und Ausdrücke trifft, die außerhalb des Sprachumfangs ihres Trainingsdatensatzes liegen. Das passiert besonders häufig bei Fachjargon, Markennamen oder Eigennamen.
TTS-Engines können auch hastige, abgehackte oder roboterhafte Sprache erzeugen, wenn Textpassagen lang sind oder zum Lesen statt zum Vorlesen strukturiert und punktiert wurden.
Bei der Anbindung Ihrer Anwendungen an TTS-Engines per API können zudem einige häufige technische Probleme auftreten.
In diesem Artikel betrachten wir diese drei Problemkategorien und gängige Lösungen für jede davon.
Zusammenfassung
- Text-to-Speech-Fehler lassen sich allgemein in falsche Aussprache, unnatürliches Tempo bzw. unnatürliche Sprachmelodie und technische API-Ausführungsfehler einteilen.
- Falschaussprachen beheben Sie am wirksamsten mit W3C-konformen Pronunciation-Lexicon-Specification-(PLS)-Wörterbüchern oder individuell mit phonetischen Inline-Tags in Ihren Skripten.
- Die Natürlichkeit Ihrer Sprachausgabe steuern Sie durch die passende Formatierung und Zeichensetzung Ihres Skripts. Für das Sprechen formatierter Text unterscheidet sich oft von Text, der nur gelesen werden soll.
- API-Fehler können Sie über standardisierte HTTP-Statuscodes diagnostizieren.
- Wenn Sie die Aussprache von Markennamen, Eigennamen und neuen Ausdrücken vorab isoliert testen, ersparen Sie sich später aufwendige Fehlersuche.
Warum funktioniert Text to Speech nicht?
Text-to-Speech-Probleme fallen grundsätzlich in drei Kategorien.
Arten von TTS-Problemen
Falschaussprachen
Das TTS-Modell liest unbekannte Wörter oder Ausdrücke falsch. Zum Beispiel Ihren Markennamen, Fachjargon, Akronyme oder Homographen.
Unnatürliche Sprechweise & Sprachmelodie
Die Sprachausgabe ist monoton, macht an unpassenden Stellen Pausen oder eilt durch Passagen, die langsamer gesprochen werden sollten.
Integrations- & API-Fehler
Ihre Anwendung erzeugt aus einem oder mehreren technischen Gründen keine Sprache, etwa wegen fehlender Voice-IDs, Auslastungsgrenzen oder ungültiger API-Schlüssel.
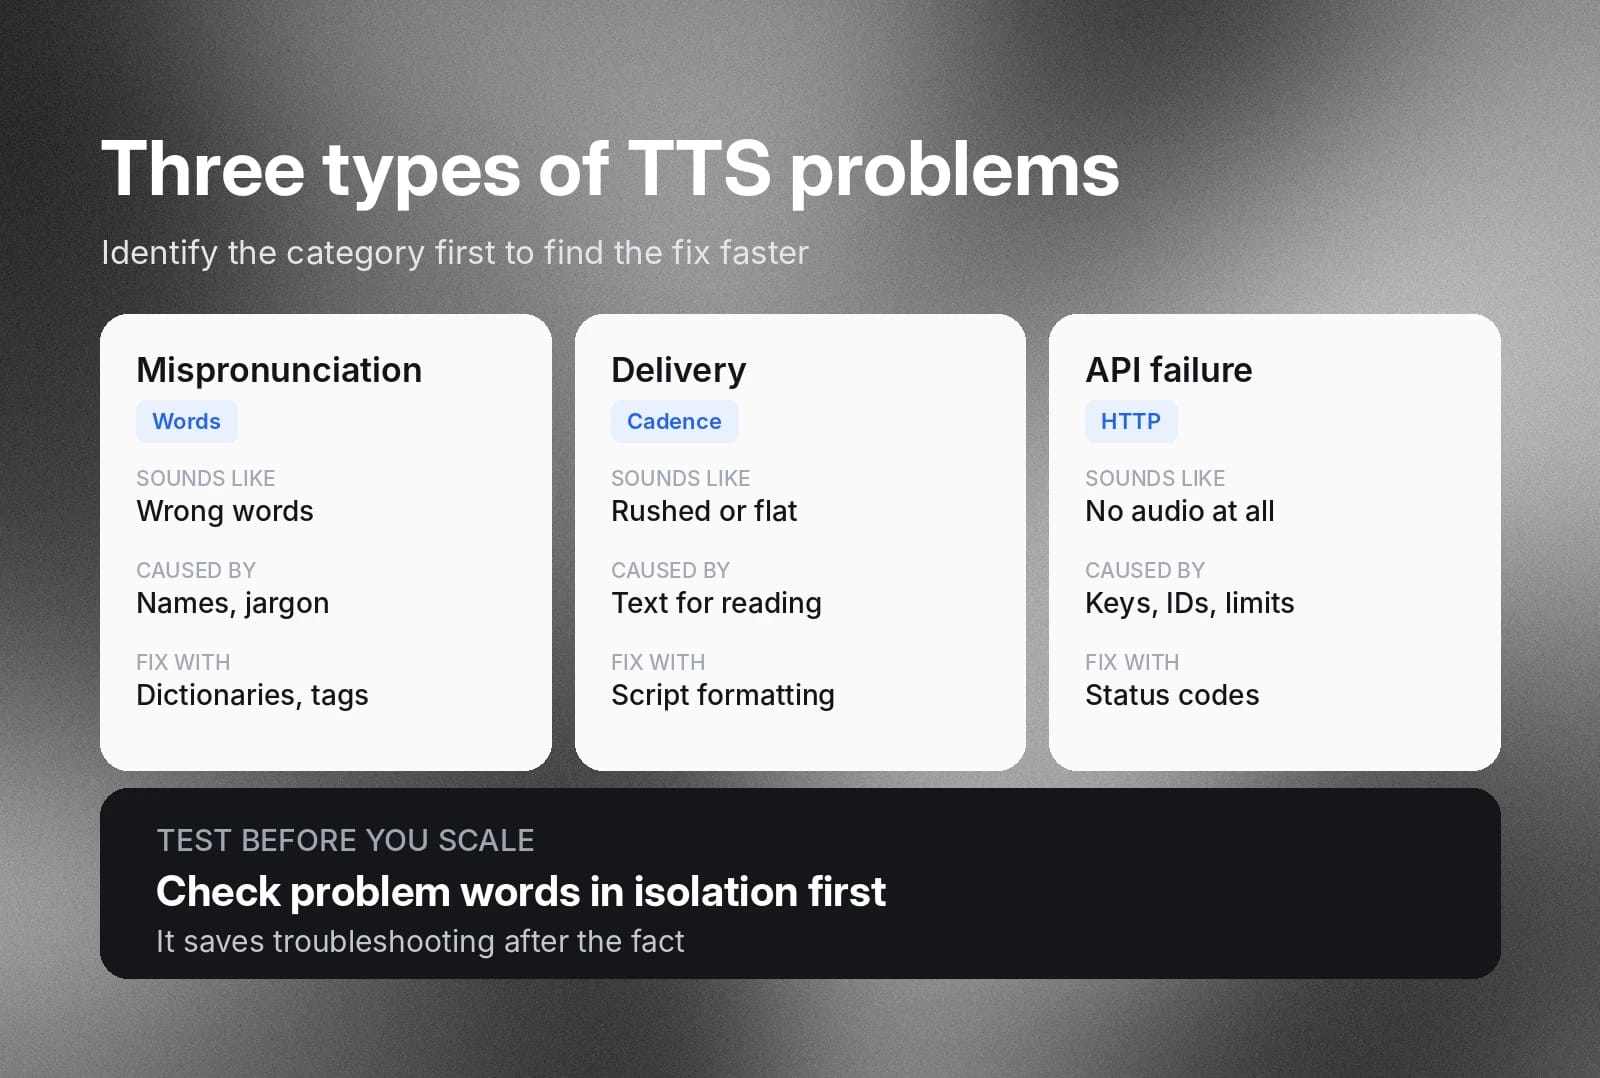
Dieser Leitfaden erläutert jedes dieser drei Probleme genauer, damit Sie genau verstehen, mit welchem Qualitäts- oder technischen Problem Sie es zu tun haben. So finden Sie schneller die passende Lösung.
Probleme mit der Text-to-Speech-Genauigkeit beheben: Falschaussprachen und unnatürliche Sprechweise
Entwickler trainieren moderne neuronale Sprachmodelle mit riesigen Sprachdatensätzen. Sie können natürlich klingende Sprache in nahezu unzähligen Wortkombinationen erzeugen. Kein Trainingsdatensatz ist jedoch universell. Es wird immer Sonderfälle bei der Aussprache sowie seltene Wörter oder Eigennamen geben, die das Modell nicht korrekt ausspricht.
Das passiert nicht oft, doch wer regelmäßig TTS-Modelle nutzt, sollte wissen, wie damit umzugehen ist. Zunächst ist es wichtig zu verstehen, warum diese Falschaussprachen entstehen.
Häufige Ursachen von Sprachfehlern
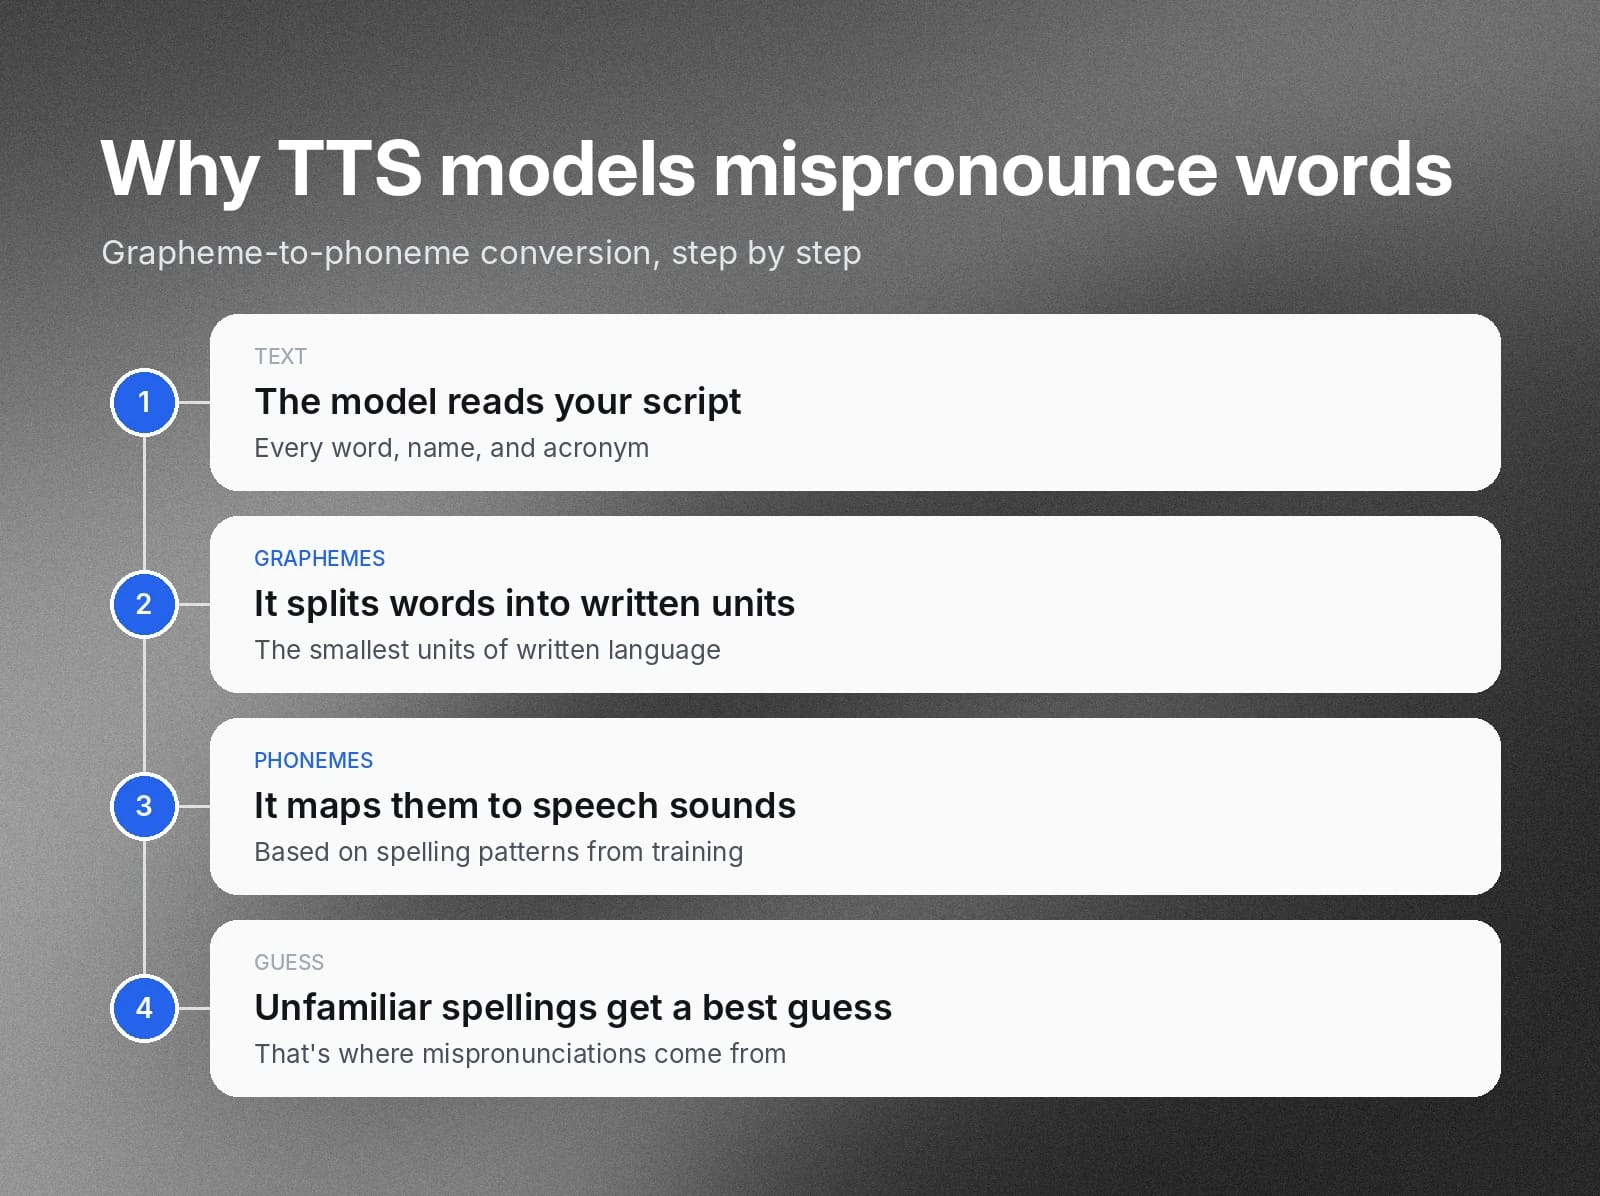
Sprachsynthesemodelle wandeln Text durch einen Prozess namens Graphem-zu-Phonem-(G2P)-Umwandlung in Sprache um. Phoneme sind die kleinsten Einheiten gesprochener Laute. Grapheme sind die kleinsten Einheiten der Schriftsprache, meist einzelne Buchstaben, die ein Phonem darstellen.
Wenn die Texteingabe nicht den Schreibmustern entspricht, auf die die Modelle in den Trainingsdaten gestoßen sind, schätzen sie die phonetische Aussprache bestmöglich. Das führt manchmal zu Falschaussprachen.
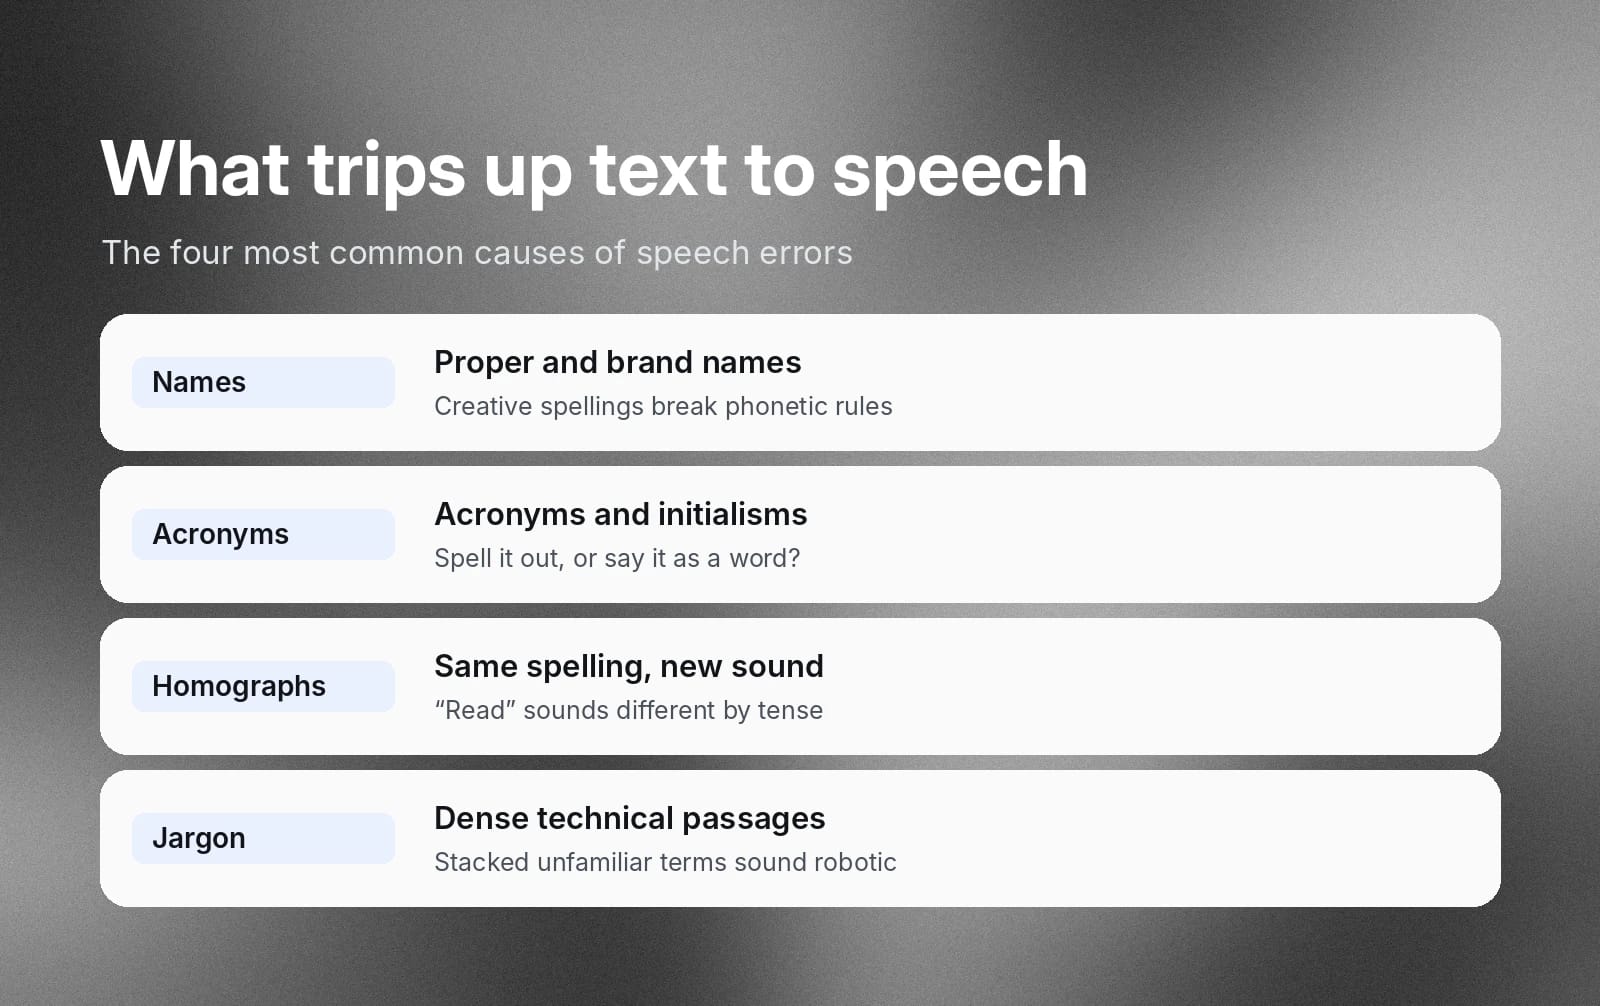
Eigen- und Markennamen
Unternehmen verwenden für Markennamen oft kreative Schreibweisen. Sie fallen ins Auge, verwirren jedoch häufig auch Sprachsynthesemodelle. Aus demselben Grund kann das auch bei kreativen Vor- und Nachnamen passieren.
Trifft ein Modell auf einen unbekannten Namen, versucht es, die erlernten grundlegenden phonetischen Regeln anzuwenden. Die resultierende Sprachausgabe kann stark von dem abweichen, was Sie erwarten.
Akronyme & Initialwörter
Denken Sie an das Akronym NASA. Stellen Sie sich vor, Sie hätten es noch nie gesehen – ähnlich wie ein Sprachmodell. Sprechen Sie es „N.A.S.A.“ oder „nassa“ aus? Und was ist mit einer Software-API? Heißt es „A.P.I.“ oder „api“? Was, wenn Ihr Unternehmen ein neues Softwaretool mit einem neuen Akronym verkauft? Sie können sicher sein, dass es nicht in den Trainingsdaten eines Sprachmodells vorkommt. Das Modell müsste also raten, wie Sie es ausgesprochen haben möchten, sofern Sie ihm keine eigenen Anweisungen geben.
Homographen
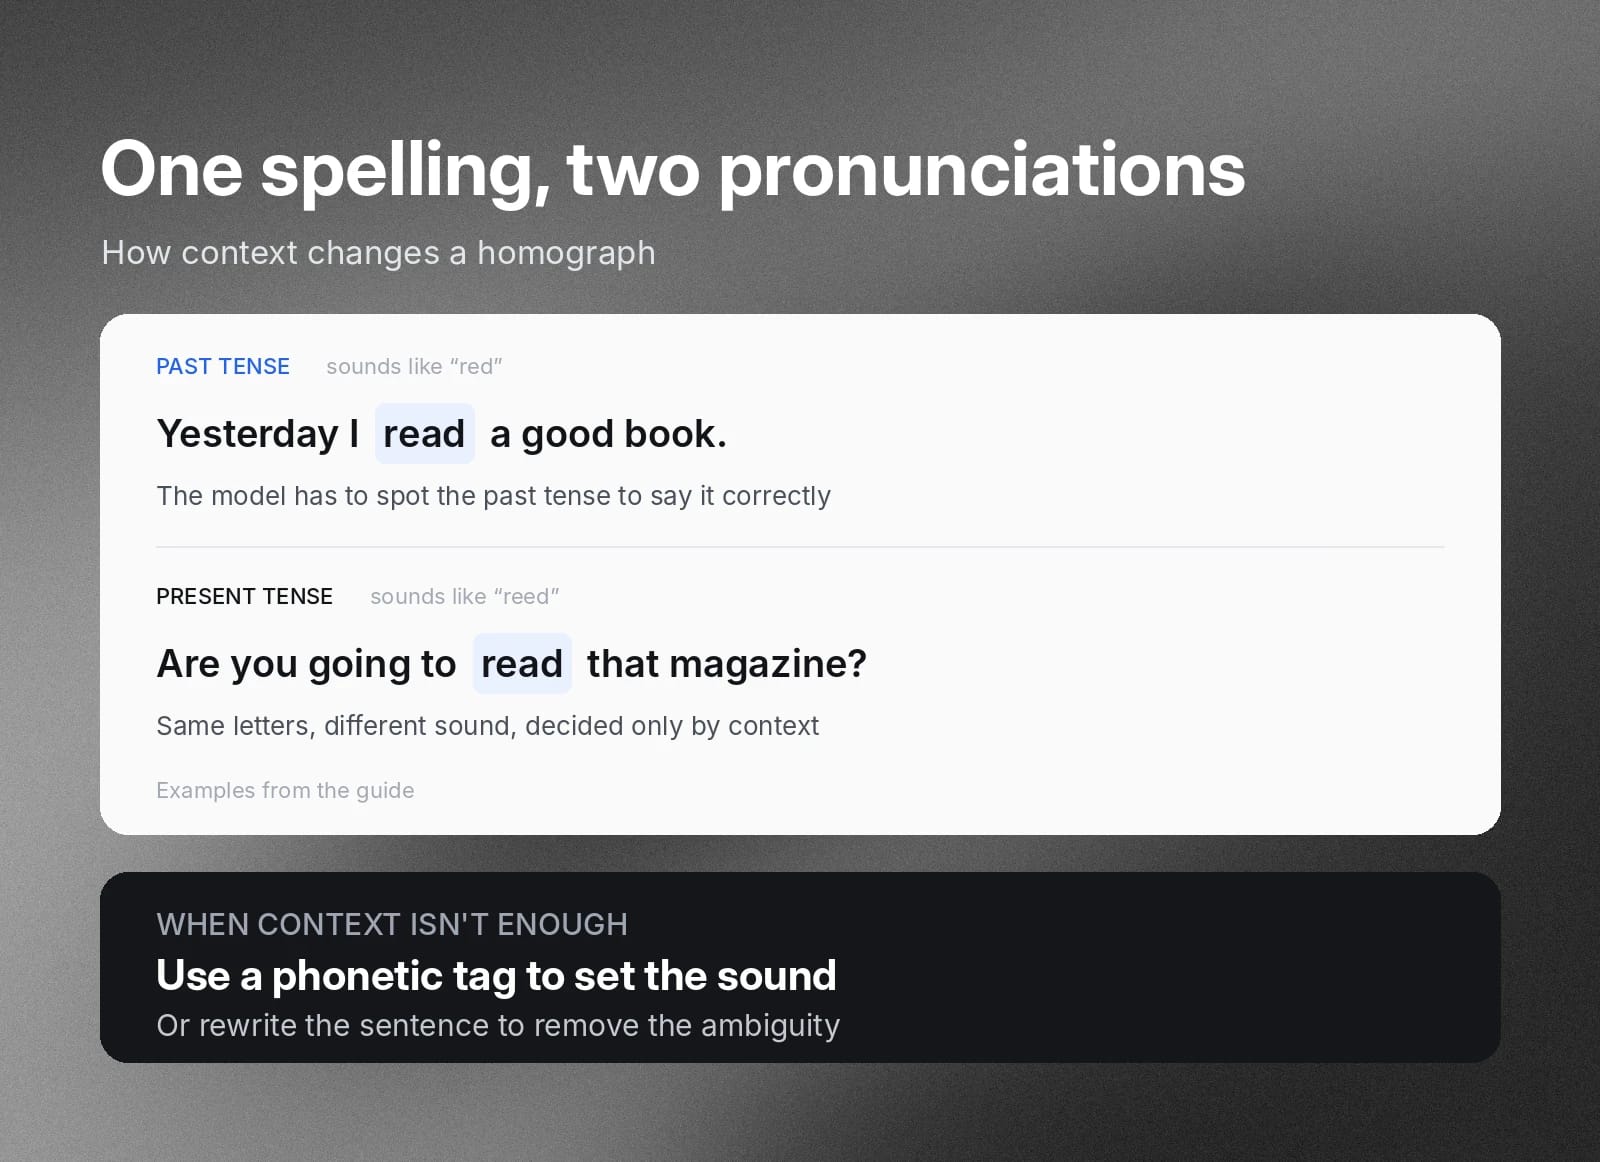
Homographen sind Wörter mit gleicher Schreibweise, deren Aussprache je nach Kontext unterschiedlich ist. So wird das englische Wort „read“ gleich geschrieben, aber in Vergangenheit und Gegenwart unterschiedlich ausgesprochen.
- „Gestern habe ich ein gutes Buch gelesen.“
- „Wirst du diese Zeitschrift lesen?“
Ein Sprachmodell benötigt ausreichend Kontextverständnis, um Homographen wie gewünscht auszusprechen.
Unnatürliche Betonungsmuster
Lange Sätze mit technischem Jargon können schnell seltene Wörter, spezielle Aussprachen und Akronyme aneinanderreihen. Was für sich genommen ein kaum merklicher Fehler wäre, kann rasch zu flacher, roboterhafter Sprache beitragen, während ein Modell versucht, viele unbekannte Wörter und Formulierungen zu verarbeiten.
Zwei Möglichkeiten, die Aussprache der Stimme zu steuern
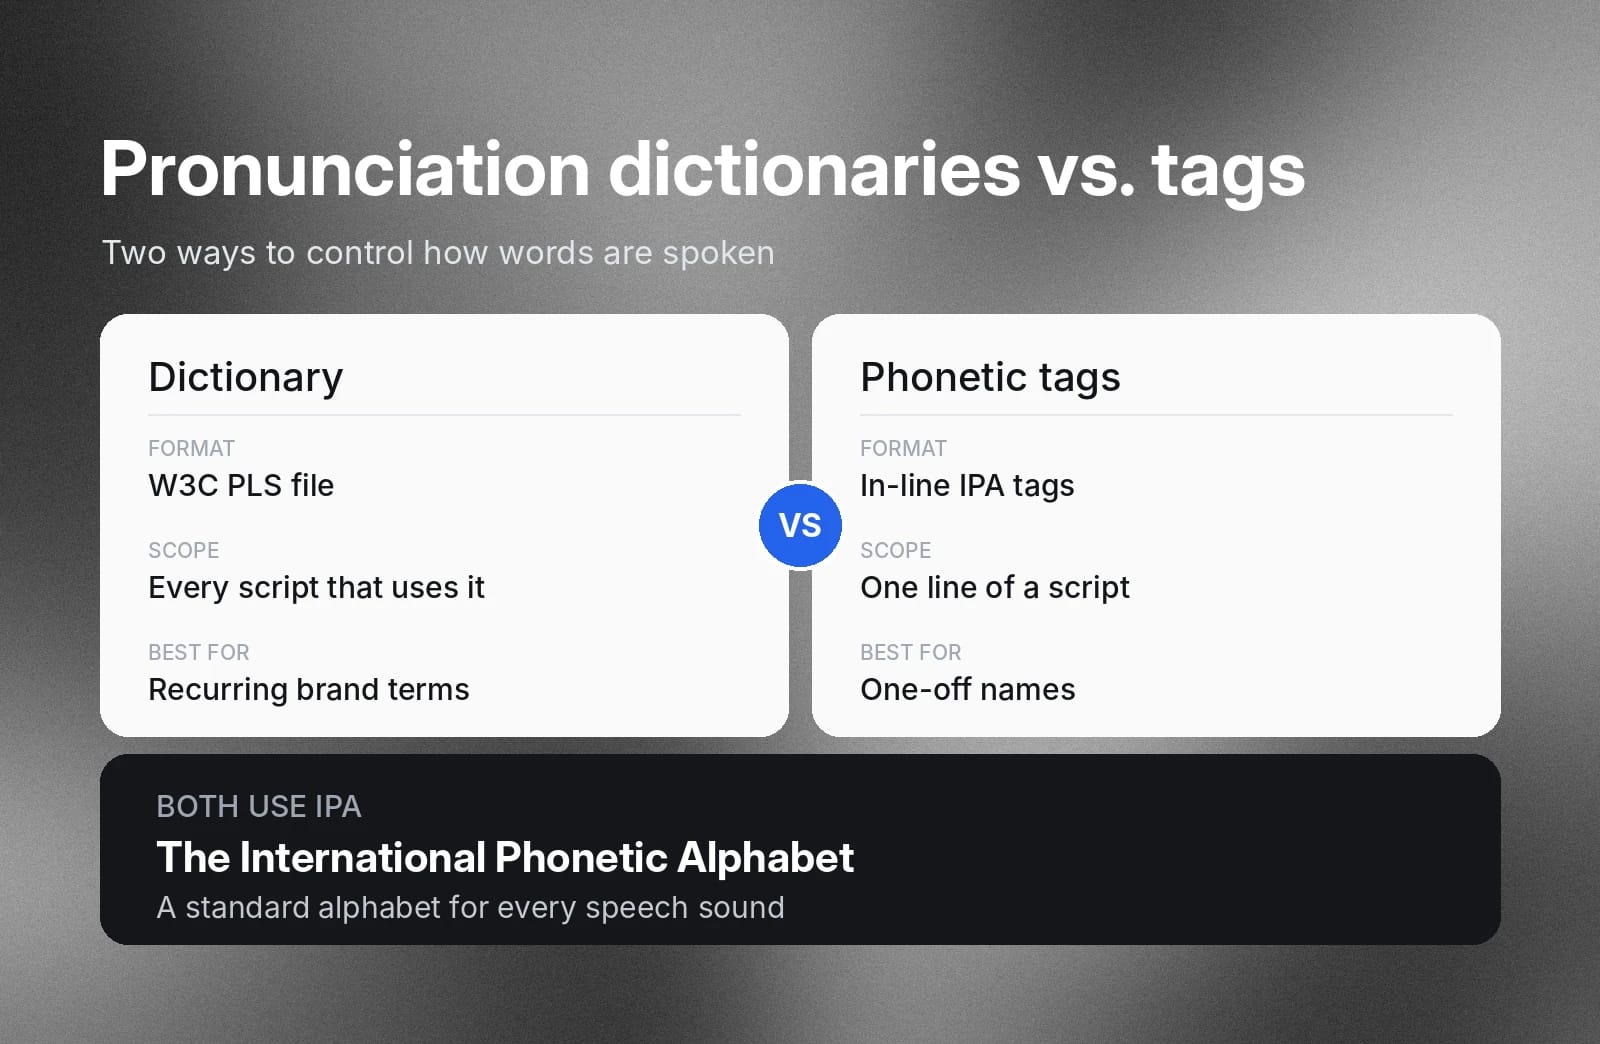
Sie müssen Ihre Skripte nicht vollständig umschreiben, um diese Situationen zu vermeiden. Moderne neuronale Sprachmodelle bieten zwei Werkzeuge, um sie effizient von Fall zu Fall zu beheben: Aussprachewörterbücher und phonetische Skript-Tags.
Text-to-Speech-Aussprachewörterbücher
Wörterbücher eignen sich am besten, wenn Sie benutzerdefinierte Aussprachen haben, die regelmäßig in Ihren TTS-Projekten wiederkehren. Zum Beispiel, wenn Ihr Unternehmen Medizinprodukte verkauft und Ihre Skripte regelmäßig Fachbegriffe, medizinische Verfahren und andere domänenspezifische Inhalte enthalten.
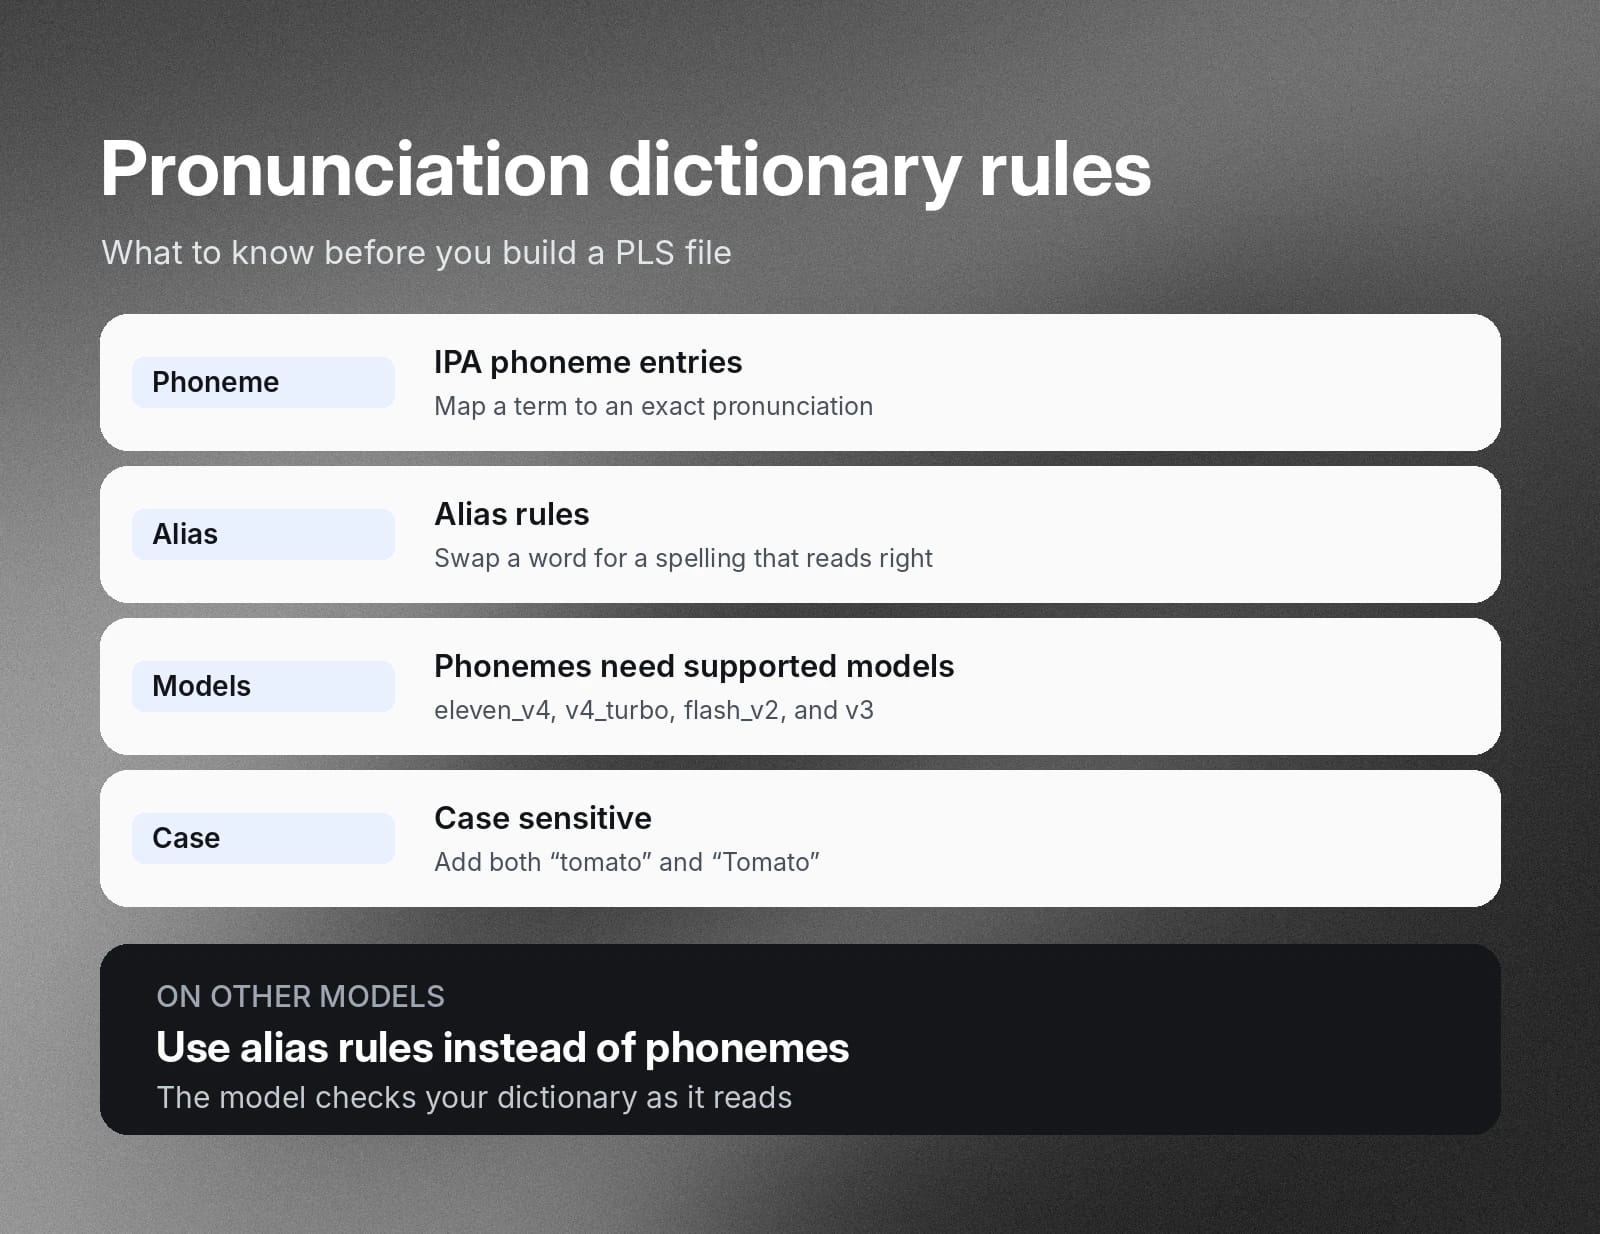
Das W3C-konforme Format Pronunciation Lexicon Specification (PLS) bietet eine Struktur, um diese Begriffe mithilfe der Notation des Internationalen Phonetischen Alphabets (IPA) bestimmten phonetischen Aussprachen zuzuordnen. Das Internationale Phonetische Alphabet ist ein standardisiertes Alphabet aller möglichen Sprachlaute. Das Sprachmodell prüft Ihr Wörterbuch beim Lesen des Skripts und verwendet die aufgeführten Aussprachen, sobald es Wörter aus Ihrem Wörterbuch findet. Phonemeinträge funktionieren nur mit den Modellen eleven_v4, eleven_v4_turbo, eleven_flash_v2 und eleven_v3. Verwenden Sie bei anderen Modellen stattdessen Alias-Regeln. PLS-Dateien unterscheiden zwischen Groß- und Kleinschreibung. Fügen Sie daher sowohl „tomato“ als auch „Tomato“ hinzu, wenn Sie beides benötigen.
Phonetische Skript-Tags
Phonetische Tags sind meist die bessere Wahl, wenn Sie einzelne Zeilen eines Skripts anpassen müssen. Statt ein Wörterbuch zu erstellen, verwenden Sie phonetische Inline-Tags, die das Sprachmodell gemäß dem IPA anweisen, ein Wort wie gewünscht auszusprechen.
Angenommen, Sie schreiben ein Podcast-Skript und möchten zwei- oder dreimal auf eine Branchenexpertin verweisen. Statt ihren Namen zu Ihrem unternehmensweiten Aussprachewörterbuch hinzuzufügen, versehen Sie ihn im Skript einfach mit der korrekten Aussprache.
Skripte schreiben und formatieren, die beim Vorlesen natürlich klingen
Wörterbücher und Tags sind nützlich, um Probleme mit einzelnen Wörtern in der Sprachausgabe zu lösen. Sie betreffen jedoch nicht die gesamte Sprechweise, Sprachmelodie und Sprechdynamik. Beim Schreiben eines Skripts sollten Sie berücksichtigen, dass es vorgelesen wird. Wortwahl, Formulierungen und Zeichensetzung sollten sich oft von Text unterscheiden, der nur gelesen werden soll.
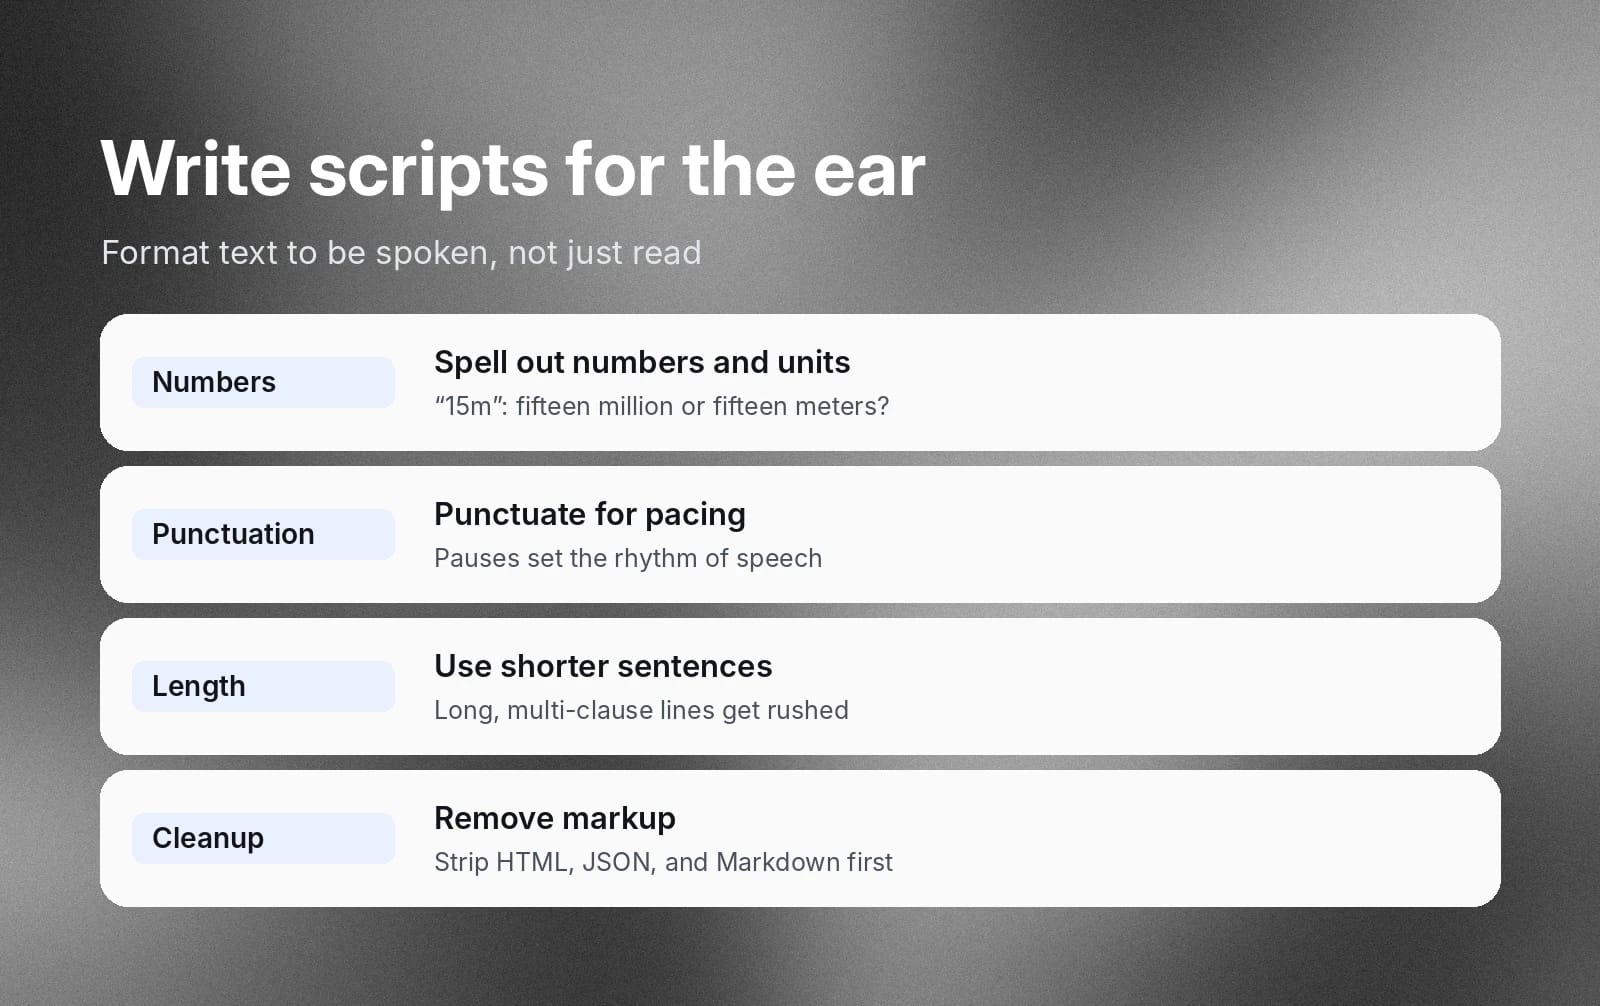
Für das Hören schreiben, nicht für das Lesen
Schreiben Sie Ihr Skript mit der Denkweise eines Redenschreibers: „Wie soll das vorgelesen werden? Wo machen wir für einen dramatischen Effekt eine Pause? Wo beschleunigen wir?“ Diese Fragen gelten für Skripte für fortschrittliche neuronale Sprachmodelle genauso wie für Skripte, die Sie für Menschen schreiben.
Zahlen, Währungen und Daten ausschreiben
Lassen Sie in Ihren Skripten keinen Interpretationsspielraum. Neuronale Sprachmodelle verstehen Kontext gut, funktionieren aber am besten, wenn sie nicht raten müssen. Abkürzungen und Kurzformen sind häufige Stolpersteine.
Ein Skript könnte zum Beispiel sagen: „Sie suchen nach einer Zahl nahe 15 m.“ Soll die TTS-Engine „fünfzehn Millionen“ oder „fünfzehn Meter“ sagen? Schreiben Sie es aus, damit das Modell nicht aus dem Kontext raten muss.
Normale Zeichensetzung zur Steuerung des Tempos verwenden
Zeichensetzung spielt in geschriebenem Text eine wichtige Rolle, ist aber in der Text-to-Speech-Synthese noch wichtiger. Sie steuert den Rhythmus. Sie kennzeichnet verschiedene Arten von Pausen, mit denen Sie komplexe Gedanken gliedern oder einfach eine natürliche Sprachmelodie beibehalten können, die angenehmer zu hören ist.
- Verwenden Sie Kommas für kurze Pausen innerhalb eines Satzes.
- Verwenden Sie Punkte als vollständigen Abschluss eines Gedankens.
- Verwenden Sie Auslassungspunkte und Gedankenstriche, um komplexe Ideen in der Mitte zu unterbrechen, damit Ihr Modell nicht gehetzt klingt.
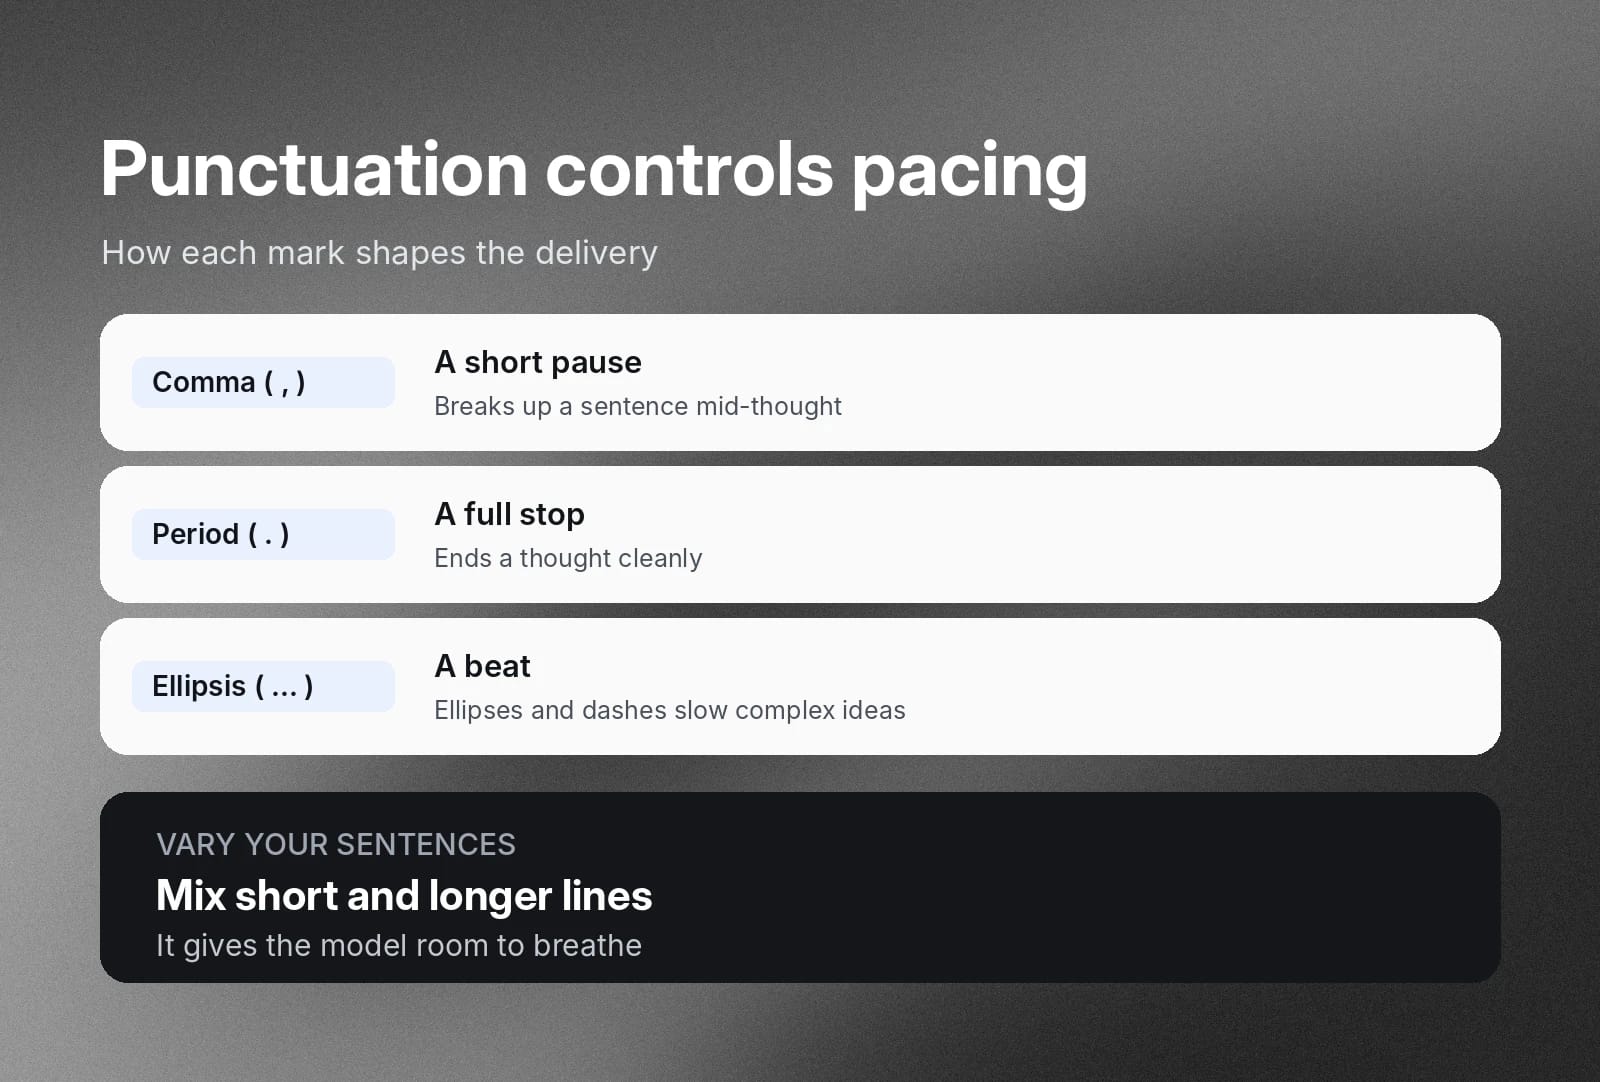
Kurze Sätze sind bessere Sätze
Modelle stolpern besonders leicht über lange Sätze mit Bedingungen und mehreren Teilsätzen oder sprechen sie zu schnell. Teilen Sie diese in kürzere Aussagen unterschiedlicher Länge auf. Das gibt dem Modell mehr Raum zum Atmen und verhindert, dass es bei der Suche nach einer Sprachmelodie für lange Schachtelsätze hetzt.
Formatierungs- und Markdown-Artefakte entfernen
Wenn Sie Sprache aus einem Content-Management-System oder einem anderen Geschäftssystem synthetisieren, kann der Text HTML, JSON, Markdown oder andere Formatierungen enthalten. Entfernen Sie diese und formatieren Sie den Inhalt als Text, um eine möglichst natürlich klingende Sprache zu erhalten. Sprachmodelle können Schwierigkeiten haben zu erkennen, wann sie solche Tags ignorieren, wörtlich vorlesen oder kontextbezogen in ihre Ausgabe einbeziehen sollen.
Mehr zu Falschaussprachen und anderen Problemen erfahren Sie im ElevenLabs-Leitfaden zur Fehlerbehebung.
Häufige ElevenLabs-API-Fehler beheben
Teams, die Sprach-Audio in großem Umfang produzieren, verbinden ihre Anwendungen typischerweise per API mit einem Sprachsynthesemodell. Das macht die Produktion insgesamt effizienter, fügt aber eine technische Ebene hinzu, die Sie zusätzlich zur Sprachausgabe des Modells verwalten müssen.
Die Referenz zu ElevenLabs-API-Fehlercodes behandelt Antwortcodes im Detail. Hier sind jedoch die vier häufigsten HTTP-Statuscodes bei der Fehlerbehebung von Text-to-Speech-Integrationen und wie Sie sie lösen.
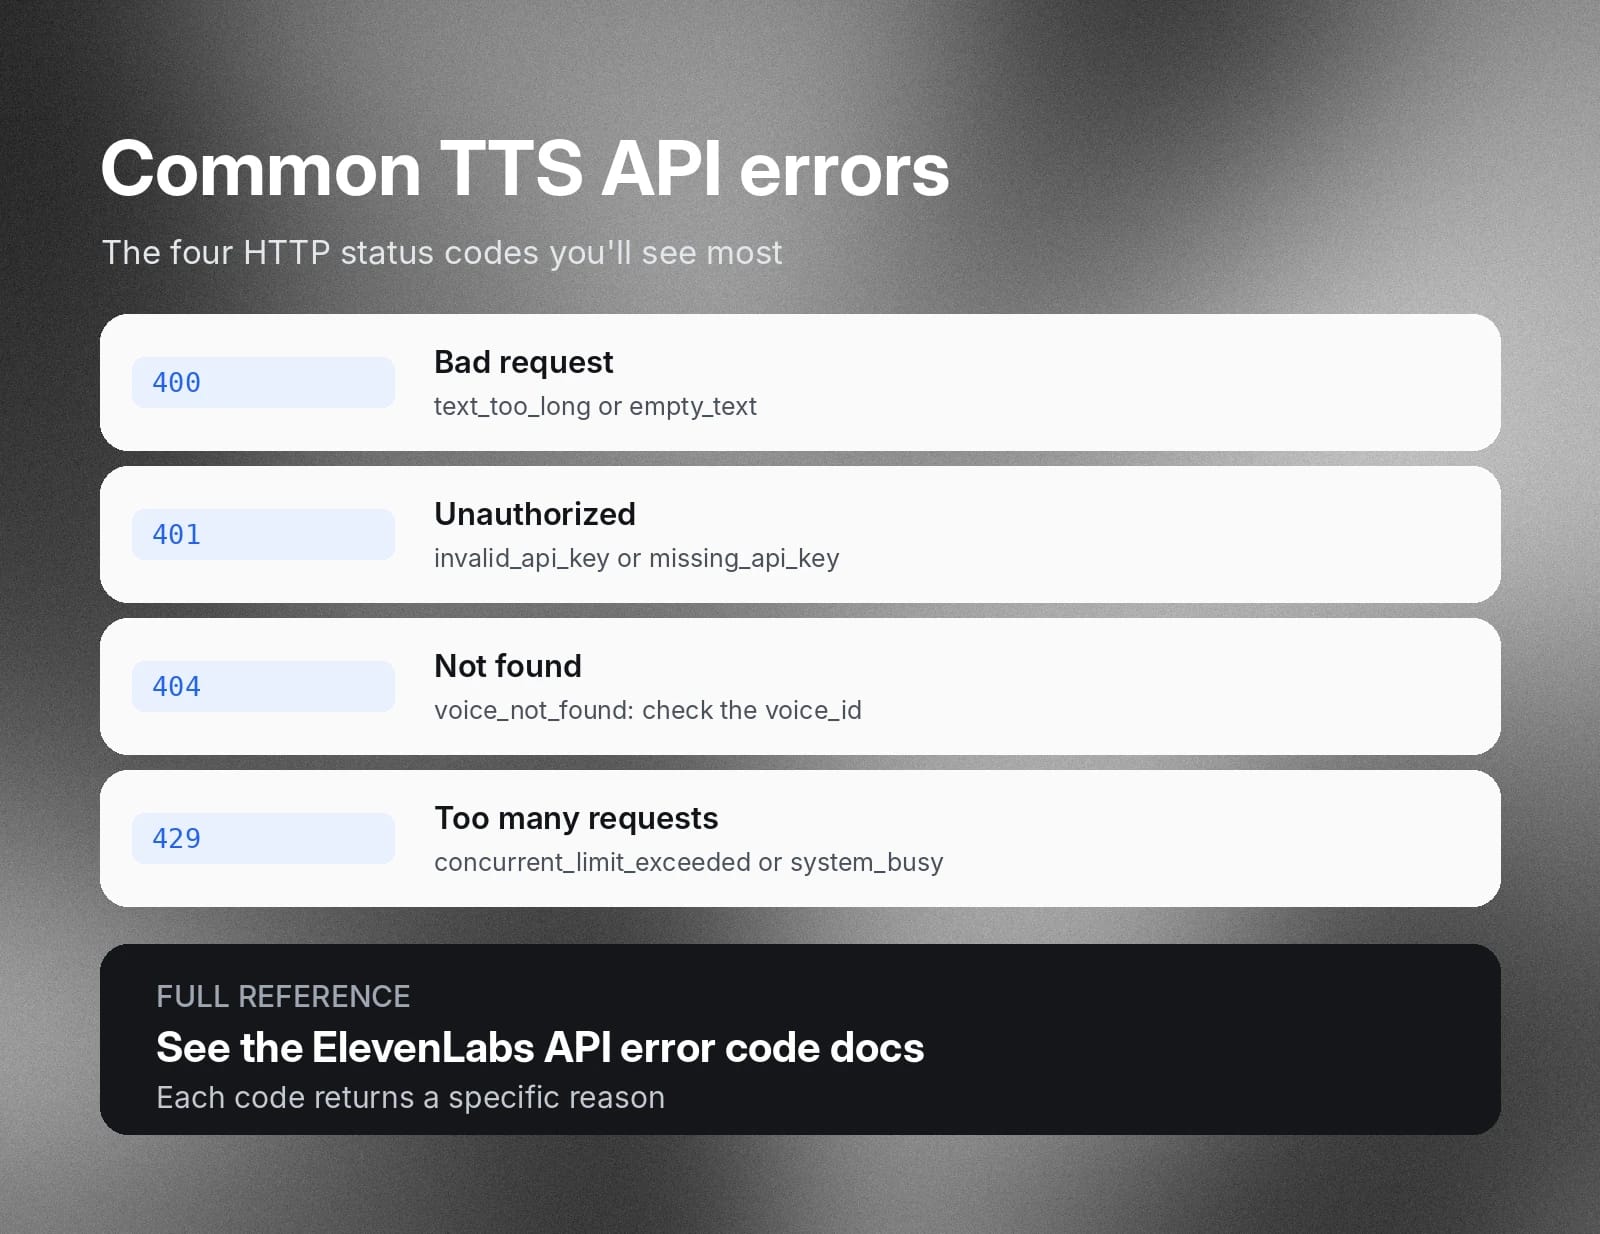
400 Bad Request (Payload-Fehler)
Ein Statuscode 400 von einer Sprachmodell-API bedeutet, dass Ihre Anwendung Daten gesendet hat, die das Modell nicht verarbeiten konnte. In TTS-Workflows liegt das meist daran, dass Zeichenlimits überschritten oder versehentlich leere Eingaben gesendet wurden.
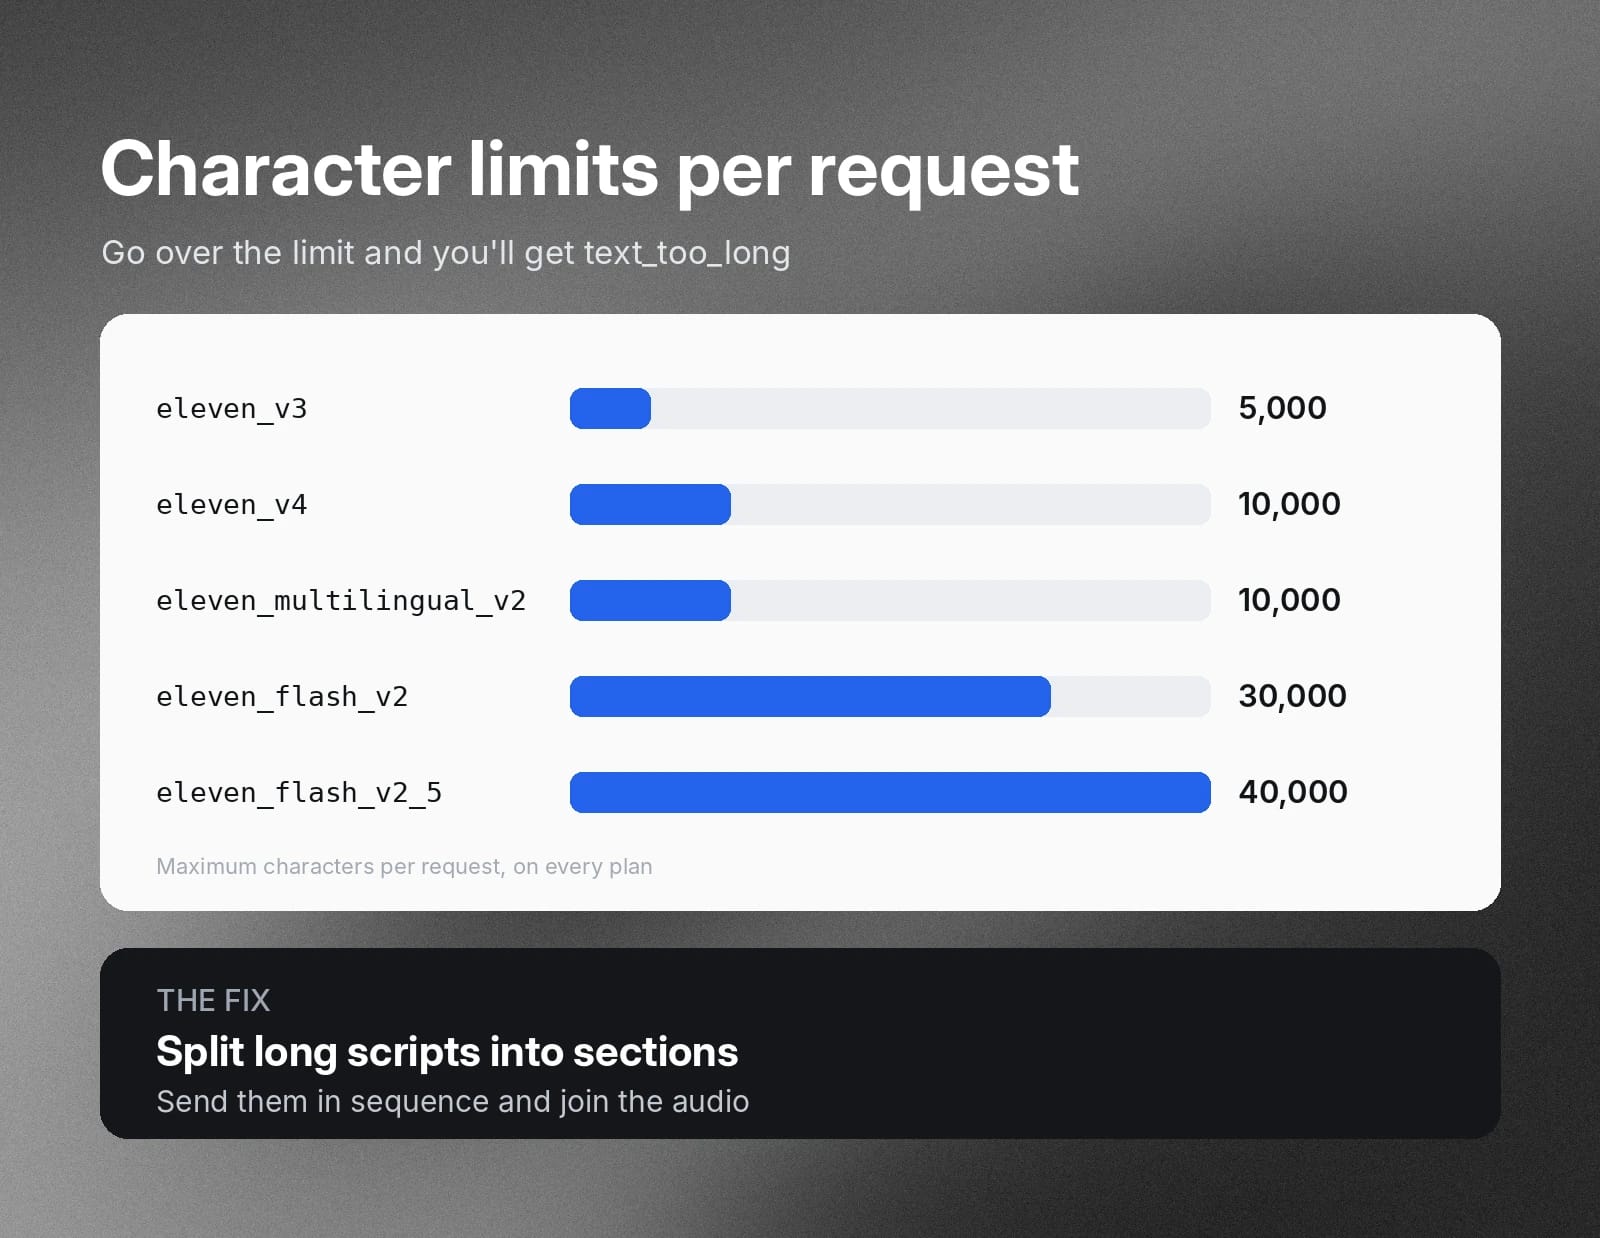
Zeichenlimit überschritten (text_too_long)
Jede TTS-Anfrage unterliegt einem vom Modell festgelegten Zeichenlimit. Wenn Sie mehr Text senden, als das Limit des Modells erlaubt, gibt der TTS-Server diesen Fehler zurück. Die Limits pro Anfrage betragen bei allen Tarifen 10.000 Zeichen für eleven_v4 und eleven_multilingual_v2, 5.000 für eleven_v3, 30.000 für eleven_flash_v2 und 40.000 für eleven_flash_v2_5. Teilen Sie längere Skripte in mehrere Abschnitte auf, die das Modell nacheinander verarbeiten kann.
Leere Texteingabe
Eine TTS-Engine weist alle Payloads zurück, die leere Zeichenfolgen enthalten (empty_text). Fügen Sie Ihrer Eingabepipeline Bereinigungsschritte hinzu, um leere Zeilen zu entfernen, damit der Server einen ansonsten funktionierenden Payload nicht zurückweist.
401 Unauthorized (Authentifizierungsprobleme)
Ein Fehlercode 401 bedeutet, dass das API-Gateway Ihre Zugangsdaten abgelehnt und Ihren Payload nicht an das Modell weitergeleitet hat. Das geschieht bei einem Problem mit dem API-Schlüssel.
Ungültiger API-Schlüssel
Ihre Anfrage an den Modellserver muss einen gültigen xi-api-key enthalten. Andernfalls gibt der Server einen Fehler 401 zurück. Prüfen Sie, ob Ihr Schlüssel tatsächlich in der Anfrage vorhanden ist und bei der Bereitstellung nicht widerrufen wurde, abgelaufen ist oder aus den Headern abgeschnitten wurde. Die API gibt invalid_api_key zurück, wenn der Schlüssel falsch ist, und missing_api_key, wenn keiner gesendet wurde.
404 Not Found (Nicht übereinstimmende Voice-Identifier)
Sie erhalten einen Fehler 404, wenn der Endpunkt die in der URL-Anfrage angegebene TTS-Ressource nicht finden kann. Das kann passieren, wenn Sie den falschen Parameter voice_id senden oder er in der Anfrage-URL fehlt. Stellen Sie sicher, dass Sie die richtige voice_id verwenden. Prüfen Sie, ob sie tatsächlich in den Pfadparametern vorhanden und nicht falsch geschrieben ist. Die API gibt voice_not_found zurück, wenn die Voice-ID nicht existiert.
429 Too Many Requests
Dieser Fehler hat zwei unterschiedliche Ursachen: Sie haben das Limit gleichzeitiger Anfragen für Ihre Servicestufe erreicht oder die TTS-Plattform drosselt Anfragen, um eine Lastspitze zu bewältigen.
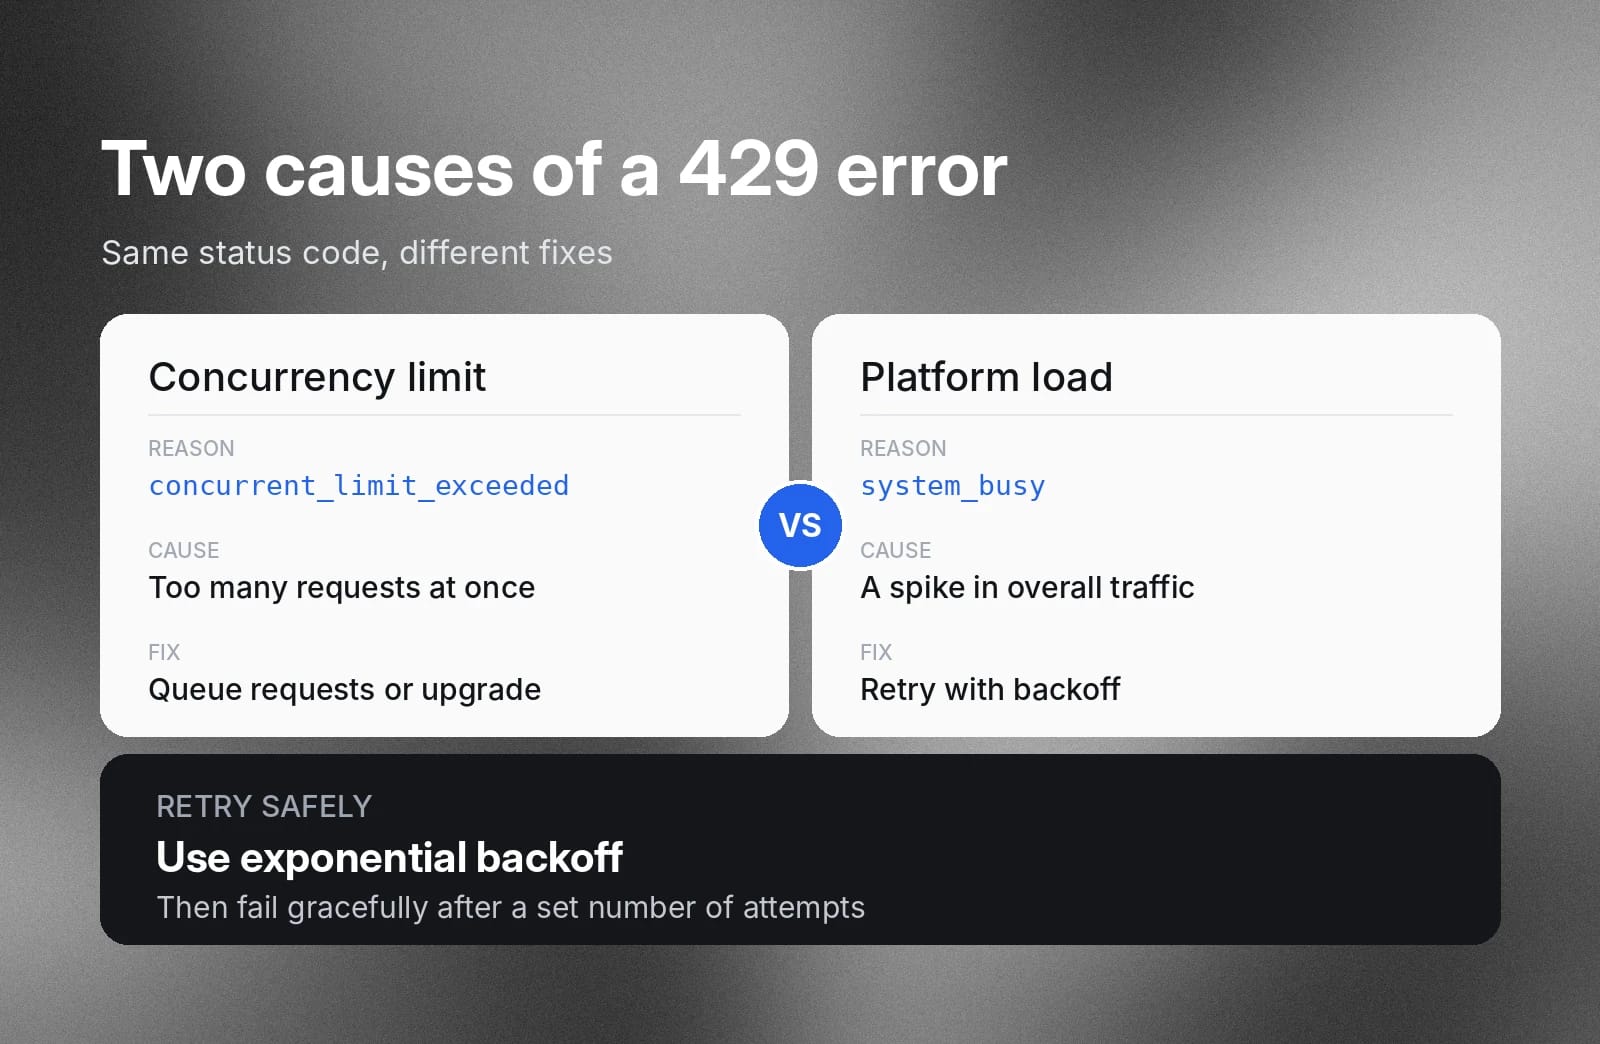
Limits für gleichzeitige Anfragen (concurrent_limit_exceeded)
Jede Abostufe einer TTS-Engine legt eine feste Anzahl gleichzeitiger Anfragen fest, die Sie senden können. Wenn Ihre Anwendungen dieses Limit überschreiten, gibt der Server diesen Typ von Fehler 429 zurück.
Erstellen Sie mit einem Dienst wie Redis eine asynchrone Warteschlange, um Ihre ausgehenden Payloads zu steuern, damit sie die Limits Ihrer Stufe nicht überschreiten. Prüfen Sie alternativ, ob sich ein Abonnement einer höheren Stufe rechnet.
Lastspitzen der Plattform (system_busy)
Unter hoher Last kann ein TTS-Server eingehende Anfragen drosseln, um die Leistung aufrechtzuerhalten. Implementieren Sie eine automatisierte Wiederholungslogik im API-Client Ihrer Anwendung. Stellen Sie sicher, dass sie Wiederholungen mit exponentiellem Backoff unterstützt und nach einer maximalen Anzahl von Versuchen kontrolliert fehlschlägt.
Stimmen, Sprachen und Einstellungen vor der Veröffentlichung testen
Ein schneller Test in der Web-App ist für TTS-Payloads im großen Maßstab meist keine ausreichende Qualitätskontrolle. Die Kosten schlechter Durchläufe können sich schnell summieren. Testen Sie Ihr Skript vor dem Absenden in einer Reihe kontrollierter Iterationen. Diese Vorbereitung hilft Ihnen, Sprach-Audio höchster Qualität effizienter zu produzieren.
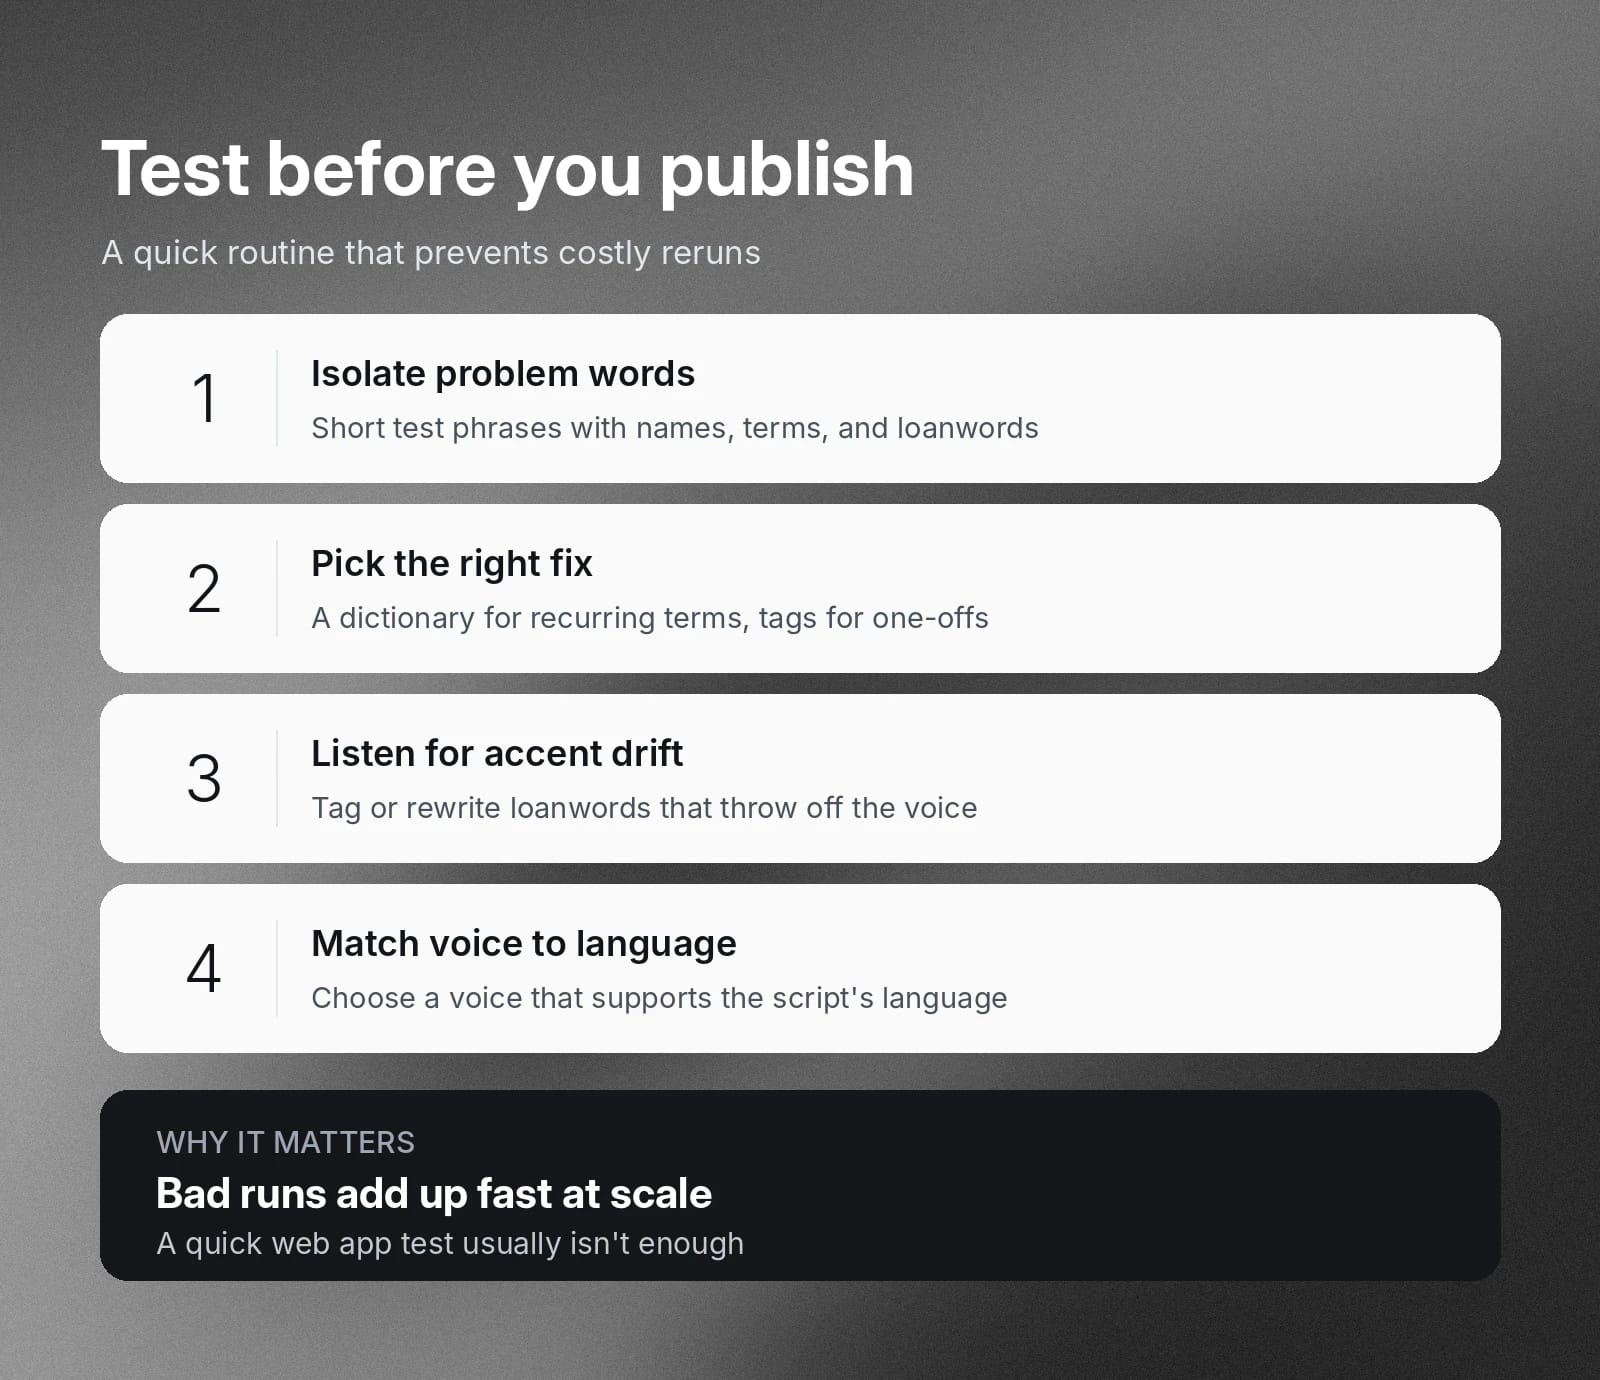
Problematische Wörter isoliert testen
Ihre Probleme betreffen meist bestimmte Passagen oder einzelne Wörter bzw. Namen, nicht den gesamten Text. Erstellen Sie Testphrasen mit fünf bis zehn Wörtern, die Ihre Markennamen, Fachbegriffe oder fremdsprachigen Ausdrücke enthalten. Entscheiden Sie anhand der Ausgaben, ob Sie für jeden Fall ein Aussprachewörterbuch oder nur phonetische Tags verwenden möchten.
Mögliche Abweichungen bei Sprache oder Akzent erkennen
Sprachmodelle können mitten im Satz gelegentlich eine ungewöhnliche oder langsame Sprachmelodie annehmen. Das geschieht oft, wenn das Modell raten muss, wie eine Passage auszusprechen ist, die von den Trainingsdaten abweicht.
- Lehnwörter: Texte mit seltenen Lehnwörtern aus einer Fremdsprache können die Graphemzuordnung eines Modells beeinträchtigen, sodass die gesamte nachfolgende Sprache einen ungewöhnlichen Akzent erhält. Verwenden Sie phonetische Tags für das Lehnwort oder formulieren Sie den Text um.
- Abgehackte nicht-englische Sprache: Ein für Englisch optimiertes Modell kann beim Lesen eines übersetzten Skripts stottern oder roboterhaft klingen. Wählen Sie ein Stimmprofil, das auch die jeweilige Muttersprache unterstützt.
Mit ElevenAPI zu zuverlässigerer Sprachausgabe starten
Wenn Sie wissen, worauf Sie achten müssen, erstellen Sie hochwertige Sprachinhalte schneller und mit weniger Aufwand. Erkennen Sie, wie Sie mit Ausgabeproblemen und technischen API-Problemen umgehen, die die Produktion verzögern könnten.
Erfahren Sie mehr über die Erstellung hochwertiger, präziser TTS-Inhalte mit ElevenAPI oder rufen Sie noch heute Ihren API-Schlüssel ab, um zu starten.
Häufig gestellte Fragen zu Text-to-Speech-Problemen

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.