什么是对话式 AI 中的轮次交替:自然对话指南
- 发布时间
优质客户服务需要出色的对话能力。其中最重要的一项,就是学会倾听并知道何时开口。否则,客服人员可能会打断已经感到沮丧的客户,他们或许已多次来电说明问题。
对话式 AI 中的轮次交替同样遵循这一标准。对话式 AI 智能体必须在两者之间找到微妙平衡:既要留出足够时间让对方说话,也不能沉默太久,以免延迟和冷场降低对话质量。
因此,现代对话轮次交替要求模型快速判断语音意图,而非使用严格的静音计时器。ElevenLabs 的统一架构通过持续分析语调、节奏和词语上下文,让对话始终顺畅自然。
摘要
- 客服团队部署经过轮次交替训练的语音智能体,以更少阻碍快速解决问题。
- 轮次交替帮助模型判断何时回复或互动、何时继续发言,以及何时倾听或保持沉默。
- AI 智能体 借助自适应时机、语音活动检测和语义分析,维持自然的对话流程。
- 工程团队通过跟踪响应延迟和打断率来衡量对话流畅度,并优化 workflow。
什么是对话式 AI 中的轮次交替?
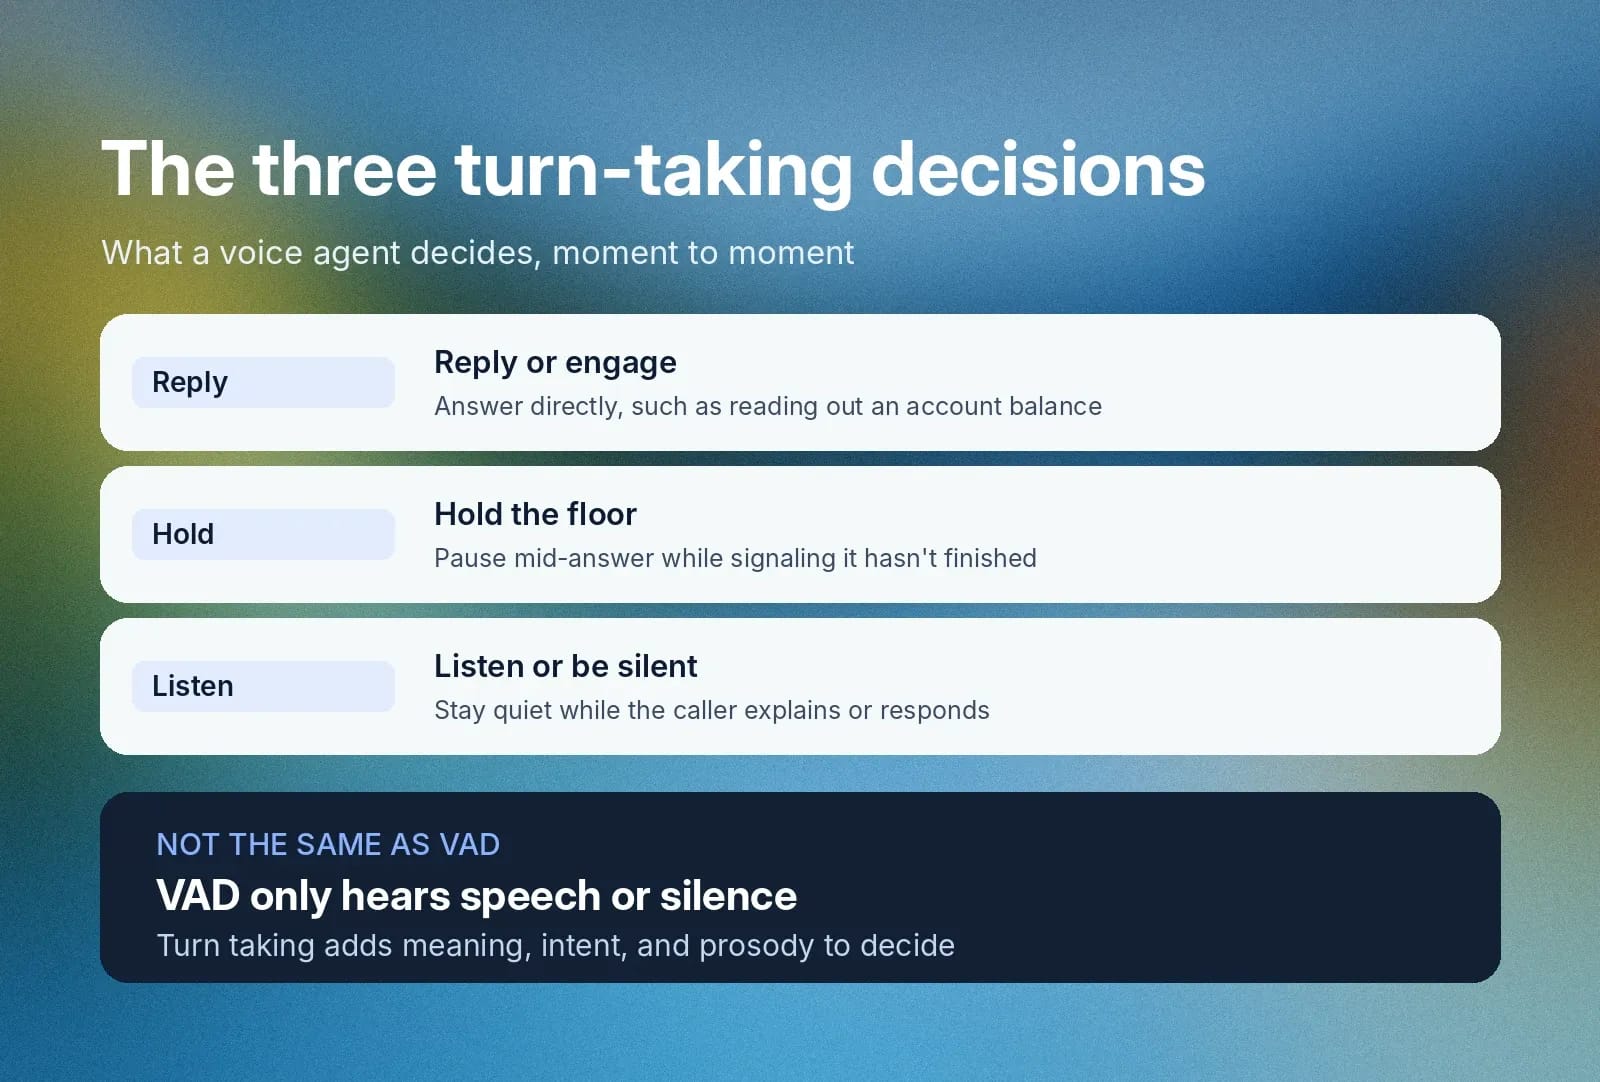
当对话式 AI 模型进行轮次交替时,会遵循一套规则来确定以下行为的最佳时机:
- 回复或互动:此时,AI 智能体直接回答问题。例如,客户询问账户余额,系统回复:“账户余额为 $57.34。”
- 继续发言:此时,模型会继续说话,并在停顿时表明自己尚未说完。例如,客户询问账户余额,它回复:“首先,我来根据你提交的信息查询账户…… [pause]。账户余额是 $57.34,不过…… [pause] 我还看到有一笔相同金额的待处理付款。你来电是想确认这笔付款何时到账,以及是否不会收取滞纳金吗?”
- 倾听或保持沉默:此时,智能体会保持沉默,等待客户说明情况或作出回应。例如,客户确认自己想了解付款是否已到账,因为提交付款已经好几天了。AI 模型回复:“是的,我看到你提交付款至今已有 2 天。通常需要 3 天处理,因此应会在明天上午到账。不会收取滞纳金。还需要其他帮助吗?”
开发者文档通常将此称为轮次检测或轮次结束检测。将语音活动检测与语言理解相结合、用于判断说话者是否已说完的系统,通常称为语义 VAD。
这种流畅维持客户对话的方式,摒弃了生硬的对讲机式交流,让语音智能体能够自然交谈。
还需注意,这种三点式对话 AI 决策层不同于原始语音活动检测(VAD)。VAD 仅将音频分类为语音或静音,而对话轮次交替除原始信号外,还会考虑语义上下文、意图和韵律。查看我们的 VAD 指南,深入了解语音检测算法的工作原理及其必要性。
自然轮次交替为何对语音智能体至关重要
糟糕的轮次交替最容易惹恼客户,尤其是那些本就不愿与功能较弱的机器人交流的客户。过时的对话式 AI 智能体会抢话、长时间尴尬停顿,或跟不上对话节奏。
ElevenAgents 使用自适应时机,让自动化智能体保持自然的来回对话节奏。精准的时机能建立客户对模型能力的信任,进而增强他们对所部署技术及品牌客户服务承诺的信任。
使用搭载 ElevenAgents 的 Eleven v4 Turbo 时,智能体从收到请求到发出可听语音的中位时间为 142 ms。
此外,时机恰当的对话轮次交替可让客户持续参与,在首次沟通中解决问题,无需升级至人工客服。
实时对话轮次交替的工作原理
实时对话轮次交替采用多层处理管线,持续分析实时音频。模型还会结合多项规则,确定维持流畅对话的最佳行动。ElevenAgents 通过 3 个不同阶段处理这些任务,让每次交流都自然且响应迅速。
检测语音、静音和意图
语音活动检测每秒数十次解读并将输入音频流分类为语音或静音。VAD 提供原始信号后,意图检测会判断说话者是真的结束发言,还是只是停下来思考。用于确认轮次结束的因素可能包括降调或语法完整的句子。相反,句末拖长的音调或“嗯……”和“就是……”等填充词,可能表明只是暂时停顿。
决定何时响应
响应延迟可能导致来电者放弃对话,因此模型何时响应的决策是成功的关键因素之一。传统语音架构常依赖限制性计时器,判断对方是否真正停止说话,但这可能在对方想再次发言时打断他们,或造成令人不适的沉默。现代对话式 AI 的轮次交替通过深度学习,充分理解韵律、语速和填充词等线索。
管理从倾听到语音输出的响应延迟
根据《Journal of Cognition》发表的语言学研究,人类说话者之间的轮次间隔在不同文化中平均约为200 ms。因此,响应明显更慢的模型会造成尴尬停顿,引发不耐烦并提高通话放弃率。
处理打断、附和和语音重叠
服务提供商及其编程对话式 AI 模型的方式,决定了智能体处理打断、附和和语音重叠的能力。
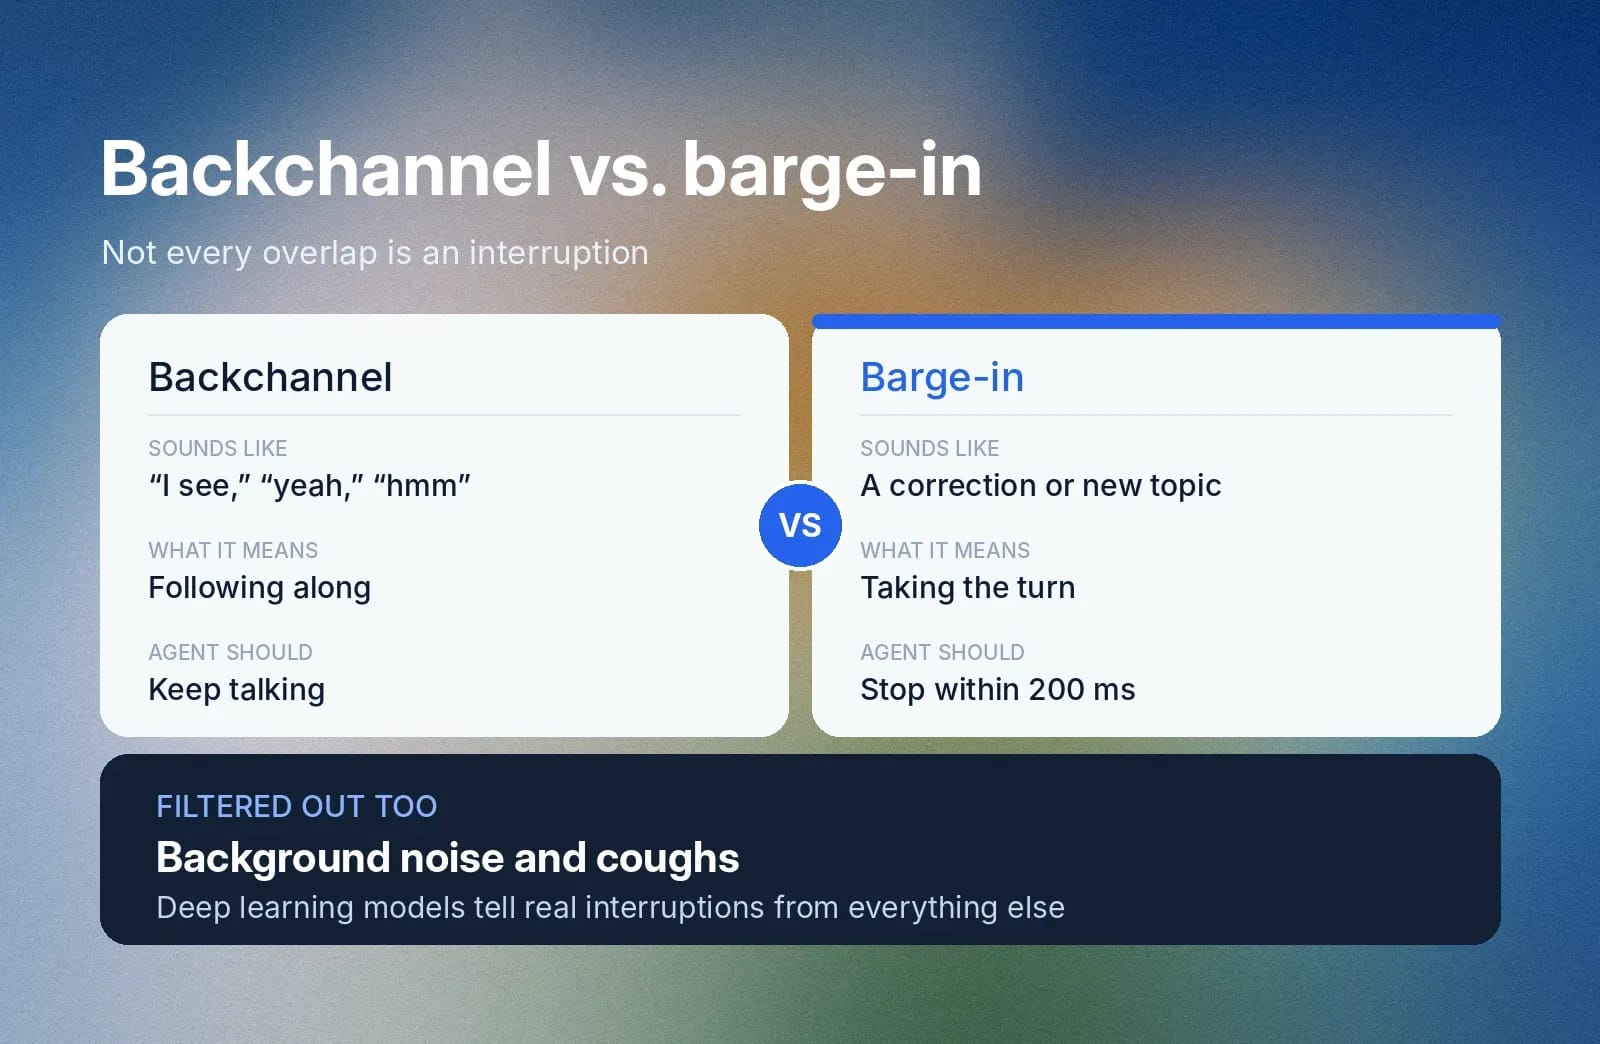
附和是指听者使用“我明白”或“对”等简短确认音或词语,表明自己在跟随对话,但并不接过话轮。语音智能体需要理解这些信号,继续说话,而不是将其视为插话。
ElevenAgents 能处理实时语音重叠:当来电者确实打断时,会立即让出话轮。若来电者插话,例如纠正账户信息或改变话题,ElevenAgents 会在不到 200 ms 内发送终止信号。这会让智能体在说到一半时停止,而不是继续完成原计划的句子。
我们的深度学习模型还会持续过滤背景噪声,并区分真正的打断与表示确认或思考的填充词。例如,智能体说话时,用户说“我明白……”或“嗯……”会产生语音重叠,但并非想要插话。
即使在高意图插话时刻,这类功能也能帮助语音智能体维持精准响应时间和自然节奏。
常见的轮次交替故障及预防方法
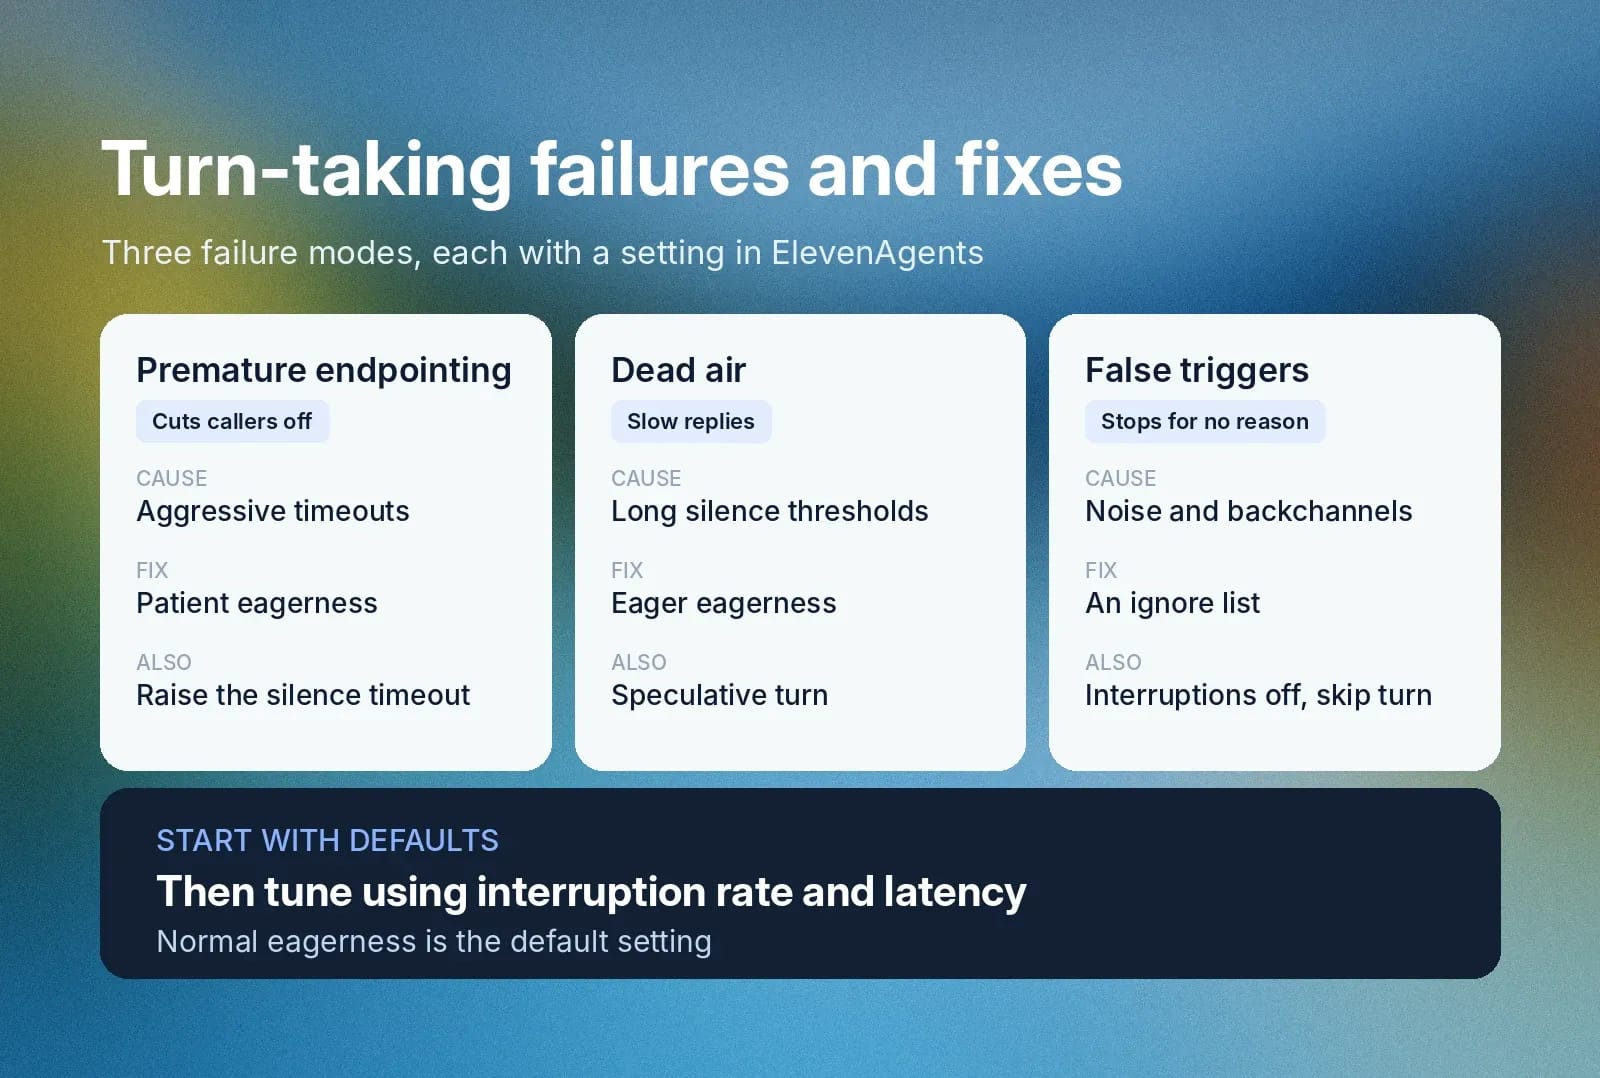
设置语音智能体时,工程团队需要考虑对话式 AI 模型的 3 种主要故障模式:
- 过早判定结束:过于激进的超时设置可能让模型误将来电者在句中思考或查找信息时的停顿判定为轮次结束,导致语音智能体频繁打断客户并使其感到沮丧。
- 冷场和响应延迟:过高的静音阈值会导致长时间尴尬停顿,增加挂断率。这些延迟会让语音智能体显得缓慢、响应不及时,损害客户体验和品牌形象。
- 填充词和噪声引发误触发:调优不佳的模型还可能将环境噪声、咳嗽声和听者附和误判为真正的打断,导致客户实际上只是在倾听、无意打断时,模型不必要地暂停或停止。
工程师可部署采用上下文语言模型的 ElevenAgents 来避免这些问题。这种结合 VAD 的自适应方法可减少误截断、响应过慢和对背景噪声过度敏感的问题。
如何在 ElevenAgents 中配置轮次交替
轮次交替的合适设置取决于使用场景及智能体通常接听的电话类型。ElevenAgents 支持团队在智能体设置中微调上述每种故障模式。
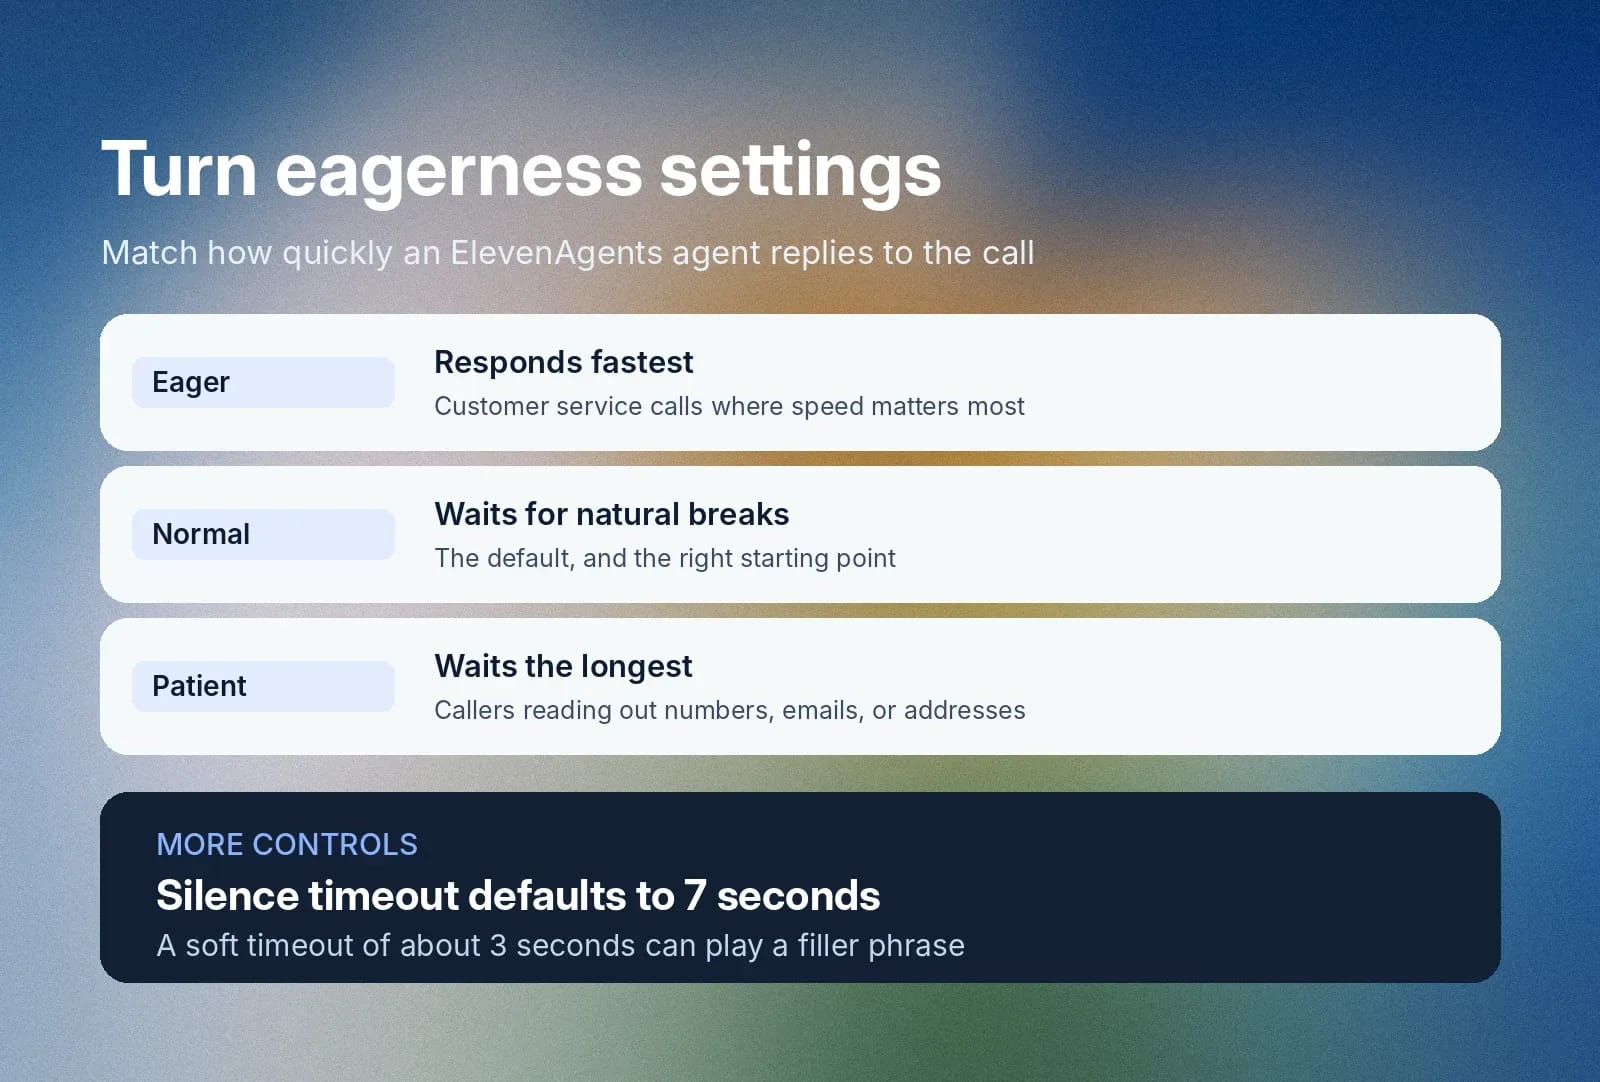
- 过早判定结束:当来电者念出电话号码、电子邮箱、地址或其他敏感信息时,将轮次积极度设为 Patient。积极度分为 3 个级别:Eager 响应更快,Normal(默认)等待自然停顿,Patient 等待时间最长。还可根据使用场景调整静音超时,例如响应迅速的客服使用 5–10 秒,免责声明使用 15–30 秒。默认值和建议范围因渠道和场景而异。
- 冷场和响应延迟:对于重视速度的客服通话,使用 Eager 积极度。推测性轮次会在智能体尚未确定来电者是否说完前,就启动语言模型生成回复,从而降低延迟,但也可能提高 LLM 成本。模型响应较慢时,软超时还可播放简短填充语,建议设为 3 秒。
- 误触发和不必要的打断:将“对”等确认词添加到忽略列表,避免打断智能体。如果每个词都必须听清,例如朗读法律免责声明时,可关闭打断功能。智能体仍可转录来电者所说内容,并在下一轮传递。对于“给我一分钟”这类短语,跳过轮次工具会让智能体保持安静,并可在设定时间后再次确认。
要充分发挥这些设置的作用,可将其与 Workflows 结合,让智能体动态切换轮次积极度。例如,日常对话时使用 Normal,进入收集电话号码的步骤时切换为 Patient。先使用默认设置,再根据下方的打断率和响应延迟指标调整积极度和超时设置。
如何衡量对话式 AI 的轮次交替质量
质量保证团队需要具体的运营指标来评估对话式 AI 的轮次交替。这要求将关注点从技术和配置转向实际影响。简单说,他们需要衡量的不只是“感觉自然”与否。
打断率和响应延迟是需要关注的两项主要指标。打断率衡量模型错误截断来电者的频率;响应延迟则跟踪对方停止说话并期待回应后,模型需要多久才作出响应。ElevenAgents 会记录每通电话的这两项指标,团队可利用数据优化语音活动检测阈值,无需依赖人工审核转录文本。查看我们的衡量对话式 AI 指南,全面了解评估框架。
QA 团队通过制定结构化的模型评估周期来维持高准确率。以下是典型团队使用的计划示例。
评估活动
频率
QA 目标
运营监控
每周
跟踪实时表现,发现线上语音智能体的时机问题
用户满意度评估
每月
分析来电者情绪,微调轮次交替配置
全系统基准测试
每季度
评估端到端准确率、对话轮次交替和响应延迟阈值
最后,即使已有自动化指标,QA 团队仍应抽取部分数据进行人工审核。检查原始音频文件而不只看文本转录,可获得更准确的数据。因为文本转录增加了一层自动化,可能漏掉转录工具产生的错误,尤其是在语音重叠时。

使用 ElevenAgents 开始自然的语音对话
能快速解决问题的类人语音智能体,可在降低成本的同时提升运营效率。但要获得这些优势,需要使用可微调的先进 AI 模型,正确处理轮次交替。工程团队可通过部署 ElevenAgents 实现这一点。我们的统一架构结合语音活动检测与语义理解,维持自然对话流程并降低延迟。
查看我们的ElevenAgents 轮次检测文档,为客户支持团队配置自然的对话轮次交替,或注册开始使用。
常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。