推出 Scribe v3 和 v3 Live:迄今最准确的语音转文本模型
- 作者
- Min Kim
- 发布时间
- 最近更新
收听收听本文
以音频为核心的产品都始于文字转录:会议纪要、语音智能体、配音、临床文档,以及跨越数十年内容的广播档案。首次就获得正确转录至关重要,因为每个错误都会流向后续环节,修复成本也更高。
但现实世界的音频往往很复杂:会议中多人同时说话,繁忙街道上的客户说到半句停顿,或客服通话中双方都不使用母语交流。
今天,ElevenLabs 推出两款专为这些场景打造的新语音转文本模型:
- 用于录音的 Scribe v3 在 102 种语言中比 Scribe v2 少 27% 的词错误,且拥有我们测试过的所有模型中最准确的说话人标签,
- Scribe v3 Live 是面向实时音频的低延迟版本,比 Scribe v2 Realtime 少出错 43%。它还首次提供说话人分离(标记每句话由谁说出),并改进了轮次检测。
Scribe v3 Live 现已在 ElevenAgents 中提供。两款模型也可通过 ElevenAPI 使用;从 Scribe v2 切换只需修改一行模型 ID。
塑造 Scribe v3 的反馈
Scribe 已为会议纪要应用、联络中心、临床文档工具和语音智能体提供数亿小时的转录服务。不同应用场景的团队不断提出同样的 5 项需求。
会议和笔记团队希望在快速交谈及 3 位或更多说话人的情况下获得更好的说话人分离效果。语音智能体团队表示,当来电者在句中停顿或放慢速度读出数字时,静音计时器会中断他们。构建实时产品的团队为了速度牺牲了准确性,因为实时转录的表现明显不如批量转录。印度客户希望印地语能与英语表现一致,即使来电者在句中切换两种语言。还有许多人希望对输出有更多控制,从将数字写成“123”,到可容纳产品目录或药品名称列表的长关键术语列表。
说话人标签、轮次检测及更灵活的输出控制
拥挤环境下依然可靠的说话人分离
在会议转录中,识别正确的说话人与识别正确的词同样重要。对于 3 位或更多说话人的录音——也是多数现有模型容易失效的场景——Scribe v3 的说话人分离错误比 Scribe v2 少 17%。Scribe v3 Live 也首次将说话人分离引入实时转录,其错误比我们测试中次优的实时模型少 39%。
理解对话的轮次检测
要让对话自然,语音智能体需要准确预测说话人何时讲完。传统轮次交接系统依靠静音时长判断。但仅凭静音会带来取舍:阈值过短可能打断句中停顿的人,过长又会让智能体显得迟缓。Scribe v3 Live 会结合对话上下文和音频判断,因此来电者读到一半数字时停顿也不会被打断。这也是 ElevenAgents 已在使用的轮次检测功能,现在已在 ElevenAPI 中提供。
更灵活地控制语言、术语和格式
Scribe v3 可推断录音中可能包含的语言,并让你选择将数字输出为阿拉伯数字还是文字。关键术语提示最多可添加 1,000 个确定会出现的术语,例如品牌名称、缩略词和行业术语;转录编辑则可应用以自然英语编写的格式规则,例如“将所有日期写为 YYYY-MM-DD”。
Scribe v3 Live 为句中切换语言的对话新增多语言模式,还为词汇量过大、不适合列表的情况新增关键术语库。关键术语提示覆盖你确定会出现的术语;关键术语库则收录数千个可能出现的术语,模型仅在听到可能匹配的内容时才会查询。
Scribe v3 表现如何
ElevenLabs 在相同数据集上评估了两款模型,并与 Scribe v2、Scribe v2 Realtime 及其他热门语音转文本模型进行对比。多语言准确性基于内部版本的 FLEURS 基准测试衡量,该测试覆盖 102 种语言的简短、清晰朗读语音。由于每个片段仅有 1 位说话人,FLEURS 无法衡量说话人分离,因此我们还构建了自有数据集,涵盖 16 种语言的真实会议、智能体通话和语音笔记。我们很快会将其开源。
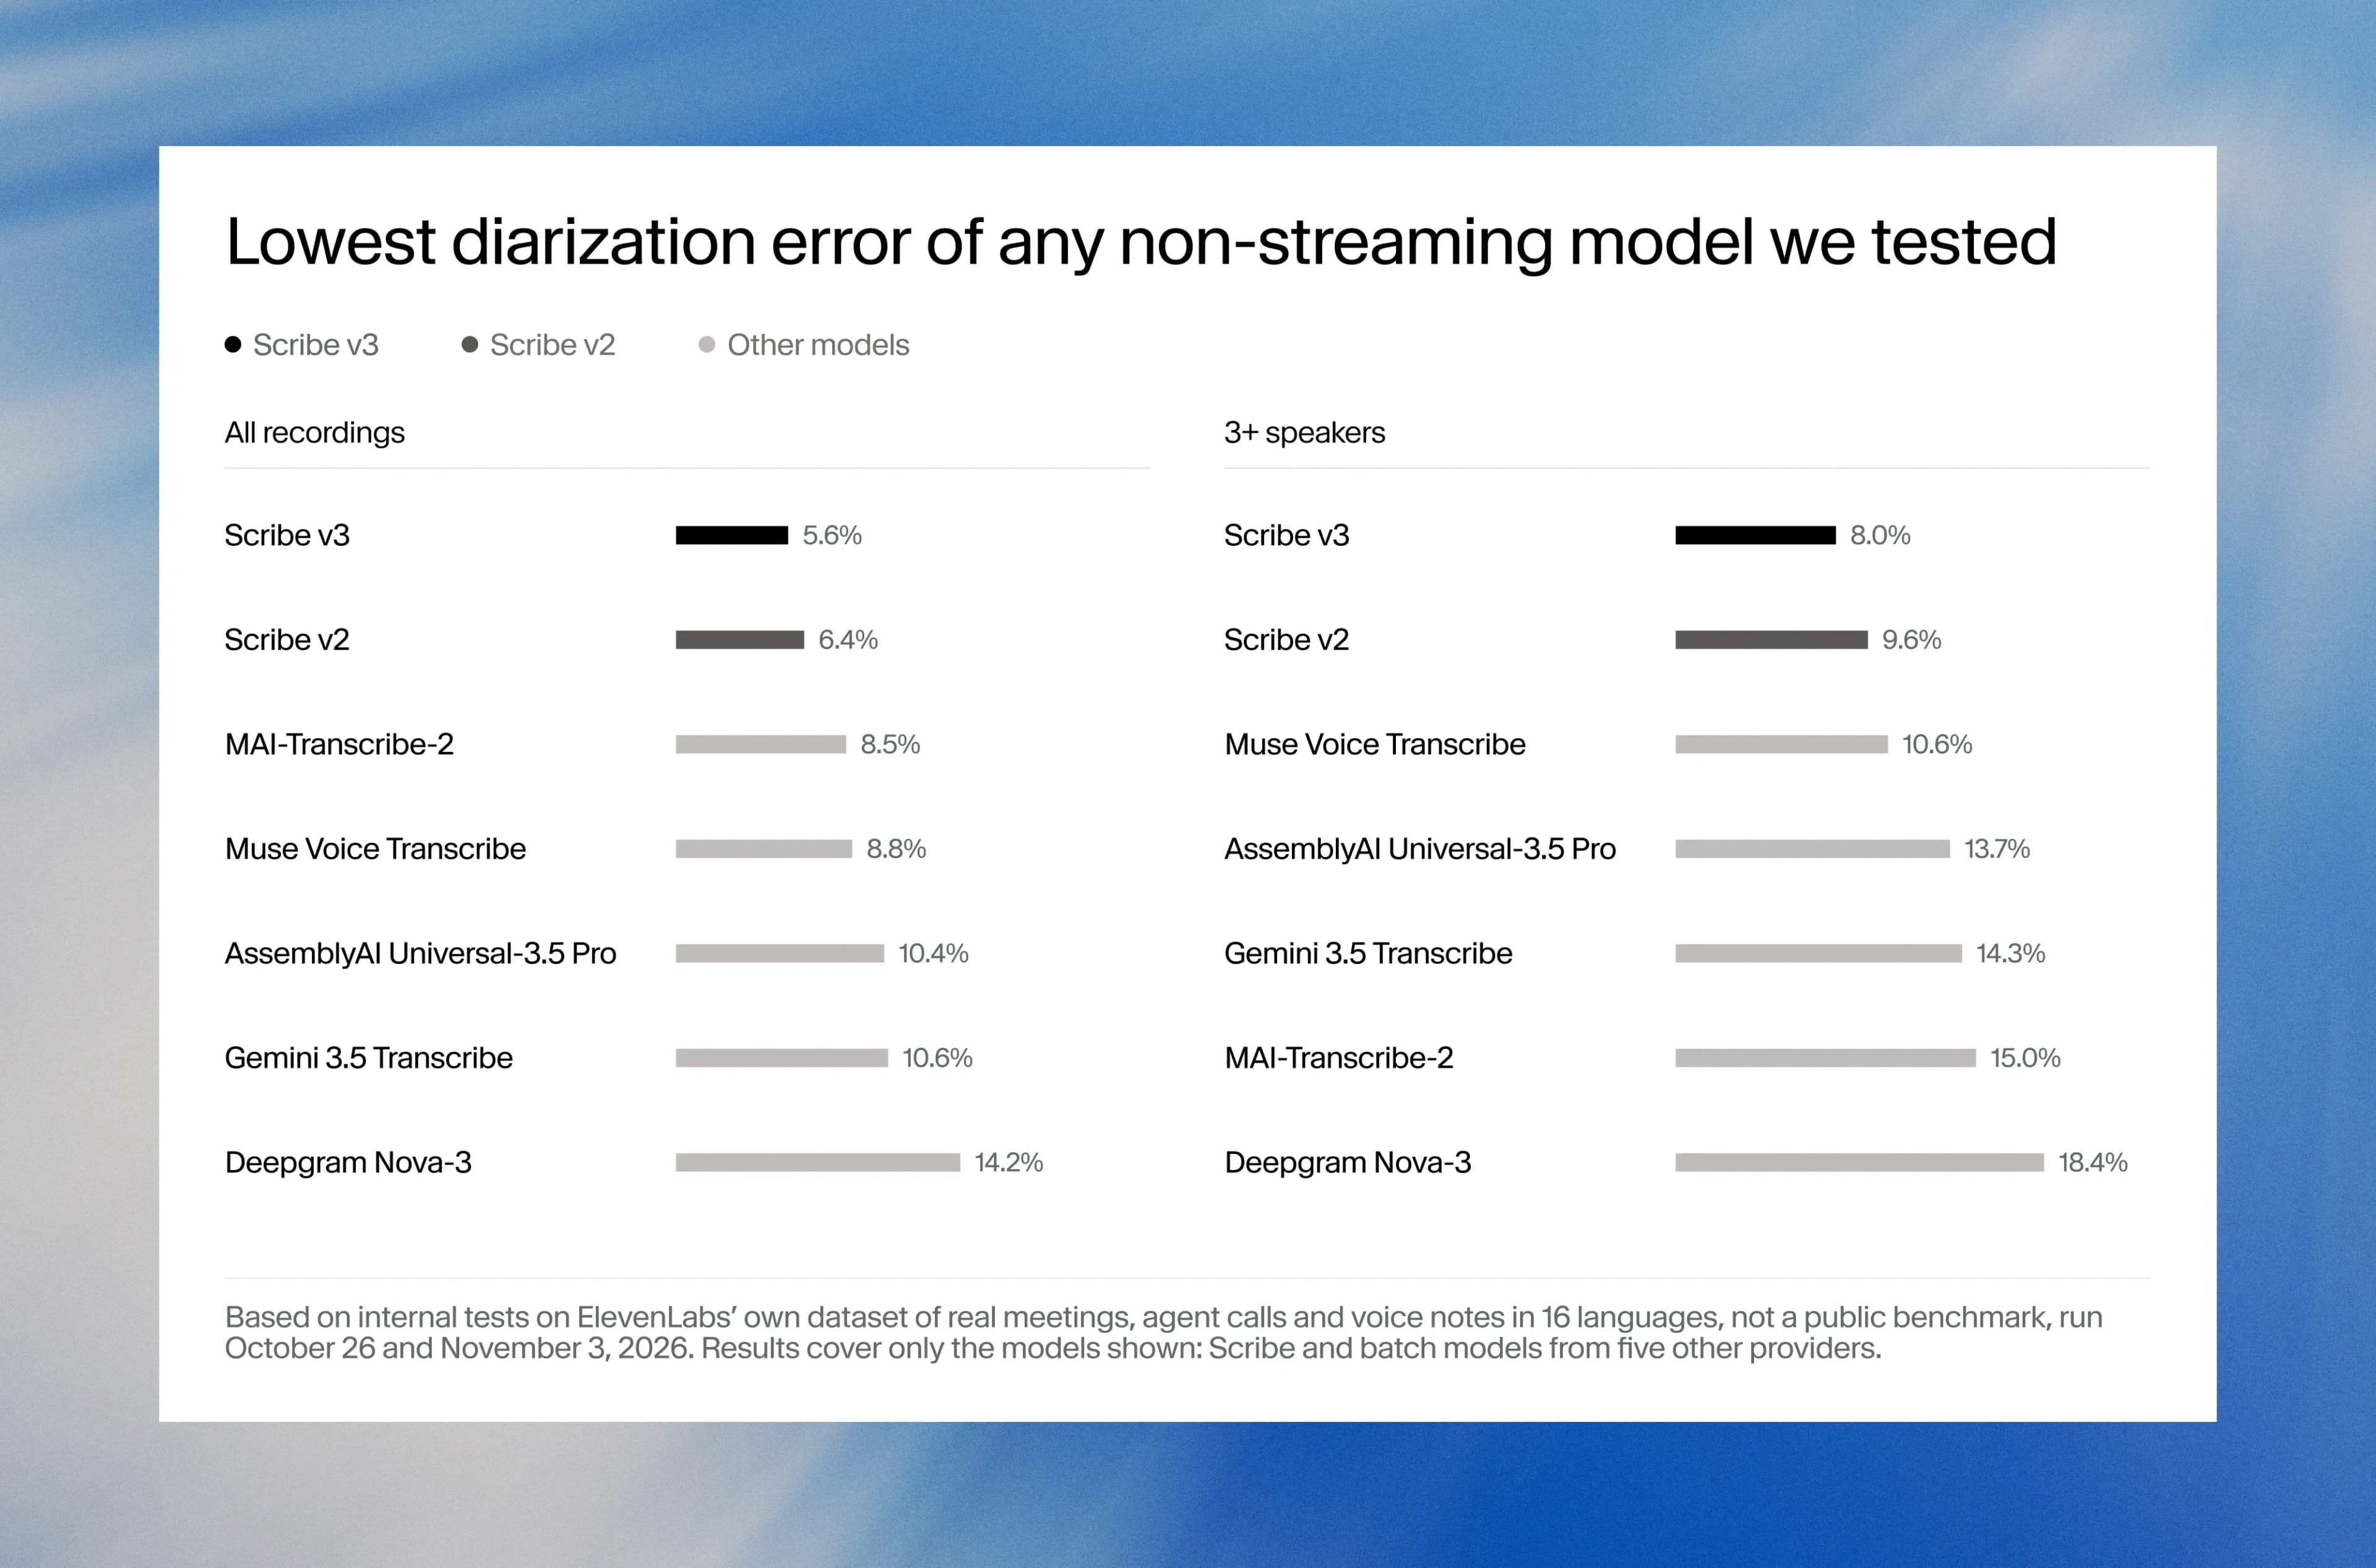
说话人分离
Scribe v3 的说话人分离错误率是我们测试的所有模型中最低的:总体比 Scribe v2 少 12%,在 3 位或更多说话人的录音中少 17%。
多语言转录准确性
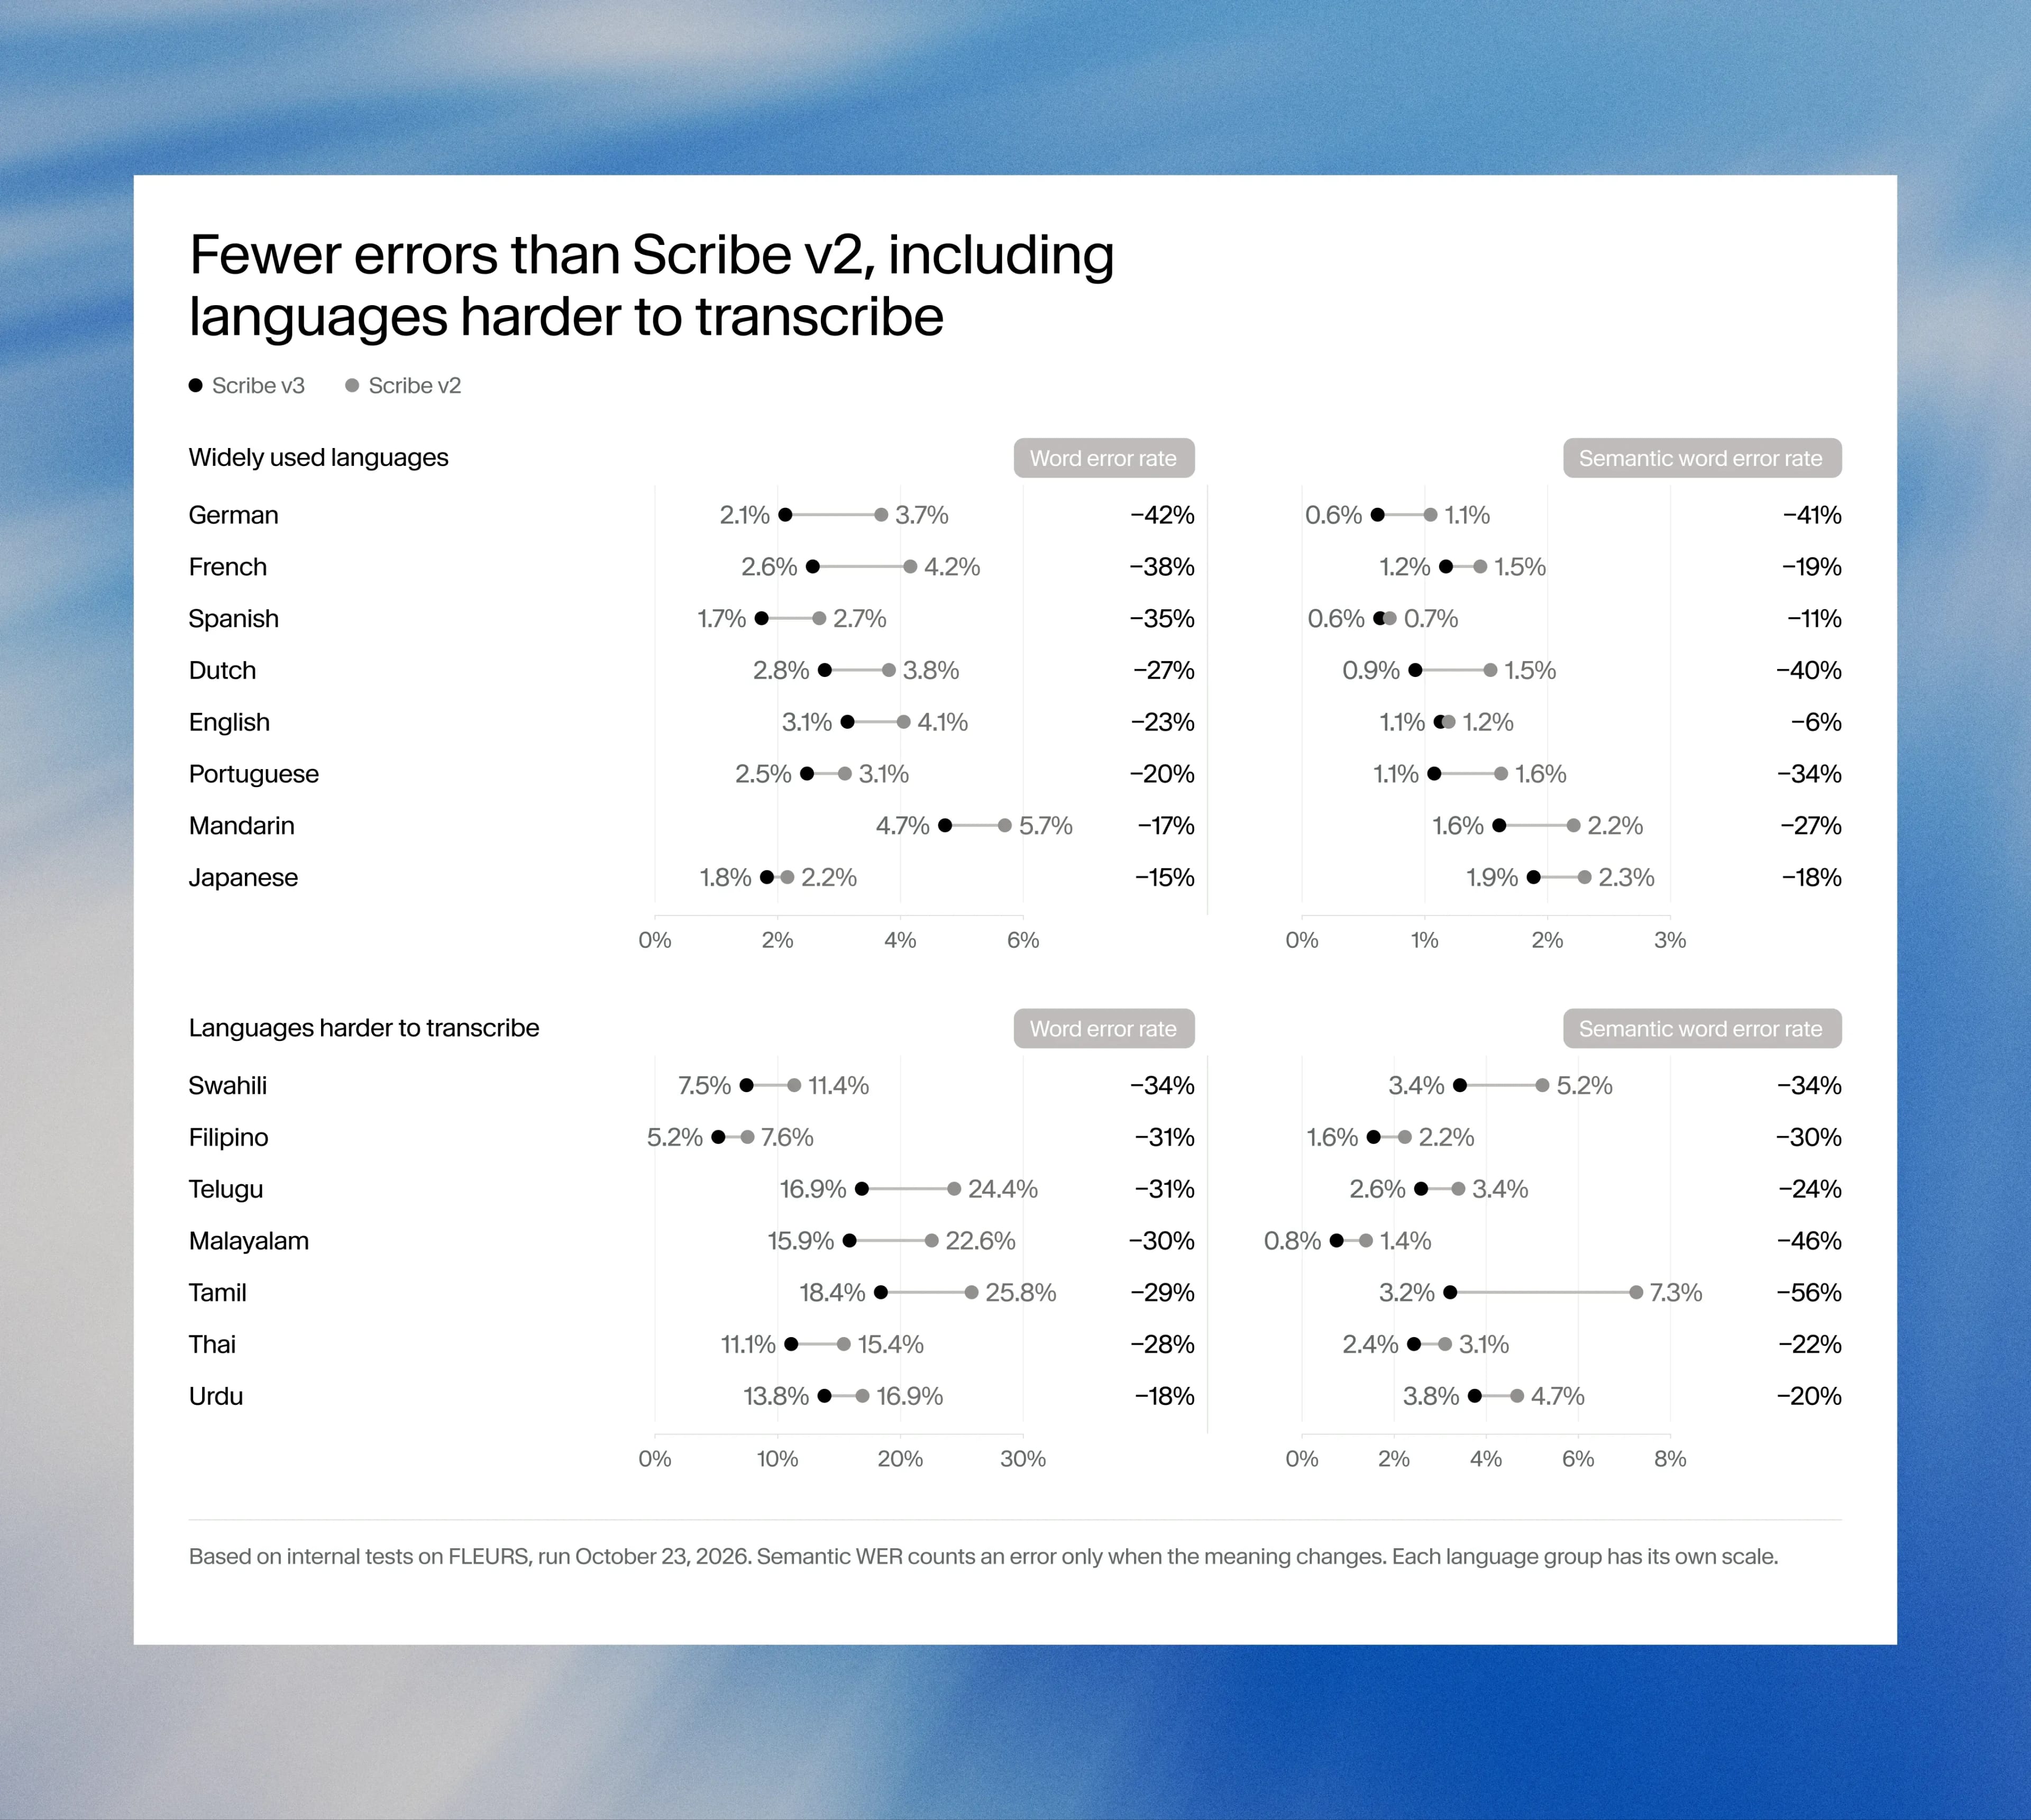
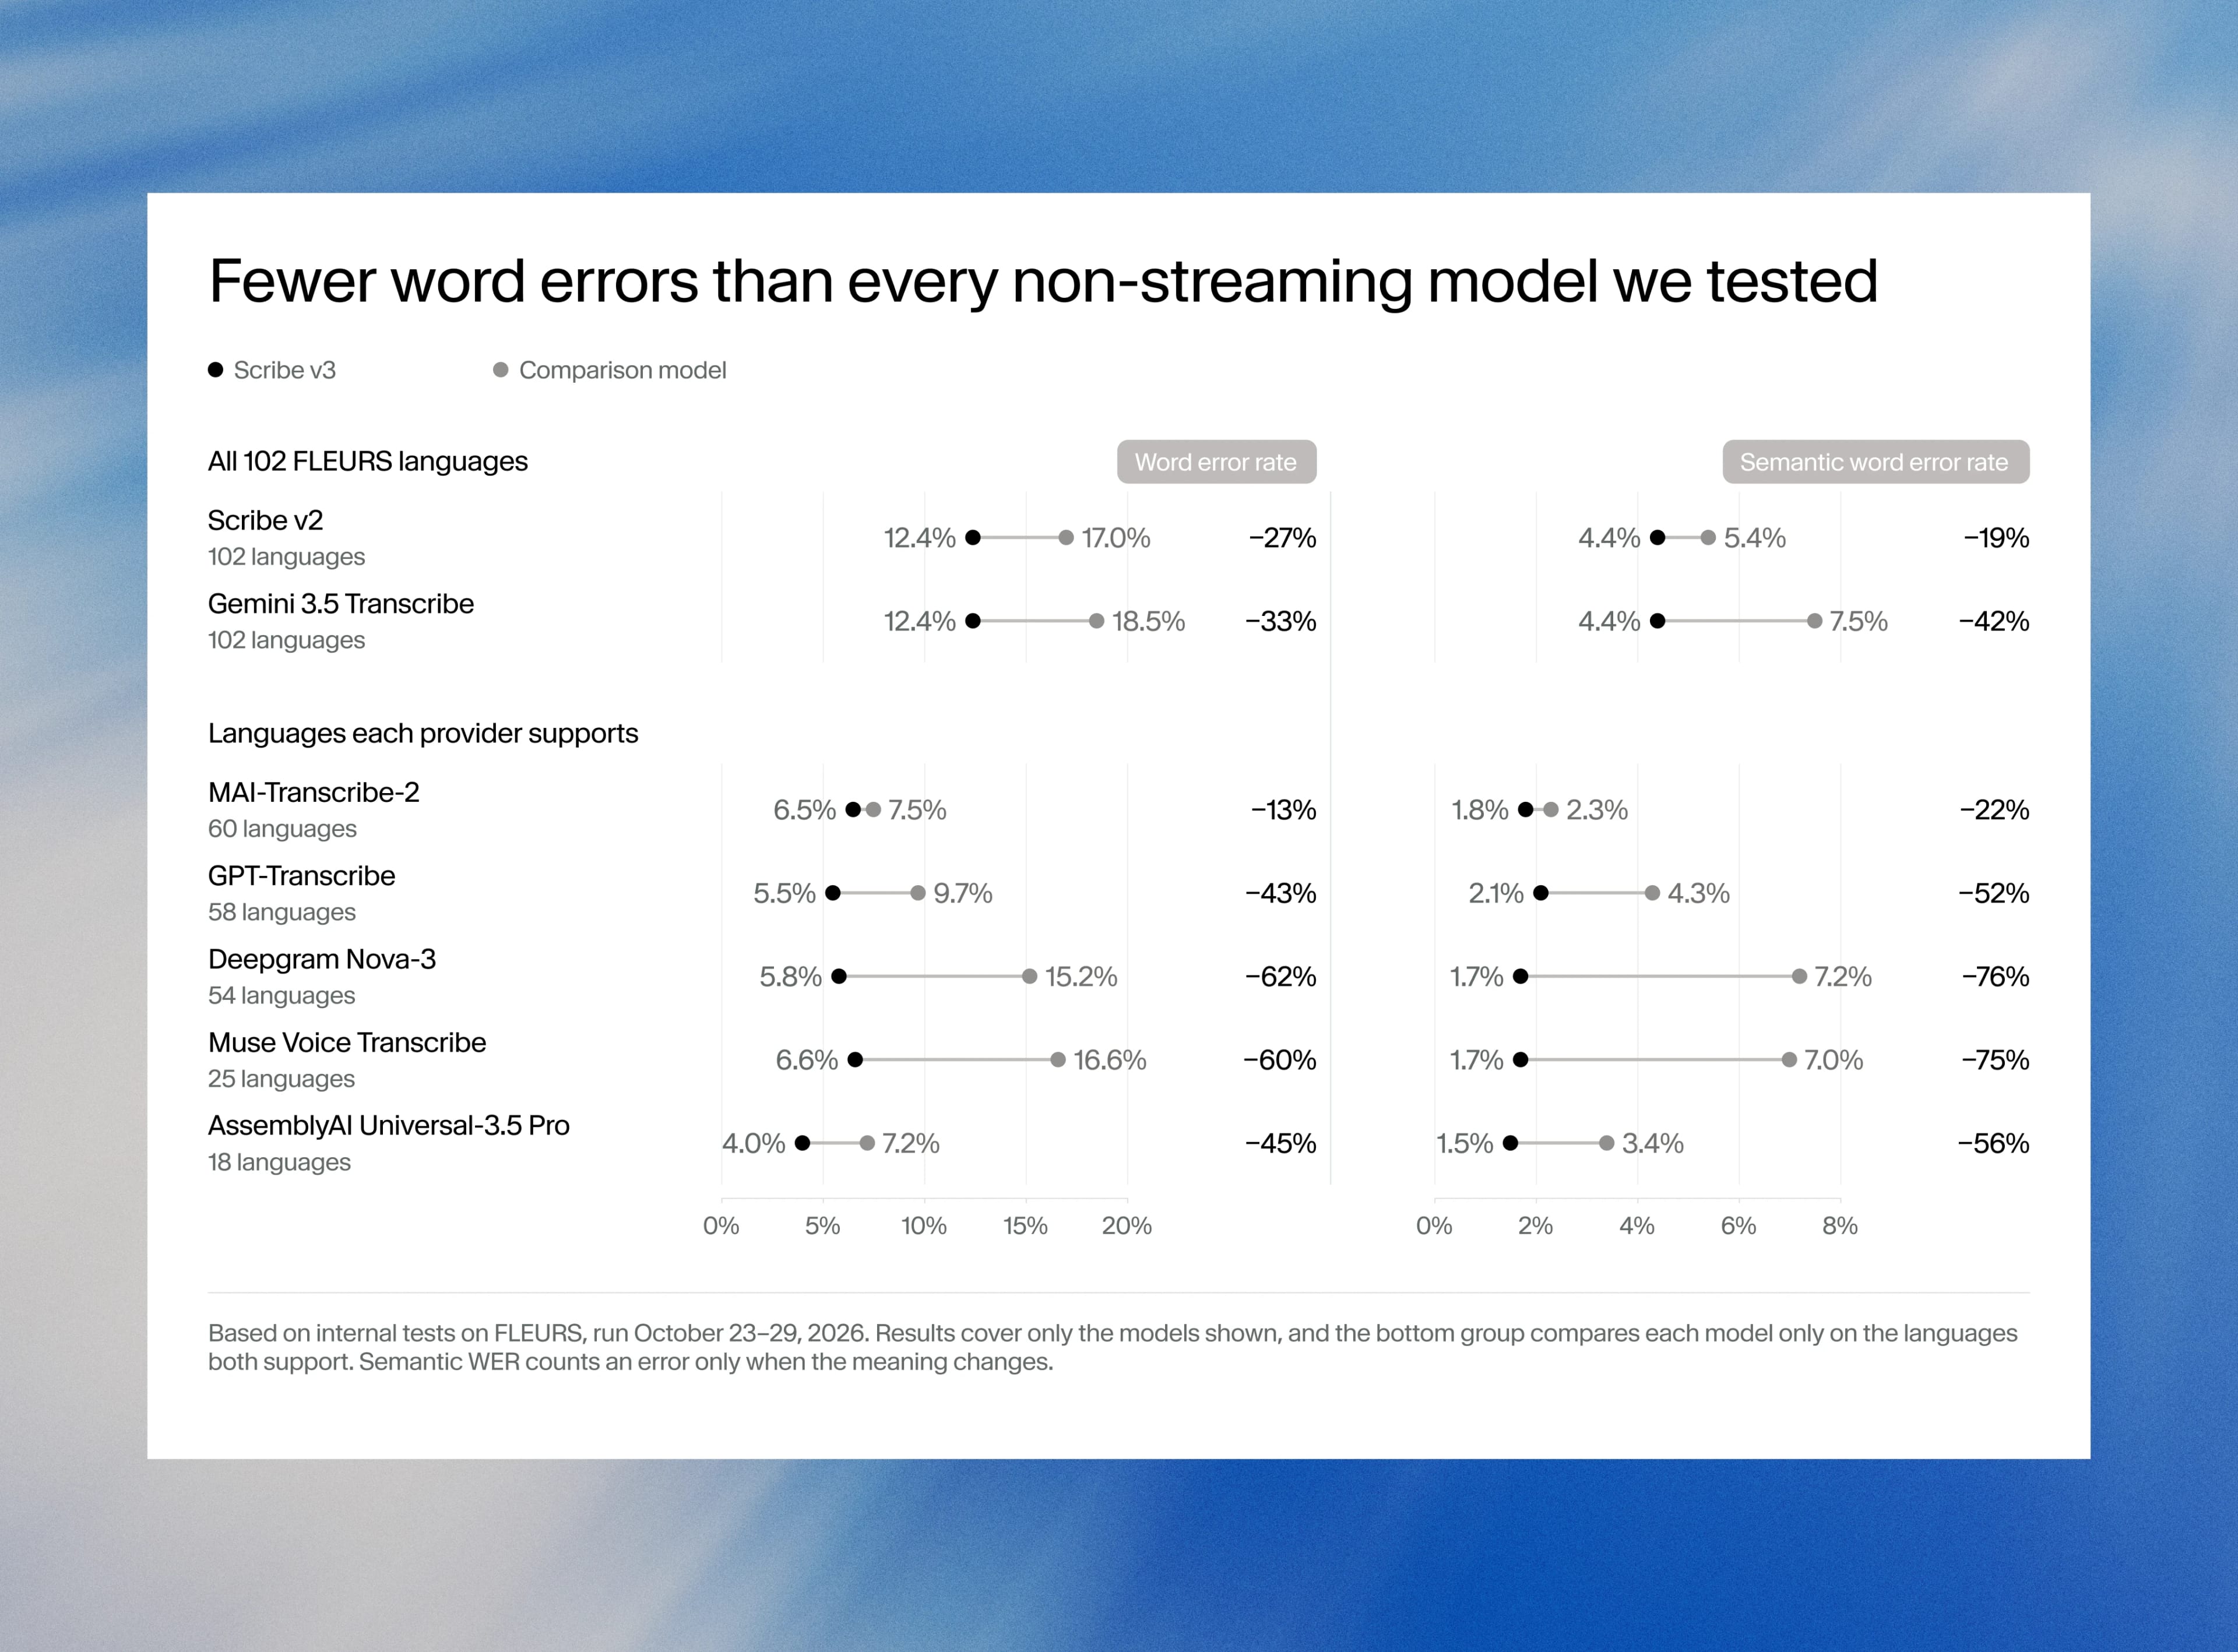
我们同时报告词错误率(WER)和语义 WER;语义 WER 仅在转录含义发生变化时计为错误。
在 FLEURS 的 102 种语言中,Scribe v3 的 WER 比 Scribe v2 低 27%,并在每种测试语言中都有提升。在较易转录的语言中,德语提升 42%,西班牙语提升 35%,英语提升 23%。在较难转录的语言中提升更大:斯瓦希里语降低 34%,泰米尔语降低 29%,泰语降低 28%。
在两者均支持的语言中逐一对比后,Scribe v3 的词错误也少于我们测试的所有其他批量(非流式)模型。
实时说话人分离
在我们涵盖 16 种语言的真实世界数据集的英语部分中,Scribe v3 Live 的说话人分离错误率为 3.1%,而我们测试的其他实时模型为 5.9% 至 7.3%。
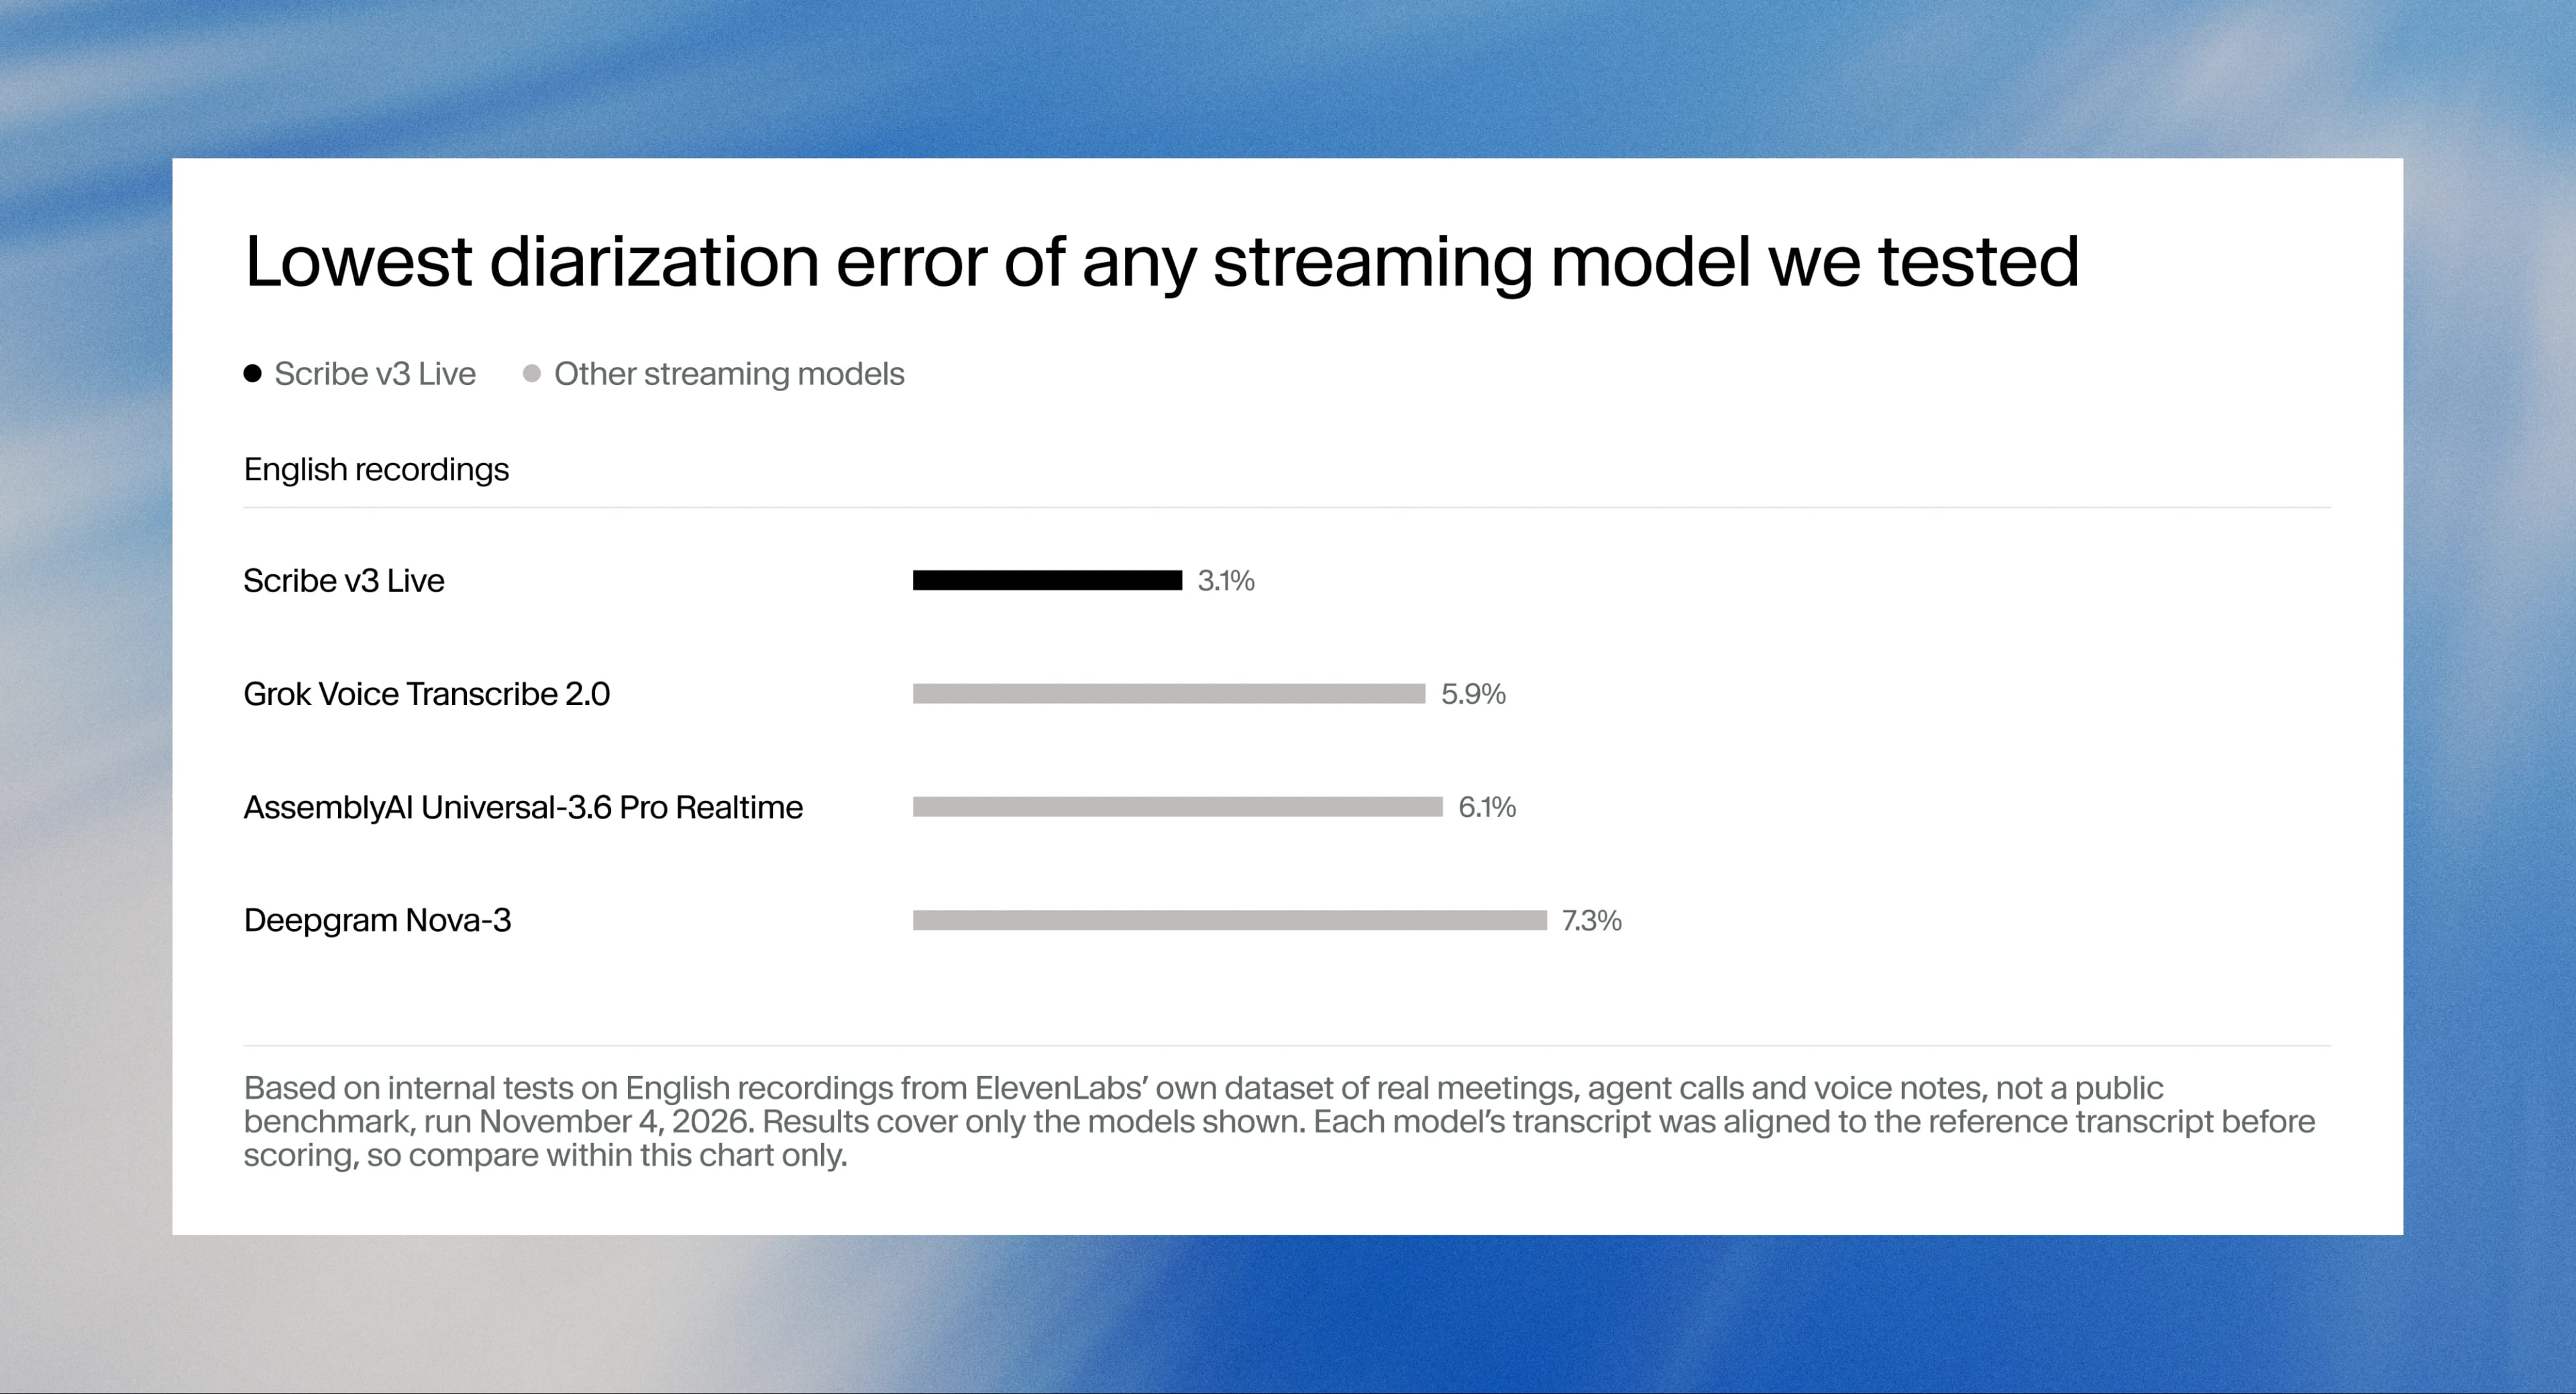
标准说话人分离评分还会计入漏词等转录错误,而实时模型比批量模型漏词更多。为只衡量每个词是否分配给正确说话人,我们在评分前将各模型的转录与参考文本对齐。这会降低所有模型的错误率,因此这些结果不能与上方的批量说话人分离结果直接比较。
实时多语言准确性
对于实时模型,我们重点关注语义 WER。流式模型在尚未听完整句之前就会输出文本,而各提供商对数字、标点和大小写的处理方式也不同。即使含义相同,标准 WER 也会将这些差异计为错误,因此语义 WER 是更公平的比较方式。
在 102 种语言中,与 Scribe v2 Realtime 相比,Scribe v3 Live 的语义 WER 降低 43%,WER 降低 31%。它在每种语言中都有提升,错误率也低于我们测试的其他所有实时模型。
实时转录此前表现较弱的语言提升最为显著:希腊语提升 77%,丹麦语提升 54%,克罗地亚语提升 45%,印地语提升 36%。
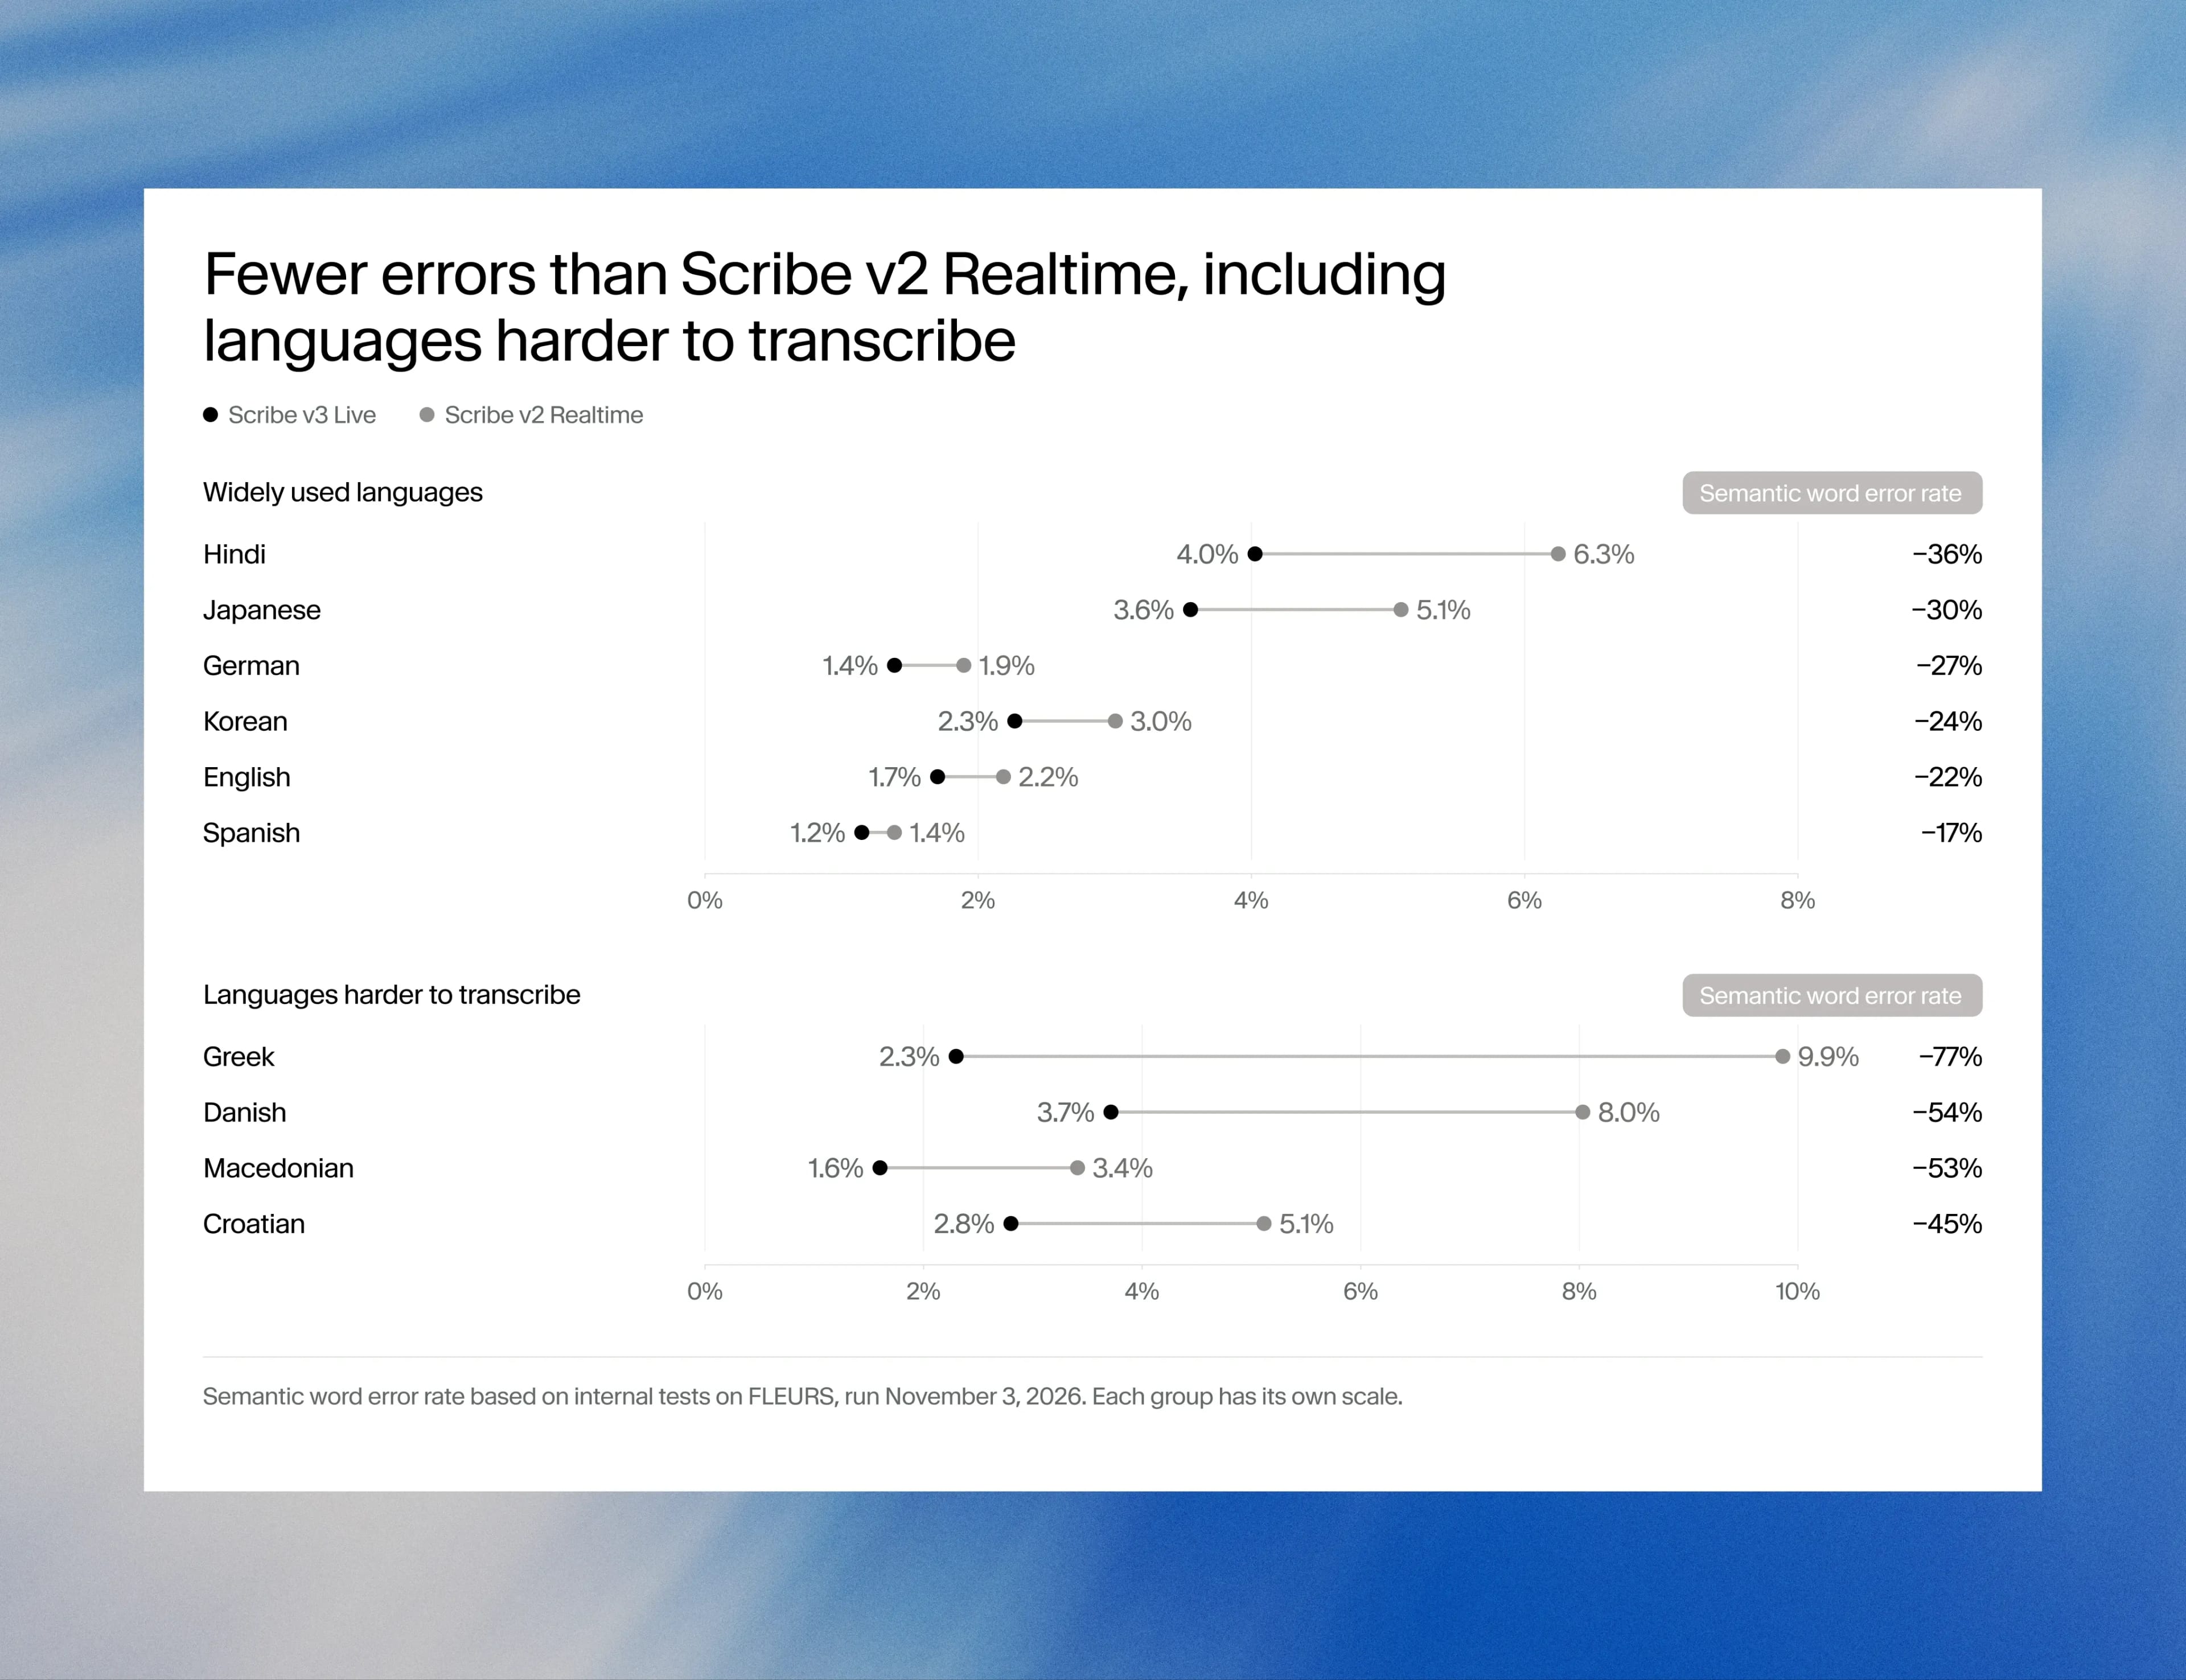
方法说明:我们先分别对每种语言评分,再计算平均值,因此 102 种语言的权重相同。许多已发布结果将所有片段汇总为单一分数,这通常会得到更低的数值,因此不同方法测得的结果无法直接比较。
几个百分点的准确性意味着什么
每次模型发布都会附带百分比,这次也不例外;但从数字上很难看出几个百分点在真实场景中意味着什么。以每分钟 150 个词计,1 小时会议约有 9,000 个词,因此词错误率从 4% 降至 2%,意味着少错 180 个词,也就是每分钟发言少错 3 个词。说话人分离错误按时间而非词数衡量,所以在同一场会议中,每降低 1 个百分点,就有 36 秒语音不再归到错误的人名下。
这些错误的代价取决于它们出现的位置。在播客转录中,一个错词只是笔误;但在财报电话会议中,将“fifteen”听成“fifty”就会进入分析师的模型。错误也常集中在姓名、数字、缩略词和行业术语上,而这些正是摘要或智能体最需要正确识别的词。
在 ElevenAgents 中首次就正确完成
语音智能体最能感受到这一点,因为听错一个数字就可能导致启动通话的验证失败。Eneco 为荷兰超过 200 万户家庭和企业提供能源服务,其语音智能体运行在 ElevenAgents 上,并在发布前测试了 Scribe v3 Live。在真实客户通话中,智能体首次正确识别荷兰邮政编码的频率提高了 40%,首次正确识别门牌号的频率提高了 15%。
Eneco 高级产品经理 Ruud Huigsloot 表示:“ElevenLabs 是 Eneco 真正的合作伙伴。我们正与他们的前线部署工程师携手,进一步改进语音智能体。如此早期就看到显著成果令人欣喜,我们期待继续合作。”
专为企业打造
Scribe v3 和 Scribe v3 Live 默认在美国运行;对于有数据驻留要求的企业客户,也在隔离的欧盟、印度和新加坡环境中提供。零保留模式会在请求完成后立即删除音频和文本。两款模型均纳入我们的 SOC 2、ISO 27001 和 PCI DSS Level 1 合规计划,在签署业务伙伴协议后符合 HIPAA 使用条件,并支持私有部署。
立即开始
Scribe v3 Live 已在 ElevenAgents 中推出,v3 和 v3 Live 也是 ElevenLabs app 的默认模型。注册即可试用。
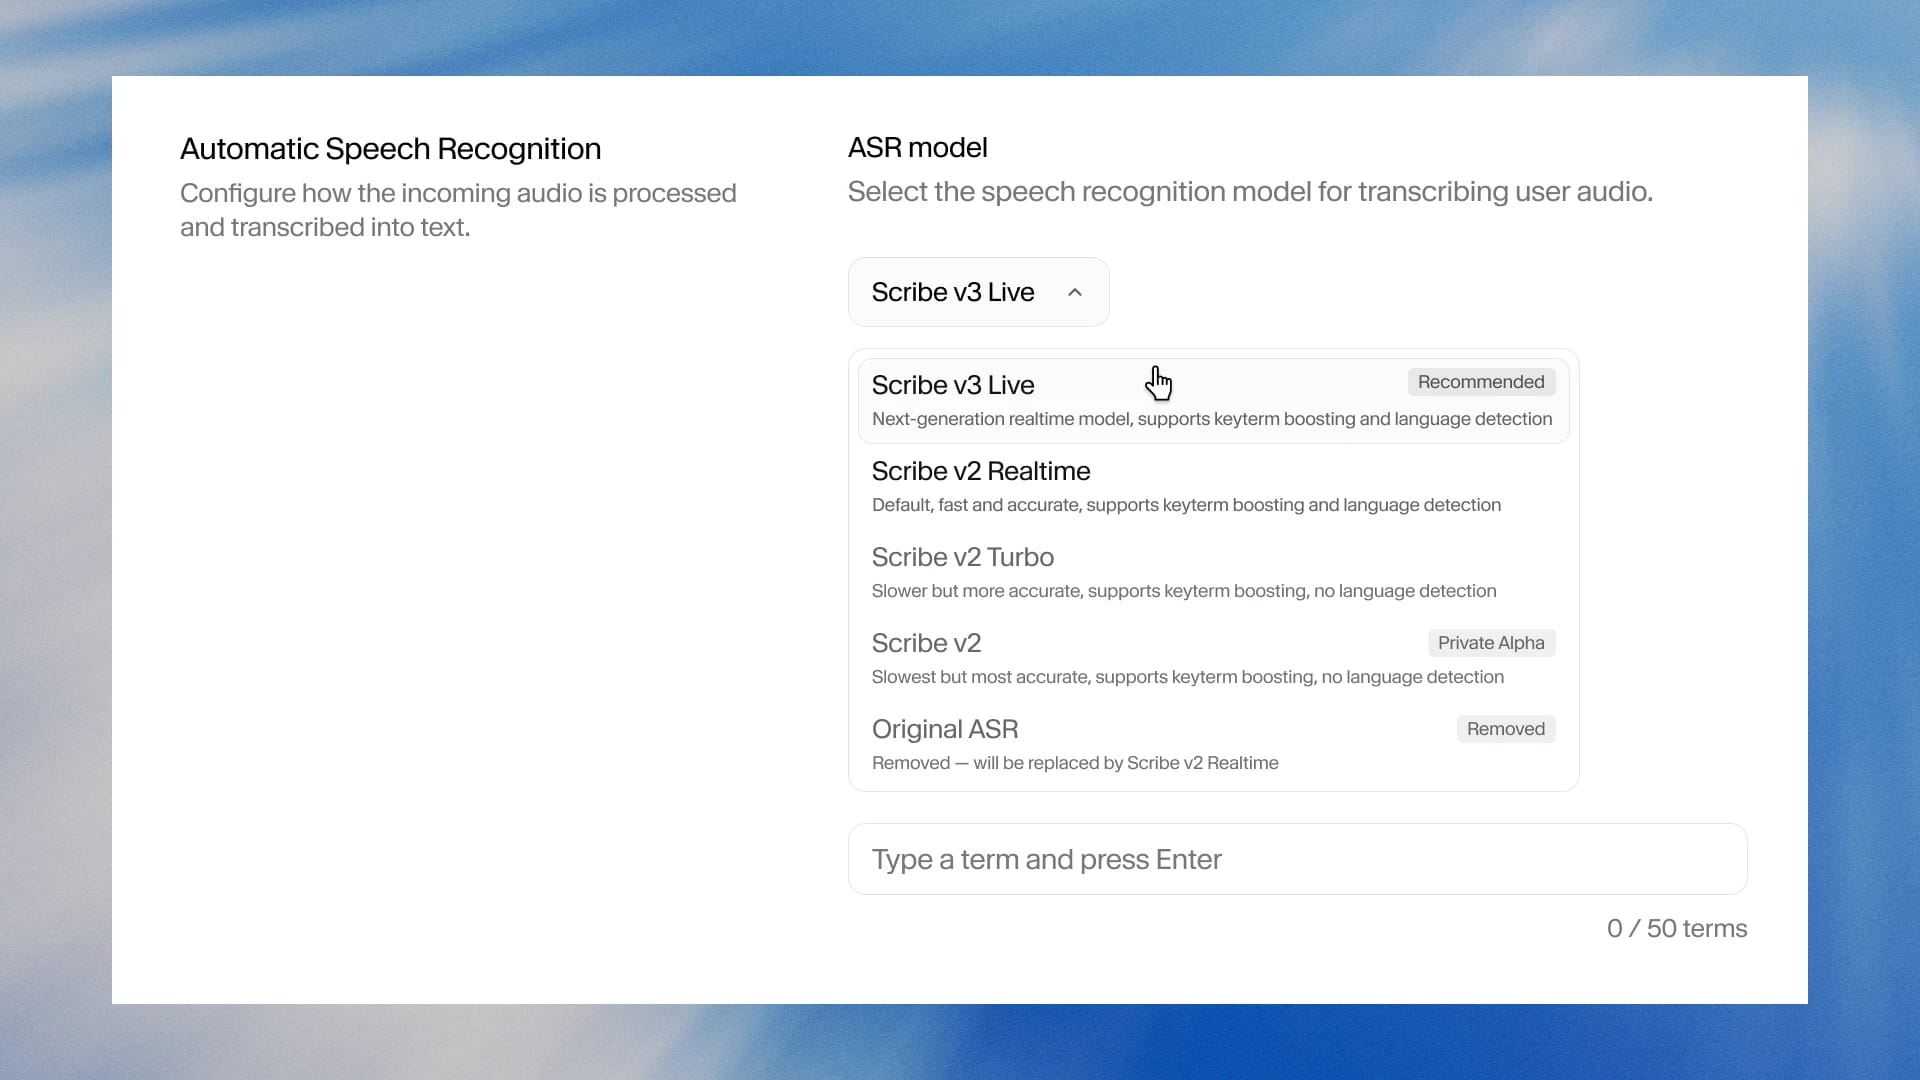
两款模型现已在 ElevenAPI 中提供。现有集成只需将模型 ID 更改为 scribe_v3 或 scribe_v3_live 即可升级。
面向医疗团队,我们还将在 ElevenAgents 中推出针对医疗对话优化的 Scribe v3 Live 版本。