在 ElevenAgents 中处理图片和文档
- 发布时间
- 最近更新
收听收听本文
一名工地主管发现现场材料短缺。他拍下照片,通过 WhatsApp 发给采购智能体,并用语音确认收货地址。智能体处理照片,识别缺少的材料,并在一次对话中完成加急下单。企业工作流程通常包含仅靠文字无法传达的上下文。解决请求所需的信息,可能是一张受损物品的照片或一份政策 PDF。直接将其传给智能体,能缩短对话并加快处理。当客户可以展示而非描述问题时,智能体无需让他们切换渠道,就能更快排查问题。 Rohlik是欧洲最大的在线杂货平台之一,其智能体支持电话、网页、应用和 WhatsApp 等 6 种语言,可自动解决 90% 的客户咨询。多模态输入将同样的解决率扩展到客户需要展示而非说明的场景。 ElevenAgents将文件视为一等输入,可由同一智能体处理语音、WhatsApp、网页和移动端输入。文件会作为原生消息传至底层模型,因此一个智能体可在同一对话线程中处理所有输入类型。
本文介绍多模态在平台中的含义、文件如何从客户设备进入模型上下文、各渠道支持哪些功能,以及客户再次联系时如何跨会话传递上下文。
渠道和输入
ElevenAgents 围绕企业现有的客户触达渠道构建:网页和移动应用、支持平台、电话、SMS、电子邮件、WhatsApp 等。智能体配置(提示词、模型、工具、知识库和音色)只需定义一次,即可在所有渠道共享。不同渠道有两项差异:传输层和支持的输入类型。网页和移动应用可通过嵌入式组件、任一 SDK 或 Agents WebSocket 连接。电话对话可通过原生 Twilio、SIP 中继或基于原生 WebSocket 的集成连接。SMS 通过原生 Twilio 集成连接。WhatsApp 则通过导入 WhatsApp Business 账户,并在智能体上启用集成来连接。一个智能体可同时部署在所有这些传输层上。
目前,网页、移动端和 WhatsApp 支持文件输入(图片和 PDF)。输入处理由类型驱动,而非渠道驱动:同一 WhatsApp 会话中收到的照片和语音留言,在到达模型前会经过完全不同的处理流程。无论渠道或输入类型如何,所有输入都会汇集至同一预处理层,再作为原生上下文传递给模型,并分为两种路径。
输入表示:文件支持与内联
无论输入类型或渠道如何,平台都会先将每项输入标准化为两种内部表示之一,再传递给模型。该分类决定输入如何编码到模型的上下文窗口,以及集成需要在上游处理哪些事项。
文件支持的输入
图片和 PDF 会作为原生文件引用传递给模型,而非文本摘要。平台存储文件,为其分配 file_id,并将该标识符绑定到用户本轮输入。具备视觉或文档处理能力的模型会在上下文窗口中接收原始文件,而非其派生表示。集成要求很简单:获取上传端点返回的 file_id,并将其加入消息载荷。如果发送消息时未包含 file_id,无论上传是否成功,模型都无法引用该文件。文件存储范围仅限于当前对话。这意味着,任何需在会话结束后保留的内容(文件本身、提取字段或结构化输出)都必须由集成显式处理。具体方式因渠道和使用场景而异。
内联
第二种表示是内联,涵盖其他所有输入。语音和语音留言会被转写。模型运行前,输入的文字、转写后的语音、WhatsApp 位置标记和联系人卡片都会在转录中标准化为纯文本。位置标记会变为坐标和可选地址;联系人会变为姓名和电话号码。这些内容不会作为文件存储,也不会产生文件引用,而是直接存在于转录中。
为何这一区分很重要
这一区分决定集成工作应投入在哪里。对话过程中,内联路径无需你执行任何操作:平台会将这些输入标准化为文本,并直接存入转录。文件支持路径则有独立的集成接口。协调器不会在模型运行前将文件内容转换为文本,而是将原始文件直接传入模型的 上下文窗口。模型处理的是文件结构,而非派生的文本表示或描述,因此可保留原本会丢失的空间关系、视觉布局和文档格式。了解这一区分后,本文接下来将介绍具体实现:如何配置智能体、文件如何通过各渠道传递,以及如何跨会话传递上下文。
设置多模态输入
启用多模态输入时,网页、移动端和 WhatsApp 使用相同的智能体配置。之后,文件如何上传以及如何检索,取决于所用渠道。
启用文件输入
文件输入要生效,智能体配置中必须设置两项内容。首先,将 conversation_config.conversation.file_input.enabled 设为 True,可在创建智能体时通过 API 设置,也可在控制台的 设置 > 高级设置 > 文件输入中设置。其次,智能体必须配置具备视觉和文档处理能力的模型。如果底层模型无法处理图像或文档块,仅启用此标志不会生效;测试前必须同时完成两项设置。
SDK 和 WebSocket
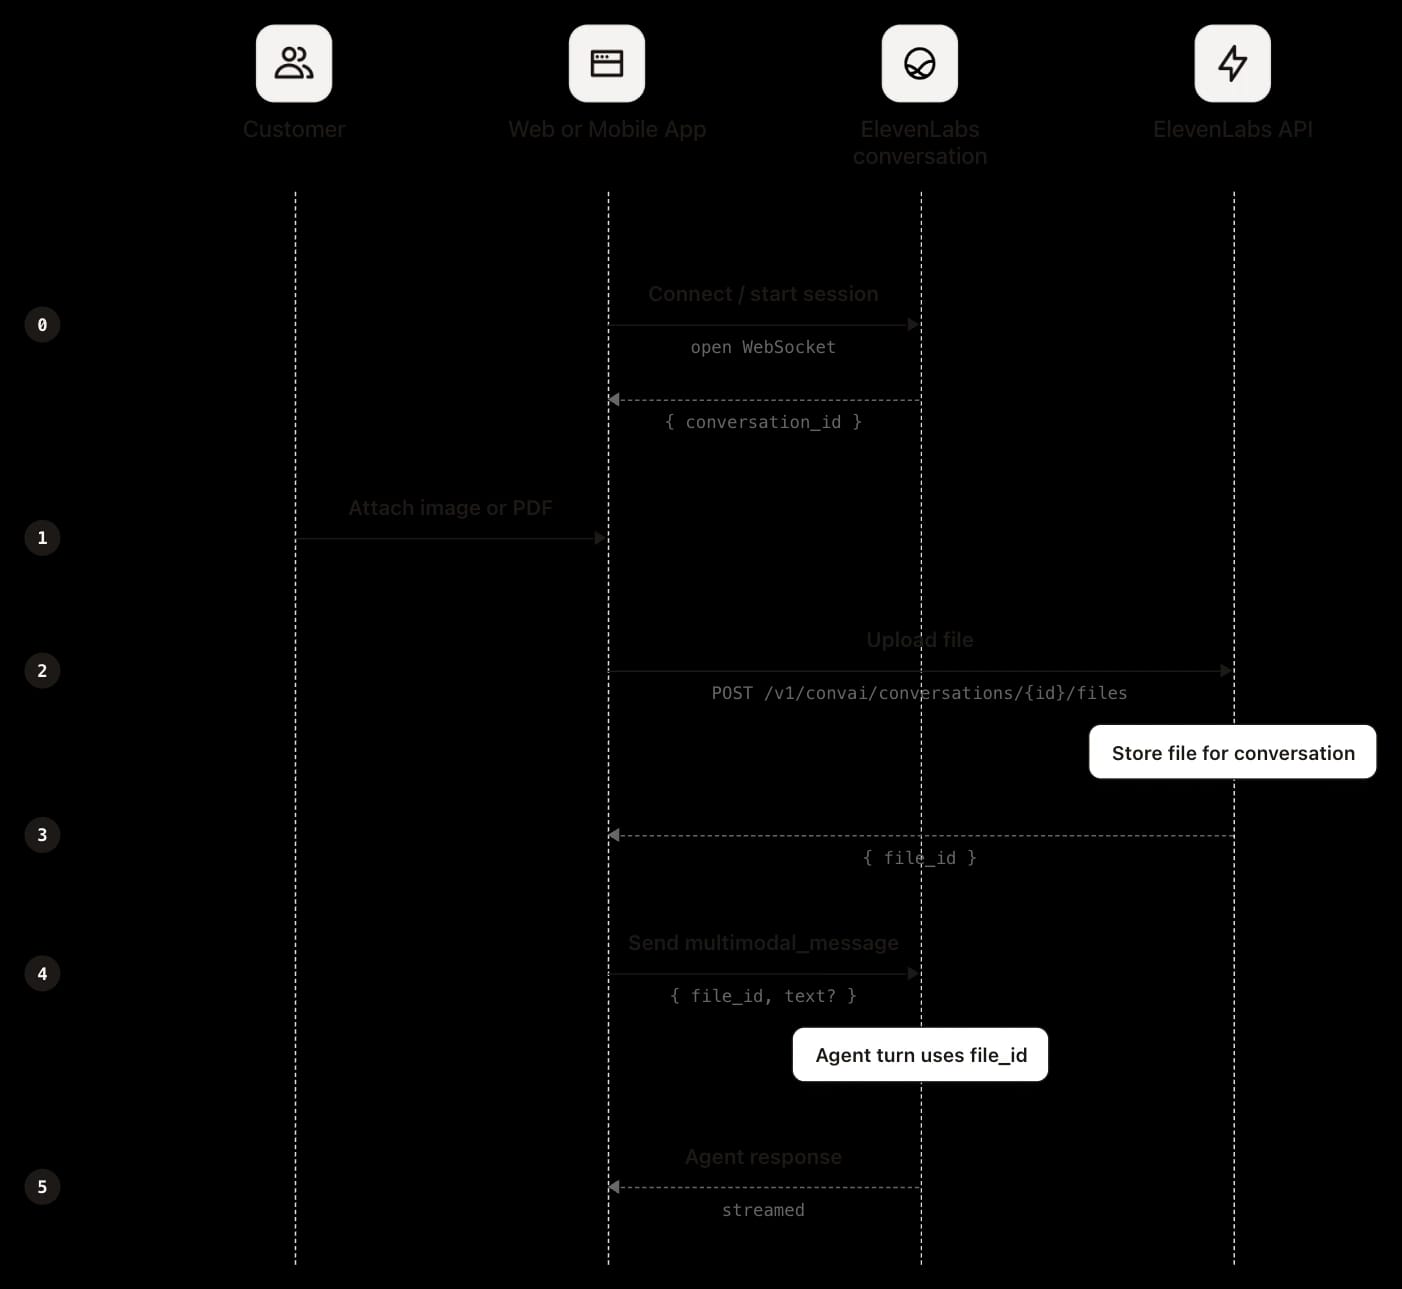
网页或移动端的文件输入需要基于 SDK 构建自定义聊天客户端,或使用原始 Agents WebSocket 连接。三者流程完全相同,且顺序必须严格遵守:必须先上传文件,再发送消息,因为消息载荷会引用上传后返回的标识符。
先上传文件:
完整请求和响应请参阅 文件上传:
然后通过连接发送一条引用返回 file_id 的消息:
SDK 将上传和引用步骤整合为一次调用,并在内部处理文件标识符。完整消息格式请参阅 multimodal_message规范。由于上传由应用执行,此时已持有该文件。如果只需用于当前对话,上传文件并引用其标识符即可。如果需在会话结束后继续保留,最简洁的做法是在上传时由应用存储文件。之后也可通过通话后 webhook 检索,详见“跨会话传递上下文”部分。
在 WhatsApp 上,应用不参与上传。客户发送图片、文档或贴纸时,文件会先进入 Meta 的基础设施。Meta 会通过 WhatsApp Business API webhook 通知 ElevenLabs,ElevenLabs 随后使用已连接 WhatsApp Business 账户的凭据,以服务器到服务器的方式下载文件,存储一份副本,并像网页或 SDK 上传一样将其附加到对话中。智能体将其作为多模态输入接收,转录则会记录一条 file_input 事件。
由于应用从不处理上传,因此不会直接持有文件。它不像网页和移动端那样,存在在上传时捕获文件的途径。文件会通过通话后 webhook 中的 file_url 进入系统,该 URL 指向 ElevenLabs 存储的副本。Meta 的媒体 URL 仅用于接收文件,绝不会对外公开。包括下载时限在内的检索机制,详见“跨会话传递上下文”部分。
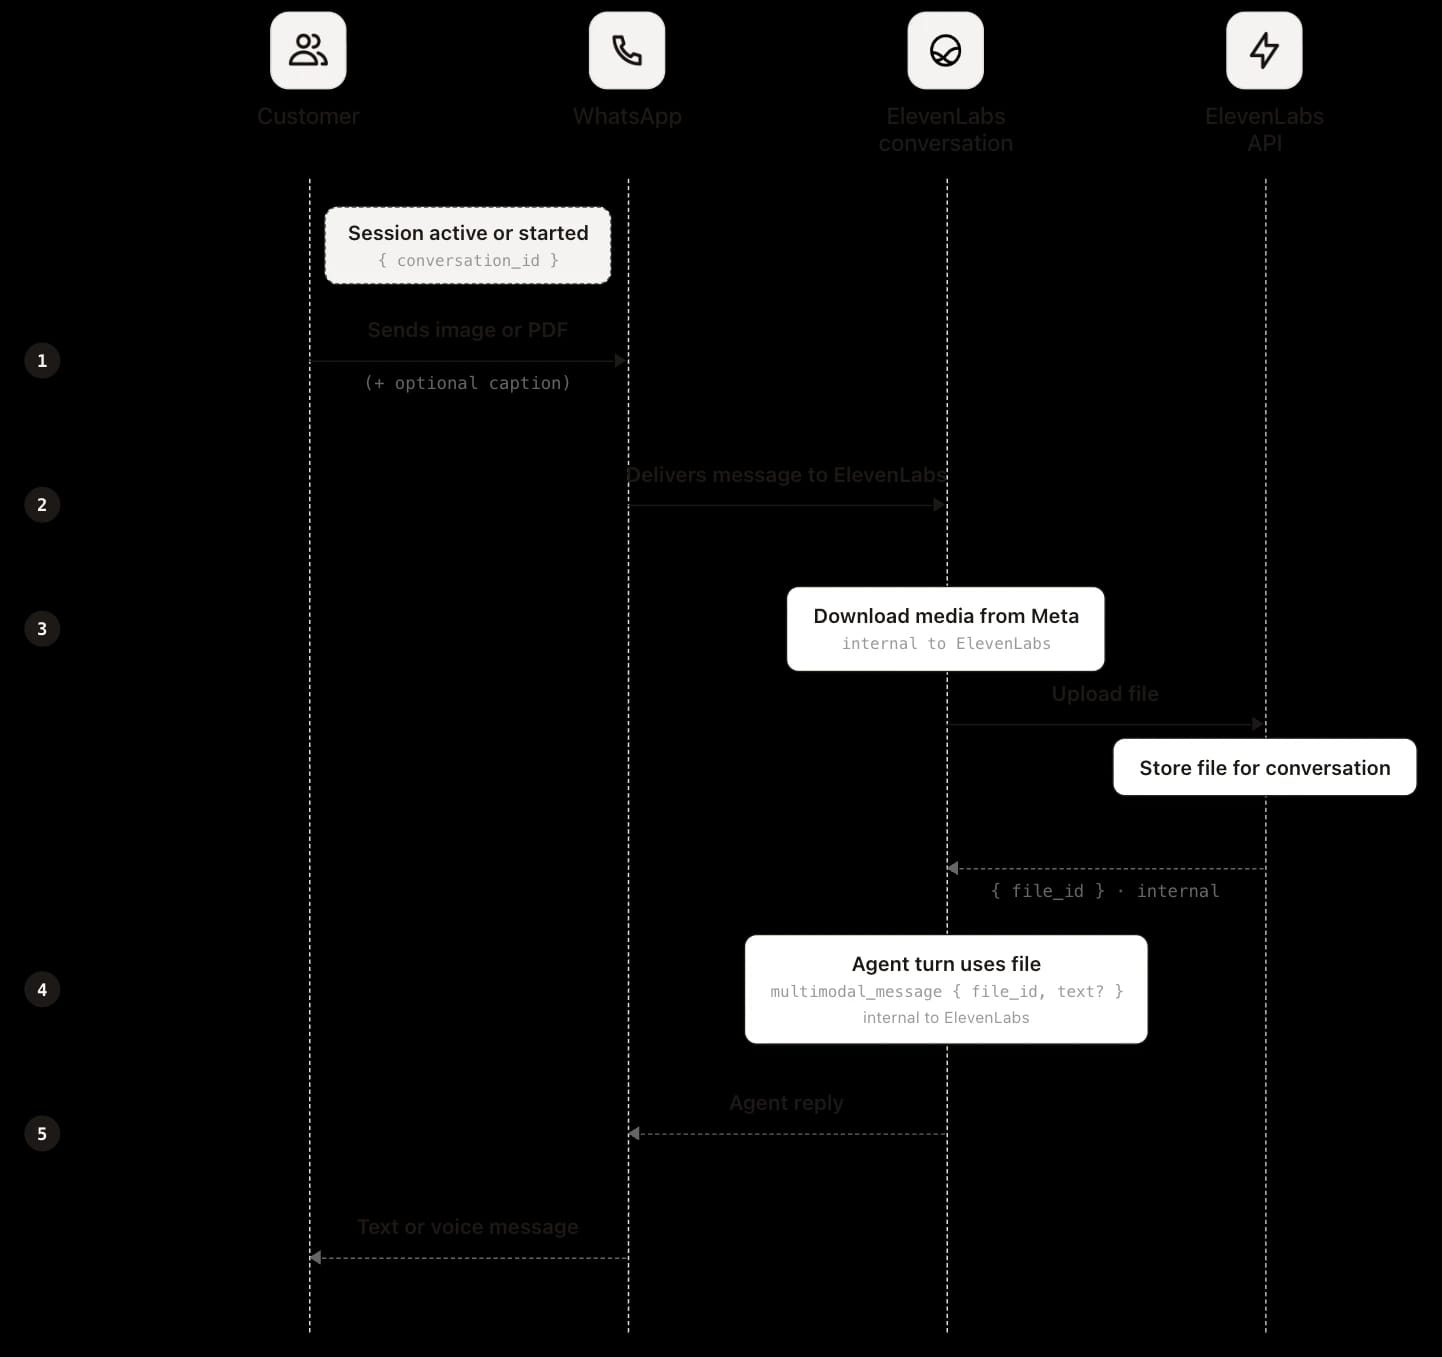
在 WhatsApp 上,客户会在聊天中发送文件。ElevenLabs 从 Meta 获取并存储文件,然后在平台端附加 file_id。这意味着没有客户端上传步骤。与网页和移动端不同,应用不会调用 POST /v1/convai/conversations/{id}/files,也不会通过 WebSocket 发送 multimodal_message。ElevenLabs 负责传递、存储和智能体轮次处理。
跨会话传递上下文
ElevenAgents 会独立处理每次对话。客户发送的内容以及智能体在对话中解决的问题,都不会自动延续至下一次对话。智能体会通过通话后 webhook 将已完成对话的所有内容交给系统,但跨对话记忆位于 ElevenLabs 边界之外。连续性需要由你负责。
这一架构边界值得在设计时慎重考虑。多模态输入最重要的对话场景(客户拍摄受损物品、上传政策文件、分享位置)通常无法在一次会话中解决。发送损坏零件照片并预约回电的客户,会期待智能体在回电时记得这张照片。如果没有明确的上下文管理,智能体每次都会从零开始,客户也只能重复说明。解决这一问题的模式分为两部分。对话结束时,通话后 webhook 会提供转录、分析结果、定义的任何结构化数据收集字段,以及会话中传递的所有文件 URL。后端会将相关内容按电话号码、用户 ID 或账户键等持久客户标识符存储。客户再次联系时,应用会在会话开始时通过动态变量注入已存储的上下文,让智能体带着已有信息开始对话。对于文件支持的输入,webhook 载荷中的文件 URL 指向 ElevenLabs 存储的副本,也是对话关闭后唯一的检索途径。平台副本仅限当前会话,因此如果未来对话或自有系统需要该文件,必须在该窗口关闭前从 webhook 载荷下载。具体需要多快采取行动取决于保留策略,参考文档中有说明。webhook 将状态传出,动态变量将状态传回。其间的所有工作都由系统负责;对于客户会再次联系、升级问题或在处理中途继续的场景,这正是集成工作的核心。
上下文注入取决于渠道
注入机制因渠道而异,但底层模式一致。对于电话,ElevenLabs 会在电话接通前调用服务器,让你可按号码查询来电者,并在智能体开口前返回姓名、订单 ID 或账户等级等动态变量。在 WhatsApp 上,每条入站消息都会触发消息前 webhook,让你能在智能体处理前,使用系统中的身份和业务上下文补充消息。否则,在会话开启时通过 conversation_initiation_client_data传递相同字段。ElevenAgents 不会将跨渠道会话合并为一个线程。即使涉及同一客户,WhatsApp 对话和网页对话也是独立会话。但由于 webhook 输出和动态变量注入在所有渠道中的工作方式相同,一个持久化层即可处理所有渠道。构建一次,即可覆盖智能体运行的每个渠道。上下文注入处理文本形式的数据:姓名、订单 ID、摘要和结构化字段。文件则是另一种情况,需要采用不同方法。
延续文件信息
文件仅限于一次对话,不会自动保留。需延续什么,取决于下一次对话需要文件中的信息,还是文件本身。多数情况下,只需保留信息。智能体会在收到上传文件的那一轮对其进行解读,但不会自动将解读结果写入任何持久位置。结构化输出来自通话后数据:转录、转录摘要和定义的任何数据收集结果字段。如果客户发送了一张开裂门封条的照片,并在一周后回来跟进索赔,智能体无需再次获取照片,只需知道该索赔涉及开裂的门封条。你可从通话后数据中提取该信息,按客户标识符存储,并在客户再次联系时将其作为动态变量注入。简短摘要或少量结构化字段通常已足够。
当确实需要原始文件时,例如用于自有记录、合规或下游系统,通话后 webhook 是检索途径。每个上传文件都会在转录中显示为一条带有签名文件 URL 的 file_input 事件。该 URL 有效期为 15 分钟,因此应在收到 webhook 时下载并存储文件,而非延后处理。如果会话仍存在但错过了该窗口,可通过 GET conversation API 重新获取新的 URL 作为备用方案。应考虑到在零保留模式等某些情况下,可能不存在 file_input,而不要假设每个文件支持的输入轮次都带有 URL。
这涵盖了完整生命周期:文件进入会话,模型以原生方式处理它,结构化输出通过 webhook 传出,持久化层决定智能体下次知道哪些信息。
结语
同一智能体配置无需针对每个渠道单独构建,即可在网页、移动端和 WhatsApp 上接收图片和 PDF。文件会被标准化、绑定到对应轮次,并作为原生块而非文本摘要传递给模型,因此空间布局、视觉结构和文档格式都能完整传达至模型。所有渠道的跨会话上下文都遵循同一模式:通话后 webhook 将状态传出,动态变量将状态传回。
如果你正在基于 ElevenLabs Agents 构建智能体,并希望它能结合语音和文本处理图片及文档,请启用多模态输入,并告诉我们你的想法。

Francesca 隶属于 Forward Deployed Engineering 团队,协助客户将 ElevenLabs 智能体集成到工作流程中。加入 ElevenLabs 前,她曾在医疗行业担任 Forward Deployed AI 工程师,负责自动化病历审核,此前还为能源交易员开发技术解决方案。