
用 ElevenLabs 和 Twilio 20 分钟搭建语音智能体
- 发布时间
- 最近更新
语音智能体可接听呼入电话,并通过 语音转文字(STT)实时转写来电者的语音,使用大语言模型(LLM)生成回复,再通过 文本转语音(TTS)模块播报回复。使用 ElevenLabs 和 Twilio,大约 20 分钟即可让智能体在真实电话号码上运行。
面向开发者,完整技术栈包括:ElevenLabs 用于语音合成(Flash v2.5)和转写(Scribe v2 Realtime),Twilio 用于电话服务,OpenAI 或 Anthropic 作为 LLM。不过,这些组件都可替换,因此可以选用最熟悉的组件。
本文将介绍如何使用 Node.js 和 Typescript,在 20 分钟内构建语音智能体。如果希望使用托管式方案,无需自行维护级联流程,也能处理轮次切换、打断和电话服务,请前往 ElevenAgents。
语音智能体架构的工作原理
在编写代码前,先了解技术栈中的这 3 项服务如何连接会很有帮助。
- Twilio: 处理电话呼叫和音频传输。
- ElevenLabs: 通过 Scribe v2 Realtime 处理 STT,通过 Flash v2.5 处理 TTS。
- LLM: 处理 工具调用 和编写回复。
每个阶段都是轻量适配器,因此可替换其中一项服务而无需改动其余部分。例如,可将 OpenAI LLM 换成 Anthropic,无需重写其他组件。
电话通过 Twilio 到达服务器。Twilio 接听 PSTN 呼叫,向服务器建立 WebSocket,并将来电者音频以 base64 编码的 mu-law 帧流形式转发。服务器运行级联流程,再通过同一 WebSocket 回传合成音频,由 Twilio 播放给来电者。
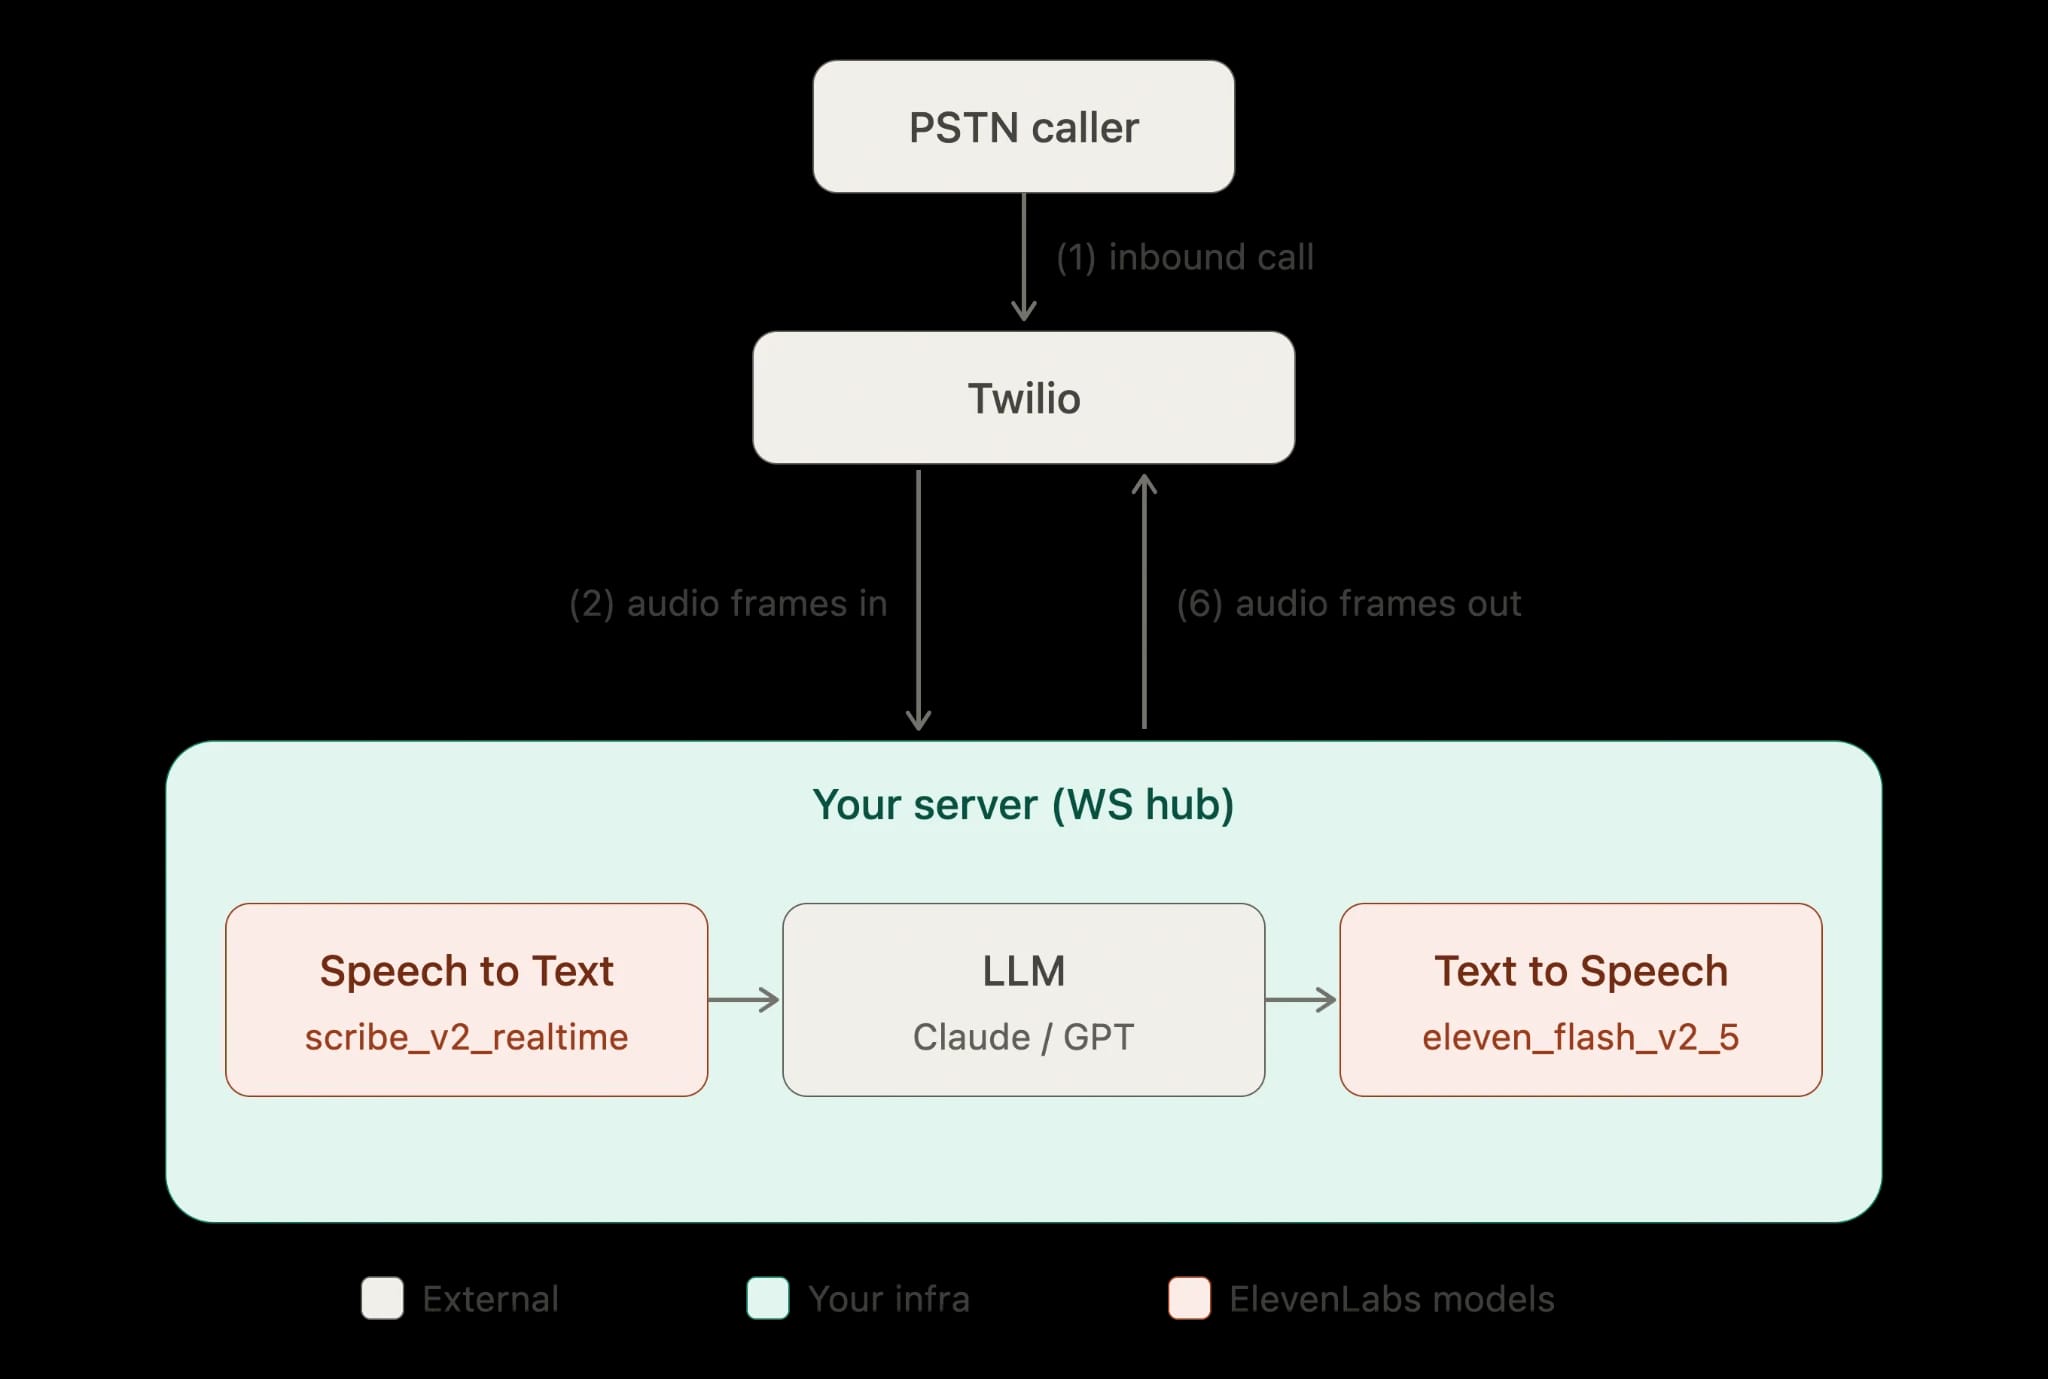
以下是构建语音智能体时使用的流程:
来电者拨打 Twilio 号码。Twilio 从 webhook 获取 TwiML 文档。TwiML 指示 Twilio 向 WebSocket 端点打开 Media Stream。Twilio 将入站音频作为 JSON 事件流传输,其中包含 base64 编码的 mu-law(ulaw_8000)负载。
服务器将音频分块转发至 Scribe v2 Realtime 进行流式转写。来电者的一轮发言结束后,将转写文本发送给 LLM,再使用 Flash v2.5 以 ulaw_8000 格式合成回复。接着通过 WebSocket 将合成的 mu-law 帧以 base64 编码发回 Twilio,由 Twilio 播放给来电者。
Scribe v2 Realtime 输出部分转写的延迟约为 150ms,Flash v2.5 的模型推理约为 75ms,不含网络和应用延迟。LLM 对首段音频时间的影响最大且最难预测,占用了大部分延迟预算。为缩短间隔,我们逐 token 流式输出 LLM 结果,并在模型完成整句前开始合成。
如需了解这些选择背后的模型权衡,请参阅 模型概览 以及关于 理解延迟 的说明。
构建语音智能体前需要准备什么
本指南假设已准备好 4 项内容。每项都能快速完成设置,但缺少其中任意一项,服务器都无法运行。
请检查以下前置条件:
- 具备 Voice 功能的 Twilio 电话号码:记下该号码,以及 Twilio 控制台中的 Account SID 和 Auth Token。
- ElevenLabs API 密钥:在 ElevenLabs 控制台中创建。密钥通过 xi-api-key 请求头传递,属于机密信息,因此只能保留在服务端。参阅 API 身份验证。
- LLM API 密钥:本教程将 Anthropic Claude 和 OpenAI 视为可互换的后端,任选一个即可。
- 用于本地开发的 Ngrok(或任意隧道): Twilio 必须通过公开的 HTTPS 和 WSS URL 访问服务器,而无需部署即可通过 ngrok 实现。
将机密设置为环境变量,绝不要提交到代码仓库。
然后启动一个指向服务器所用端口的隧道:
了解 Twilio Media Streams 协议
Twilio 不会提供原始音频套接字,而是通过 WebSocket 将所有内容封装在结构化 JSON 协议中。了解 4 种事件类型和发送格式后,在编写第 2 步的 WebSocket 处理程序前就能完全理解其逻辑。
Twilio 连接到 WebSocket 后,会发送一系列 JSON 文本消息,共有 4 种事件类型。
首先到达的是 connected 事件,用于确认 WebSocket 已连接。媒体流开始时会发送一次 start 事件;其中包含必须保存的 streamSid,以便回传音频,还包含位于 start.customParameters 和 start.callSid 下的通话元数据。
media 事件会重复出现:media.payload 是一段 base64 编码的 8kHz mu-law 音频,每帧为 20ms;来电者音频的 media.track 为 inbound。最后,流结束时会发送 stop,通常是因为通话已挂断。
要回放音频,需发送类型为 media 的消息,其中包含相同的 streamSid 和 base64 编码的 mu-law 负载。要中断已排队的音频,则发送带有 streamSid 的 clear 消息,这会清空 Twilio 的出站缓冲区。
入站和出站编码完全相同(ulaw_8000)。我们从 ElevenLabs 文本转语音请求 ulaw_8000,并将字节直接转发给 Twilio,无需进行任何重采样。
第 1 步:提供 TwiML webhook
来电时,Twilio 会向 webhook 发出 HTTP 请求,需返回将通话连接到 Media Stream 的 TwiML。<Connect><Stream> 指令会打开双向 WebSocket。这里请使用 <Connect> 而非 <Start>:它会在流持续期间保持通话,并允许回传音频,这正是此设置的目的。
webhook 返回的 TwiML 如下:
在 Express 中,只需一个 POST 处理程序来填入主机并返回文档:
在 Twilio 控制台中,将该号码的“来电时” webhook 设置为 https://your-subdomain.ngrok.app/incoming-call,并使用 HTTP POST。
第 2 步:接受 Media Stream WebSocket 连接
WebSocket 处理程序读取 Twilio 事件、驱动级联流程,并回写音频。
我们为每通电话保留少量状态:streamSid、STT 连接,以及指示智能体当前是否正在说话的标志。处理程序将每个入站媒体帧从 base64 解码,再将原始 mu-law 字节转发给 STT:
第 3 步:使用 Scribe v2 Realtime 转写
Scribe v2 Realtime 接受流式音频分块并返回部分和最终转写,还直接支持 mu-law 编码,因此可原样传入 Twilio 的帧。
它还提供 语音活动检测,可基于静音分段,并通过手动提交来完成分段。对于 电话智能体,通常应选择 VAD 驱动的分段,因为自然停顿是判断来电者一轮发言结束的最可靠信号。
步骤如下:通话开始时打开 STT 流。推送每个入站 mu-law 分块。转写完成后调用 LLM。
实时 STT 客户端接口仍在不断演进,因此下方结构通过一个小型 TypeScript 适配器(openRealtimeStt)封装。应根据实时 API 实现它,而非依赖固定字段名。将 onFinal 视为把完成的来电者轮次交给下一阶段的钩子。
实时识别的部分结果延迟约为 150ms,因此来电者说完到智能体开始回应之间的感知间隔很短。有关批处理版本和完整功能集,请参阅 语音转文字文档 和 实时语音转文字 产品页面。
第 4 步:使用 LLM 生成回复
这是生成回复的阶段。LLM 接收对话历史并返回助手文本。请流式输出回复,以便在第一句话时就开始合成。
此处使用 OpenAI 作为后端:
上面的模型 ID gpt-4.1-mini 是低延迟选择的示例;Anthropic 方面可选用类似的 claude-haiku-4-5。任一提供商都可支持相同的 llmReply 契约;只需替换函数主体,其余智能体逻辑无需变更。
系统提示词会限制回复长度,这对电话场景很重要:过长的回复会显得缓慢,也不便自然打断。
第 5 步:使用 ulaw_8000 通过 Flash TTS 合成
现在需将文本转换为 Twilio 可播放的音频。请求 Flash v2.5 时设置 outputFormat: "ulaw_8000",使字节与 Twilio 预期编码一致;随后流式传输音频,并将每个分块作为 media 事件通过 WebSocket 回传。
将 LLM token 累积为句子大小的片段,并在每段完成时合成,而非等待整段回复。这能缩短首段音频时间,因为模型仍在生成第二句时,来电者已经能听到第一句。如需更深入地控制增量合成,实时 TTS WebSocket 指南展示了如何向单个保持打开的合成套接字输入文本;下方的 HTTP 流式方案更简单,也足以处理简短的对话轮次。
强化 AI 语音智能体以用于生产环境
完成以上 5 个步骤后,已有一个可运行的智能体。但这不等同于生产环境部署。
在将智能体接入真实电话线路前,还需注意以下几个问题。
验证 Twilio webhook 签名
任何知道 webhook URL 的人都可向其发送 POST 请求,因此首先要确认请求确实来自 Twilio。Twilio 会在 X-Twilio-Signature 请求头中使用 Auth Token 对每个请求签名,应拒绝所有未通过验证的请求。签名基于完整 URL 和 POST 参数计算,因此必须采用与 Twilio 相同的方式计算。
Twilio 的辅助工具可为你完成此操作:
妥善管理机密信息
将 ELEVENLABS_API_KEY、LLM 密钥和 TWILIO_AUTH_TOKEN 保存在机密管理器中,而不是源代码或提交到代码仓库的明文 env 文件中。将 ElevenLabs 密钥限定为仅访问此服务所需端点,并设置 credits 配额,使泄露的影响范围可控,而非无限扩大。
企业版还可通过 IP 白名单将密钥限制在特定 IP 范围内。此服务器直接使用 API 密钥,因为密钥不会离开后端;若将任何音频逻辑移至浏览器或移动客户端,则应改用一次性 token,避免在客户端暴露密钥。
了解并发限制
每个套餐都有并发限制,且因模型系列而异。该限制计算同时处于音频生成状态的请求数量。
对于电话智能体,这种计算方式对你有利。音频生成比播放更快,因此每通电话仅会在合成回复的短暂窗口内占用 TTS 并发,而不是在整个通话期间占用。粗略来看,并发限制约为 5 时,可支持约 100 路同时进行的对话式通话,因为生成通常在播放结束前很早就完成。
即便如此,也应监控余量,而不是凭猜测判断。ElevenLabs 响应会提供 current-concurrent-requests 和 maximum-concurrent-requests 请求头;请记录它们,并在接近上限时发出告警。超过限制后,请求会按优先级排队,通常增加约 50ms 延迟;持续过载则会返回 HTTP 429。
处理 HTTP 429 响应时采用短暂退避。若持续出现,可在定价页面升级以提高限制;企业版客户也可联系客户经理。
处理插话和打断
智能体说话时,若来电者开始讲话,通常会期望它停止。这称为插话;正确处理插话是让智能体听起来自然而非照本宣科的重要部分。
在智能体播放期间,使用 STT VAD 信号检测来电者语音。检测到后,执行两项操作。首先,停止转发 TTS 分块;speak 中的 agentSpeaking 标志已通过跳出循环实现。其次,向 Twilio 发送 clear 消息,清空其端已排队的音频。
若跳过 clear,在停止发送后 Twilio 仍会继续播放缓冲音频,导致智能体看起来在盖过来电者说话。
记录日志、监控并优雅地处理失败
为每个阶段添加监测,以便在通话感觉缓慢时定位延迟来源。记录从最终转写到第一个 LLM token、从第一个 LLM token 到第一个 TTS 字节,以及从第一个 TTS 字节到发送给 Twilio 的帧之间的间隔。会发现大多数可变延迟都发生在 LLM 阶段;STT 和 TTS 阶段则相对稳定。
还要为部分失败做好准备。LLM 可能超时,STT 流可能断开,根据地理位置不同,通过公共互联网往返 ElevenLabs 的网络延迟约为 20 至 200ms。应将服务器部署在来电者附近,而不只是 ElevenLabs 附近;ElevenLabs 已会路由至北美、欧洲和东南亚集群中最近的一个。
某个阶段失败时,不要让来电者陷入沉默:合成一句简短的备用回复(“抱歉,可以再说一遍吗?”),并保持通话。为每个阶段设置超时和 try/catch,避免一次轮次失败就断开整个 WebSocket。
上线前还值得设置以下默认项:
- 如上所示,在系统提示词中限制回复长度,使每轮回复简短且可被打断。
- 限制对话历史,避免长通话让 LLM 上下文无限增长。
- 设置最大通话时长,防止卡住的会话悄然占用并发。
如需继续优化可控的组件,延迟文档 介绍了首段音频时间的来源,模型概览 说明速度和质量之间的权衡,而 实时 TTS WebSocket 指南 展示了如何通过增量文本输入进一步降低合成延迟。
使用 ElevenAPI 构建可用于生产环境的语音智能体
20 分钟后,你已具备生产级 语音智能体 的全部层级。Twilio 处理电话服务,Scribe v2 Realtime 进行转写,LLM 生成回复,Flash v2.5 则通过同一 WebSocket 播报回复。
如果不想自行维护级联流程,ElevenAgents 可提供基于刚才手动连接的同一组模型构建的托管服务,包括轮次切换、打断处理和电话服务集成。
如需继续优化自行掌控的技术栈,请查看 ElevenAPI 产品页面,了解套餐、并发限制和 声音库。或者,注册,立即开始拨打第一通电话。
使用 Twilio 和 ElevenLabs 构建语音智能体:常见问题

Tadas Petra 是一名开发者关系工程师,致力于帮助开发者使用 ElevenLabs 产品。他还是开发者教育平台 Hungrimind 的创始人。此前曾任 Agora 首席开发者布道师和 Zero To Mastery 讲师。




