Åtgärda problem med tal-till-text-noggrannhet med ett smartare arbetsflöde
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Noggrannheten i tal till text (STT) beror på tre saker: kvaliteten på ditt ljud, hur människor talar och vilka ord de använder. Brus och kraftig komprimering tar bort detaljer från en inspelning, och även starka modeller kan ha svårt med överlappande röster eller obekant jargong. Den här guiden visar var varje STT-problem uppstår och hur du löser det.
Transkriptionsfel stannar sällan i transkriptionen. Ett feluppfattat läkemedelsnamn i en klinisk anteckning eller ett felaktigt kontonummer i en samtalslogg följer med in i alla system som använder texten, från sök och analys till AI-agenter som agerar utifrån det som sagts. Dålig noggrannhet ökar också granskningstiden, eftersom någon måste hitta och rätta felen manuellt.
Den goda nyheten är att de flesta problem med STT-noggrannhet går att lösa. Många av lösningarna kräver bara små ändringar i dina befintliga konfigurationer eller inspelningsinställningar, så du kan lösa problemet utan att ändra modellinställningarna.
Du kan också se ämnet beskrivas som noggrannhet i taligenkänning, ASR-noggrannhet eller transkriptionsnoggrannhet. Tal till text, taligenkänning och automatisk taligenkänning (ASR) beskriver alla samma process: att omvandla talat ljud till skriven text. Lösningarna i den här guiden gäller oavsett vilken term du använder.
Sammanfattning
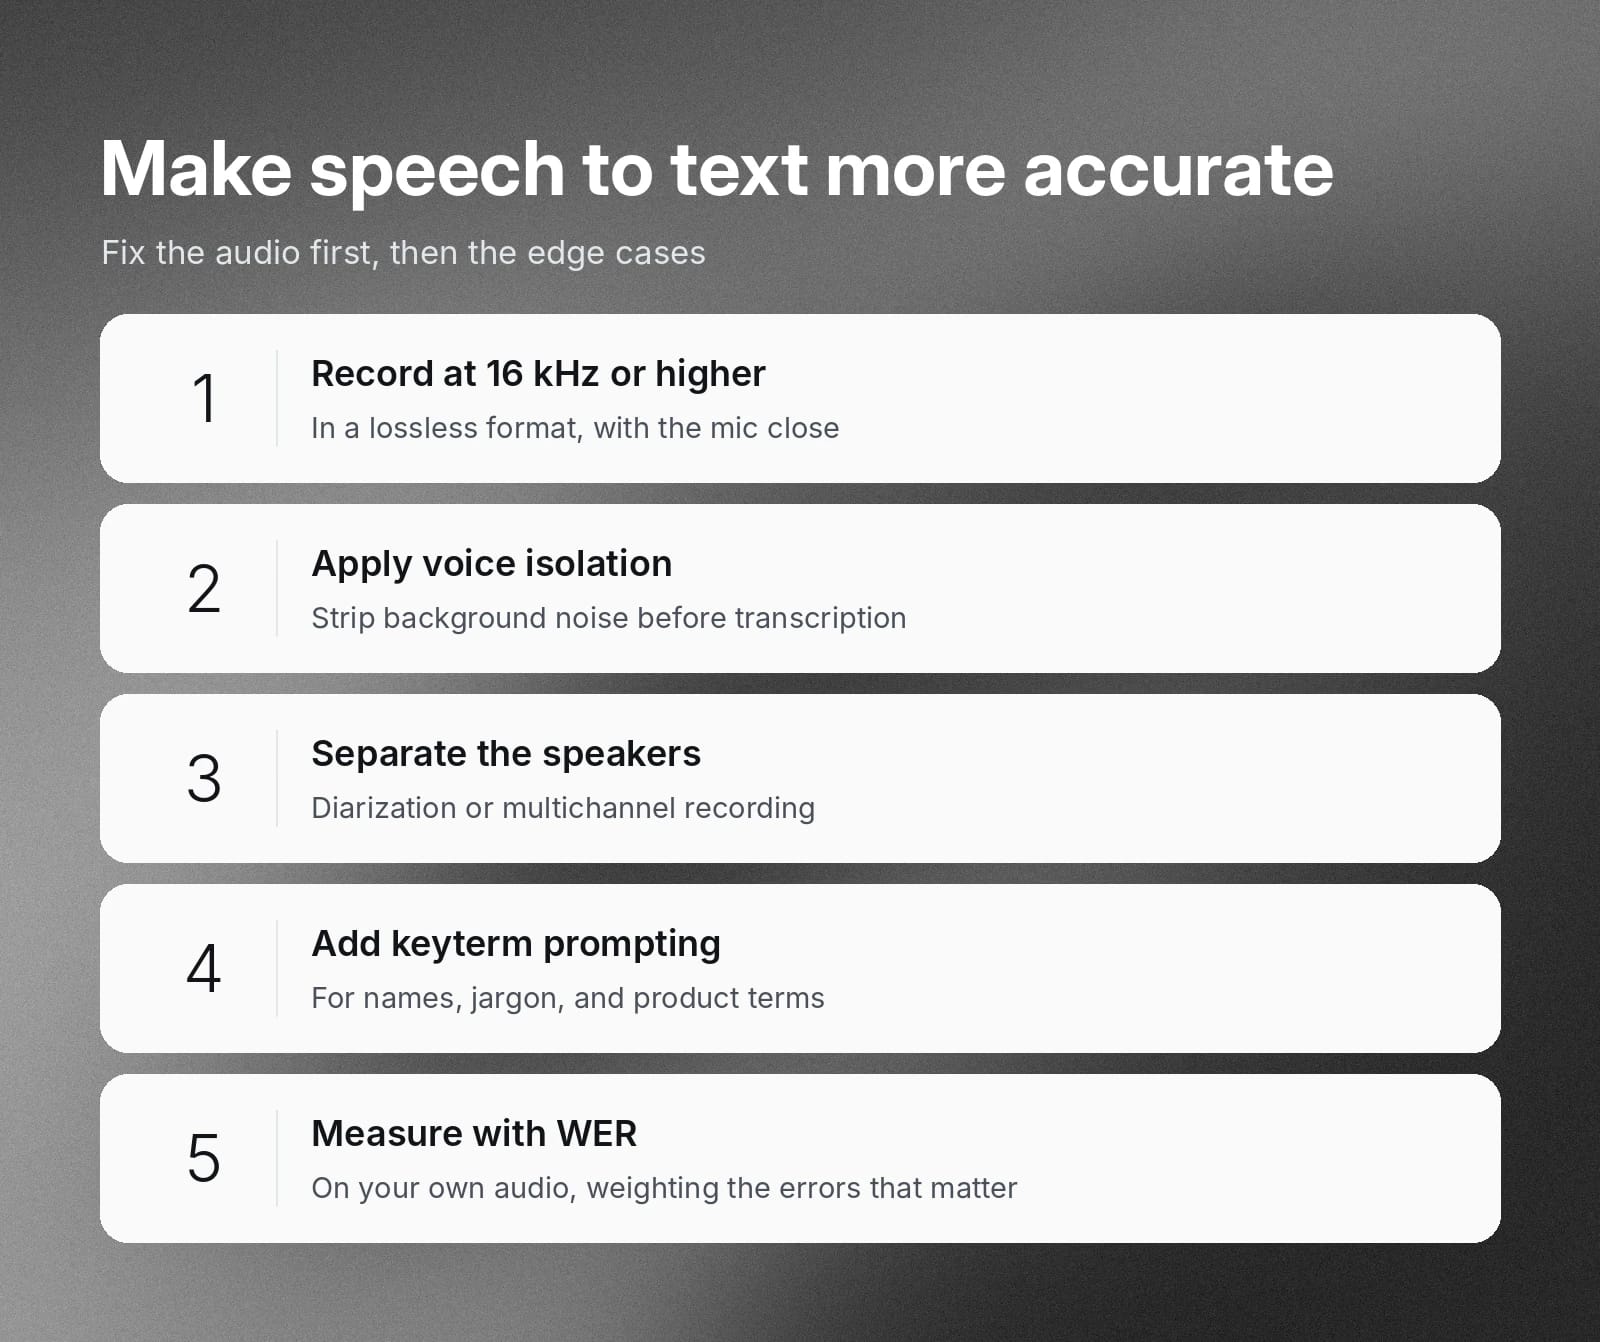
- Noggrannheten i tal till text beror på kvaliteten på ljudinmatningen, talardynamik och lexikala samt kontextuella frågor.
- För att lösa ett noggrannhetsproblem ska du hitta var i pipelinen – inmatning, bearbetning eller utmatning – du kan göra en ändring.
- Spela in med 16 kHz eller högre, använd förlustfria format och placera mikrofoner 10–15 cm från talaren.
- Använd voice isolation, diarization eller flerkanalsinspelning samt keyterm prompting för att hantera brus, överlappande talare och specialiserad vokabulär.
- Mät noggrannheten med word error rate (WER), och kontrollera vilka fel som är viktigast för ditt användningsfall.
Vad orsakar problem med noggrannheten i tal till text?
Föreställ dig att någon ber dig transkribera en ljudinspelning av en professor med stark accent som beskriver komplex teoretisk fysik, inspelad på en fullsatt restaurang med bakgrundsmusik och sorl. Digitala datorsystem är inte naturligt anpassade till akustisk variation. Det krävs omfattande träning och finjustering för att få STT att fungera effektivt, och även om moderna AI-verktyg är mycket effektiva kan många problem fortfarande påverka resultatet. Men när du förstår vad de är kan du hantera dem i dina transkriptionsarbetsflöden.
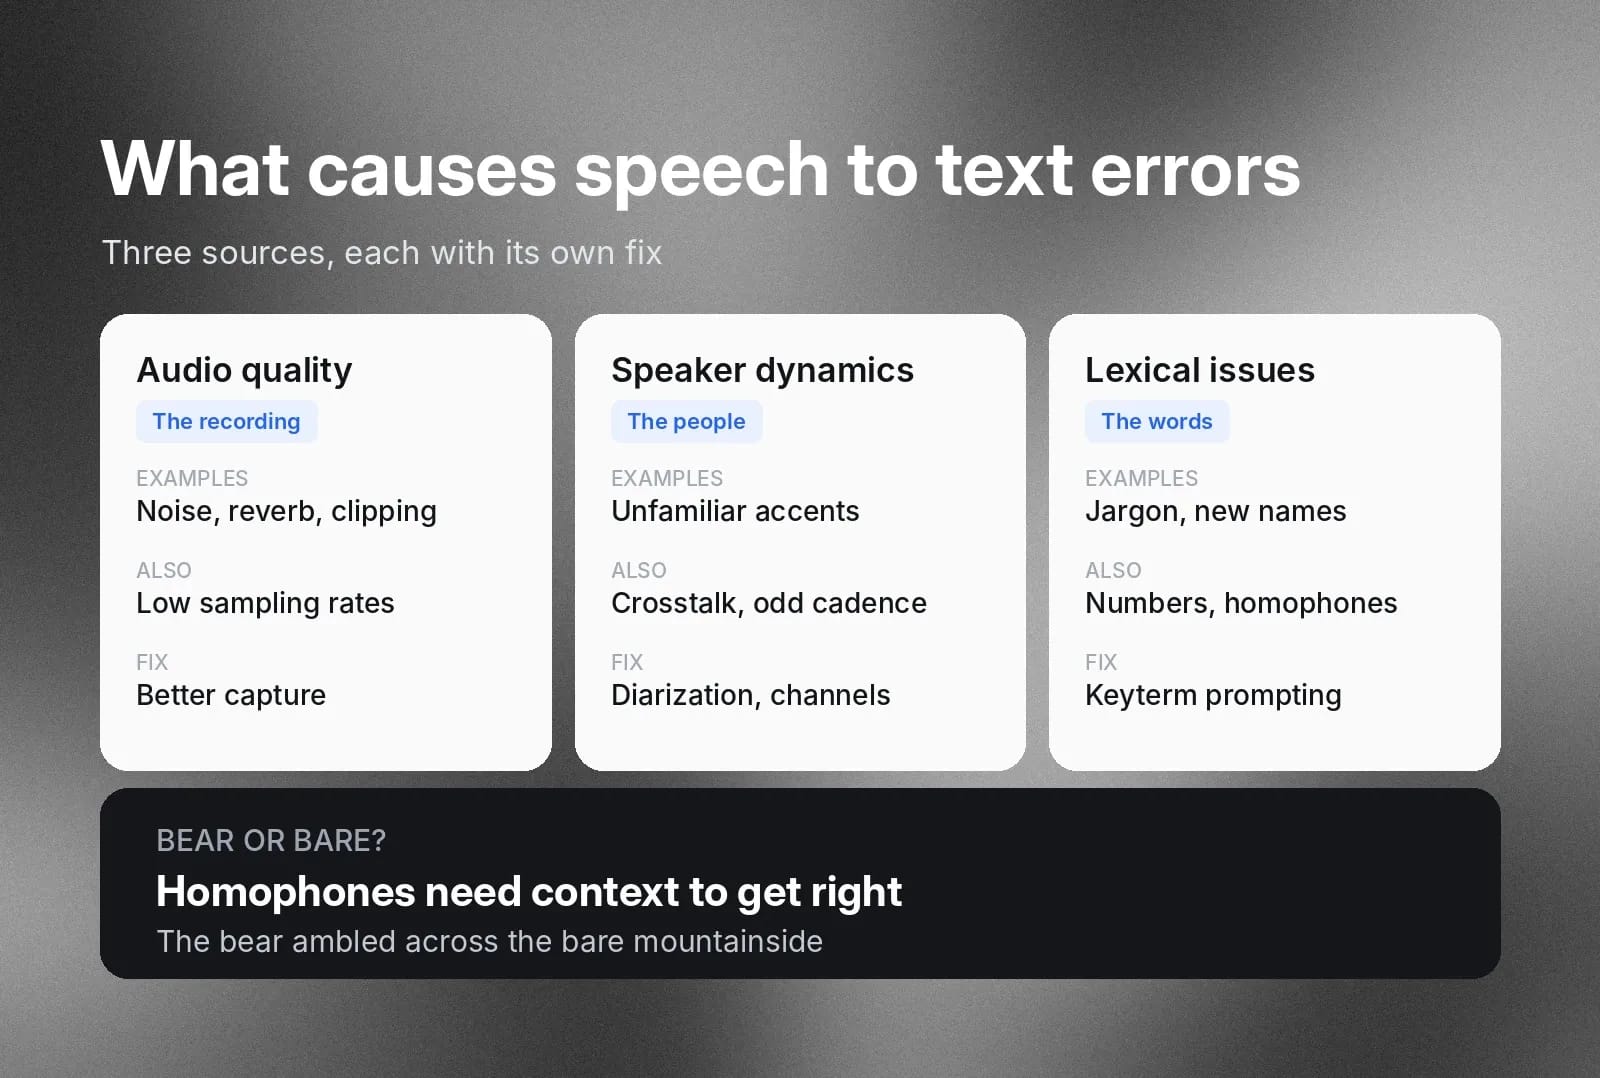
Det finns tre huvudsakliga orsaker till felaktig omvandling från tal till text:
- Problem med ljudinmatningens kvalitet
- Talardynamik
- Lexikala och kontextuella problem
Varje orsak kräver en egen lösning, som avsnitten nedan går igenom i tur och ordning.
Problem med ljudkvalitet
Först kan själva ljudinspelningen ha problem. Mikrofonproblem kan göra att talet blir förvrängt eller klipps. Efterklang på grund av lokalens akustik, ett dåligt signal-brusförhållande (SNR) i inspelningen eller en låg samplingsfrekvens kan alla ta bort viktig fonetisk information från inspelningar.
Talardynamik
En ensam talare med neutral accent som talar i en tyst lokal är relativt enkel att transkribera. Men det är sällan den typ av inspelning vi vill transkribera. Obekanta accenter och hackigt eller på annat sätt ovanligt taltempo kan förvirra en STT-modell som tränats på standardiserat tal. Överlappande samtal eller talare kan också störa modellens förmåga att korrekt tolka det som sägs.
Lexikala och kontextuella problem
Slutligen kan själva talinnehållet också vara utmanande för vissa STT-modeller. Branschjargong och nya produktnamn kanske inte är språk som en STT-modell har stött på under träningen. Eftersom den väljer det statistiskt mest sannolika resultatet kanske obekant tal inte är en av de främsta förutsägelserna. Numeriska eller matematiska uttryck, eller tal som annars skulle skrivas med siffror, kanske inte heller transkriberas tydligt.
Homofoner är ord som låter likadant men stavas olika. En STT-modell behöver tillräcklig kontextuell förståelse för att skilja dem åt. Till exempel: ”the bear ambled across the bare mountainside.” Modellen måste veta att djuret stavas ”bear” och att adjektivet för en oskyddad yta stavas ”bare”.
Så åtgärdar du problem med noggrannheten i tal till text, från ljud till utmatning
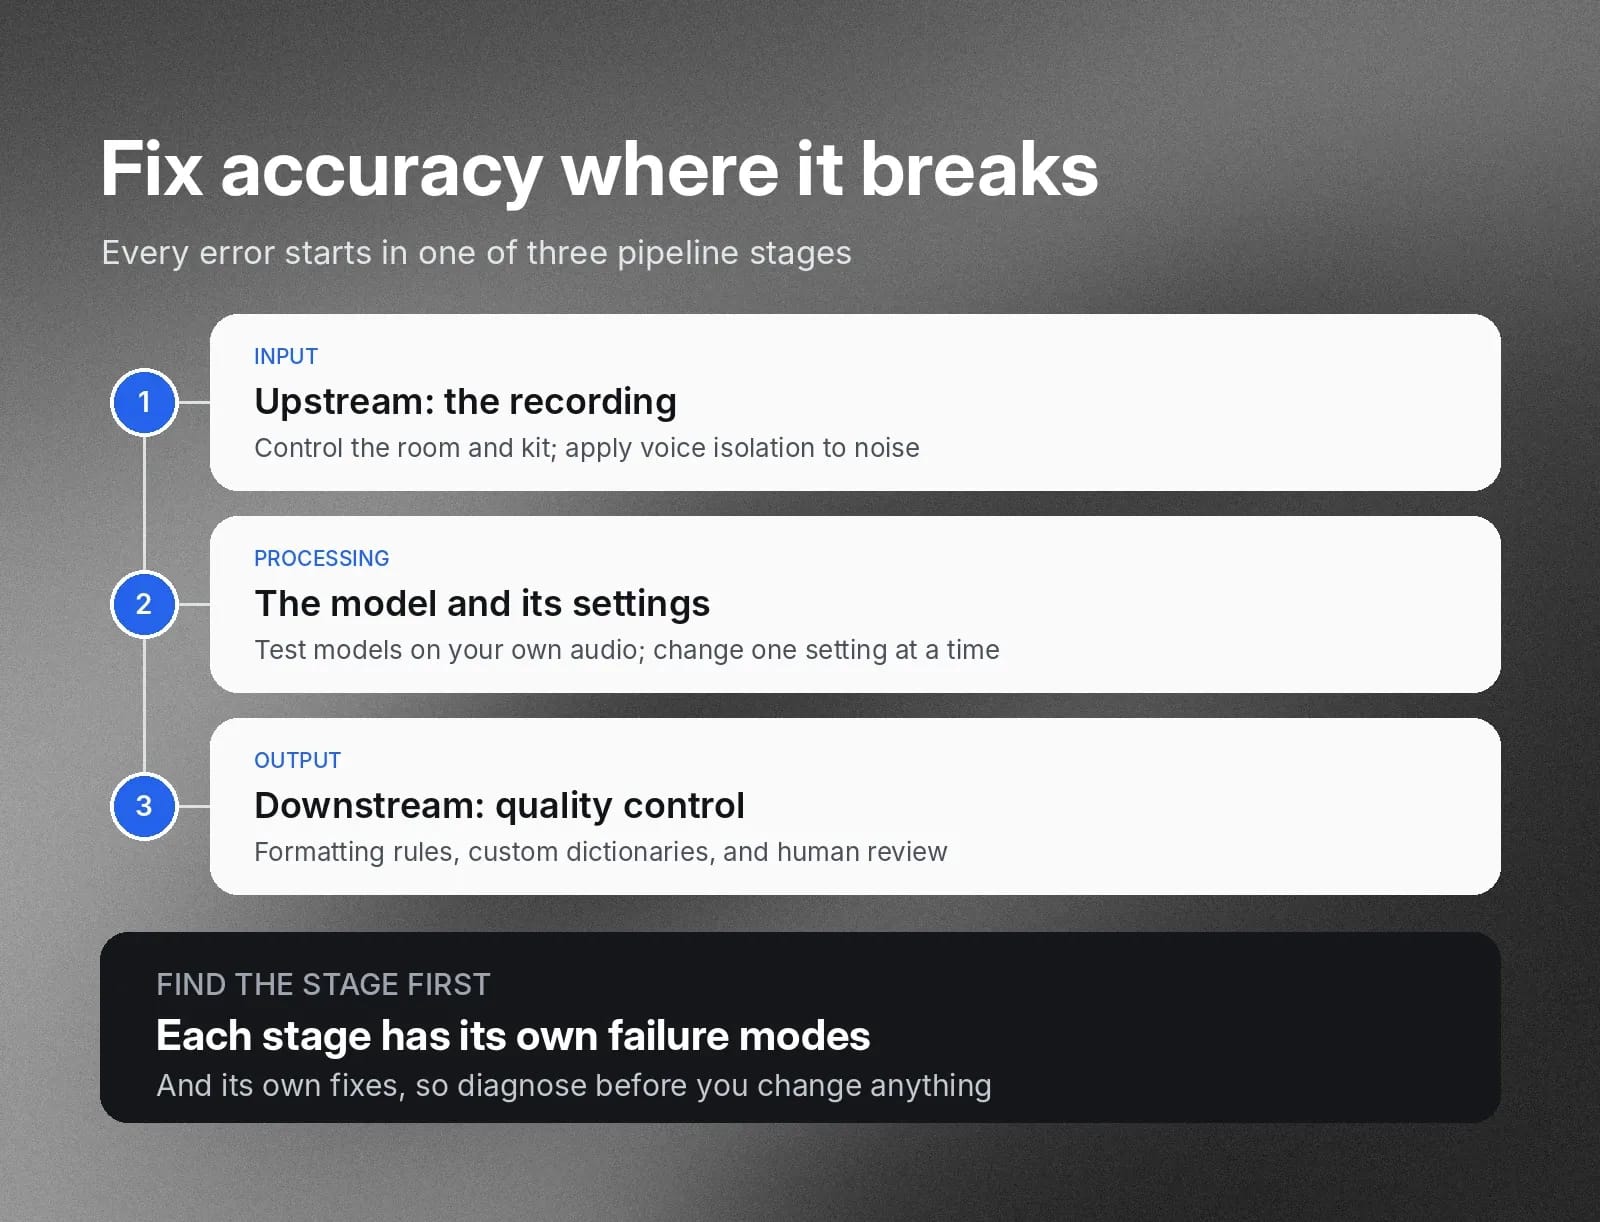
Bearbetning av tal till text sker i en serie väldefinierade steg. För att lösa ett noggrannhetsproblem behöver du identifiera var i den pipelinen du kan göra en ändring. I stora drag delas STT-processen upp i:
- Inmatning
- Bearbetning
- Utmatning
Varje steg har sina egna felmoder och sina egna lösningar.
Noggrannhetsproblem i inmatningen
Det kan finnas problem med miljön där du spelar in. Vanliga problem är bakgrundsbrus eller ekon. Inspelningsutrustningen kan också vara källan till problemet om den är felaktig.
Att lösa problem i det här steget innebär vanligtvis att isolera vad som orsakar problemet och åtgärda det. Om du till exempel vet att STT-verktyget har svårt med höga bakgrundsljud är det en bra idé att hålla samtal i en miljö som du har mer kontroll över.
För brus du inte kan undvika, använd voice isolation innan ljudet når modellen.
Noggrannhetsproblem i bearbetningen
Hur du konfigurerar din API-anslutning till en STT-motor kan påverka bearbetningen. Promptstrukturen och modellen du väljer kan också påverka kvaliteten och antalet fel.
Att lösa problem i det här steget innebär att testa din konfiguration mot ditt eget ljud. Kör samma exempelinspekningar genom varje kandidatmodell, jämför deras word error rates och ändra sedan en inställning i taget för att förfina resultatet.
Om en modell fortsätter att missa en viss typ av tal, till exempel ett brusigt samtal eller en viss regional accent, testa olika modellers noggrannhet i precis den miljö där du ska använda dem.
Noggrannhetsproblem i utmatningen
Det här är ditt kvalitetskontrollager, där specialiserade processer rensar upp transkriptionsfel och oklarheter som din primära motor kan ha missat. STT-pipelines använder regelbundet regelbaserad mönstermatchning för att standardisera formatering, till exempel genom att ändra ”tio dollar” till ”$10.00”, en process som kallas invers textnormalisering (ITN). Men om en talare använder ett sådant uttryck på ett ovanligt sätt eller uttalar det fel fångas det inte av ett stelt sök-och-ersätt-verktyg.
Det är också en fråga om en människa i loopen (HITL) kontrollerar kvaliteten på utmatningen. Om inte kan felaktigheter hamna i produktionsresultatet. Som med alla aktiviteter finns det risk för mänskliga fel när en människa utför dem.
I det här steget innebär problemlösning att fånga upp de fel som dina primära motorer lämnar efter sig. Du kan jämföra transkriptioner med ett referensprov för att hitta vilka misstag som återkommer och sedan lägga till riktade regler eller en egen ordlista för dessa termer. Lägg alltid till ett steg för mänsklig granskning, särskilt för transkriptioner där mycket står på spel.
Så förbättrar du noggrannheten i taligenkänning med bättre ljud
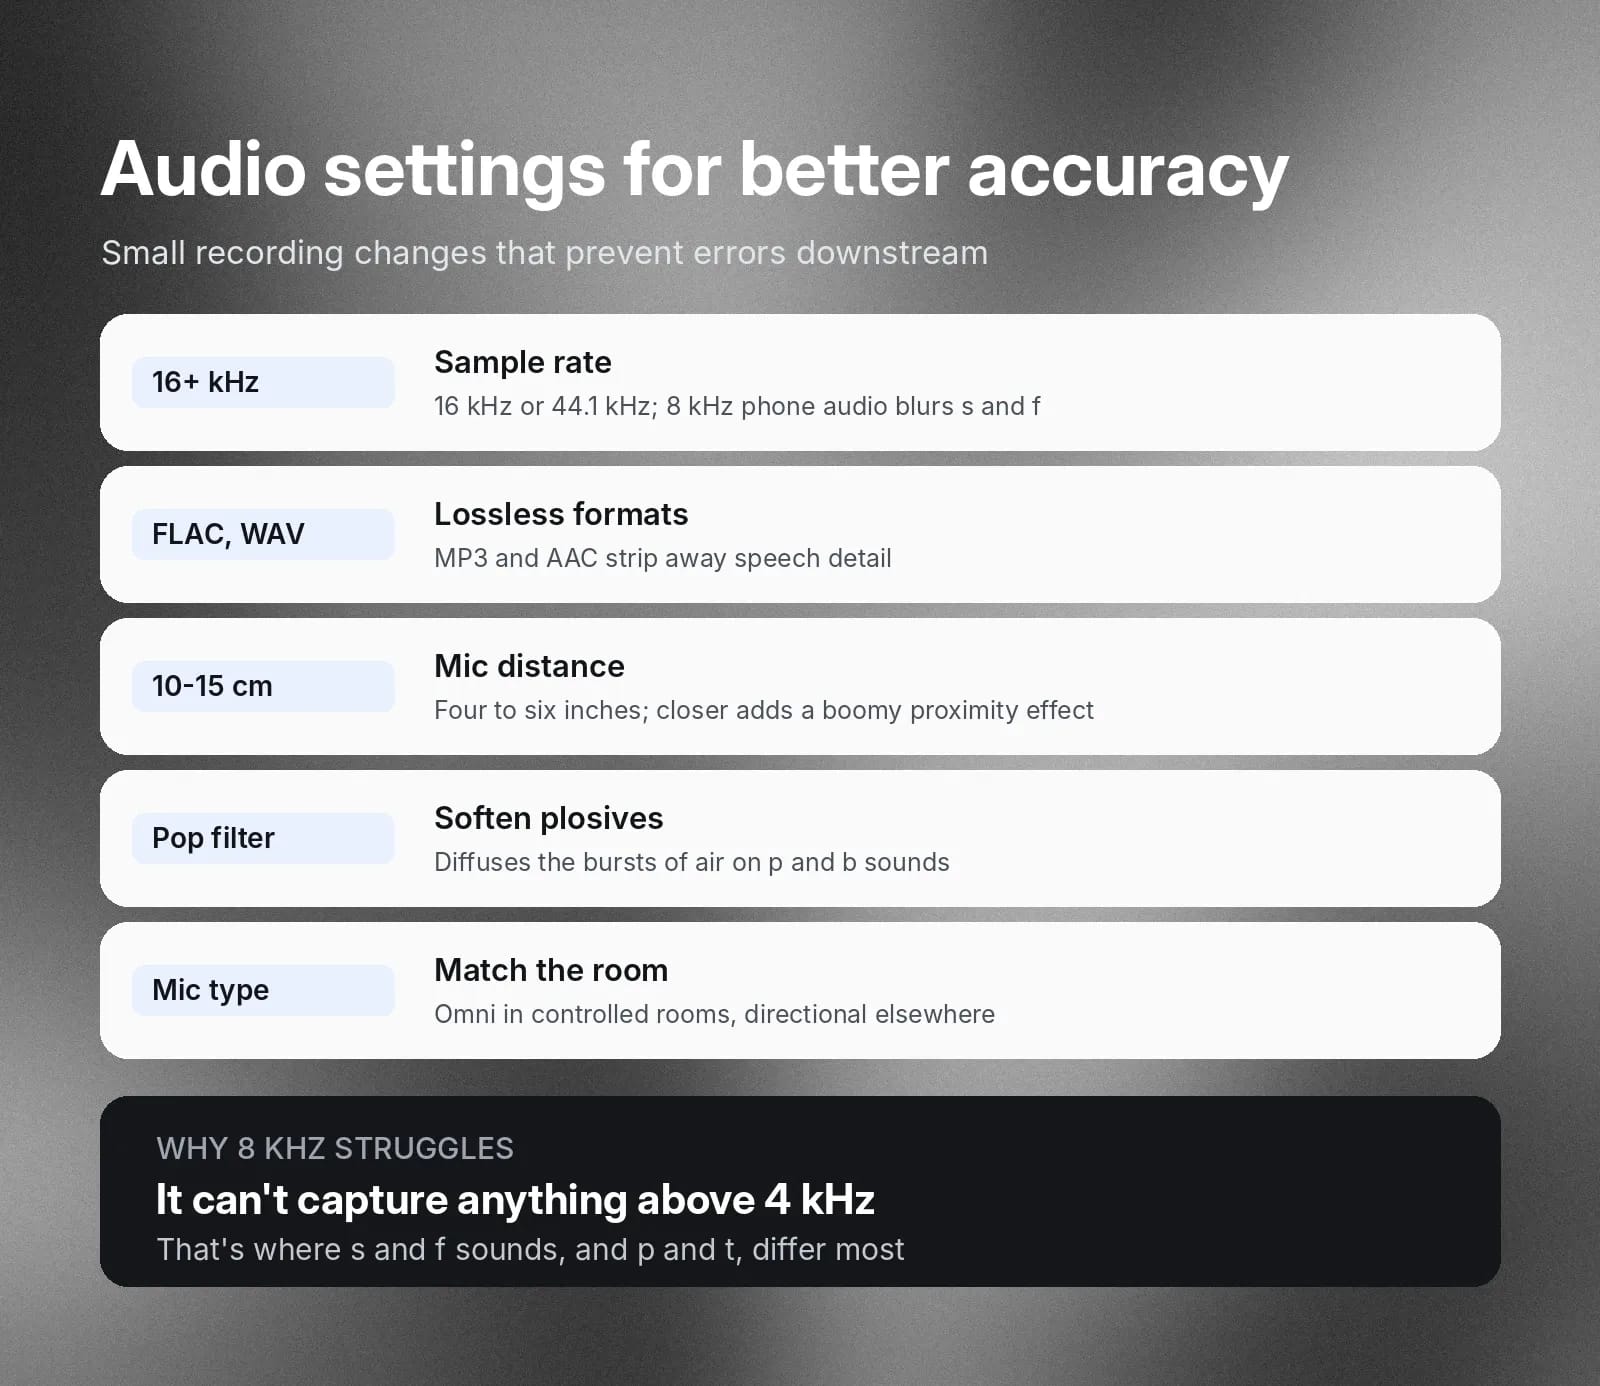
Att förbättra ljudkvaliteten vid inspelning kan minska många nedströmsproblem med noggrannheten. Använd en högre samplingsfrekvens, tillämpa minimal eller ingen komprimering och håll inspelningsmiljön så tydlig som möjligt.
Samplingskvalitet
Använd ljud med 16 kHz eller 44,1 kHz vid inspelning. Äldre telefonljud med 8 kHz samplingsfrekvens eller lägre kan vara svåra för STT-modeller att tolka. För modellerna låter det dämpat och otydligt, och de kan inte be talare att upprepa sig som en person kan i ett samtal.
En samplingsfrekvens kan bara återge frekvenser upp till hälften av sin egen frekvens. Det kallas systemets Nyquistfrekvens. Vid endast 8 kHz försvinner allt över 4 kHz, vilket särskilt gör det svårt för en STT-modell att skilja mellan frikativor (”s”- respektive ”f”-ljud) och klusiler (”p”- respektive ”t”-ljud).
Komprimering
Inspelning i förstörande format som MP3 och AAC kan också ta bort talets nyanser. Då finns det mindre signal för modellen att arbeta med. Håll dig till förlustfria eller okomprimerade format som FLAC eller PCM WAV.
Inspelningsmiljö
Följ bästa praxis inom ljudteknik när du använder mikrofoner. Rundupptagande mikrofoner fungerar bäst i kontrollerade miljöer. I andra fall är riktade mikrofoner bättre på att isolera tal. Placera mikrofonerna 10–15 cm från talarens mun och försök förhindra att talare lutar sig närmare, eftersom det skapar en närhetseffekt och gör inspelningen grumlig med förstärkta låga frekvenser.
Använd också ett popfilter på mikrofonen när det är möjligt. Popfilter sprider ut luftstötar som uppstår när du uttalar explosiva konsonanter, till exempel ”p”- och ”b”-ljud.
Minska bakgrundsbrus för bättre taligenkänning
Som nämndes i föregående avsnitt bör du använda närmikrofoninspelning där det är möjligt, helst 10–15 cm från talarens mun. Undvik vitt brus och bakgrundsbrus som gör inspelningar grumliga. Vanliga källor som du kanske inte märker utan erfarenhet av fältinspelning är brummande ventilationssystem, tangentbordsklick och allmänt gatubuller. Allt detta kan göra det svårare för en STT-modell att tolka tal.
Det är dock ofta omöjligt att undvika bakgrundsbrus. Då bör du använda voice isolation som ett förbehandlingssteg innan du skickar ljudet till en STT-modell. Voice isolation använder programvarualgoritmer eller en lätt, specialiserad neural modell för att filtrera bort bakgrundsljud från talinspekningar.
Hantera accenter, överlappande talare och specialiserad vokabulär
Moderna flerspråkiga modeller tränas på varierade taldata, men noggrannheten varierar fortfarande för ljud från verkligheten. Kör egna riktmärktester på olika modeller med exempelljud från relevanta målgrupper. Om du har historiska kundsamtal som du kan använda, kör dem genom transkribering – samtal med de accenter, taltempon och talmönster du vill transkribera i verkligheten.
Kontrollera resultaten efter fel och identifiera relevanta mönster. Har modellen svårt med slang som yngre åldersgrupper använder? Snubblar den på en viss regional accent som du ofta stöter på?
Hantera överlappande talare
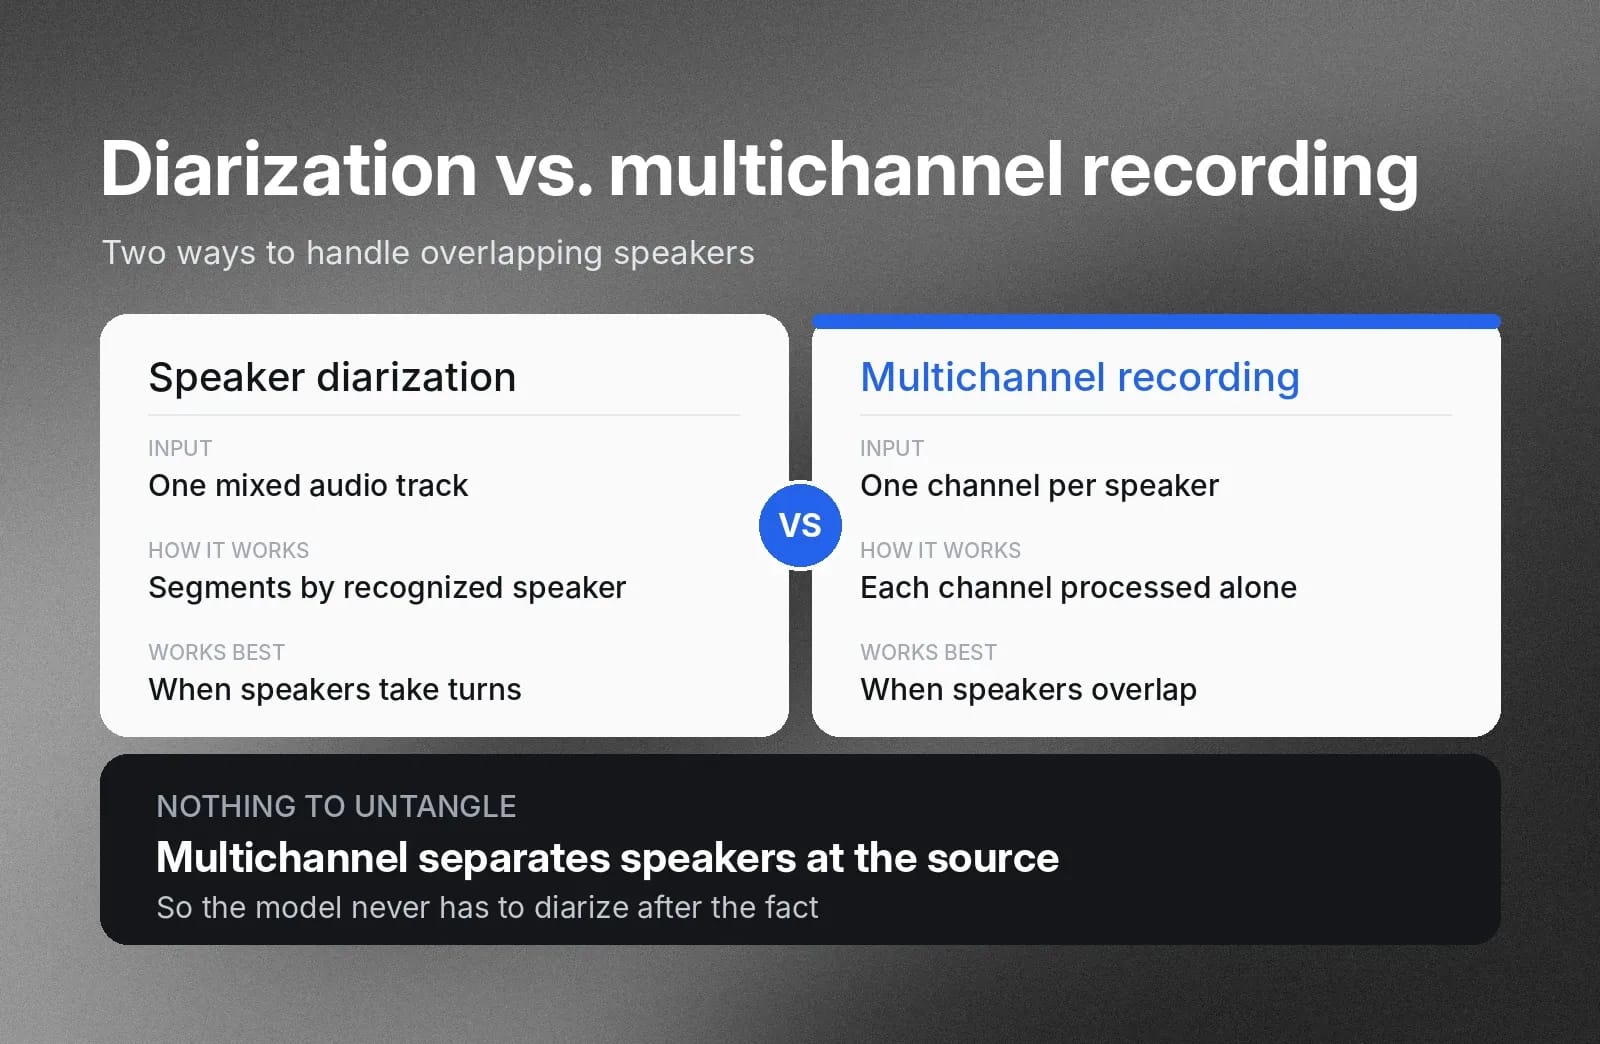
Dina två främsta verktyg för att transkribera överlappande tal korrekt är diarization och flerkanalsinspelning. En diarization-process tar en rå ljudinmatning och segmenterar den efter individuellt identifierade talare. Den fungerar bra när talarna turas om tydligt.
I stället för att blanda alla röstströmmar till ett ljudspår låter inbyggd flerkanalsinspelning dig behålla varje talare på en separat kanal, som STT-modellen kan identifiera och bearbeta oberoende av de andra. Varje talare är uppdelad direkt i inspelningen, så talmodellen behöver inte diarize i efterhand.
Keyterm prompting ger positiv bias
Varumärkesnamn, nya produktnamn, branschjargong och andra unika termer transkriberas ofta inte korrekt om de inte fanns i en STT-modells träningsdata. Keyterm prompting innebär att du ger en STT-modell specifika stavningar som du vill att den ska prioritera. Det är vanligtvis inte promptar för ordagrann ersättning, utan du styr modellen mot att välja den anpassade stavning du vill ha utifrån sammanhanget.
Transkribera siffror, ID:n och läkemedelsnamn korrekt
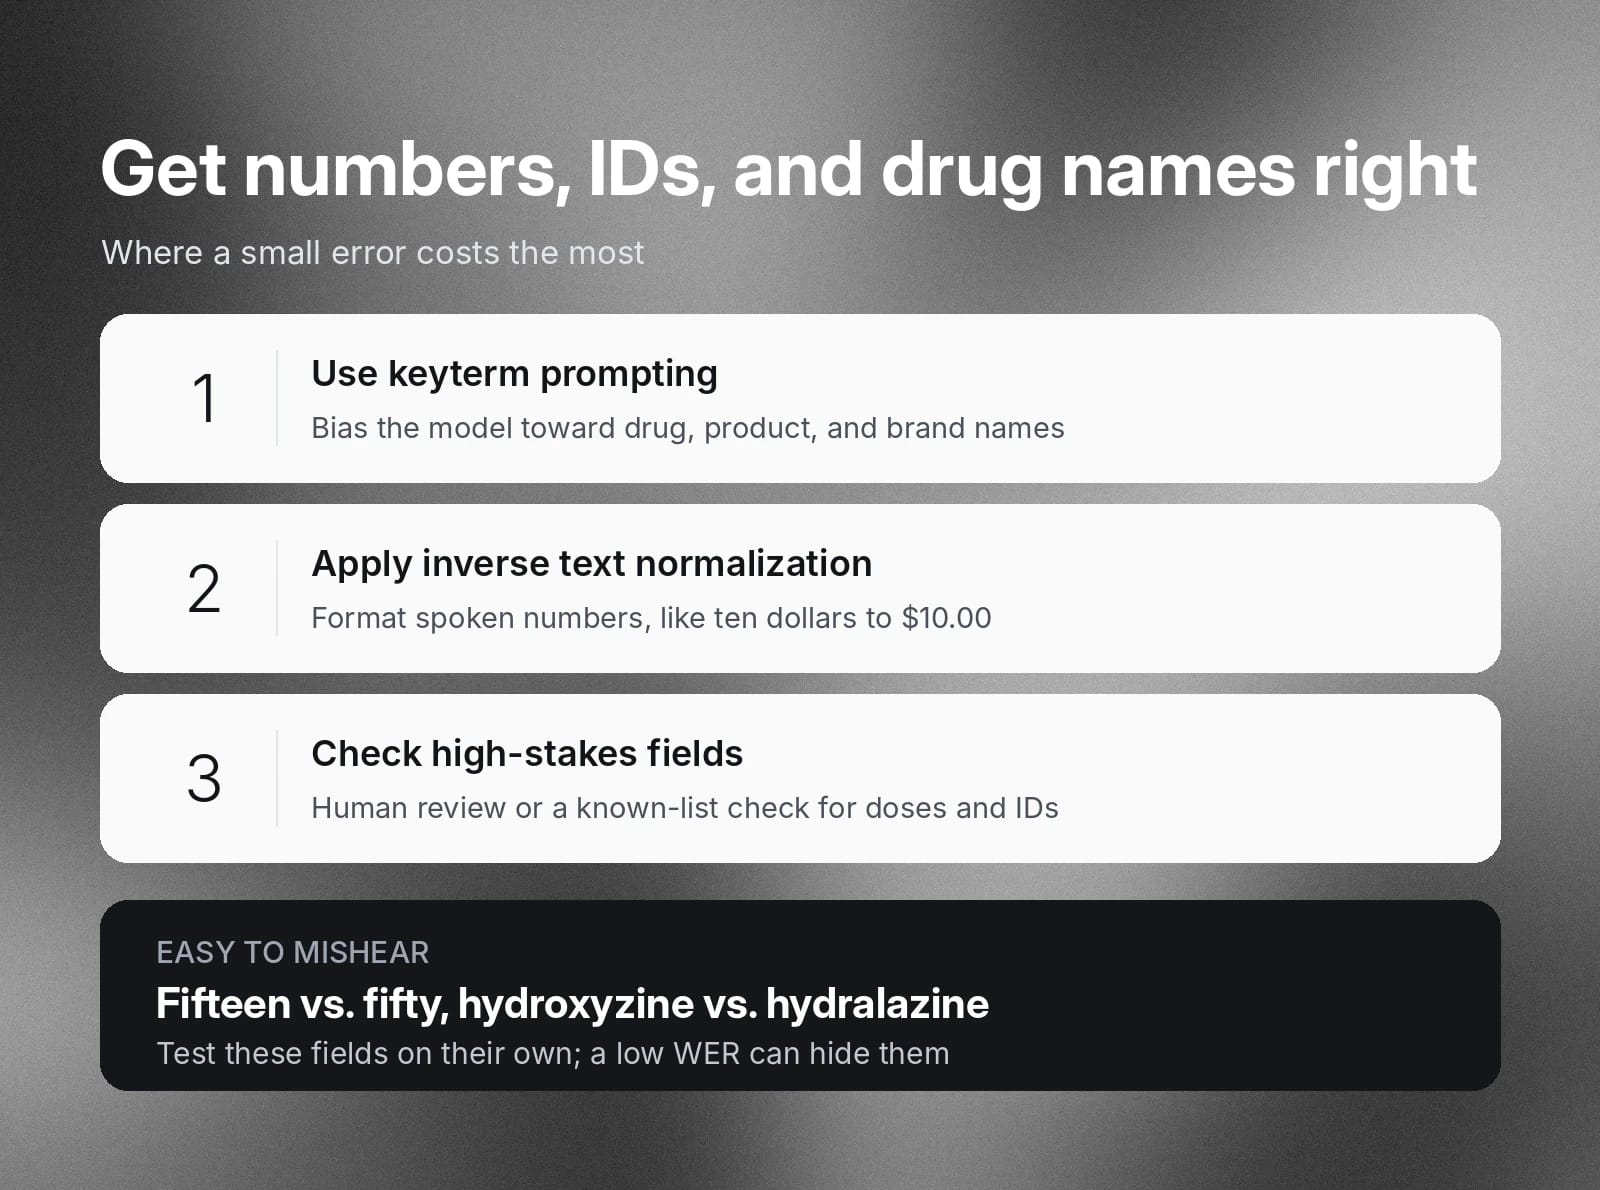
Siffror, konto-ID:n, postnummer och läkemedelsnamn är områden där ett litet fel kostar mest. En modell kan höra ”fifteen” som ”fifty” eller förväxla två läkemedelsnamn som skiljer sig med en stavelse, som hydroxyzine och hydralazine.
Tre steg hjälper:
- Använd keyterm prompting: Styr modellen mot stavningen av läkemedelsnamn, produktnamn och andra termer du förväntar dig.
- Använd invers textnormalisering (ITN): Formatera talade siffror konsekvent, till exempel genom att ändra ”tio dollar” till ”$10.00”.
- Lägg till en kontroll för fält där mycket står på spel: Använd mänsklig granskning eller en automatisk kontroll mot en känd lista för fält som läkemedelsdoser och kontonummer.
Testa dessa fält separat, eftersom ett lågt övergripande WER kan dölja fel i just de ord som är viktigast.
Mät kvalitet med word error rate i taligenkänning
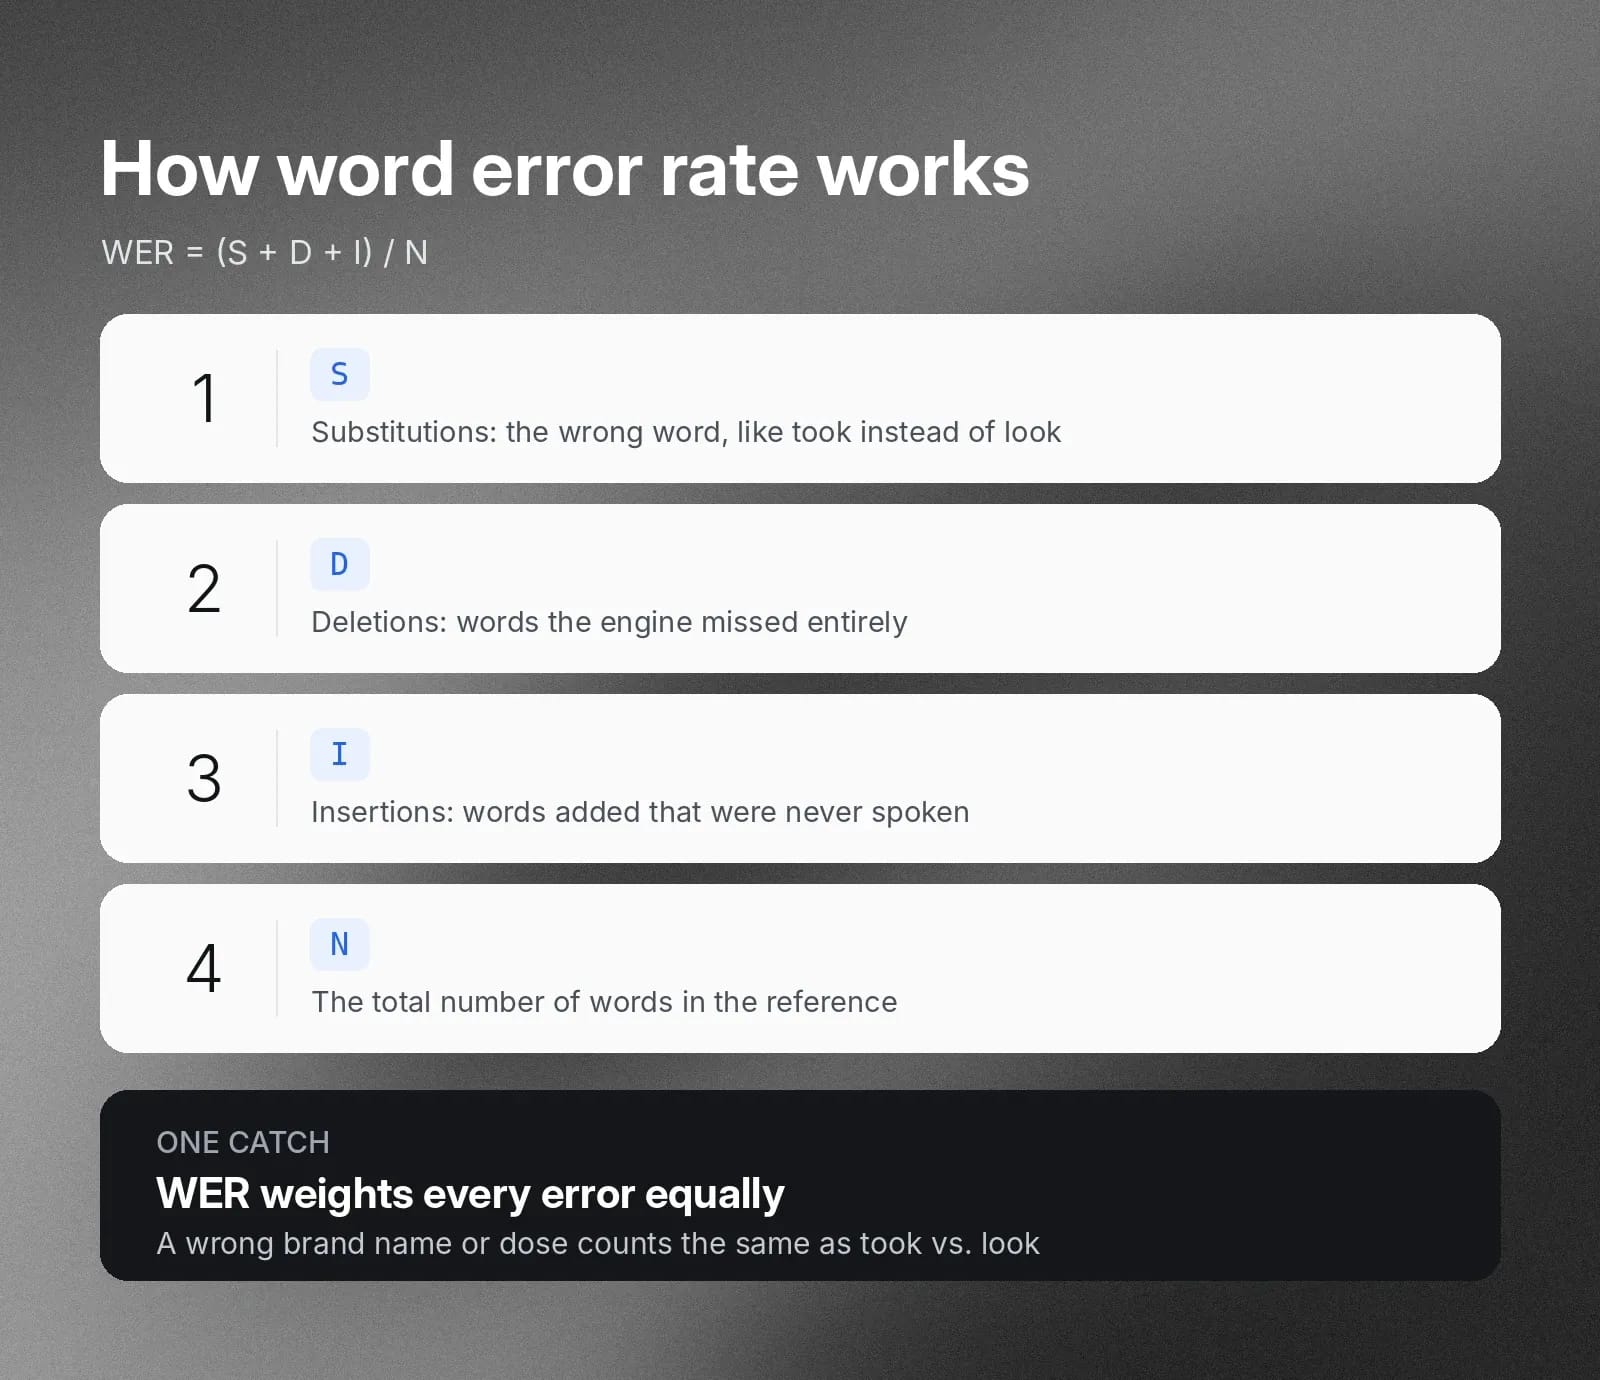
Word error rate (WER) är ett användbart mått för att bedöma noggrannheten hos en STT-motor. Du kan jämföra WER mellan olika modelltester för att få en uppfattning om deras relativa noggrannhet.
Så här beräknas WER:
WER = (S + D + I) / N
- Ersättningar (S): Antalet gånger STT-motorn skriver ut fel ord i en transkription, till exempel ”took” i stället för ”look”.
- Borttagningar (D): Antalet ord som den helt missade.
- Infogningar (I): Antalet ord som den lade till trots att de aldrig sades.
- Totalt antal referensord (N): Det totala antalet ord i talprovet.
Det är viktigt att notera att WER väger alla fel lika. Att till exempel ersätta ”look” med ”took” räknas lika mycket som att feltolka ditt varumärkesnamn eller en viktig uppgift, som storleken på en läkemedelsdos. Kontrollera WER-värdena för olika modeller.
Vad räknas som en bra word error rate?
Det finns inget enskilt bra WER, eftersom rätt mål beror på ditt ljud och ditt användningsfall. Rent ljud med en enda talare ger mycket lägre felfrekvenser än brusiga samtal med överlappande talare. Jämför modeller på dina egna inspelningar i stället för att förlita dig på en siffra i en rubrik.
Som referens för specialiserat ljud är Scribe v2 Medical en av de bäst presterande modellerna i offentliga medicinska ASR-riktmärken. Kontrollera aktuella resultat för de senaste siffrorna.
Riktmärkesresultat förändras när nya modeller släpps. Kontrollera aktuella resultat innan du jämför.
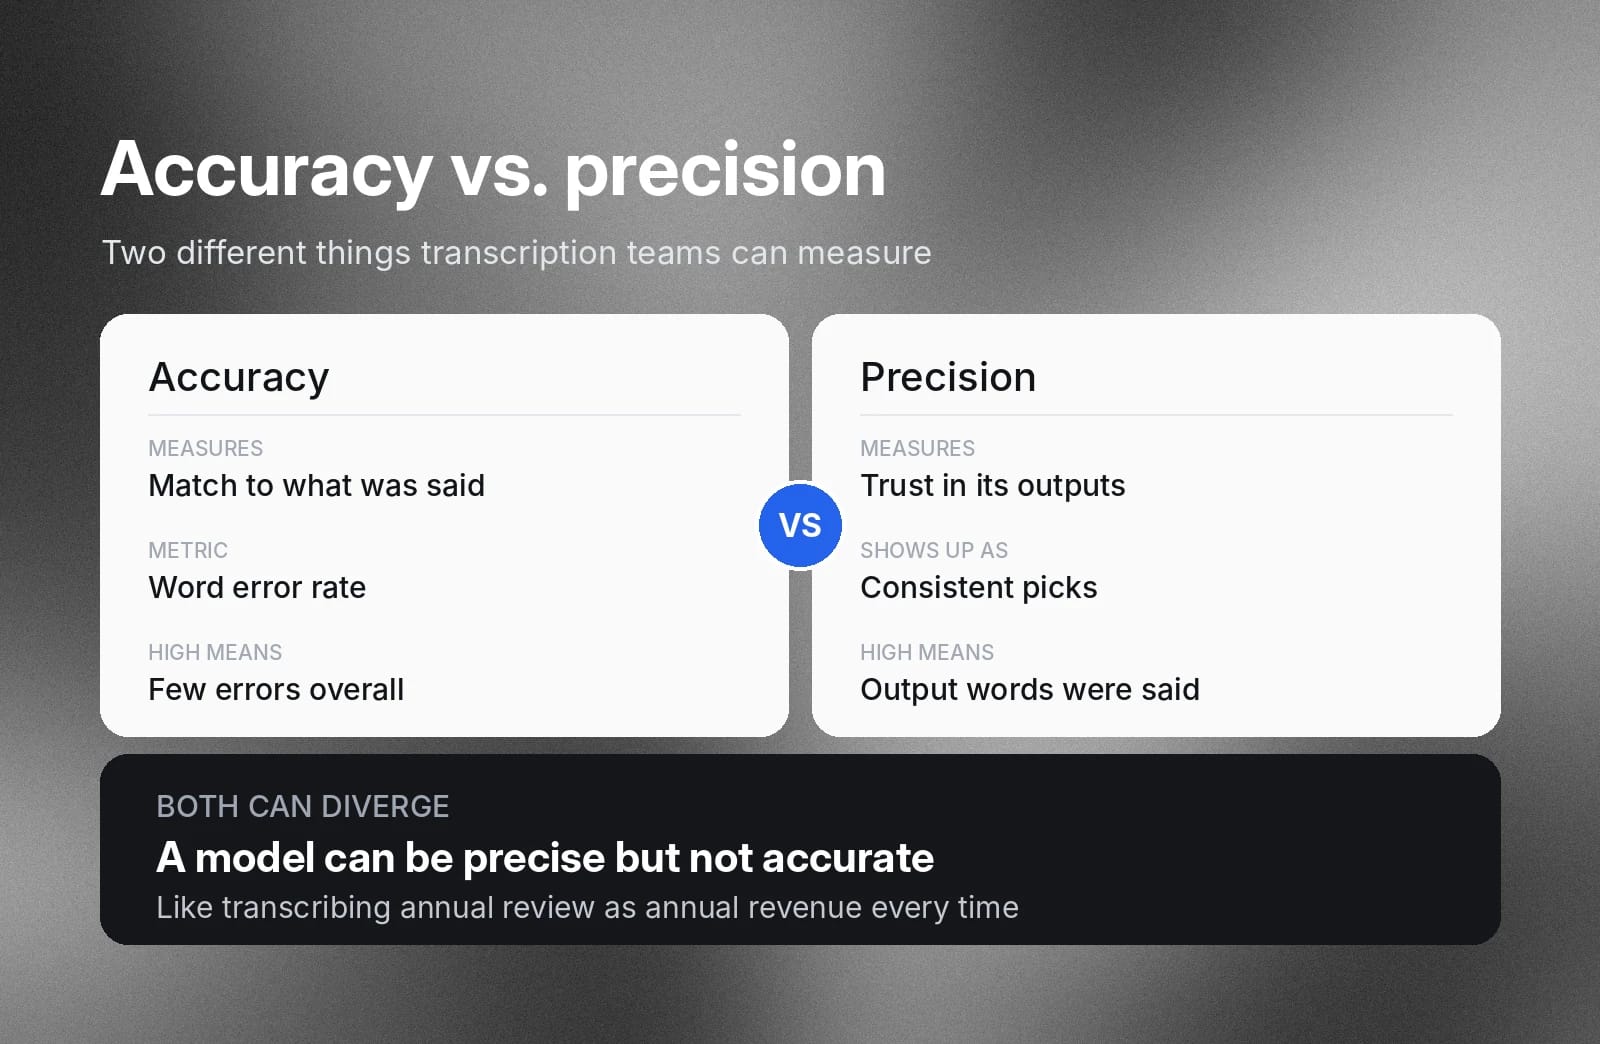
Noggrannhet jämfört med precision: vad transkriptionsteam bör mäta
Noggrannhet är hur väl transkriptionsresultatet stämmer överens med den talade inmatningens ”grundsanning”. Word error rate mäter noggrannhet.
Precision är hur tillförlitliga STT-modellens positiva förutsägelser är. En mycket precis modell väljer samma ord för komplext tal över flera körningar. Om modellen skriver ut ett ord kan du lita på att ordet fanns i talet. Men en mycket precis modell kan ändå ha låg noggrannhet, vilket innebär att den utelämnar många ord.
Kom igång med ElevenAPI för mer korrekt transkribering
ElevenAPI ger dig tillgång till Scribe v2, ElevenLabs modell för tal till text, tillsammans med funktioner som hanterar noggrannhetsproblemen i den här guiden: keyterm prompting för namn och jargong, flerkanalstranskribering för överlappande talare och talardiarization.
Om du vill transkribera utan att använda API:et kan du också använda ElevenCreateive STT.
Kom igång i dag och skapa tal till text av hög kvalitet med ElevenAPI, eller läs mer om ElevenAPI:s funktioner för tal till text.
Vanliga frågor om noggrannheten i tal till text

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.