Vad är flerspråkig transkribering och hur fungerar det?
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Oavsett om du arrangerar en internationell konferens eller bara vill ha korrekta register över kundsupportssamtal på valfritt språk, är flerspråkig transkribering viktigare än någonsin.
Genom att omvandla ljuddata till korrekt, sökbar text gör verktyg för flerspråkig transkribering samtal till användbara register. Tekniken som möjliggör transkribering på olika språk har utvecklats i takt med den växande forskningen inom Speech to Text-modeller (STT). Utvecklare kan nu även integrera kraftfulla STT-API:er i sina workflow för komplexa flerspråkiga transkriberingsflöden.
I den här artikeln går vi igenom vad flerspråkig transkribering är, berör hur den fungerar via datorapp och API samt visar varför den är viktig för företag världen över.
Sammanfattning
- Flerspråkig transkribering omvandlar en ljudfil till skriven text på flera språk.
- De bästa verktygen för flerspråkig transkribering erbjuder ytterligare funktioner som talarseparering, nyckelordsstyrning och enhetsidentifiering.
- Du kan använda verktyg för flerspråkig transkribering online eller integrera ett Speech to Text-API i utvecklingsworkflow.
- Automatisk transkribering ger snabbhet och skalbarhet, medan mänsklig transkribering kan vara användbar i komplexa fall med flera överlappande talare.
- Noggrannheten i flerspråkig transkribering mäts med Word Error Rate (WER), som varierar mellan språk.
Vad är flerspråkig transkribering och varför är den viktig?
Flerspråkig transkribering omvandlar talat ljud till skriven text på fler än ett språk. System med artificiell intelligens identifierar automatiskt språket eller språken som talas och transkriberar ljudet. Resultatet från flerspråkig STT kan vara en ordagrann transkription eller innehålla ett översättningslager som förenar inmatningsspråken i ett gemensamt resultat.
På en global konferens kan till exempel talare få frågor på sitt modersmål. Det flerspråkiga Speech to Text-verktyget kan antingen direkt transkribera vad varje talare säger på sitt eget språk eller skapa ett enhetligt resultat på ett målspråk som publiken kan läsa. Organisationer kan öka tillgängligheten till sina evenemang med dessa STT-verktyg.
ElevenLabs bygger in funktioner för flerspråkig STT direkt i vår Speech to Text Scribe v2-modell. Scribe v2 har stöd för automatisk språkidentifiering, vilket innebär att en enskild fil kan innehålla flera språk. Du kan ange vilka språk som finns i ett ljudklipp eller lämna inställningen på ”Detect” så identifierar vårt system språken i den uppladdade filen.
När du använder ElevenAPI är parametern language_code som standard inställd på automatisk förutsägelse. Om du redan vet vilka språk som förekommer förbättras prestandan om du anger dem i förväg.
Varför flerspråkig transkribering är viktig
Ny forskning tyder på att den globala marknaden för transkriberingstjänster kommer att nå 6 miljarder dollar år 2035. En del av det som driver tillväxten är det breda utbudet av användningsområden för flerspråkig STT.
Det finns flera praktiska skäl till att flerspråkig transkribering är viktig:
- Tillgänglighet: Bildtexter och undertexter är beroende av korrekta flerspråkiga transkriptioner innan översättning eller dubbning kan påbörjas. Flerspråkig STT kan avsevärt förbättra tillgängligheten för användare.
- Sökbarhet: Transkriberat ljud kan bli indexerbar text, vilket innebär att dina supportsamtal eller möten kan bli användbara resurser för andra. Sökbarhet är särskilt viktig när AI-system börjar lyfta fram mer data från interna dokument, där tydlig transkribering bidrar till att skapa ett heltäckande underlag.
- Efterlevnad: Många reglerade branscher behöver granskningsbara skriftliga register över talade interaktioner, och med flerspråkig STT kan du stödja detta på alla språk som dina kunder använder. Till exempel anger Financial Conduct Authority att finansinstitut måste spara inspelningar och transkriptioner av telefonsamtal.
- Globala innehållsflöden: Oavsett om det gäller dubbning eller textning börjar workflow alltid med en mycket korrekt ursprunglig transkription att utgå från. Kvalitativa verktyg för flerspråkig transkribering möjliggör det första steget i dessa bredare globala workflow för innehållsdistribution.
Flerspråkig transkribering är en nödvändig del av många branscher: telekomleverantörer som transkriberar supportsamtal, finansföretag som uppfyller efterlevnadskrav, vårdteam som dokumenterar patientinteraktioner och till och med filmstudior som lokaliserar innehåll. Oavsett om du arbetar med SaaS, resor eller samhällstjänster säkerställer ett kraftfullt system att dina transkriptioner alltid håller hög kvalitet och är exakta.
Viktiga funktioner att leta efter i lösningar för flerspråkig transkribering
Verktyg för flerspråkig transkribering måste kunna anpassa sig till ljudinmatningen de arbetar med, identifiera språk dynamiskt och transkribera dem med hög precision.
Här är de viktigaste funktionerna att leta efter i en högkvalitativ lösning för flerspråkig transkribering:
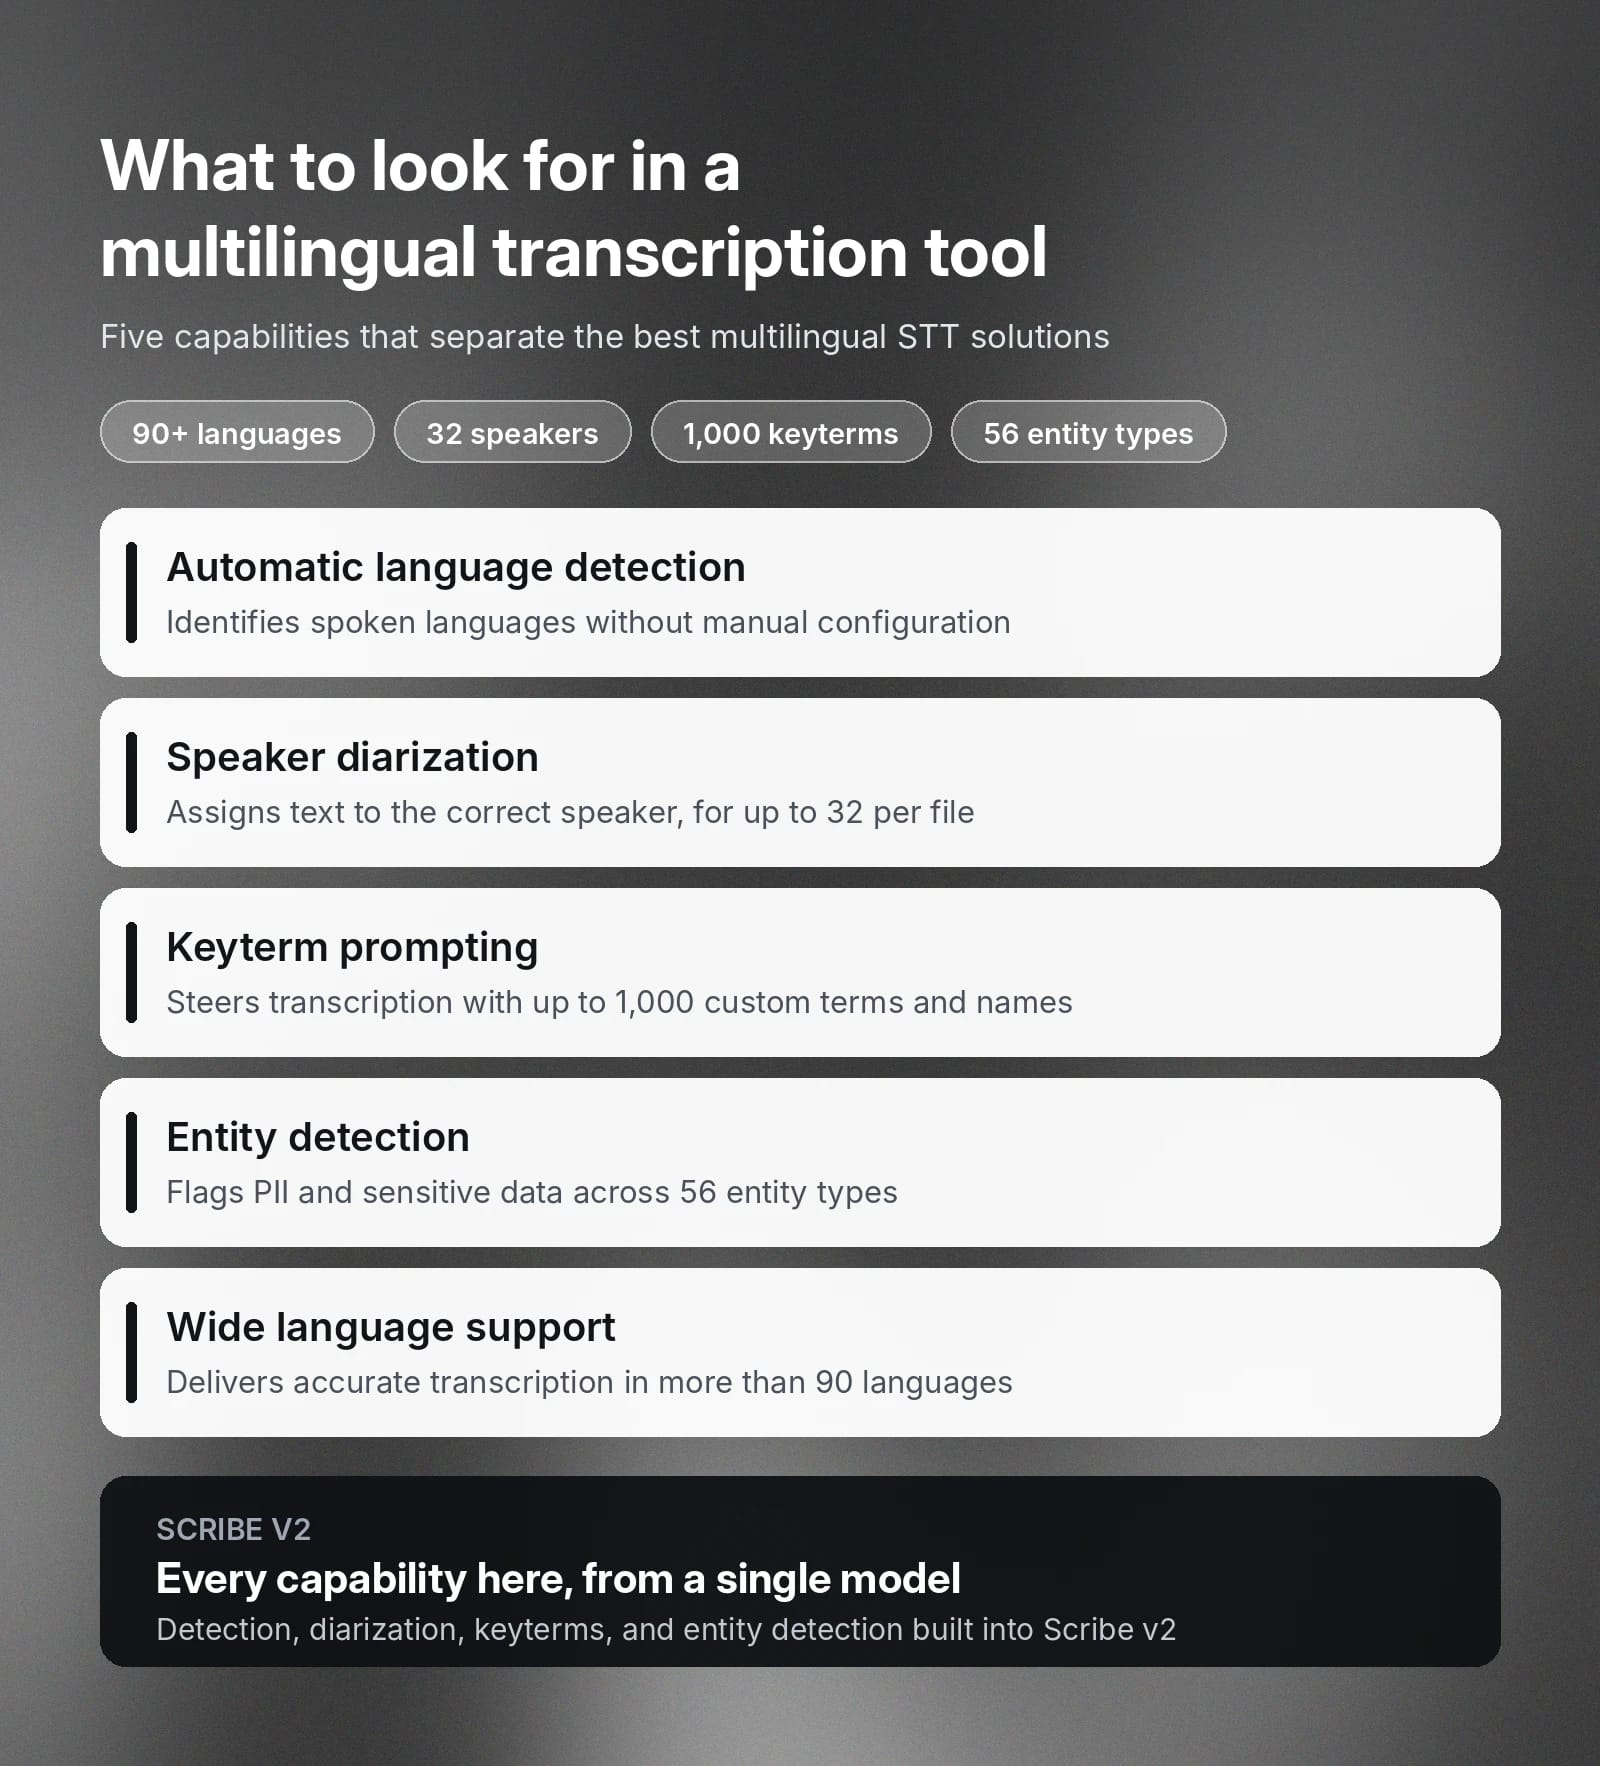
- Automatisk språkidentifiering: Systemet bör själv identifiera språket som talas, i stället för att blockera transkribering tills användaren anger ett källspråk. Särskilt när inmatningsspråket är okänt eller ett klipp innehåller flera språk säkerställer automatisk språkidentifiering att du kan hantera flera språk utan manuell konfigurering.
- Talarseparering: Talarseparering kopplar transkriberad text till rätt talare i en fil, vilket är viktigt för alla ljudtranskriptioner med flera talare. Det kan till exempel finnas flera personer i en panel som du behöver skilja åt, eller helt enkelt en tydlig avgränsning mellan när en kund och en supportagent talar. Scribe v2 har stöd för talarseparering för upp till 32 talare i en och samma fil.
- Nyckelordsstyrning: Nyckelord gör det möjligt för användare att manuellt ange specifik vokabulär, till exempel produktnamn eller egennamn, för att säkerställa korrekt transkribering. I batchsystem tillåter Scribe v2 upp till 1 000 nyckelord, medan Scribe v2 Realtime för live-transkribering erbjuder upp till 50.
- Enhetsidentifiering: Enhetsidentifiering identifierar specifika ord i en transkription, vilket är viktigt för efterlevnad och säkerhetsarbete som skyddar känsliga data. Läs ElevenLabs dokumentation om enhetsidentifiering för en fullständig genomgång av de 56 enhetstyper som stöds.
- Brett språkstöd: De bästa flerspråkiga STT-lösningarna har naturligtvis stöd för transkribering på ett stort antal språk. Som referens erbjuder Scribe v2 korrekt transkribering på över 90 språk.
Tillsammans stöder dessa funktioner många olika användningsområden och gör att du kan använda ett tillförlitligt STT-system som täcker flera språk med precision.
Så transkriberar du ljud på olika språk effektivt
Det mest effektiva sättet att transkribera ljud på olika språk beror på vilken arbetsmängd du har i åtanke. För enstaka batchfiler kan du ladda upp en fil på ElevenLabs Speech to Text-sida och snabbt få transkriptionen.
När du arbetar i ElevenCreative, är att transkribera ljud så enkelt som att:
- Ladda upp ljudet: Gå till Speech to Text och klicka på ”Transcribe files”.
- Välja alternativ: Välj huvudspråk eller lämna det på ”Detect”, aktivera ljudhändelser om du vill tagga skratt eller andra händelser som inte är tal, och lägg till nyckelord vid behov.
- Visa resultaten: När du har laddat upp dina filer kan du klicka på ljudfilens namn för att se transkriptionen. Därifrån kan du granska och förfina transkriptionen direkt i Transcript Editor och sedan exportera den i det format som varje efterföljande workflow behöver.
För programmatisk transkribering eller transkribering i stor skala använder du Speech to Text API. Här är några detaljer som kan hjälpa dig att utforma produktionsflöden:
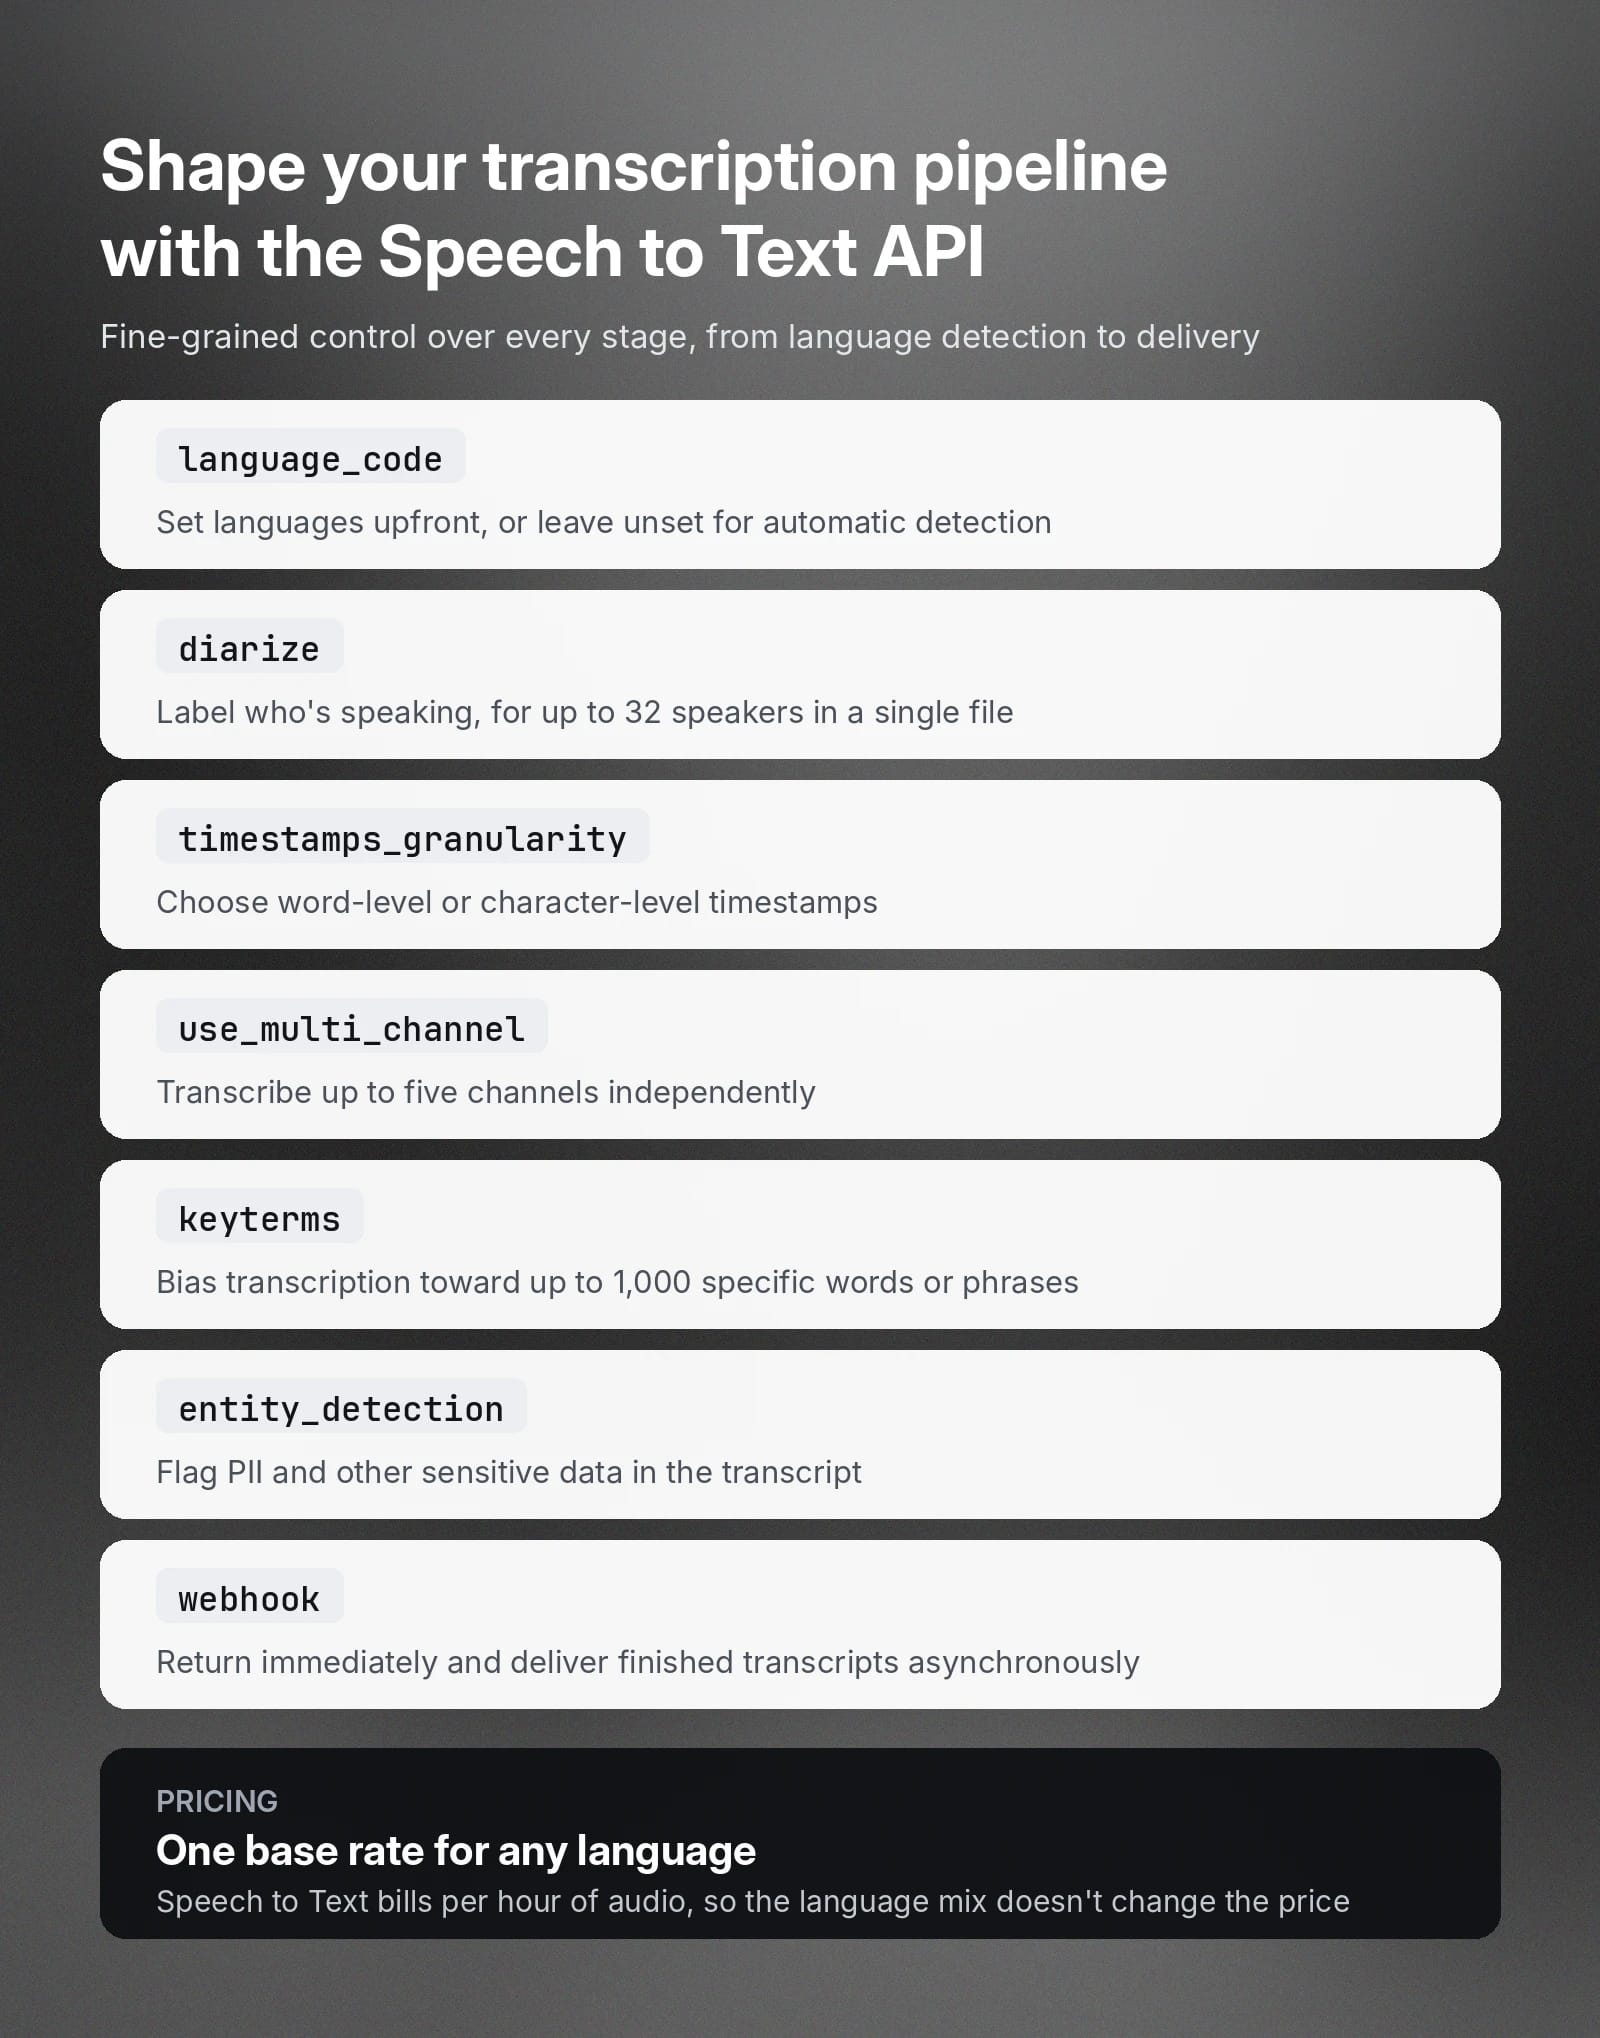
- Modellval: Parametern model_id väljer mellan scribe_v2 och scribe_v1, så att pipeline kan ange en specifik modell i stället för att förlita sig på ett standardval som kan ändras över tid.
- Språkhantering: Parametern language_code accepterar en ISO-639-1- eller ISO-639-3-kod och använder automatisk identifiering som standard när den lämnas odefinierad. Att ange ett språk direkt kan förbättra prestandan.
- Kontroller för talarseparering: Om du ställer in diarize på true anges vilken talare som pratar. Parametern num_speakers begränsar antalet till mellan 1 och 32. För mer detaljerad kontroll kan du använda parametern diarization_threshold för att justera avvägningen mellan olika talare.
- Tidsstämpelprecision: Parametern timestamps_granularity styr detaljnivån i resultatet, med alternativ för tidsstämplar på ord- eller teckennivå tidsstämplar (eller inga alls).
- Asynkron bearbetning i stor skala: Om du ställer in webhook på true returneras svaret direkt och den färdiga transkriptionen levereras till din konfigurerade webhook när bearbetningen är klar. Fältet webhook_metadata bifogar anpassade spårningsdata, som ditt interna jobb-ID, till varje webhook-svar.
- Flerkanalsljud: Om du ställer in use_multi_channel på true transkriberas varje kanal oberoende, med upp till fem kanaler, och varje ord taggas med fältet channel_index.
- Hantering av specialiserat innehåll: Parametern keyterms styr transkriberingen mot upp till 1 000 specifika ord eller fraser, entity_detection flaggar PII och andra känsliga data, och no_verbatim tar bort utfyllnadsord och felsägningar från resultatet.
Tillsammans ger dessa parametrar dig detaljerad kontroll över varje steg i pipeline. Från språkidentifiering och talarmärkning till formatering och leverans av resultatet anpassar sig Speech to Text API efter dina produktionsbehov.
Förklaring av språk som stöds för transkriberingstjänster
Språktäckning är en viktig faktor som skiljer de bästa verktygen för flerspråkig transkribering åt. ElevenLabs Scribe v2 och Scribe v2 Realtime har båda stöd för över 90 språk, och i Speech to Text-dokumentationen finns hela listan över språk som stöds.
Språk som engelska, spanska, italienska, polska, franska och tyska har större mängder träningsdata, vilket innebär att STT för dessa språk ofta har högre precision. Vissa språk, som amhariska, ganda, yoruba och zulu, har lägre precision än språken ovan.
ElevenLabs Scribe-modeller har <5 % ordfelsfrekvens för 36 olika språk och <10 % WER för ytterligare 21. Läs ElevenLabs genomgång av språkstödet för mer information om språk som stöds och deras WER-värden.
Vad kostar flerspråkig transkribering?
Prissättning för automatisk transkribering baseras vanligtvis på ljudfilens längd, snarare än antalet ord eller språk. ElevenLabs tar betalt för Speech to Text baserat på ljudets längd, per ljudtimme. Exakta priser varierar beroende på nivå och modell.
Det här är de främsta faktorerna som påverkar priset för flerspråkig transkribering:
- Ytterligare transkriberingsfunktioner: Vissa leverantörer tar extra betalt för att aktivera vissa funktioner, till exempel enhetsidentifiering.
- Flerkanalsljud debiteras per kanal: När use_multi_channel aktiveras debiteras varje kanal separat, så en inspelning med två kanaler kostar ungefär dubbelt så mycket som en inspelning med en kanal.
- Språket ändrar inte grundpriset: Tidsbaserad prissättning innebär att flerspråkig STT kan stödja alla språk till samma pris per timme, vilket förenklar budgeteringen för team som arbetar med flera språk.
Mer information om vad ElevenLabs Speech to Text kostar finns på vår prissida.
Kom igång med ElevenAPI för korrekt flerspråkig transkribering
ElevenAPI gör flerspråkig transkribering tillgänglig i alla produktionsworkflow i bara några steg. Oavsett om du transkriberar innehåll för globala mediearkiv, kundsupport-interaktioner, möten eller forskningsintervjuer, eller bara söker korrekt taligenkänning på dussintals språk, kan vår kraftfulla flerspråkiga STT-motor hjälpa dig.
Utforska ElevenAPI Speech to Text API för att se alla funktioner, eller skapa ett ElevenLabs-konto för att börja transkribera flerspråkigt ljud i dag.
Vanliga frågor om flerspråkig transkribering

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.