Przedstawiamy Eleven Realtime: prostszy sposób na tworzenie naturalnych agentów głosowych
- Autor
- Min Kim
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Stworzenie agenta głosowego, który brzmi naturalnie, wymaga dziś wielu decyzji. Trzeba wybrać poszczególne komponenty, takie jak rozpoznawanie mowy, wykrywanie aktywności głosowej, zarządzanie turami, bazowy LLM i zamiana tekstu na mowę. Zbudowanie takiego stosu to projekt sam w sobie, a sprawne współdziałanie wszystkich komponentów wymaga dodatkowych testów i dostrajania.
Eleven Realtime to nowa klasa modeli Speech to Speech, która eliminuje te przeszkody. Każdy model to kompletny agent głosowy zoptymalizowany pod inne zastosowania. Oba obsługują ponad 90 języków i mogą korzystać z dowolnego z ponad 17 000 głosów w bibliotece ElevenLabs:
Dziś wprowadzamy:
- Eleven Realtime v1 Mini do naturalnych rozmów przy niskich kosztach. To najlepszy wybór dla asystentów AI, nauczycieli i interaktywnych postaci, który sprawdzi się w większości zastosowań.
- Eleven Realtime v1 Max do złożonych zadań. Idealnie nadaje się do obsługi klienta, kwalifikacji leadów i wieloetapowych workflowów, w których agent musi trzymać się procesu i analizować kolejne kroki.
Dlaczego stworzyliśmy modele realtime
Nie musisz zostać ekspertem od konfiguracji, by stworzyć agenta głosowego brzmiącego naturalnie. To, czy agent dobrze brzmi i sprawia właściwe wrażenie, zależy od drobnych decyzji wymagających wyczucia: jak długo czekać po pauzie przed odpowiedzią, jak reagować, gdy użytkownik przerwie agentowi, oraz jak głos, prompty i model współpracują ze sobą. W ElevenAgents możesz dostosować wszystkie te ustawienia.
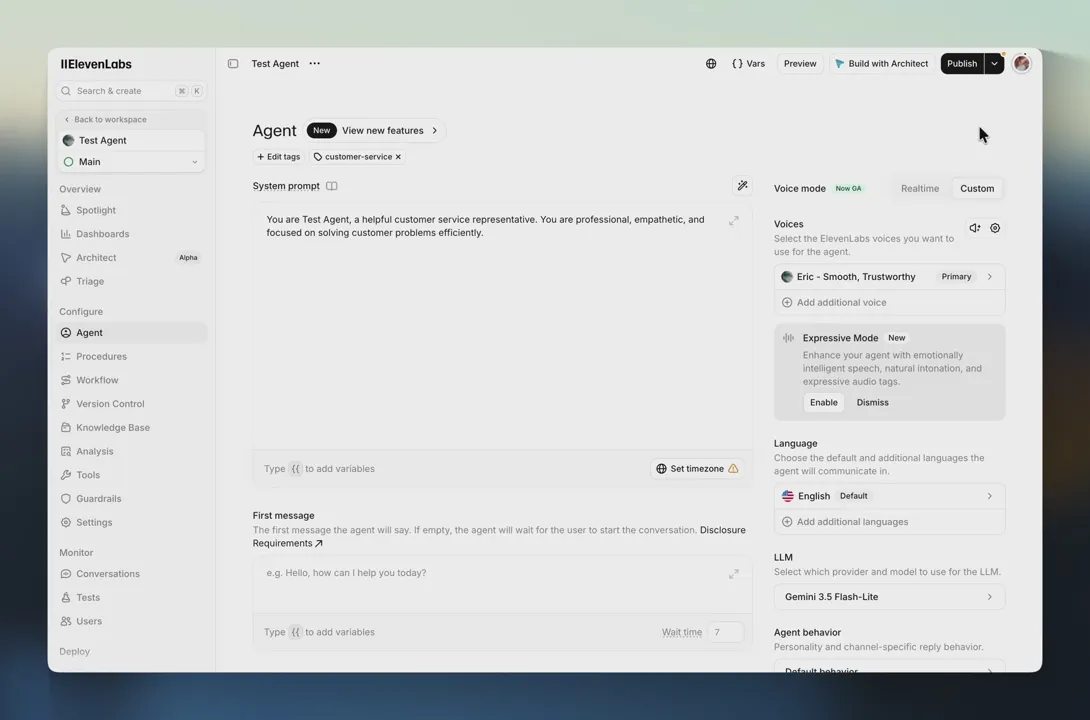
To samo dotyczy deweloperów, którzy już korzystają z realtime API. Nasze API jest zgodne z Realtime API OpenAI, więc aby wypróbować Eleven Realtime, wystarczy zmienić endpoint i nazwę modelu w kodzie, który możesz już mieć.
Oparte na architekturze kaskadowej
Eleven Realtime opiera się na architekturze kaskadowej z opisanych wyżej komponentów, dostrojonych end-to-end. Nazywamy je modelami Speech to Speech, bo właśnie to otrzymujesz: audio na wejściu, audio na wyjściu, jeden identyfikator modelu i system, który można mierzyć w tych samych rankingach co modele fused i duplex.
Modele fused początkowo wyznaczyły poziom naturalności, jaki może osiągnąć agent głosowy, podczas gdy konfiguracja kaskadowa zwiększała opóźnienie przy każdym przekazaniu i obejmowała komponenty, które nigdy nie były dostrajane względem siebie. Realtime eliminuje ten kompromis, a dostrajanie, które wcześniej było twoim projektem, jest już gotowe.
Architektura kaskadowa ma też praktyczne zalety w produkcji, ponieważ każdy etap generuje tekst. Możesz zobaczyć, co agent usłyszał i co zdecydował się powiedzieć, więc odróżnisz źle usłyszane słowo od błędnej decyzji. Ten sam tekst pozwala ElevenAgents stosować zabezpieczenia i redakcję danych osobowych (PII) w agencie Realtime.
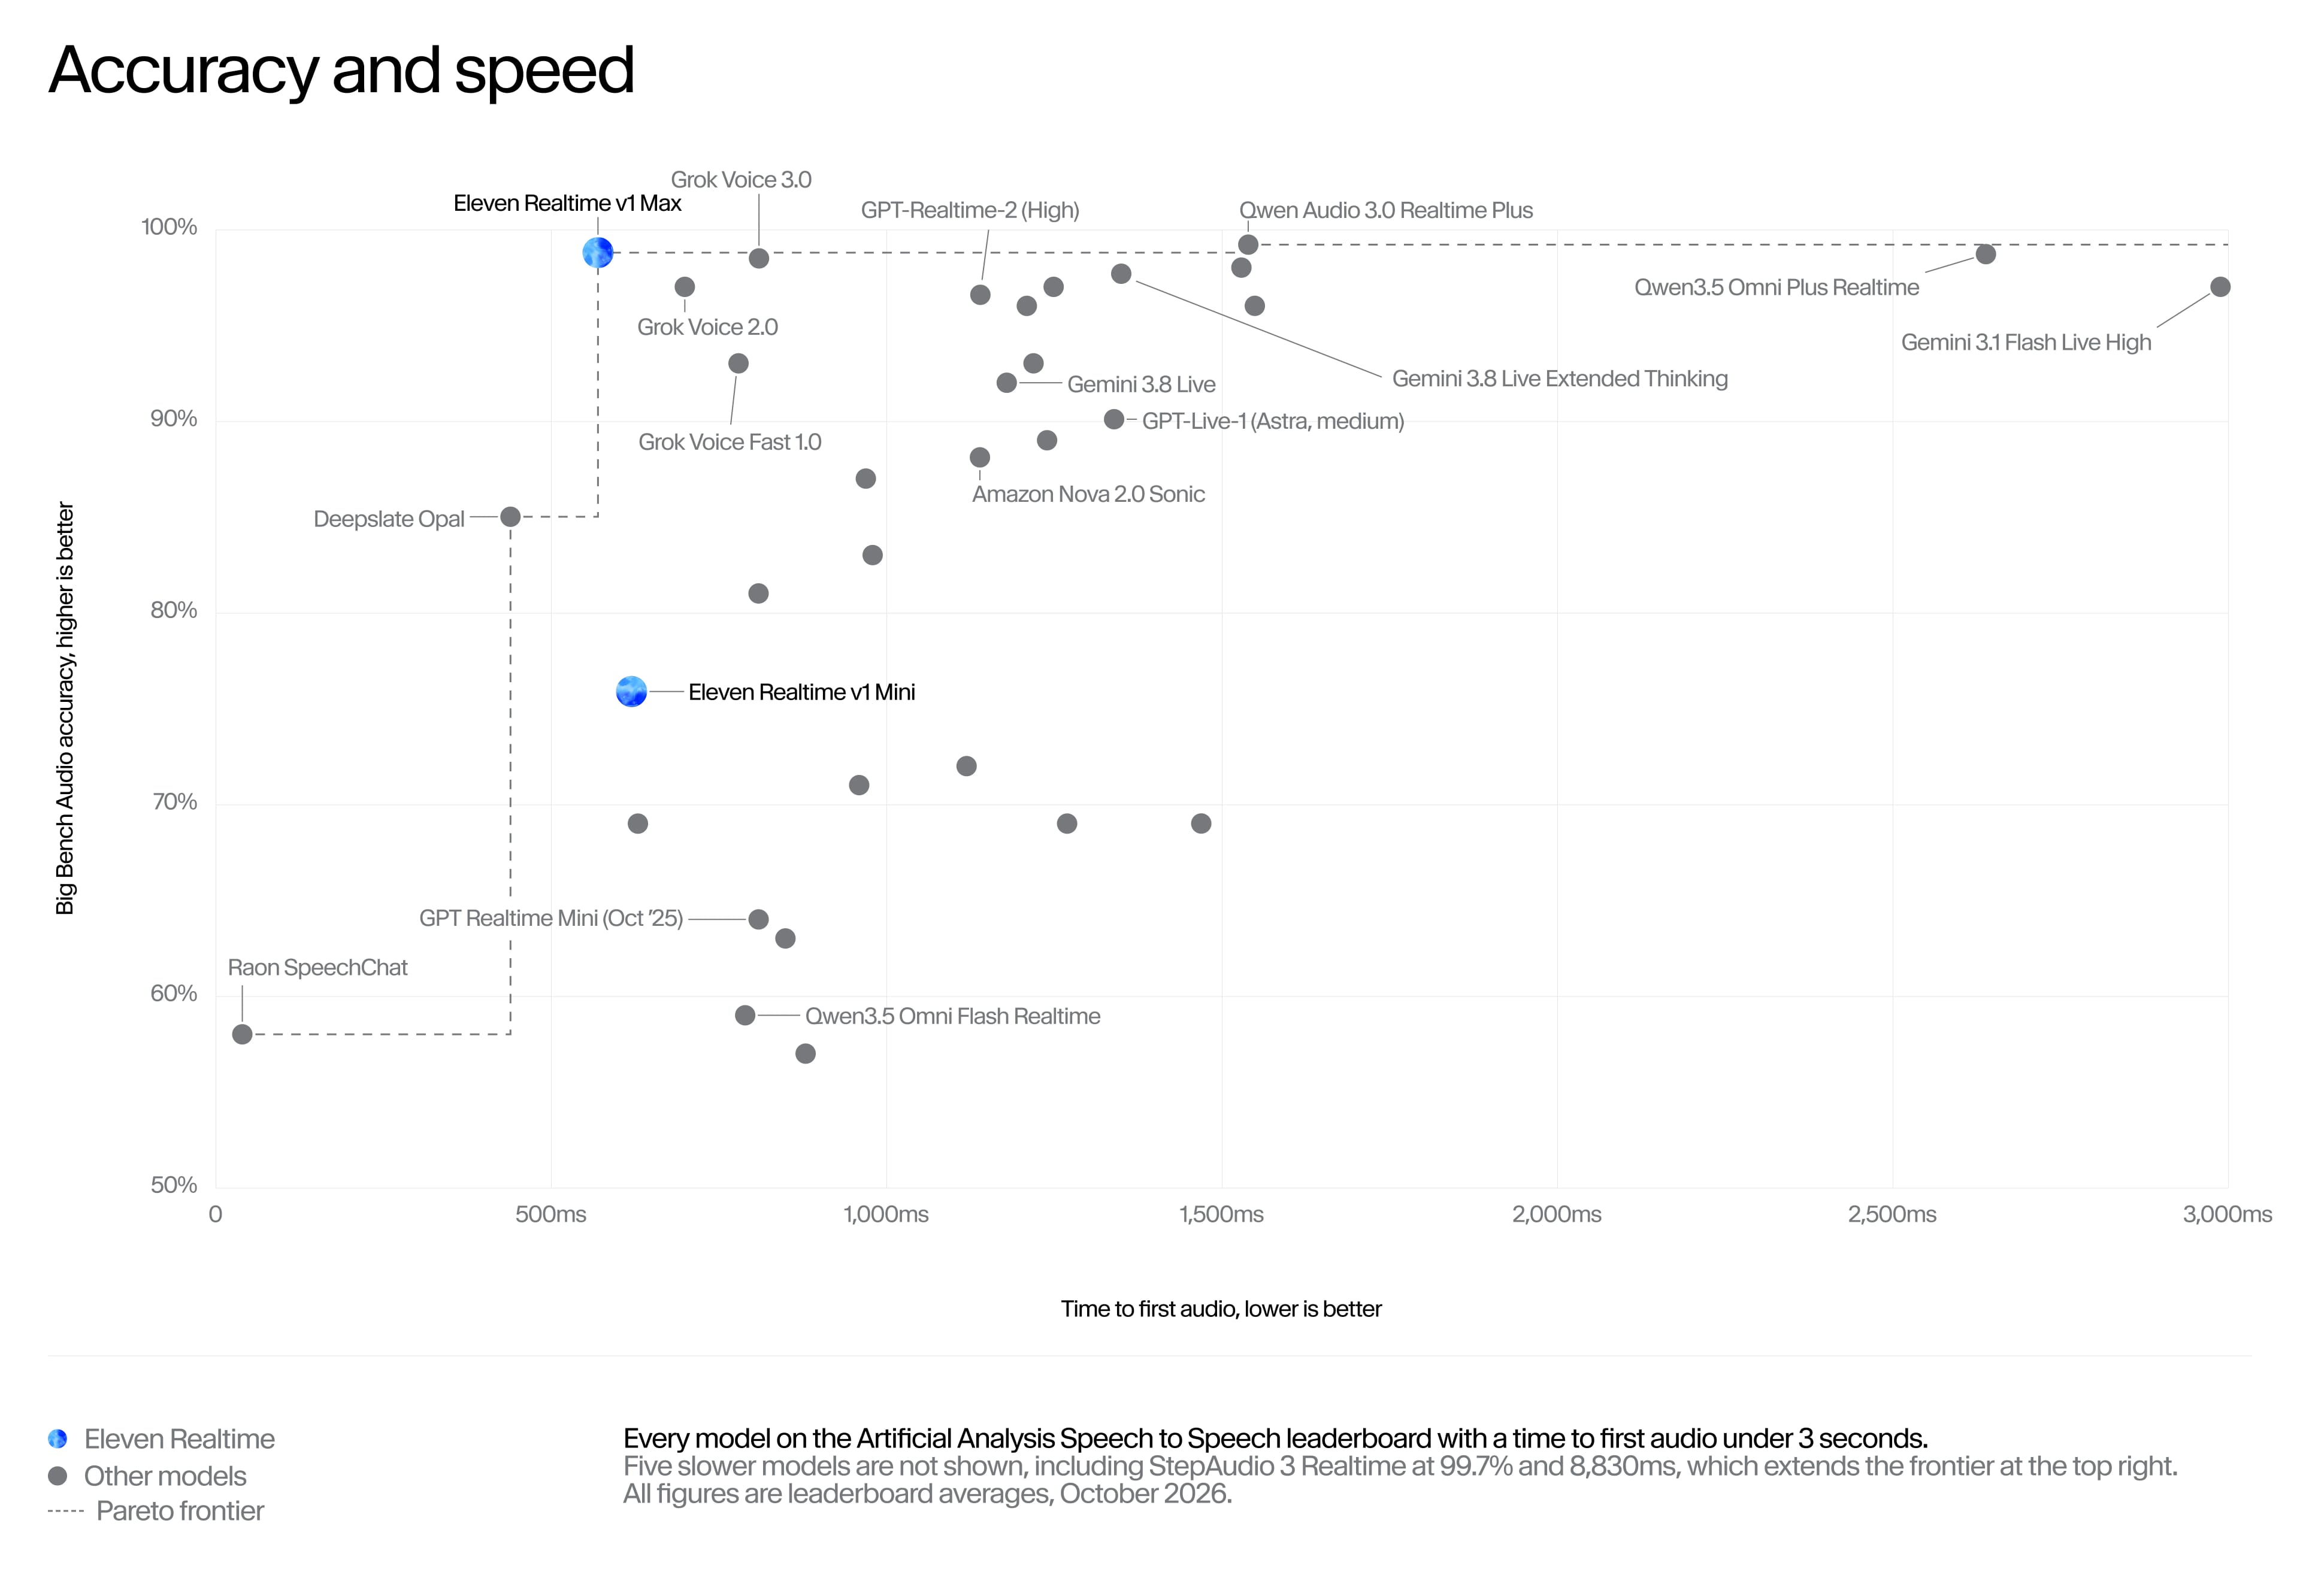
Poniższe benchmarki sprawdzają, czy ten kompromis rzeczywiście zniknął. W dynamice rozmowy oba modele osiągają wyniki na poziomie modeli fused. Pod względem łącznej dokładności i szybkości żaden model w rankingu Artificial Analysis nie jest jednocześnie szybszy i dokładniejszy niż v1 Max.
Wyniki modeli
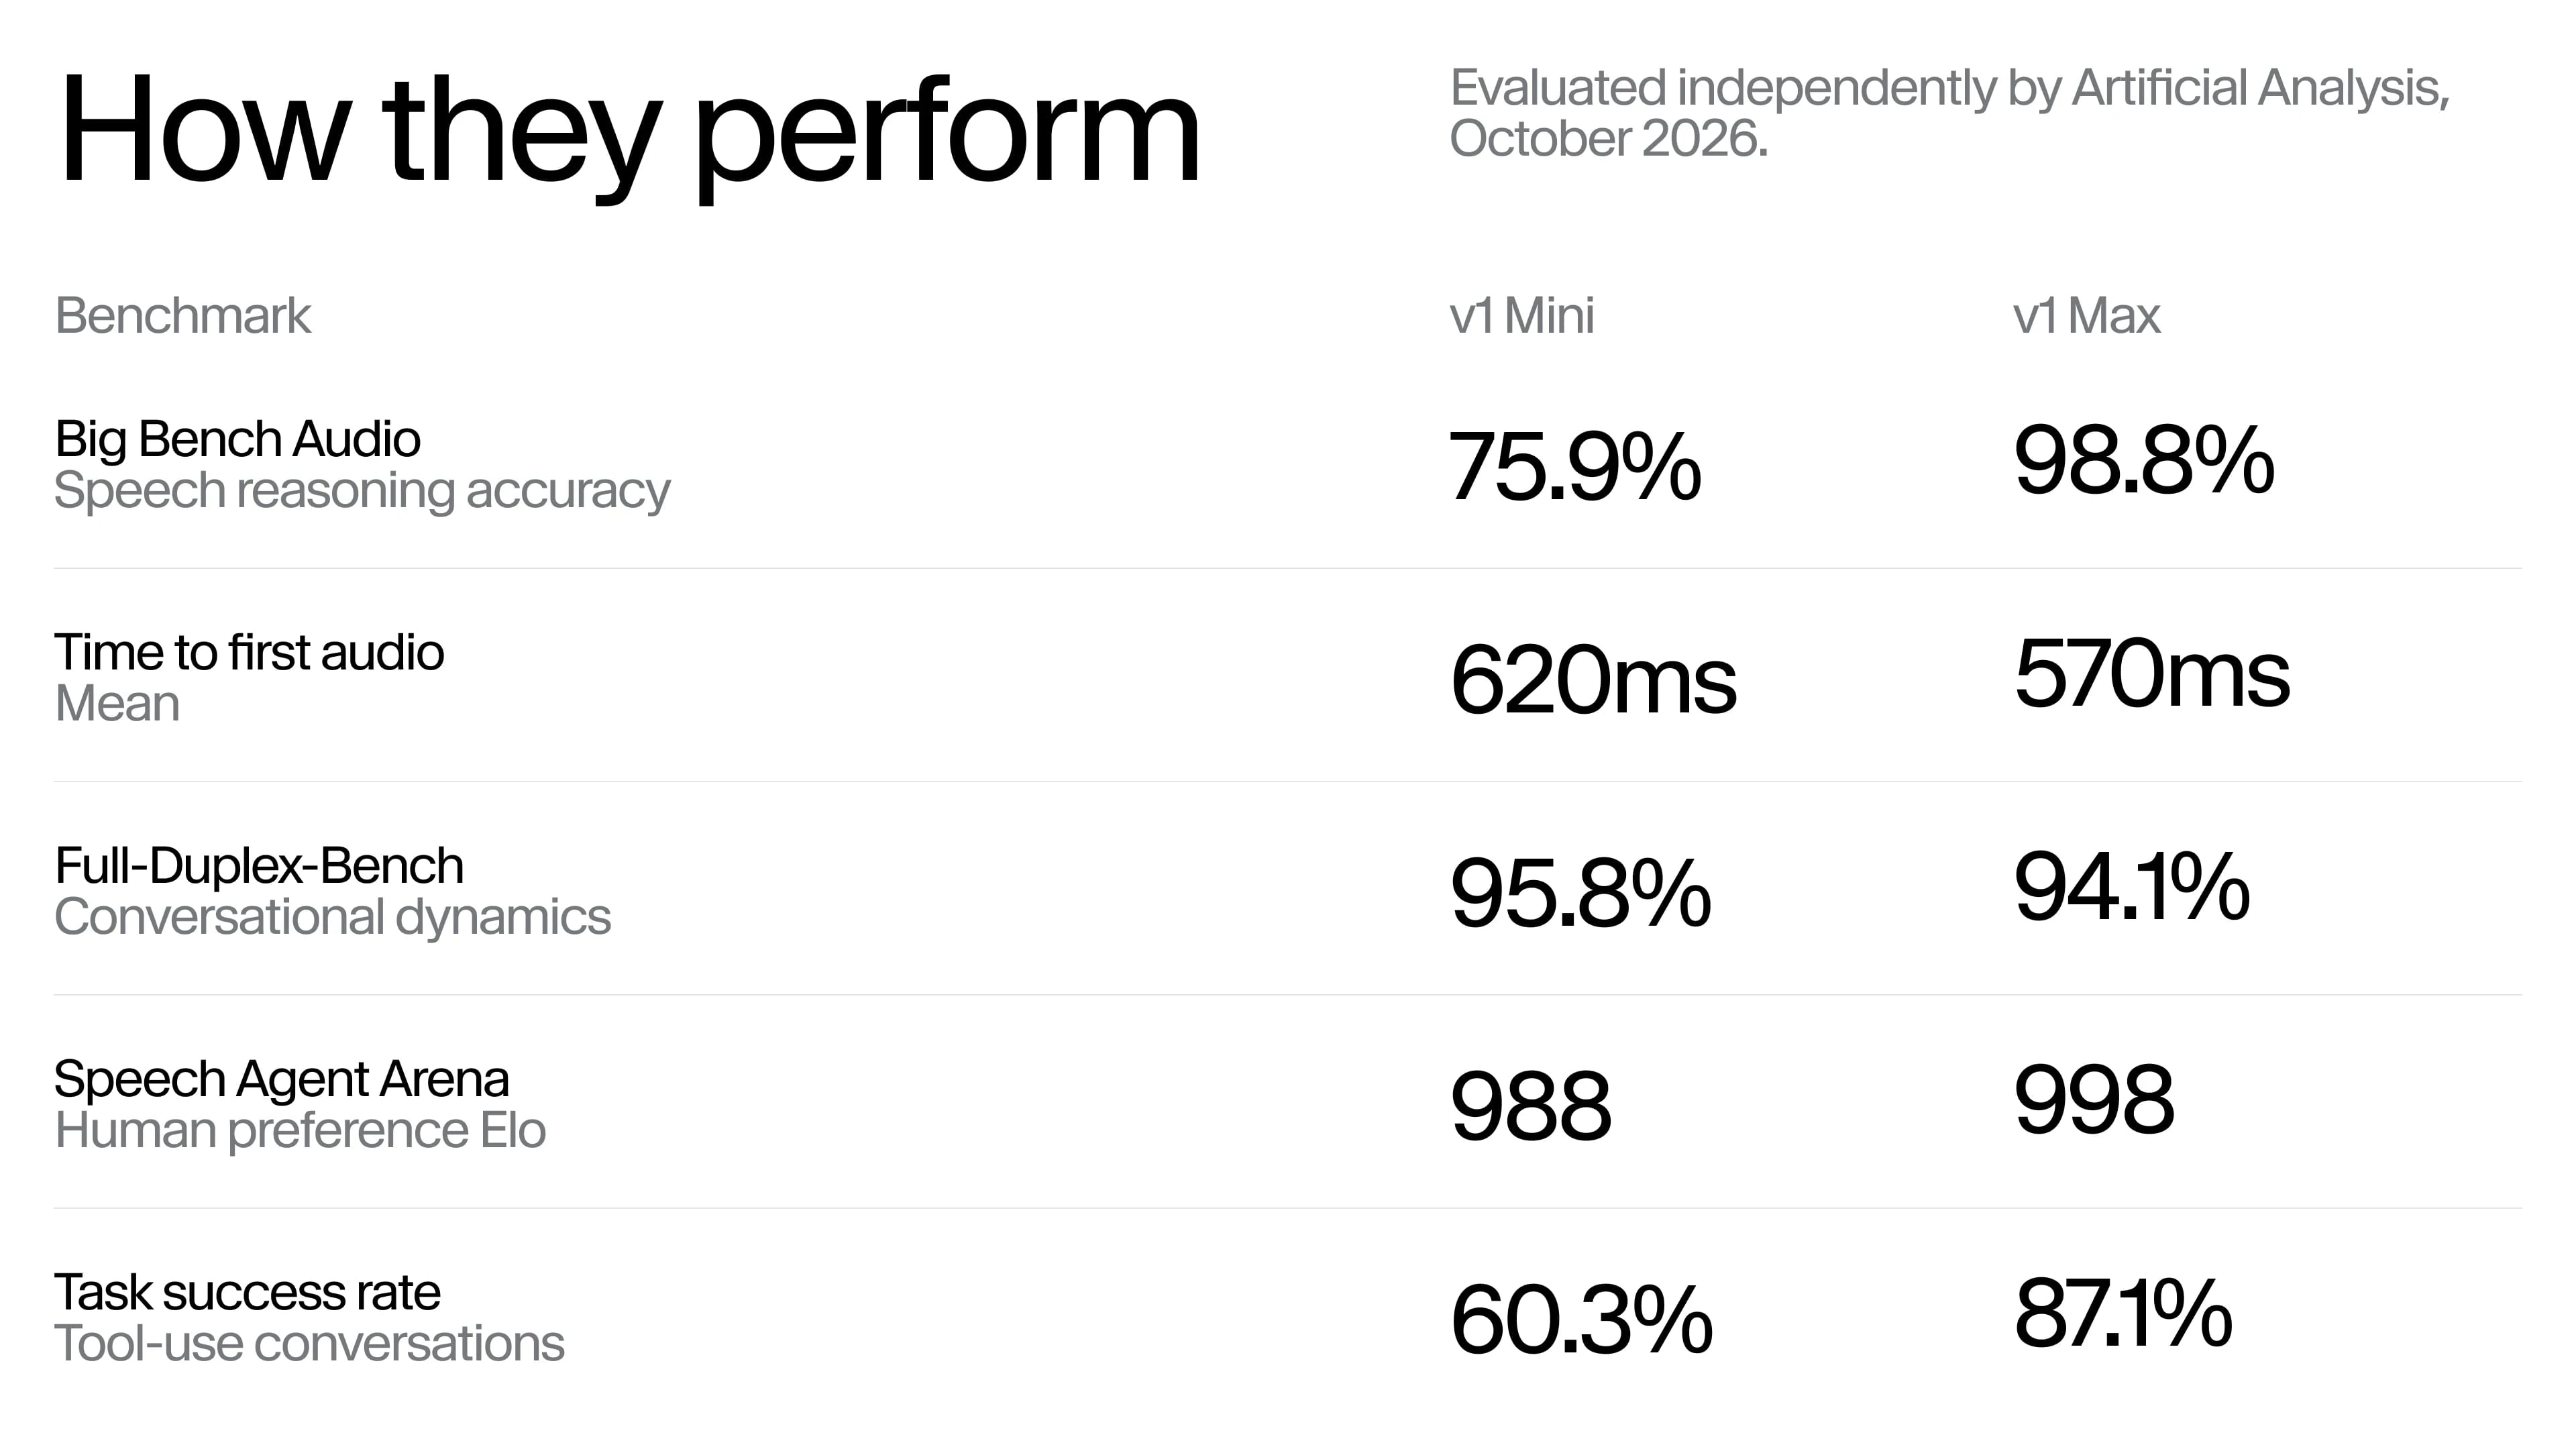
Artificial Analysis niezależnie oceniło oba modele w trzech publicznych benchmarkach: Big Bench Audio dla rozumowania głosowego, Full-Duplex-Bench dla dynamiki rozmowy oraz Speech Agent Arena dla preferencji ludzi i skuteczności zadań.
Rozumowanie głosowe
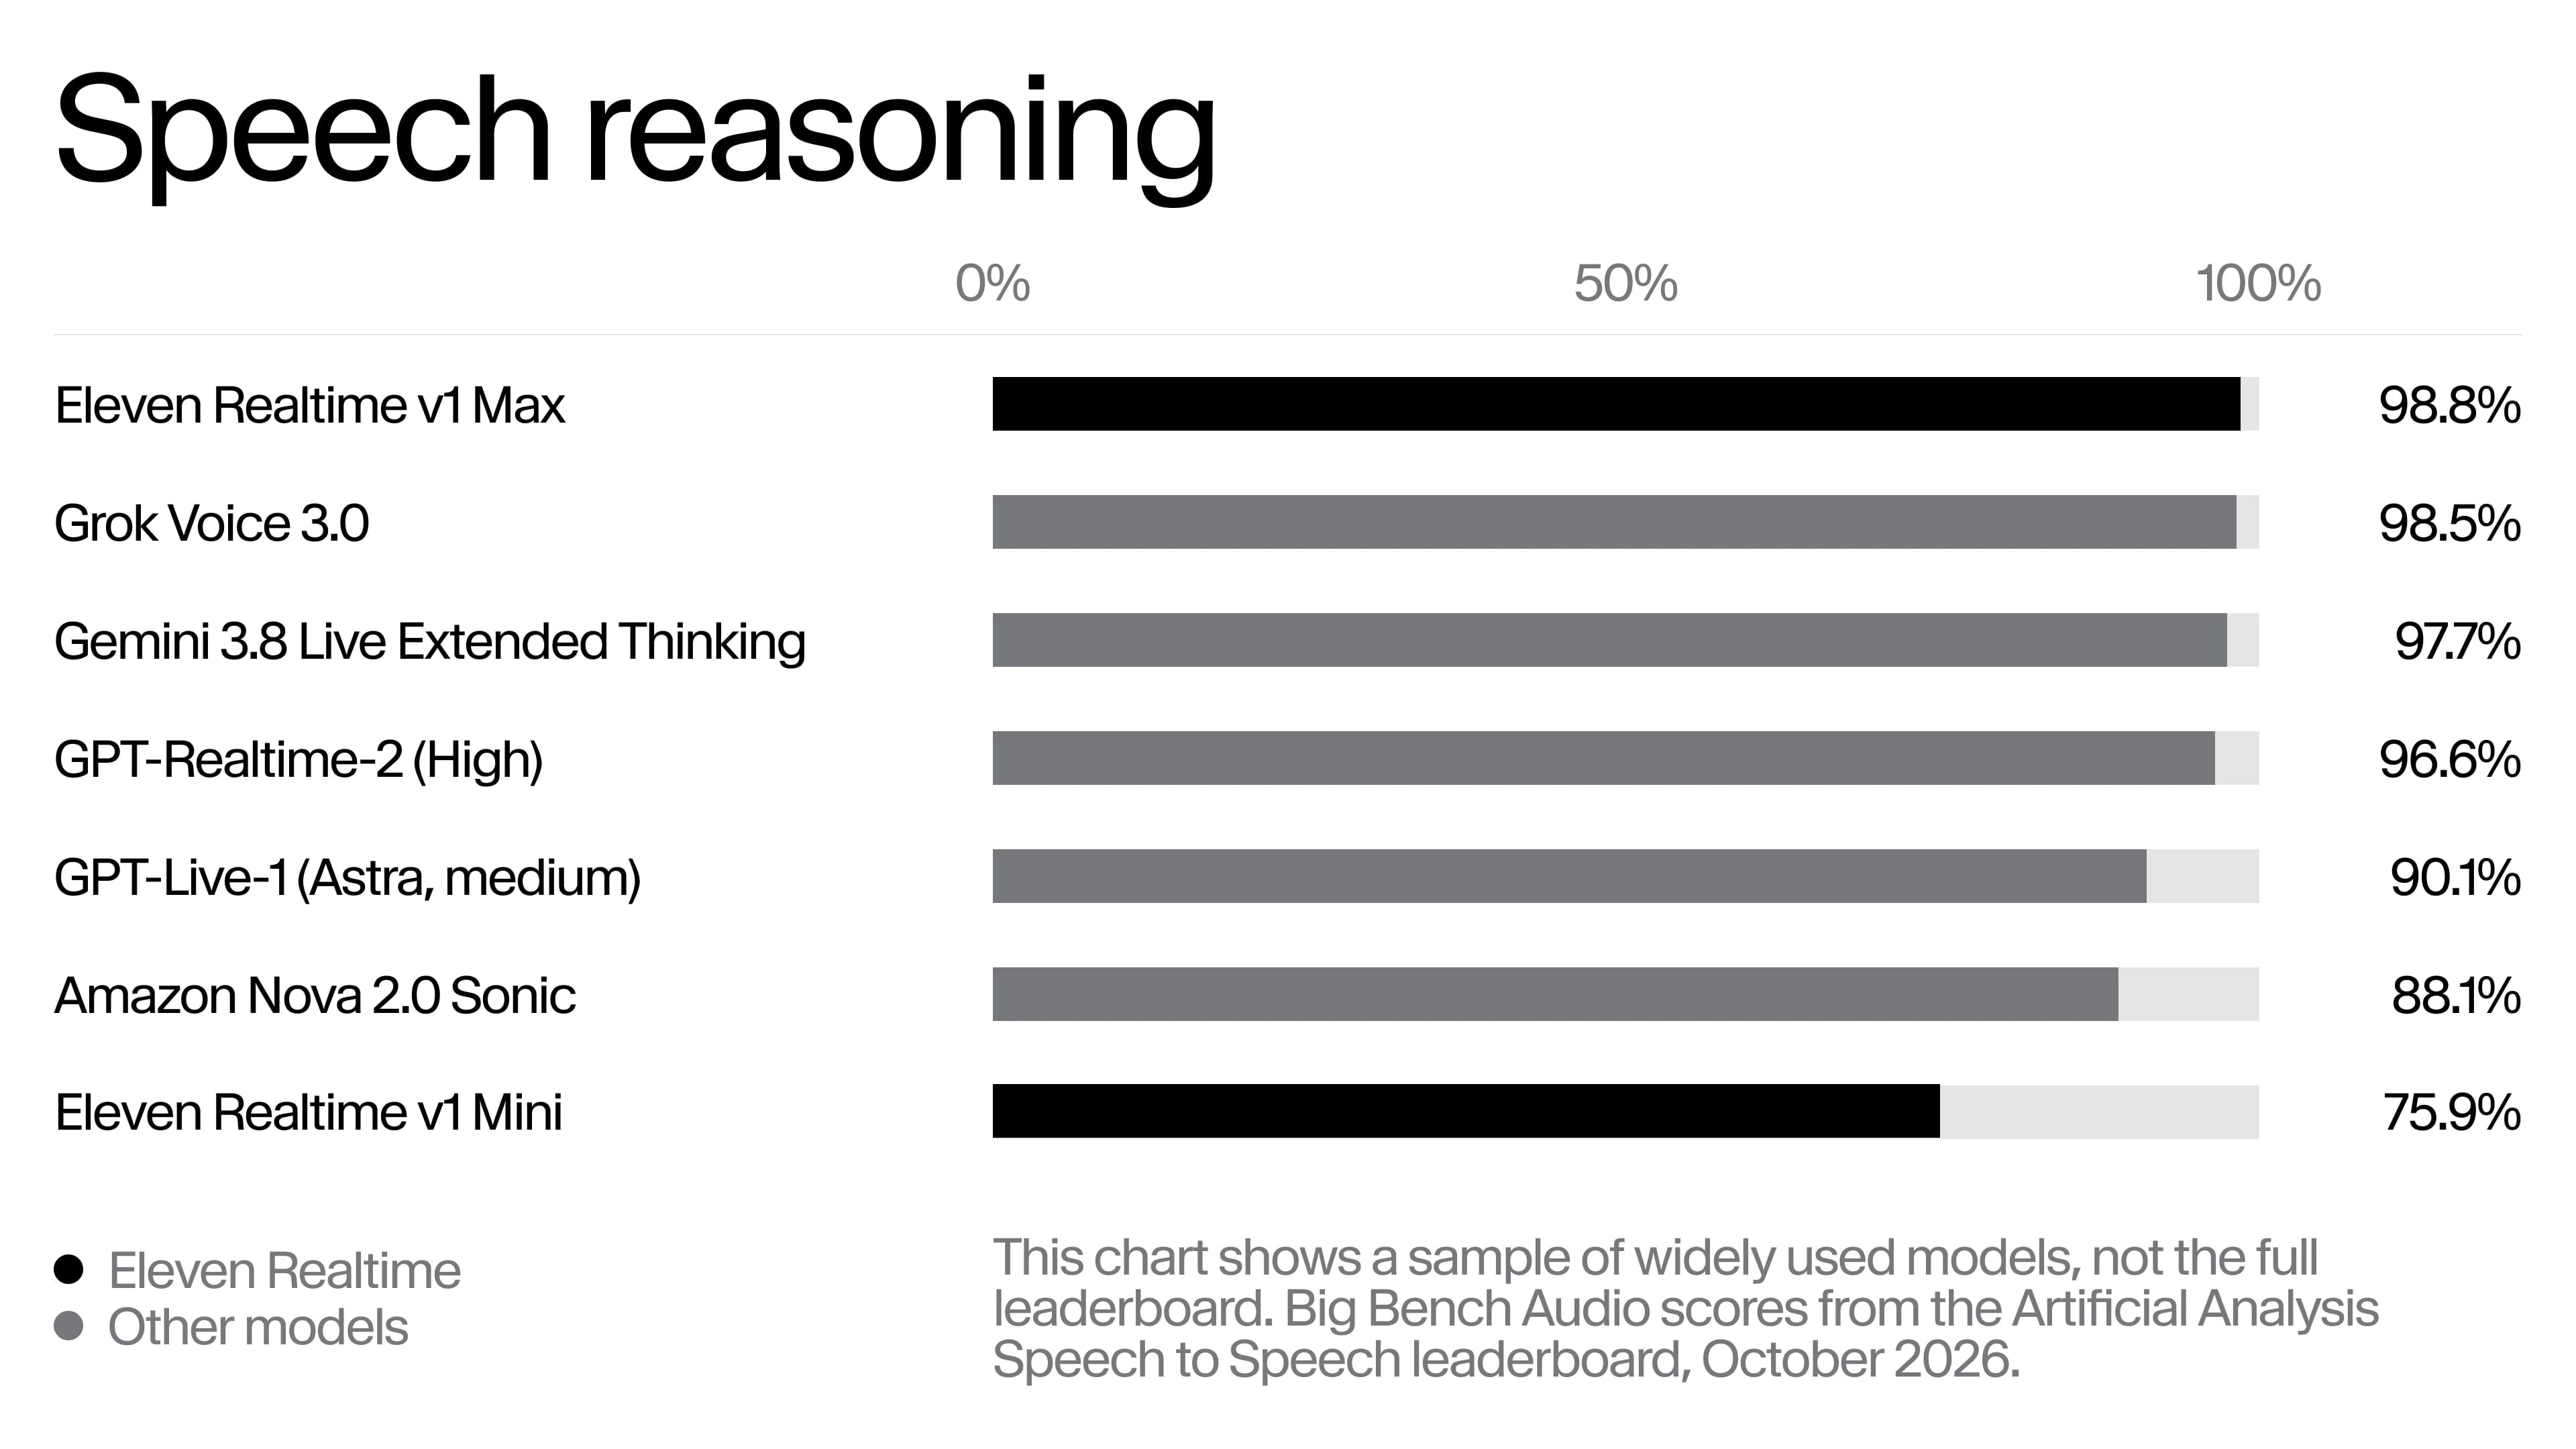
Big Bench Audio zadaje głosowo 1000 pytań wymagających rozumowania i ocenia wypowiedzianą odpowiedź. Realtime v1 Max poprawnie odpowiedział na 98,8% pytań, a v1 Mini na 75,9%.
Szybkość
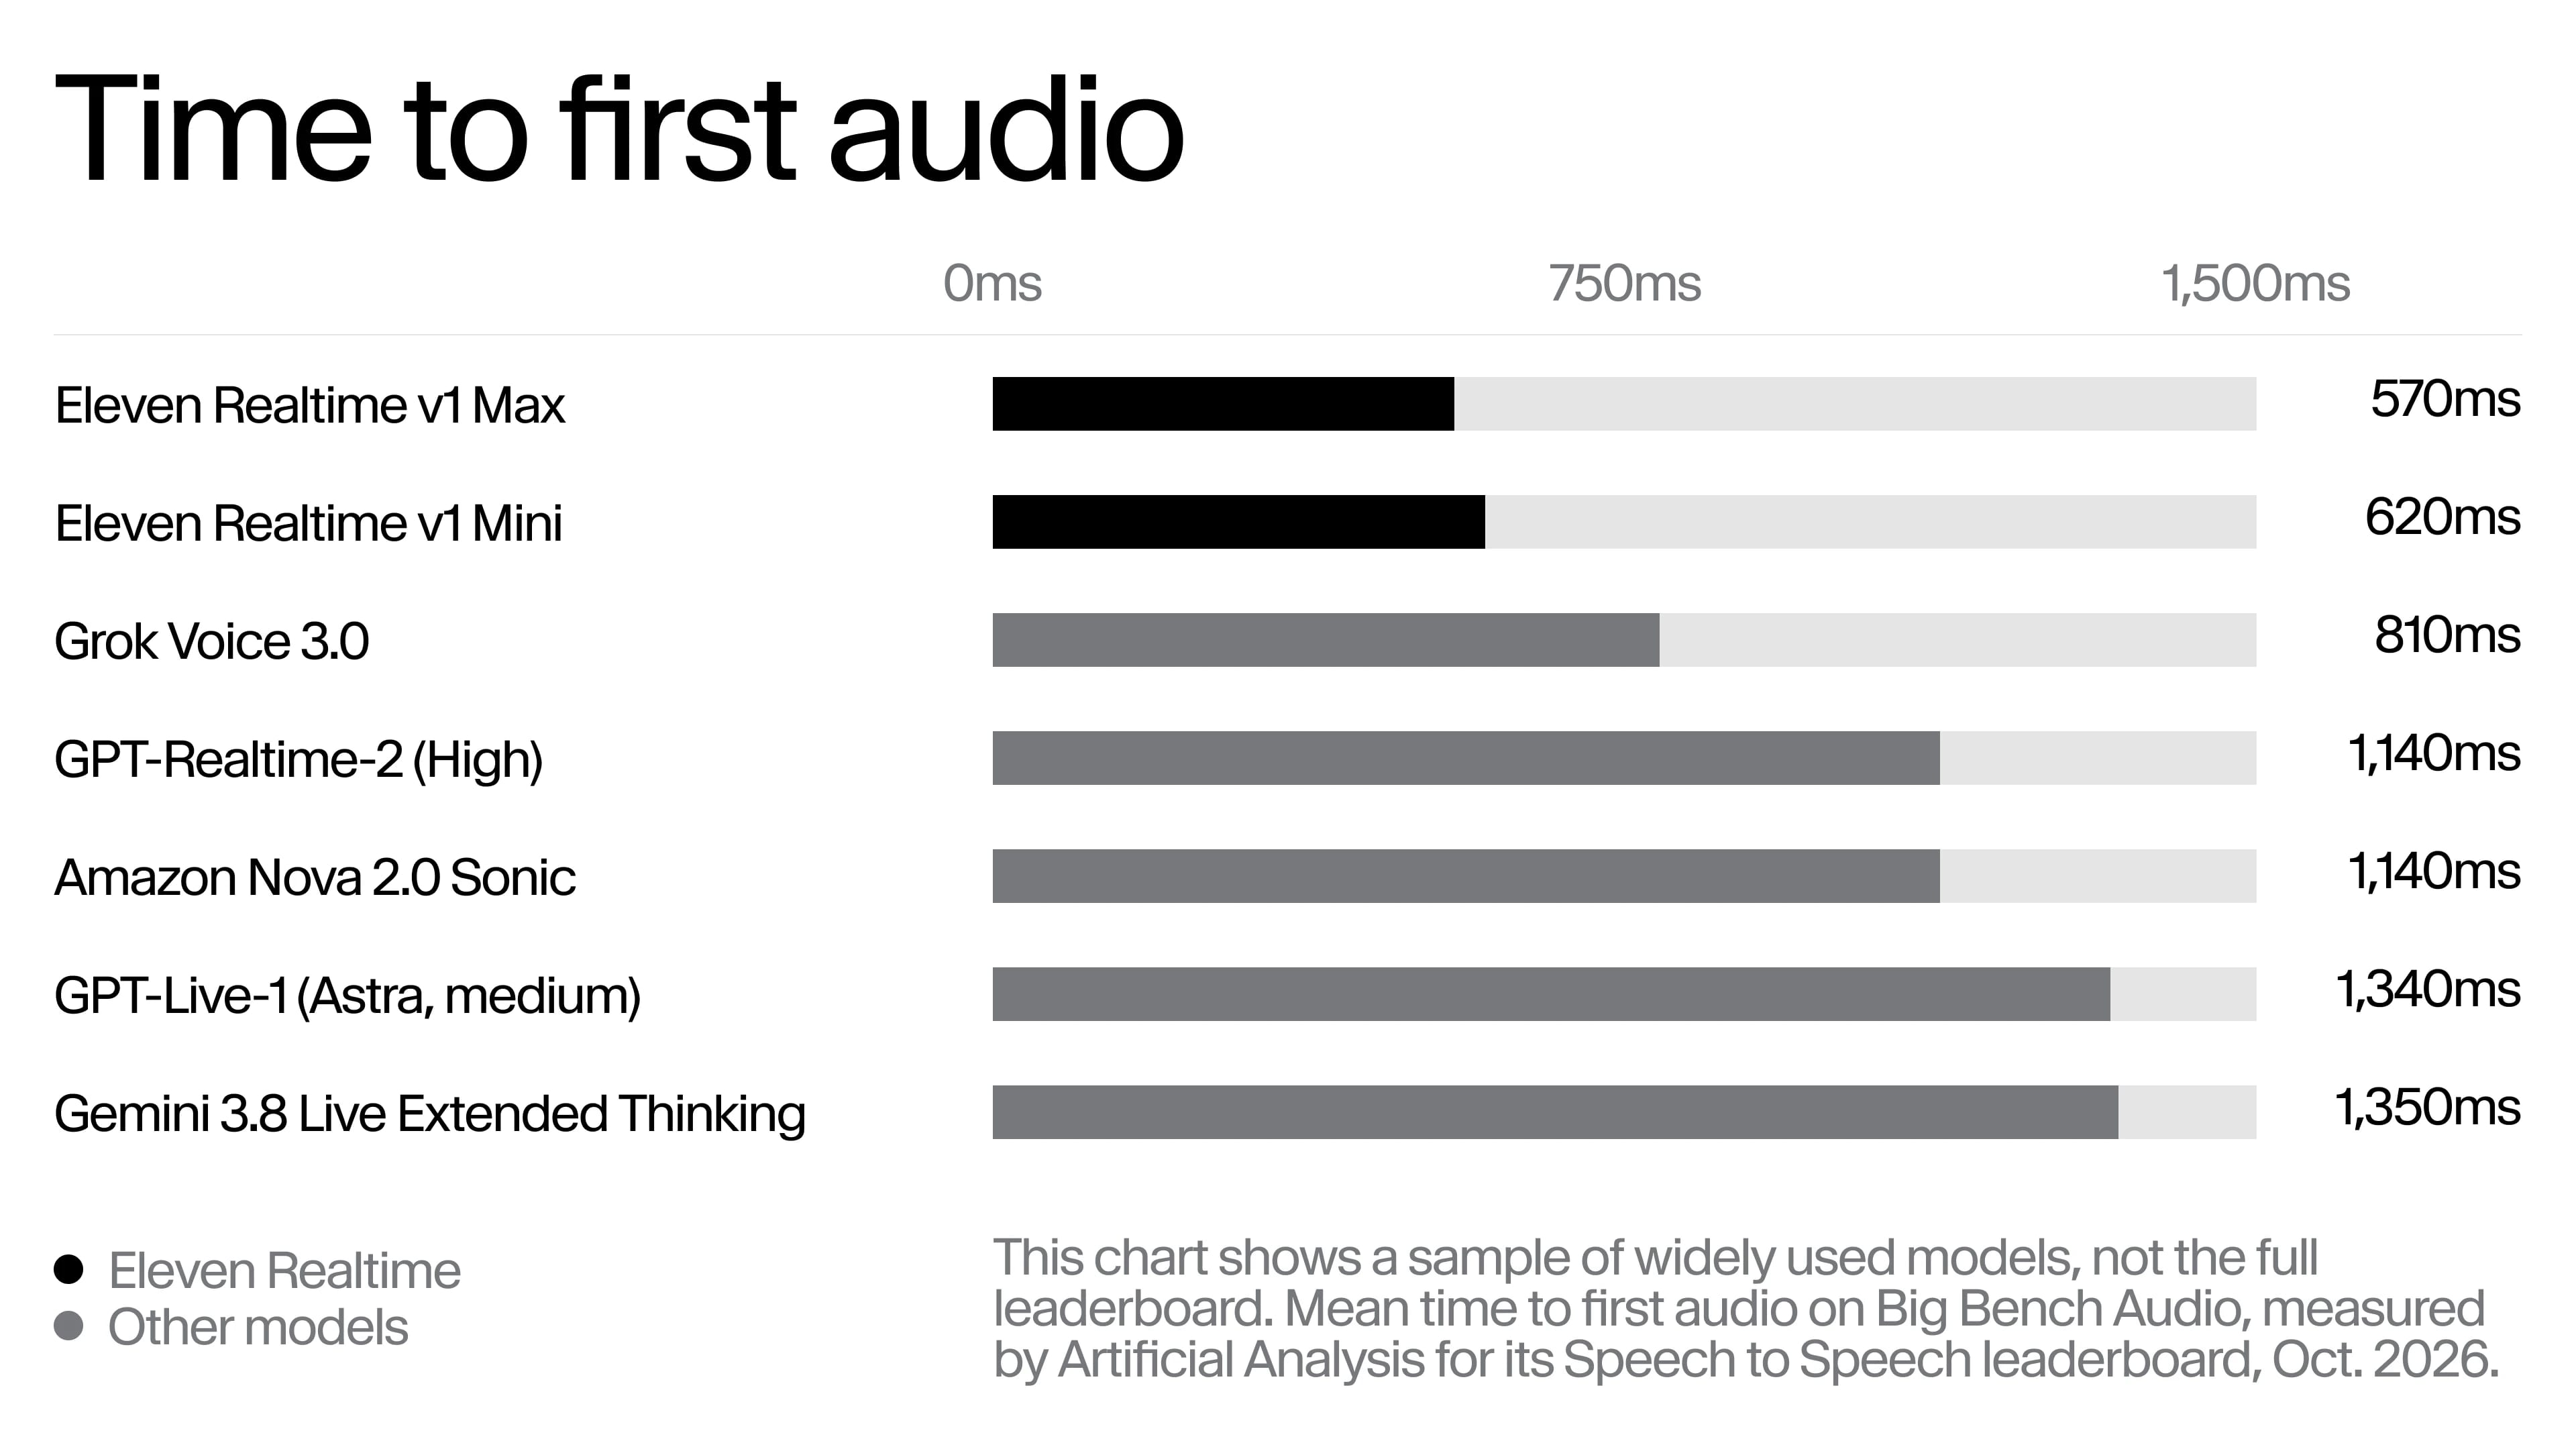
Big Bench Audio zadaje głosowo 1000 pytań wymagających rozumowania i ocenia wypowiedzianą odpowiedź. V1 Max zaczyna mówić średnio po 0,57 sekundy, a v1 Mini po 0,62 sekundy.
Granica Pareto dla dokładności i szybkości
Dokładność i szybkość zwykle postrzega się jako kompromis. Modele z najwyższymi wynikami w Big Bench Audio odpowiadają najdłużej, a najszybsze tracą dużo na dokładności. v1 Max wyróżnia się w obu tych wskaźnikach.
Dynamika rozmowy i preferencje użytkowników
W Full-Duplex-Bench, który testuje pauzy, zmianę tur, przerwania i sygnały podtrzymujące rozmowę, v1 Mini uzyskał 95,8%, a v1 Max 94,1%. W Speech Agent Arena, gdzie ludzie porównują dwa modele w ślepych rozmowach na żywo, v1 Max uzyskał 998 punktów, a v1 Mini 988. W zadaniach z użyciem narzędzi v1 Max ukończył 87,1%, a v1 Mini 60,3%, dlatego polecamy Max do zastosowań wymagających intensywnego wywoływania narzędzi.
Zacznij
W ElevenAgents (zalecane)
Utwórz agenta lub otwórz istniejącego, a następnie wybierz model Realtime z listy rozwijanej. Otrzymasz wtedy wszystko, co ElevenAgents oferuje do działania agentów na produkcji. Obejmuje to kanały telefoniczne, internetowe, WhatsApp i CCaaS, workflow, bazę wiedzy, zabezpieczenia, testowanie i monitorowanie.
Więcej informacji znajdziesz w dokumentacji ElevenAgents.
Przez Realtime API
Jeśli masz już integrację z Realtime API OpenAI, najszybszy sposób na wypróbowanie Eleven Realtime to zachowanie kodu i zmiana adresu, z którym się łączy. Realtime API łączy się przez WebSocket i jest zgodne ze specyfikacją OpenAI Realtime, więc SDK OpenAI działa bez zmian.
Realtime API łączy się tylko przez WebSocket, więc integrację z WebRTC trzeba najpierw przenieść na WebSocket. Działa też niezależnie od ElevenAgents, więc jeśli potrzebujesz kanałów, bazy wiedzy lub innych funkcji platformy, od początku twórz w ElevenAgents.
Nasz przewodnik po migracji opisuje kroki i różnice względem API OpenAI.
Min pracuje w zespole Growth w ElevenLabs i odpowiada za ElevenAPI oraz rozwiązania On-Prem/On-Device. Wcześniej jako drugi pracownik GTM w Stainless kierował marketingiem produktu, a jeszcze wcześniej był jednym z pierwszych PMM w WorkOS, gdzie prowadził premiery, wsparcie zespołów, tworzenie treści i rozwój.