콘텐츠 크리에이터를 위한 텍스트 음성 변환: 캡션 및 콘텐츠 재활용 워크플로 가이드
- 게시일
- 최종 업데이트
정확한 텍스트 음성 변환 도구는 모든 콘텐츠 크리에이터의 기술 스택에 필수입니다. AI 기반 텍스트 음성 변환을 사용하면 기존 오디오를 비디오 캡션, 팟캐스트 쇼 노트, 블로그 게시물 등으로 만들 수 있습니다. 여러 채널에서 콘텐츠를 재활용해 더 폭넓은 잠재고객에게 도달하는 데도 도움이 됩니다.
텍스트 음성 변환은 바쁜 콘텐츠 크리에이터에게 큰 시간 절약 효과도 제공합니다. 모든 보이스오버와 팟캐스트를 수동으로 전사하려면 몇 시간이 걸릴 수 있지만, 텍스트 음성 변환 모델을 사용하면 몇 분 만에 작업을 마쳐 업로드 일정을 지킬 수 있습니다.
이 글에서는 콘텐츠 크리에이터를 위한 텍스트 음성 변환의 작동 방식과 효과적인 이유, 그리고 콘텐츠 제작 워크플로에 적용하는 방법을 살펴봅니다.
요약
- 콘텐츠 크리에이터는 텍스트 음성 변환 모델을 사용해 비디오 캡션을 생성하고, 팟캐스트 쇼 노트를 만들며, 오디오 콘텐츠를 글 형식으로 재활용합니다.
- AI 기반 텍스트 음성 변환 모델은 자동 소셜 미디어 캡션보다 더 정확한 전사와 서식을 제공합니다.
- 텍스트 음성 변환으로 팟캐스트를 전사하면 쇼 노트를 빠르게 만들거나 블로그와 뉴스레터로 재활용할 수 있습니다.
- 키텀 프롬프팅을 사용하면 이름과 업계별 용어를 명확히 지정해 더 정확한 전사본을 만들 수 있습니다.
- 캡션을 번역하려면 원하는 언어로 비디오를 더빙한 다음, 텍스트 음성 변환으로 더빙 오디오를 전사하세요.
콘텐츠 크리에이터는 텍스트 음성 변환을 주로 어디에 활용할까요?
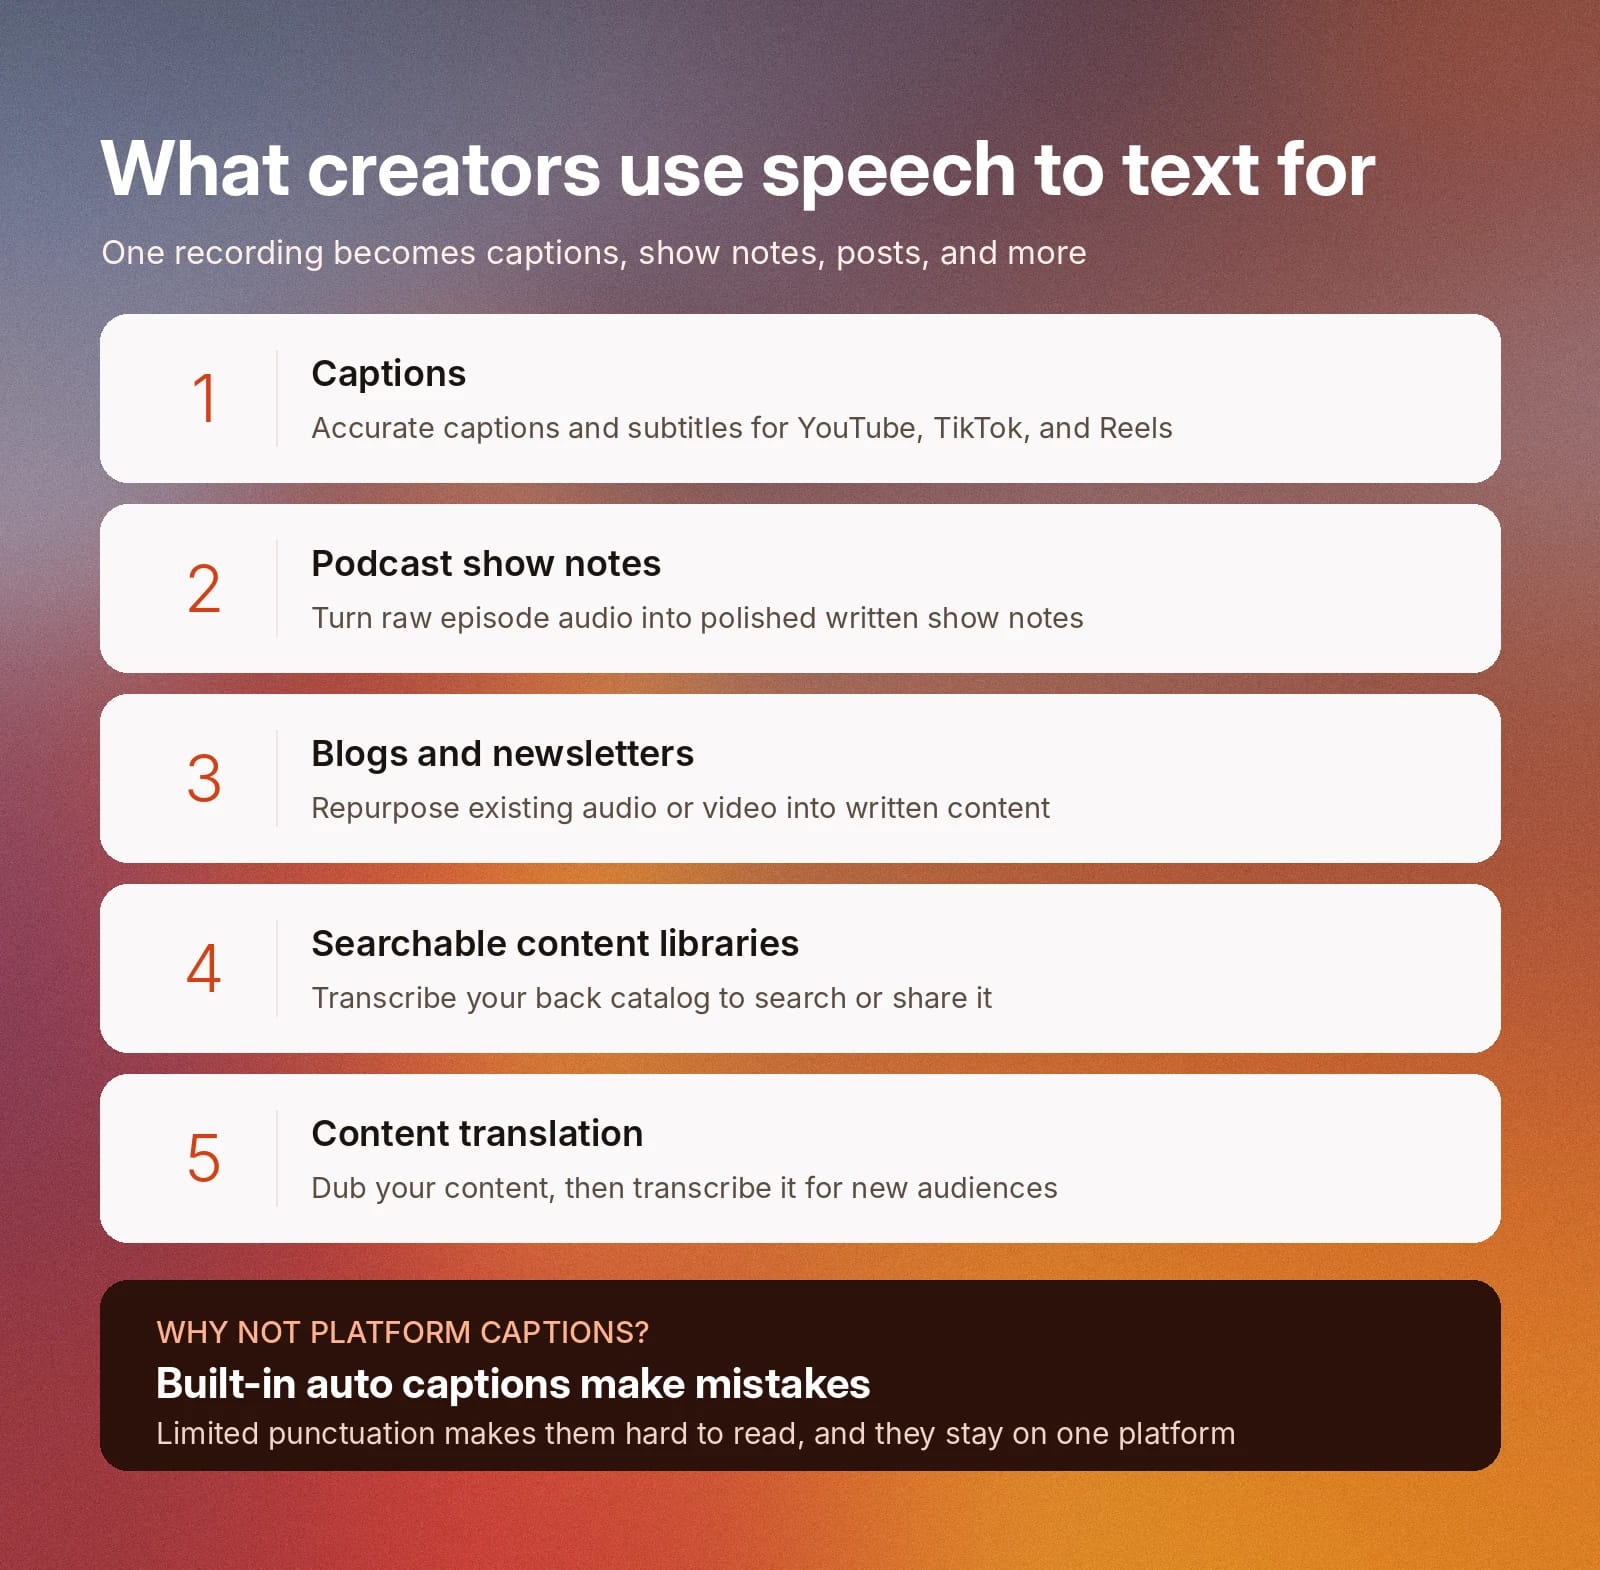
콘텐츠 크리에이터는 다음과 같은 다양한 작업에 텍스트 음성 변환을 사용합니다.
- 캡션: 텍스트 음성 변환은 YouTube, TikTok, Instagram Reels 등의 플랫폼에서 짧은 형식과 긴 형식의 비디오 모두에 정확한 캡션과 자막을 생성합니다.
- 팟캐스트 쇼 노트: 텍스트 음성 변환은 원본 에피소드 오디오를 완성도 높은 쇼 노트로 바꾸는 데 도움이 됩니다.
- 블로그 및 뉴스레터: 텍스트 음성 변환을 사용하면 기존 오디오나 비디오 콘텐츠를 블로그, 뉴스레터 및 기타 글 콘텐츠로 바꿀 수 있습니다.
- 검색 가능한 콘텐츠 라이브러리: 자동 텍스트 음성 변환 도구는 기존 콘텐츠 라이브러리를 전사해 검색 가능하게 만듭니다. 이를 통해 내부적으로 콘텐츠를 체계화하거나 잠재고객을 위한 외부 리소스 라이브러리를 만들 수 있습니다.
- 콘텐츠 번역: 텍스트 음성 변환은 콘텐츠를 다양한 언어로 번역해 전 세계 잠재고객에게 도달할 수 있도록 합니다.
많은 소셜 미디어 플랫폼에는 비디오 콘텐츠용 자동 캡션 생성 기능이 있습니다. 하지만 이러한 도구는 실수할 수 있고 문장 부호 사용이 제한적이어서 캡션을 읽기 어려울 수 있습니다.
전용 텍스트 음성 변환 모델을 사용하면 비디오용 깔끔하고 정확한 캡션을 만들 수 있습니다. 전사본을 다운로드해 다양한 플랫폼에서 재활용할 수도 있습니다.
전사본을 캡션과 자막으로 전환하기
캡션과 자막은 더 이상 소셜 미디어 비디오에서 선택 사항이 아닙니다. 청력 수준과 관계없이 모든 사람이 비디오를 이용할 수 있게 해 줍니다. 시청자가 소리를 끄고 비디오를 볼 수 있게도 합니다.
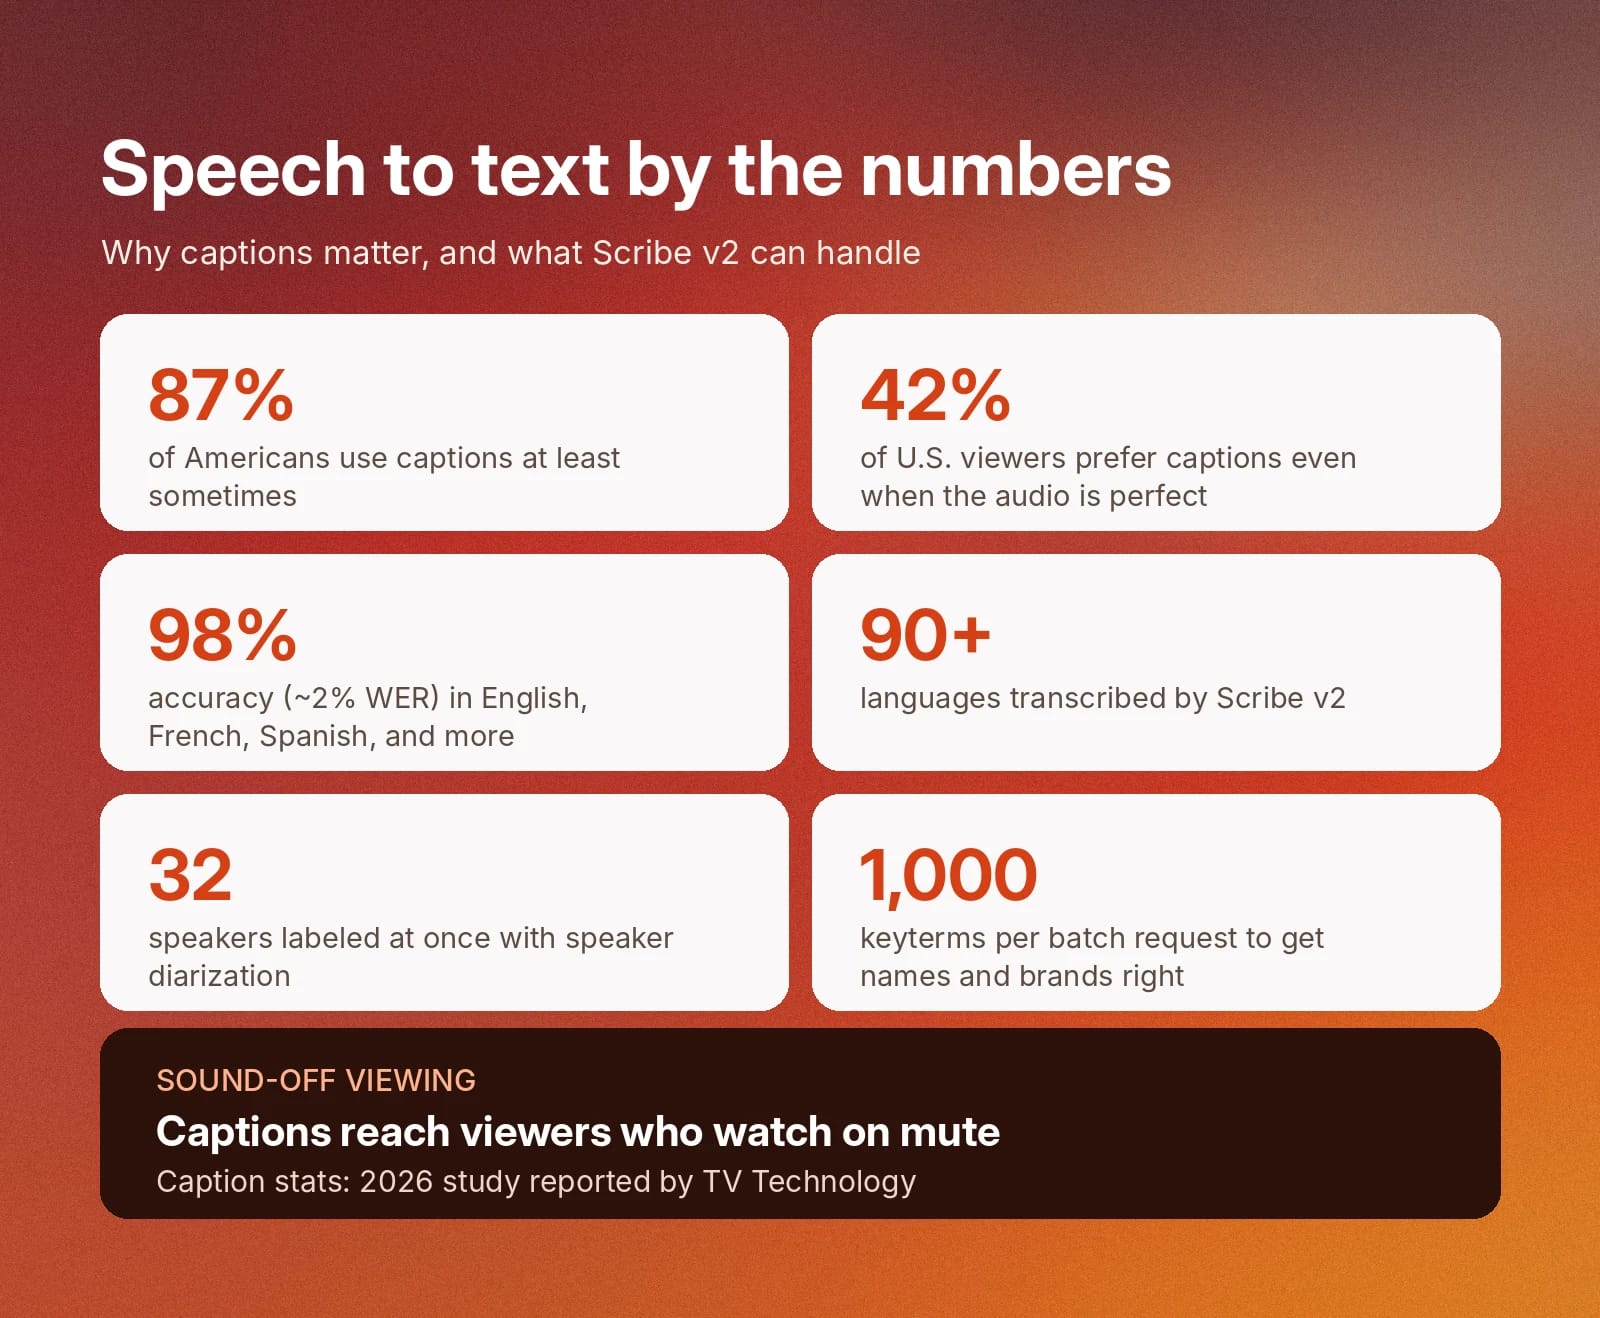
소리를 끈 상태로 시청하는 것은 많은 소셜 미디어 사용자에게 기본 방식이 되었습니다. 특히 공공장소에 있거나 헤드폰을 바로 사용할 수 없을 때 그렇습니다. 2026년 연구에 따르면 미국인의 87%가 비디오를 볼 때 적어도 가끔은 캡션을 사용합니다.
실제로 미국 시청자의 42%는 비디오 오디오가 이미 완벽해도 캡션을 선호합니다. 이는 모든 비디오에 캡션을 추가하는 것이 콘텐츠의 매력을 얼마나 높이는지 보여 줍니다.
텍스트 음성 변환 모델은 캡션과 자막 생성을 위해 소셜 미디어 비디오를 전사합니다. ElevenLabs Caption Generator는 단어 및 문자 단위 타임스탬프가 포함된 전사본을 생성하므로 비디오의 음성과 동기화됩니다. 원본 비디오를 여러 플랫폼용 짧은 클립으로 잘라도 이 타임스탬프는 유지됩니다.
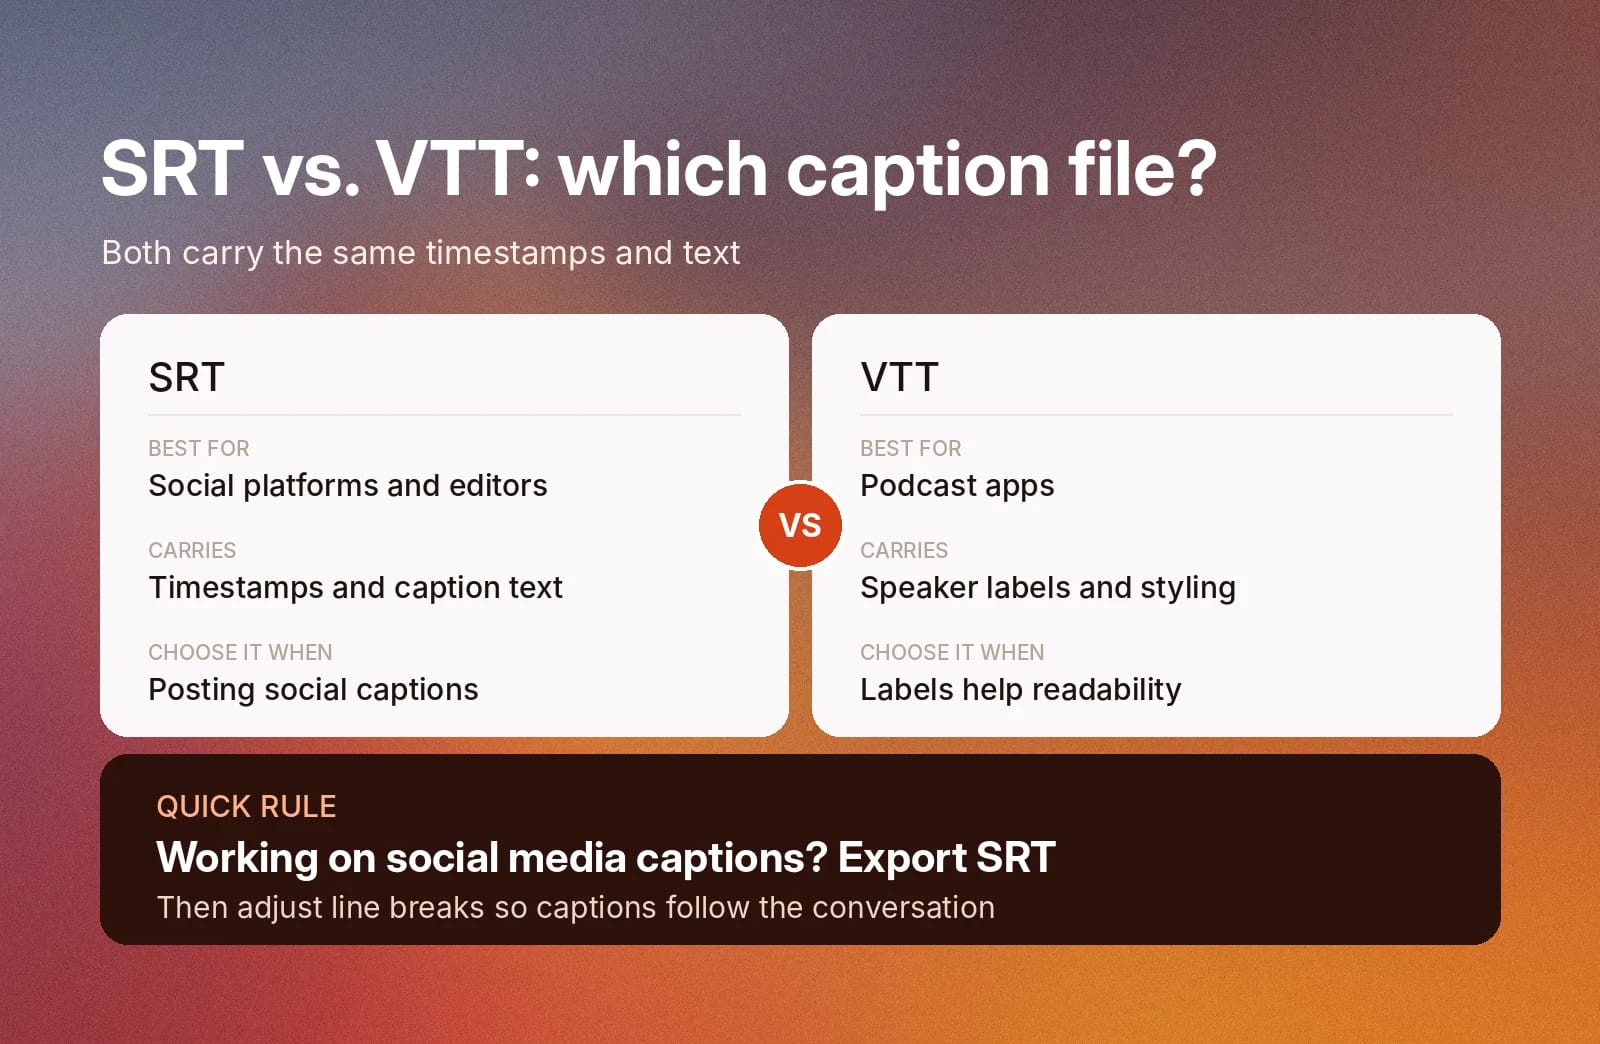
캡션은 SRT 및 VTT 파일로도 내보낼 수 있어 소셜 미디어나 선호하는 비디오 편집 플랫폼에 바로 업로드할 수 있습니다. 비디오를 편집할 때는 대화의 흐름에 맞게 자연스럽게 읽히도록 줄바꿈을 조정하세요.
SRT와 VTT: 어떤 캡션 파일을 내보내야 할까요?
SRT와 VTT는 모두 동일한 타임스탬프와 텍스트를 담습니다.
각 형식을 선택해야 하는 경우는 다음과 같습니다.
- 대부분의 소셜 플랫폼과 비디오 편집 소프트웨어에서 사용할 수 있는 간단한 파일이 필요하다면 SRT를 내보내세요.
- 팟캐스트 앱에 캡션이나 전사본을 게시한다면 VTT를 내보내세요. 화자 라벨과 가독성을 높이는 기본 스타일을 추가할 수 있습니다.
소셜 미디어 캡션 작업이라면 SRT가 적합할 가능성이 높습니다.
소셜 미디어 캡션을 위한 클린 전사와 축어 전사
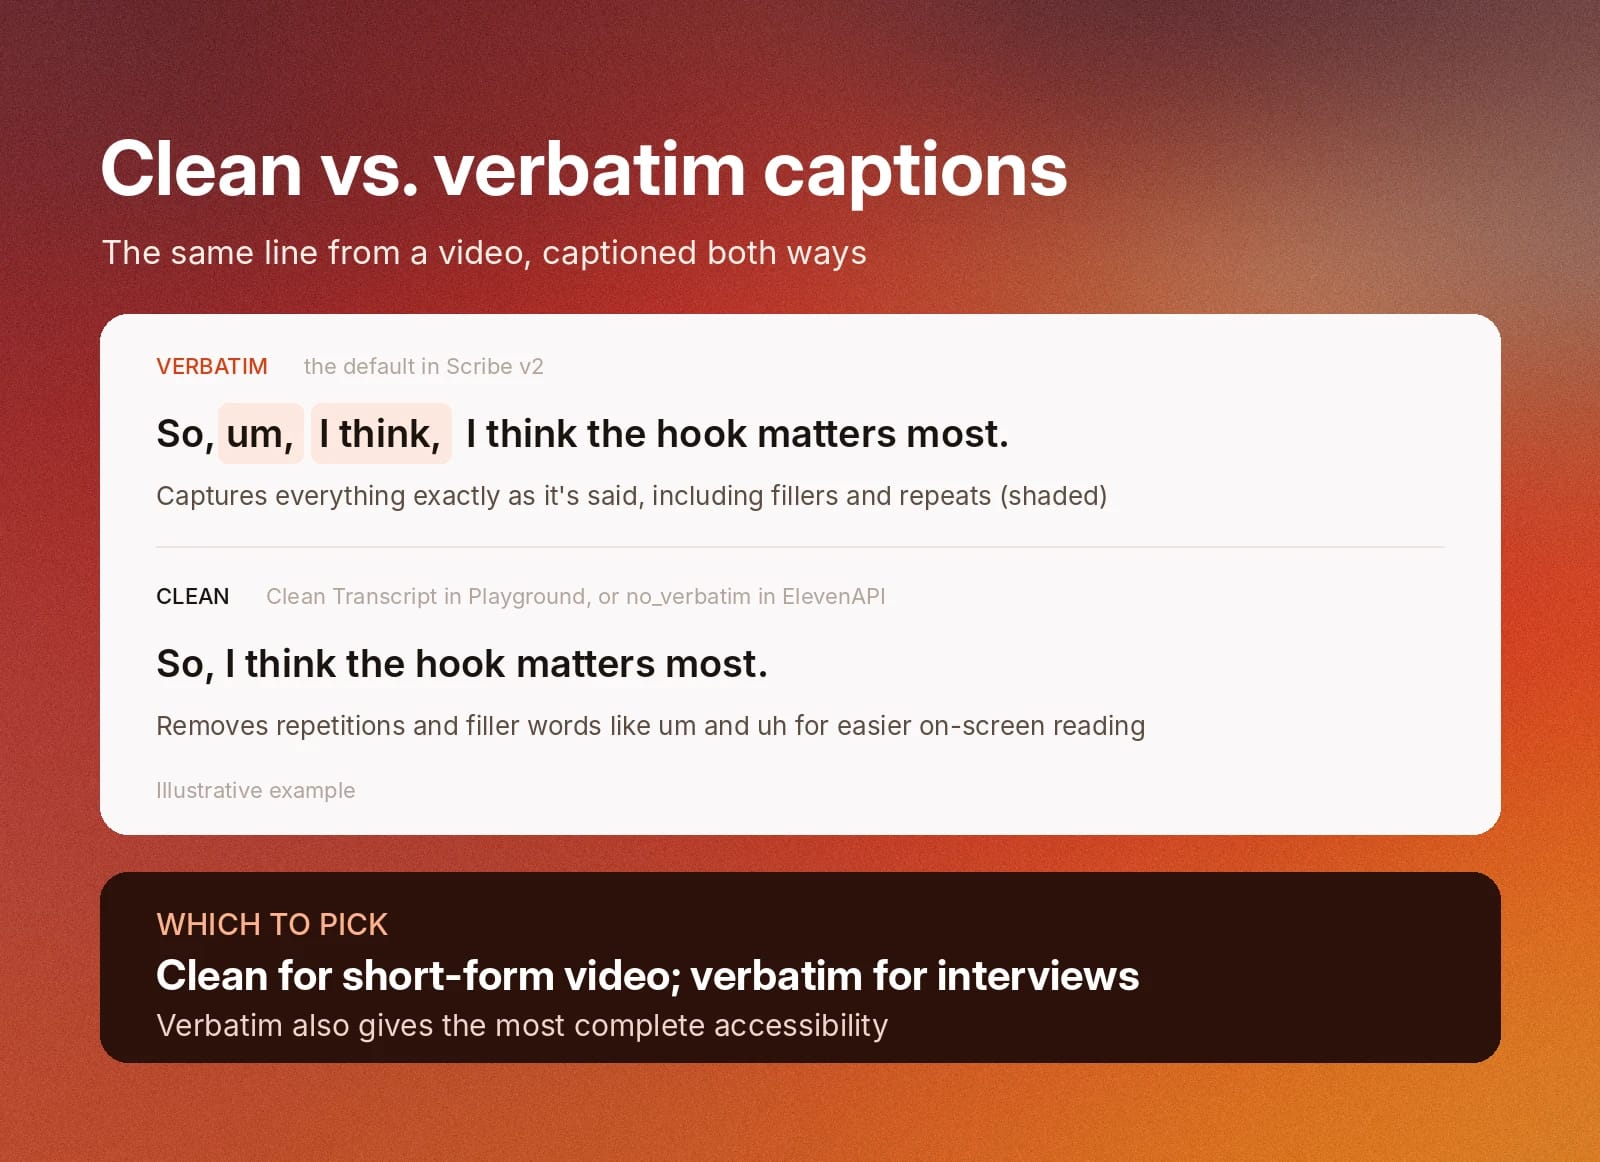
소셜 미디어 캡션을 만들 때 클린 전사와 축어 전사 중 선택할 수 있습니다. 클린 전사는 반복과 ‘음’, ‘어’ 같은 추임새를 제거하는 반면, 축어 전사는 말한 내용을 그대로 담습니다.
클린 캡션은 화면에서 읽기 쉽지만, 축어 캡션은 완전한 접근성 측면에서 더 좋습니다. 적합한 선택은 잠재고객과 그들의 고유한 필요에 따라 달라집니다.
ElevenLabs Scribe v2 모델은 축어 전사를 기본 설정으로 사용합니다. 하지만 ElevenLabs Playground에서 “Clean Transcript”를 켜거나 ElevenAPI의 no_verbatim 매개변수를 사용하면 클린 전사로 전환할 수 있습니다.
시청자가 비디오를 훑어보며 콘텐츠를 읽을 가능성이 높은 짧은 형식의 비디오에는 클린 전사를 선택하세요. 정확한 표현이 중요해 충실한 전사가 필요한 긴 인터뷰나 연구 상황에는 축어 전사가 가장 좋습니다.
쇼 노트와 콘텐츠 재활용을 위한 팟캐스트 전사
팟캐스트는 전체 콘텐츠 전략의 기반입니다. 더 폭넓은 잠재고객에게 도달하려면 각 에피소드에서 다룬 아이디어를 쇼 노트, 블로그, 뉴스레터, 짧은 형식의 소셜 미디어 콘텐츠로 바꾸세요.
텍스트 음성 변환 도구를 사용하면 팟캐스트 에피소드를 쉽게 전사하고 재활용할 수 있습니다. 전사본을 만든 후에는 잠재고객이 언제든 참고할 수 있는 쇼 노트로 편집할 수 있습니다.
매번 글을 처음부터 작성하는 대신, 각 전사본의 일부를 블로그와 뉴스레터 콘텐츠로 바꿀 수도 있습니다. 이는 듣기보다 읽기를 선호하는 잠재고객에게 도달하는 데 도움이 됩니다.
글 콘텐츠 라이브러리는 쉽게 검색할 수 있습니다. 잠재고객이 이전 에피소드의 아이디어를 다시 확인하고 싶다면 쇼 노트나 블로그를 검색하기만 하면 됩니다. 글 콘텐츠는 오디오 콘텐츠보다 검색 결과에 노출될 가능성도 높아 온라인 가시성을 높여 줍니다.
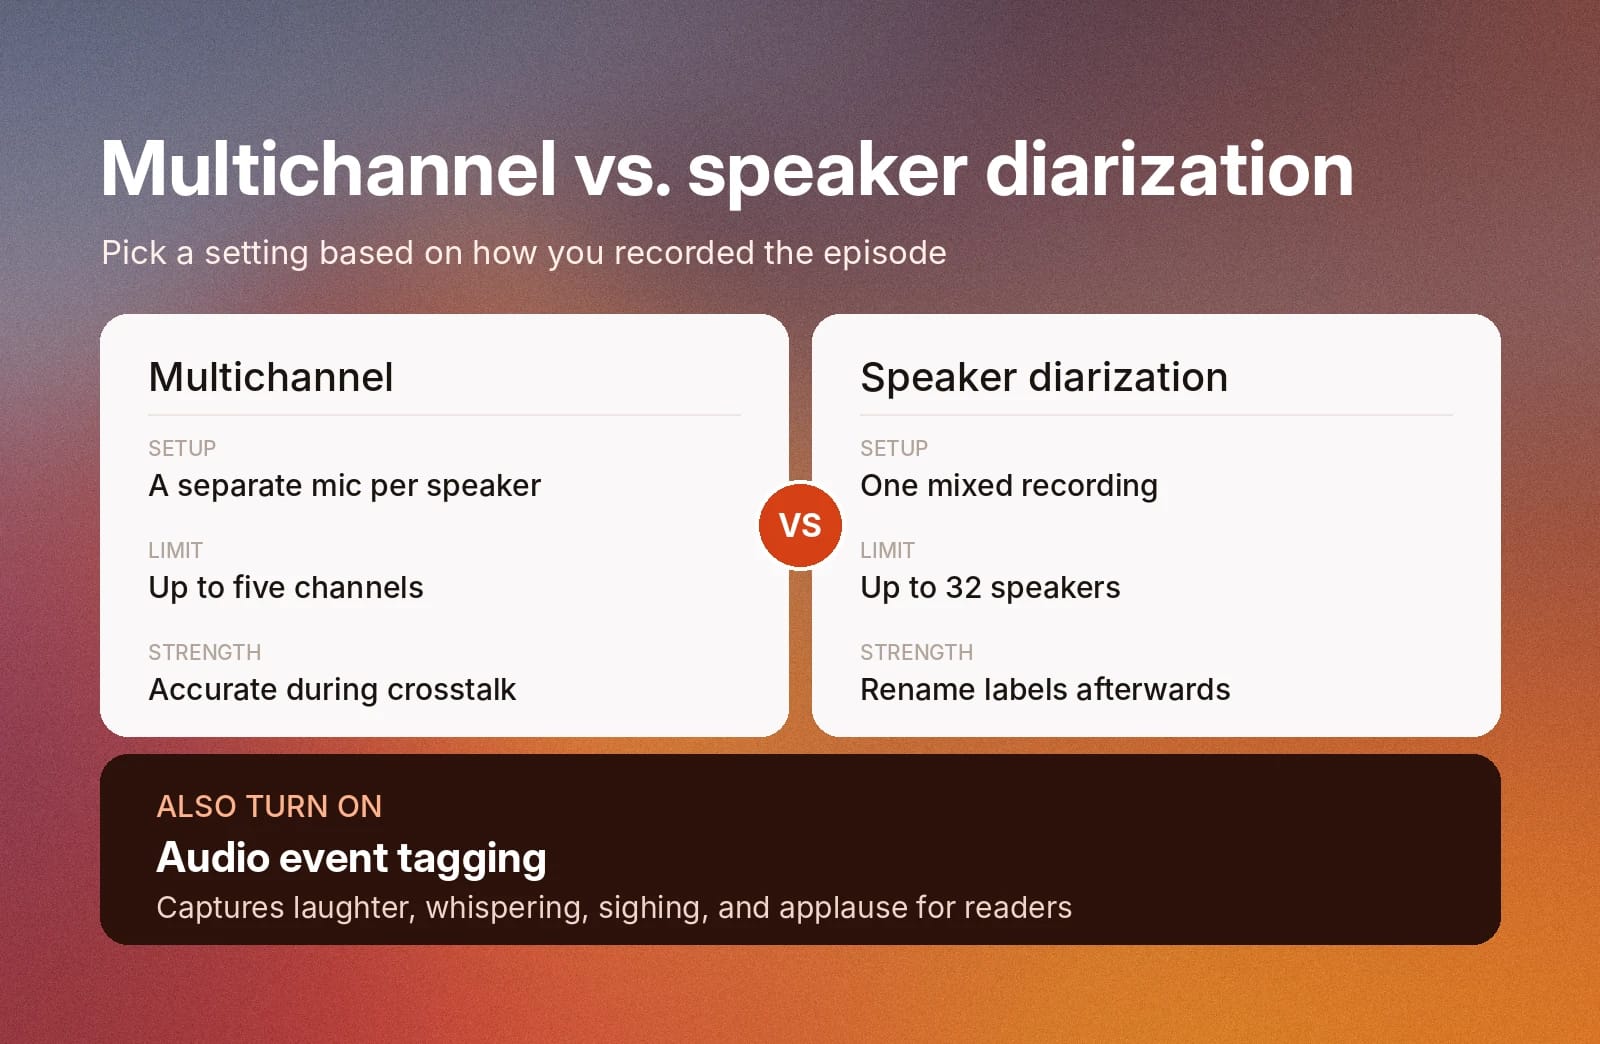
팟캐스트를 가장 효율적으로 전사하는 방법은 멀티채널 전사 설정을 사용하는 것입니다. 이를 위해 화자마다 별도의 마이크를 사용하세요. 전사 모델이 각 화자를 별도로 전사하므로 화자들이 동시에 말해도 정확한 결과를 얻을 수 있습니다.
또한 팟캐스트를 전사할 때 오디오 이벤트 태깅을 켜세요. 이 설정은 웃음, 속삭임, 한숨 또는 박수를 포착해 독자가 전체 맥락을 이해할 수 있도록 합니다. ElevenLabs 텍스트 음성 변환에서 사용하려면 “Tag Audio Events”를 켜거나 ElevenAPI에서 tag_audio_events 매개변수를 사용하세요.
단일 녹음에서 화자 식별하기
멀티채널 전사는 최대 5개 채널을 지원합니다. 모든 음성을 하나의 믹스 트랙으로 녹음했거나 음성 수가 채널 수보다 많다면 화자 분리를 대신 켜세요. Scribe v2는 전사본에서 각 화자에 라벨을 지정하며, 한 번에 최대 32명의 화자를 지원합니다. 전사 후 ElevenLabs 대시보드에서 화자 라벨 옆의 편집 버튼을 클릭해 화자 이름을 변경할 수 있습니다.
녹음을 클립, 블로그, 뉴스레터로 재활용하기
인터뷰를 전사한 번만 하고 게시하는 모든 채널에서 재활용하세요.
하나의 전사본으로 캡션은 물론 클립과 글 콘텐츠를 위한 원본 자료도 얻을 수 있습니다. ElevenLabs STT는 전 세계 크리에이터와 기업이 팟캐스트를 글 콘텐츠로 전환하는 과정을 빠르게 진행하도록 돕는 데 사용됩니다.
제가 만드는 모든 팟캐스트, 기조연설, 인터뷰는 텍스트 음성 변환을 거칩니다. 전사본 하나로 전체 콘텐츠의 정확한 캡션, 짧은 비디오 클립으로 만들 최고의 순간, 그리고 글 콘텐츠로 바꿀 핵심 인용문을 얻습니다.
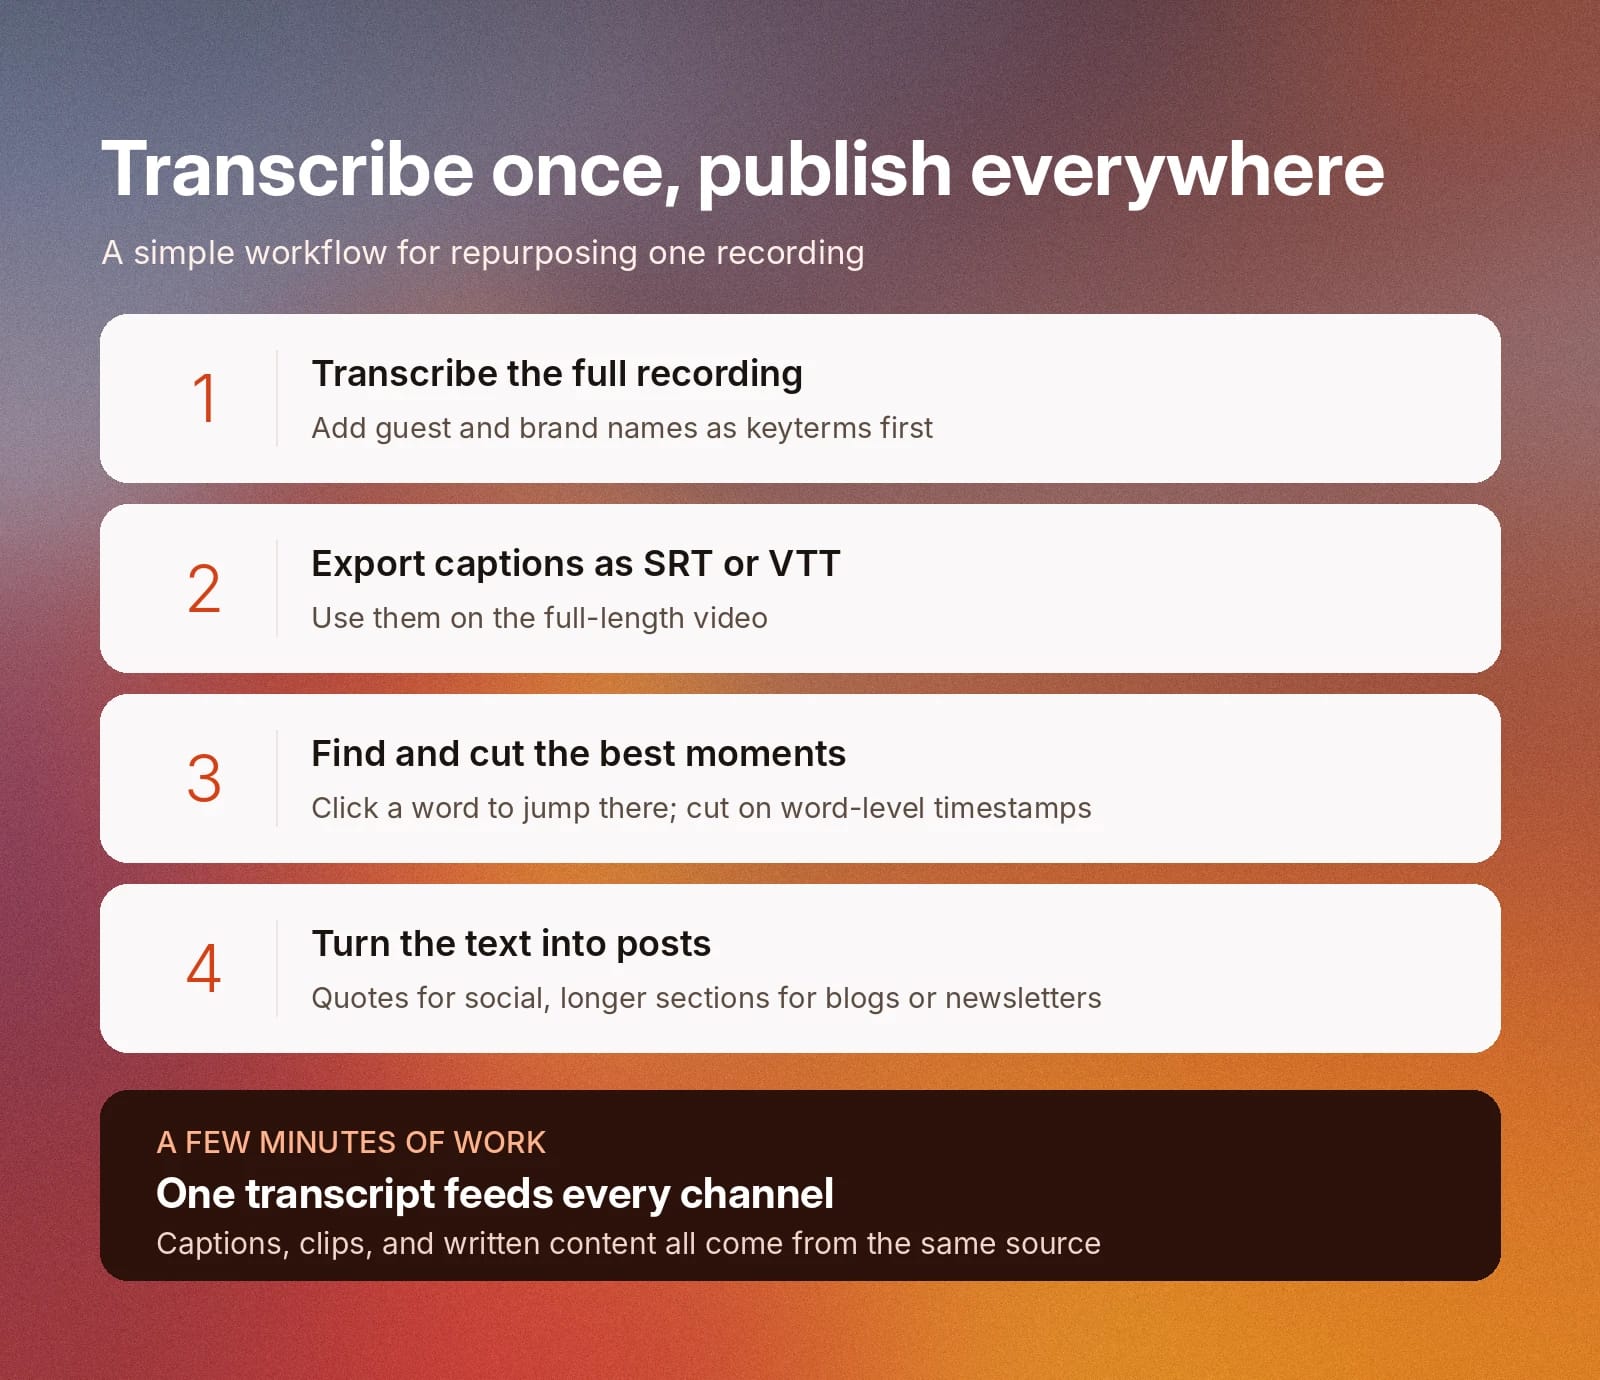
다음과 같은 간단한 콘텐츠 재활용 워크플로를 사용할 수 있습니다.
- 전체 녹음을 전사하고, 게스트와 브랜드 이름을 발음 사전에 추가하세요.
- 캡션을 SRT 또는 VTT로 내보내 전체 비디오에 사용하세요.
- 전사본을 읽으며 가장 강력한 순간을 찾으세요. 전사본의 단어를 클릭해 오디오의 해당 지점으로 이동한 다음, 단어 단위 타임스탬프를 사용해 각 클립을 정확한 시작과 끝 지점에서 자르세요.
- 핵심 인용문을 소셜 게시물에 복사하고, 더 긴 հատված은 블로그 게시물이나 뉴스레터로 편집하세요.
STT 팟캐스트 전사본으로 긴 형식의 콘텐츠를 만드는 데는 몇 분밖에 걸리지 않습니다.
LLM 분석을 위해 비디오를 전사본으로 전환하기
비디오를 텍스트로 변환한 후 콘텐츠를 LLM에 대량 업로드하여 분석할 수 있습니다. 새로운 아이디어를 찾고, 콘텐츠 재활용에 사용할 수 있는 핵심 화제를 강조하거나, 콘텐츠에서 효과가 있는 요소를 파악할 수 있습니다.
제가 만드는 모든 것은 제 목소리에서 시작하지만, 대부분의 AI 도구는 여전히 텍스트로 가장 잘 작동합니다. ElevenLabs Scribe는 제 번역 계층입니다. 비디오를 전사본으로 바꿔 주기 때문에 어떤 LLM이든 무엇이 효과가 있는지, 무엇이 그렇지 않은지 분석할 수 있습니다. 제 생각에는 이것이 AI의 가장 큰 격차 중 하나를 해소합니다.
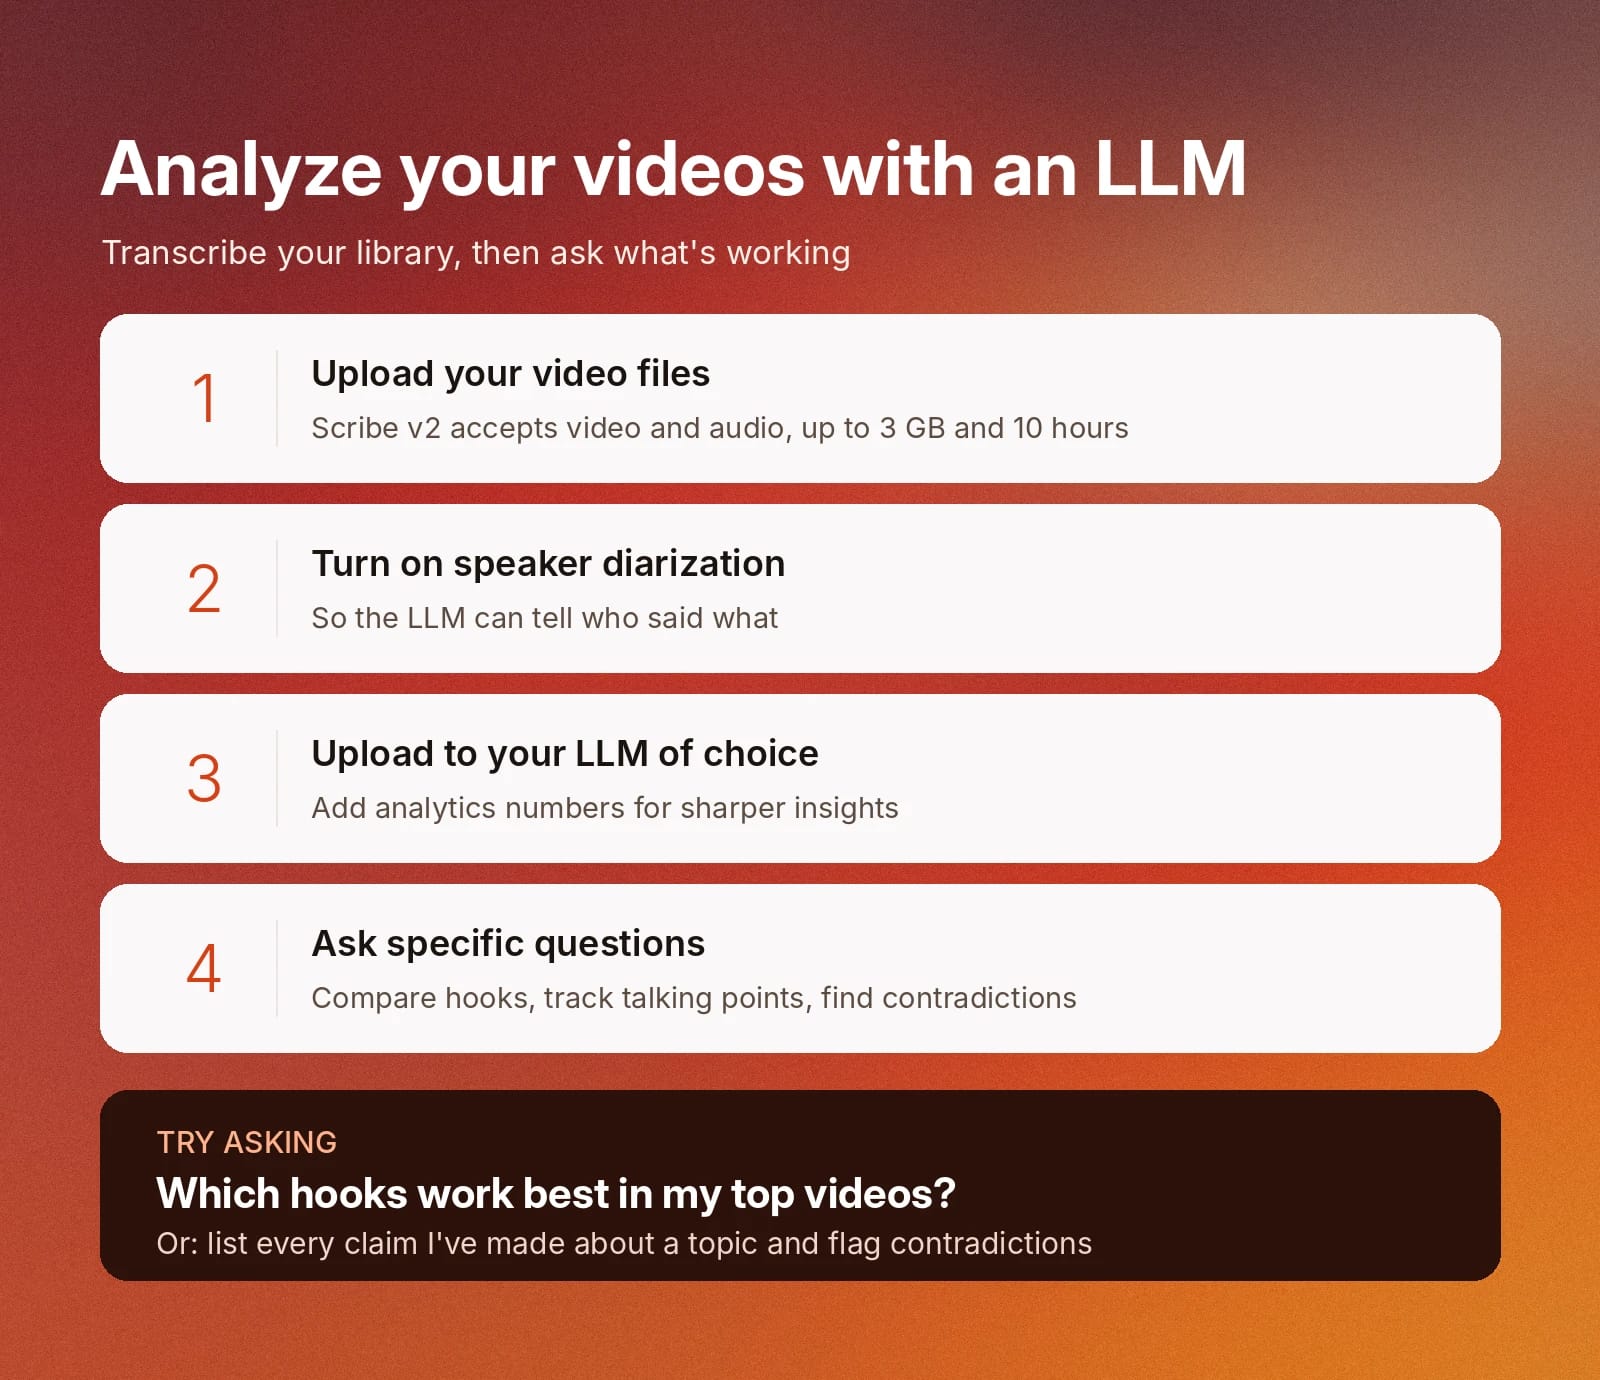
비슷한 워크플로를 설정하는 방법은 다음과 같습니다.
- 전사용 비디오 파일 업로드: ElevenLabs STT는 오디오뿐 아니라 비디오도 지원하며, 최대 3GB, 최대 10시간 길이의 파일을 처리할 수 있습니다.
- 화자 분리 켜기: 여러 명이 말한다면 LLM이 누가 무엇을 말했는지 알 수 있도록 화자 분리를 활성화하세요.
- 원하는 LLM에 업로드: 분석 수치나 추가 정보를 넣어 얻을 수 있는 인사이트를 개선하세요.
- 콘텐츠에 관해 구체적으로 질문하기: “내 성과가 가장 좋은 비디오의 첫 20초를 비교해 내 잠재고객에게 가장 효과적인 훅이 무엇인지 확인해 줘” 또는 “X 주제에 대해 내가 한 모든 주장을 나열하고 모순되는 부분을 표시해 줘”와 같이 질문하면 새로운 인사이트를 발견할 수 있습니다.
프롬프트와 노트 받아쓰기
음성 입력을 사용하면 모두 직접 입력했다면 생략했을 배경 정보와 뉘앙스를 AI 도구에 제공할 수 있습니다. 텍스트 음성 변환은 말한 내용을 프롬프트, 브리프 또는 노트에 바로 붙여 넣을 수 있는 텍스트로 바꿉니다. 일부 작가는 모든 내용을 타이핑하는 대신 음성을 전사하는 STT로 더 빠르게 글을 쓰고 있습니다.
특히 프롬프팅에서는 이것 없이 일하는 모습을 상상할 수 없습니다. AI와의 모든 상호작용에는 수많은 뉘앙스가 들어가야 하는데, 그걸 전부 입력하고 싶지는 않아요.
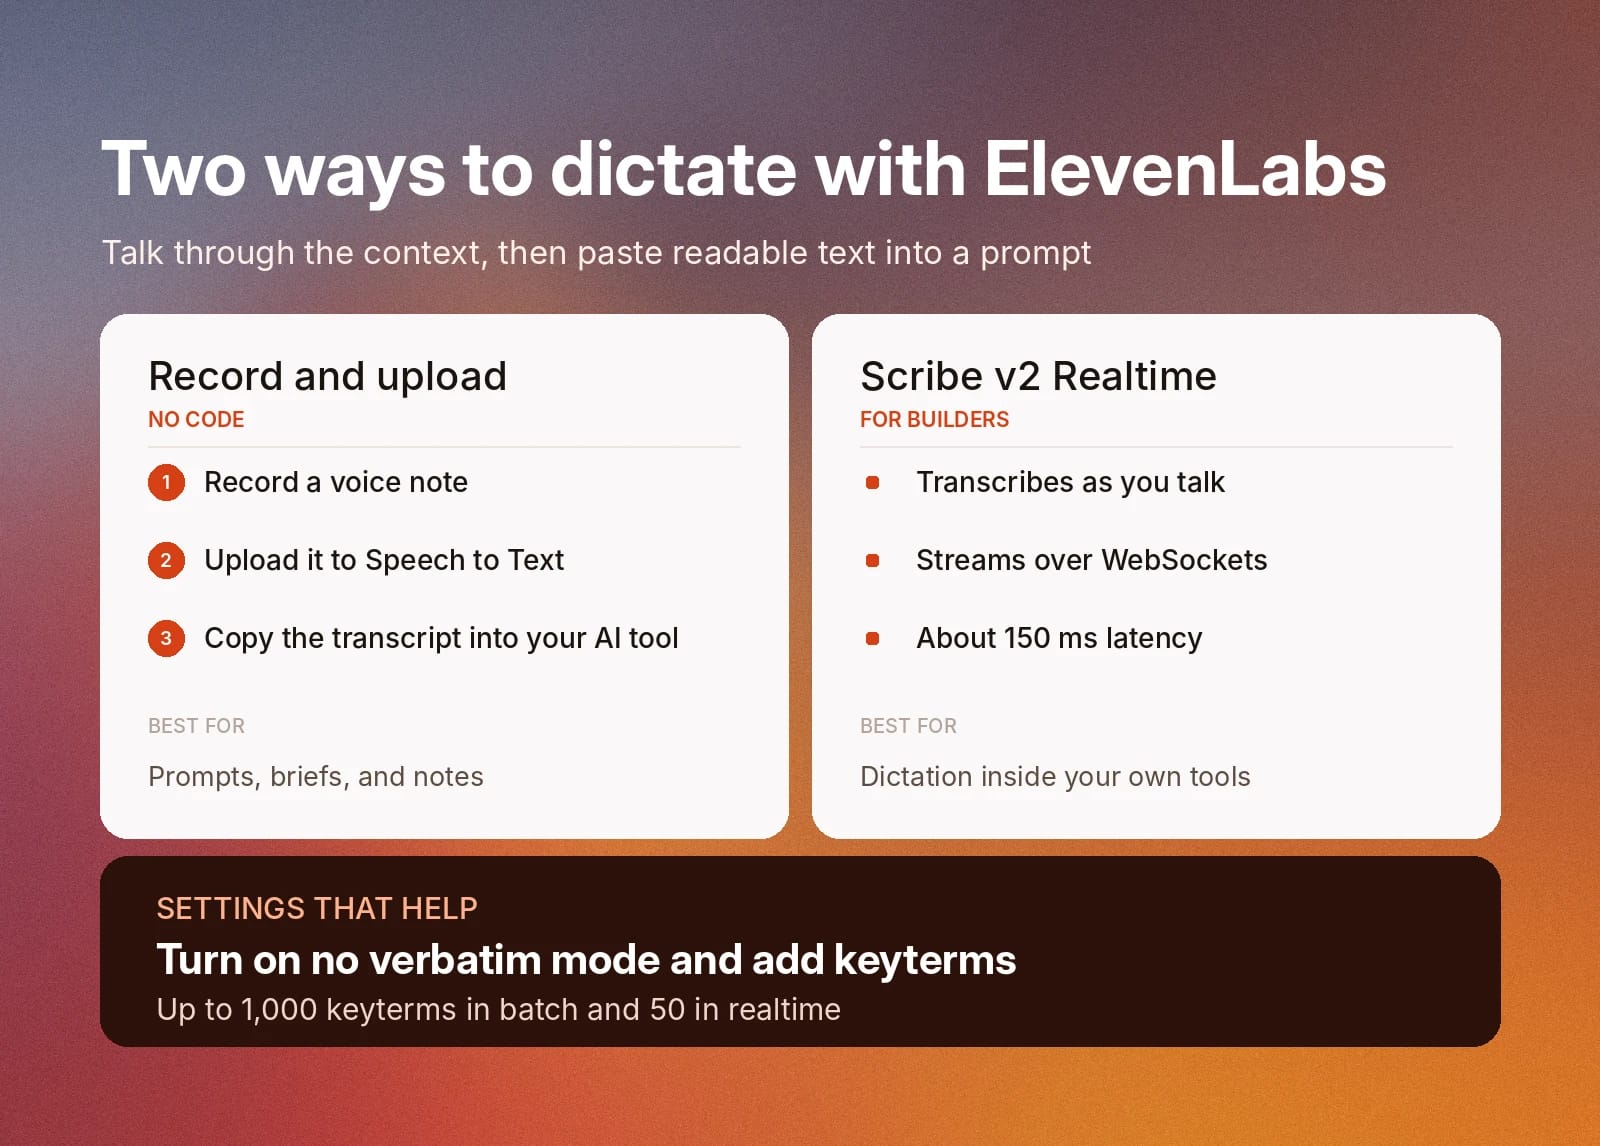
ElevenLabs에서 받아쓰기를 사용하는 방법은 두 가지입니다.
- 녹음 후 업로드: 음성 메모를 녹음하고 ElevenLabs 텍스트 음성 변환 페이지에 업로드한 뒤, 전사본을 AI 도구에 복사하세요.
- 실시간 스트리밍: 자체 도구를 구축하고 있다면 Scribe v2 Realtime이 WebSocket을 통해 말하는 동안 음성을 전사하며, 문서 기준 약 150ms의 낮은 지연 시간을 제공합니다.
추임새, 말실수, 비유창성을 제거하는 no verbatim 모드를 반드시 켜서 장황한 음성 메모도 읽기 쉬운 텍스트로 만들세요. 그런 다음 키텀 프롬프팅에 자주 사용하는 제품 이름과 전문 용어를 추가해 항상 정확하게 전사되도록 하세요. 일괄 전사는 최대 1,000개의 키텀을 지원하고, 실시간 전사는 최대 50개를 지원합니다.
STT로 이름, 브랜드, 전문 용어를 정확히 전사하기
텍스트 음성 변환 모델이 화자 이름, 브랜드 이름 또는 업계별 용어를 항상 인식하는 것은 아닙니다. 콘텐츠를 전사할 때는 키텀 프롬프팅을 사용해 철자와 형식을 명확히 지정하세요.
키텀 프롬프팅을 사용하면 전사가 시작되기 전에 이름이나 전문 용어의 올바른 철자를 제공할 수 있습니다. 각 비디오나 팟캐스트 에피소드에 자주 언급하는 게스트, 채널 또는 브랜드 이름을 추가하세요. 업계 전문 용어나 기타 틈새 용어도 추가해야 할 수 있습니다.
키텀 프롬프팅은 전사본의 정확도를 높이고 잠재고객이 읽기 쉽게 만듭니다. 이러한 용어를 수동으로 수정할 필요가 없으므로 편집 과정도 빨라집니다.
다른 언어의 잠재고객에게 도달하기
텍스트 음성 변환 모델은 전사를 넘어서는 기능을 제공합니다. 콘텐츠 크리에이터라면 이를 사용해 콘텐츠를 현지화하고 다른 언어를 구사하는 잠재고객에게 도달할 수도 있습니다.
ElevenLabs Scribe v2는 90개 이상의 언어로 콘텐츠를 전사합니다. ElevenLabs 더빙 스튜디오와 함께 사용해 완전한 현지화 워크플로를 구축할 수 있습니다.
이를 위해 더빙 스튜디오에 오디오를 업로드하고 원하는 언어로 콘텐츠를 더빙하세요. 그런 다음 더빙된 오디오를 전사해 현지화된 캡션, 쇼 노트 또는 기타 글 콘텐츠를 만드세요.
텍스트 음성 변환이 해주지 않는 일
텍스트 음성 변환은 강력한 도구이지만 한계도 있습니다. 텍스트 음성 변환 모델은 정확한 타임스탬프와 함께 오디오를 전사하지만 비디오 편집기는 아닙니다. 최종 결과물을 만들려면 별도의 비디오 편집 플랫폼을 사용해야 합니다.
콘텐츠를 만들 때는 먼저 텍스트 음성 변환으로 오디오를 전사하세요. 그런 다음 원본 전사본과 캡션을 모두 내보내 콘텐츠 전반에 활용하세요. 캡션을 비디오 편집기 또는 소셜 미디어에 직접 업로드하고, 전사본은 쇼 노트, 블로그 게시물 및 기타 글 자산의 기반으로 사용하세요.
게시하기 전에 모든 전사본을 반드시 검토하세요. 특히 이름과 화자들이 동시에 말하는 구간을 확인해야 합니다. Transcript Editor를 사용하면 앱 내에서 실수를 쉽게 수정할 수 있습니다.
콘텐츠 크리에이터에게 가장 적합한 텍스트 음성 변환 도구 선택 방법
적합한 STT 도구는 녹음을 깔끔하고 철자가 정확한 텍스트로 바꾸고, 콘텐츠 재활용을 최대한 쉽게 해 주는 타임스탬프를 제공합니다.
최고의 텍스트 음성 변환 플랫폼을 찾을 때는 다음 다섯 가지를 갖추었는지 확인하세요.
- 사용 언어에서의 정확도: STT 성능은 언어마다 다를 수 있으며, 특히 사용 가능한 데이터가 적은 언어에서 그렇습니다. 공개된 정확도 수치를 확인하세요. 예를 들어 ElevenLabs Scribe v2는 98%의 정확도를 제공합니다(약 2% WER)는 영어, 프랑스어, 이탈리아어, 스페인어 등의 언어에서 달성됩니다.
- 이름 및 업계 전문 용어 처리: STT 모델은 대화의 맥락을 이해하고 정확하게 전사할 수 있어야 합니다. 키텀 프롬프팅과 발음 사전을 제공하는 STT 플랫폼을 찾으세요.
- 타임스탬프 및 내보내기 형식: 단어 단위 타임스탬프와 SRT 또는 VTT 캡션을 내보내는 옵션이 필요합니다.
- 화자 처리: 특히 여러 화자가 등장하는 오디오 작업이라면 서로 다른 화자를 정확하게 식별하는 기능이 전사본을 명확하게 유지하는 데 도움이 됩니다.
- 파일 제한: 팟캐스트처럼 더 큰 오디오나 비디오 프로젝트는 파일 크기도 커질 수 있습니다. ElevenLabs는 최대 3GB 파일을 지원하며, 표준 모드에서는 최대 10시간까지 지원합니다.
Eleven Scribe v2와 같은 전용 STT 모델이 소셜 플랫폼에 내장된 자동 캡션 도구와 어떻게 다른지 살펴보겠습니다.
필요한 기능
자동 플랫폼 캡션
Scribe v2와 같은 전용 모델
이름 및 브랜드의 정확한 철자
오류가 발생할 수 있음
키텀 프롬프팅, 일괄 요청당 최대 1,000개 용어
읽기 쉬운 문장 부호
대체로 제한적
no verbatim 모드를 사용한 깔끔한 결과물
다른 곳에서 텍스트 재사용
캡션이 플랫폼에만 남음
전사본과 캡션을 다운로드해 어디서나 사용
타이밍
해당 플랫폼의 플레이어에 종속됨
클립에도 활용할 수 있는 단어 단위 타임스탬프
언어
플랫폼마다 다름
90개 이상 언어
시작하는 두 가지 방법: 노코드 업로드 또는 API
ElevenLabs에서는 텍스트 음성 변환을 사용해 비디오 콘텐츠를 전사하는 방법이 두 가지입니다.
첫 번째 방법은 오디오 파일을 ElevenLabs Playground 대시보드에 업로드하는 것입니다. 전사 설정을 조정하고 Transcript Editor에서 결과물을 직접 편집한 후 필요한 파일 형식으로 내보내세요. 과정은 빠르고 쉬우며 코딩이 필요하지 않습니다.
자체 콘텐츠 게시 워크플로를 구축하고 있다면 ElevenAPI를 사용해 전사할 수도 있습니다. 이미 구축 중인 도구에 API를 직접 추가하면 도구를 전환하지 않고도 동일하게 정확한 전사 결과를 얻을 수 있습니다.
ElevenLabs 가입하기로 오늘 STT를 시작하거나 자세히 알아보기를 통해 크리에이터를 위한 텍스트 음성 변환이 어떻게 판도를 바꾸고 있는지 확인하세요.
FAQ

Jack Limebear는 Growth 팀에서 블로그와 인사이트 페이지의 콘텐츠 작가이자 전략가로 활동하고 있습니다. ElevenLabs에 합류하기 전에는 빠르게 성장하는 SaaS 스타트업부터 포춘 500대 기업까지 다양한 조직에서 10년 넘게 콘텐츠 전략을 이끌었습니다. 케임브리지 대학교에서 영문학 석사 학위를 취득했습니다.