화자 분할이란? 작동 방식과 활용 사례
- 게시일
- 최종 업데이트
화자 분할은 화자 수를 알 수 없는 오디오 스트림을 받아 레이블이 지정된 구간의 타임라인을 생성합니다. 예를 들어 화자 A는 0:00~0:42, 화자 B는 0:42~1:15, 이후에는 다시 화자 A입니다. 시스템은 화자가 누구인지는 모르지만 서로 다른 사람이라는 점을 파악하고, 녹음 전체에서 레이블을 일관되게 유지합니다.
이 과정이 다중 화자 오디오를 활용할 수 있게 해줍니다. 회의록, 콜센터 분석, 인터뷰 전사, 팟캐스트 편집, 법적 기록은 모두 무엇이 말해졌는지뿐 아니라 누가 말했는지를 파악하는 데 의존합니다.
이 가이드에서는 화자 분할의 작동 방식, 세그먼테이션 및 식별 같은 관련 기술과의 차이점, 이를 지원하는 오픈 소스 도구, 그리고 화자 분할 시스템의 성능 측정 방법을 설명합니다.
요약
- 화자 분할은 누가 말하고 있는지를 기준으로 오디오 녹음을 구간으로 나누며, 실명을 식별하지 않고 레이블이 지정된 화자 발화를 생성합니다.
- 화자 분할은 화자가 바뀌는 시점을 찾는 화자 세그먼테이션, 그리고 음성을 실명과 매칭하는 화자 식별과 다릅니다.
- 화자 분할 성능은 전체 정확도를 위한 화자 분할 오류율(DER)과 모든 화자에게 정확도가 유지되는지 확인하는 자카드 오류율(JER)로 측정합니다.
화자 분할이란 무엇이며, 어떻게 작동하나요?
화자 분할은 누가 말하는지에 따라 오디오 스트림을 여러 구간으로 나누는 과정입니다. 화자 분할이 적용된 전사는 각 오디오 구간에 화자 ID를 부여합니다. 간단히 말해, “누가 언제 말했는가?”라는 질문에 답합니다.
회의의 원본 전사는 단어만 제공하지만, 화자 분할 전사는 화자 1이 질문했고 화자 2가 답했으며 화자 3이 중간에 끼어들었다는 정보를 알려줍니다.
대부분의 화자 분할 시스템은 다음 4단계 파이프라인을 따릅니다.
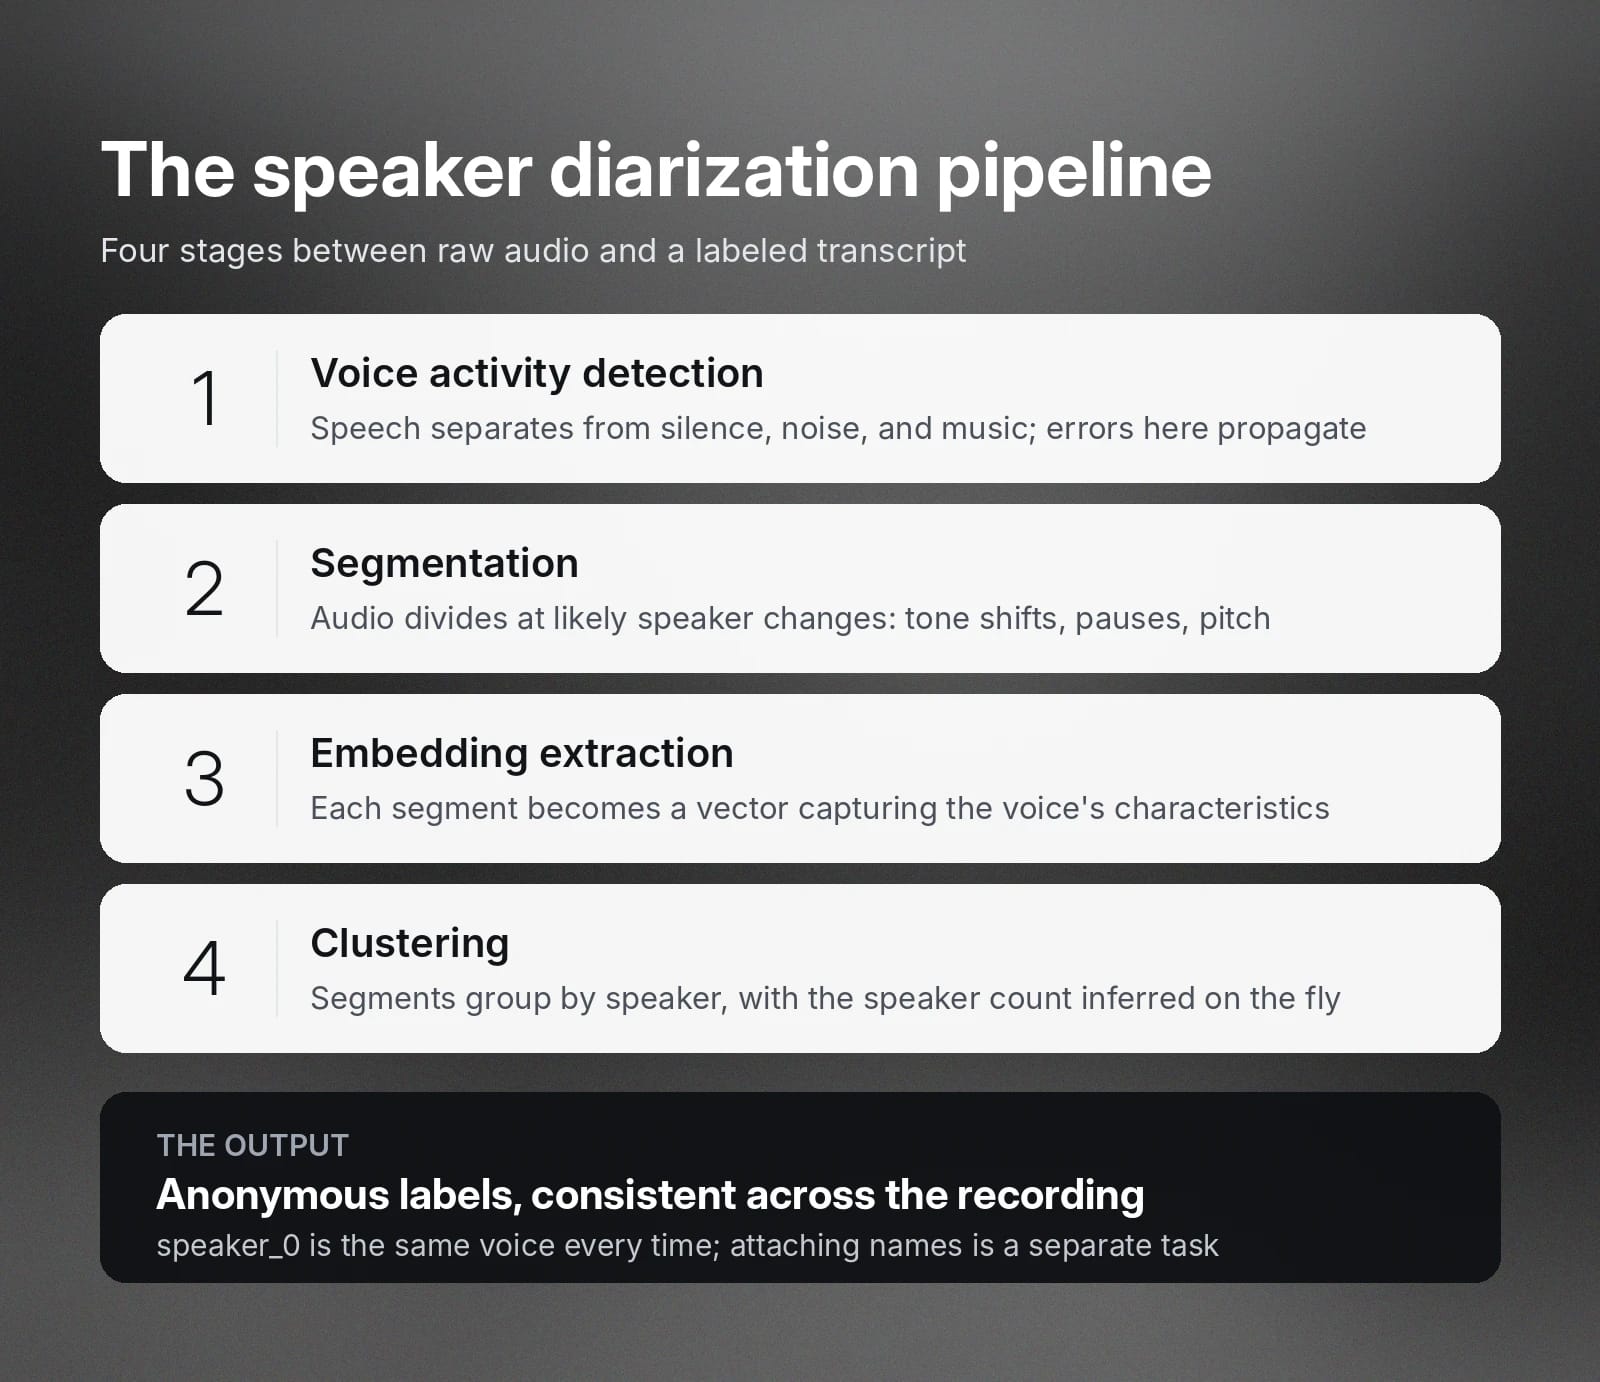
각 단계를 자세히 살펴보겠습니다.
음성 활동 감지(VAD)
음성 활동 감지는 음성을 그 밖의 모든 요소, 즉 무음, 배경 소음, 음악, 또는 키보드 클릭 소리와 분리합니다. 실제 음성이 포함된 오디오 구간만 다음 단계로 넘어갑니다.
이 단계에서 오류가 발생하면 이후 모든 단계로 전파됩니다.
세그먼테이션
이후 음성이 포함된 구간은 화자가 바뀔 가능성이 있는 지점에서 나뉩니다. 예를 들어 음색의 변화, 발화 간 휴지, 음높이 패턴의 변화 등이 있습니다. 대부분의 시스템은 후보 경계 양쪽의 음향 특성을 비교해 이러한 변화 지점을 직접 감지합니다.
일부 세그먼테이션 도구는 오디오를 2초 단위처럼 짧고 균일한 윈도우로 나눈 뒤, 클러스터링 단계에서 같은 화자에 속한 인접 윈도우를 병합합니다.
임베딩 추출
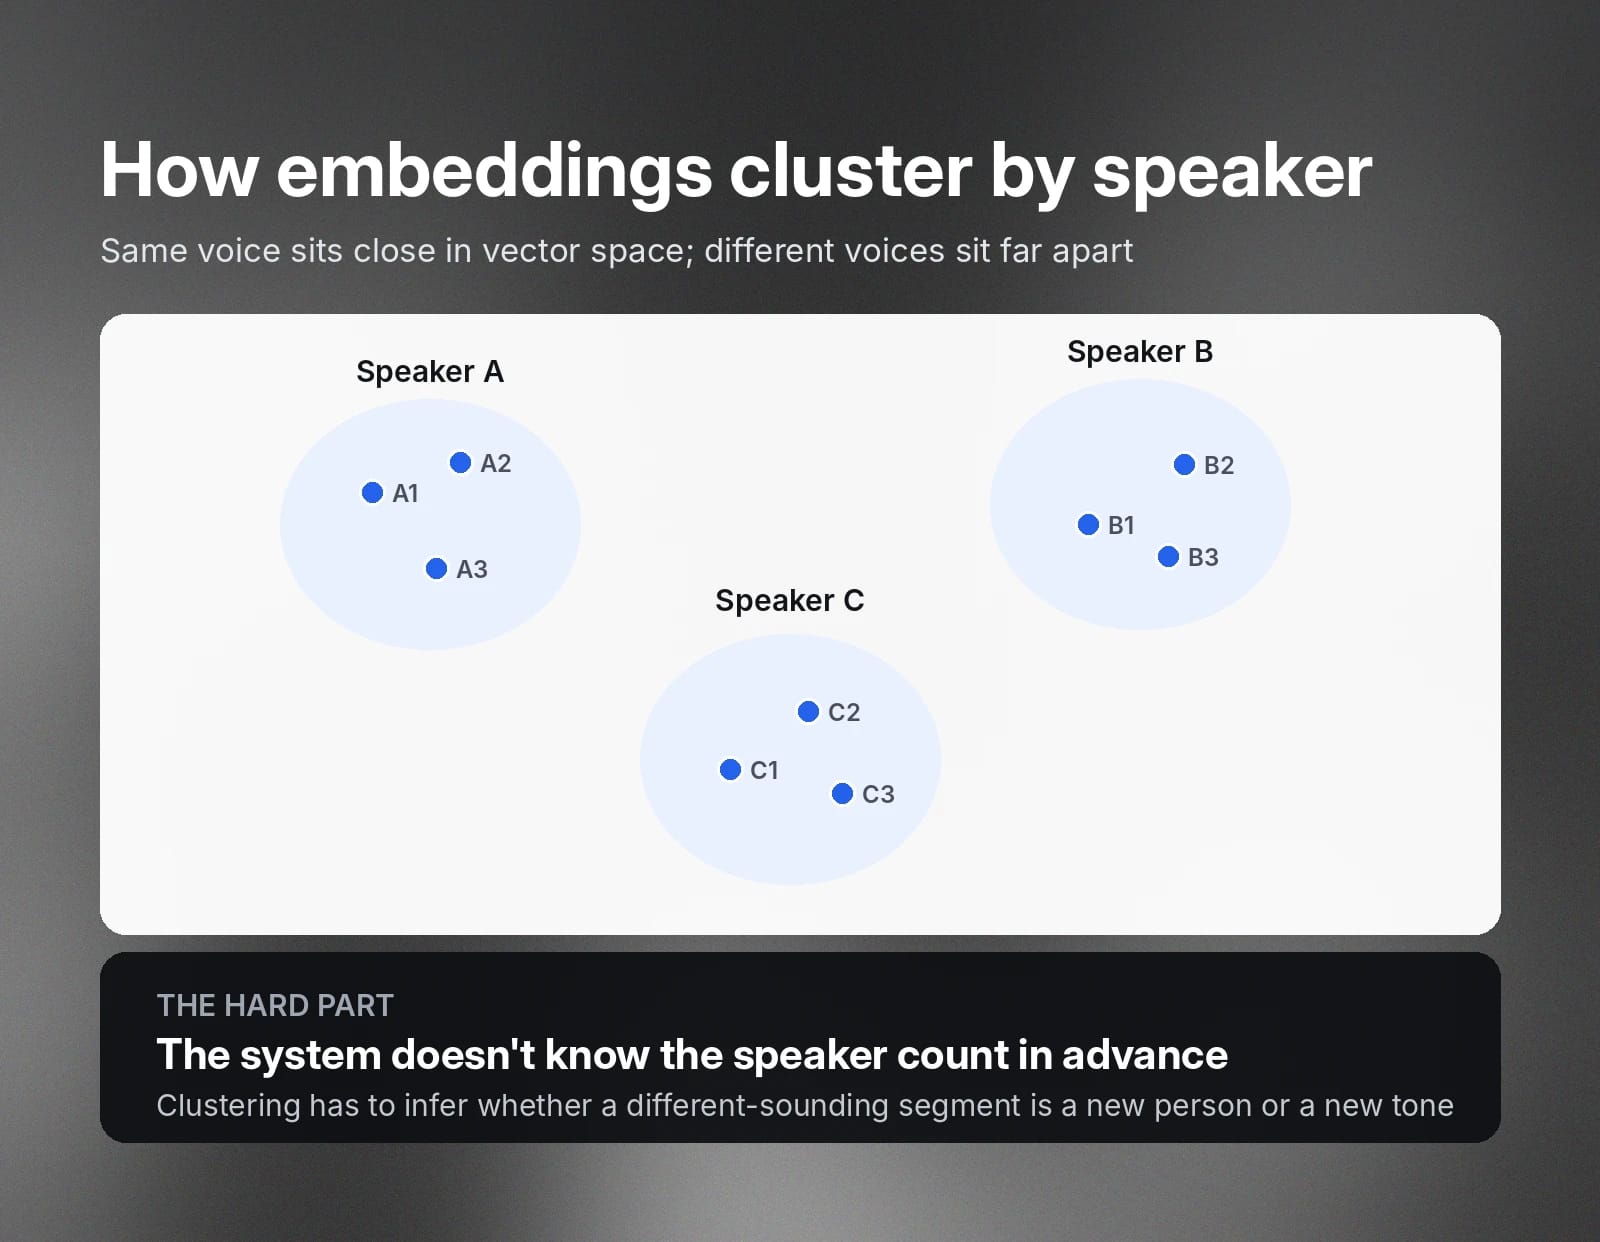
각 음성 구간은 해당 구간에서 말하는 사람의 음성 특성을 포착한 수치 벡터인 화자 임베딩으로 변환됩니다. 같은 화자의 임베딩은 벡터 공간에서 가깝게 군집을 이루고, 다른 화자의 임베딩은 더 멀리 떨어집니다.
클러스터링
그런 다음 임베딩을 그룹화하여 같은 화자의 구간에 동일한 레이블을 부여합니다. 시스템은 일반적으로 화자 수를 미리 알지 못하므로, 클러스터링 알고리즘이 이를 추론해야 합니다. 즉, 약간 다르게 들리는 구간이 새 화자인지 아니면 다른 톤으로 말하는 동일 인물인지 판단합니다.
출력은 일반적으로 전사와 함께 제공되는, 시간 범위에 연결된 화자 레이블 집합입니다. 예를 들어 2인 통화의 화자 분할 전사는 다음과 같습니다.
- [speaker_0] 전화 주셔서 감사합니다. 무엇을 도와드릴까요?
- [speaker_1] 안녕하세요, 지난달 청구서 관련해서 전화드렸습니다.
- [speaker_0] 네, 확인해 보겠습니다.
레이블은 익명이며 내부적으로 일관됩니다. Speaker_0은 등장할 때마다 같은 음성이지만, 시스템은 speaker_0의 이름이 Fergal이라는 사실은 알지 못합니다. 실제 신원을 연결하는 것은 별도의 작업이며, 아래에서 다룹니다.
화자 세그먼테이션과 화자 식별의 주요 차이점
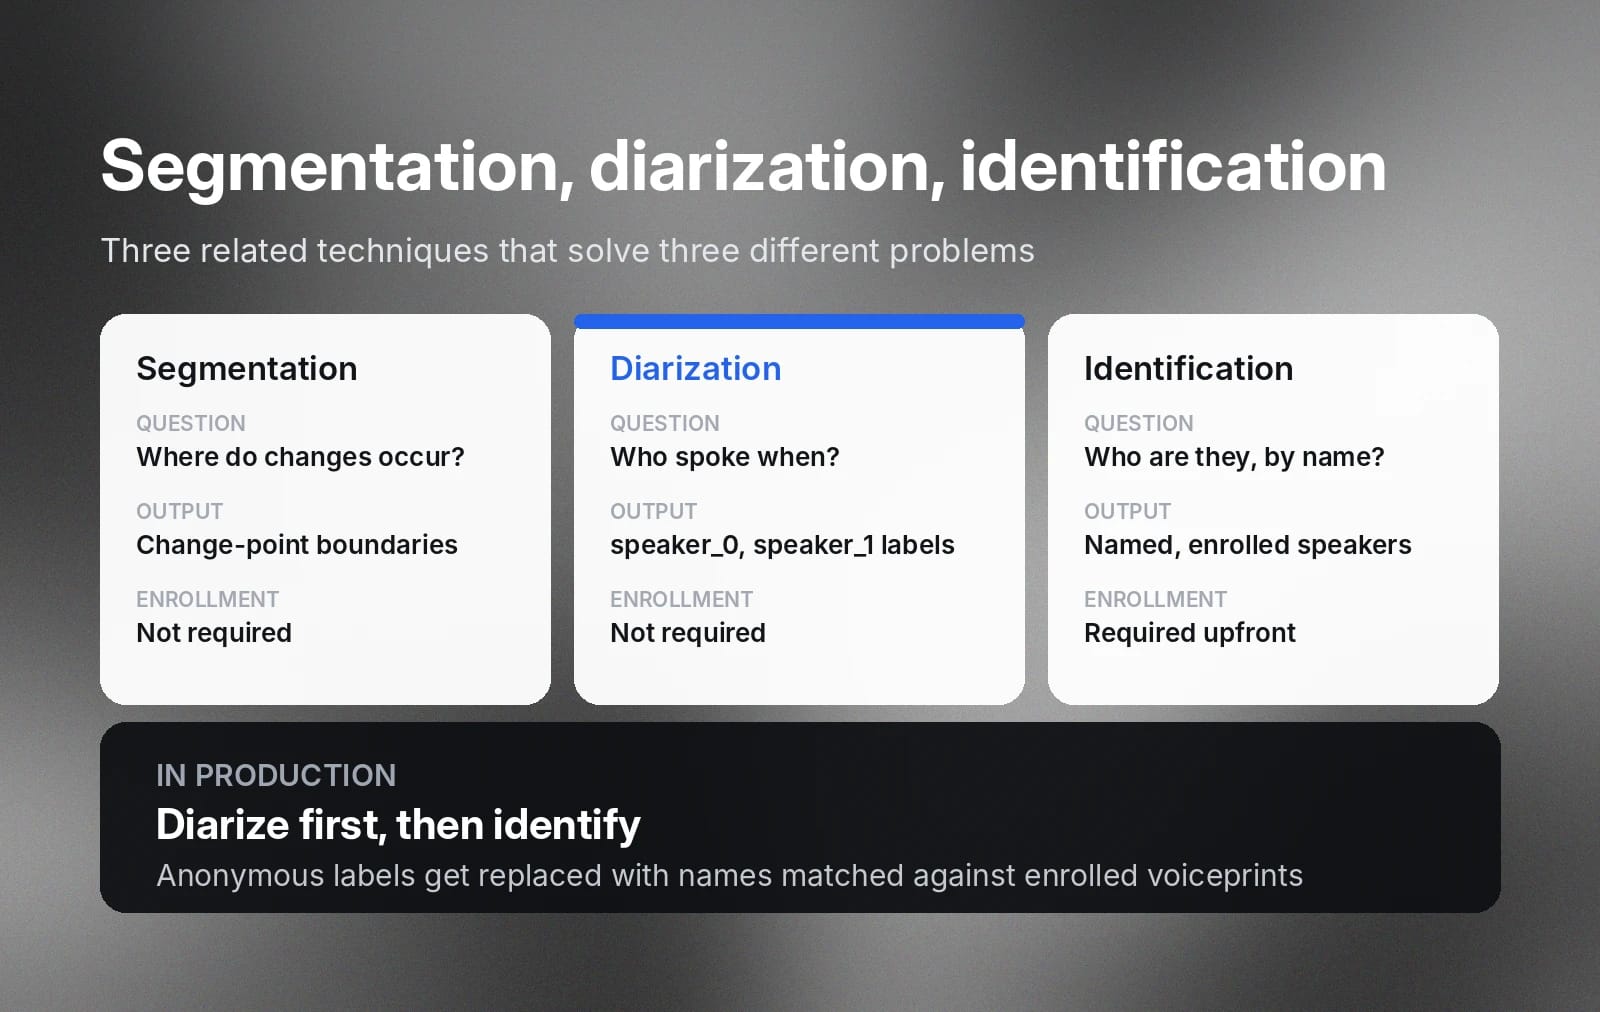
화자 세그먼테이션과 화자 식별은 모두 화자 분할과 밀접하게 겹치므로, 이 세 가지는 흔히 혼동됩니다.
각각 해결하는 문제는 조금씩 다르므로, 도구를 평가할 때는 그 차이를 이해하는 것이 중요합니다.
앞서 설명했듯 화자 세그먼테이션은 파이프라인 초반에 수행되는 화자 분할의 한 단계입니다. 레이블을 부여하지 않고 화자가 한 음성에서 다른 음성으로 바뀌는 경계를 찾습니다. 세그먼테이션은 0:42에 변화가 발생했다는 사실을 알려줍니다. 화자 분할은 이를 바탕으로 결과 구간을 그룹화하고 완전히 레이블링된 출력을 생성하여, 1:15의 음성이 녹음 시작 시점에 말한 음성과 같다는 것을 알려줍니다.
화자 식별은 화자 분할과 별개의 기능이지만 자주 함께 사용됩니다. 식별은 해당 화자가 실제로 누구인지 판별합니다. 식별 시스템은 등록된 음성 지문과 음성을 비교하고, 알려진 화자 참조 정보를 사용해 신원을 반환합니다. 식별 후 speaker_0과 speaker_1은 “Fergal”과 “Eric”이 됩니다.
많은 제품은 더 포괄적인 최종 전사를 만들기 위해 이 도구들을 결합합니다. 회의 도구는 모든 참석자의 발화를 수동 검토 없이 이름으로 귀속하도록 이를 자동으로 처리할 수 있습니다. Teams나 Meet에 설정한 이름 같은 문자열을 가져오는 경우도 있습니다.
널리 사용되는 오픈 소스 화자 분할 도구와 라이브러리
제어권, 유연성 또는 로컬 배포가 필요하다면 오픈 소스 화자 분할 도구를 고려해 볼 만합니다. 최적의 선택은 처리하는 오디오 유형(전화 통화, 회의, 팟캐스트, 방송), 지연 시간 요구 사항, 투자할 수 있는 엔지니어링 시간에 따라 달라집니다.
다음은 가장 인기 있는 옵션 몇 가지입니다.
Pyannote.audio
Pyannote.audio는 화자 분할을 위해 특별히 구축된 PyTorch 기반 툴킷으로, 가장 널리 사용되는 오픈 소스 옵션 중 하나입니다. VAD, 세그먼테이션, 임베딩, 클러스터링을 포함한 전체 화자 분할 스택을 다루는 사전 학습 파이프라인과 자체 데이터로 모델을 학습하거나 미세 조정할 수 있는 구성 요소를 제공합니다.
사전 학습 모델은 Hugging Face를 통해 배포되며, 대규모 전사 프로젝트에서 화자 분할 레이어로 흔히 사용됩니다.
WhisperX
WhisperX는 OpenAI의 Whisper ASR에 화자 분할과 강제 정렬을 결합합니다. Whisper 자체로도 뛰어난 전사를 생성하지만 화자 레이블을 부여하지 않으며, 타임스탬프도 근사치에 불과합니다. WhisperX는 단어 수준 타임스탬프 정렬을 추가하고 pyannote 기반 화자 분할을 통합해, 각 단어에 정확한 타임스탬프와 화자 레이블이 모두 포함된 전사를 생성합니다.
NVIDIA NeMo
NVIDIA NeMo는 더 폭넓은 대화형 AI 프레임워크의 일부로 화자 분할을 제공합니다. 겹치는 음성을 처리하는 엔드투엔드 접근 방식을 포함한 학습 가능한 화자 분할 모델을 제공하며, GPU 인프라에서 대규모 맞춤형 음성 시스템을 구축하는 팀을 위해 설계되었습니다.
이러한 도구는 각각 모델 배포, 확장, 모니터링, 업데이트를 포함한 화자 분할 인프라를 관리해야 합니다. 이러한 운영 부담을 원하지 않는 팀에게는 관리형 음성 화자 분할 API가 더 간단한 대안입니다. 기존 workflow에 통합하거나 전체 화자 분할 파이프라인을 처리할 수 있어, 고객 지원 분석, 회의 전사, 팟캐스트 처리 같은 프로덕션 사용 사례에 적합합니다.
실시간 화자 분할: 과제와 사용 사례
실시간 화자 분할은 시스템이 불완전한 맥락에서 결정을 내려야 하므로, 완성된 녹음의 화자 분할보다 훨씬 어렵습니다.
오프라인 시스템은 결정을 내리기 전에 전체 녹음을 확인합니다. 2분 시점의 음성과 40분 시점의 음성을 비교해 두 순간의 정보를 동시에 활용할 수 있으므로, 같은 화자라고 확신을 가지고 판단할 수 있습니다. 실시간 시스템에는 이런 여유가 없습니다. 다음에 어떤 내용이 나올지 알 수 없고, 결정한 뒤 수정할 기회도 거의 또는 전혀 없는 상태에서 음성이 도착하는 즉시 레이블을 부여해야 합니다.
이처럼 미래의 맥락이 없다는 점 때문에 다음 세 가지 문제를 실시간으로 해결하기가 훨씬 어려워집니다.
- 지연 시간과 정확도: 대화 전체를 앞뒤로 살펴볼 수 없으므로, 더 짧은 응답 시간 예산을 맞추려면 정확도를 직접 희생해야 합니다.
- 겹치는 음성: 사람들이 동시에 말할 때 오디오를 재처리할 수 있는 시스템이라면 이를 분리할 수 있습니다. 실시간 시스템은 이를 단일 레이블로 처리하거나, 즉석에서 특수한 중첩 인식 모델에 의존해야 합니다.
- 짧은 발화: 짧은 “네”나 “말씀하세요”는 시스템이 분석할 수 있는 음성을 거의 제공하지 않으며, 의지할 주변 맥락도 없이 즉시 레이블을 확정해야 합니다.
어려움에도 불구하고, 일부 애플리케이션은 녹음이 끝날 때까지 기다릴 수 없습니다. 실시간 자막은 회의와 방송에서 사람이 말하는 즉시 화자 레이블이 필요합니다. 콜센터 소프트웨어는 통화 중 상담원에게 안내를 제공하려면 고객이 사용하는 단어를 실시간으로 파악해야 합니다. 음성 에이전트는 여러 참여자가 있는 통화를 처리할 때 누가 무엇을 묻는지 지연 없이 추적해야 합니다. 각 경우에서 정확도는 약간 낮더라도 즉시 응답하는 시스템이 더 정확하지만 지연되는 시스템보다 낫습니다.
분석, 규정 준수 검토, 전사 생성처럼 실시간 레이블이 반드시 필요하지 않은 워크로드에서는 정확도가 훨씬 높기 때문에 배치 화자 분할이 여전히 더 나은 선택입니다.
화자 분할 성능 평가 방법
화자 분할 정확도를 측정할 때 가장 중요한 지표는 두 가지입니다. 전체 정확도를 나타내는 화자 분할 오류율(DER)과 모든 화자에게 그 정확도가 유지되는지 확인하는 자카드 오류율(JER)입니다.
DER은 잘못 귀속된 전체 음성 시간의 비율을 계산합니다. 다음 세 가지 오류 유형을 결합합니다.
- 오탐 음성: 아무도 말하지 않았는데 시스템이 구간을 음성으로 레이블링했습니다.
- 누락 음성: 누군가 말하고 있었지만 시스템이 무음으로 레이블링했습니다.
- 화자 혼동: 음성은 감지됐지만 잘못된 화자에게 귀속되었습니다.
DER = (오탐 + 누락 음성 + 화자 혼동) / 전체 음성 길이
DER이 10%라는 것은 이 세 가지 유형에서 발생한 오류가 전체 음성 시간의 10분의 1에 해당한다는 의미입니다. 낮을수록 좋으며, 동일한 조건에서 동일한 데이터로 측정한 점수끼리만 비교할 수 있습니다. DER은 오디오 품질, 화자 수, 녹음에 포함된 중첩 음성의 양에 따라 크게 달라집니다.
자카드 오류율(JER)은 화자별 화자 분할 정확도를 개별적으로 측정한 다음, 모든 화자의 결과를 평균냅니다. 각 참조 화자에 대해 평가기는 시스템의 가장 가까운 화자 레이블을 매칭하고, 올바르게 겹치는 시간과 둘 중 하나에 할당된 전체 시간을 비교합니다.
예를 들어 화자 A가 50분, 화자 B가 10분 말하는 60분 회의를 생각해 보겠습니다. 화자 분할 시스템이 화자 A의 50분 중 48분을 올바르게 레이블링했지만 화자 B의 10분 중에서는 4분만 올바르게 레이블링했다고 가정합니다. 회의 대부분이 화자 A의 발화이므로 전체 DER은 여전히 비교적 좋아 보일 수 있습니다. JER은 화자 A와 화자 B의 점수를 평균내기 전에 각각 독립적으로 평가하므로, 화자 B의 낮은 결과도 동등하게 반영합니다.
JER_speaker = 1 - (correct_overlap / (ref_time + sys_time - correct_overlap))
최종 JER은 화자별 오류율의 평균입니다.
JER = (1 / N) * Σ[JER_speaker_i] 또는 i = 1..N
DER과 JER을 모두 추적하면 화자 분할 정확도를 더 완전하게 파악할 수 있습니다. DER은 전체 정확도를, JER은 발화량이 적은 사람을 포함한 모든 참여자에게 정확도가 유지되는지를 보여줍니다.
프로덕션 환경을 대표하는 오디오로 테스트하기
화자 분할 시스템을 평가할 때는 실제 배포 조건과 일치하는 오디오에서 DER과 JER을 모두 계산하세요. 일반적인 화자 수, 오디오 품질, 대화 중첩 정도를 반영해야 합니다.
공개된 벤치마크 점수는 스튜디오 녹음처럼 실제 통화 녹음이나 실시간 회의와는 거의 다른 깨끗하고 통제된 데이터 세트에서 측정되었을 수 있습니다. 벤치마크에서 좋은 점수를 받은 시스템도 소음이 많고 음성이 겹치는 실제 환경의 오디오에서는 성능이 크게 저하될 수 있습니다. 화자 분할 제품을 결정하기 전에 자체 데이터로 테스트하세요.
ElevenAPI로 화자 분할 시작하기
다중 화자 지원 전사 기능을 구축할 준비가 되었다면, Scribe v2를 통해 ElevenLabs는 화자 분할을 단일 음성 텍스트 변환 API로 제공합니다. diarize=true와 함께 엔드포인트로 오디오를 보내면 JSON 응답이 최대 32명의 화자, 90개 이상의 언어, 최대 10시간 길이의 파일에서 각 단어에 화자 ID를 레이블링합니다.
두 가지 옵션으로 표준 화자 분할 출력을 확장할 수 있습니다. 통화 녹음의 경우 detect_speaker_roles=true를 사용하면 익명 번호 대신 화자를 상담원과 고객으로 레이블링합니다. 워크스페이스에 등록된 화자 프로필이 있다면 use_speaker_library=true로 감지된 화자를 등록된 음성과 매칭하여, 하나의 요청에서 화자 분할과 식별을 함께 수행할 수 있습니다.
화자 분할 임계값 파라미터를 사용하면 화자를 과도하게 분리하는 것과 병합하는 것 사이의 균형을 조정할 수 있습니다. 또한 스테레오 통화 녹음처럼 화자가 이미 별도의 오디오 채널로 분리되어 있다면, 멀티채널 전사는 채널별로 화자를 할당하고 화자 분할을 완전히 건너뜁니다.
음성 텍스트 변환 퀵스타트에서 첫 통합 과정을 단계별로 안내합니다. 규제 대상 배포를 위해 이 플랫폼은 SOC 2, ISO 27001, PCI DSS L1 및 HIPAA를 준수하며, EU 데이터 레지던시와 제로 보존 모드를 제공합니다.
시스템에 화자 분할을 구축할 준비가 되셨나요? 먼저 API 키를 받고 또는 ElevenLabs Docs에서 자세히 알아보세요.




