Python 음성 인식 튜토리얼: 오디오 파일에서 트랜스크립트까지
- 게시일
- 최종 업데이트
Python 앱에 음성 인식 기능을 도입하는 일은 예전에는 번거로웠습니다. Python 개발자는 오디오 전처리, 특징 추출, 모델 통합 등 전사 프로세스 자체를 직접 구현해야 했습니다. 여기에 엔지니어링 팀은 저수준 오디오 처리, 낮은 전사 품질, 음성과 실시간 자막 사이의 지연까지 해결해야 했습니다.
오디오 모델과 음성 인식 SDK의 발전으로 상황이 달라졌습니다.
이 Python 음성 인식 튜토리얼에서는 ElevenLabs 텍스트 음성 변환 오디오 모델을 Python 프로젝트에 통합하여 상용 수준의 전사 앱을 만드는 방법을 알아봅니다.
요약
- 상용 텍스트 음성 변환 모델은 기본 음성 인식 모델에 없는 화자 분리, 단어 수준 타임스탬프, 핵심 용어 프롬프팅 등의 기능을 제공합니다.
- ElevenAPI는 Scribe v2 및 Scribe v2 Realtime을 통해 Python 코드에 음성 인식 기능을 제공합니다.
- 개발자는 AI 코딩 플랫폼에 ElevenLabs 스킬을 설치해 공식 API 문서를 기반으로 정확한 Python 코드를 생성할 수 있습니다.
- 상용 개발을 위한 유료 플랜을 구독하기 전에 ElevenLabs API를 무료로 사용해 볼 수 있습니다.
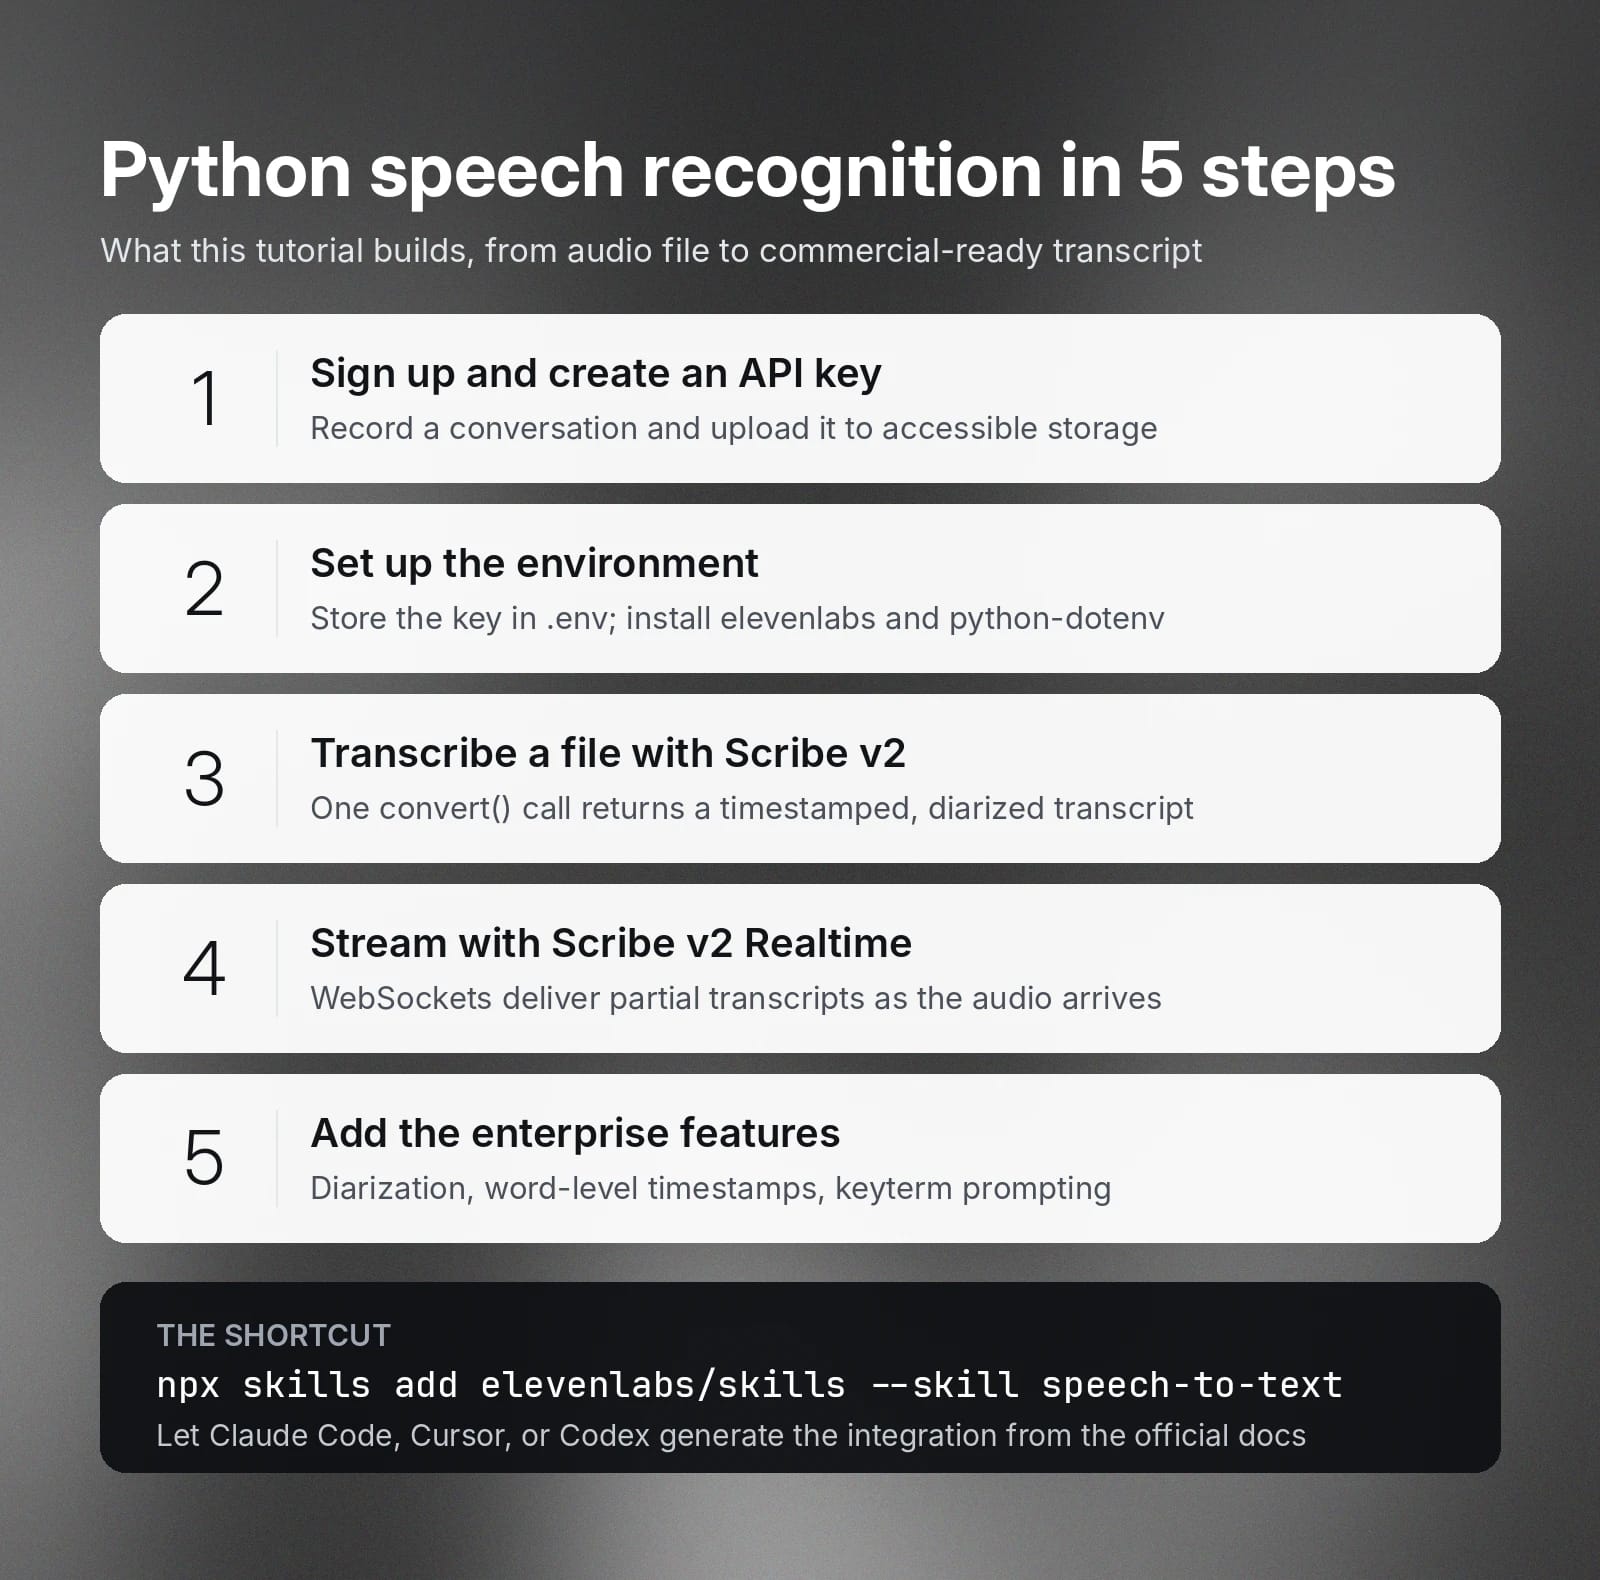
이 Python 음성 인식 튜토리얼에서 다루는 내용
이 튜토리얼에서는 엔터프라이즈 사용 사례에 맞는 음성 인식 Python 앱을 구축하는 데 도움이 되는 사전 준비 사항, API 통합, 고급 전사 기능을 다룹니다.
최근 몇 년간 음성 인식 기술은 크게 발전했습니다. 특히 대규모 언어 모델과 딥러닝 신경망이 Python 개발자의 전사 SDK 활용 방식을 바꿨습니다. 많은 튜토리얼에서 기본 전사 앱을 만드는 방법을 보여주지만, 상용 수준의 제품에 필요한 기능까지 다루는 경우는 드뭅니다.
이러한 간극을 메우기 위해 이 튜토리얼을 작성했습니다.
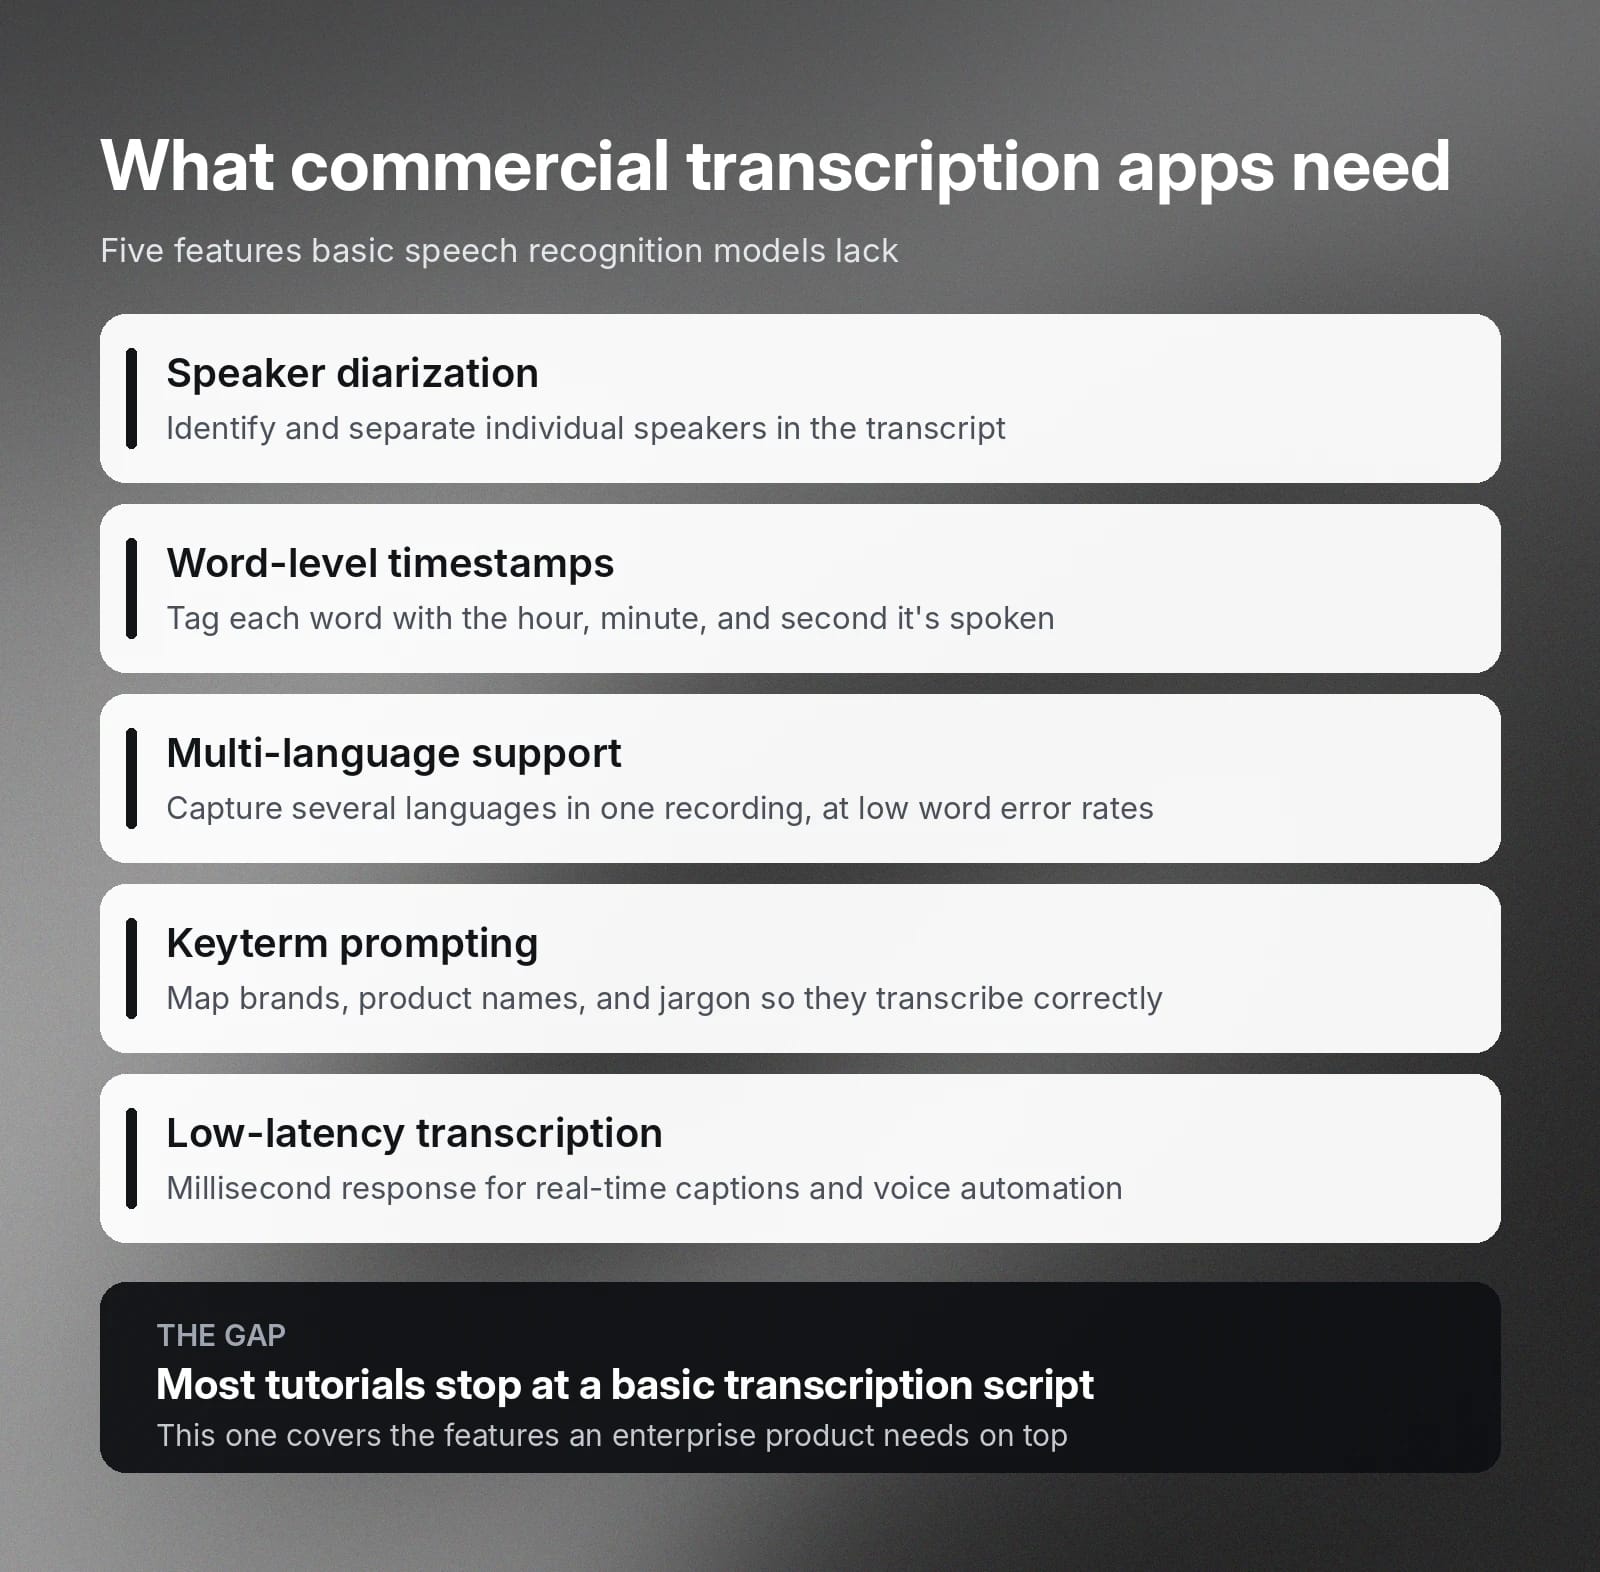
예를 들어, 많은 엔터프라이즈 전사 솔루션에는 다음 기능이 필요합니다:
- 화자 분리: 트랜스크립트에서 개별 화자를 식별하고 분리하는 기능입니다.
- 타임스탬프: 각 단어가 발화된 상대적 시, 분, 초를 정확하게 태그하는 기능입니다.
- 다국어 지원: 하나의 녹음 또는 라이브 스트림에서 여러 언어의 발화를 낮은 단어 오류율로 캡처합니다.
- 핵심 용어 프롬프팅: 브랜드, 제품명, 기술 용어 등 특수 단어를 매핑해 전사 오타를 방지하는 기능입니다.
- 저지연 전사: 실시간 전사 앱을 구동하는 밀리초 단위의 음성-텍스트 응답입니다.
참고: 이 튜토리얼은 취미 또는 개인 프로젝트를 위한 단순한 개인 스크립트 작성에 그치지 않습니다. 비즈니스마다 다르므로 텍스트 음성 변환 API 통합을 기반으로 한 애플리케이션 로직은 포함하지 않습니다.
Python 음성 인식 통합 사전 준비 사항
이 튜토리얼은 코드에서 음성 모델과의 상호작용을 간소화하는 ElevenLabs의 프로덕션급 API인 ElevenAPI를 중심으로 구성했습니다. ElevenAPI를 사용하면 배치 및 실시간 전사를 위한 주요 음성 모델인 Scribe v2와 Scribe v2 Realtime에 액세스할 수 있습니다.
ElevenLabs 텍스트 음성 변환 모델에 직접 액세스하는 대신 API 호출을 통해 오디오 녹음, 라이브 스트림, 인수를 전달합니다. 그러면 오디오 모델이 오디오 데이터를 텍스트로 변환합니다. 완료되면 코드 또는 웹훅을 통해 트랜스크립트를 받습니다.
시작하려면 다음 준비 단계를 따르세요.
- ElevenLabs에 가입합니다.
- API 키를 생성합니다.
- 대화를 녹음하고 공개적으로 액세스 가능한 스토리지에 업로드합니다.
준비가 되면 다음 섹션으로 넘어가세요.
환경 설정
ElevenLabs 모델을 통합하기 전에 ElevenLabs API 키를 안전하게 관리할 수 있도록 Python 환경을 설정하세요. 다른 모든 API 키와 마찬가지로 .env 파일에 환경 변수(관리형 시크릿)로 저장하는 것을 권장합니다.
API 호출 시 환경 변수를 전달합니다. 이렇게 하면 공용 네트워크를 통해 API 요청을 보낼 때 API 키가 실수로 노출되는 것을 방지할 수 있습니다.
다음으로 Bash 명령을 실행해 ElevenLabs SDK인 elevenlabs를 Python 환경에 설치합니다. SDK를 사용하면 다양한 음성 모델에 액세스할 수 있습니다. 이 경우 Scribe v2와 Scribe v2 Realtime 중에서 선택합니다.
또한 Python 코드가 .env 파일에 저장된 환경 변수에 액세스할 수 있게 해 주는 python-dotenv도 설치해야 합니다.
첫 번째 전사 스크립트 작성하기
Python 환경을 설정했다면 ElevenLabs Scribe v2를 사용해 오디오 파일을 전사할 수 있습니다.
ElevenLabs Scribe v2는 대규모로 오디오 파일을 전사할 수 있는 업계 선도 음성 인식 모델입니다. 오디오 녹음에 상당한 배경 소음이 있어도 음소를 높은 정확도로 감지합니다. 오디오를 전사하려면 ElevenLabs API를 통해 녹음을 모델에 전송하고 완료된 트랜스크립트를 가져옵니다.
아래는 오디오 파일을 타임스탬프와 화자 분리가 포함된 트랜스크립트로 변환하는 Python 코드 스니펫입니다.
이 코드는 필요한 기능을 제공하는 라이브러리를 로드합니다. 또한 선언한 환경 변수를 프로그램 환경으로 불러옵니다.
그런 다음 환경 변수에 저장된 API 키를 사용해 ElevenLabs 클라이언트를 생성합니다. 다음으로 오디오 파일을 다운로드하고 바이너리 데이터로 변환합니다.
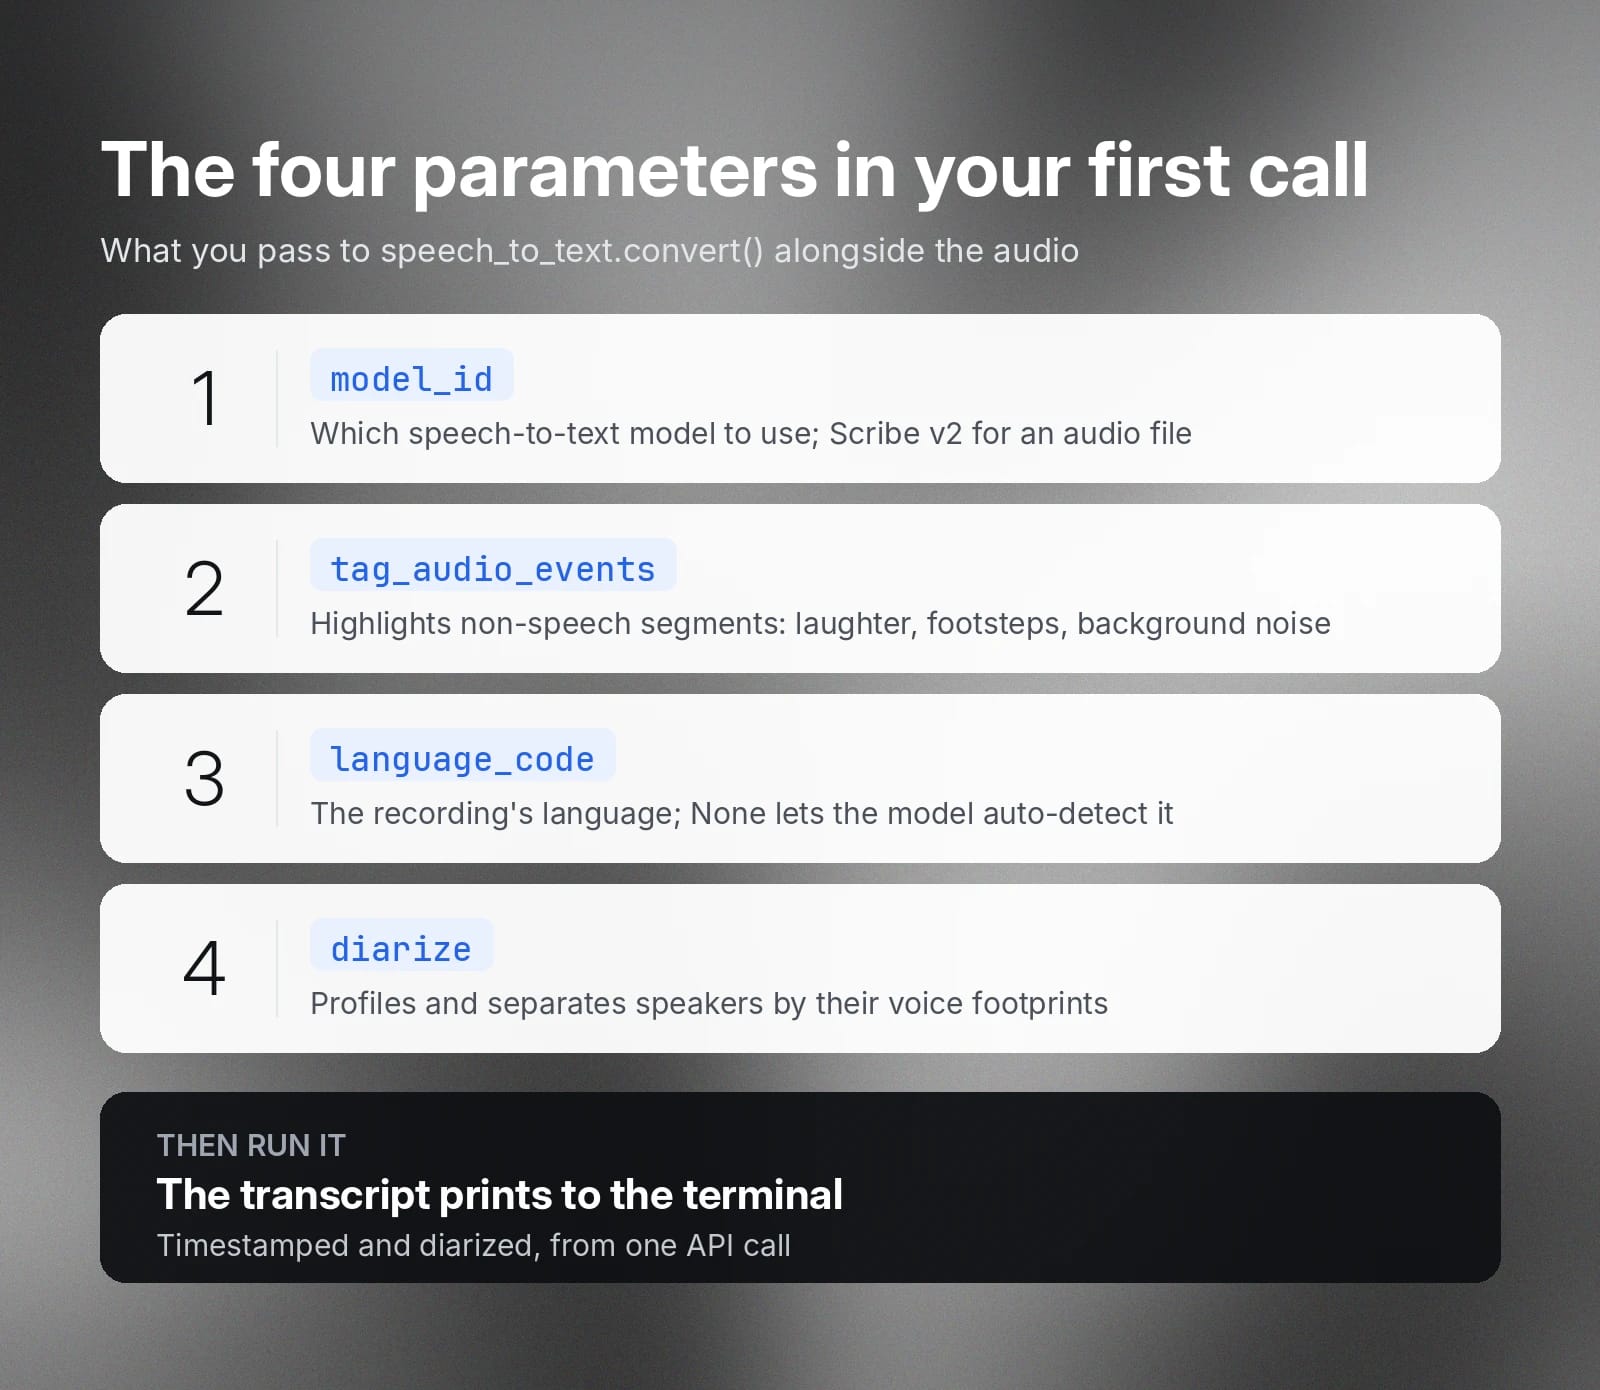
원시 오디오 데이터를 준비했다면 여러 매개변수와 함께 ElevenLabs API로 전송합니다.
- model_id는 사용할 음성-텍스트 모델을 지정합니다. 오디오 파일을 전달하므로 Scribe v2가 가장 적합한 옵션입니다.
- tag_audio_events 를 사용하면 웃음, 발소리, 기타 배경 소음처럼 음성이 아닌 구간을 강조 표시할 수 있습니다.
- language_code 는 녹음 파일 속 대화의 언어를 나타냅니다. 값을 None으로 설정하면 모델이 언어를 자동으로 감지합니다.
- diarize는 모델이 음성 특징을 기준으로 서로 다른 화자를 프로파일링하고 분리할지 여부를 지정합니다.
마지막으로 코드를 실행하면 터미널에서 전사된 오디오를 확인할 수 있습니다.
Python에서 스트리밍 음성 인식하기
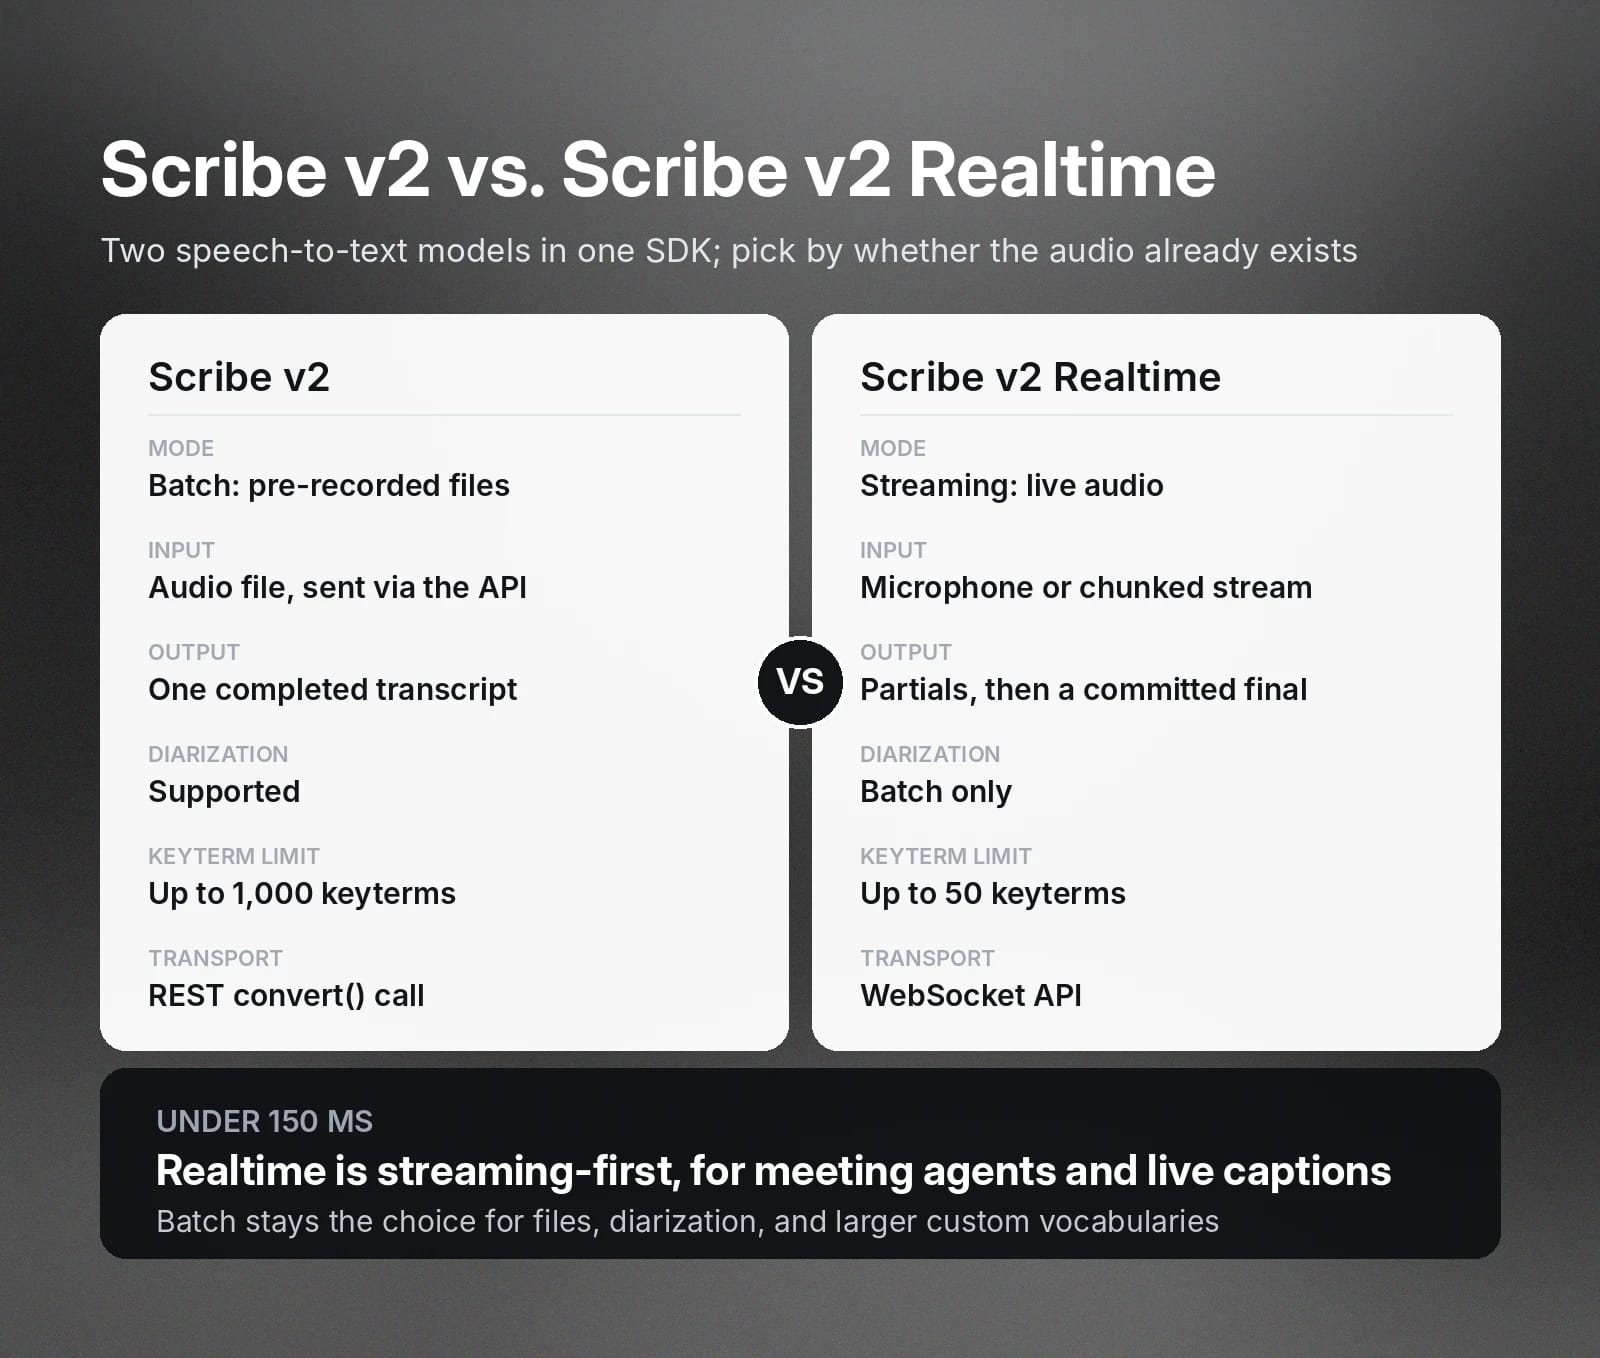
위 예시는 사전 녹음된 파일에 적합한 배치 전사를 다룹니다. 하지만 ElevenLabs는 스트리밍 음성 인식을 구축할 수 있는 API도 제공합니다. 배치 처리와 달리 이 모드는 대화가 진행되는 동안 실시간으로 음성 인식을 실행해 트랜스크립트를 생성합니다.
이를 위해 WebSocket API를 사용해 Python 코드를 Scribe v2 Realtime 모델에 연결합니다.
Scribe v2 Realtime은 전사 지연 시간이 150ms 미만인 스트리밍 우선 아키텍처를 제공합니다. Scribe v2 Realtime을 사용하면 회의 에이전트, 접근성 도구, 음성 활성화 자동화와 같은 애플리케이션을 구축할 수 있습니다. 모델은 오디오 스트림을 처리하면서 부분 트랜스크립트를 반환합니다. 코드가 자동 또는 수동으로 오디오 세그먼트를 커밋할 때만 최종 트랜스크립트를 반환합니다.
오디오 소스와 애플리케이션 유형에 따라 서버 측 또는 클라이언트 측에서 ElevenLabs API와 음성 인식을 통합합니다.
- 클라이언트 측 스트리밍을 사용하면 마이크에서 직접 또는 수동으로 청크화한 오디오 스트림을 통해 스트리밍할 수 있습니다.
- 서버 측 스트리밍은 URL 또는 오디오 소스의 오디오 데이터를 음성 모델로 라우팅합니다.
클라이언트 측과 서버 측 스트리밍 모두 비동기 workflow를 사용할 수 있습니다. API를 계속 폴링하는 대신 WebSocket으로 결과를 처리하세요. 코드에서는 부분 및 최종 트랜스크립트를 수신하는 핸들러를 만들어야 합니다.
더 나아가기: 화자 분리, 타임스탬프, 사용자 지정 어휘
자동 음성 인식 외에도 ElevenLabs 텍스트 음성 변환 모델은 화자 분리, 타임스탬프, 사용자 지정 어휘를 지원합니다.
- 화자 분리: 배치 전사만 화자 분리를 지원합니다. diarize 인수를 설정해 화자 분리를 활성화할 수 있습니다. 하지만 배치 전사 내 모드인 멀티채널 전사는 화자 분리를 지원하지 않습니다.
- 타임스탬프: 배치 전사를 수행할 때 단어 또는 문자 수준의 타임스탬프 중에서 선택할 수 있습니다. 이를 위해 convert 메서드 사용 시 timestamps_granularity 매개변수를 설정하세요.
- 사용자 지정 어휘: 실시간 및 배치 전사 모두 핵심 용어 프롬프팅을 지원합니다. 이 기능은 목록에 포함한 특정 핵심 용어를 모델이 우선적으로 전사하도록 유도합니다. Scribe v2 Realtime은 최대 50개의 핵심 용어를 지원하며, Scribe v2는 1,000개를 지원합니다.
AI 코딩 어시스턴트에서 ElevenLabs 스킬 사용하기
AI 코딩 어시스턴트는 개발 속도를 높여 줍니다. Claude Code, Cursor, Codex 또는 유사한 AI 코딩 도구를 사용하고 있다면 코딩 환경에 ElevenLabs 스킬을 추가할 수 있습니다.
플랫폼의 터미널에서 다음 명령을 실행하기만 하면 됩니다:
AI 코딩 에이전트가 ElevenLabs의 GitHub 리포지토리 에서 음성-텍스트 스킬을 다운로드해 로컬 스킬 디렉터리에 설치합니다. 따라서 전체 API 통합을 처음부터 작성하지 않고도 ElevenLabs 공식 문서를 기반으로 음성 인식용 Python 코드를 자동 생성할 수 있습니다.
설치가 완료되면 원하는 기능을 대화하듯 설명하는 것만으로 음성 인식 Python 코드를 생성할 수 있습니다. 설명을 바탕으로 코딩 어시스턴트가 올바른 모델과 매개변수를 사용해 음성-텍스트 스킬 기반 코드를 자동으로 생성합니다.
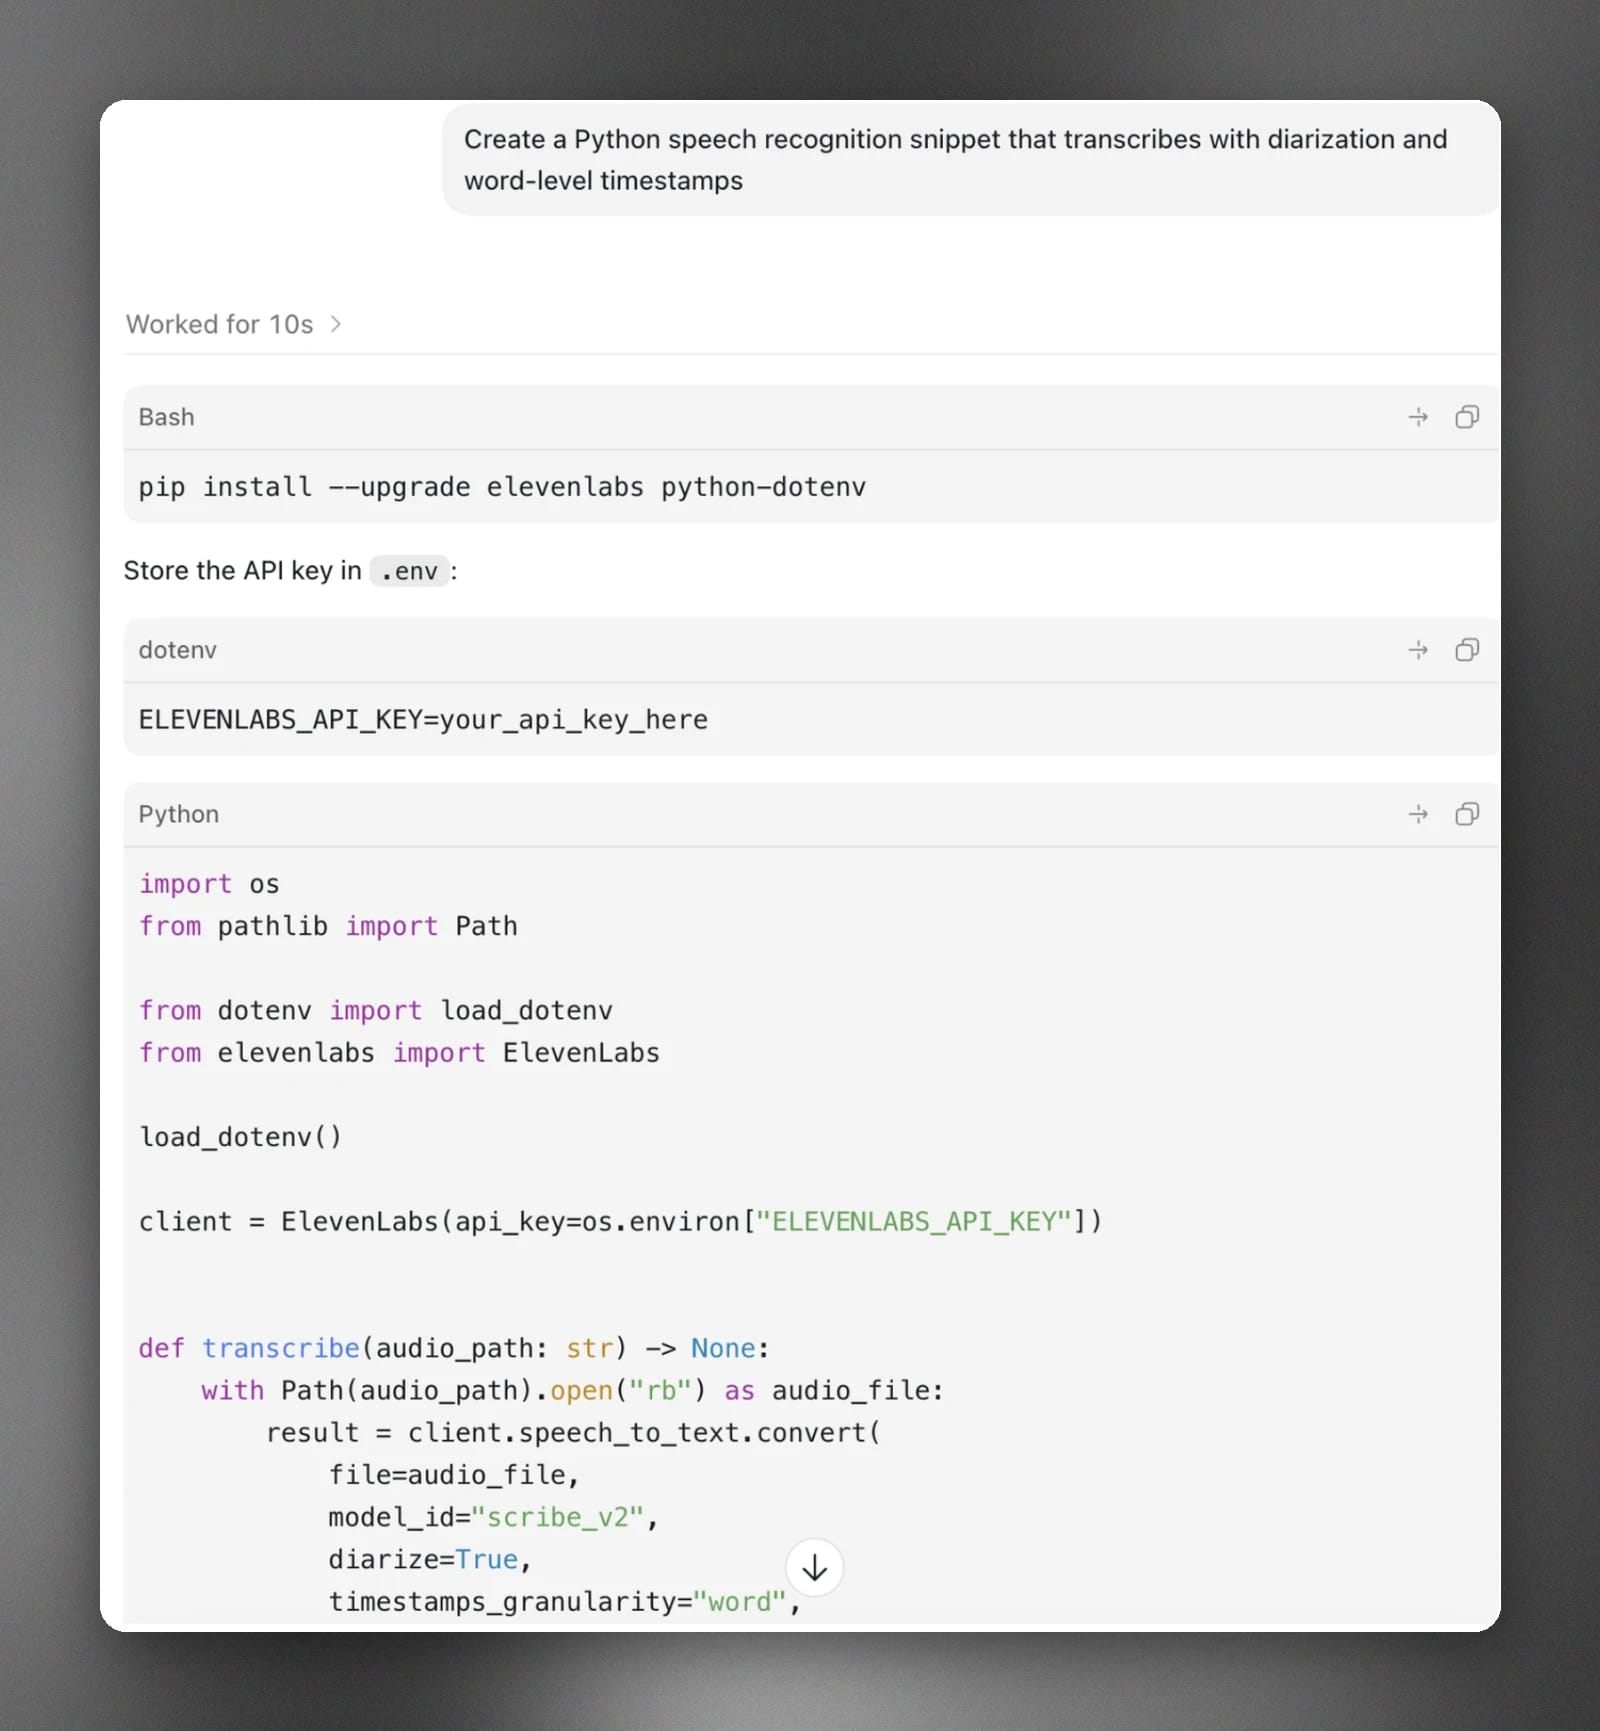
예를 들어 Codex에 “화자 분리와 단어 수준 타임스탬프로 전사하는 Python 음성 인식 스니펫을 만들어 줘”라고 입력하면 아래와 유사한 스니펫을 얻을 수 있습니다.
음성 인식을 위한 ElevenAPI 시작하기
ElevenAPI를 사용하면 Python에서 음성 인식 앱을 구축하기 위한 고급 텍스트 음성 변환 모델에 액세스할 수 있습니다.
ElevenAPI를 사용하면 제품 혁신을 지연시키는 통합 코드를 처음부터 작성하지 않아도 됩니다. 대신 핵심 용어 프롬프팅, 화자 분리, 타임스탬프 등 상용 수준의 요구 사항을 충족하는 텍스트 음성 변환 서비스를 제공하는 SDK를 사용할 수 있습니다.
지금 ElevenLabs API 키를 받고 공식 문서에서 API 작동 방식을 알아보세요.

