Scribe 만나보기
- 게시일
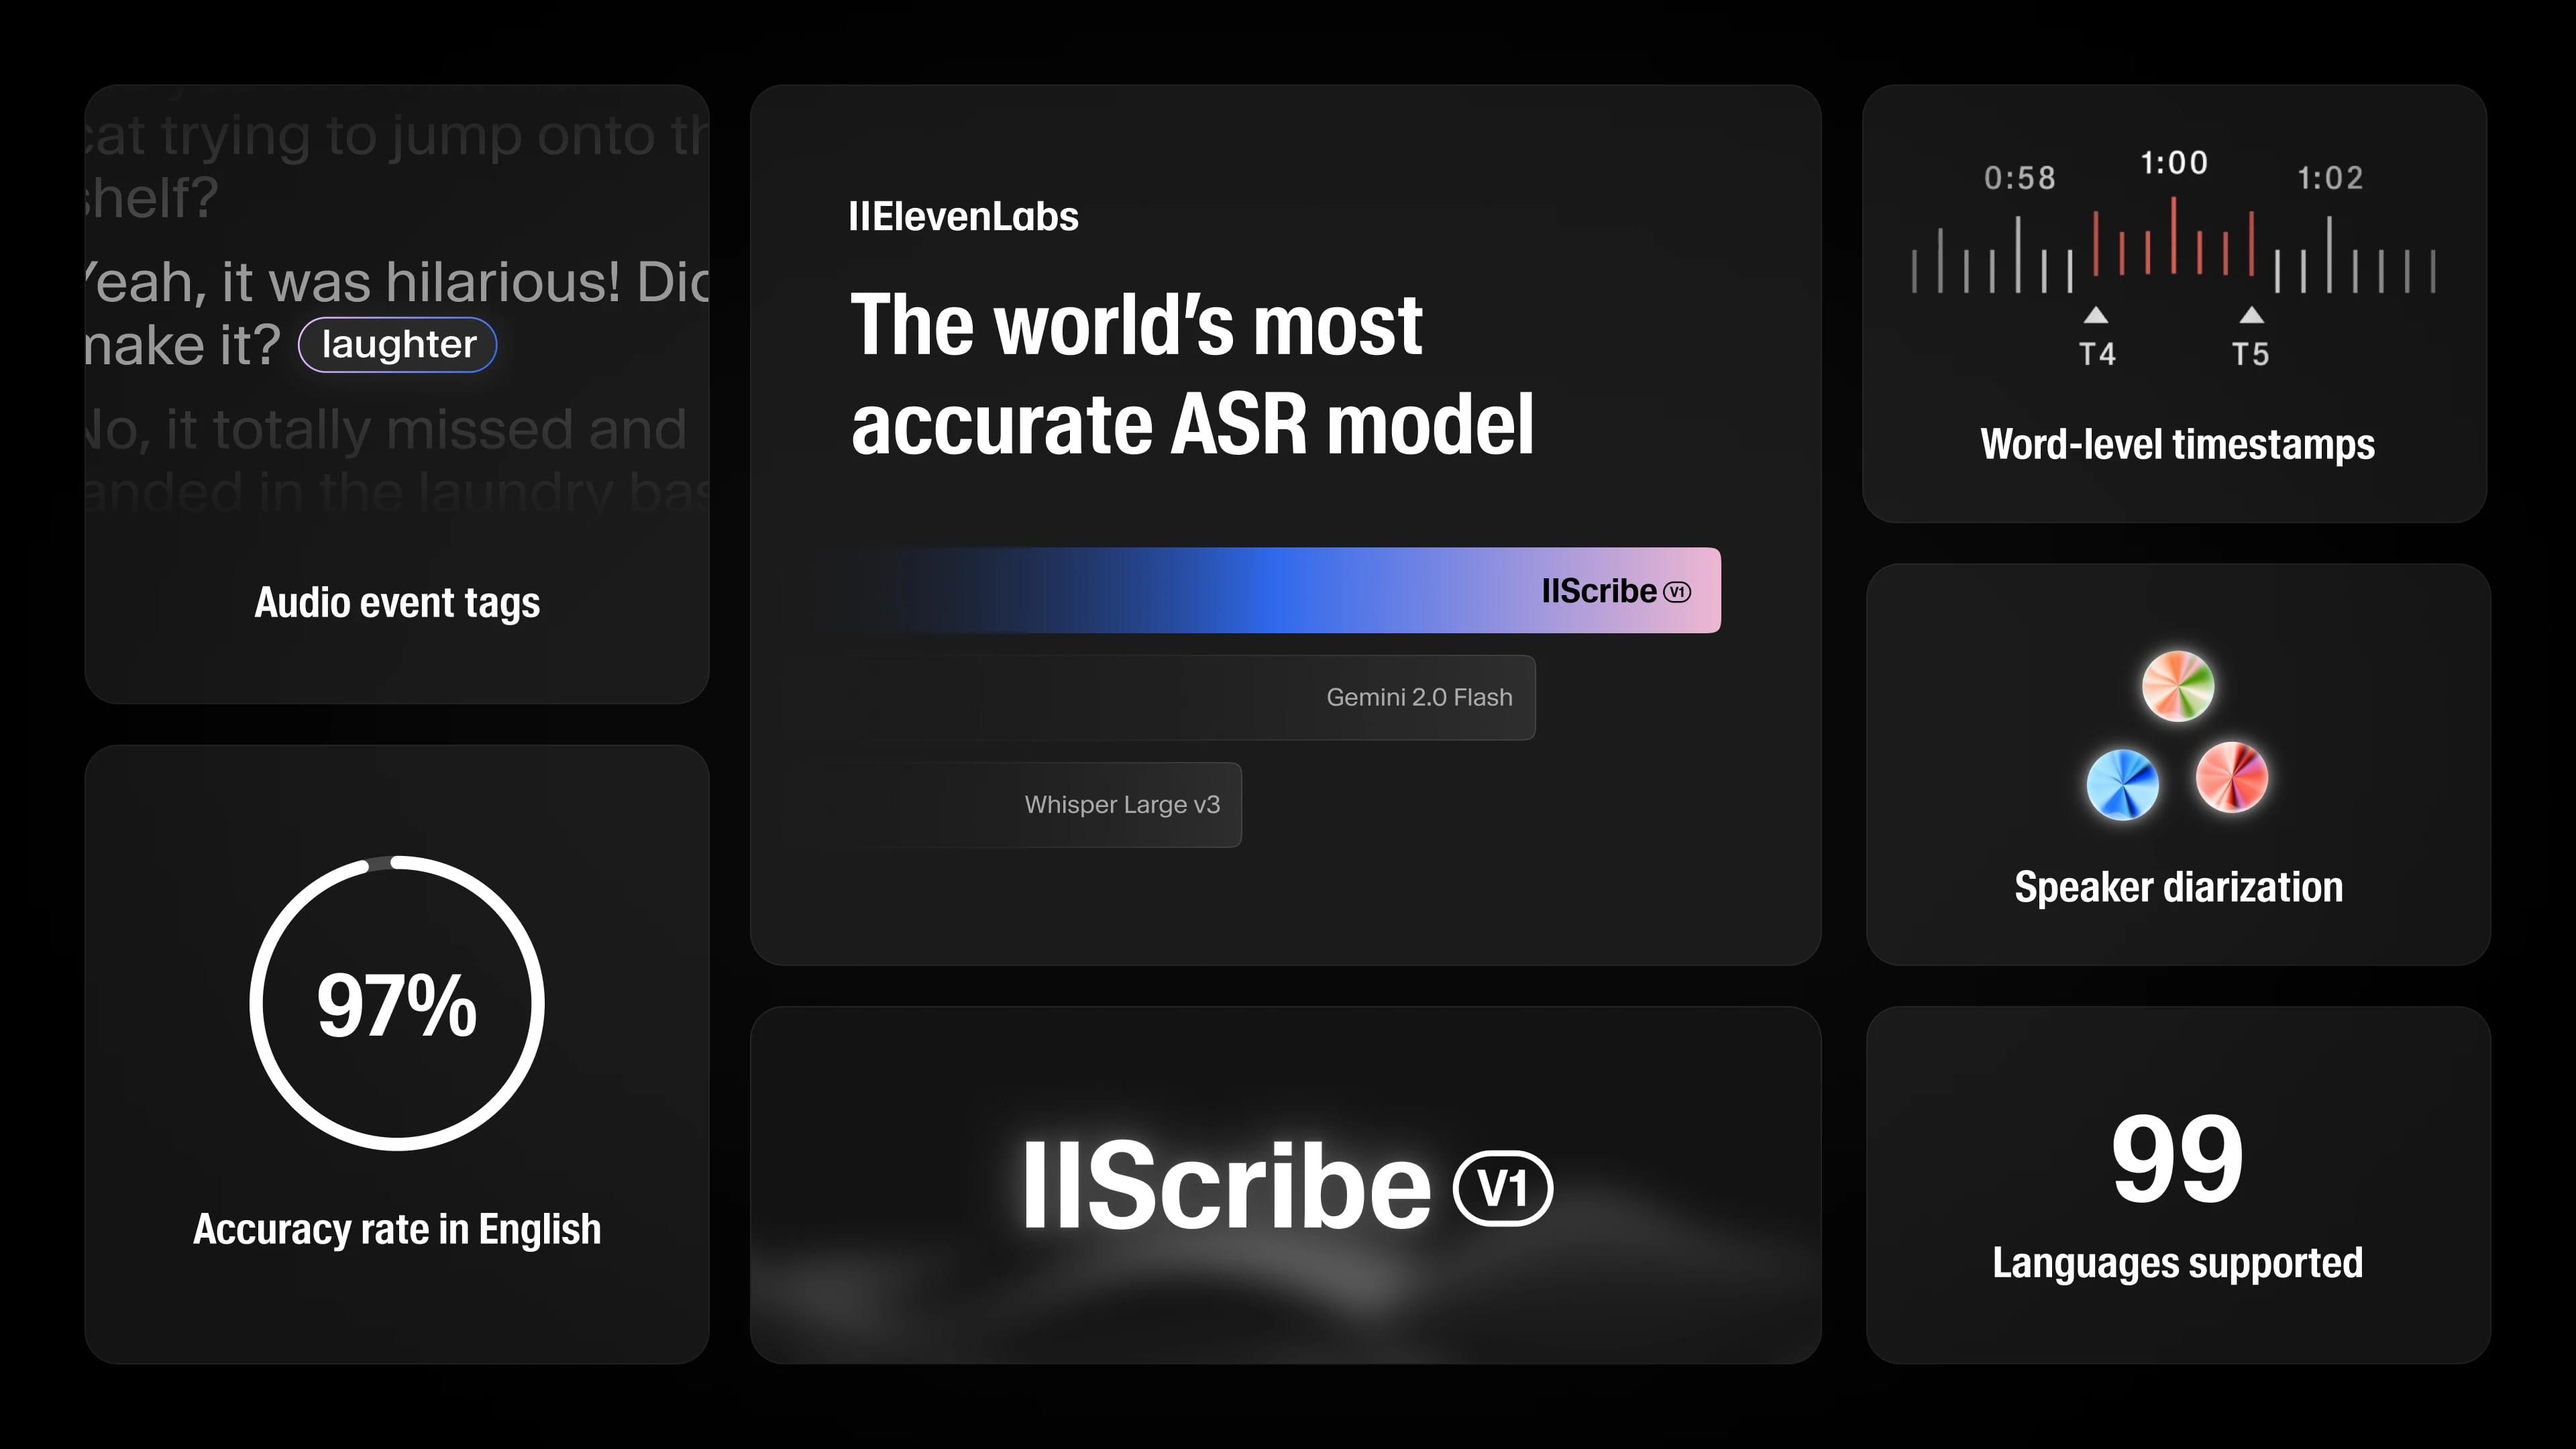
ElevenLabs 최초의 텍스트 음성 변환 모델인 Scribe는 세계에서 가장 정확한 전사 모델입니다. 실제 오디오의 예측 불가능한 특성을 처리하도록 설계된 Scribe는 99개 언어의 음성을 전사하며, 단어 단위 타임스탬프, 화자 분리, 오디오 이벤트 태깅 기능을 제공합니다. 모든 결과는 원활한 통합을 위해 구조화된 응답으로 제공됩니다.
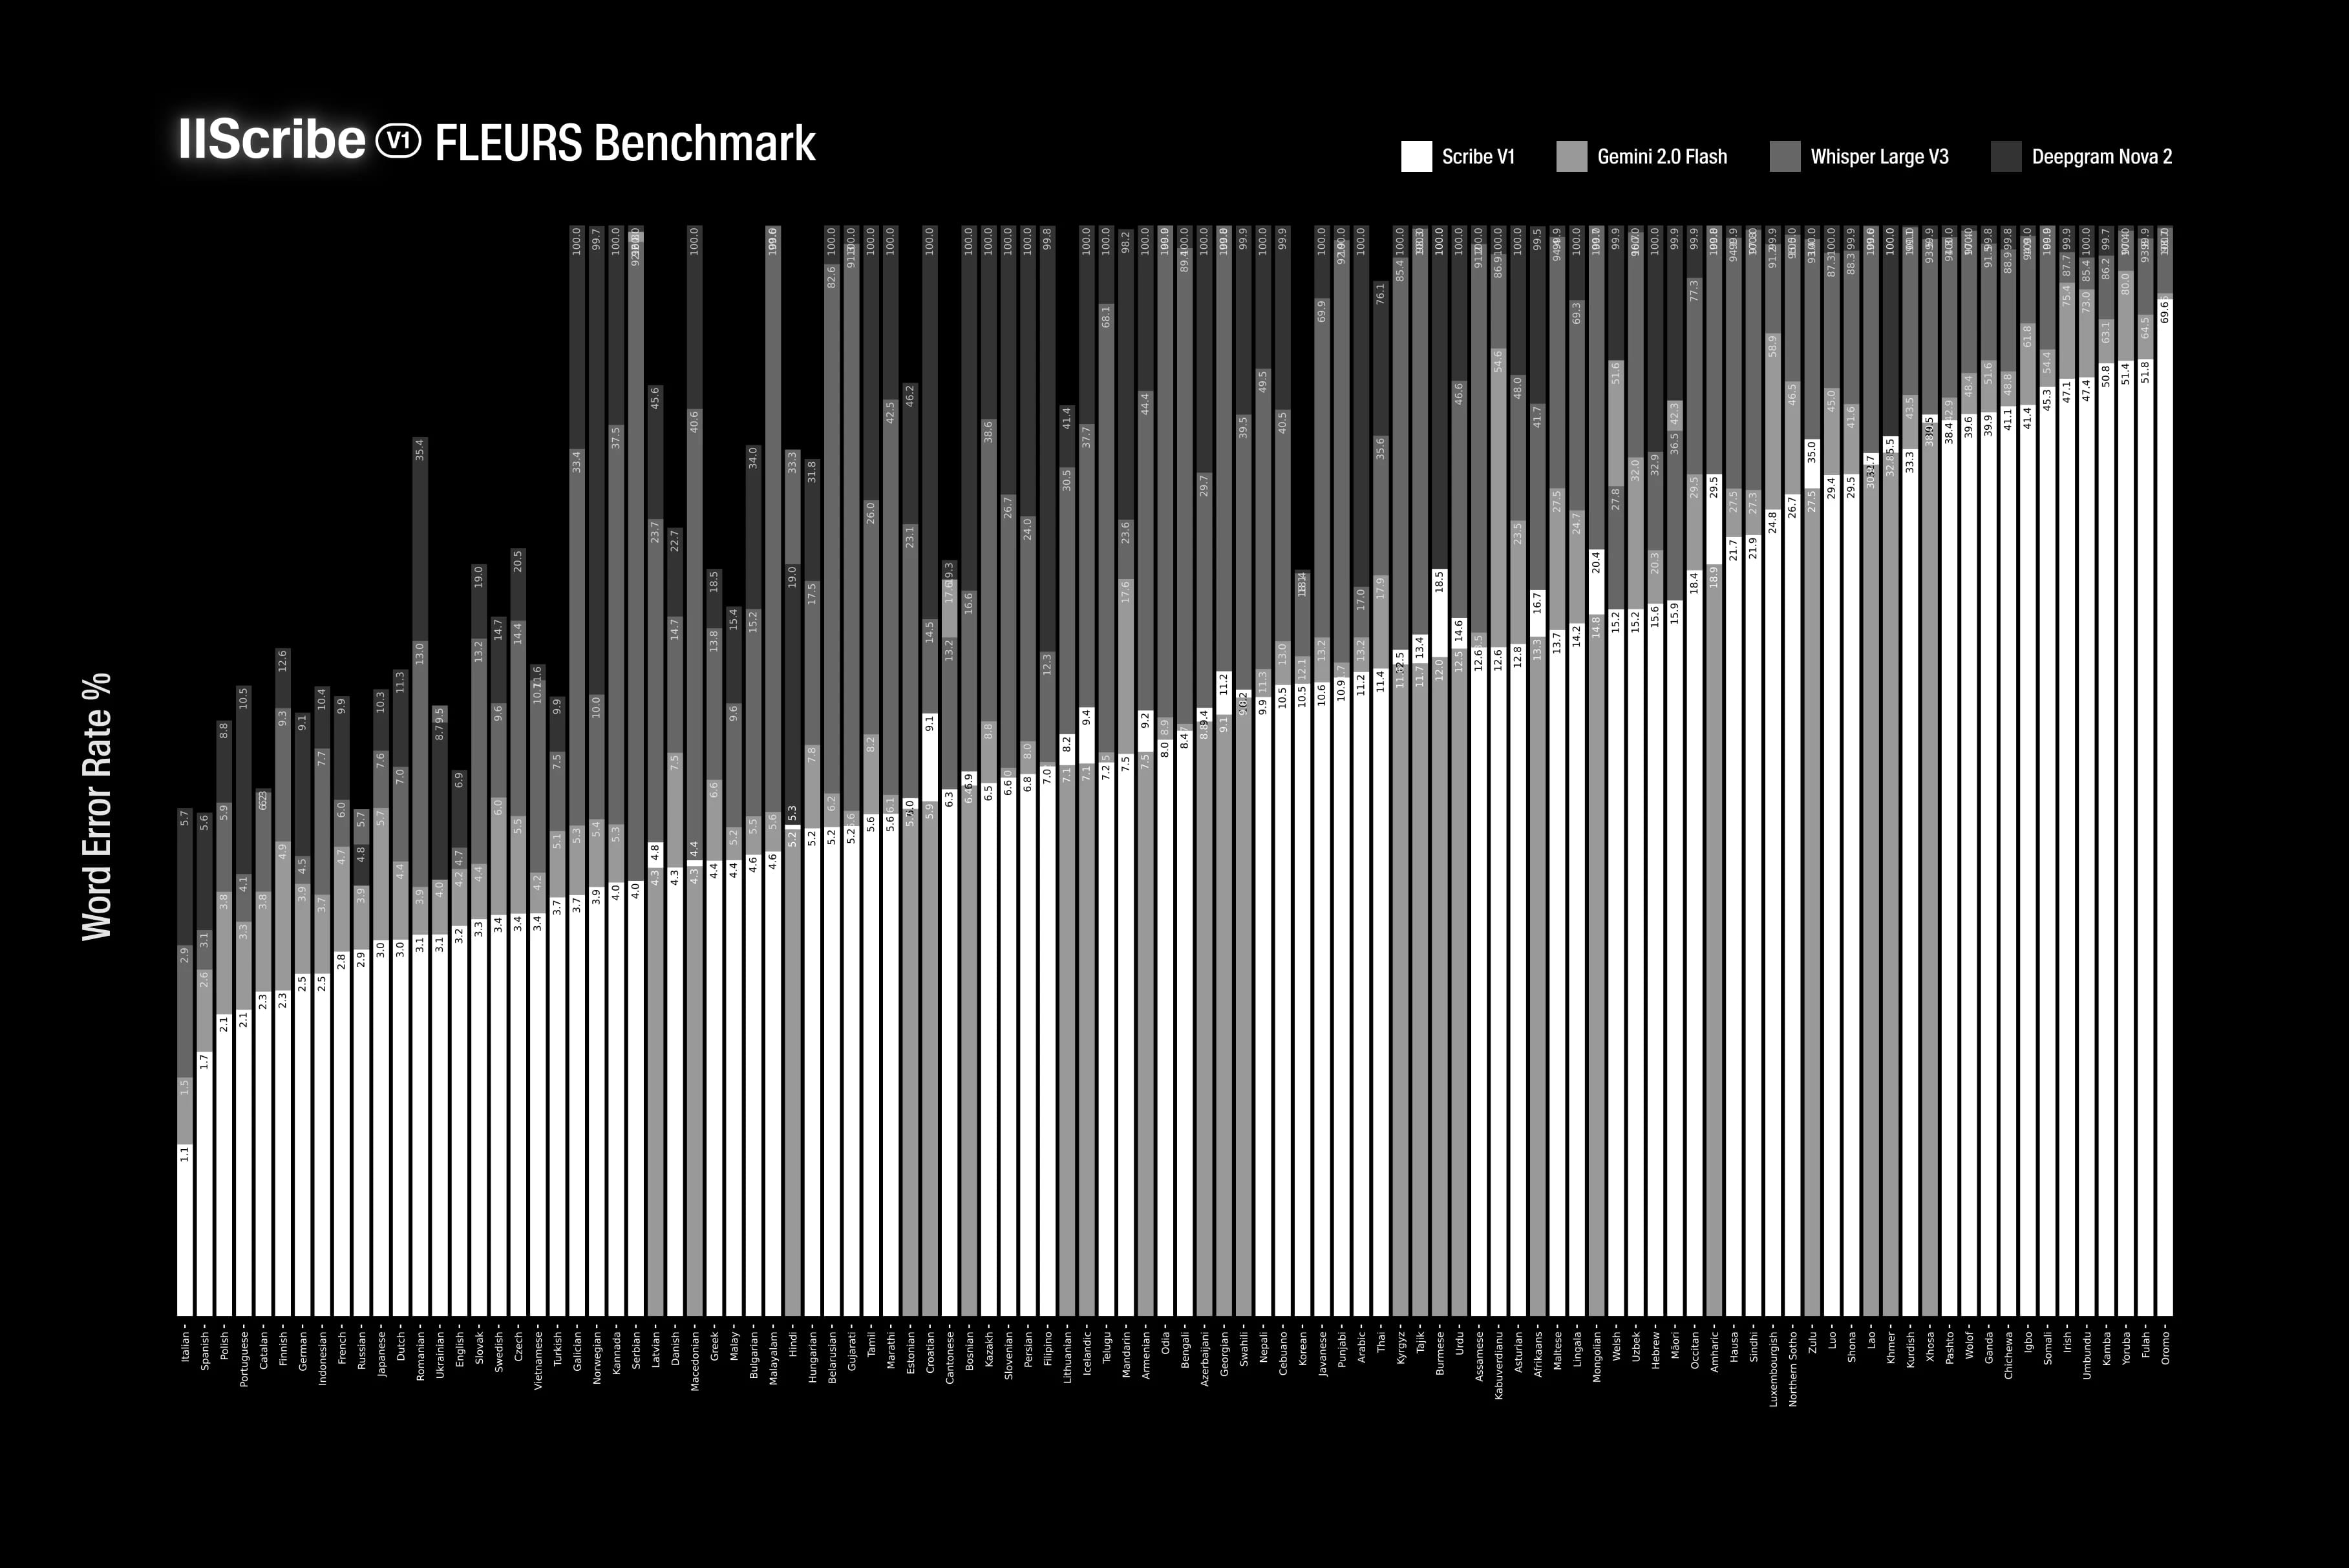
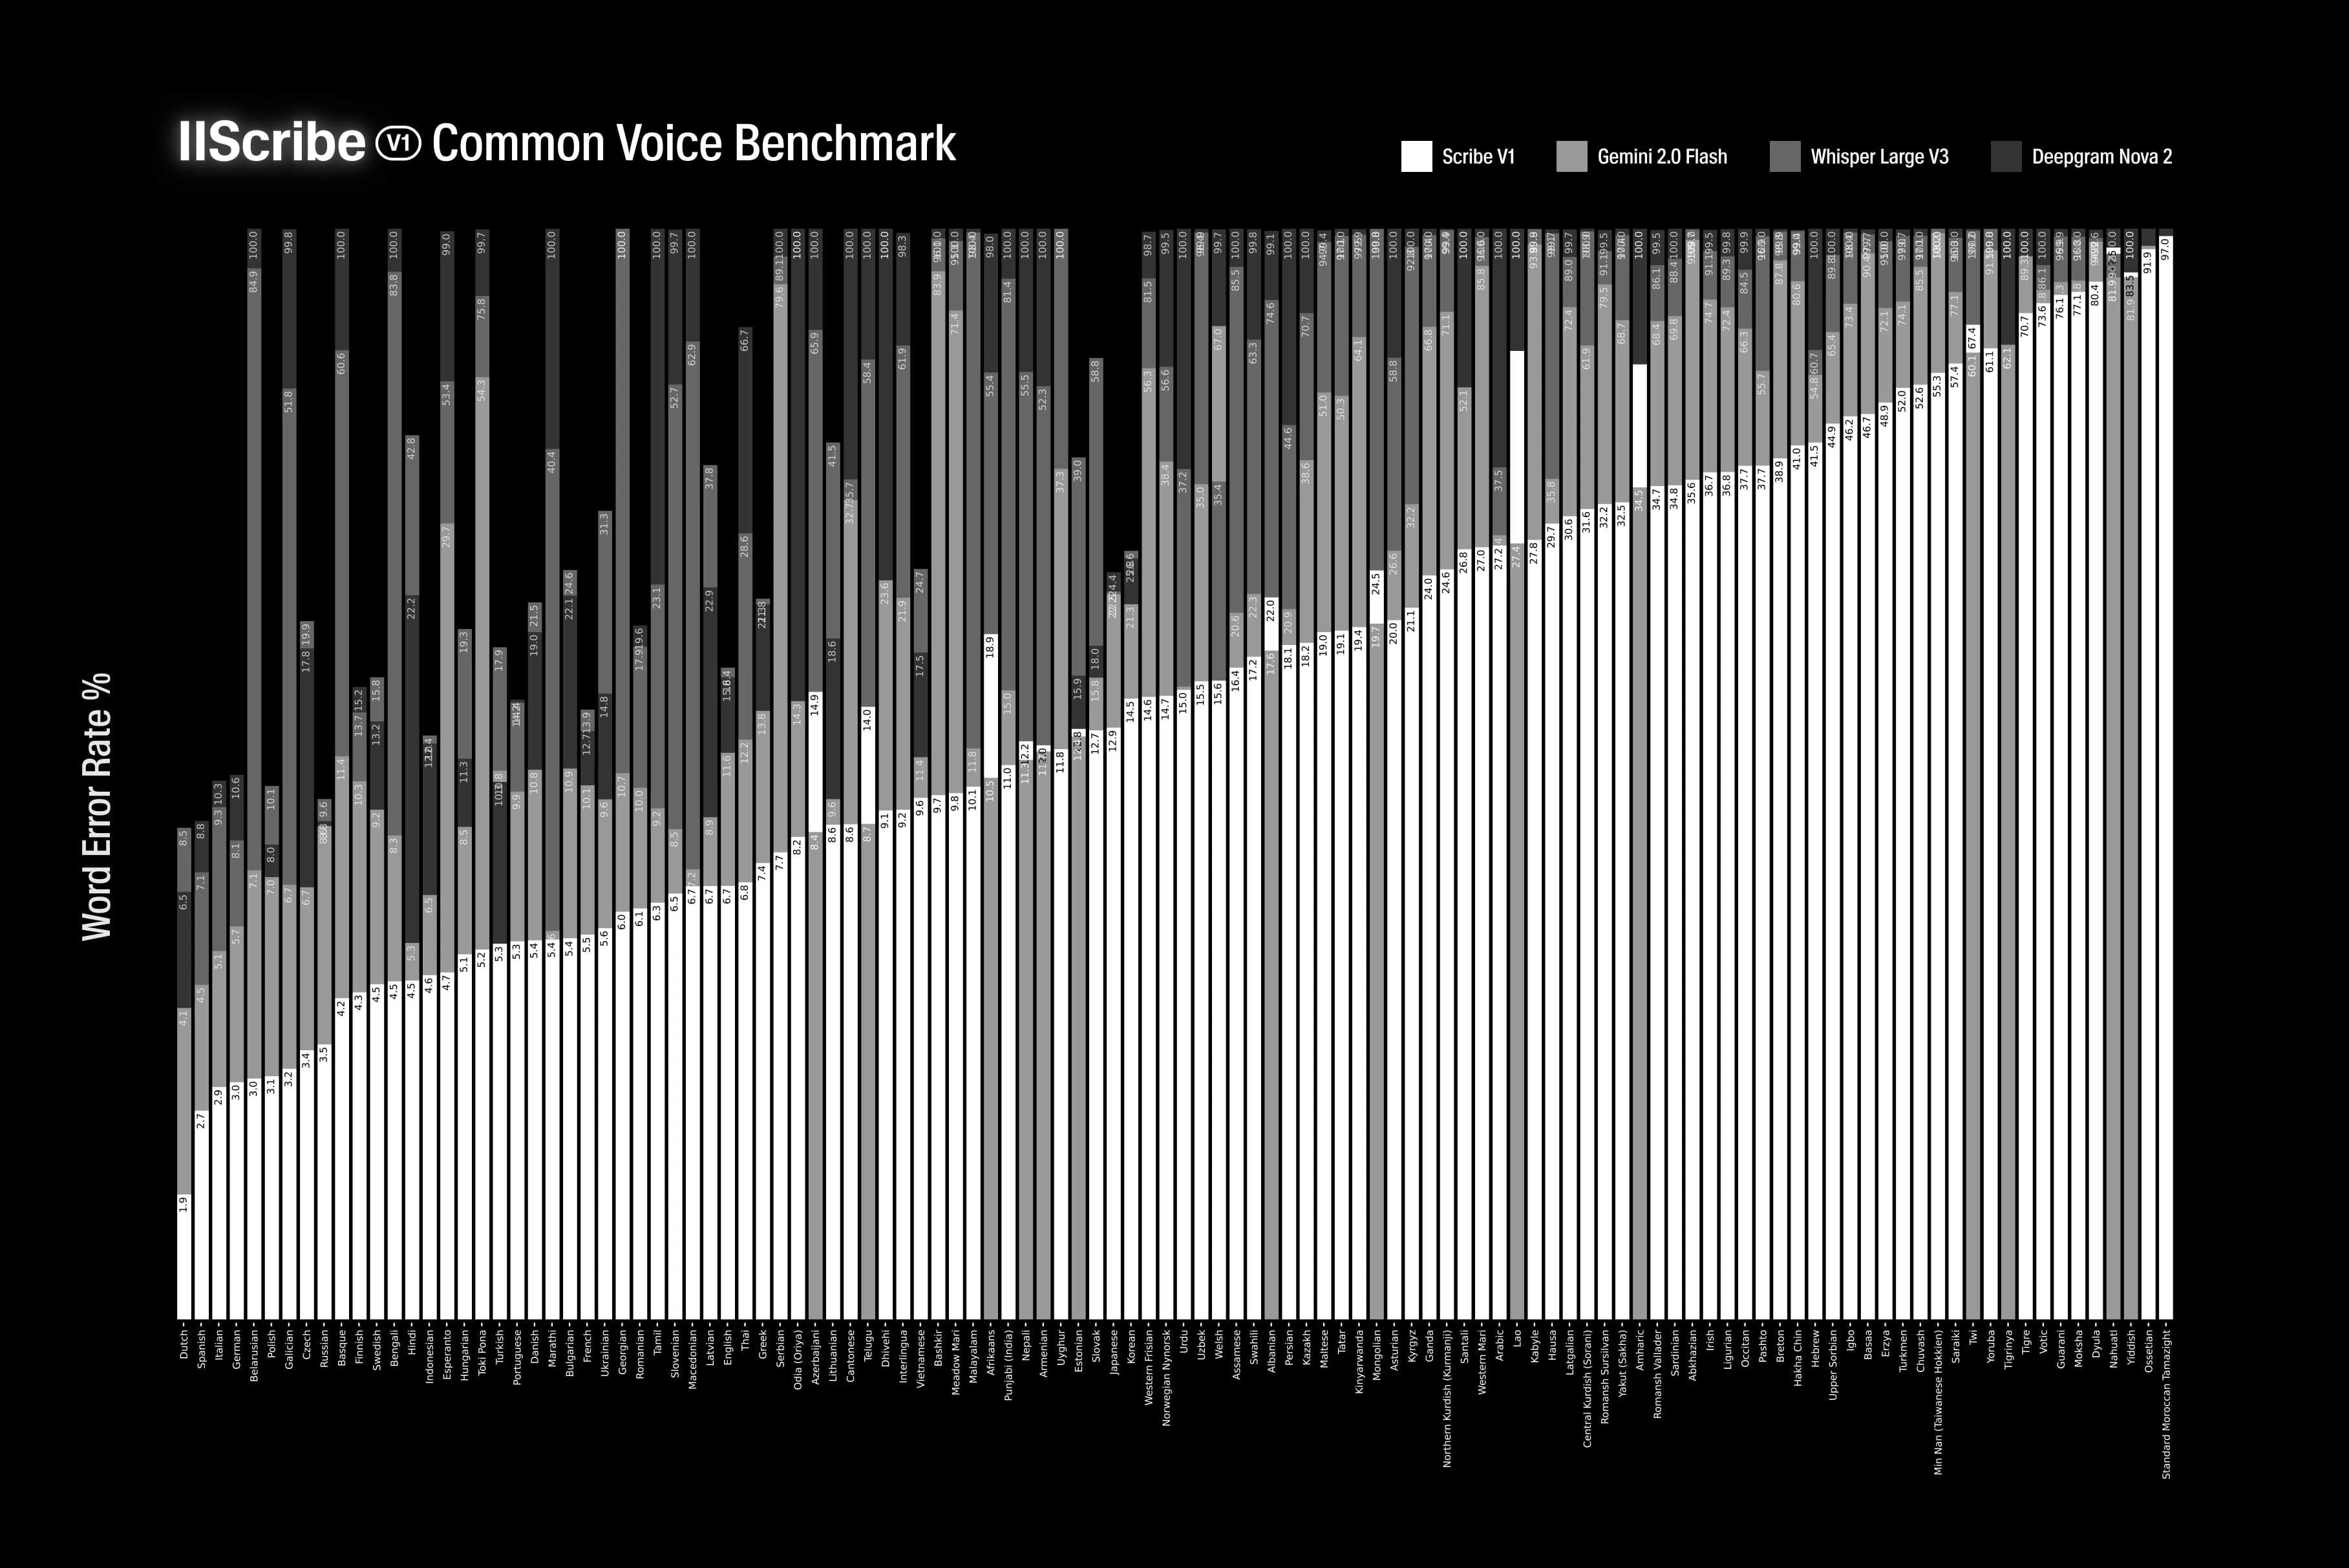
Scribe는 정밀성을 위해 설계되었습니다. 99개 언어를 대상으로 한 FLEURS 및 Common Voice 벤치마크 테스트에서 Gemini 2.0 Flash, Whisper Large V3, Deepgram Nova-3 같은 주요 모델을 꾸준히 앞섰습니다. 회의 요약, 영화 자막, 노래 가사 등 어떤 용도에서도 Scribe는 이탈리아어(98.7%), 영어(96.7%) 및 기타 97개 언어에서 가장 낮은 자동 전사 단어 오류율을 제공합니다.
Scribe는 ASR을 누구나 이용할 수 있도록 지원합니다. 경쟁 모델의 단어 오류율이 40%를 넘는 경우가 많은 세르비아어, 광둥어, 말라얄람어처럼 기존에 충분한 지원을 받지 못했던 언어의 오류를 크게 줄였습니다.
개발자는 지금 텍스트 음성 변환 API를 통해 Scribe를 통합하여 화자 분리와 단어 단위 타임스탬프, 비음성 이벤트 마커(예: 웃음)가 포함된 구조화된 JSON 전사 결과를 받을 수 있습니다. 실시간 애플리케이션을 위한 저지연 버전도 곧 출시됩니다.
크리에이터와 기업은 ElevenLabs 대시보드에서 Scribe를 직접 사용하여 오디오 또는 비디오 파일을 업로드하고 형식이 갖춰진 전사본을 생성할 수 있습니다.
Scribe로 개발을 시작하세요:
API 문서 | ElevenLabs 대시보드에서 사용해 보기
벤치마크
FLEURS - 단어 오류율 % - 102개 언어
Common Voice - 단어 오류율 % - 102개 언어
기여자
연구 총괄, 학습, 아키텍처
Flavio Schneider
프로젝트 총괄, 사전 학습 데이터, 미세 조정 데이터
Tim von Känel
추론, 최적화
Maximiliano Levi
연구 기여자
Johan Nordberg, Piotr Dabkowski
프론트엔드
Austin Malerba
백엔드
Hristo Stoychev
데이터 수집
Alex George