트랜스크립트는 각 단어가 말해진 위치를 어떻게 알까요?
- 작성자
- Mike Murphy
- 게시일
- 최종 업데이트
TV로 영화를 보다가 방송에 문제가 생겨 배우들의 대사와 자막이 완전히 어긋난 적이 있다면, 얼마나 산만하고 이야기에 몰입하기 어려운지 아실 겁니다. 음성 모델을 사용하는 비디오와 소프트웨어도 같은 문제를 겪습니다. 자막이 1초 늦게 표시되거나 트랜스크립트가 잘못된 단어를 강조하면, 마찬가지로 어색하고 망가진 것처럼 느껴질 수 있습니다.
“사람은 적어도 단어 수준에서는 미디어를 정렬하는 데 꽤 능숙합니다.” 정렬을 연구하는 ElevenLabs 연구원 다닐라 코즐로프(Danila Kozlov)는 이렇게 말합니다. “단어가 어디서 시작하는지는 대체로 감각적으로 알 수 있지만, 문자 수준에서 밀리초 미만의 정밀도로 맞추는 일은 훨씬 어렵습니다.”
오늘 ElevenLabs는 오디오 파일의 모든 문자를 정확한 타임라인에 배치하는 강제 정렬 모델 Cue를 자세히 소개합니다. Cue는 ElevenLabs의 Scribe 모델 제품군을 구동하며, 실제 녹음 환경에서 벤치마크의 29개 모든 언어에 대해 ElevenLabs가 테스트한 어떤 정렬기보다 정확합니다. 또한 길이에 상관없이 녹음을 한 번에 처리하며, 1시간 분량의 오디오를 1초 이내에 정렬합니다.
강제 정렬이란 무엇인가요?
누군가 비디오와 트랜스크립트를 건네며 각 단어를 말하는 순간에 맞춰 달라고 요청한다고 상상해 보세요. 이것이 강제 정렬입니다. ElevenLabs 트랜스크립트에서 단어를 클릭했을 때 플레이어가 정확히 그 지점으로 이동한다면, 그 작업은 정렬기가 수행하는 것입니다.
하지만 강제 정렬은 다소 모호한 개념인 AI 정렬과는 다릅니다. AI 정렬은 AI 시스템의 행동이 사람들의 가치 체계와 비즈니스 선호에 부합하도록 설계하는 일을 뜻합니다. 강제 정렬에서는 텍스트와 소리를 맞춰 정렬하는 것만을 말합니다.
Cue는 음성-텍스트 변환 파이프라인의 마지막 단계입니다. ElevenLabs의 텍스트 음성 변환 모델 Scribe가 오디오를 전사하고, 정렬기가 타이밍을 설정합니다. 모든 Scribe 요청은 이 과정을 거칩니다. 같은 모델은 자막, 더빙, 음악 가사의 타이밍에도 사용되며, 강제 정렬 API를 통해 단독으로도 이용할 수 있습니다.
많은 제품이 이에 의존하기 때문에, 정렬기는 지원되는 모든 언어에서 정확해야 하고 매우 빨라야 하며 여러 요청을 동시에 처리할 수 있어야 합니다.
기존 정렬기의 한계
새 모델 이전에는 팀이 지금까지 모든 ElevenLabs 제품에 사용된 정렬기 모델을 만들었습니다. 강력한 모델이었지만, 새 버전은 더 개선할 수 있다는 것을 알고 있었습니다. 코즐로프가 합류한 뒤, 그와 팀은 이전 정렬기를 사용할 때 불편했던 점을 고객과 ElevenLabs 내부 사용자에게 인터뷰하며 파악하기 시작했습니다. 이들의 불만은 팀이 테스트한 오픈소스 도구의 한계와 일치했습니다.
첫 번째 주요 문제는 길이입니다. 오늘날 많은 정렬기는 약 30초 길이의 클립에서는 잘 작동하지만, 더 긴 파일은 여러 청크로 나누어야 합니다. 새 청크가 추가될 때마다 작은 타이밍 오차가 생길 수 있고, 청크 사이의 경계를 이어 붙이는 과정에서 오차가 더해질 수 있습니다. 전체 녹음에서 Cue의 평균 타이밍 오차는 179밀리초에 불과한 반면, 오픈소스 도구는 283ms에서 6,000ms 이상이었습니다.
실제 환경에서 녹음된 오디오는 더욱 어렵습니다. 배경 소음, 겹치는 음성, 주변 음악 때문에 많은 도구가 텍스트와 오디오를 맞추는 과정에서 위치를 놓칩니다. 하지만 완벽하게 조용하지 않은 곳에서 생활하는 만큼, 이런 파일이야말로 많은 사람이 실제로 전사를 원하는 파일입니다. 배경 문제가 있는 영어 녹음에서 Cue의 평균 오차는 57ms였으며, 다른 도구는 65ms에서 920ms였습니다.
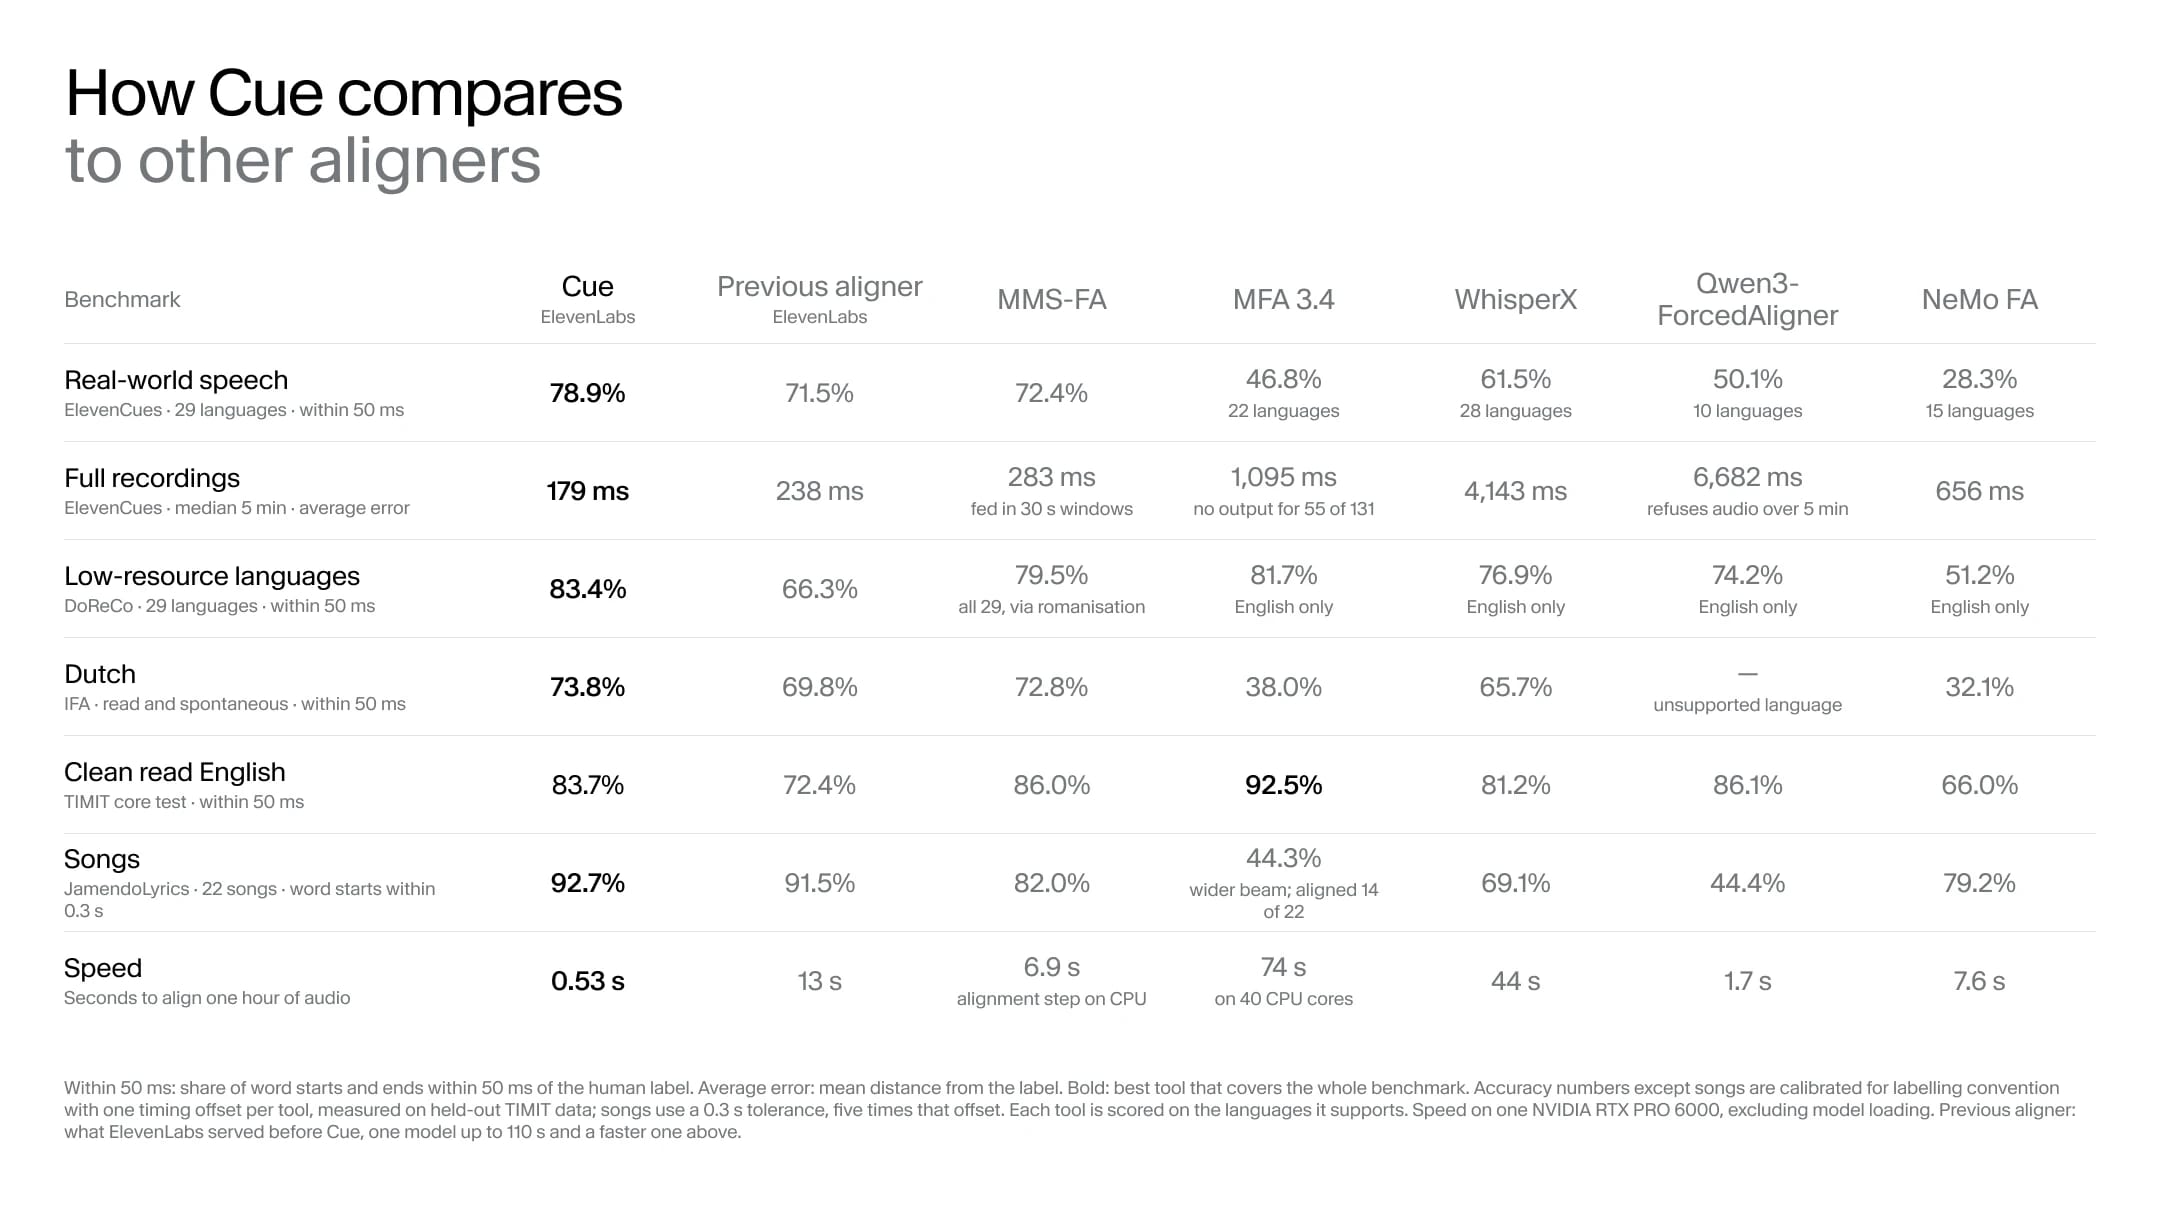
언어 지원도 또 다른 제약입니다. 대부분의 오픈소스 정렬기는 지원하는 언어마다 별도의 모델이 필요하므로, 학습 데이터가 적은 언어는 성능이 낮거나 아예 지원되지 않는 경우가 많습니다. MMS-FA는 29개 벤치마크 언어를 모두 처리하는 유일한 다른 도구이며, 비교해 보면 Cue가 단어 간 경계를 찾아내는 속도도 대체로 더 빨랐습니다.
대량의 오디오를 정렬하면 비용이 빠르게 증가할 수 있으므로, 속도 역시 이 모델들의 과제입니다. Cue는 프로덕션 GPU에서 1시간 분량의 오디오를 약 0.5초 만에 정렬할 수 있습니다. 그다음으로 빠른 도구인 Qwen3-ForcedAligner는 거의 2초가 걸리며, 테스트한 도구 중 가장 느린 도구는 1분 이상 걸렸습니다.
Cue의 차별점
Cue는 대부분의 경쟁 제품과 달리 90개 이상의 벤치마크 언어를 지원하는 단일 모델입니다. 또한 길이에 상관없이 녹음을 한 번에 처리할 수 있어, 긴 파일에서 타이밍 오차가 누적되는 원인인 청크 분할을 피할 수 있습니다.
핀치하거나 Control 키를 누른 채 스크롤하여 확대 또는 축소하세요. 가로로 스와이프하거나 Shift 키를 누른 채 스크롤하여 이동하세요. 단어에 포커스가 있을 때는 더하기와 빼기 키로 확대 또는 축소하고, Shift 키와 왼쪽 또는 오른쪽 화살표 키로 이동하세요.
단어를 선택하면 문자를 확인할 수 있습니다
대부분의 모델이 성능 향상과 함께 더 커지는 추세인 반면, Cue는 이전 ElevenLabs 정렬기보다 작다고 코즐로프는 말합니다. 여전히 GPU에서 실행되지만, 1시간 분량의 오디오를 약 0.5초 만에 정렬합니다.
팀은 사람들이 실제로 업로드하는 유형의 오디오를 중심으로 Cue를 만들었습니다. 이전 정렬기를 기준으로 실제 요청에서 벤치마크를 만들고, 도구가 배치하지 못한 모든 단어를 오류로 집계해 모든 도구를 동일한 방식으로 평가했습니다. Cue는 대부분의 벤치마크가 사용하는 단어 수준 레이블보다 더 세밀한 문자 수준에서 작동하므로, 이러한 점수는 실제 정밀도를 충분히 보여주지 못할 가능성이 높습니다.
“어느 순간 인간의 능력 수준에 도달하게 됩니다.” 코즐로프는 정렬기 모델에 대해 이렇게 말합니다. “현재 정렬기는 그 수준을 넘어섰습니다. 따라서 이를 위한 완벽한 기준 벤치마크가 없기 때문에, 완전히 정확한지 또는 얼마나 정밀한지 확인하기가 훨씬 어려워집니다. 문자 수준 시스템을 벤치마크하기 위해 단어 수준 벤치마크를 사용해야 했는데, 이는 Cue의 잠재력을 온전히 보여주지는 못합니다.”
Cue의 품질은 ElevenLabs가 사용자 피드백에 얼마나 빠르게 대응하는지도 보여줍니다. Cue 출시 직후 한 고객이 조지아어와 몇몇 저자원 언어의 성능이 기대보다 낮다고 팀에 알렸습니다. ElevenLabs는 연구를 제품을 사용하는 팀과 고객 가까이에 두고 있어, 문제를 신속히 파악하고 가능한 모델 개선 방안을 연구한 뒤 새 버전의 모델을 학습해 출시할 수 있었습니다. 고객이 처음 문제를 제기한 시점부터 24시간도 채 걸리지 않았습니다.
노래 정렬하기
노래는 단어가 늘어나고 뭉개지기 때문에 어렵고, 이를 잘 처리하는 모델은 많지 않습니다. 팀은 Cue가 이 정도로 잘 처리할 것이라고 예상하지 못했습니다. Cue는 크리에이티브 커먼즈 라이선스의 JamendoLyrics MultiLang 데이터세트에 있는 일부 곡을 정렬할 수 있었습니다. 영어, 프랑스어, 스페인어, 독일어로 이를 한 번에 처리했으며, 놀랄 만큼 정확했습니다. 레이블 기준 0.3초 이내에 단어의 92.7%를 배치했으며, 그다음으로 우수한 도구는 82.0%였습니다.
Cue의 평균 시작 오차는 0.82초로, 가장 근접한 경쟁사의 약 절반 수준이었습니다. 22곡 중 최소 19곡에서 다른 모든 도구보다 정확했습니다. 좋아하는 신곡이 출시되는 당일 가라오케에서 부를 수 있는 가능성은 매우 큽니다.
지금 Cue를 사용해 보세요
Cue는 이미 ElevenLabs의 모든 텍스트 음성 변환 전사 기능을 뒷받침하고 있습니다. 직접 사용하려면 강제 정렬 API를 사용해 보세요.
감사의 말
ElevenLabs의 정렬기 모델 개발은 회사 전반의 많은 사람 없이는 가능하지 않았을 것입니다. 팀은 공동 창립자이자 CTO인 Piotr Dąbkowski, 연구원 Danila Kozlov, Luca Lanzendörfer, Flavio Schneider, Max Levi, Tim von Känel, Angelos Perivolaropoulos를 비롯해 이전 버전과 새 버전의 모델 개발에 참여한 모든 분께 감사드립니다. 또한 데이터 운영팀의 Ani Janelidze, Forward Deployed Engineer 및 지원팀, 그리고 이 블로그의 시각화 작업을 맡은 Lorenzo Dossi에게도 감사드립니다.
Mike Murphy는 ElevenLabs 블로그의 수석 에디터이자 작가로, 복잡한 연구와 기술을 명확하고 흥미로운 이야기로 풀어냅니다. ElevenLabs에 합류하기 전에는 Quartz를 비롯한 여러 매체에서 기술 기자로 오랫동안 활동했으며, IBM Research에서 콘텐츠를 총괄했습니다. 노스웨스턴대학교에서 저널리즘 석사 학위를 받았습니다.