가장 감정 표현력이 뛰어난 모델, Eleven v4 소개
- 게시일
- 최종 업데이트
듣기이 글 오디오로 듣기
텍스트 한 줄도 어떻게 말하느냐에 따라 크게 달라질 수 있습니다. “진정하셔야 합니다”라는 말은 겁에 질린 환자에게 부드럽게 전하는 의사인지, 전장에 투입되기 전 분대원들에게 외치는 게임 속 캐릭터인지에 따라 다르게 들려야 합니다.
오늘 ElevenLabs는 Eleven v4와 가장 낮은 지연 시간을 제공하는 변형 모델 Eleven v4 Turbo를 출시합니다. Eleven v4는 지금까지 가장 풍부한 감정을 표현하는 텍스트 음성 변환 모델입니다.
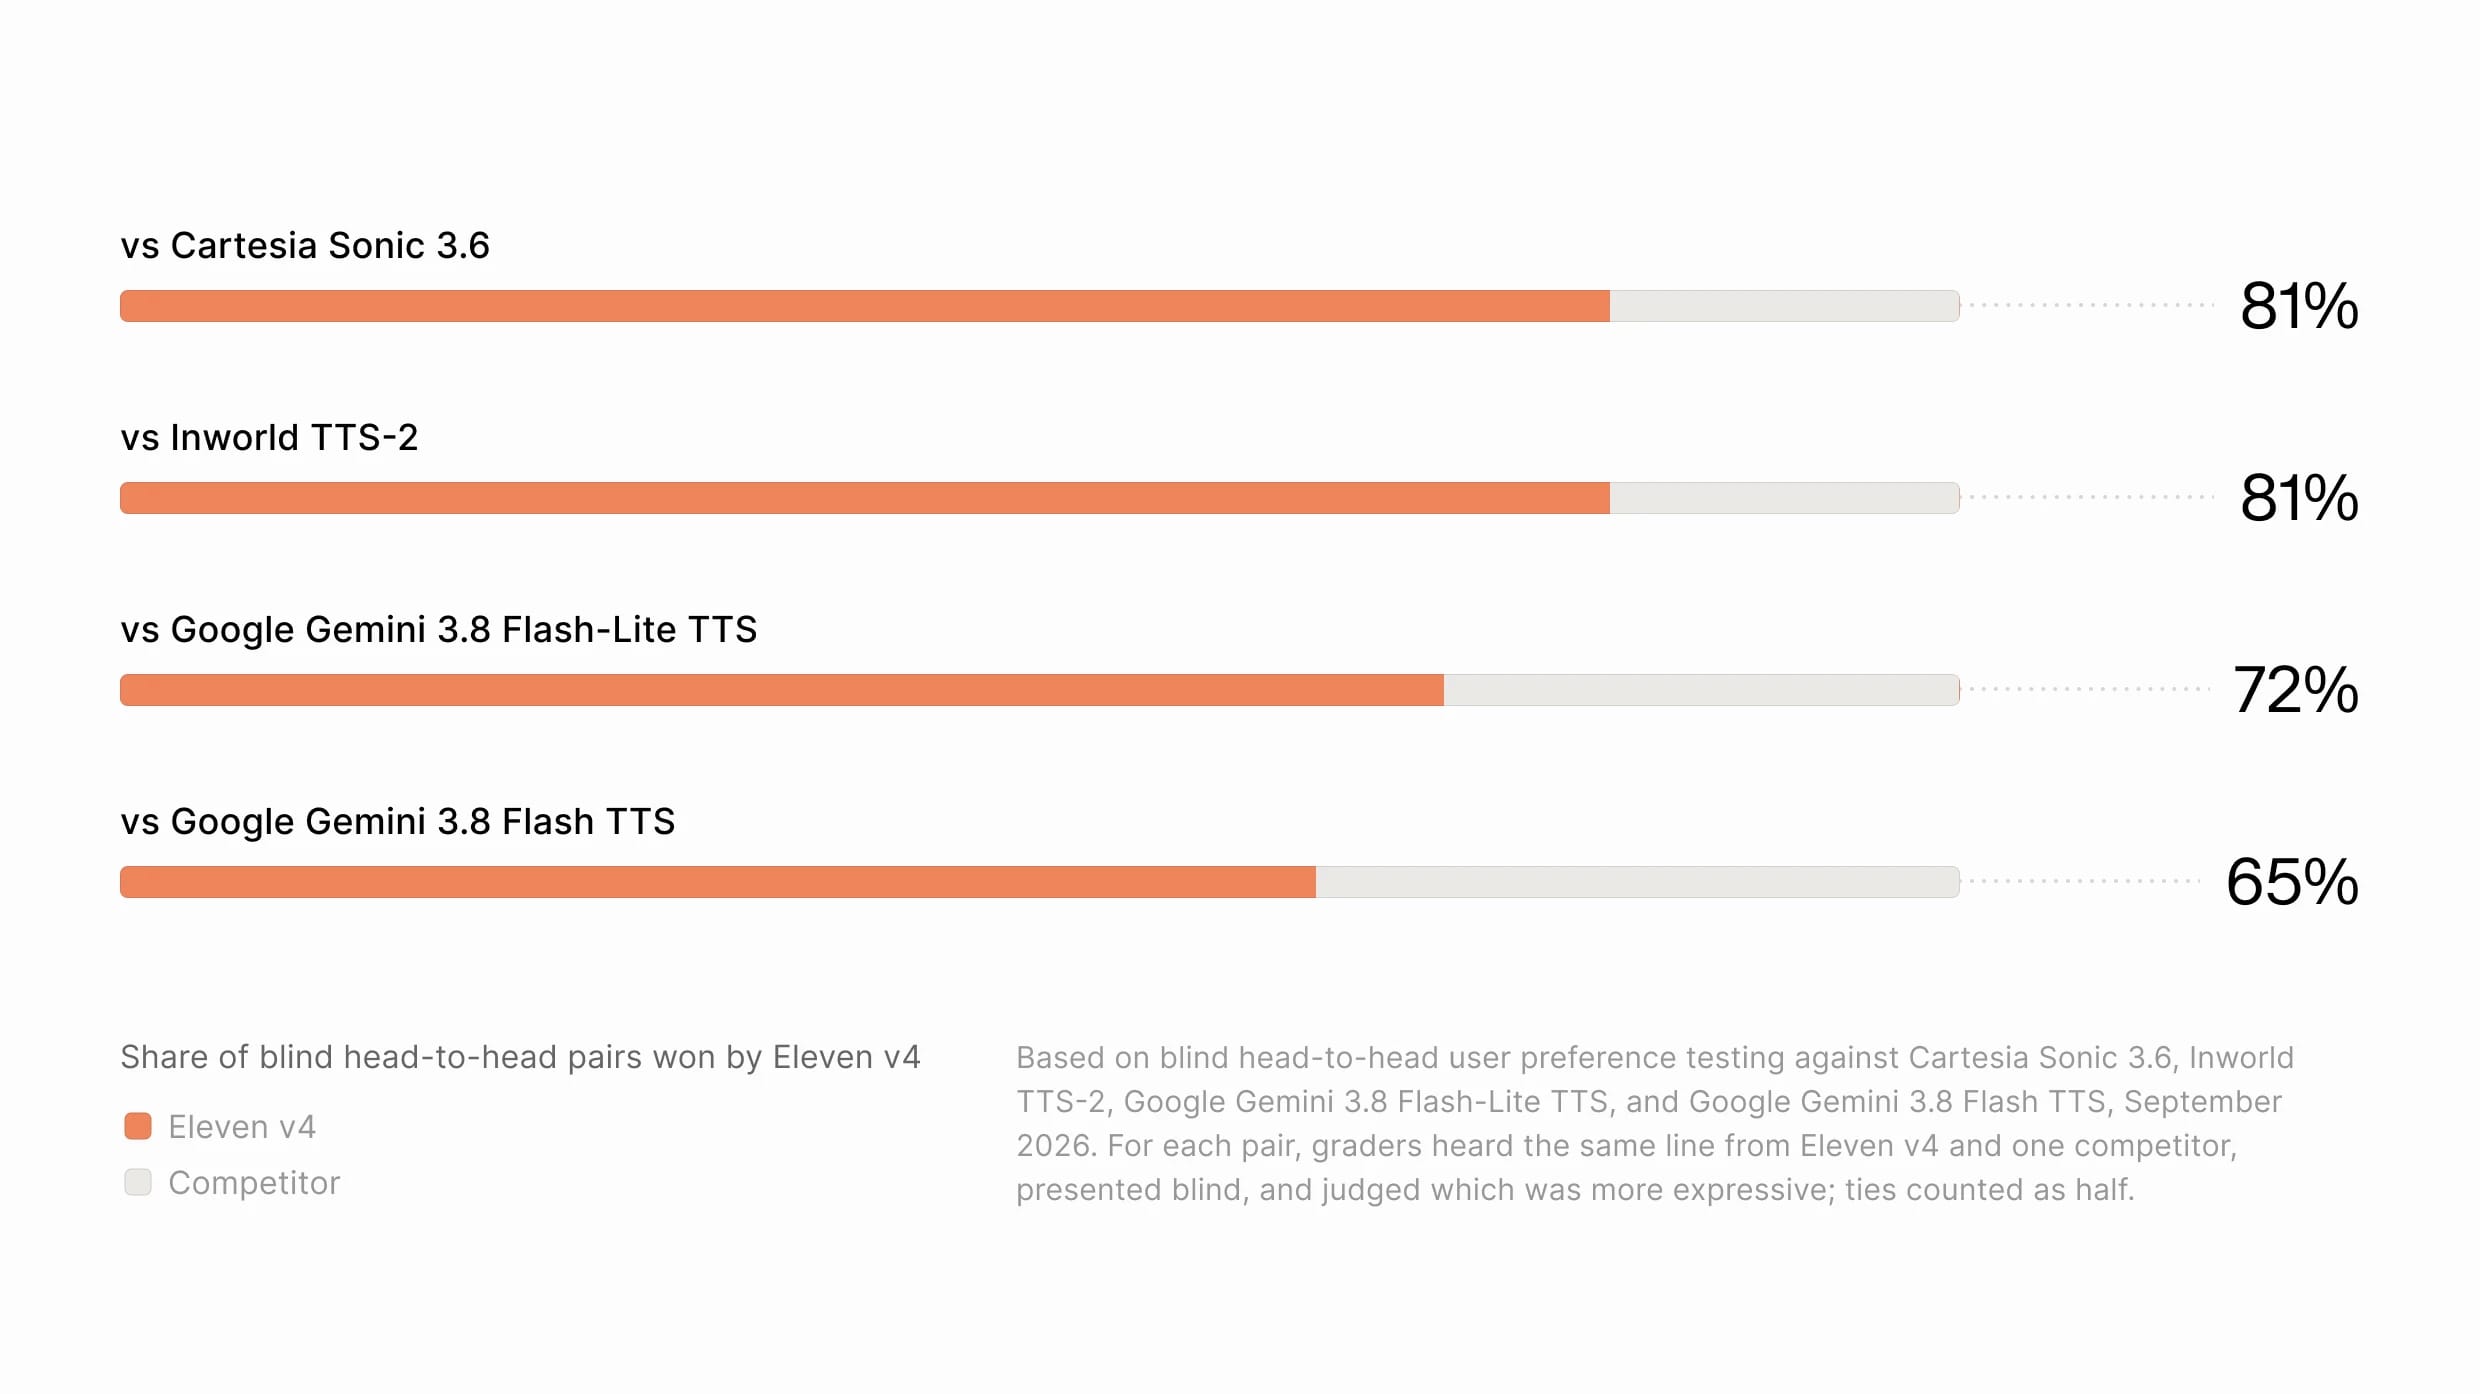
Artificial Analysis에서 1위를 차지했으며1 경쟁 모델과의 블라인드 일대일 테스트에서 약 75%의 청취자가 선호한2 Eleven v4는 어조, 속도, 감정, 캐릭터, 맥락을 해석하도록 설계되었습니다. 화자의 정체성을 유지하면서도 극적이거나 다정하고, 긴박하거나 코믹하며, 자연스러운 대화처럼 들리는 음성을 생성합니다. 더 자연스러운 다화자 상호작용 덕분에 대화가 각각의 문장을 이어 붙인 듯하지 않고 즉각적으로 반응하는 것처럼 느껴집니다. 화자는 대화의 맥락에 반응해 더 자연스러운 대화와 캐릭터 간 상호작용을 만들어 냅니다.
성능을 위해 설계된 새로운 아키텍처
완전히 새로운 아키텍처를 기반으로 구축된 Eleven v4는 Artificial Analysis에서 1위를 차지한텍스트 음성 변환 모델입니다1. Eleven v4 Turbo는 이와 동일한 기술을 에이전트와 같은 저지연 사용 사례에 제공합니다. 추론 지연 시간 중앙값은 약 100ms로, 두 사람이 대화할 때의 평균적인 휴지 시간보다 빠르게 응답할 수 있습니다.
두 모델 모두 기계적이기보다 감정이 느껴지는 음성을 생성할 수 있습니다. 전반적인 오디오 충실도도 높아져 더 깨끗하고 자연스러운 결과물을 제공합니다.
이전 세대의 텍스트 음성 변환 모델도 텍스트를 소리 내어 읽을 수는 있었지만, Eleven v4는 훨씬 더 자연스럽게 느껴지는 감정적 깊이를 음성에 더합니다. 모델은 의도한 어조와 말의 속도, 글의 특성, 텍스트의 맥락을 해석해 감정적으로 공감되는 음성을 제공합니다.
사용자는 출력 결과를 세밀하게 제어하고, 문장을 어떻게 전달할지 자연어로 설명할 수 있습니다. 특정 구절을 말하는 방법이나 전달해야 할 감정, 심지어 음향 효과까지 구체적으로 지시할 수 있습니다. [laughs], [said angrily in French accent], [light rain], [phone buzzing]와 같은 인라인 태그를 사용하면 됩니다. Eleven v4는 이전 모델보다 이러한 오디오 태그와 연출 프롬프트를 더 정확히 따르므로, 설명한 방식 그대로 전달됩니다. 덕분에 내레이션을 연출하고, 캐릭터와 대사를 구체화하는 등 전달 방식이 중요한 모든 작업이 더 쉬워집니다.
ElevenLabs 개발자 문서에서 전체 태그 구문과 API를 통해 태그를 적용하는 방법을 확인할 수 있습니다. 국제 음성 기호(IPA) 음소 지원도 크게 개선되어 맞춤 발음이 더욱 안정적으로 작동합니다.
Eleven v4는 여러 화자 간의 일관성과 역동적인 대화도 개선했습니다. 화자의 정체성을 포착하는 새로운 방식을 통해 Eleven v4는 각 음성의 고유한 특성을 보존합니다. 에이전트 대화, 오디오북 또는 광고 전반에서 음성의 일관성을 유지할 수 있습니다. 모델은 장면 전체의 맥락을 이해하기 때문에, 고립된 문장을 이어 붙이는 대신 방금 들은 말에 화자가 반응하는 자연스러운 대화를 생성합니다.
저지연 사용 사례를 위한 Turbo 모델
고품질 음성 모델은 음성 생성 속도가 느린 경향이 있어, 사용자는 빠른 음성 에이전트와 표현력이 풍부한 음성 에이전트 중 하나를 선택해야 했습니다. 많은 사용자가 능숙하지만 단조로운 에이전트를 선택했고, 이는 문제를 해결하려는 당황한 고객에게 로봇처럼 느껴질 수 있습니다.
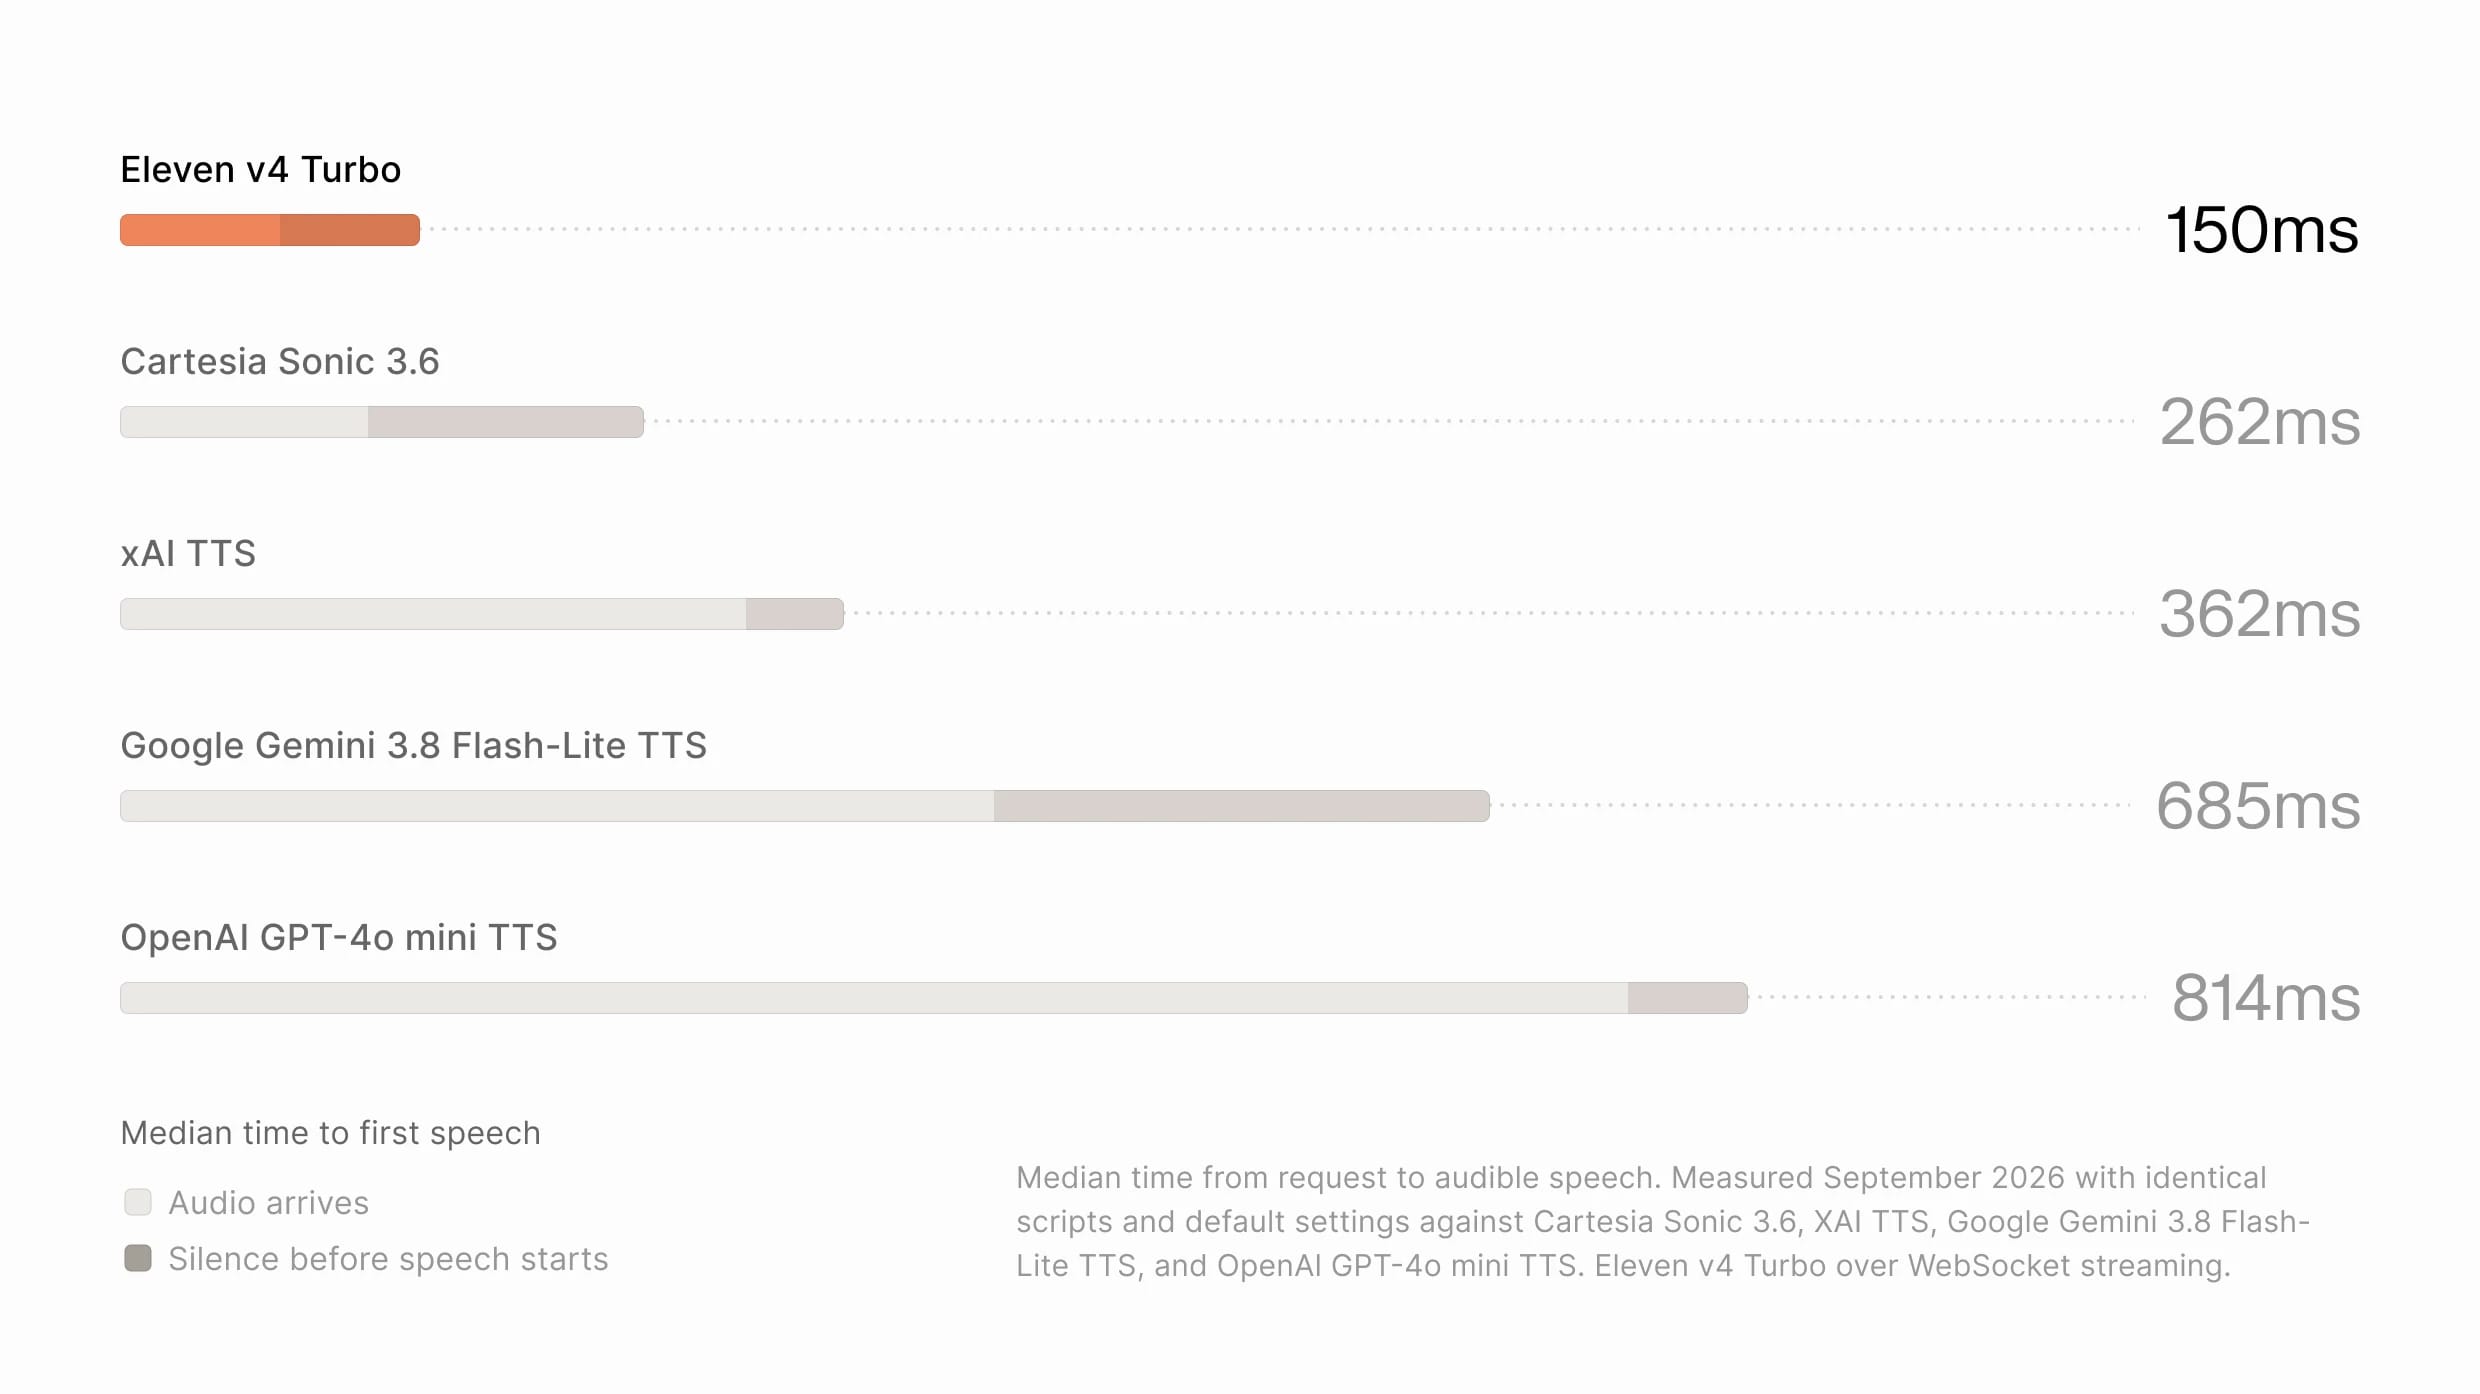
Eleven v4 Turbo는 첫 음성 출력까지 걸리는 시간의 중앙값이 약 150ms3로, 속도와 감정을 모두 갖췄습니다. 의료 분야에서 의학 용어를 정확히 발음하는 따뜻하고 안심시키는 에이전트부터, 게임에서 플레이어를 즐겁게 하는 빠른 말투와 슬랭을 구사하는 에이전트까지 수많은 산업에 강력한 에이전트를 배포할 수 있습니다.
Eleven v4 Turbo 모델은 ElevenLabs의 대화형 에이전트 플랫폼 ElevenAgents와 함께 작동하도록 구축되었습니다. 다른 에이전트 빌더는 서로 다른 공급업체의 모델과 소프트웨어를 조합하기 때문에, 사용자는 각자의 사용 사례에 맞게 모델 출력을 조정하거나 개선할 방법이 없습니다. ElevenLabs의 연구 및 엔지니어링 팀은 Eleven v4 Turbo와 ElevenAgents를 하나의 시스템으로 함께 최적화하여, 더 풍부한 표현력과 안정성, 낮은 지연 시간을 갖춘 에이전트를 제공합니다.
하나의 목소리, 수많은 언어
소통 방식은 맥락, 장소, 심지어 하루 중 시간에 따라 달라집니다. 이를 반영하는 표현력 있는 음성을 여러 언어로 구현하는 일은 여전히 AI 오디오 분야에서 가장 어려운 과제 중 하나입니다.
Eleven v4는 이 모든 영역에서 한 단계 더 발전했으며, 개선점은 단순히 모델이 구절을 발음하는 방식에만 그치지 않습니다. Eleven v4는 언어 전반에서 리듬, 감정, 전달 방식을 더 잘 포착해 크리에이터가 언어와 맥락에 자연스럽게 어울리는 음성을 만들 수 있도록 돕습니다. 예를 들어, 일본에서 처음 만난 고령자에게 말하는 방식은 이탈리아에서 그렇게 말하는 방식과 크게 다릅니다.
Eleven v4와 Eleven v4 Turbo는 모두 90개 이상의 언어를 지원합니다. 이제 한 언어로 녹음된 음성도 원래 화자의 정체성을 유지하면서 원어민 억양을 구사해 다른 모든 언어를 유창하게 말합니다. 억양 유지 성능도 이전보다 눈에 띄게 강화되어, 생성이 진행되는 동안 음성이 원래 언어의 억양으로 되돌아가지 않습니다.
카탈루냐어
스페인어
더빙과 현지화의 경우, 이는 함께 작업하는 유명 배우의 목소리든 회사 스타일에 가장 잘 맞는 톤이든, 선택한 브랜드의 목소리가 Eleven v4가 지원하는 모든 언어에서 훌륭하게 들린다는 의미입니다.
더욱 사실적이고 일관된 음성 복제
Eleven v4와 Eleven v4 Turbo의 음성 복제는 더욱 사실적이고 강력하며 일관성이 높아졌고, 원본 소스 음성과의 화자 유사도도 크게 향상되었습니다. 이제 즉석 음성 복제는 단 10초의 오디오만으로도 높은 충실도로 음성을 포착할 수 있습니다.
실제 음성
Eleven v4
Eleven v4는 생성 결과, 대화, 내레이션, 재생성된 문장 전반에서 화자의 정체성을 더욱 안정적으로 보존합니다. 즉, 장편 프로젝트에서도 캐릭터, 내레이터, 복제된 음성이 제작물 전체에서 일관되게 유지됩니다. Eleven v4는 최고 충실도의 복제가 필요한 사용 사례를 위해 프로페셔널 음성 복제(PVC)도 지원합니다.
장편 콘텐츠를 위해 생성 결과를 연결하는 요청 연결 기능도 Eleven v4에서 크게 안정화되어 ElevenLabs Studio와 ElevenLabs Reader App 작업 경험을 개선합니다.
직접 차이를 들어 보세요
Eleven v4와 Eleven v4 Turbo는 표현력 있는 음성 생성에 관한 최신 연구의 결실입니다. 오디오북, 캐릭터 연기, 보이스오버, 더빙, 대화형 에이전트 현지화 등 말 자체만큼 전달 방식이 중요한 콘텐츠를 위해 설계되었습니다.
두 모델은 지금 ElevenAgents, ElevenCreative 및 ElevenAPI에서 이용할 수 있습니다. 무료 계정 만들기를 통해 지금 Eleven v4 또는 Eleven v4 Turbo로 생성을 시작하세요.
- Artificial Analysis, Provider Voice Arena Leaderboard, 2026년 9월
- 2026년 9월 Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS, Google Gemini 3.8 Flash TTS를 대상으로 실시한 블라인드 일대일 사용자 선호도 테스트에 기반합니다. 각 쌍에서 평가자는 Eleven v4와 경쟁 모델 하나가 동일한 문장을 읽는 음성을 블라인드 방식으로 듣고, 어느 쪽이 더 표현력이 풍부하고 더 자연스럽게 들리는지 평가했습니다. 동점은 0.5점으로 계산했습니다.
- 요청부터 들을 수 있는 음성이 출력될 때까지의 중앙값입니다. 2026년 9월, 동일한 스크립트와 기본 설정으로 Cartesia Sonic 3.6, xAI TTS, Google Gemini 3.8 Flash-Lite TTS, OpenAI GPT-4o mini TTS를 대상으로 측정했으며, 모든 시스템에서 네트워크 지연 시간은 측정 후 제외했습니다. Eleven v4 Turbo는 WebSocket 스트리밍으로 측정했습니다.
Mati is the cofounder of ElevenLabs, where he leads teams building AI that can communicate at human level. Before ElevenLabs, Mati worked at Palantir where he embedded with enterprises and governments to help them deploy new technology. He grew up in Poland, before moving to the UK to study Mathematics at Imperial College London.