Audio Tags란 무엇인가요? 감성 TTS 완벽 가이드
- 게시일
- 최종 업데이트
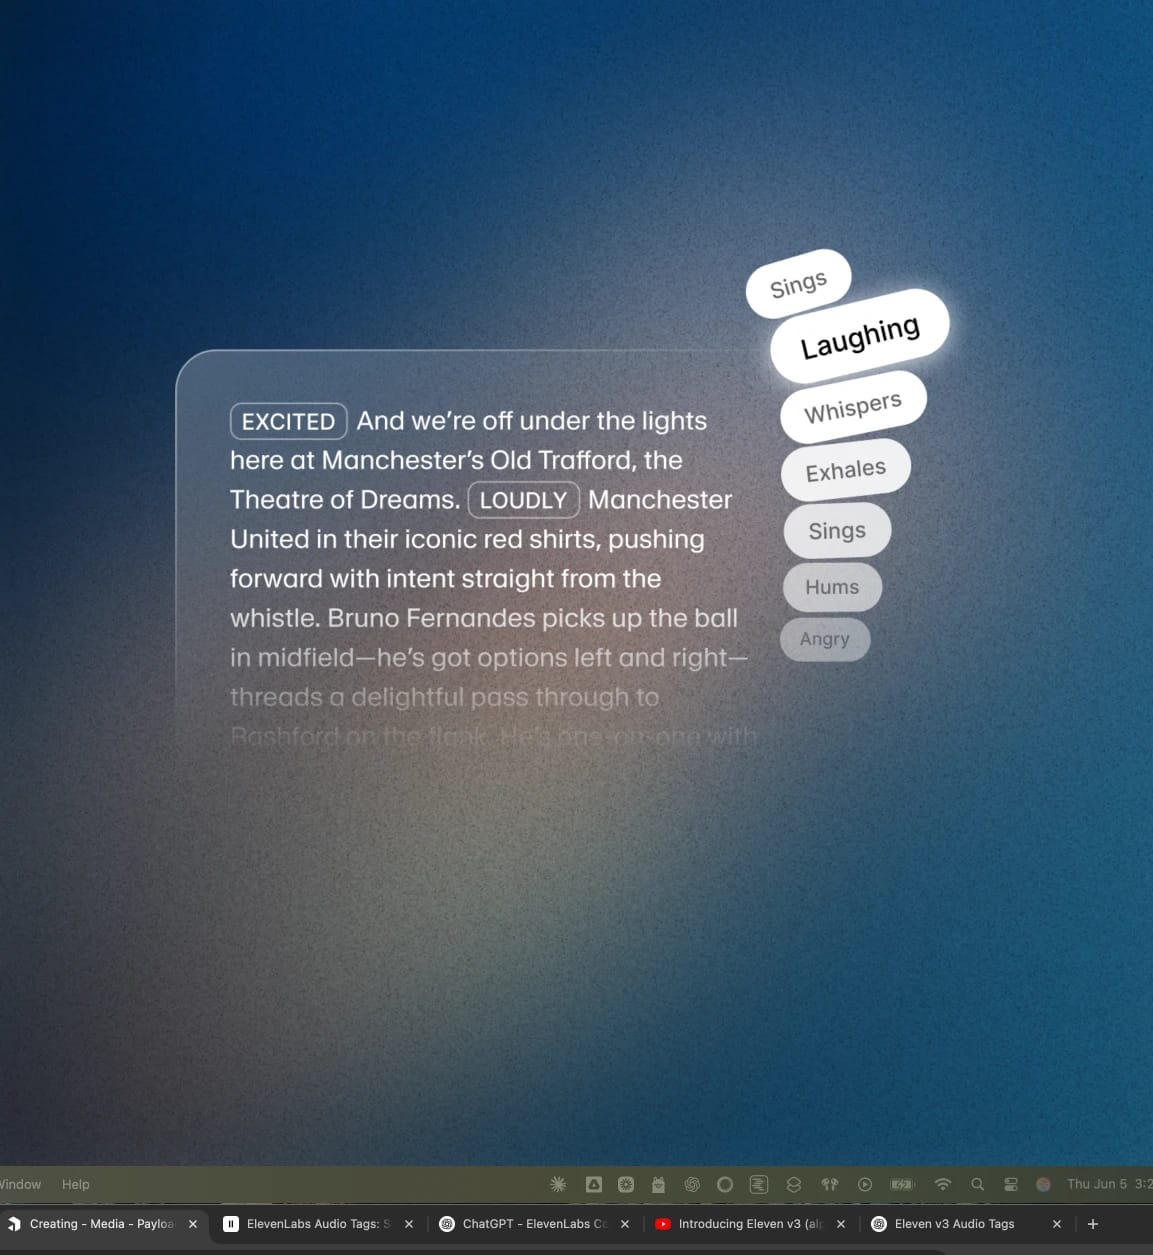
Audio Tags는 [laughs], [gasps], [excited], [worried]처럼 대괄호로 표시된 자연어 신호로, Eleven v3와 Eleven v4에서는 발화할 단어가 아니라 퍼포먼스 지시로 읽습니다. 텍스트 음성 변환 모델용 스크립트를 작성할 때 이러한 Audio Tags를 삽입하면 글의 감정 표현을 세밀하게 제어할 수 있습니다.
Eleven v3는 2026년 3월에 공개되었습니다. v3 이전에는 텍스트 음성 변환 모델에서 원하는 감정 표현을 얻으려면 콘텐츠를 반복 생성하며 최선의 결과를 기대하는 수밖에 없었습니다. Audio Tags는 이런 추측을 없애고 감정이 담긴 텍스트 음성 변환 퍼포먼스를 완벽하게 제어할 수 있게 해줍니다. Eleven v4는 이를 한 단계 더 발전시켜 감정을 세밀하게 제어할 수 있게 합니다.
이 가이드에서는 Audio Tags의 정의와 작동 방식, 사용 가능한 모든 태그 카테고리, 그리고 SSML(음성 합성 마크업 언어)과의 차이점을 다룹니다. 각 전용 가이드로 연결되는 일반적인 활용 사례도 살펴봅니다.
요약
- Audio Tags는 [shouts], [excited]와 같은 대괄호 신호로, Eleven v3와 Eleven v4의 TTS에서 감정, 속도, 전달 방식, 톤을 지시합니다.
- Eleven v3와 Eleven v4는 SSML을 지원하지 않지만, 더 자연스러운 작성 경험을 위해 Audio Tags를 사용합니다.
- 태그는 감정, 전달 방식과 속도, 사람의 반응, 억양, 음향 효과 등 여러 카테고리로 나뉩니다.
- 텍스트의 문장 부호와 대문자 표기를 활용하면 AI 음성 퍼포먼스의 속도를 조절할 수 있습니다.
- ElevenLabs UI 또는 API를 통해 Audio Tags를 사용할 수 있습니다.
Audio Tags는 어떻게 작동하나요?
Audio Tags는 대본 안에 인라인으로 삽입되며 대괄호로 감쌉니다. 일반적인 톤에서 [worried]처럼 전달 방식을 바꾸고 싶을 때는 오디오 태그를 추가하기만 하면 됩니다.
한 문장에 여러 태그를 사용할 수도 있고, [tired] 오늘은 정말 긴 하루였어… [upset] 이런 날이 언제까지 계속될까?처럼 태그를 조합해 더 다층적인 퍼포먼스를 만들 수도 있습니다.
Eleven v4의 아키텍처는 이전 모델보다 더 깊은 수준에서 문맥을 읽을 수 있어, 별도의 매개변수나 설정 없이도 감정 신호, 톤 변화, 화자 전환, 문맥 단서를 따라갈 수 있습니다. 그 순간에 필요한 것을 모델에 알려주기만 하면, 계획한 그대로 대사를 연기합니다.
Eleven v4는 태그와 스크립트 구조만으로도 끼어들기, 분위기 변화, 실제 대화의 자연스러운 주고받음이 포함된 즉흥적인 다중 화자 대화도 처리합니다.
Audio Tags와 SSML 비교
다른 TTS 시스템을 사용해 봤다면 음성 합성 마크업 언어(Speech Synthesis Markup Language)를 접해 보셨을 것입니다. Amazon Polly나 Microsoft Azure Speech 같은 플랫폼은 <break>, <emphasis> 같은 SSML 태그를 사용해 TTS 스크립트에 추가적인 문맥 정보를 제공합니다.
Eleven v4는 SSML break 태그나 그 외 SSML 태그 세트를 지원하지 않습니다. 대신 Audio Tags와 문장 부호, 텍스트 구조 자체가 그 역할을 대신하며, 전달 방식을 세밀하게 제어할 수 있습니다.
아래 표에서 일반적인 SSML 태그와 이에 해당하는 Eleven v4 기능을 확인할 수 있습니다.
작성자 입장에서는 대사에 [whispers]를 추가하는 편이 운율 속도를 설정하는 것보다 훨씬 간편합니다.
v3의 Audio Tags 카테고리: Audio Tags로 퍼포먼스 연출하기
스크립트의 어느 위치에나 Audio Tags를 배치해 실시간으로 전달 방식을 조절할 수 있습니다. 스크립트 안에서, 심지어 한 문장 안에서도 태그를 조합해 사용할 수 있습니다.
태그는 다음과 같은 핵심 카테고리로 나뉩니다.
감정
이 태그는 차분하거나 강렬하거나 경쾌한 등 음성의 감정적 톤을 설정하는 데 도움이 됩니다. 예를 들어 [sad], [angry], [happily], [sorrowful]을 하나 또는 조합하여 사용할 수 있습니다.
전달 방식과 속도
이 태그는 톤과 퍼포먼스에 더 초점을 맞춥니다. 절제되거나 강한 표현이 필요한 장면에서 볼륨과 에너지를 조절하는 데 사용할 수 있습니다. [whispers], [shouts], [softly] 같은 태그가 이에 해당합니다.
사람의 반응
진정으로 자연스러운 말에는 반응이 포함됩니다. 예를 들어 자연스럽고 즉흥적인 순간을 음성에 넣어 사실감을 더할 수 있습니다. [laughs], [clears throat], [sighs] 같은 태그는 사람의 감정을 전달할 수 있는 TTS 모델을 만드는 데 도움이 됩니다.
그 밖의 오디오 태그 카테고리 예시는 다음과 같습니다.
- 억양과 캐릭터 보이스: 억양 태그는 모델을 바꾸지 않고도 [French accent], [British accent], [pirate voice]처럼 음성을 특정 지역이나 페르소나로 전환합니다. 하나의 고정된 퍼포먼스가 아닌 유연한 캐스팅으로 단일 음성을 활용할 수 있습니다.
- 음향 효과: 음향 효과 태그는 [gunshot], [explosion], [clapping]처럼 비음성 오디오를 생성 결과에 직접 추가합니다. 장면에 음성 이상의 요소가 필요한 몰입형 오디오, 게임, 극화된 내레이션에 적합합니다. 또는 ElevenCreative AI 음향 효과 생성기를 사용하세요.
태그로 높은 수준의 제어가 가능하지만, 문장 부호를 사용해 리듬과 강조를 조절할 수도 있습니다. 예를 들어 자연스러운 쉼을 위해 줄임표를 추가하거나 쉼표로 자연스러운 호흡 패턴을 만들 수 있습니다. 강조하려면 단어를 모두 대문자로 써 보세요. “지금 당장 원해.”
Audio Tags로 무엇을 할 수 있나요?
Audio Tags는 직관적인 방식으로 스크립트의 감정적 복잡성을 구현합니다. 자연스럽게 작성하고, 필요할 때 태그를 추가하세요.
Audio Tags를 활용한 감정형 TTS의 몇 가지 사용 사례를 간략히 살펴보겠습니다.
AI 오디오의 상황 인식
[whisper], [shouting] 같은 태그를 사용하면 Eleven v4가 상황에 반응하게 할 수 있습니다. 경고를 부드럽게 전달하는 것부터 긴장감을 위한 긴 멈춤을 유지하는 것까지, 스크립트에 역동적인 상황 인식을 구축할 수 있습니다.
자세한 내용은 AI 오디오의 상황 인식 가이드를 확인하세요.
음성 속 캐릭터 퍼포먼스 연출
여러 캐릭터가 등장하는 스크립트를 작성할 때는 각 음성이 어떻게 다른지 명확히 보여줘야 합니다. [sarcastically]로 성격을 조정하거나 [British accent]로 말하는 방식을 정의하는 등, TTS 엔진으로 폭넓은 감정을 표현할 수 있습니다.
자세한 내용은 AI 음성에서 캐릭터 퍼포먼스 연출하기를 확인하세요.
음성으로 감정적 맥락 표현하기
Audio Tags를 사용하면 대사가 진행되는 동안 감정 표현을 조절할 수 있습니다. 캐릭터가 잠재력을 최대한 발휘하는 순간을 상상하며, 연설 전체에 걸쳐 감정을 쌓아 절정에 이를 수 있습니다. [awe], [booming], [big laugh] 같은 태그는 AI 음성 퍼포먼스에 완전한 감정의 폭을 더해줍니다.
AI 음성에서 감정적 맥락 활용하기에 대해 자세히 알아보세요.
다중 캐릭터 대화에 생동감 더하기
다중 캐릭터 대화 퍼포먼스를 만들 때는 각 대사를 오디오 태그로 시작해 풍부한 캐릭터 간 대화를 구성할 수 있습니다.
다음 예를 살펴보세요. Tom: [coughing] [beginning to speak] 미안해, 오늘 몸이 좀 안 좋아— Emma: [interrupting] —아프다고? 내가 기침 싫어하는 거 알잖아, Tom! Tom: [surprised] 그냥 가벼운 기침이야, 심각한 건 아니야. 네가 만약— Emma: [overlapping] [annoyed] —집에 가야 할 것 같아.
Eleven v3의 다중 캐릭터 대화로 할 수 있는 다른 작업도 확인하세요.
AI 음성을 위한 정밀한 전달 제어
Audio Tags 또는 문장 부호를 사용해 Eleven v3와 Eleven v4에서 음성의 속도를 조절할 수 있습니다. [pause], [rushed], [drawn out] 같은 태그를 사용하면 대사를 정밀하게 능동적으로 다듬을 수 있습니다. 또는 줄임표, 마침표, 느낌표를 추가해 TTS 퍼포먼스에 자연스럽게 감정을 담을 수 있습니다.
Eleven v3의 정밀한 전달 제어에 대한 심층 가이드를 작성했습니다.
감정형 TTS는 API에서 사용할 수 있습니다
Audio Tags는 텍스트 음성 변환 API를 통해서도 ElevenLabs UI와 동일하게 작동합니다. 스크립트 텍스트에 태그를 인라인으로 작성하면 API가 오디오북 파이프라인부터 광고 보이스오버까지 태그가 적용된 퍼포먼스를 생성된 오디오로 반환합니다.
Eleven v4에 대해 자세히 알아보거나 영업팀에 문의하여 오늘 시작하세요.
Audio Tags 및 감정형 TTS FAQ

Jack Limebear는 Growth 팀에서 블로그와 인사이트 페이지의 콘텐츠 작가이자 전략가로 활동하고 있습니다. ElevenLabs에 합류하기 전에는 빠르게 성장하는 SaaS 스타트업부터 포춘 500대 기업까지 다양한 조직에서 10년 넘게 콘텐츠 전략을 이끌었습니다. 케임브리지 대학교에서 영문학 석사 학위를 취득했습니다.