Eleven v3 오디오 태그: AI 오디오에 상황 인식 부여
- 게시일
- 최종 업데이트
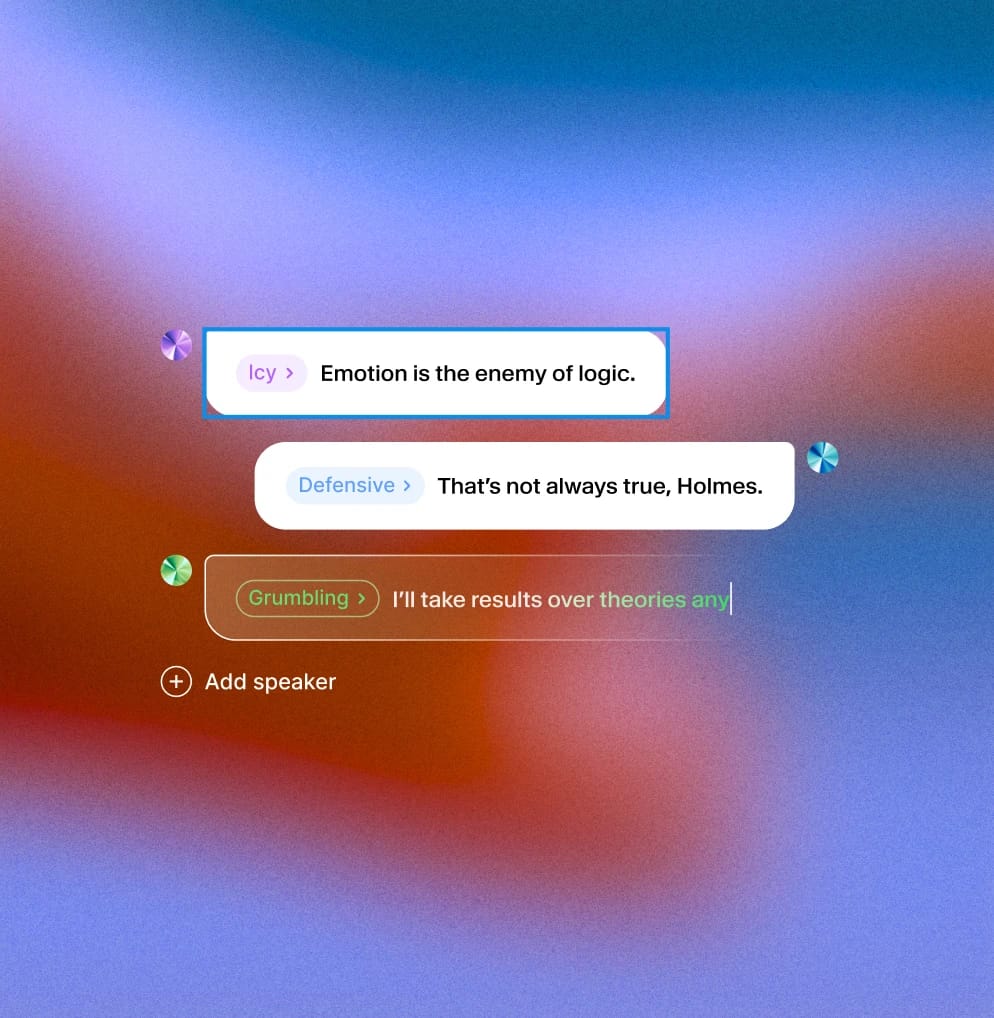
오디오 태그는 새로운 Eleven v3 (알파) 텍스트 음성 변환 모델의 핵심 기능입니다. 톤, 감정, 속도를 조절해 실제 상황의 맥락에 맞게 대사가 전달되는 방식을 제어할 수 있습니다.
오디오 태그는 가장 단순하게 말하면 대괄호 안에 넣는 단어입니다. 모델은 이를 연기 지시로 해석합니다. 즉, 문장 중간에도 감정의 흐름이나 상황 변화를 반영하도록 전달 방식을 조절해 AI에 상황 인식 능력을 더할 수 있습니다.
AI 음성에서 상황 인식이란 무엇인가요?
상황 인식이란 AI가 그 순간에 맞게 전달 방식을 조정하는 것을 뜻합니다. 오디오 태그를 사용하면 모델이 무엇을 말하는지뿐 아니라 어떻게 반응하는지도 제어할 수 있습니다.
[SHOUTING] 태그로 긴박감을 더하거나, [WHISPER]로 경고를 부드럽게 전달하거나, [SIGH]로 망설임을 표현할 수 있습니다. 태그는 내레이션을 연기로 바꿔 줍니다. 특히 맥락이 풍부하거나 역동적인 장면에서 유용합니다.
단순한 낭독이 아닌 연기
11 United와 12 United의 축구 경기 Veo 3 하이라이트 비디오를 위한 스크립트를 작성한다고 상상해 보세요. 경기 흐름에 따라 긴장감이 고조되길 원합니다. “수비수 한 명을 제치고 — [EXCITED] 크로스가 올라옵니다 — [SHOUTING] 고오오올!”
또는 오디오북에서 긴장감 넘치는 장면을 연기할 수도 있습니다. “[WHISPERING] 집 안에 누군가 있는 것 같아. [PAUSE] 조용히 해.”
이는 단순한 스타일 요소가 아닙니다. 순간을 정의하고, 그 순간이 느껴지는 방식을 이끕니다. 모델은 읽는 것이 아니라 연기합니다.
상황별로 자주 쓰는 태그
오디오 태그로 다양한 감정적·신체적 신호를 구현할 수 있습니다:
- 감정 톤: [EXCITED], [NERVOUS], [FRUSTRATED], [TIRED]
- 반응: [GASP], [SIGH], [LAUGHS], [GULPS]
- 음량 및 에너지: [WHISPERING], [SHOUTING], [QUIETLY], [LOUDLY]
- 속도 및 리듬: [PAUSES], [STAMMERS], [RUSHED]
태그를 겹쳐 사용하면 더욱 섬세한 표현이 가능합니다. “[NERVOUSLY] 나... 이게 잘될지 모르겠어. [GULPS] 그래도 해보자.”
원하는 대로 이끄는 연기
Eleven v3는 더 깊이 있는 맥락 모델로 이러한 태그를 지원합니다. 대사 중간에 톤을 바꾸고, 끼어드는 상황을 처리하며, 자연스러운 흐름을 유지할 수 있어 스크립트를 다시 쓰지 않아도 더욱 자연스러운 전달이 가능합니다.
보이스 디자인 사용자, 게임 개발자, 스토리텔러에게 이는 새로운 창작의 층위를 열어 줍니다. 단순히 대사를 쓰는 것이 아닙니다. 대사를 연출하는 것입니다.
적합한 음성 선택하기
프로페셔널 음성 복제(PVC)는 현재 Eleven v3에 완전히 최적화되지 않아 이전 모델과 비교해 복제 품질이 낮을 수 있습니다. 이 리서치 프리뷰 단계에서는 v3 기능을 사용해야 한다면 프로젝트에 적합한 Instant 음성 복제 (IVC) 또는 디자인된 음성을 찾는 것이 좋습니다. v3용 PVC 최적화는 가까운 시일 내에 제공될 예정입니다.
Ryan joined ElevenLabs after more than two decades in news and publishing, including roles at the BBC and Future Plc. He focuses on content strategy and storytelling, helping ElevenLabs shape and share its narrative.