मल्टीलिंगुअल ट्रांसक्रिप्शन क्या है और यह कैसे काम करता है?
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
चाहे आप अंतरराष्ट्रीय सम्मेलन आयोजित कर रहे हों या किसी भी भाषा में ग्राहक सहायता बातचीत का सटीक रिकॉर्ड रखना चाहते हों, बहुभाषी ट्रांसक्रिप्शन पहले से कहीं अधिक जरूरी हो गया है।
ऑडियो डेटा को सटीक, खोजे जा सकने वाले टेक्स्ट में बदलकर, बहुभाषी ट्रांसक्रिप्शन टूल बातचीत को उपयोगी रिकॉर्ड में बदल देते हैं। भाषाओं के बीच ट्रांसक्रिप्शन सक्षम करने वाली टेक्नोलॉजी, स्पीच टू टेक्स्ट (STT) मॉडल पर बढ़ते शोध के साथ परिपक्व हुई है। डेवलपर अब जटिल बहुभाषी ट्रांसक्रिप्शन पाइपलाइन के लिए अपने वर्कफ़्लो में शक्तिशाली STT API भी जोड़ सकते हैं।
इस लेख में, हम जानेंगे कि बहुभाषी ट्रांसक्रिप्शन क्या है, डेस्कटॉप ऐप और API के ज़रिए यह कैसे काम करता है, और दुनिया भर के उद्यमों के लिए यह क्यों जरूरी है।
सारांश
- बहुभाषी ट्रांसक्रिप्शन एक ऑडियो फ़ाइल को कई भाषाओं में लिखित टेक्स्ट में बदलता है।
- सबसे अच्छे बहुभाषी ट्रांसक्रिप्शन टूल में अतिरिक्त सुविधाएं होती हैं, जैसे स्पीकर डायराइज़ेशन, कीटर्म प्रॉम्प्टिंग और एंटिटी डिटेक्शन।
- आप बहुभाषी ट्रांसक्रिप्शन टूल ऑनलाइन इस्तेमाल कर सकते हैं या डेवलपमेंट वर्कफ़्लो के लिए स्पीच टू टेक्स्ट API इंटीग्रेट कर सकते हैं।
- ऑटोमैटिक ट्रांसक्रिप्शन गति और बड़े पैमाने पर काम संभालता है, जबकि कई ओवरलैप होते स्पीकर वाले जटिल मामलों में मानव ट्रांसक्रिप्शन उपयोगी हो सकता है।
- बहुभाषी ट्रांसक्रिप्शन की सटीकता को वर्ड एरर रेट (WER) से मापा जाता है, जो भाषा के अनुसार बदलती है।
बहुभाषी ट्रांसक्रिप्शन क्या है और यह क्यों मायने रखता है?
बहुभाषी ट्रांसक्रिप्शन बोली गई ऑडियो को एक से अधिक भाषाओं में लिखित टेक्स्ट में बदलता है। आर्टिफ़िशियल इंटेलिजेंस सिस्टम बोली जा रही भाषा (या भाषाओं) का अपने आप पता लगाते हैं और ऑडियो को ट्रांसक्राइब करते हैं। बहुभाषी STT का आउटपुट शब्दशः ट्रांसक्रिप्ट हो सकता है या इनपुट भाषाओं को एक सामान्य आउटपुट में एकीकृत करने के लिए इसमें अनुवाद की परत शामिल हो सकती है।
उदाहरण के लिए, किसी वैश्विक सम्मेलन में वक्ताओं को उनकी मातृभाषा में प्रश्न मिल सकते हैं। बहुभाषी स्पीच टू टेक्स्ट टूल या तो हर वक्ता की बात को उसकी अपनी भाषा में सीधे ट्रांसक्राइब कर सकता है, या दर्शकों के पढ़ने के लिए लक्षित भाषा में एकल आउटपुट दे सकता है। संगठन इन STT टूल का उपयोग करके अपने आयोजनों तक पहुंच बढ़ा सकते हैं।
ElevenLabs बहुभाषी STT क्षमताएं सीधे अपने स्पीच टू टेक्स्ट Scribe v2 मॉडल में बनाता है। Scribe v2 ऑटोमैटिक भाषा पहचान को सपोर्ट करता है, यानी एक फ़ाइल में कई भाषाएं हो सकती हैं। आप बता सकते हैं कि ऑडियो क्लिप में कौन-सी भाषाएं हैं या सेटिंग को “Detect” पर छोड़ सकते हैं और हमारे सिस्टम को अपलोड की गई फ़ाइल में मौजूद भाषाओं की पहचान करने दे सकते हैं।
ElevenAPI का उपयोग करते समय, language_code पैरामीटर डिफ़ॉल्ट रूप से ऑटोमैटिक अनुमान पर सेट होता है। अगर आपको पहले से पता है कि कौन-सी भाषाएं मौजूद हैं, तो उन्हें पहले से देने पर प्रदर्शन बेहतर होता है।
बहुभाषी ट्रांसक्रिप्शन क्यों मायने रखता है
हालिया शोध के अनुसार, वैश्विक ट्रांसक्रिप्शन सेवा बाजार 2035 तक $6 बिलियन तक पहुंच जाएगा। इसकी वृद्धि को तेज करने वाला एक कारण बहुभाषी STT का इस्तेमाल करने वाले उपयोग के व्यापक मामले हैं।
बहुभाषी ट्रांसक्रिप्शन के महत्वपूर्ण होने के कई व्यावहारिक कारण हैं:
- सुलभता: अनुवाद या डबिंग शुरू होने से पहले कैप्शन और सबटाइटल सटीक बहुभाषी ट्रांसक्रिप्शन पर निर्भर करते हैं। बहुभाषी STT यूज़र्स के लिए सुलभता को काफी बढ़ा सकता है।
- खोजने की सुविधा: ट्रांसक्राइब किया गया ऑडियो इंडेक्स किए जा सकने वाले टेक्स्ट में बदल सकता है, यानी आपकी सहायता कॉल या मीटिंग दूसरों के लिए उपयोगी संसाधन बन सकती हैं। जब AI सिस्टम आंतरिक दस्तावेज़ों से अधिक डेटा सामने लाने लगते हैं, तब खोजने की सुविधा विशेष रूप से महत्वपूर्ण होती है। स्पष्ट ट्रांसक्रिप्शन एक व्यापक इनपुट रेफरेंस बनाने में मदद करता है।
- अनुपालन: कई विनियमित उद्योगों को बोली गई बातचीत का ऑडिट किए जा सकने वाला लिखित रिकॉर्ड चाहिए होता है। बहुभाषी STT के साथ आप अपने ग्राहकों की हर भाषा में यह सुविधा दे सकते हैं। उदाहरण के लिए, फाइनेंशियल कंडक्ट अथॉरिटी के अनुसार वित्तीय संस्थानों को टेलीफोन बातचीत की रिकॉर्डिंग और ट्रांसक्रिप्ट सुरक्षित रखनी चाहिए।
- वैश्विक कंटेंट पाइपलाइन: चाहे डबिंग हो या सबटाइटलिंग, वर्कफ़्लो हमेशा काम के लिए अत्यधिक सटीक शुरुआती ट्रांसक्रिप्ट से शुरू होते हैं। अच्छी बहुभाषी ट्रांसक्रिप्शन टूल इन व्यापक वैश्विक कंटेंट वितरण वर्कफ़्लो के पहले चरण को सक्षम करते हैं।
बहुभाषी ट्रांसक्रिप्शन कई उद्योगों का जरूरी हिस्सा है: सहायता कॉल ट्रांसक्राइब करने वाले टेलीकॉम प्रदाता, अनुपालन आवश्यकताएं पूरी करने वाली वित्तीय सेवा कंपनियां, मरीजों के साथ बातचीत दर्ज करने वाली हेल्थकेयर टीमें और कंटेंट का स्थानीयकरण करने वाले मूवी स्टूडियो। चाहे आप SaaS, यात्रा या यूटिलिटीज़ क्षेत्र में हों, एक शक्तिशाली सिस्टम यह सुनिश्चित करता है कि आपके आउटपुट ट्रांसक्रिप्ट हमेशा उच्च-गुणवत्ता वाले और सटीक हों।
बहुभाषी ट्रांसक्रिप्शन समाधानों में देखने योग्य मुख्य सुविधाएं
बहुभाषी ट्रांसक्रिप्शन टूल को उस ऑडियो इनपुट के अनुकूल होना चाहिए जिस पर वे काम कर रहे हैं, भाषाओं की गतिशील रूप से पहचान करनी चाहिए और उन्हें उच्च सटीकता से ट्रांसक्राइब करना चाहिए।
उच्च-गुणवत्ता वाले बहुभाषी ट्रांसक्रिप्शन समाधान में ये मुख्य सुविधाएं देखें:
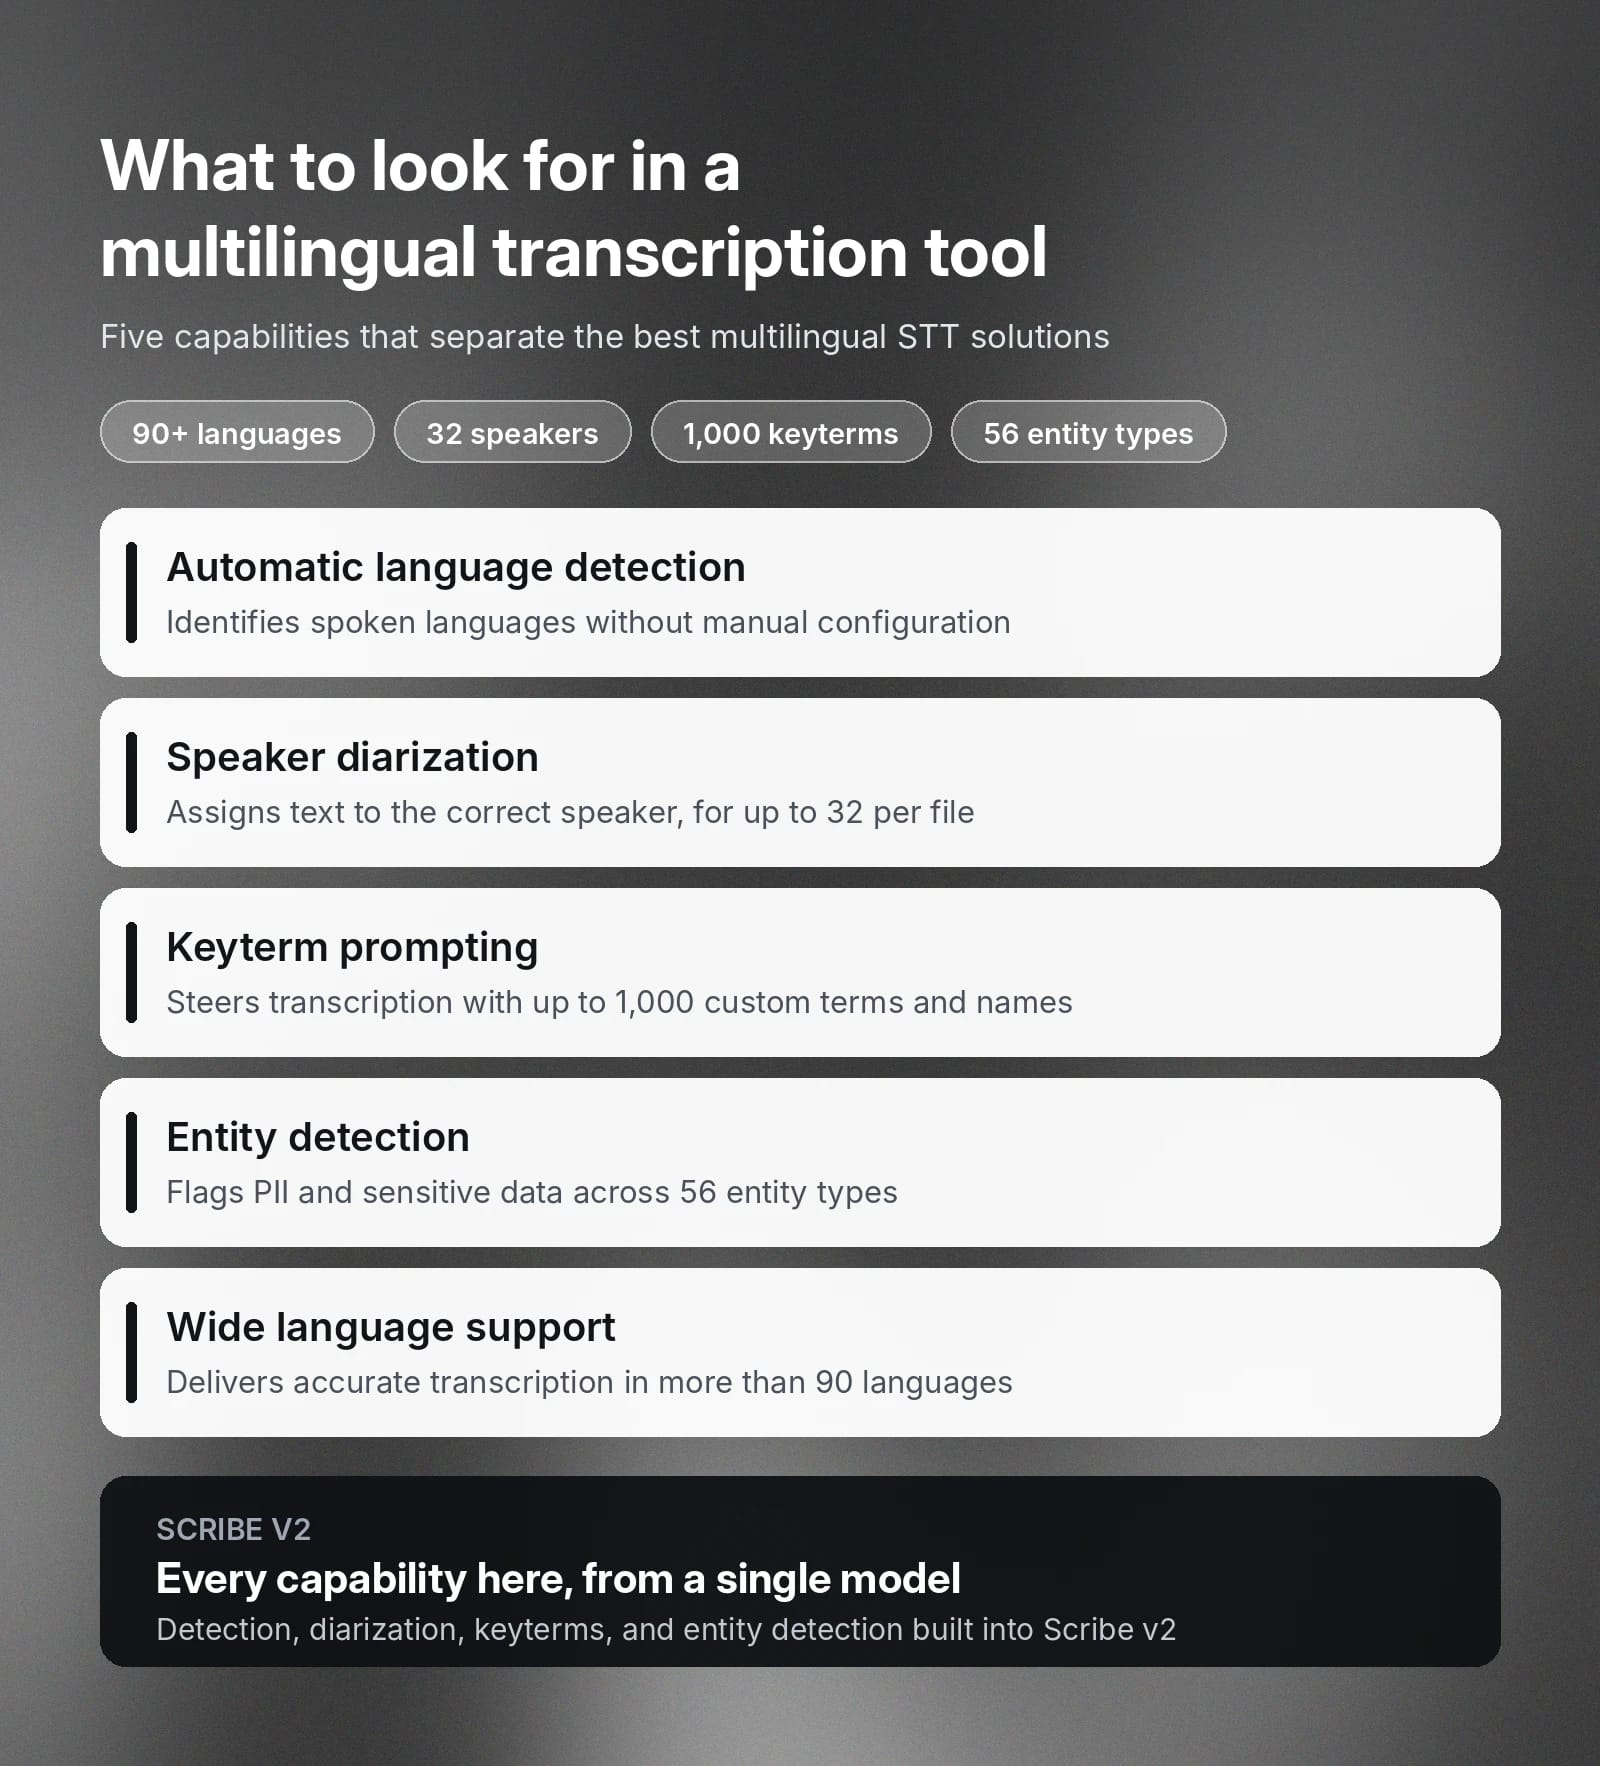
- ऑटोमैटिक भाषा पहचान: सिस्टम को यूज़र द्वारा स्रोत भाषा दिए जाने तक ट्रांसक्रिप्शन रोकने के बजाय, बोली गई भाषा की अपने आप पहचान करनी चाहिए। खासकर उन स्थितियों में जहां इनपुट भाषा ज्ञात नहीं है या क्लिप में कई भाषाएं हैं, ऑटोमैटिक भाषा पहचान सुनिश्चित करती है कि आप बिना किसी मैन्युअल कॉन्फ़िगरेशन के कई भाषाएं मैनेज कर सकें।
- स्पीकर डायराइज़ेशन: डायराइज़ेशन फ़ाइल में ट्रांसक्राइब किए गए टेक्स्ट को सही स्पीकर से जोड़ता है, जो कई स्पीकर वाले हर ऑडियो ट्रांसक्रिप्शन के लिए जरूरी है। उदाहरण के लिए, किसी पैनल में कई लोग हो सकते हैं जिन्हें आपको अलग-अलग पहचानना हो, या ग्राहक और सहायता एजेंट के बोलने के समय के बीच स्पष्ट अंतर चाहिए हो। Scribe v2 एक फ़ाइल में अधिकतम 32 स्पीकर के लिए डायराइज़ेशन सपोर्ट करता है।
- कीटर्म प्रॉम्प्टिंग: कीटर्म यूज़र्स को सही ट्रांसक्रिप्शन निर्धारित करने के लिए प्रोडक्ट नाम या व्यक्तिवाचक संज्ञा जैसे खास शब्द मैन्युअल रूप से दर्ज करने देते हैं। बैच सिस्टम में, Scribe v2 अधिकतम 1,000 कीटर्म की अनुमति देता है, जबकि लाइव ट्रांसक्रिप्शन के लिए Scribe v2 Realtime में अधिकतम 50 की सुविधा है।
- एंटिटी डिटेक्शन: एंटिटी डिटेक्शन ट्रांसक्रिप्ट में खास शब्दों की पहचान करता है, जो संवेदनशील डेटा की सुरक्षा के लिए अनुपालन और सुरक्षा-आधारित प्रयासों में जरूरी है। समर्थित 56 एंटिटी प्रकारों की पूरी जानकारी के लिए ElevenLabs के एंटिटी डिटेक्शन डॉक्यूमेंटेशन पढ़ें।
- भाषाओं के लिए व्यापक सपोर्ट: स्वाभाविक रूप से, सबसे अच्छे बहुभाषी STT समाधान बहुत बड़ी संख्या में भाषाओं में ट्रांसक्रिप्शन सपोर्ट करते हैं। उदाहरण के तौर पर, Scribe v2 90+ भाषाओं में सटीक ट्रांसक्रिप्शन देता है।
मिलकर, ये क्षमताएं उपयोग के व्यापक मामलों को सपोर्ट करती हैं और आपको एक भरोसेमंद STT सिस्टम का उपयोग करने देती हैं, जो कई भाषाओं को सटीकता से संभालता है।
अलग-अलग भाषाओं में ऑडियो को कुशलता से ट्रांसक्राइब कैसे करें
अलग-अलग भाषाओं में ऑडियो ट्रांसक्राइब करने का सबसे प्रभावी तरीका आपके काम के भार पर निर्भर करता है। एक बार वाली बैच फ़ाइलों के लिए, ElevenLabs स्पीच टू टेक्स्ट पेज आपको फ़ाइल अपलोड करके तुरंत ट्रांसक्रिप्ट पाने देता है।
जब आप ElevenCreative में काम कर रहे हों, तो ऑडियो ट्रांसक्राइब करना इतना आसान है:
- अपना ऑडियो अपलोड करना: स्पीच टू टेक्स्ट पर जाएं और “Transcribe files” पर क्लिक करें।
- अपने विकल्प चुनना: प्राथमिक भाषा चुनें या इसे “Detect” पर छोड़ दें। अगर आप हंसी या अन्य गैर-वाक् घटनाओं को टैग करना चाहते हैं, तो ऑडियो इवेंट्स टॉगल करें और जरूरत हो तो कीटर्म जोड़ें।
- अपने नतीजे देखना: फ़ाइलें अपलोड करने के बाद, आप ऑडियो फ़ाइल के नाम पर क्लिक करके उसका ट्रांसक्रिप्शन देख सकेंगे। वहां से आप Transcript Editor में सीधे ट्रांसक्रिप्ट की समीक्षा कर सकते हैं और उसे बेहतर बना सकते हैं, फिर हर अगले वर्कफ़्लो के लिए जरूरी फ़ॉर्मैट में एक्सपोर्ट कर सकते हैं।
प्रोग्रामेटिक या अधिक मात्रा वाले ट्रांसक्रिप्शन के लिए स्पीच टू टेक्स्ट API का उपयोग करें। प्रोडक्शन पाइपलाइन तैयार करने के लिए इन विवरणों का उपयोग करें:
- मॉडल चयन: model_id पैरामीटर scribe_v2 और scribe_v1 में से चुनता है, इसलिए पाइपलाइन किसी ऐसे डिफ़ॉल्ट पर निर्भर रहने के बजाय एक खास मॉडल चुन सकती है जो समय के साथ बदल सकता है।
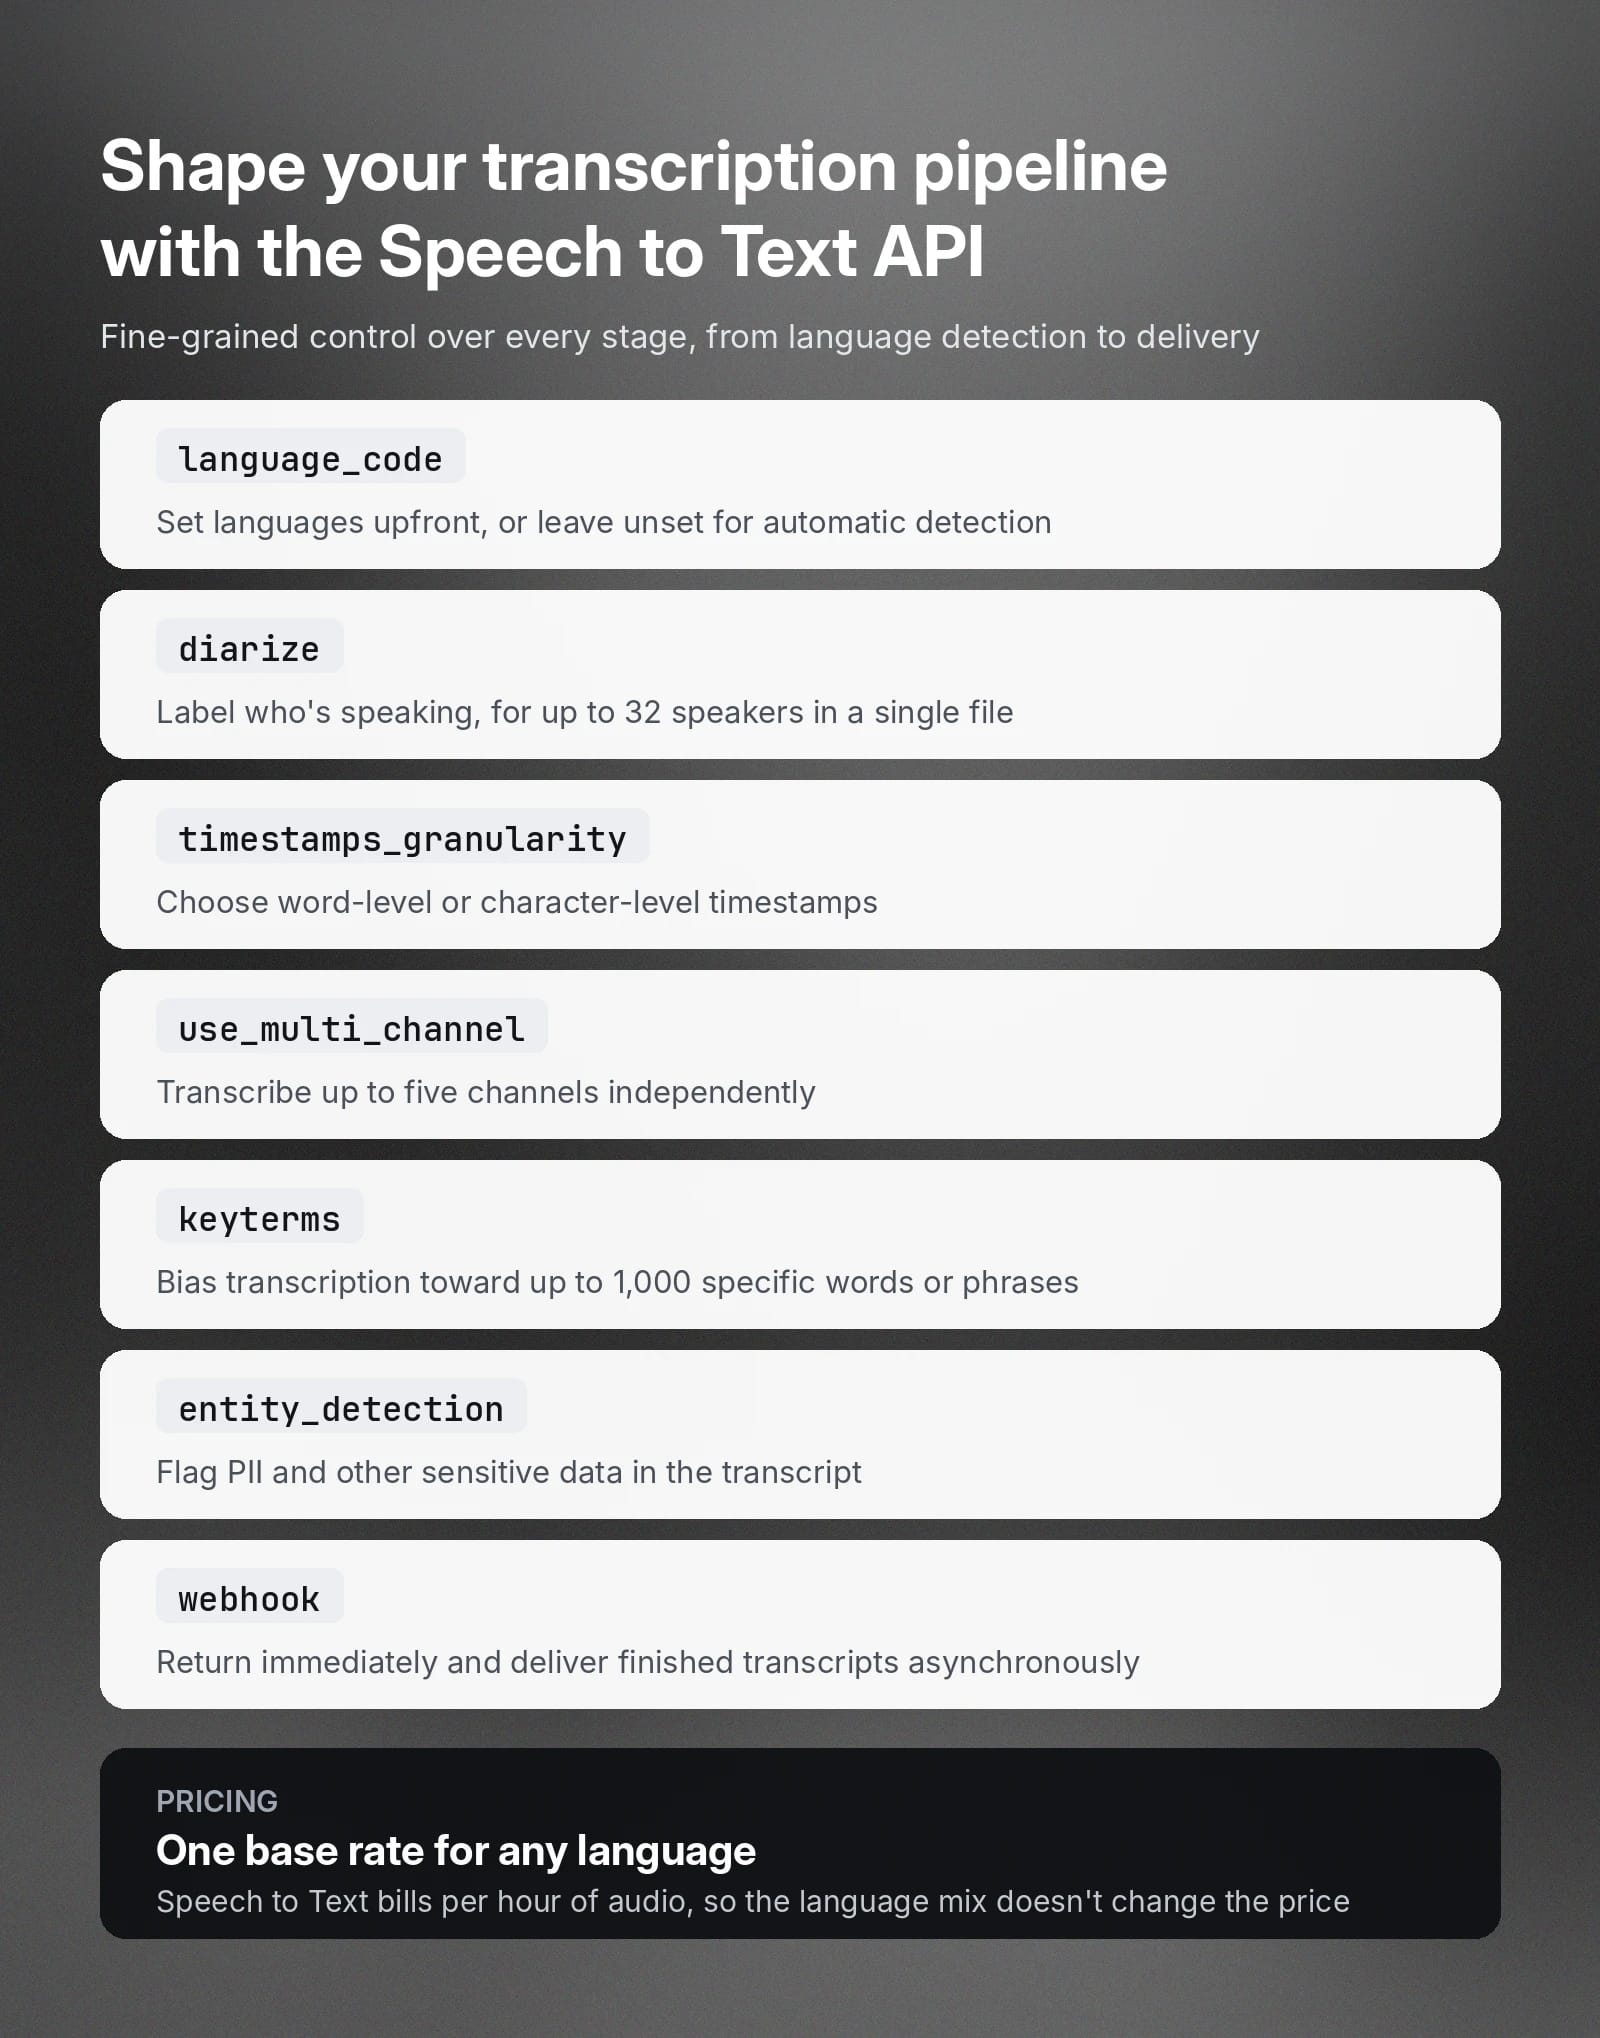
- भाषा प्रबंधन: यह language_code पैरामीटर एक ISO-639-1 या ISO-639-3 कोड स्वीकार करता है और सेट न होने पर डिफ़ॉल्ट रूप से ऑटोमैटिक पहचान करता है। सीधे भाषा देने से प्रदर्शन बेहतर हो सकता है।
- स्पीकर डायराइज़ेशन कंट्रोल: diarize को true पर सेट करने से यह एनोटेट होता है कि कौन-सा स्पीकर बोल रहा है। num_speakers पैरामीटर संख्या को 1 से 32 के बीच सीमित करता है। अधिक बारीक नियंत्रण के लिए, अलग-अलग स्पीकर के बीच संतुलन को ट्यून करने हेतु diarization_threshold पैरामीटर का इस्तेमाल कर सकते हैं।
- टाइमस्टैंप सटीकता: timestamps_granularity पैरामीटर आउटपुट का विवरण नियंत्रित करता है। इसमें शब्द-स्तर या वर्ण-स्तर के टाइमस्टैंप (या कोई नहीं) के विकल्प हैं।
- बड़े पैमाने पर असिंक्रोनस प्रोसेसिंग: webhook को true पर सेट करने से रिस्पॉन्स तुरंत मिलता है और प्रोसेसिंग पूरी होने पर तैयार ट्रांसक्रिप्ट आपके कॉन्फ़िगर किए गए webhook पर भेज दिया जाता है। webhook_metadata फ़ील्ड हर webhook रिस्पॉन्स में आपके आंतरिक जॉब ID जैसा कस्टम ट्रैकिंग डेटा जोड़ता है।
- मल्टीचैनल ऑडियो: use_multi_channel को true पर सेट करने से पांच चैनल तक, हर चैनल स्वतंत्र रूप से ट्रांसक्राइब होगा और हर शब्द को channel_index फ़ील्ड से टैग किया जाएगा।
- विशेष कंटेंट प्रबंधन: keyterms पैरामीटर ट्रांसक्रिप्शन को अधिकतम 1,000 खास शब्दों या वाक्यांशों की ओर प्राथमिकता देता है, entity_detection PII और अन्य संवेदनशील डेटा को फ़्लैग करता है, और no_verbatim आउटपुट से फ़िलर शब्दों और गलत शुरुआतों को हटा देता है।
मिलकर, ये पैरामीटर आपको पाइपलाइन के हर चरण पर बारीक नियंत्रण देते हैं। भाषा पहचान और स्पीकर लेबलिंग से लेकर आउटपुट फ़ॉर्मैटिंग और डिलीवरी तक, स्पीच टू टेक्स्ट API आपकी प्रोडक्शन जरूरतों के अनुरूप ढलता है।
ट्रांसक्रिप्शन सेवाओं के लिए समर्थित भाषाओं की जानकारी
भाषा कवरेज, सबसे अच्छे बहुभाषी ट्रांसक्रिप्शन टूल को अलग बनाने वाला एक प्रमुख पहलू है। ElevenLabs Scribe v2 और Scribe v2 Realtime, दोनों 90+ भाषाओं को सपोर्ट करते हैं और स्पीच टू टेक्स्ट डॉक्यूमेंटेशन में समर्थित भाषाओं की पूरी सूची दी गई है।
अंग्रेज़ी, स्पेनिश, इतालवी, पोलिश, फ़्रेंच और जर्मन जैसी भाषाओं के लिए ट्रेनिंग डेटा की मात्रा अधिक है, इसलिए इन भाषाओं में STT की सटीकता अक्सर अधिक होती है। अम्हारिक, गांडा, योरूबा और ज़ुलू जैसी कुछ भाषाओं की सटीकता दर ऊपर दी गई भाषाओं की तुलना में कम होती है।
ElevenLabs Scribe मॉडल में 36 अलग-अलग भाषाओं के लिए <5% वर्ड एरर रेट और अन्य 21 भाषाओं के लिए <10% WER है। समर्थित भाषाओं और उनकी WER के बारे में अधिक जानकारी के लिए ElevenLabs का भाषा सपोर्ट का विवरण देखें।
बहुभाषी ट्रांसक्रिप्शन की लागत कितनी है?
आमतौर पर, ऑटोमैटिक ट्रांसक्रिप्शन की कीमत ऑडियो फ़ाइल की अवधि पर आधारित होती है, न कि उसके शब्दों की संख्या या शामिल भाषाओं की संख्या पर। ElevenLabs स्पीच टू टेक्स्ट के लिए ऑडियो की अवधि के आधार पर, प्रति ऑडियो घंटे के हिसाब से शुल्क लेता है। खास दरें टियर और मॉडल के अनुसार अलग होती हैं।
बहुभाषी ट्रांसक्रिप्शन की कीमत को प्रभावित करने वाले मुख्य कारक ये हैं:
- अतिरिक्त ट्रांसक्रिप्शन सुविधाएं: कुछ प्रदाता एंटिटी डिटेक्शन जैसी कुछ सुविधाएं चालू करने के लिए अतिरिक्त शुल्क ले सकते हैं।
- मल्टीचैनल ऑडियो का शुल्क प्रति चैनल: use_multi_channel चालू करने पर हर चैनल का अलग शुल्क लगेगा, इसलिए दो-चैनल रिकॉर्डिंग की लागत सिंगल-चैनल रिकॉर्डिंग से लगभग दोगुनी होगी।
- भाषा से बेस रेट नहीं बदलता: अवधि-आधारित कीमत का मतलब है कि बहुभाषी STT एक ही प्रति-घंटे की दर बनाए रखते हुए किसी भी भाषा को सपोर्ट कर सकता है। इससे कई भाषाओं में काम करने वाली टीमों के लिए बजट बनाना आसान हो जाता है।
ElevenLabs के स्पीच टू टेक्स्ट की कीमत के बारे में अधिक जानकारी के लिए हमारा प्राइसिंग पेज देखें।
सटीक बहुभाषी ट्रांसक्रिप्शन के लिए ElevenAPI के साथ शुरुआत करें
ElevenAPI कुछ ही चरणों में किसी भी प्रोडक्शन वर्कफ़्लो में बहुभाषी ट्रांसक्रिप्शन जोड़ देता है। चाहे आप वैश्विक मीडिया आर्काइव, ग्राहक सहायता बातचीत, मीटिंग या शोध साक्षात्कारों के लिए कंटेंट ट्रांसक्राइब कर रहे हों, या दर्जनों भाषाओं में सटीक स्पीच रिकग्निशन चाहते हों, हमारा शक्तिशाली बहुभाषी STT इंजन मदद कर सकता है।
इसकी पूरी क्षमताएं देखने के लिए ElevenAPI स्पीच टू टेक्स्ट API देखें, या आज ही बहुभाषी ऑडियो ट्रांसक्राइब करना शुरू करने के लिए ElevenLabs अकाउंट बनाएं।
बहुभाषी ट्रांसक्रिप्शन FAQ

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।