
Guide pratique : frameworks d’agents open source et ElevenAgents
- Rédigé par
- Akhil Chauhan
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
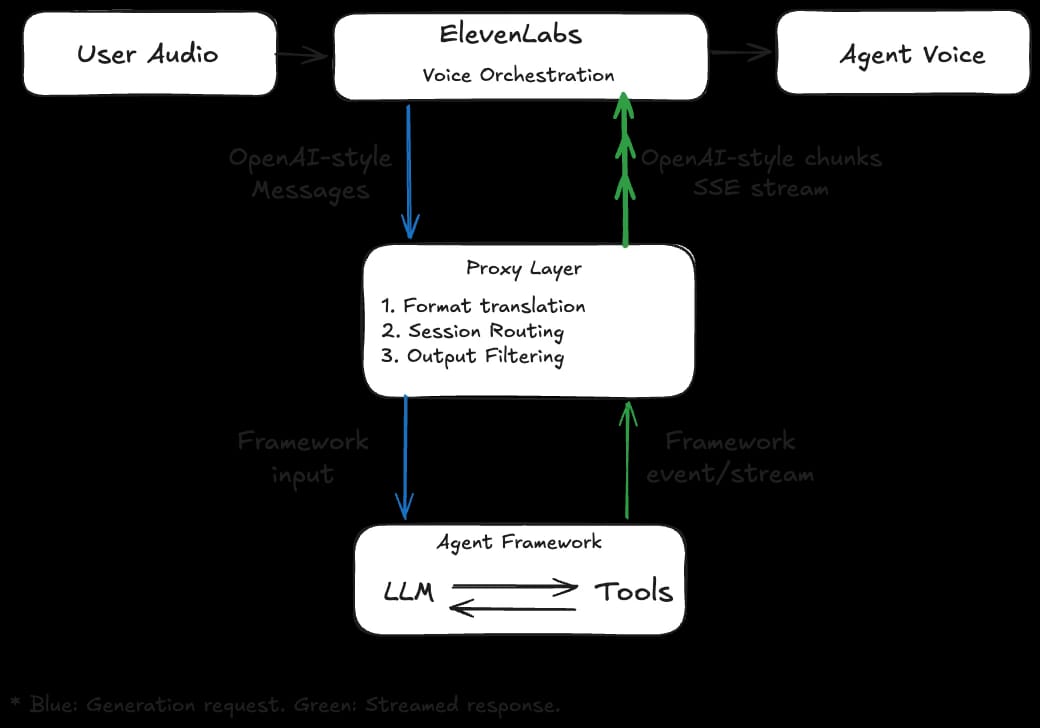
Dans notre précédent article sur l’intégration d’agents externes à l’orchestration vocale d’ElevenLabs, nous avons expliqué comment les équipes peuvent connecter leur orchestration d’agents textuels existante à ElevenLabs via Custom LLM. En nous appuyant sur cette base, ce guide montre comment adapter et déployer les principaux frameworks d’agents open source derrière l’interface Custom LLM. Il en résulte une architecture flexible, qui ajoute la voix à des systèmes d’agents matures sans compromettre la gestion de l’état, l’orchestration des outils ou le contrôle propre à l’application. Quel que soit le framework, nous suivons le même schéma en trois étapes : créer une requête de génération, extraire la réponse textuelle finale et la reformater au format Server-Sent Events (SSE) compatible avec OpenAI. ElevenLabs prend en charge les formats Chat Completions et Responses. Bien que ce guide couvre quatre frameworks largement adoptés, ces modèles s’appliquent à tout environnement d’exécution capable de produire une sortie en streaming compatible avec OpenAI.
Configuration générale
Les exemples de cette section utilisent Python et FastAPI, mais toute stack capable de gérer des requêtes HTTP POST et des réponses SSE en streaming convient. Lorsque l’orchestration vocale d’ElevenLabs détecte une fin de tour probable, elle déclenche une requête de génération vers le point de terminaison Custom LLM configuré. Cette section présente les composants essentiels de cette couche de traduction : le pont, ou proxy, qui permet à l’orchestration vocale et au framework d’agents de parler le même langage.
Naturellement, les clients peuvent choisir chaque framework par familiarité ou parce qu’il répond à un besoin précis. LlamaIndex, par exemple, a été développé à l’origine pour simplifier la mise en place de la génération augmentée par récupération (RAG), tandis que CrewAI a été conçu pour automatiser des tâches définies à l’ère des agents. Des objectifs de conception différents produisent des structures de réponse différentes, qui nécessitent chacune un traitement spécifique. Diffuser les fragments à mesure que le LLM les génère, plutôt que d’attendre un tour complet, est essentiel : le modèle Text-to-Speech (TTS) peut ainsi commencer à générer la parole plus tôt, ce qui réduit la latence perçue. Nous nous concentrons sur quatre frameworks populaires : LangGraph, Google ADK, CrewAI et LlamaIndex.
Note sur le code partagé
Chaque framework doit diffuser les réponses sous forme de fragments SSE compatibles avec OpenAI. Nous introduisons une petite fonction utilitaire, utilisée dans tous les exemples, pour construire ces fragments.
Cette base établie, commençons avec LangGraph.
LangGraph
LangGraph modélise les agents sous forme de graphes, où les nœuds représentent les étapes individuelles et les arêtes définissent le flux de contrôle entre elles. La configuration minimale est simple : initialiser un modèle de chat, définir les outils de l’agent et créer l’environnement d’exécution du graphe d’agents.
Pour chaque requête de génération, l’agent LangGraph reçoit l’historique complet de la conversation, ce qui lui permet de conserver l’état requis en interne. LangGraph prend en charge la persistance côté serveur via Checkpoints, que nous n’abordons toutefois pas ici afin de conserver une implémentation minimale.
Une fois la gestion de l’état prise en charge, le choix spécifique à LangGraph concerne le mode de streaming. LangGraph propose deux options, adaptées à des cas d’usage différents :
- stream_mode="values" fournit des instantanés de l’état du graphe. Plus simple à implémenter, ce mode inclut toutefois un état des messages plus complet dans chaque réponse, ce qui ajoute de la latence aux flux conversationnels en temps réel.
- stream_mode="messages" diffuse des fragments incrémentiels de messages depuis le modèle. Ce mode est généralement préférable pour les interactions vocales en temps réel, car il réduit le délai avant le premier audio dans la couche d’orchestration d’ElevenLabs.
Plus précisément, l’implémentation du mode messages de la boucle d’agent comprend des étapes intermédiaires, telles que les mises à jour liées à l’appel d’outils, qui ne doivent pas être prononcées. Le proxy les filtre et ne transmet que le texte de réponse destiné à l’utilisateur à la couche TTS. Voici un exemple de tour utilisant un outil.
[1] Le modèle décide d’appeler un outil (tool_calls=["get_price"])[2] L’outil s’exécute et renvoie des données (result="$24.99") [3] Le modèle produit une réponse à partir du résultat (content="Cela coûte 24,99 $")
Naturellement, seuls les fragments de l’étape 3 doivent être transmis dans le flux SSE. En pratique, deux vérifications de garde assurent ce filtrage dans la boucle de streaming : l’une ne conserve que les événements langgraph_node == "model", l’autre ignore les contenus vides. Ensemble, elles garantissent que seul le texte de l’assistant destiné à l’utilisateur est transmis à ElevenLabs en SSE. En réunissant ces concepts, nous proposons une implémentation légère du proxy de requêtes.
Cela garantit que seuls les fragments du modèle destinés à l’utilisateur sont transmis à ElevenLabs. Comme LangGraph expose l’exécution interne de ses outils via le flux d’état, le filtrage est explicite et contrôlé par le proxy.
Examinons maintenant les particularités de Google Agent Development Kit (ADK)
Google ADK
L’ADK de Google abstrait la boucle d’exécution derrière quelques primitives essentielles : Agent, Runner et SessionService. Le Runner d’ADK se place entre la couche HTTP et la définition de l’agent. Il gère le routage des messages, l’orchestration des outils, le cycle de vie des sessions et le streaming d’événements.
Une fois l’agent, le backend de session et le runner initialisés, le proxy résout ou crée une session ADK pour chaque requête entrante. Dans ADK, session_id contrôle la persistance de la mémoire : réutiliser le même session_id d’un tour à l’autre conserve automatiquement l’historique, les appels d’outils et les réponses précédentes. L’identité de la conversation étant gérée en amont dans ElevenLabs, le proxy effectue explicitement ce mapping. En transmettant l’identifiant approprié pour la requête de génération, le SDK peut gérer le contexte antérieur en interne. Nous transmettons l’identifiant arbitraire lors de l’initialisation de la conversation via des paramètres supplémentaires transmis dans le corps de la requête.
Une fois le message et la session préparés, le runner peut être appelé. Les appels d’outils et leurs résultats apparaissent toujours comme des événements ADK internes pendant l’exécution, mais sont traités comme des étapes d’orchestration intermédiaires plutôt que comme une sortie destinée à l’utilisateur. Cela évite le recours à un filtre manuel, contrairement aux frameworks où les appels d’outils apparaissent comme du texte visible par l’utilisateur.
Le gestionnaire ci-dessous est une implémentation simplifiée qui inclut directement la résolution de session et la logique de récupération ou de création.
Passons maintenant à CrewAI, dont la conception est davantage centrée sur les tâches.
CrewAI
CrewAI a été conçu pour orchestrer des workflows multi-agents autour de tâches structurées (rechercher, rédiger, résumer), plutôt que des boucles de dialogue ouvertes. Les agents sont définis par un rôle, un objectif et un contexte. L’exécution s’organise autour d’objets Task, chacun doté d’une description claire et d’un résultat attendu.
Contrairement au modèle de boucle d’agent utilisé par LangGraph et ADK, CrewAI construit généralement un Task et un Crew par requête afin de définir l’unité de travail correspondant à ce tour de conversation. Nous conservons le contexte conversationnel en injectant les tours précédents dans la tâche suivante via un espace réservé. La variable {crew_chat_messages} est renseignée à chaque requête avec l’historique continu de la conversation, puis interpolée dans la description de la tâche au moment de l’exécution. Nous visons également un texte propre, prêt à être prononcé, en filtrant explicitement les motifs de traçage intermédiaires (Thought, Action, Action Input, Observation) pour n’émettre que le texte de la réponse finale.
Le gestionnaire ci-dessous réunit la construction des tâches par requête, l’interpolation de l’historique, le streaming au niveau du Crew, le filtrage des traces et le formatage de la sortie.
Examinons maintenant LlamaIndex, qui suit une approche différente, centrée sur un modèle de streaming natif piloté par les événements.
LlamaIndex
Contrairement aux autres frameworks abordés dans cet article, LlamaIndex a été conçu pour connecter les LLM à des sources de données externes (magasins de documents, index, pipelines de récupération). Sa couche d’agent, FunctionAgent, s’appuie sur cette fondation pour récupérer des informations et raisonner sur un contexte structuré, plutôt que pour le dialogue ouvert ou l’exécution de tâches.
Pour préserver la continuité conversationnelle, le proxy transforme les messages entrants en messages de chat LlamaIndex, puis les sépare entre le dernier tour utilisateur (user_msg) et les tours précédents (chat_history). Le champ event.delta de chaque événement AgentStream contient le fragment de texte suivant, qui correspond directement à un fragment delta.content au format OpenAI. Les deltas non vides peuvent être transmis tels quels, ce qui en fait le pont de streaming le plus direct du guide. Le flux contient à la fois des événements d’orchestration (appels d’outils, résultats) et des événements de parole (deltas de texte de l’assistant). Pour garder une sortie vocale propre, le proxy ne conserve que les événements AgentStream et ignore les deltas vides.
[1] AgentStream (delta='') ← ignoré[2] ToolCall ← ignoré[3] ToolCallResult ← ignoré[4] AgentStream (delta='It') ← transmis ✓[5] AgentStream (delta=' costs') ← transmis ✓[6] AgentStream (delta=' $49.99')← transmis ✓
Cette séparation exclut les mécanismes intermédiaires des outils de la sortie prononcée, tout en préservant une parole incrémentielle à faible latence. Le gestionnaire prêt à l’emploi ci-dessous réunit ces étapes.
LlamaIndex est moins prescriptif quant aux modèles d’exécution conversationnelle de bout en bout que les frameworks intégrant des couches d’orchestration plus complètes. Pour les déploiements en production, les clients doivent donc généralement implémenter la gestion des sessions, les garde-fous de réponse, l’orchestration des outils et le traçage.
Conclusion
Chaque framework présenté dans ce guide se connecte à ElevenLabs via le même contrat : accepter une requête Completions ou Responses au format OpenAI et renvoyer des fragments SSE en streaming. Les équipes peuvent ainsi ajouter l’orchestration vocale à une implémentation d’agent existante avec un minimum de modifications, en préservant ce qu’elles ont déjà développé tout en bénéficiant de l’IA conversationnelle en temps réel. Cette modularité est un principe central de la plateforme ElevenAgents. Qu’elles étendent un agent existant ou créent une expérience vocale native dès le départ, les organisations disposent d’une orchestration vocale ElevenAgents conçue pour s’adapter à leur situation.
Si vous utilisez déjà un agent reposant sur un framework open source et souhaitez activer la voix, essayez cette approche et partagez-nous votre avis.
Akhil fait partie de l’équipe Forward Deployed Engineering chez ElevenLabs, où il aide les clients à créer et déployer des agents. Avant cela, il a développé des produits basés sur l’IA pour des équipes GTM et a été ingénieur solutions principal chez Orgvue.


