ElevenAgents 推出实验功能
- 发布时间
收听收听本文
今天,我们在 ElevenAgents 推出了实验功能,可在生产流量上进行 A/B 测试,提前验证方案效果,避免大范围上线带来风险。
随着对话式智能体在支持、销售、运营等高影响场景中应用,细微的配置调整都可能影响业务结果。不同的提示词结构、更优的流程分支、新的音色或更严格的防护措施,都可能影响 CSAT、拦截率、转化率、响应时延和成本。
实验功能为团队提供结构化测试方式,利用真实流量和可量化结果验证配置调整,无需牺牲安全性和可控性。
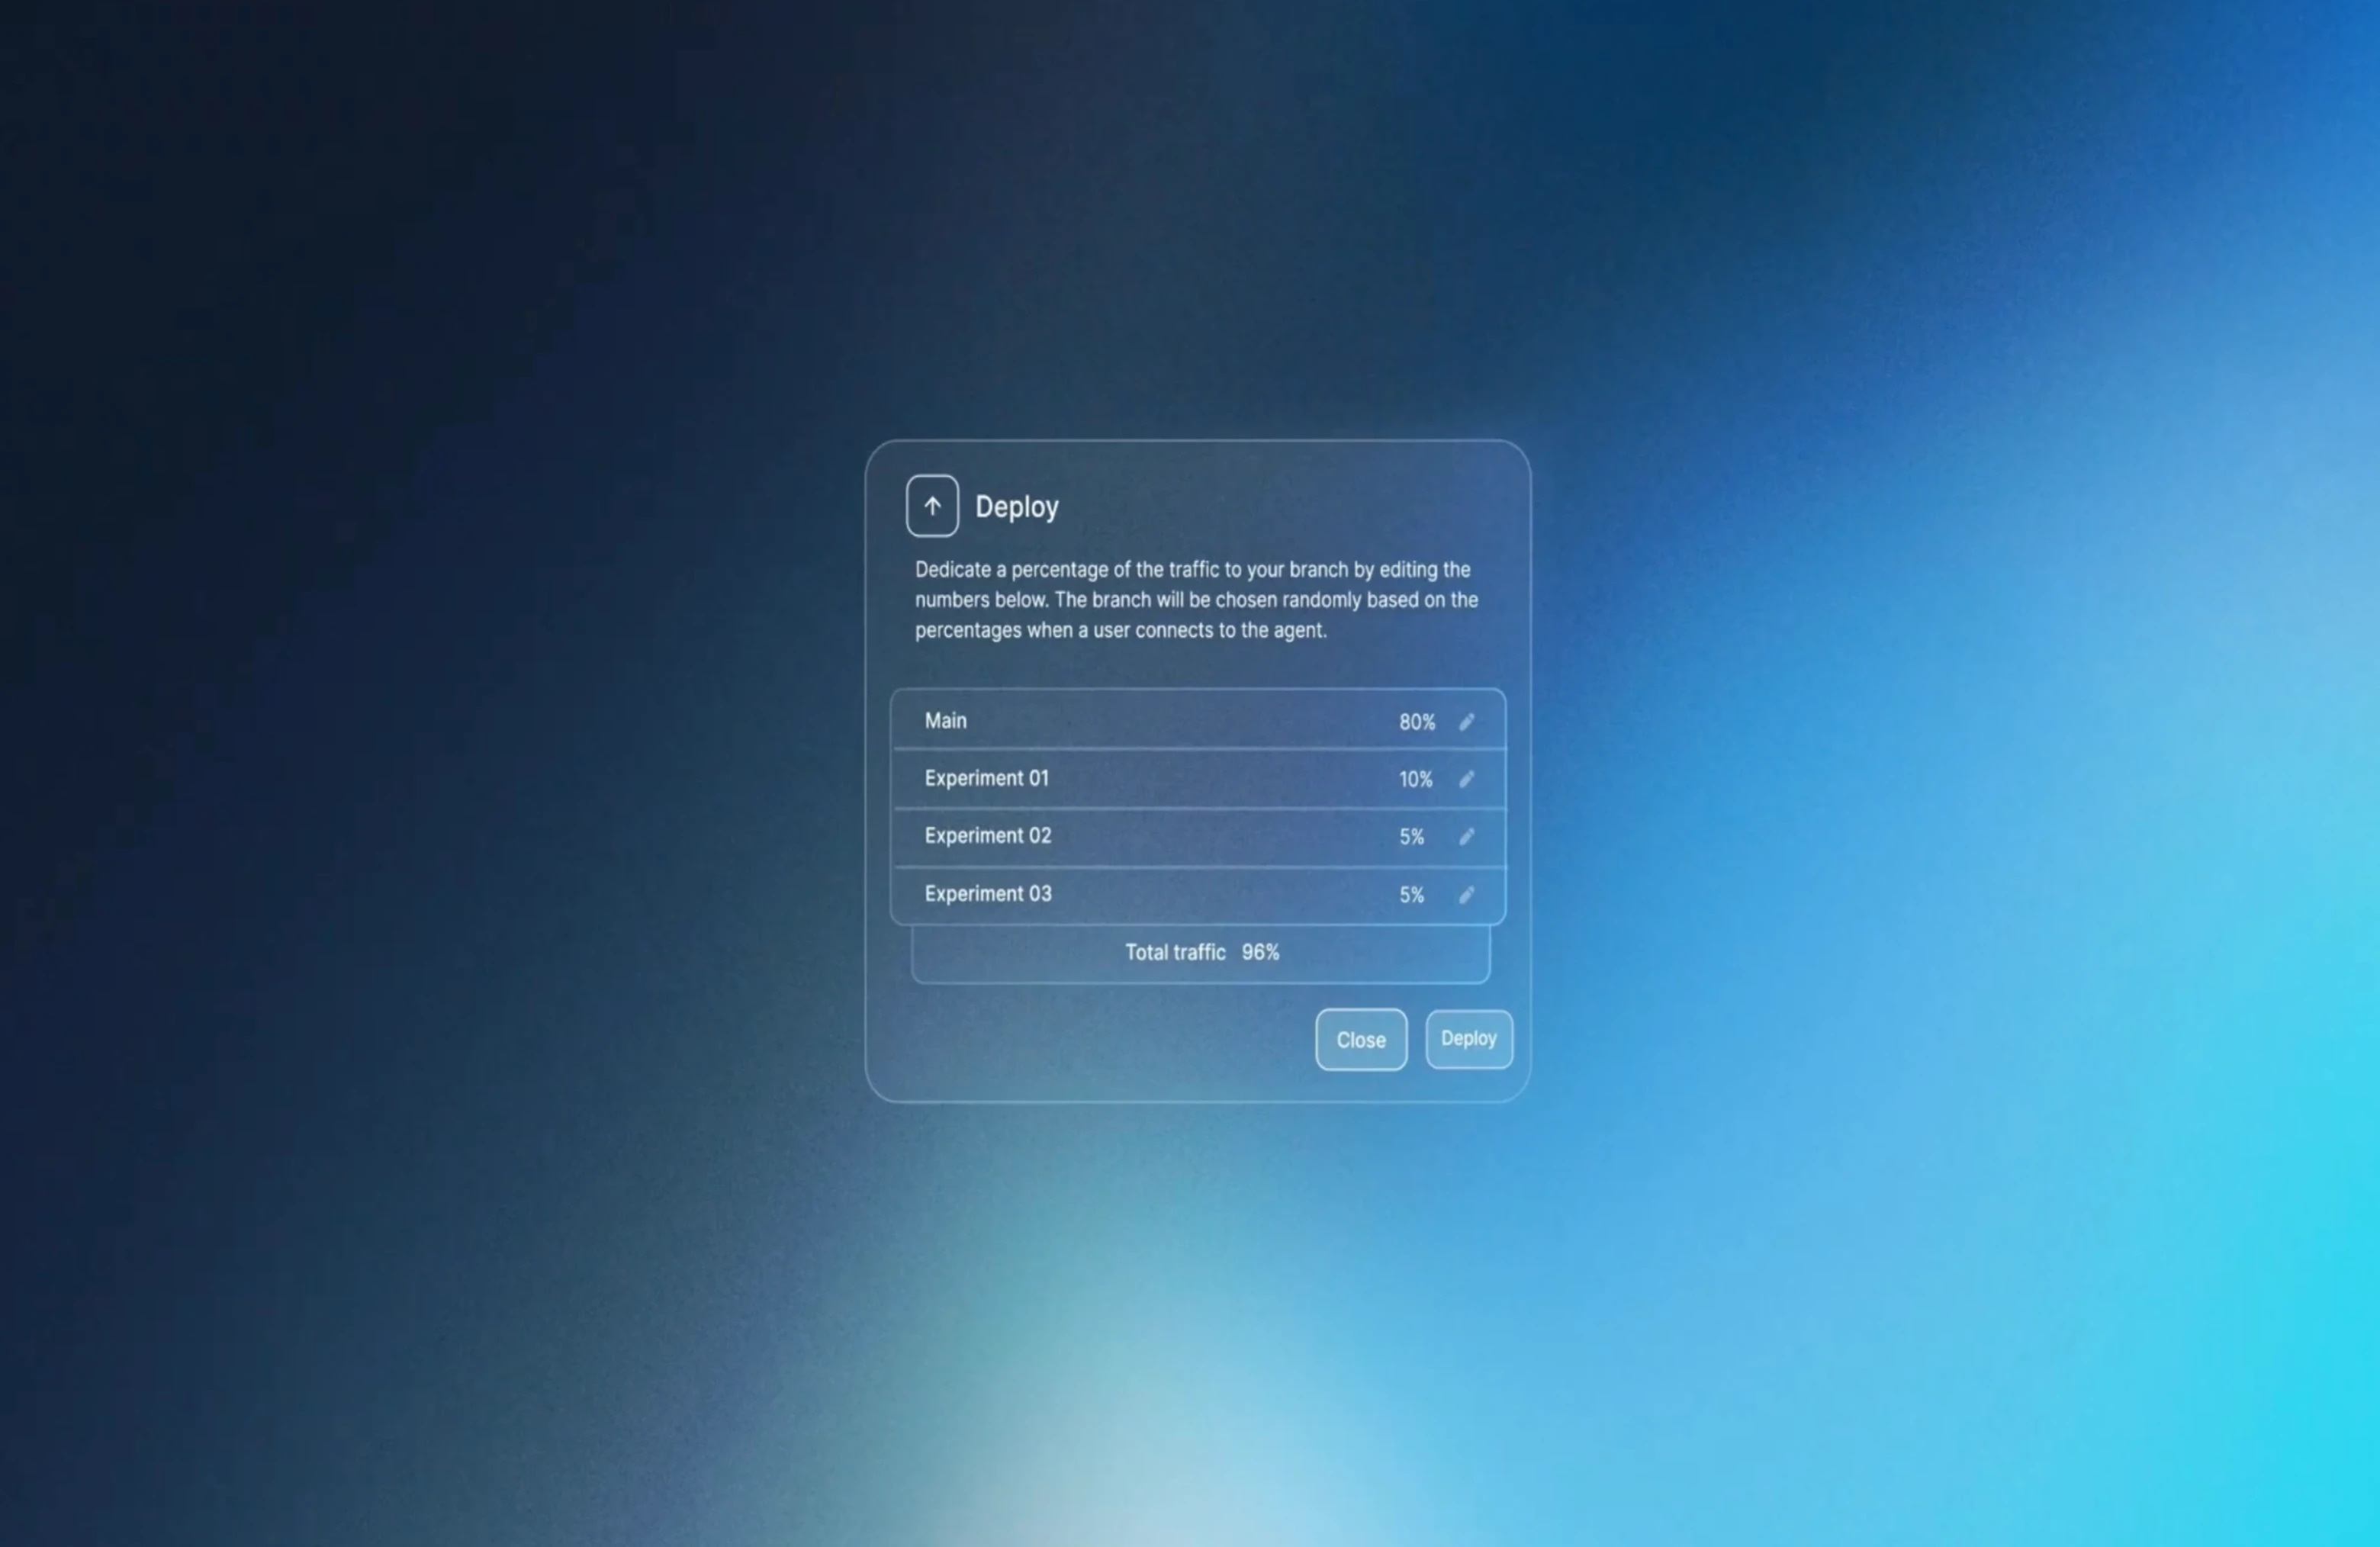
从配置调整到效果提升
没有结构化实验,优化只能靠直觉。提示词微调“感觉”更好,流程调整“应该”提升拦截率,新的升级路径“似乎”更高效。
实验功能用数据替代猜测。团队可引入受控变体,分配给一定比例的真实用户对话,量化业务和运营指标的影响。
这将现代 A/B 测试方法引入对话式智能体,基于生产数据而非主观判断。
实验功能如何运作
实验功能直接集成在 ElevenLabs Agents,流程简单且可审计。
1. 创建新变体
基于现有智能体版本创建变体。
可修改提示词、流程、工具、音色、知识库或防护措施。每项更改都关联到具体的版本配置,差异和归因清晰可查。
2. 分流部分流量
设定多少比例的实时对话分配给新变体。
流量分配受控且可审计,确保测试安全,不影响大多数用户。
3. 按关键指标衡量效果
通过真实生产对话对比各变体表现。
团队可衡量以下结果:
- CSAT
- 拦截率
- 转化率
- 平均处理时长
- 智能体响应中位时延
- 每次智能体解决的成本
测试基于真实流量,结果反映实际用户行为,而非模拟数据。
4. 推广优胜方案
当某个变体效果有明显提升时,可将更多流量迁移到高表现版本。
完整版本历史保留,便于快速回滚。
多团队适用的场景
实验功能支持客户和运营流程的持续优化。
- CX 团队可测试升级流程优化是否提升 CSAT 且不增加处理时长。
- 营收团队可测试更直接的话术或不同筛选逻辑是否提升转化率。
- 运营团队可衡量工具逻辑调整是否降低平均处理时长或基础设施成本。
每个实验都关联到具体智能体版本,确保每次性能变化都可追溯到明确的配置调整。
企业级设计
实验功能基于 ElevenLabs Agents 的版本管理和审计机制构建。
每个实验包含:
- 受控、可审计的流量分配。
- 与具体智能体版本的清晰归因。
- 结构化回滚机制。
- 完整对话历史与版本状态关联。
这样团队可在合规、可追溯和治理的前提下高效推进。
无需在速度和可控性之间取舍,两者兼得。
对话式智能体的持续优化
对话式智能体不应一成不变,应随着团队对生产数据的学习持续优化。
通过这一流程,团队可系统迭代、量化效果,自信部署更高效的对话式智能体。
团队现在可用真实生产数据自信配置、部署和优化高性能对话式智能体。
了解更多:https://elevenlabs.io/docs/eleven-agents/operate/experiments
Kacper Walentynowicz is a full-stack engineer working on the ElevenLabs Agents Platform. Before ElevenLabs, he worked at Two Sigma and Huawei, and has been coding since 2012. Kacper represented University of Cambridge at ICPC and won a silver medal.