我们如何借助 ElevenLabs Agents 扩展客户访谈流程
- 发布时间
我们使用 ElevenLabs Agents 访谈了超过 230 位 ElevenReader app 用户。
本文将分享我们如何构建这款语音智能体、此次生产测试的结果,以及如何用这些工具改进产品。
规模化的挑战
我们重视客户访谈,但要实现规模化并不容易。一次典型的 15 分钟实时访谈能带来宝贵洞察,但每天安排多场访谈在协调上很有挑战。
日程很难匹配,小团队几乎无法用数十种语言服务全球用户——全天候进行深度对话存在客观限制。
问卷虽然更易规模化,却常会丢失信息。它将反馈简化为多选项,忽略一对一对话中的情感与细微差别。随着语音 AI 和 LLM 的进步,我们如今可以弥合这一差距。
我们借助 ElevenLabs Agents 构建了 AI 访谈员,通过真实对话收集用户反馈。不到 24 小时内,我们完成了超过 230 场访谈,并已根据这些客户洞察改进 app。

创建 AI 访谈员
我们使用 ElevenLabs Agents 平台创建了一名对话式研究员。目标是了解 ElevenReader app 用户在以下 4 个主要方面的看法:
- 功能需求与改进
- 主要使用场景
- 竞品对比
- 定价与品牌价值
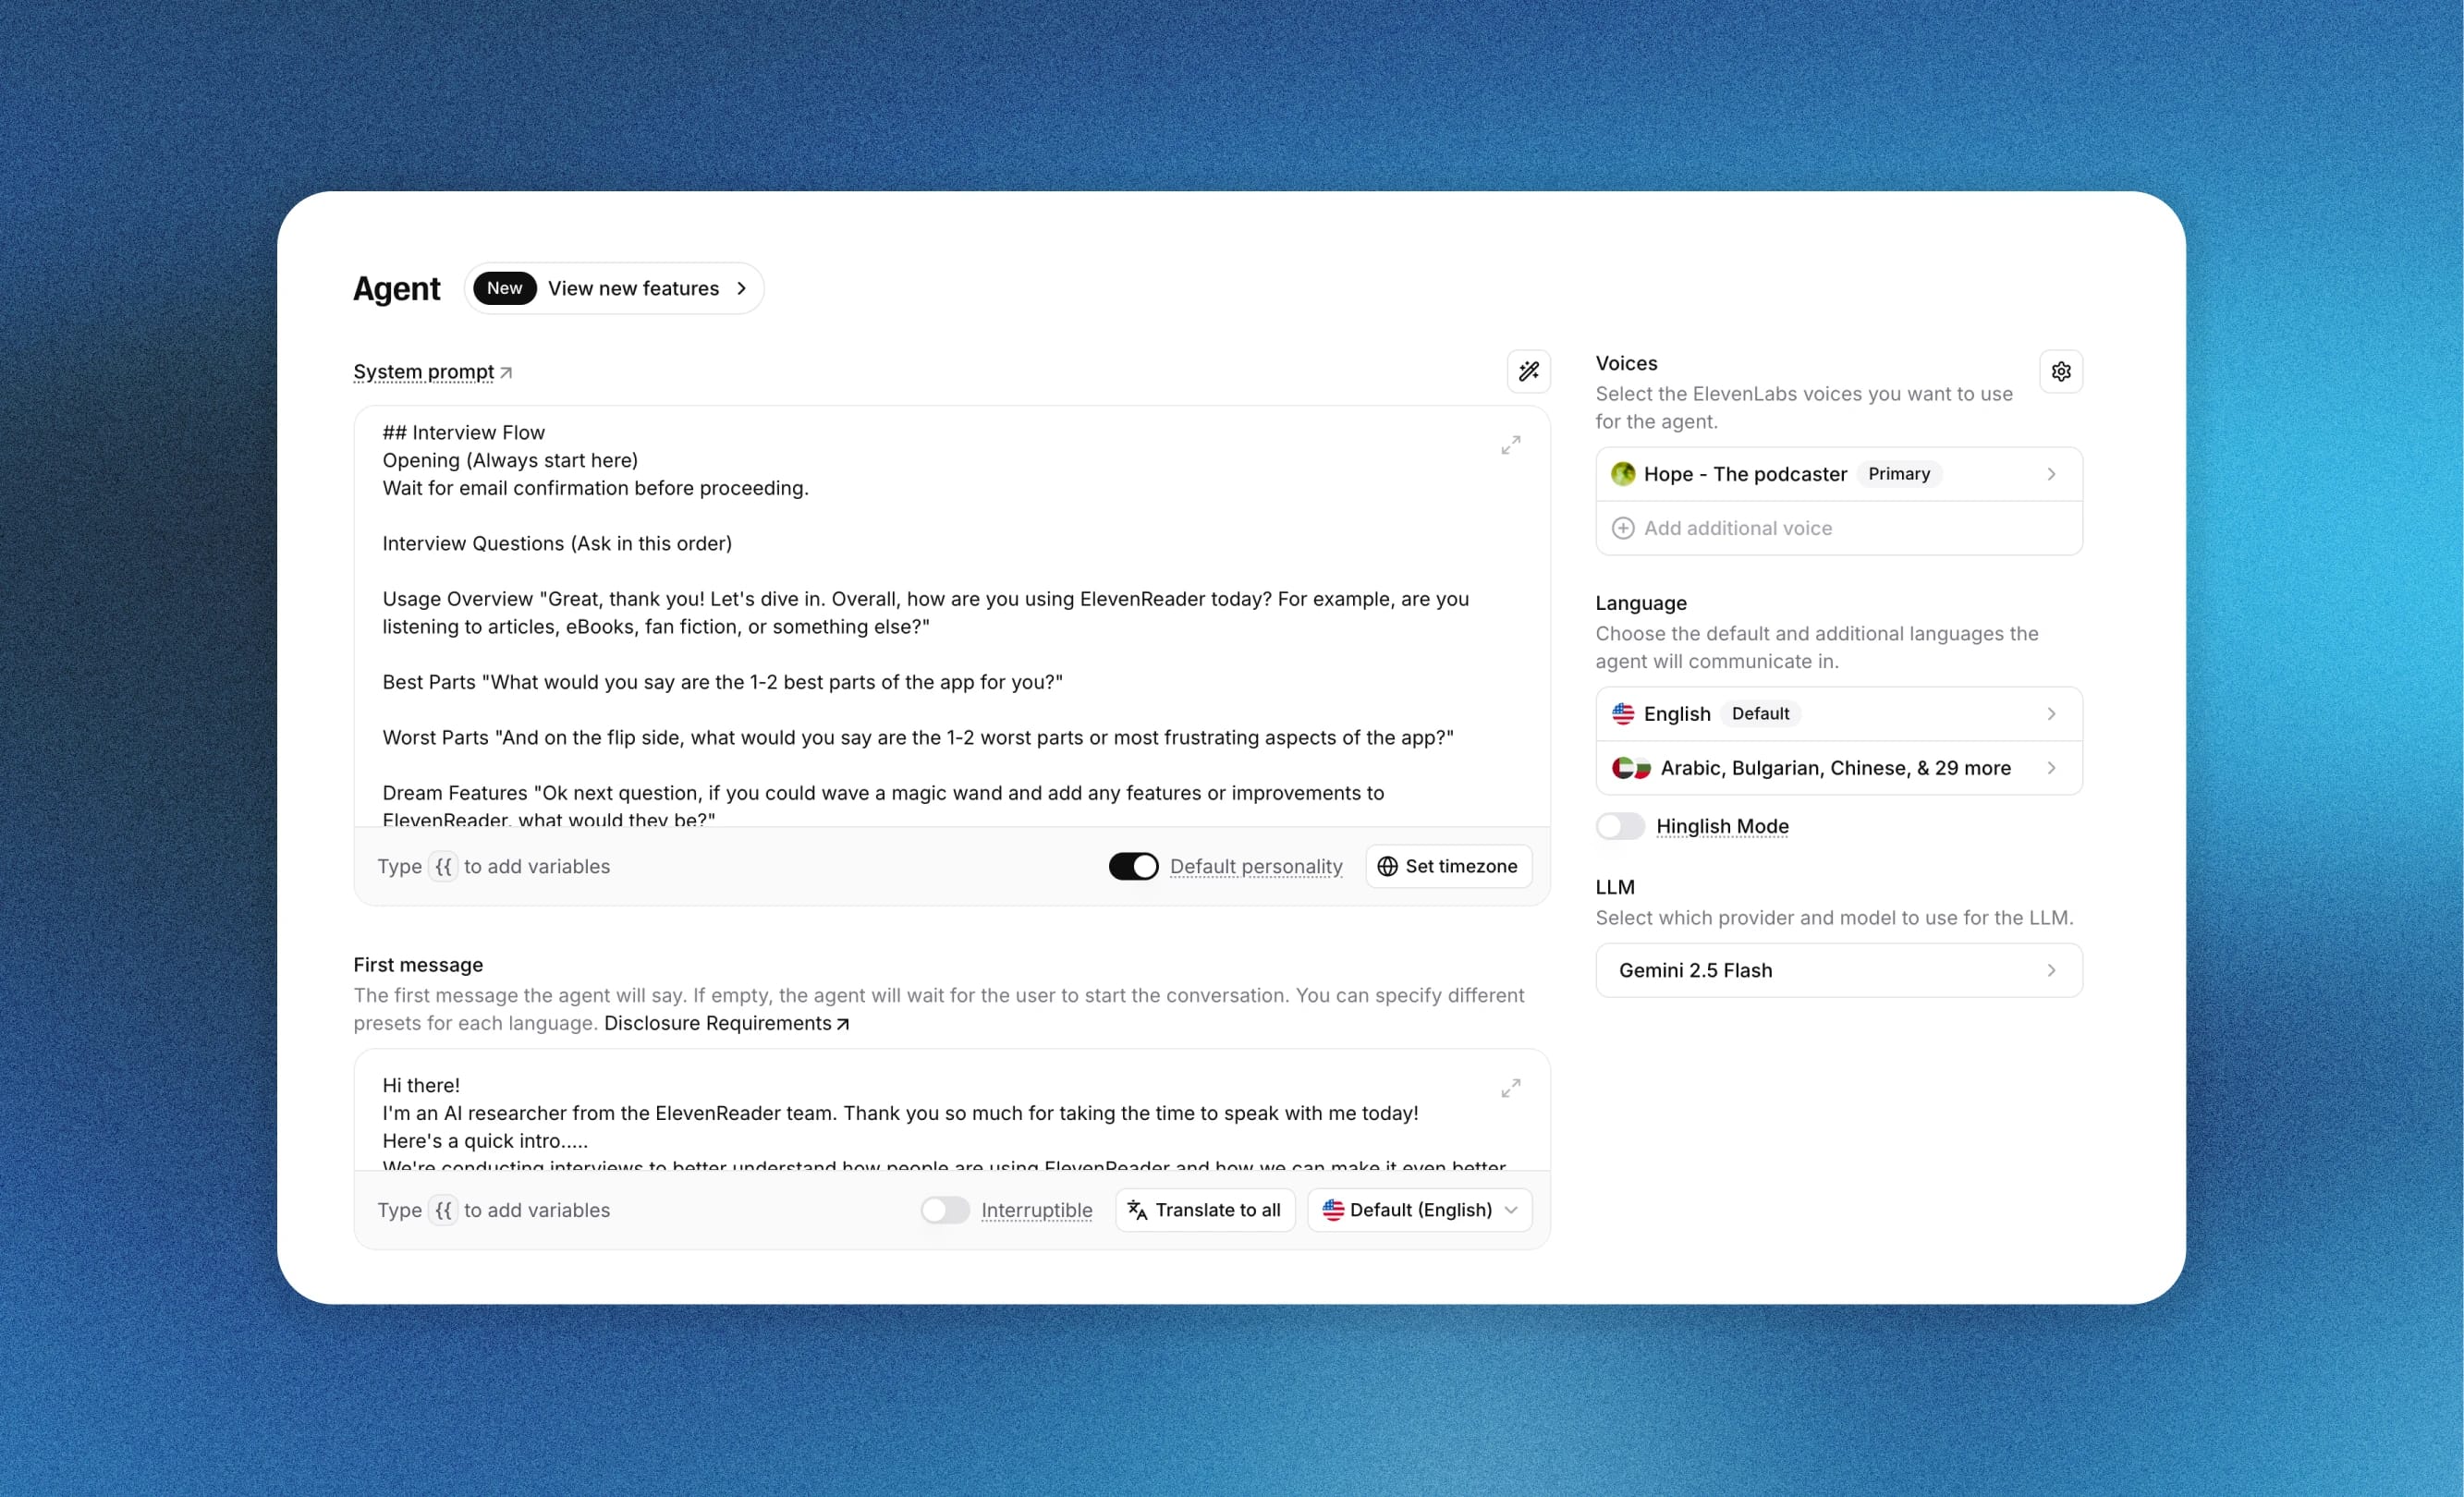
我们选择了音色“Hope - The podcaster”,它的语气友好、自然,就像与一位善解人意的研究员面对面交谈。逻辑模型则选择了 Gemini 2.5 Flash,以平衡低延迟与高智能。
提示词与防护机制
我们编写了系统提示词,指导智能体通过追问获取更深入的洞察,同时让对话不偏离主题。如果用户回答模糊或只有一个词,智能体会引导其提供更详细的反馈。发布前,我们使用 ElevenLabs 模拟测试,确保智能体能处理模糊回答或不当语言等边缘情况。
查看这里,了解我们使用的系统提示词。
数据收集
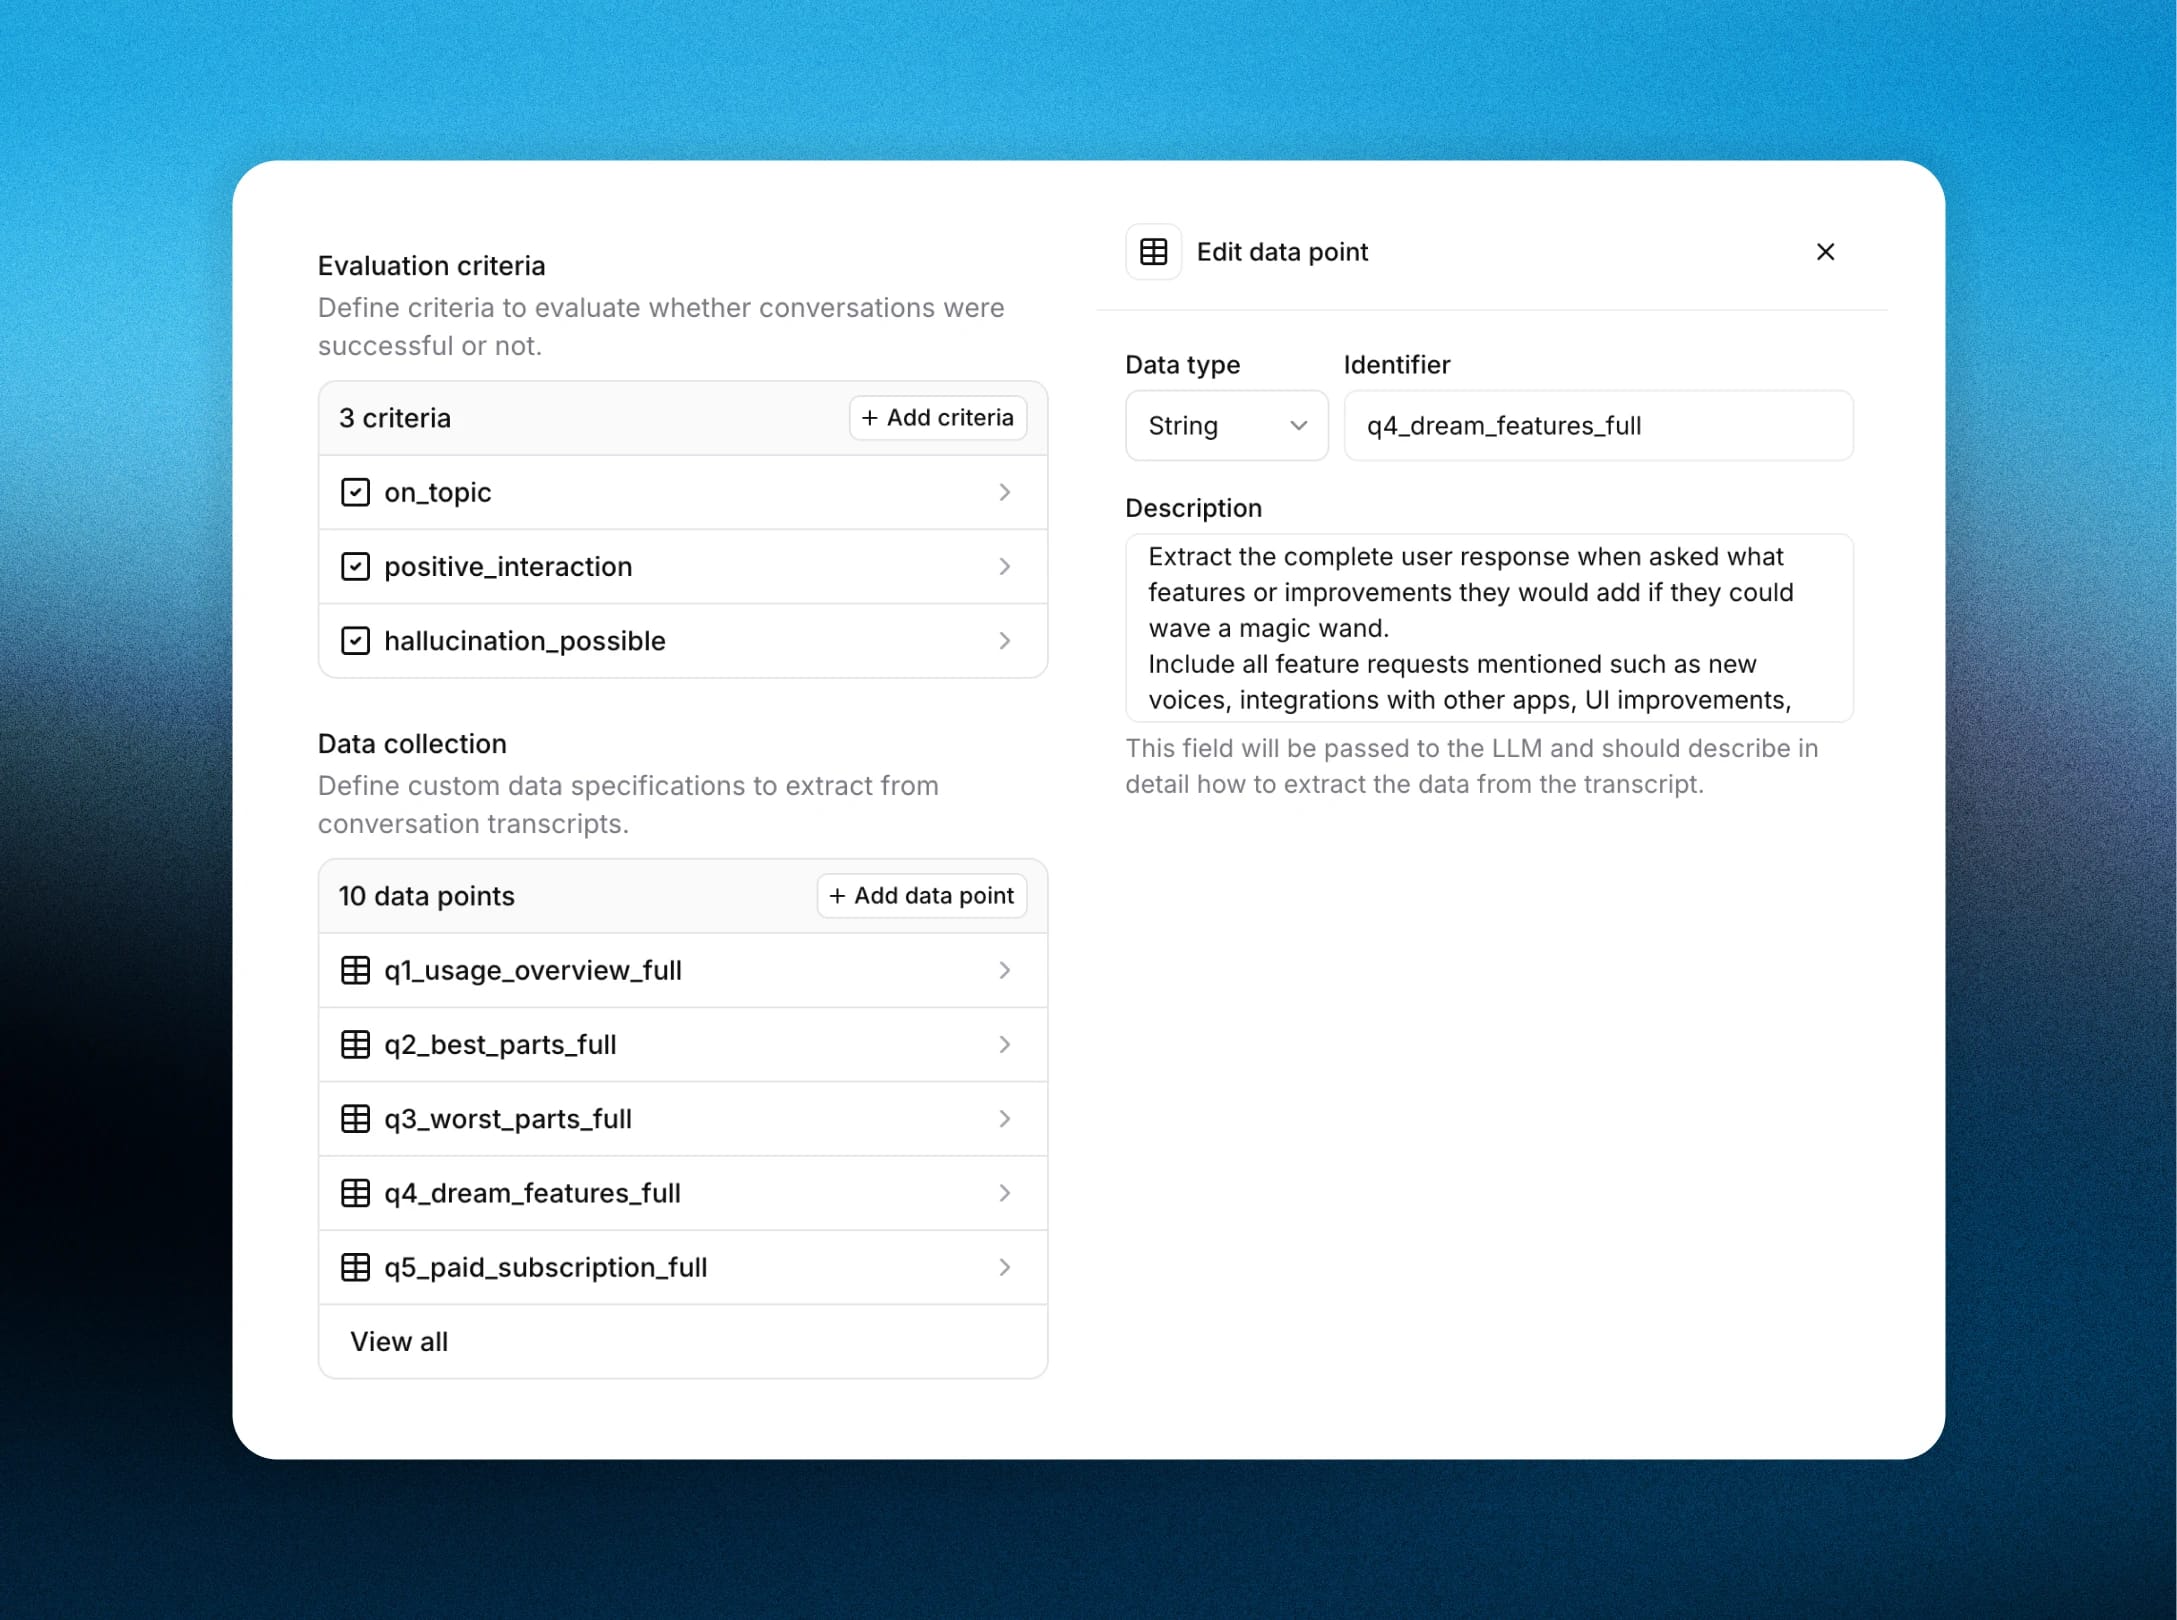
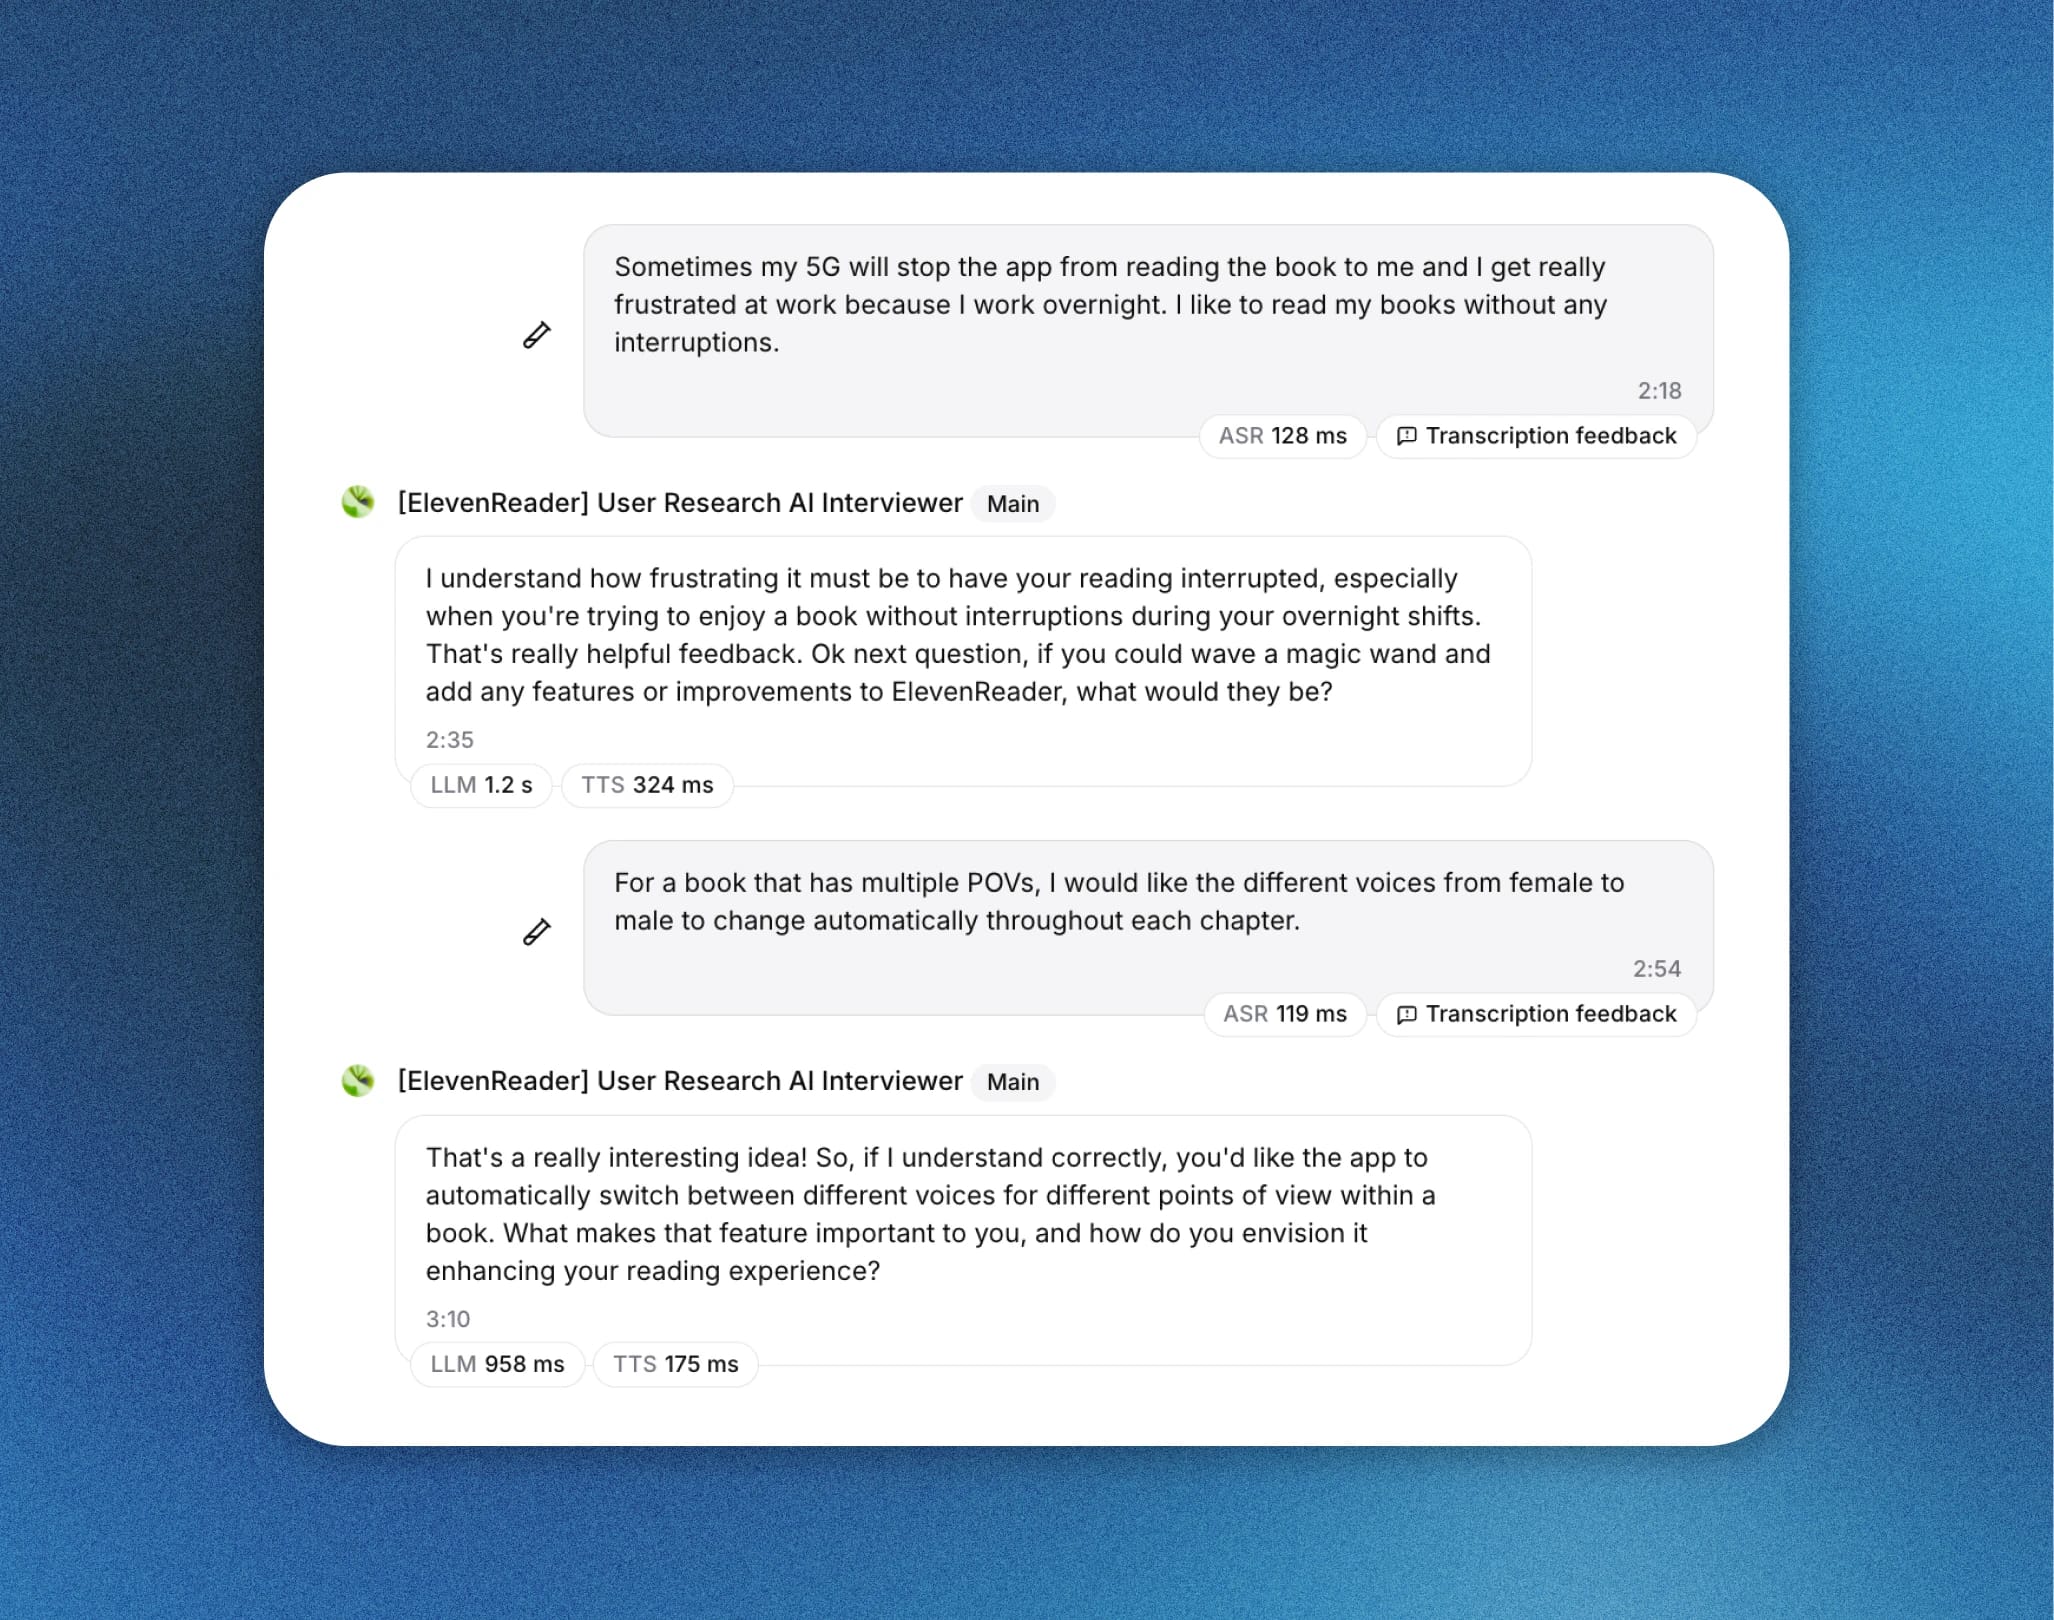
我们使用 ElevenLabs Agents 中的 Analysis 功能评估每通电话。该工具可从转录文本中提取结构化数据,将开放式对话转化为可落地的洞察。例如,我们可以自动追踪以下问题的回答:
- “你目前主要如何使用 ElevenReader?”
- “你会从哪两方面改进这款 app?”
智能体会在 10 分钟后使用 end_call 工具结束对话,并礼貌感谢用户抽出时间。
结果
在 24 小时内,我们收集了超过 36 小时的对话时长。
- 成功率: 85% 的通话成功完成且未偏离主题。
- 参与度: 通话时长中位数为 10 分钟(允许的最长时长)。
- 深度: 一场对话包含 87 条消息,中位数为 25 条消息。
- 成本: 每通 10 分钟电话成本略低于 $1.00,即每分钟 9 美分,均通过 ElevenLabs Agents
分析数据
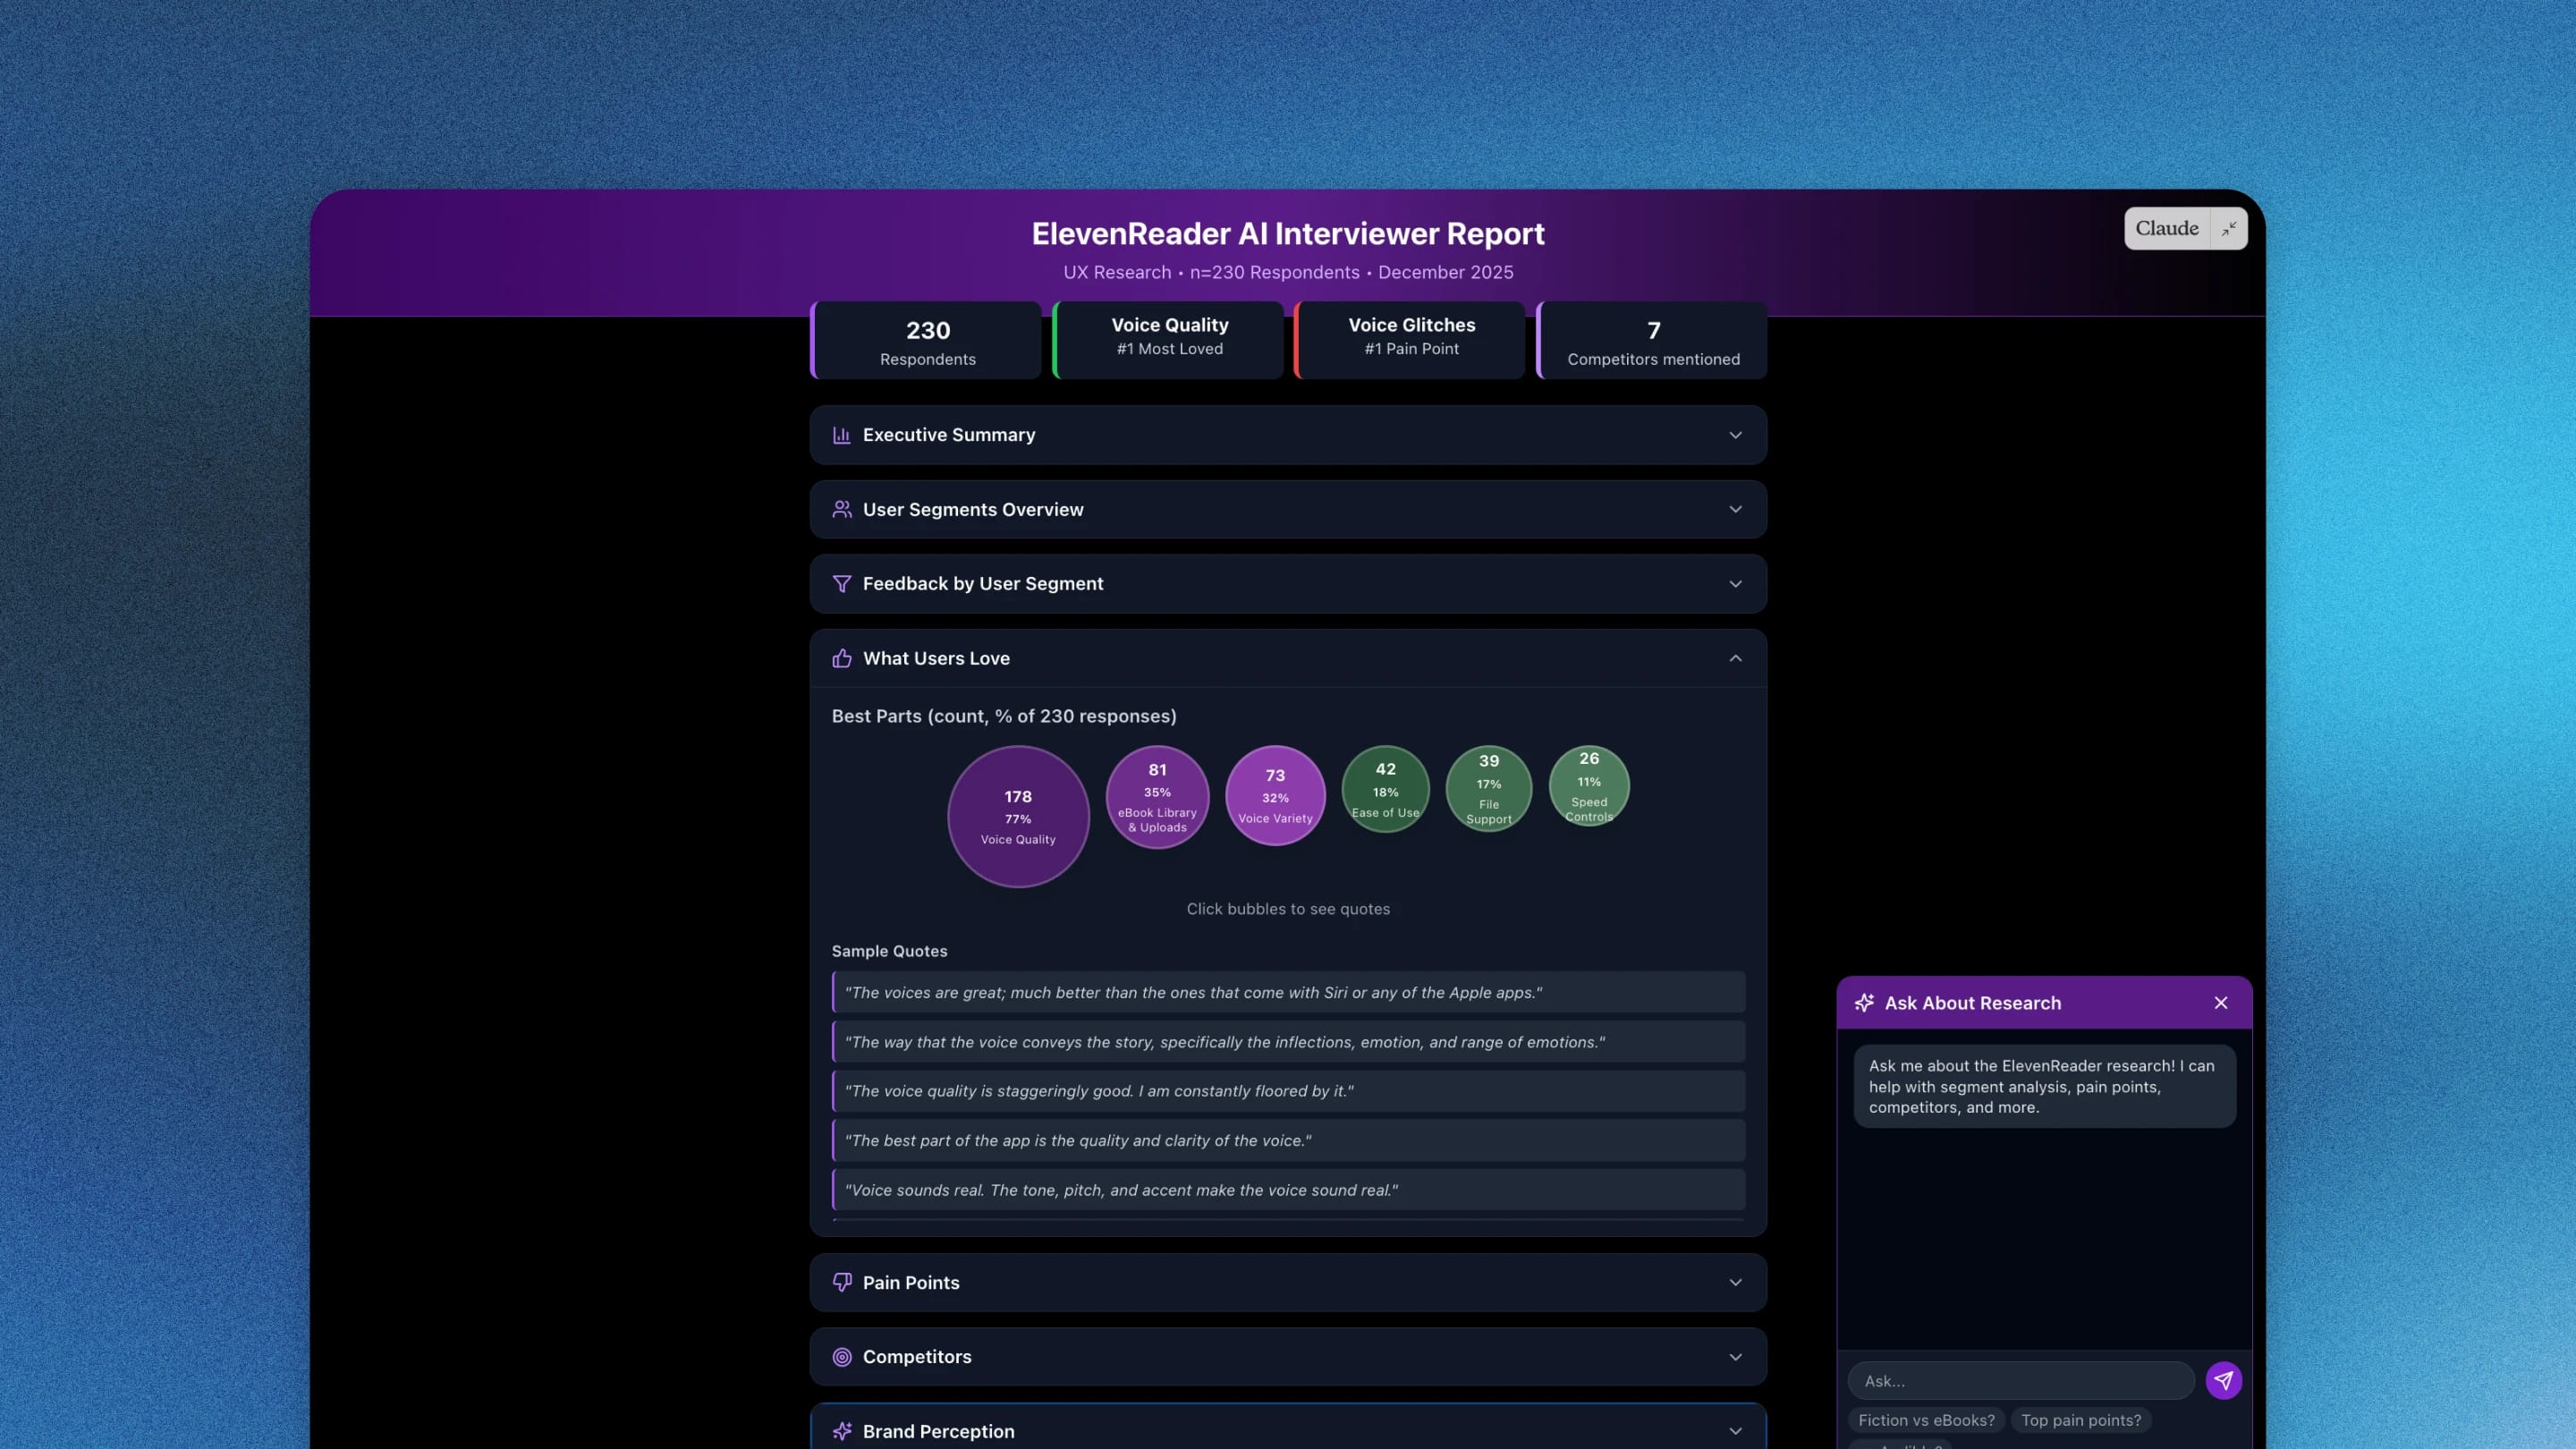
我们使用 Claude Opus 4.5,基于 UX 研究原则分析这 36 小时的转录文本,找出趋势与洞察。
模型提供了高层主题后,我们通过额外提示词细化分析,挖掘用户细分、导航反馈、不同地区的价格敏感度等具体洞察。
为在内部分享这些结果,我们用 Claude 创建了交互式分析页面。团队现在可以点击具体数据点,查看支撑趋势结论的准确用户引述。
主要发现
用户乐于与 AI 交谈——近 95% 的受访者直接与访谈员互动,并未意识到它是对话式智能体。一位用户表示:
“这是我体验过最令人惊叹的 AI 客服访谈。我希望所有问卷都能这样,也希望所有数字化客服服务都能这样。”
我们了解到:
- 细分需求: 21% 的 ElevenReader 小说读者希望支持多角色对话,这一比例远高于其他用户群体。
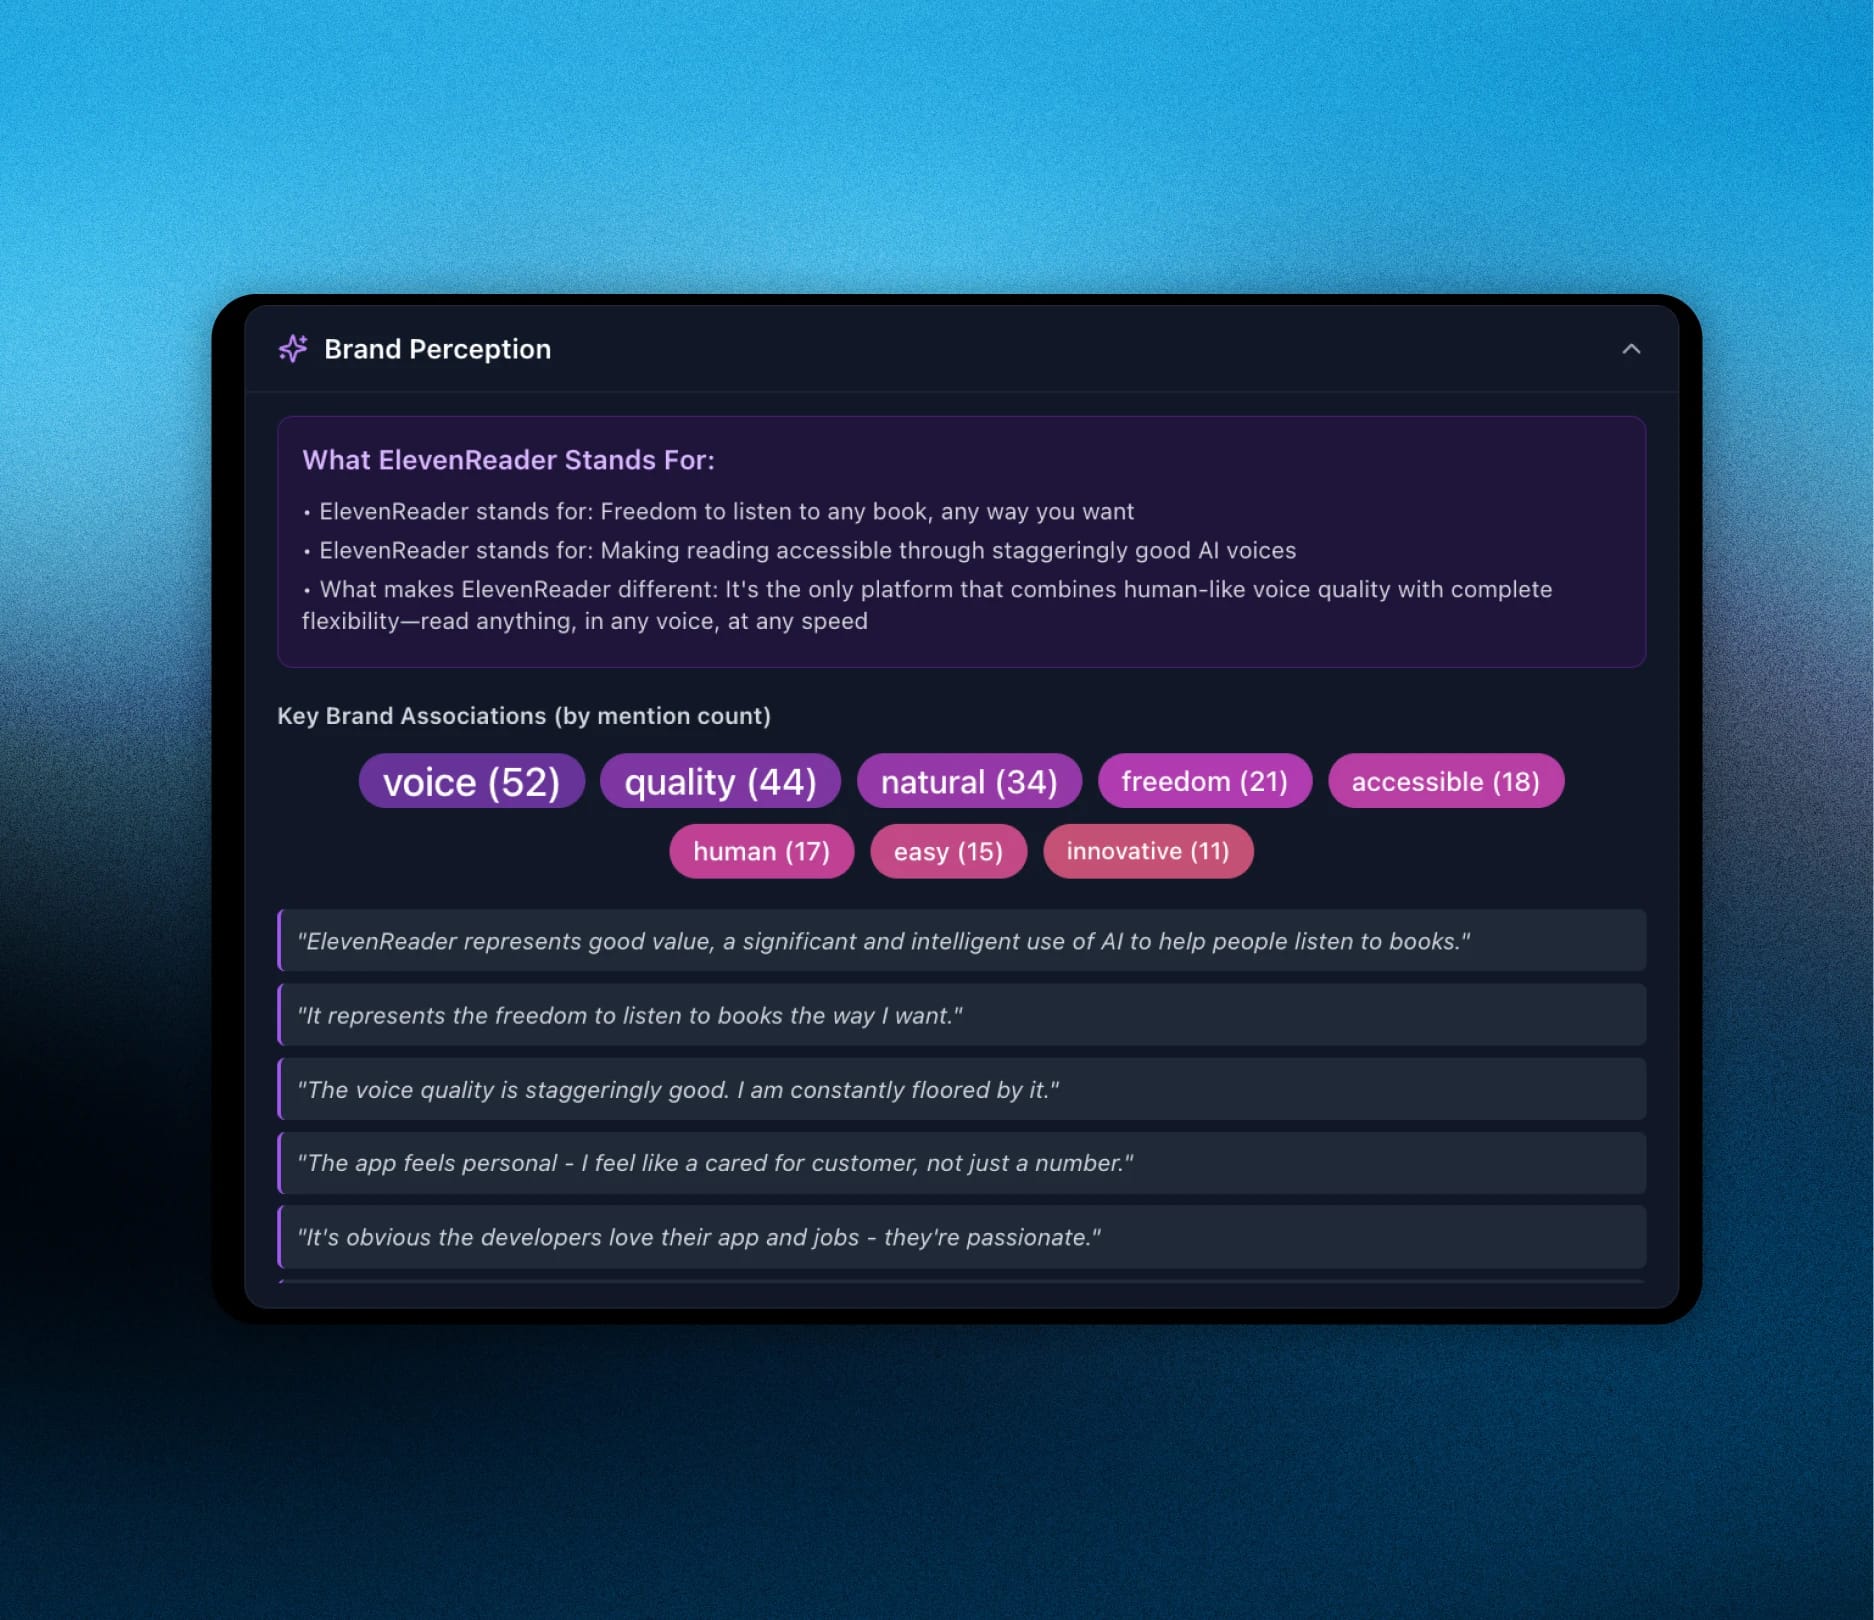
- 品牌价值: 用户认为 ElevenReader 能让他们随时随地自由聆听任何书籍,并提供最自然的语音质量。
- 语言需求: 用户发现这款 app 的 文本转语音(TTS)模型有时会混淆语言和口音——这是明确的改进方向。
- 漏洞报告: 访谈发现了一些具体问题,工程团队在次日便完成修复。
未来启示
用户研究的未来是对话式的——AI 语音智能体 让你能在全球范围内,按用户自己的时间与他们倾听和交谈。
此次测试表明,AI 智能体可以真实、可靠地大规模开展深度访谈。结合 LLM 的文本分析,这些对话揭示了数百份回答中的模式——这些洞察很难通过人工发现。