
Att mäta Conversational AI: viktiga nyckeltal för framgång
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Conversational AI-verktyg sänker kostnaden för kundsupport dygnet runt avsevärt. Det gör de utan att behöva bemanna nattpass eller ta de dataskyddsrisker som följer med att outsourca roller utomlands.
Men kostnadsbesparingar spelar bara roll om en AI-agent kan lösa kundernas problem. Genom att mäta Conversational AI med rätt nyckeltal ser du om det fungerar, särskilt i företag som hanterar stora mängder kundfrågor.
Den här artikeln beskriver hur utvärdering av samtalsflöde och svarens korrekthet skyddar både kundupplevelsen och ditt varumärke. Vi förklarar hur kundupplevelseteam genomför effektiva A/B-test av inledande hälsningar. Du får också lära dig hur du upprätthåller en tillförlitlig, flerspråkig Conversational AI-plattform.
Sammanfattning
- Systematisk mätning av Conversational AI utifrån kvalitets-, upplevelse- och driftsmått ger dig den data som behövs för att skydda kundupplevelsen.
- Automatiserade utvärderingsverktyg följer kontinuerligt upp och förbättrar mått för Conversational AI i stor skala, medan medarbetare utför regelbundna stickprovskontroller.
- När du isolerar en specifik variabel i taget i A/B-test blir det lätt att fastställa exakt vad som gick fel, så att du kan införa åtgärder som direkt riktar in sig på de identifierade problemen.
- Kontinuerlig förbättring är nödvändig eftersom AI-företag ofta uppdaterar de underliggande modellerna, vilket ofta gör att tidigare tillförlitliga chattbotar beter sig annorlunda i produktion.
Vad det innebär att mäta Conversational AI och varför det är viktigt
Att mäta Conversational AI innebär en systematisk utvärdering av hur väl dina testade eller driftsatta AI-agenter hanterar kundförfrågningar och löser problem. Målet är att avgöra hur effektivt dina automatiserade system hanterar fleromgångssamtal i verkligheten, utifrån de prestandakrav du ställer. Dessa krav speglar vanligtvis hur väl modellerna förstår användarens avsikt, håller sig till varumärket, ger korrekta svar och lyckas lösa problemet.
Modellutvärderingar kan verka som mycket extraarbete för ett system som ska minska teamets arbetsbörda. Men utan konsekvent utvärdering är det svårt att veta hur väl modellen fungerar i verkliga användningsfall. Med andra ord vet du att ditt AI-system minskar driftkostnaderna för kundsupporten, men kan du bekräfta att kunderna blir nöjda i stället för att söka andra lösningar?
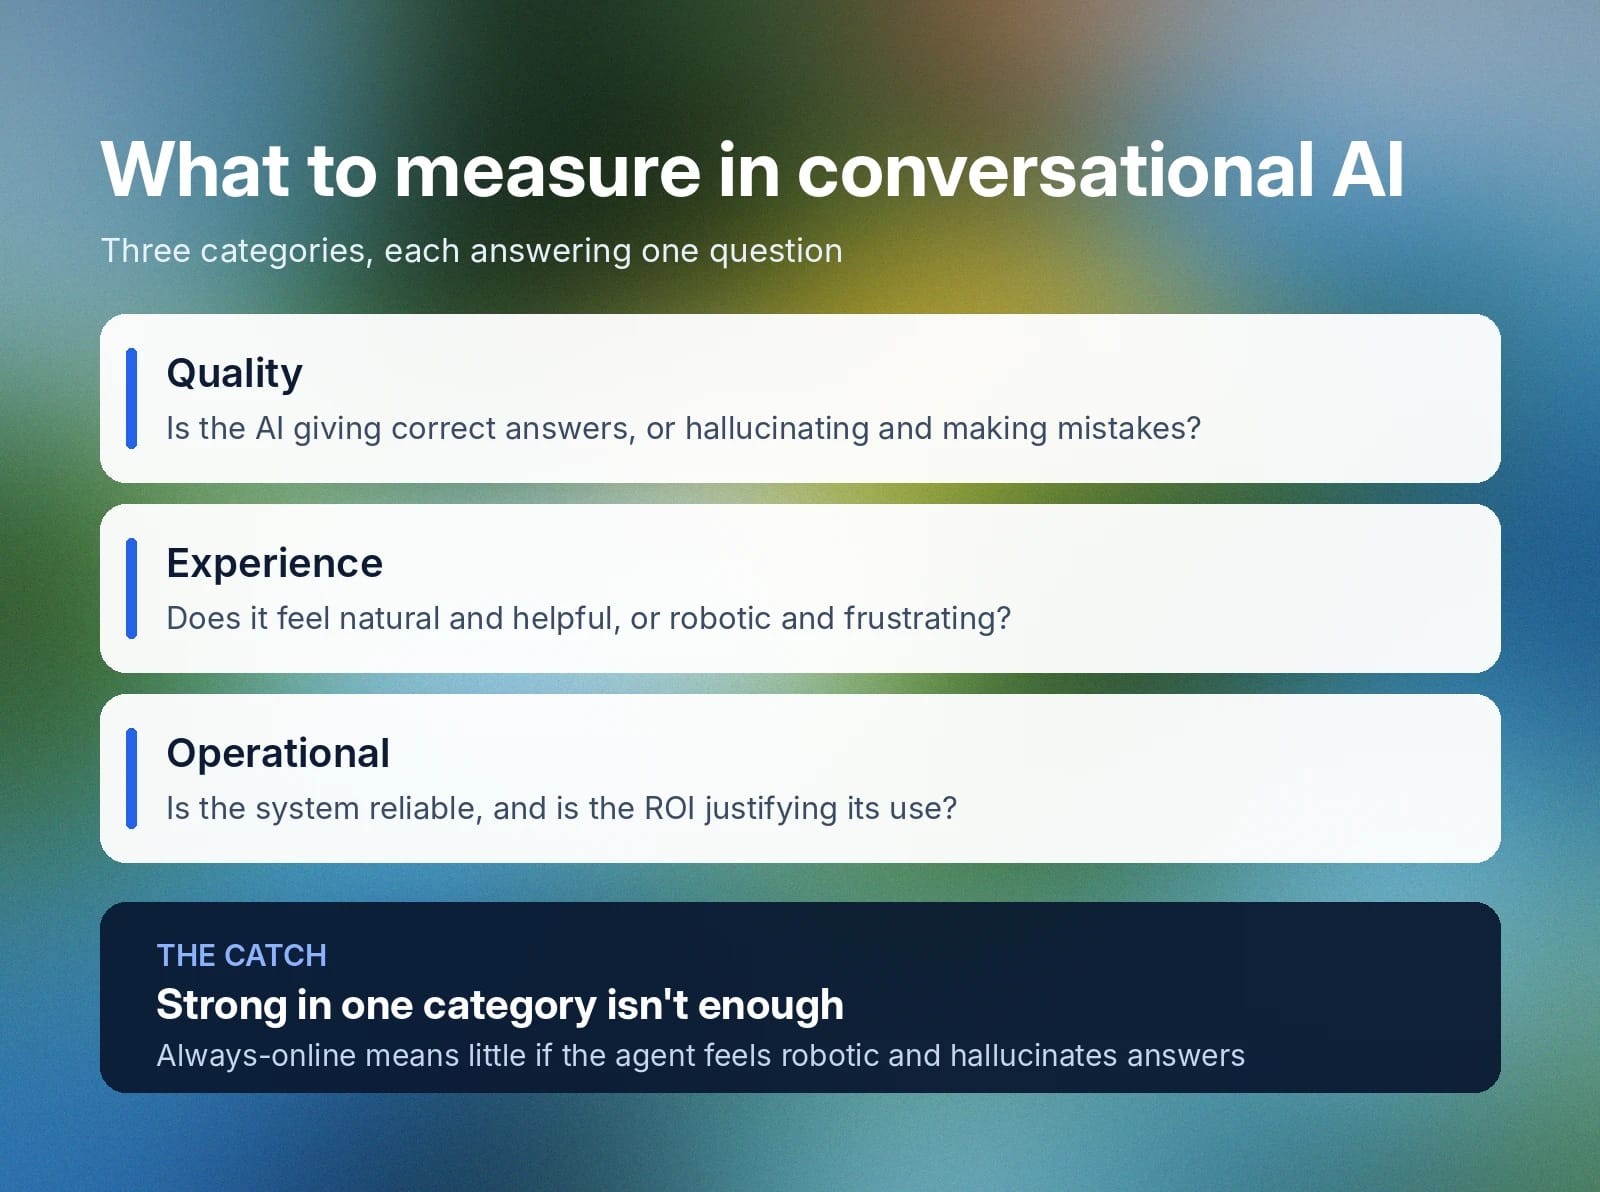
En heltäckande mätning kräver att modellen granskas utifrån tre huvudkategorier:
- Kvalitet: Bedöm hur korrekta, sammanhängande och relevanta AI:ns svar är utifrån användarens första förfrågan. Huvudfrågan är: Gör AI:n rätt och ger användarna korrekta svar, eller hallucinerar den och gör misstag?
- Upplevelse: Utvärdera kundupplevelsen, till exempel om AI:n svarade snabbt och hur många turer den behövde för att ge ett tillfredsställande svar. Huvudfrågan är: Känns upplevelsen naturlig och hjälpsam för användaren, eller robotlik och frustrerande?
- Drift: Avgör om systemet fungerar tillförlitligt och förblir en kostnadseffektiv lösning för dina kundsupportbehov. Vanliga frågor är: Har systemet hög tillgänglighet och ger det den avkastning som krävs för att motivera användningen?
Framgång ser olika ut för varje team, och era ursprungliga problem innan ni automatiserade supporten spelar stor roll. Om teamet till exempel från början hade svårt att erbjuda support dygnet runt kundsupport, kan AI-agenternas tillgänglighet dygnet runt enkelt förbättra kundsupportens resultat. Samtidigt är alla dessa kategorier viktiga för den övergripande framgången. Ett system som alltid är online och sällan kraschar hjälper alltså inte kunderna särskilt mycket om det känns robotlikt och hallucinerar svar.
Viktiga mått för Conversational AI att följa
Följ tydliga och handlingsbara siffror för att bedöma agenternas prestation med kunder och om din nuvarande implementering skapar verkligt affärsvärde. Löpande utvärdering banar också väg för regelbundna förbättringar. När du kan fastställa var det finns flaskhalsar i workflowet eller var justeringar behövs, har du data för att effektivt åtgärda grundorsaken.
Använd dessa mått för Conversational AI som utgångspunkt när du utvärderar röstsamtal och chattbotars prestanda:
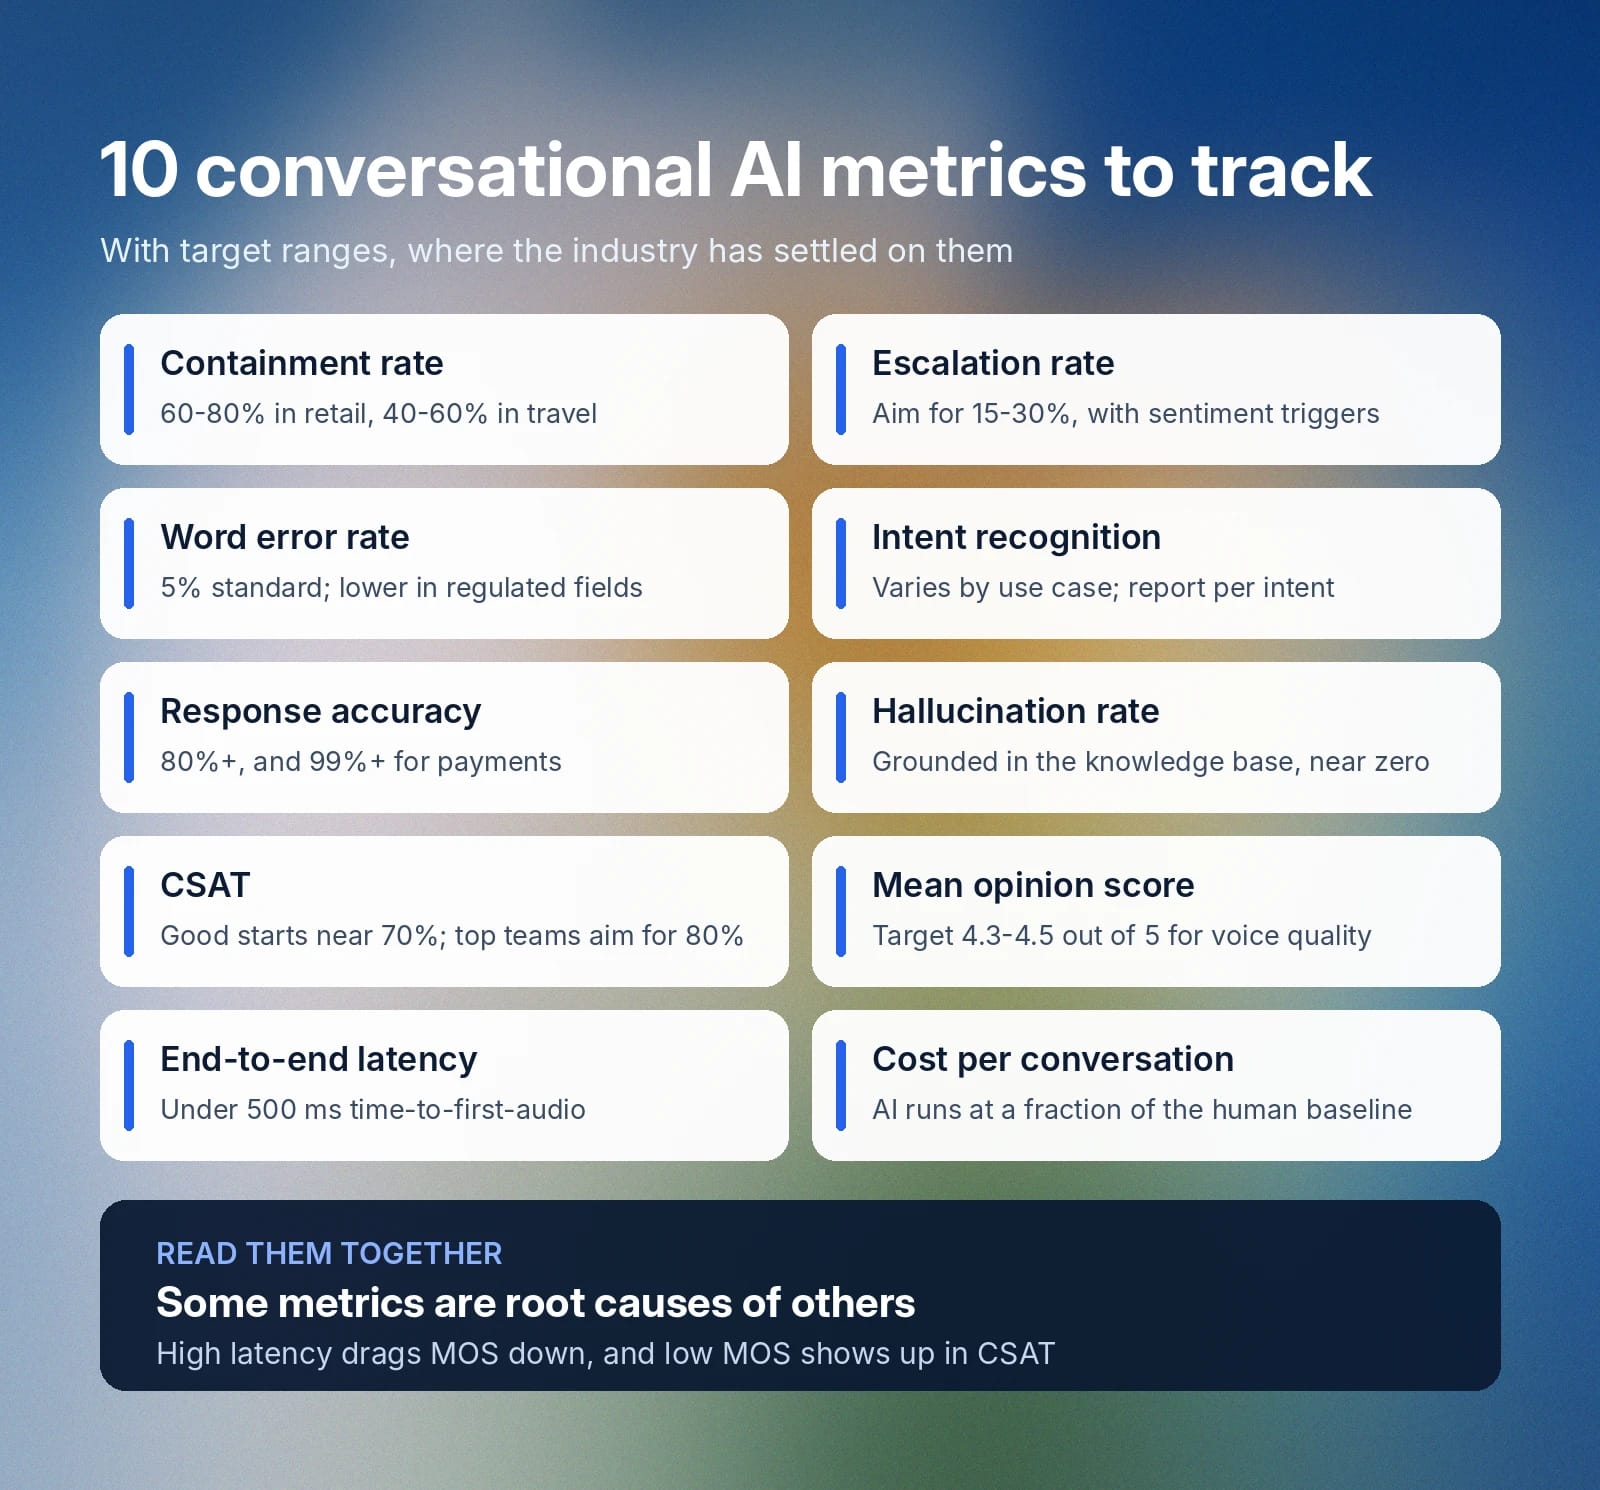
- Lösningsgrad i den automatiserade kanalen: Följ andelen förfrågningar som löses helt inom den automatiserade kanalen. Målen varierar mellan branscher, sammanhang, användningsfall och bottype. Till exempel är 60–80 % ganska standard inom detaljhandeln, medan siffrorna ligger mellan 40–60 % för resesajter.
- Eskalationsgrad: Mät hur ofta AI-agenter hanterar samtal utan att eskalera dem till en människa. Proaktiva företag sätter automatiska trösklar för att överföra samtal till människor så snart sentimentet blir negativt. En bra eskalationsgrad varierar beroende på bransch och uppgiftens komplexitet, men sikta på 15–30 %.
- Ordfelfrekvens (WER): Följ hur väl AI:n korrekt ”hör” ord under ett samtal eller i en transkribering. En bra branschstandard är 5 %, men du behöver lägre WER för användningsfall i reglerade områden eller som hanterar känslig information, till exempel hälso- och sjukvård, finans och juridik.
- Träffsäkerhet i avsiktsigenkänning: Utöver enskilda ord börjar en AI-agents framgångsrika prestation med att den korrekt förstår användarens problem och behov. Noggrannhetsmålen varierar beroende på användningsfall och mellan kategorier för enskilda avsikter.
- Svarskorrekthet: Avgör hur tillförlitligt modellen ger sanningsenliga och meningsfulla svar. Det är avgörande för att kunderna ska kunna lösa sina problem. Allmänna kundservicefrågor kräver 80 % eller mer, medan känsliga användningsfall, såsom betalningar, kräver 99 % eller mer.
- Hallucinationsfrekvens: Även om den är nära kopplad till svarskorrekthet avser hallucination specifikt svarens faktamässiga korrekthet utifrån kunskapsbasen. Låg hallucinationsfrekvens är avgörande för att vara hjälpsam och för att säkerställa att modeller inte ger löften som företaget inte kan hålla.
- Kundnöjdhet (CSAT): Samla in kundernas sentiment med enkäter efter samtal för att fastställa nöjdheten. Företag samlar in denna data på en femgradig skala, men uttrycker ofta resultaten i procent. Enligt SurveyMonkey börjar bra CSAT-resultat vanligtvis runt 70 %, medan vissa företag siktar på 80 % eller mer.
- Mean opinion score (MOS): Detta människocentrerade mått använder också en femgradig skala, men syftet är att mäta hur naturligt AI-svaret låter och hur tydlig den syntetiska rösten är. Sikta på ett MOS på omkring 4,3–4,5.
- End-to-end-latens för röst: Räkna den totala fördröjningen från att en användare avslutat sin förfrågan tills agenten börjar svara. Agenter för produktionsmiljöer siktar på en end-to-end-tid till första ljudet (TTFA) på under 500 millisekunder. Modellen ElevenLabs Flash v2.5 uppnår för närvarande en intern inferenslatens på omkring 75 ms. Den faktiska end-to-end-latensen varierar beroende på exempelvis din plats och vilken endpointtyp som används.
- Kostnad per samtal: Mät den totala driftskostnaden för varje automatiserad kundinteraktion jämfört med samtal med människor. ElevenLabs-samtal börjar på 10 cent per minut, medan genomsnittslönen per timme för kundtjänstmedarbetare tyder på att samtal med människor kostar omkring 32 cent per minut. Det ger en kostnadsbesparing på ungefär 70 %, även om priset kan variera beroende på abonnemang och användning. Se ElevenLabs prissida för aktuella priser.
När du väljer vilka mått du ska använda för att mäta modellens prestanda bör du ta hänsyn till de områden som är viktigast för din bransch och affärsmodell. Till exempel är noggrannhet och faktamässig korrekthet särskilt viktiga inom områden som bankverksamhet och patientinformation, medan latens, MOS och eskalationsgrad är viktigast för företag som prioriterar kundupplevelsen.
Observera att vissa mått förklarar grundorsakerna till andra. Hög latens leder till exempel sannolikt till ett lågt MOS-resultat och därmed låg kundnöjdhet, uttryckt som CSAT.
Så mäter du noggrannheten i Conversational AI
Mät modellens noggrannhet genom att bygga en testuppsättning med facit från omkring 500 till 1 000 verkliga historiska samtal. Riktiga loggar fångar det röriga, naturliga språk som syntetiska data ofta missar, till exempel stavfel, slang och användarfel. Utvärdera sedan systemet mot dessa verkliga loggar utifrån avsiktsigenkänning, svarskorrekthet och hallucinationsfrekvens.
Genomför automatiserade utvärderingar av dessa interaktioner med en bedömningsmetod där en LLM fungerar som domare. Validera dock alltid de automatiserade poängen mot system som märkts upp av människor för att säkerställa att de stämmer överens. Mänskliga granskare utför sedan veckovisa stickprov för att utvärdera chattbotars prestanda med en enkel tregradig bedömningsskala:
- Korrekt: Svaret är faktamässigt korrekt, relevant i sammanhanget och uppfyller direkt användarens primära avsikt.
- Godtagbart: Svaret är tekniskt korrekt och hjälpsamt, men har några mindre stilistiska problem, vissa klumpiga formuleringar eller formatering som inte följer varumärket.
- Fel: Svaret måste rättas omedelbart eftersom det innehåller faktafel, allvarliga hallucinationer eller helt missförstår användarens avsikt.
Helst bör du använda en metod per avsikt för att utvärdera modellen, eftersom AI-agenter fungerar bra i vissa sammanhang och misslyckas helt i andra. Sammanställda siffror kan göra att områden med hög prestanda döljer kritiska svagheter.
Vi har förenklat detta workflow genom att bygga in Next Reply-testning (Scenario) direkt i vår testning för ElevenAgents. Funktionen Next Reply utvärderar det uppföljningsmeddelande som en agent skickar i stället för hela fleromgångssamtalet. Du anger dock chatthistoriken fram till utvärderingspunkten och bedömer svaret mot standarder för policy, ton och kvalitet.
Så A/B-testar du svar från Conversational AI
A/B-testning samlar in återkoppling från verkligheten så att du slipper gissa vad kunderna föredrar. Sedan använder du denna empiriska data för att finjustera AI-modellens prestanda. Efter att ha följt upp mått har teamet sannolikt en lista med saker som det vill ändra eller experiment som ska genomföras. Men om du ändrar flera saker samtidigt blir det svårt att avgöra vad som fungerade och vad som inte gjorde det.
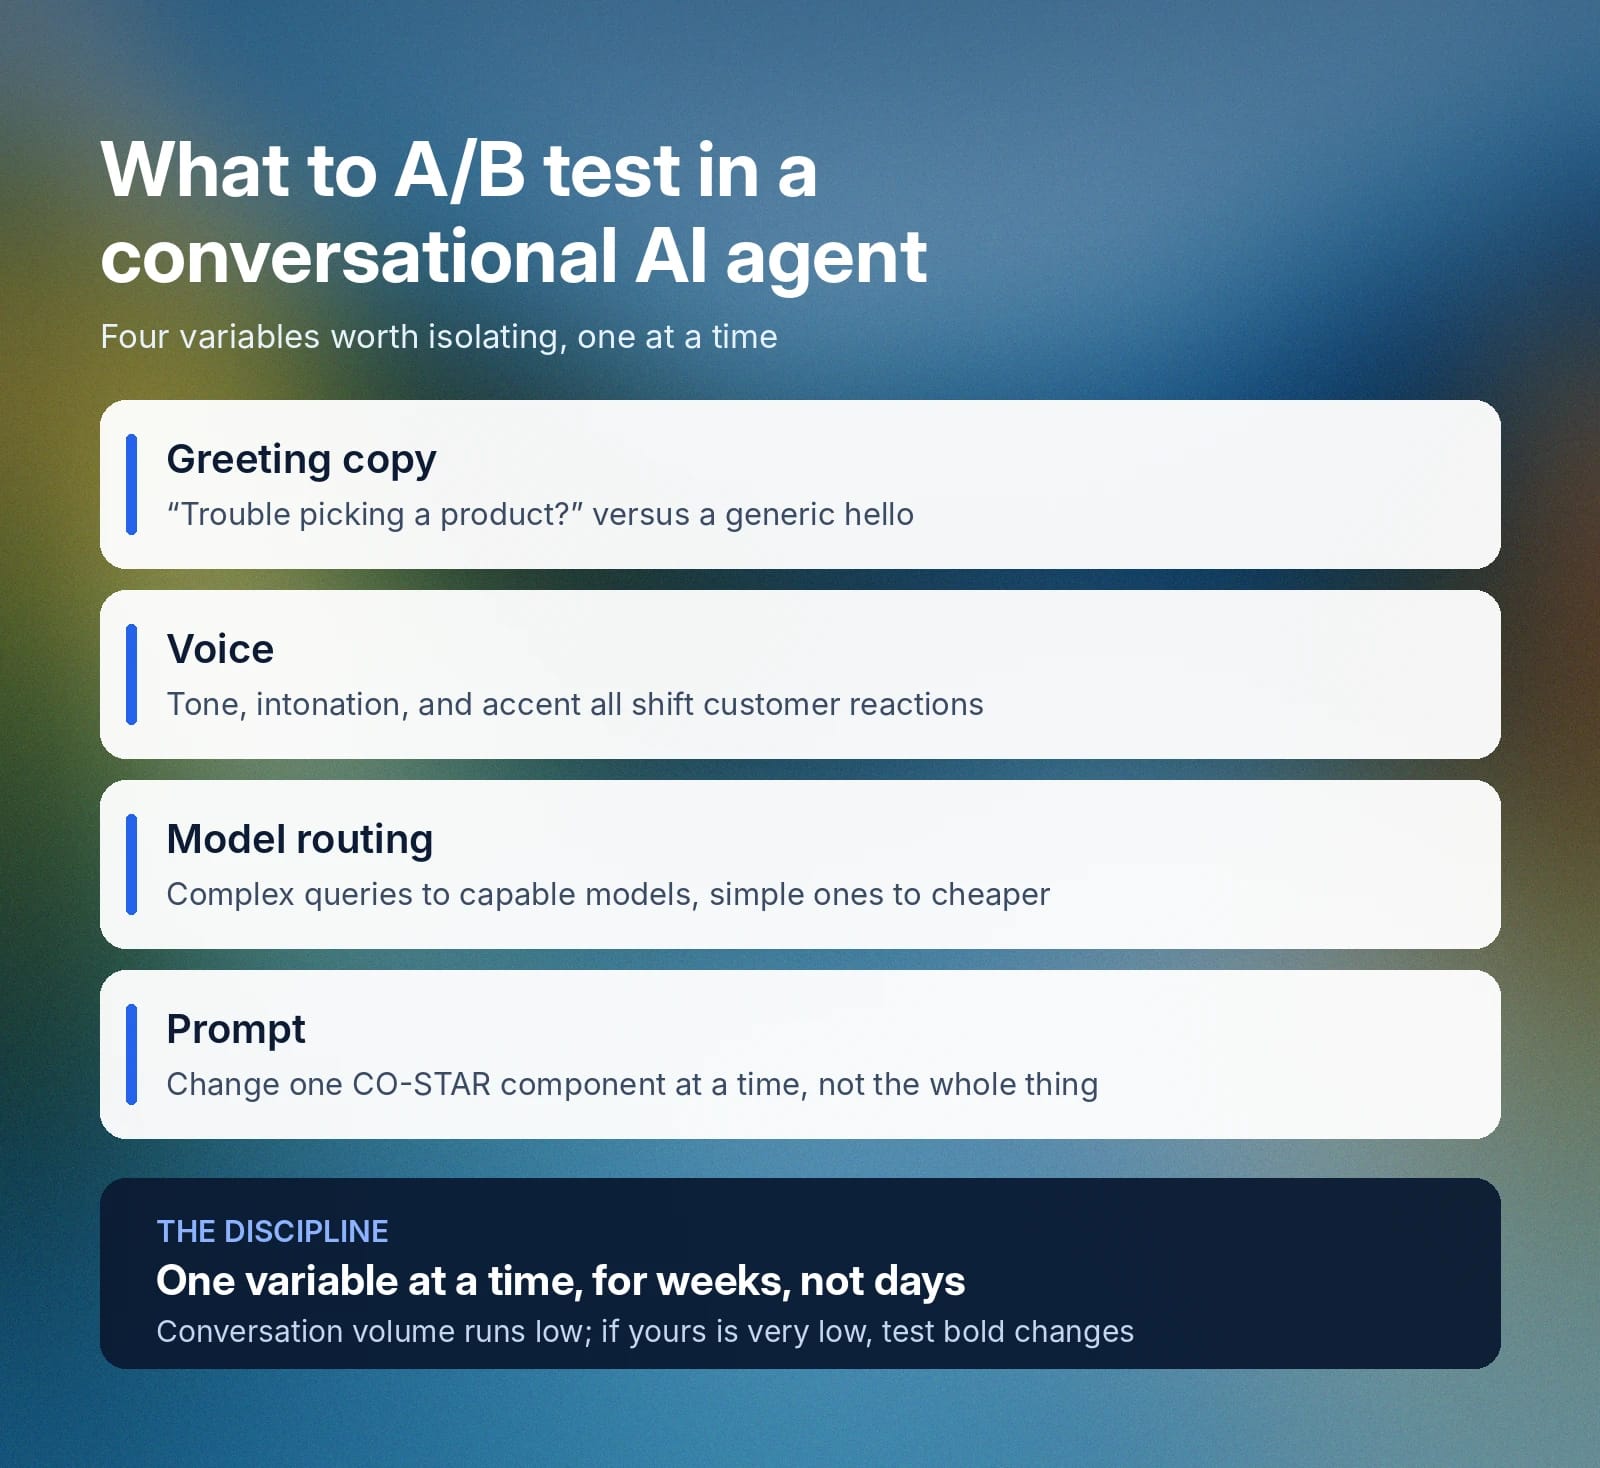
För att genomföra ett giltigt test måste du därför isolera en specifik variabel i taget och hålla resten av den underliggande kunskapsbasen konstant. Möjliga element att variera är:
- Hälsningsformulering: Justera det inledande hälsningsmeddelandet till något specifikt, som ”Hej! Har du svårt att välja produkt?” i stället för att bara säga ”Hej, hur kan jag hjälpa dig?”
- Röst: Kunder kan reagera mer positivt på vissa röster än andra i särskilda situationer beroende på maskulinitet respektive femininitet, tonfall, intonation och till och med accent.
- Modellroutning: Mycket kapabla modeller kostar vanligtvis mer, så det effektiva och kostnadseffektiva alternativet är att routa komplexa respektive enkla förfrågningar därefter.
- Prompt: Prompter har flera komponenter, så ändra bara en aspekt i taget, exempelvis sammanhang, mål, stil, ton, målgrupp eller svarsmall (CO-STAR).
Team bör också anpassa testperioden. Samtalstrafiken är vanligtvis mycket lägre än antalet sidvisningar på webben, så du behöver köra testet i veckor i stället för dagar för att uppnå statistisk signifikans. Om du har extremt låg volym bör du testa stora, djärva förändringar i stället för små justeringar.
Ett praktiskt workflow kräver också versionshantering för agenter, verktyg för jämförelse och återställning. Vi har byggt in detta direkt i ElevenAgents.
Så testar du en Conversational AI-agent före driftsättning
Kundtjänst är en direkt kontaktpunkt med de människor som påverkar din lönsamhet, och AI reagerar ibland oförutsägbart på små förändringar. Testa därför alltid en ny eller reviderad Conversational AI-agent innan du lanserar den i produktion. Det räcker inte att bara ”känslotesta”.
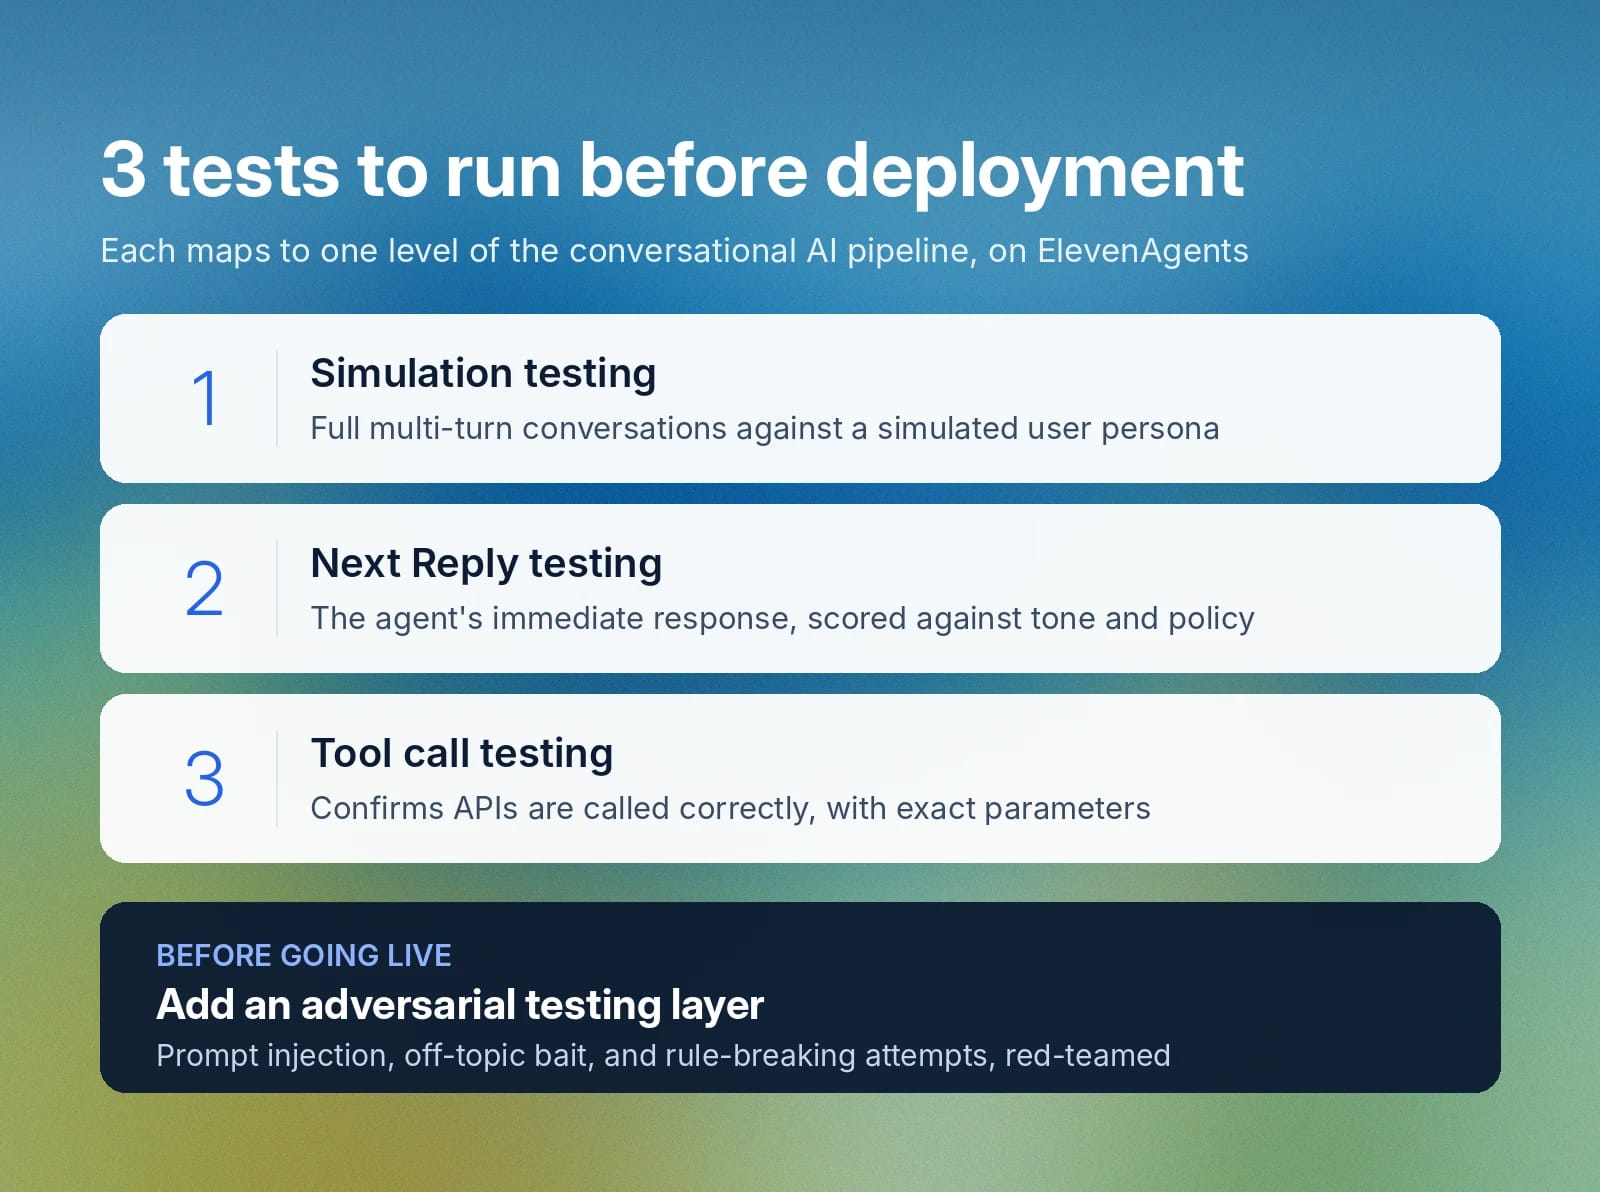
Vi utformade vårt testramverk för ElevenAgents kring tre huvudtyper av test som riktar in sig på specifika nivåer i din Conversational AI-pipeline:
- Simuleringstestning: Kör ett komplett fleromgångssamtal mot en simulerad användare med en persona för att bekräfta att dialogen uppfyller önskade prestandanivåer.
- Next Reply-testning: Testar endast agentens omedelbara svar mot specifika begränsningar för ton, policy eller annat, för att bekräfta att svaren är lämpliga och korrekta.
- Testning av verktygsanrop: Säkerställer att agenter korrekt anropar anslutna API:er och skickar de exakta parametrar som behövs för viktiga databasuppslag eller överföringar.
Eftersom så många angripare försöker jailbreaka modeller i skadliga syften behöver du också ett lager för adversarial testing innan du går live. Arbeta med QA-team, promptingenjörer och cybersäkerhetsexperter inom red teaming för att testa promptinjektioner, lockbeten utanför ämnet och försök att bryta mot regler.
Slutligen, använd en stegvis lansering genom att släppa pilotversioner till en liten användargrupp och följa deras beteende i verkligheten. Sätt strikta kriterier som modellen måste uppfylla innan den släpps till en större grupp eller hela kundbasen. Kom ihåg att utse en ansvarig person som övervakar lanseringen och skapar en återställningsplan om en justering försämrar resultatmåtten.
Utvärdera chattbotars prestanda i produktion
Definiera hur framgång ser ut för varje användningsfall innan du lanserar din Conversational AI-modell. Det är särskilt viktigt för tillämpningar i hårt reglerade områden, där noggrannhet och dataskydd har högre riktmärken och striktare krav.
Automatiserade svar gör det enkelt att A/B-testa modeller i stor skala, men objektiv testning kräver att du kombinerar detta med ad hoc-läsning av transkript och återkoppling från mänskliga testare. Människor i loopen fångar upp nyanser i samtal som AI-modeller missar och egenheter i data som annars försvinner i sammanställda siffror. En heltäckande utvärderingsstrategi omfattar även sentimentanalys och direkt återkoppling från användare.
Kontinuerlig förbättring skiljer dessutom mogna system med hög avkastning på investeringen från andra system. Konkurrenter kan behandla testning och övervakning som separata uppgifter, men en mogen pipeline kombinerar dem. I detta fall förs produktionsfel direkt in i testuppsättningen för att träna nästa optimerade agent.
Regelbundna justeringar blir också nödvändiga när AI-företag uppdaterar basmodellerna som din agent körs på. En sådan ändring gör ofta att en tidigare effektiv prompt plötsligt bidrar till opålitliga eller till och med olämpliga svar.
Vi har byggt in denna återkopplingsloop direkt i vår plattform. Använd våra verktyg för samtalsanalys för att automatisera strukturerad datainsamling och enkelt utvärdera sentiment. Stora organisationer använder också vår Conversational AI-infrastruktur för företag för att tryggt övervaka och skala sina agenter globalt.
Kom igång med ElevenAgents för kundservicemått
För att framgångsrikt lansera Conversational AI i stor skala krävs mer än högkvalitativa röster och modeller med låg latens. Du behöver ett sammanhängande ekosystem för att utforma, bygga, testa, driftsätta och justera workflow med flera agenter.
ElevenAgents ger dig den skalbara infrastruktur du behöver. Ditt team får tillgång till verktyg som Next Reply-verifiering, sentimentuppföljning och automatisk datainsamling för att kontinuerligt övervaka och optimera modeller för bästa resultat. Dessutom fångar du upp regressioner innan de når dina kunder.
Är du redo att förenkla arbetet med att mäta Conversational AI? Utforska våra funktioner för agenttestning och se hur våra företagsteam driftsätter tillförlitliga agenter som förbättrar dina kundservicemått.
Läs mer om ElevenAgents eller registrera dig för att komma igång i dag.
Vanliga frågor om att mäta Conversational AI

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.



