
Vad är ett kontextfönster? Det här bör alla LLM-användare känna till
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Ett kontextfönster är den mängd information som en stor språkmodell (LLM) kan bearbeta i en enskild begäran. Det mäts i token och kan omfatta din prompt, konversationshistorik, systeminstruktioner, hämtade dokument, verktygsresultat och modellens genererade svar.
Ett större kontextfönster gör att en modell kan arbeta med mer information i en och samma begäran. Till exempel kan en kodagent som undersöker en bugg arbeta med relevanta källfiler, dokumentation, testresultat och nyliga kodändringar samtidigt, i stället för att analysera varje del separat och förlora användbar kontext mellan begäranden.
Ett större kontextfönster är dock inte samma sak som ett perfekt minne. Längre prompter kräver mer beräkning, förbrukar fler token och kan göra det svårare för modellen att avgöra vilka detaljer som faktiskt spelar roll. Forskning om modeller med lång kontext, inklusive studien Lost in the Middle och NVIDIAs RULER-benchmark, har upprepade gånger visat att modeller använder mindre av den tillgängliga informationen när kontexten växer, särskilt när relevant information är begravd bland mindre användbart material.
Här går vi igenom hur kontextfönster fungerar, hur de mäts, vad som händer när de fylls och hur utvecklare kan hantera dem effektivt.
Sammanfattning
- Ett kontextfönster är den totala tokenbudget som en LLM använder för en enskild begäran. Det omfattar användarens prompt, konversationshistorik, hämtat innehåll och output.
- Större kontextfönster möjliggör längre dokument, kodbaser och konversationer, men garanterar inte att modellen använder alla delar väl.
- Modeller hämtar information minst tillförlitligt från mitten av långa prompter, ett mönster som dokumenterats i studien Lost in the Middle och RULER-benchmarken.
- Effektiv kontexthantering (hämtning, sammanfattning, cachning) är vanligtvis bättre än att bara maximera antalet token som skickas.
- Den bästa kontextstrategin är den som passar din faktiska arbetsbelastning, inte den som använder det största annonserade kontextfönstret.
Vad är ett kontextfönster i en AI-modell?
Ett kontextfönster är modellens aktiva arbetsyta, där allt som är relevant för den aktuella begäran samlas innan modellen genererar ett svar.
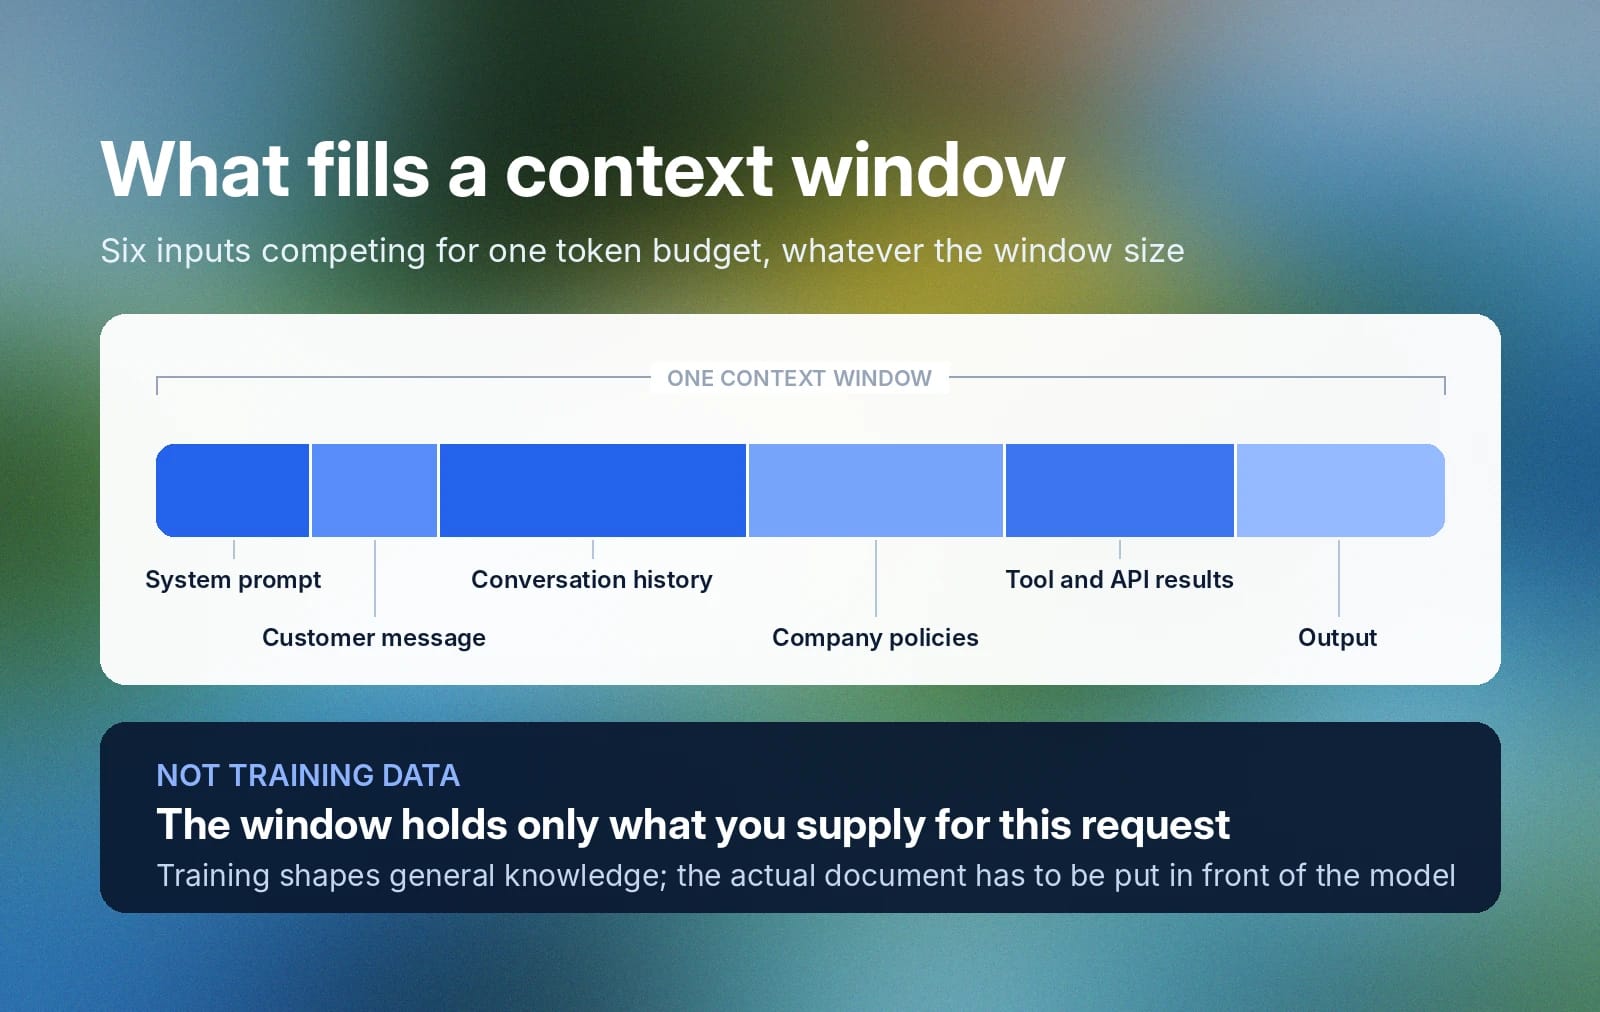
Tänk dig en AI-agent som sammanfattar en konversation inom kundtjänst och rekommenderar en lösning. För att göra det bra måste modellen bearbeta:
- Systemprompten
- Kundens meddelande
- Konversationshistoriken
- Företagets policyer
- Resultat från verktyg och API:er
- Outputen
Allt detta konkurrerar om utrymme i samma kontextfönster, oavsett hur stort fönstret är.
Kontextfönster omfattar inte träningsdata. Träning bygger permanent in information i en modells parametrar och formar vad den generellt ”vet”. Ett kontextfönster innehåller däremot bara information som tillhandahålls för den aktuella uppgiften.
Den här skillnaden spelar roll i praktiken: Om en applikation behöver att en modell resonerar kring en specifik policy, kundpost eller teknisk dokumentation, är informationen inte tillgänglig bara för att modellen tränats på liknande material. Den behöver vanligtvis föras in direkt i modellens arbetskontext, i prompten eller via ett hämtnings- eller verktygssystem. Annars resonerar modellen utifrån allmän kunskap i stället för det faktiska dokumentet framför sig.
Tokenisering och kontextfönster: Så bearbetas data
Innan en LLM bearbetar text delar en tokenizer upp den i mindre enheter som kallas token. En token kan representera ett helt ord, en del av ett ord, ett skiljetecken eller någon annan kort textbit.
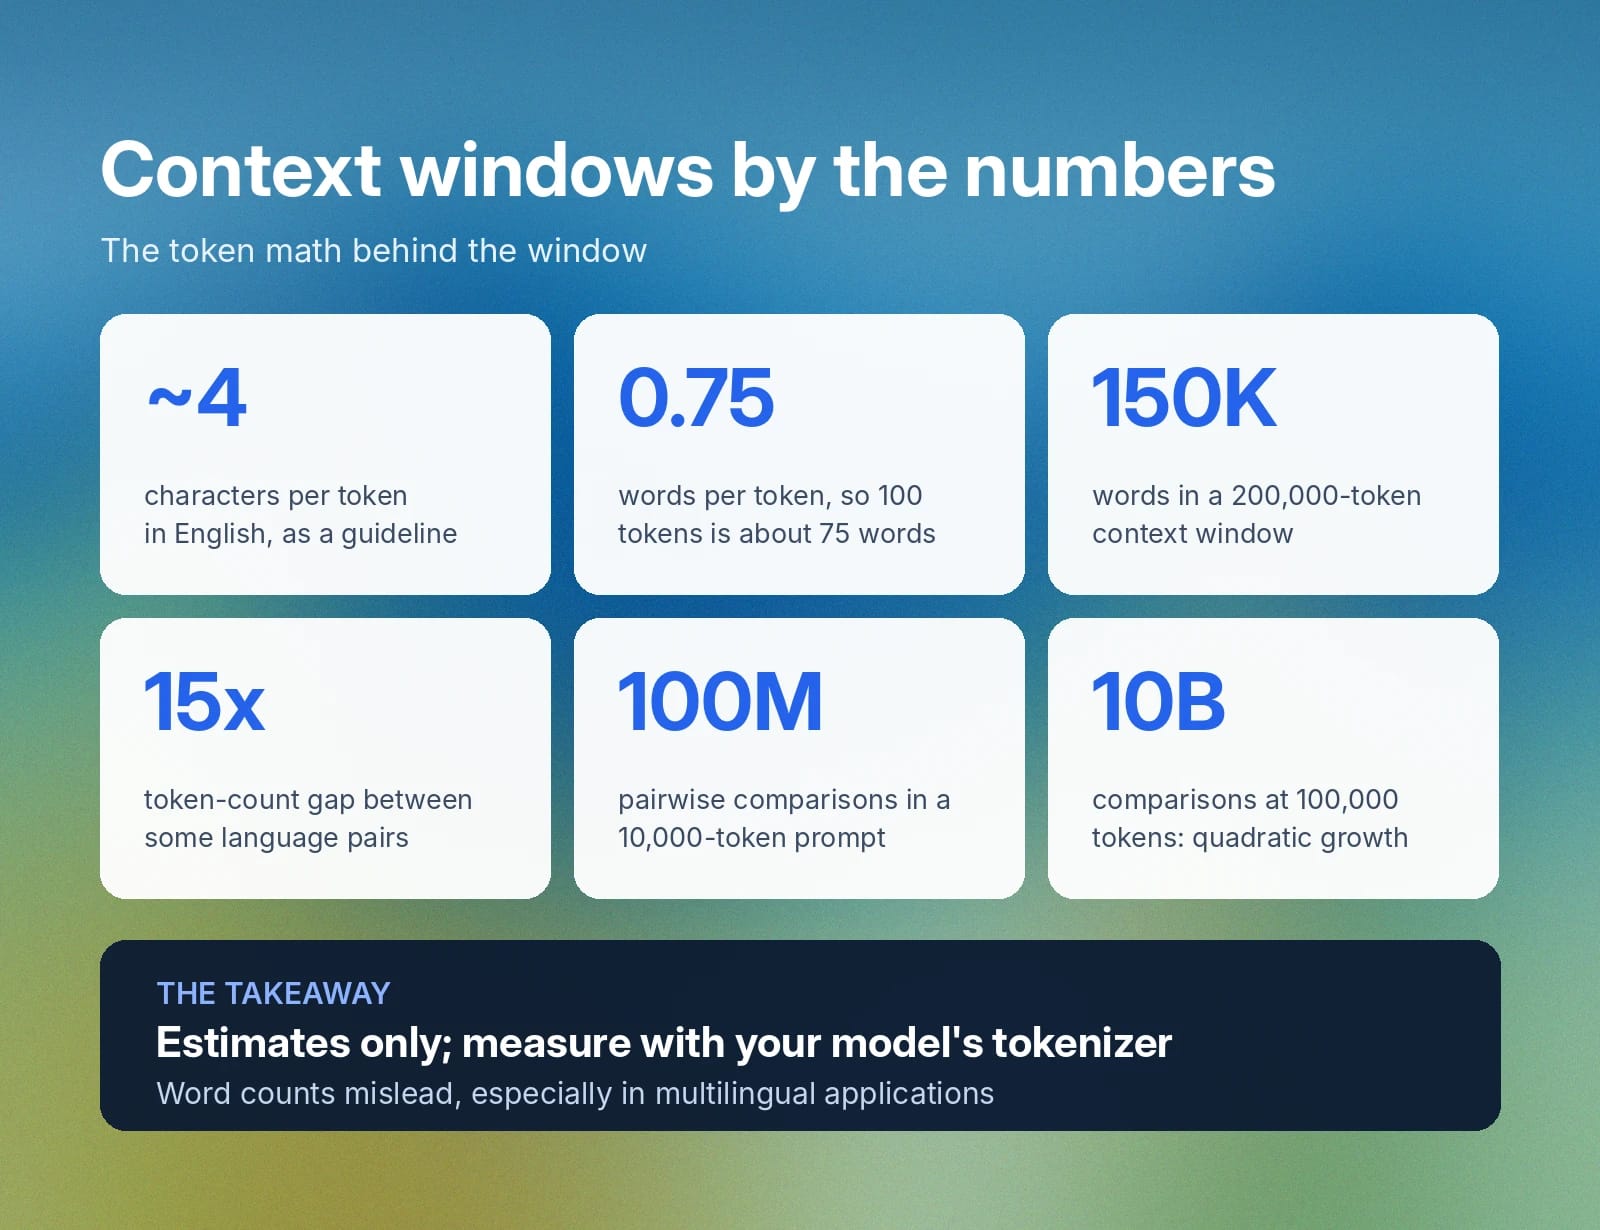
För engelska är en användbar tumregel att en token motsvarar ungefär fyra tecken, eller omkring tre fjärdedelar av ett ord. Enligt den uppskattningen motsvarar 100 token cirka 75 ord. Detta är dock bara en uppskattning. Ta frasen ”Context windows affect application performance.” En tokenizer representerar den inte nödvändigtvis som fem hela ord; beroende på tokenizern kan ett eller flera ord delas upp i flera delordstoken.
Tokenisering varierar också betydligt mellan språk. Två meningar med liknande betydelse och ungefär samma synliga längd kan använda väldigt olika antal token beroende på språk och tokenizer. Forskning om rättvisa i tokenizers har visat att vissa språkpar kan skilja sig upp till 15 gånger i tokeniserad längd för likvärdig text, även med tokenizers som byggts för flerspråkigt stöd. Utvecklare som bygger flerspråkiga applikationer bör mäta tokenanvändningen med tokenizern för den faktiska modellen i stället för att uppskatta utifrån ordantal.
Ett kontextfönster på 200 000 token kan låta enormt, men en applikation som kontinuerligt lägger till konversationshistorik, hämtad dokumentation, verktygssvar och systeminstruktioner kan nå den gränsen snabbare än väntat. Därför övervakar produktionsapplikationer ofta tokenanvändningen och använder tekniker som sammanfattning, rensning av historik, hämtningsfiltrering och promptkomprimering för att behålla den mest relevanta informationen i den aktiva kontexten.
Hur fungerar ett kontextfönster i språkmodeller?
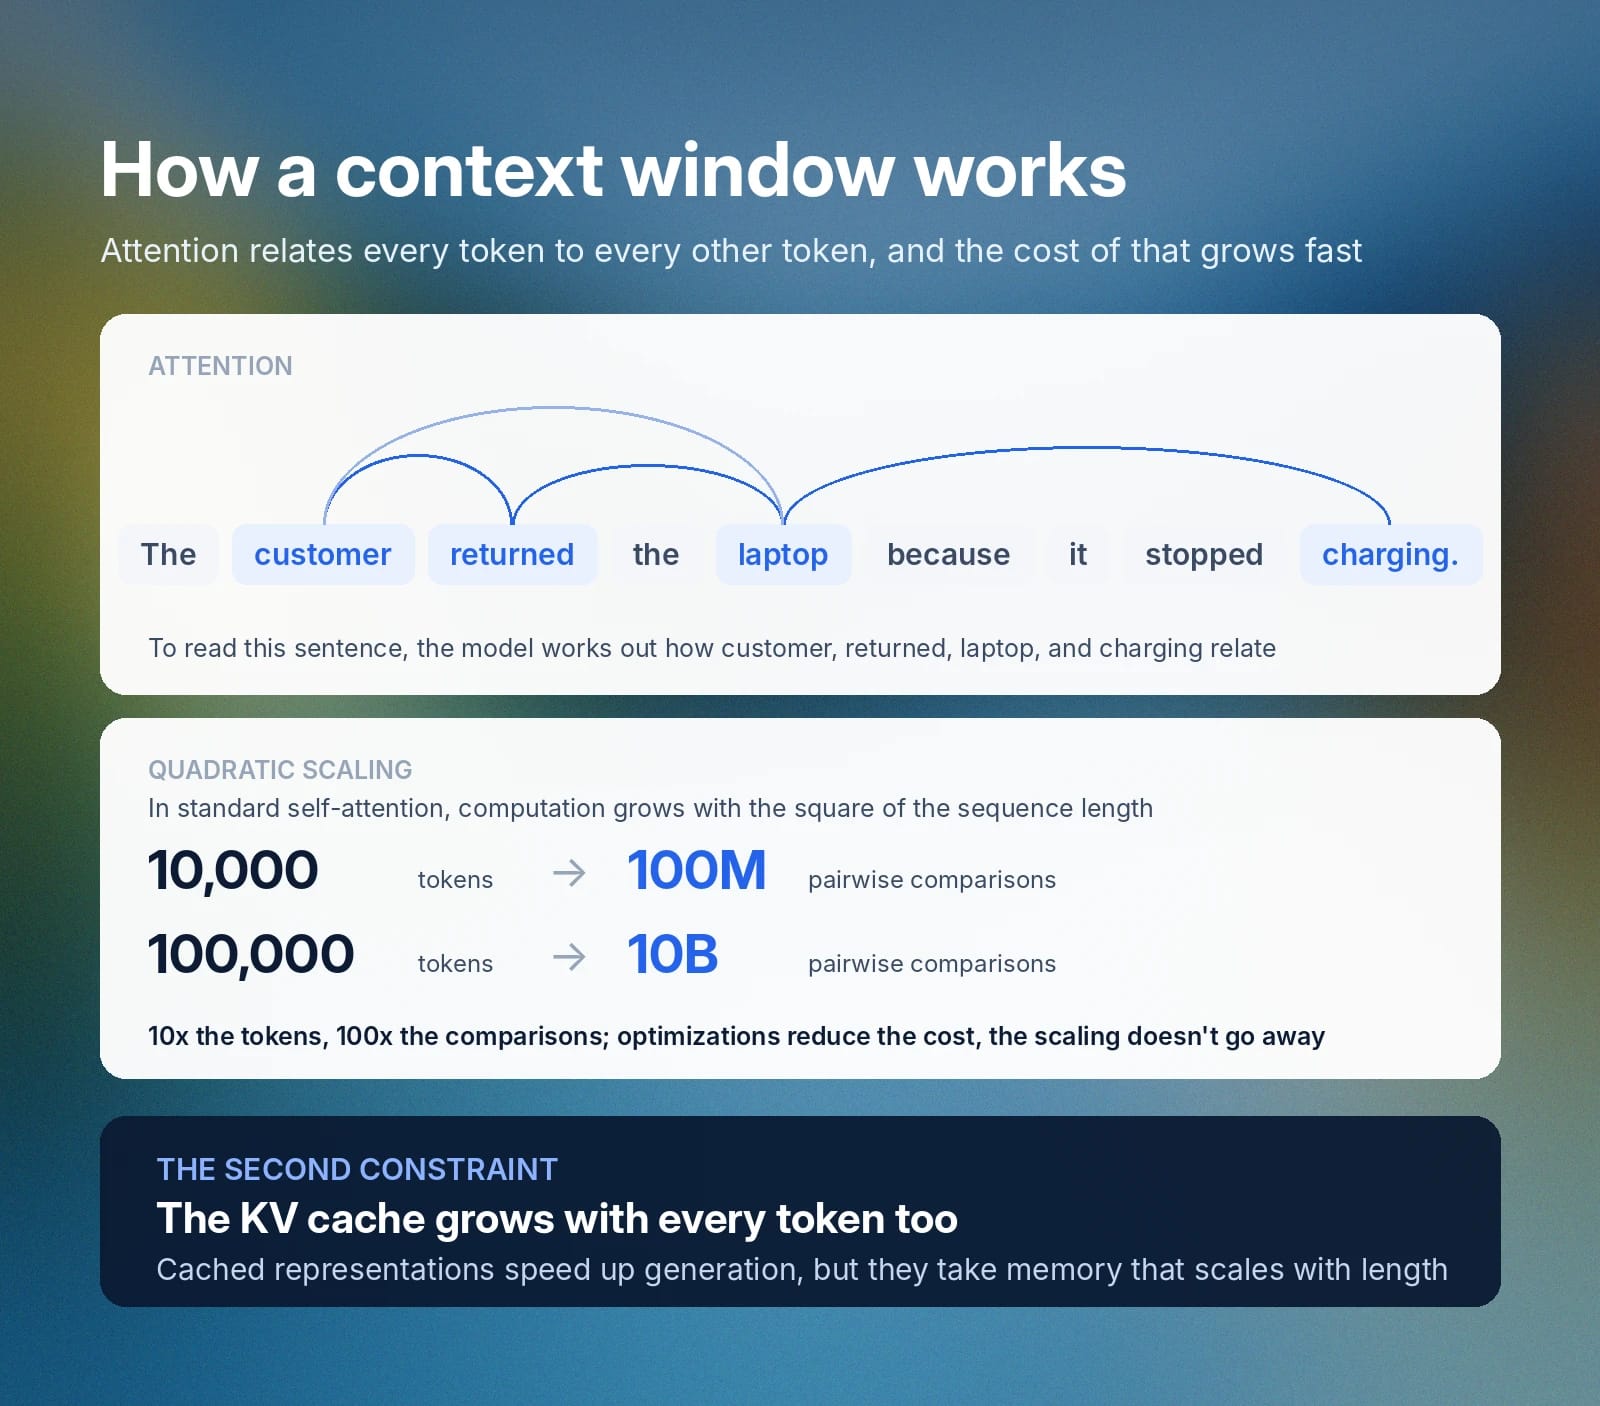
Ett kontextfönster fungerar genom transformerarkitekturens uppmärksamhetsmekanism, som beräknar hur varje token i en input förhåller sig till alla andra token innan modellen ger ett svar.
Ta meningen ”Kunden lämnade tillbaka den bärbara datorn eftersom den slutade laddas.” För att tolka den korrekt måste modellen förstå hur kund, bärbar dator, lämnade tillbaka och laddas förhåller sig till varandra. När en sekvens blir längre växer antalet sådana relationer snabbt.
I standardiserad self-attention växer den beräkning som krävs ungefär med kvadraten på sekvenslängden. Till exempel kräver en prompt på 10 000 token omkring 100 miljoner parvisa jämförelser, medan en prompt på 100 000 token kräver omkring 10 miljarder. Moderna modeller använder en rad arkitektur- och infrastrukturförbättringar för att minska kostnaden i praktiken, men det underliggande skalningsproblemet försvinner inte.
Långa konversationer medför en andra begränsning: key-value-cachen, eller KV-cachen. Under generering behåller modeller mellanliggande representationer av tidigare token i stället för att räkna om dem för varje ny token, vilket snabbar upp inferensen betydligt. Cachen tar dock själv upp minne och växer när sekvensen blir längre.
Maximal kontextlängd i AI-modeller och varför den spelar roll
En modells maximala kontextlängd definierar hur mycket information den kan ta emot och bearbeta i en enskild begäran. Huruvida modellen använder ett stort kontextfönster effektivt är dock en separat fråga.
Längre kontextfönster möjliggör användningsfall som var svåra eller opraktiska med tidigare LLM:er. Utvecklare kan ge en modell ett helt kodarkiv, ett långt juridiskt dokument, en forskningsrapport, ett mötestranskript eller en omfattande konversationshistorik utan att först behöva reducera materialet till några tusen token.
Detta spelar roll eftersom mer av den ursprungliga kontexten kan förbättra modellens förmåga att svara korrekt på frågor, identifiera relationer mellan avlägsna informationsdelar och utföra uppgifter som beror på dokumentet som helhet. En kodassistent kan till exempel behöva granska flera filer för att förstå hur en funktion anropas, medan en assistent för juridiska dokument kan behöva jämföra definitioner i ett avsnitt med skyldigheter som beskrivs mycket senare i dokumentet.
Ett större kontextfönster ger dock inte automatiskt bättre resultat. Mycket långa input kan öka kostnaden och latensen, och modeller kan ägna mindre uppmärksamhet åt information som är begravd mitt i en stor kontext. Utvecklare bör därför välja ut relevant information, strukturera långa input tydligt och använda tekniker som hämtning, sammanfattning och kontextrensning när det är lämpligt.
Jämförelse av kontextfönsterstorlekar per modell
Kontextfönster varierar stort mellan dagens främsta modellfamiljer, från några hundra tusen token upp till 10 miljoner. Så här jämför sig dagens flaggskeppsmodeller:
Modell | Kontextfönster | Kommentarer |
10 miljoner token | Metas modell med öppna vikter; det största offentligt tillgängliga fönstret när detta skrivs | |
1,05 miljoner token | OpenAI:s nuvarande flaggskeppsmodell för kodning och agentbaserat resonemang | |
1 miljon token | Googles nuvarande modell i Pro-klassen för analys av långa dokument och flera filer | |
1 miljon token | Anthropics nuvarande modell i Sonnet-klassen; fönstret gäller som standard i hela Claude API |
Annonserade gränser förändras snabbt när leverantörer släpper nya modeller och höjer sina tak, så se en sådan här tabell som en ögonblicksbild snarare än en permanent ranking. Kontextstorlek är dessutom bara en faktor vid modellval. Den säger i sig inget om kvaliteten på resonemang, outputgränser, latens eller kostnad.
Konsekvenser av ett litet respektive stort kontextfönster
Ett litet kontextfönster tvingar utvecklare att vara selektiva. Långa dokument delas upp i delar, äldre konversationshistorik sammanfattas och extern kunskap hämtas bara när den faktiskt behövs.
Ett stort kontextfönster tar bort vissa av dessa begränsningar. Du kan tillhandahålla fler exempel, bevara mer konversationshistorik eller analysera en större mängd dokument utan att först dela upp allt.
Ett större fönster introducerar dock ett annat problem: utspädd uppmärksamhet. När en prompt innehåller en stor mängd information kan modellen ha svårt att identifiera vilka detaljer som är mest relevanta för den aktuella begäran. Viktiga instruktioner eller bevis kan begravas bland mindre relevant innehåll, vilket ökar risken för ofullständiga, inkonsekventa eller mindre precisa svar.
Varför modeller går vilse i mitten
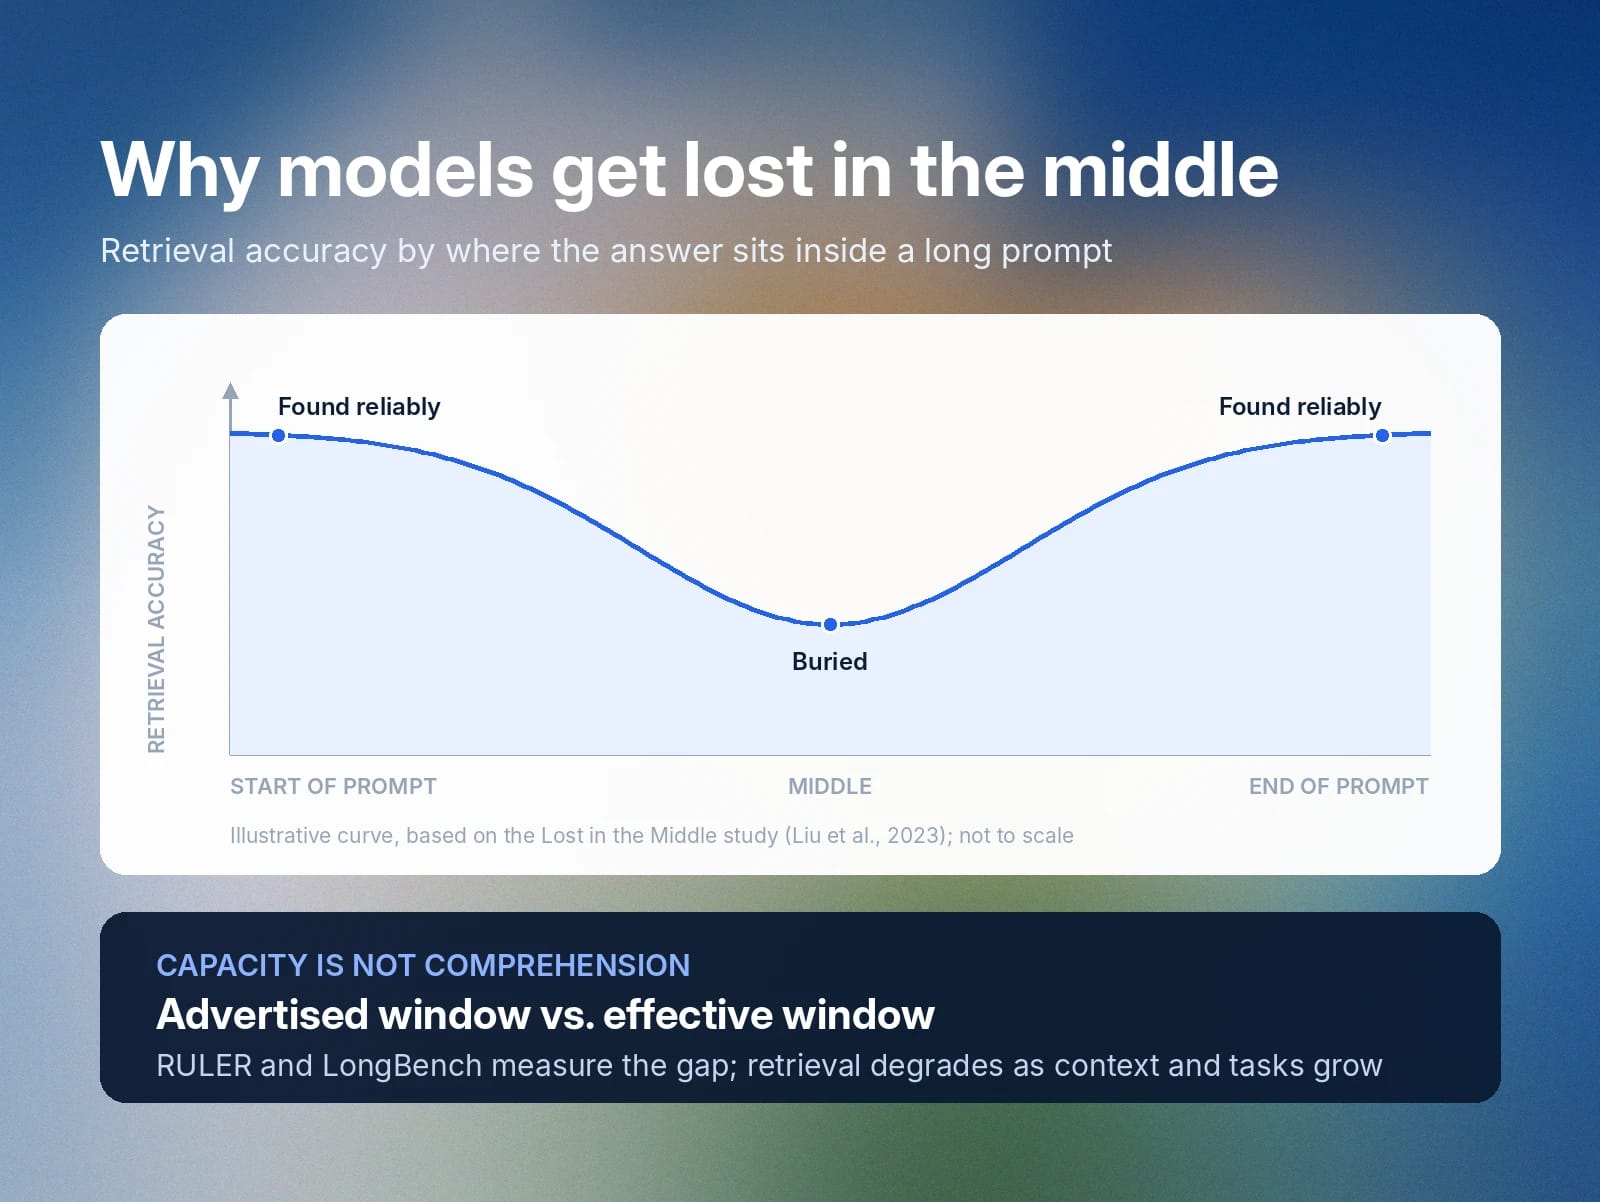
Modeller tenderar att hämta information bäst när den finns nära början eller slutet av en lång prompt, och sämst när den är begravd i mitten. Den inflytelserika studien Lost in the Middle testade detta direkt genom att placera svaret på en fråga på olika positioner i en lång prompt och mäta hur ofta modellerna hittade det. Träffsäkerheten var konsekvent högst i början och slutet av kontexten, och lägst i mitten.
Det innebär att en modell tekniskt sett kan ta emot ett dokument utan att tillförlitligt använda alla delar av det. Skicka 100 supportdokument till en LLM eftersom ett av dem innehåller svaret på en kundfråga, så kan ett större kontextfönster rymma alla 100. Men modellen måste fortfarande hitta ett relevant avsnitt bland 99 irrelevanta, och ett längre fönster garanterar inte att den gör det.
Därför är det värt att skilja mellan en modells annonserade kontextfönster och dess effektiva kontextfönster för en viss arbetsbelastning. Benchmarks som RULER och LongBench försöker mäta det glappet. RULER visade att modeller som presterade nästan perfekt i enkla hämtningstester ändå försämrades när kontextlängden och uppgiftens komplexitet ökade. LongBench utvärderar bredare uppgifter, inklusive frågebesvarande om dokument, resonemang över flera dokument, sammanfattning, few-shot learning och kodkomplettering.
Lång kontext tillför fortfarande verkligt värde. Kapacitet och förståelse är helt enkelt olika egenskaper, och båda spelar roll när du väljer modell för en viss uppgift.
Hantera kontextgränser: Bästa praxis för utvecklare
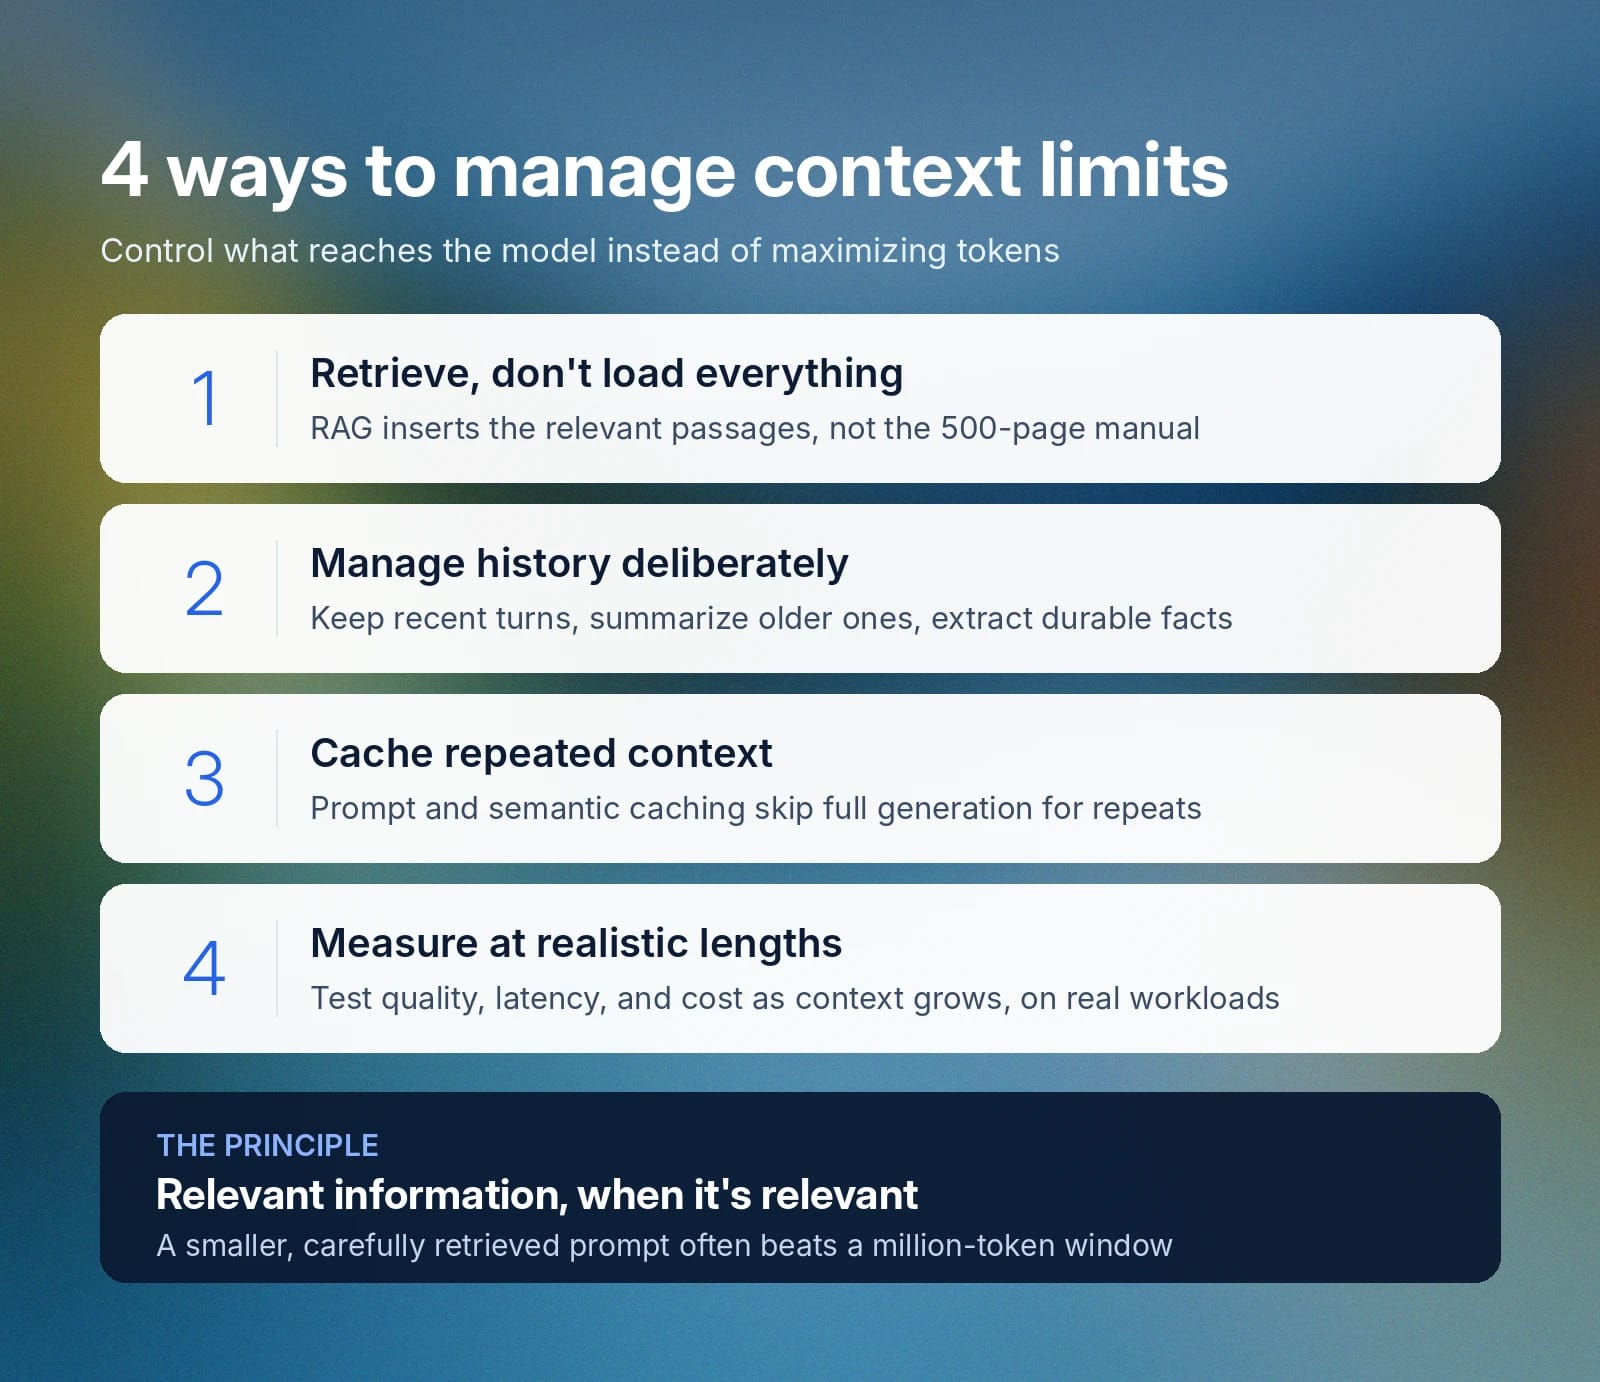
Bra kontexthantering handlar om att styra vad som når modellen: att tillhandahålla informationen som är relevant för uppgiften när den är relevant, i stället för att försöka maximera antalet token i varje begäran. Följande metoder kan hjälpa utvecklare att minska onödig kontext, förbättra svarskvaliteten och styra kostnad och latens.
1. Hämta relevant information i stället för att läsa in allt
Retrieval-augmented generation, eller RAG, gör att en applikation kan söka i en extern kunskapsbas och bara lägga in relevanta avsnitt i modellens kontext. I stället för att lägga in en hel manual på 500 sidor i varje supportbegäran hämtar applikationen de få avsnitt som ligger närmast kundens faktiska fråga.
Det minskar tokenanvändningen och ger modellen en mycket tydligare signal om vad som är viktigt. Hämtningskvaliteten spelar fortfarande roll: RAG-system i produktion förbättrar vanligtvis resultaten genom att dela upp dokument noggrant, hämta flera kandidatavsnitt, rangordna kandidaterna på nytt och filtrera bort allt irrelevant innan den slutliga prompten byggs. ElevenLabs har till exempel byggt om sin RAG-pipeline för att lägga till omskrivning av frågor och parallella modellanrop, vilket halverade medianlatensen för hämtning.
2. Hantera konversationshistoriken medvetet
Konversationsapplikationer samlar snabbt på sig kontext. Att lägga till alla tidigare meddelanden utan slut slösar token och kan dra in irrelevanta detaljer i senare turer.
Applikationer hanterar detta genom att behålla de senaste turerna, sammanfatta äldre utbyten, extrahera bestående fakta till strukturerat minne och bara hämta äldre detaljer när de blir relevanta igen. Det skapar en användbar uppdelning mellan kortsiktig konversationskontext, som modellen behöver direkt, och mer långsiktigt applikationsminne, som kan hämtas tillbaka senare.
3. Använd cachning när kontexten upprepas
Många applikationer skickar samma omfattande instruktioner upprepade gånger eller svarar på frågor som semantiskt liknar frågor de redan har hanterat. Cachning minskar den omkostnaden.
Prompt- eller kontextcachning gör att upprepad input kan återanvändas effektivare, och semantisk cachning går ett steg längre genom att känna igen när en ny fråga betyder ungefär samma sak som en fråga systemet redan har besvarat. ”Vad är er returpolicy?” och ”Hur länge kan jag returnera en vara?” är olika strängar som en semantisk cache kan behandla som samma fråga, vilket gör att ett fullständigt genereringsanrop kan hoppas över och minskar både latens och tokenkostnader.
4. Mät prestanda vid realistiska kontextlängder
Välj inte en kontextstrategi enbart utifrån en modellleverantörs annonserade tokengräns. Testa representativa produktionsarbetsbelastningar och mät svarskvalitet, hämtningsprecision, latens, tokenanvändning, kostnad och felfrekvens när kontextlängden ökar.
Jämför strategier som att tillhandahålla mer kontext, hämta färre avsnitt, sammanfatta konversationshistorik eller kombinera hämtning med sammanfattning. En modell med ett kontextfönster på en miljon token kan tekniskt sett stödja din applikation, medan en mindre, noggrant hämtad prompt ger snabbare och mer träffsäkra resultat till en lägre kostnad.
Kom igång med ElevenAgents för skalbara språklösningar
Kontexthantering är viktigast i konversationsagenter, som måste kombinera det aktuella yttrandet med tidigare turer, företagsinstruktioner, kundinformation, innehåll från kunskapsbaser och verktygsresultat, samtidigt som de svarar tillräckligt snabbt för att konversationen ska kännas naturlig.
ElevenAgents samlar dessa delar i en plattform för att bygga och driftsätta AI-röstassistenter. Dess orkestreringsmotor samordnar taligenkänning, en LLM och Text to Speech, medan utvecklare konfigurerar prompter, kunskapsbaser, verktyg, workflows och den underliggande språkmodellen. Uttrycksfull leverans, inklusive hur en agent förmedlar känslomässig kontext i tal, beror på samma kontext som formar vad agenten säger från början.
För just kunskapshantering stöder ElevenAgents både dokument med full kontext och RAG, som kan konfigureras direkt på plattformen. Små dokument läggs direkt i en agents prompt, så att innehållet är tillgängligt under hela konversationen. Större kunskapsbaser indexeras i stället, där RAG hämtar relevanta avsnitt för varje fråga i stället för att läsa in allt i kontextfönstret på en gång.
Kom igång genom att registrera dig för ElevenAgents i dag eller prata med vårt team för att ta reda på vilka driftsättningsalternativ som finns.
Vanliga frågor om kontextfönster

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.

