Resumo do Webinar: Dê uma Voz Natural ao Seu Chatbot de Texto
- Publicado
- Última atualização
OuvirOuça este artigo
Agentes de chat se tornaram parte padrão da infraestrutura de software empresarial. A maioria das empresas já tem um ou está criando um. O que menos empresas descobriram é o que acontece quando um usuário prefere simplesmente falar.
A voz transforma a interação de maneiras que vão além da conveniência. Os usuários expressam frustração, urgência e confusão pelo tom de voz de formas que o texto elimina por completo. Um cliente que digita "meu pedido não chegou" e outro que diz isso com ansiedade audível estão enviando sinais diferentes — e o agente que só consegue ler a transcrição está trabalhando com apenas metade das informações.
A pergunta que a maioria das equipes faz agora não é se deve adicionar voz, mas como fazer isso sem reconstruir tudo o que já funciona.
No Workshop ao vivo: dê ao seu chatbot de texto uma voz que soa humana, Paul Asjes (Experiência do desenvolvedor), Bhargavi Bhatt (Experiência do cliente) e Fergal Burnett (Marketing de produto, ElevenAPI) abordaram as realidades técnicas de adicionar voz a um agente existente e como uma integração funcional realmente é.
Por que criar com voz é mais difícil do que parece
Um dos principais desafios é a alternância de turnos. Os humanos sabem quando alguém terminou de falar por causa da entonação, do ritmo e do contexto. No entanto, a detecção de atividade de voz (a abordagem padrão) detecta apenas o silêncio.
O resultado costuma ser um sistema que trata cada pausa como um convite para falar: um sistema que interrompe, corta a fala no meio do raciocínio e responde a hesitações naturais como se fossem frases concluídas.
Ele é tecnicamente funcional, mas falha na conversa.
O contexto é a outra metade do problema. Enviar o histórico da conversa a um LLM a cada turno é necessário, mas não suficiente. As mesmas palavras têm significados diferentes dependendo de como são ditas — "estou bem" dito com alívio e "estou bem" dito com frustração têm a mesma transcrição, mas representam interações diferentes. Um sistema de voz que ignora essa dimensão sempre soará um pouco estranho, independentemente da qualidade de cada modelo.
Há também a sobrecarga de engenharia. Equipes que cuidam da própria orquestração de voz acabam mantendo a lógica de alternância de turnos, o tratamento de interrupções e a análise de latência como trabalho contínuo. Não é uma implementação única.
Como adicionar voz a um agente existente
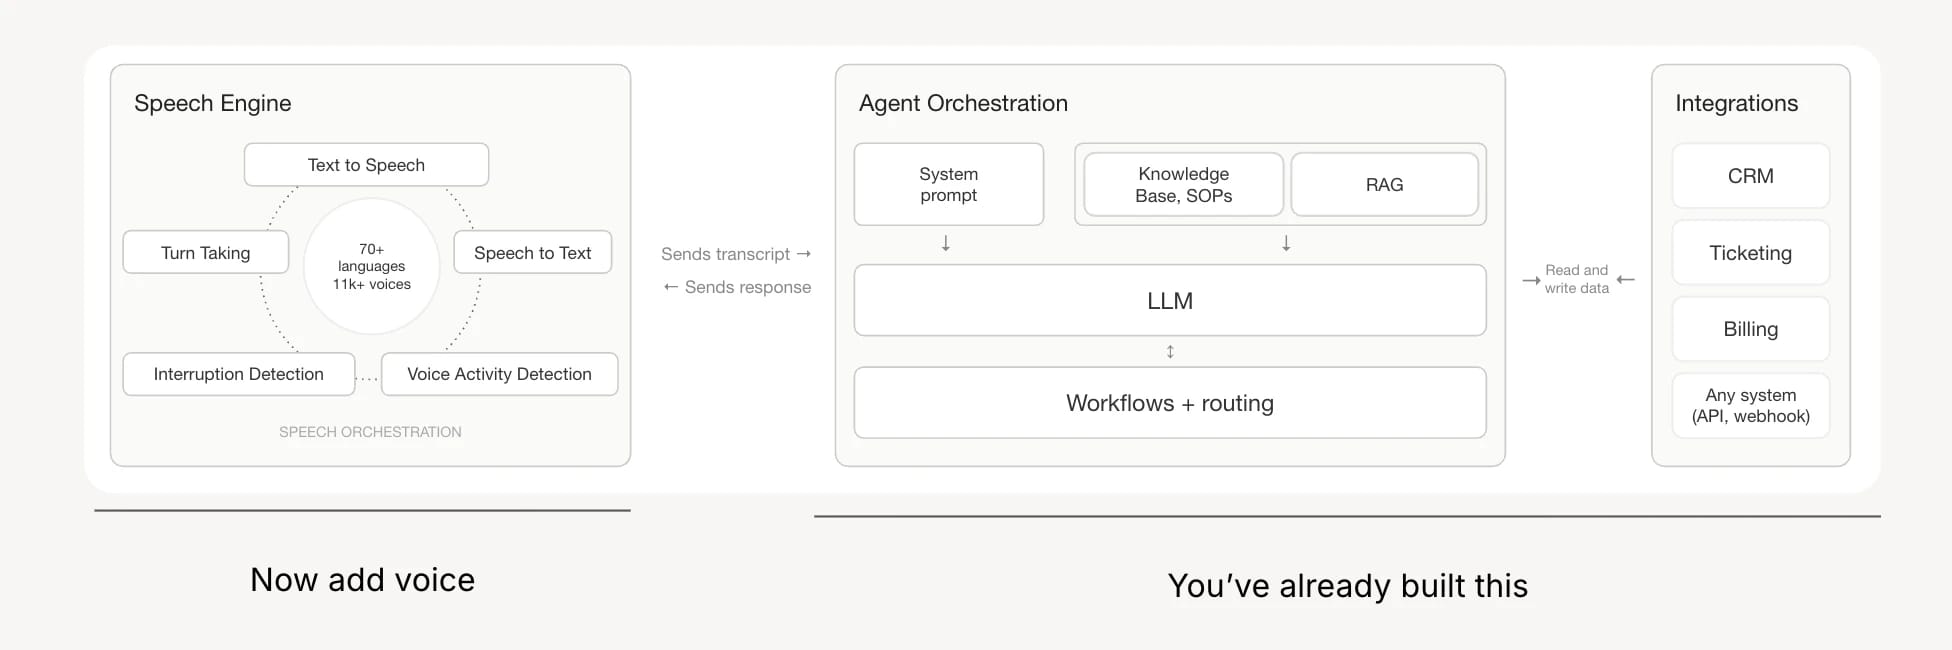
A abordagem mais simples é uma arquitetura com dois WebSockets.
- Uma conexão é estabelecida entre o cliente e a API da ElevenLabs, e outra entre o seu servidor e a API da ElevenLabs
- O usuário fala ao microfone, o áudio é enviado à API da ElevenLabs, onde é transcrito e encaminhado ao seu servidor
- Seu servidor envia ao LLM todo o histórico da conversa recebido da API da ElevenLabs, e a resposta transmitida em streaming volta para a síntese de áudio
- Isso pode começar antes que o LLM termine de gerar a resposta — mantendo baixa a latência do primeiro byte
O principal ponto de integração é o método onTranscript , acionado ao fim de cada turno e que envia todo o histórico da conversa ao LLM.
Uma contextualUpdate no início da sessão transfere o que aconteceu na parte em texto da conversa antes de o usuário mudar para voz — o que permite que um único agente trabalhe nas duas modalidades sem perder o contexto.
Alguns pontos importantes ao desenvolver:
- A escolha do LLM importa mais na voz do que no chat. Modelos de raciocínio profundo introduzem pausas que soam como hesitação não natural no áudio, mesmo que a qualidade da resposta seja maior. Para voz em tempo real, modelos mais rápidos quase sempre vencem em qualidade percebida.
- Prefira WebRTC a WebSockets para áudio. O WebRTC conta com cancelamento de eco e ruído integrado, algo especialmente importante em dispositivos móveis ou ambientes barulhentos. Usar WebSockets para transportar áudio significa cuidar disso por conta própria.
- Não peça aos usuários que selecionem um idioma. Isso interrompe o fluxo da conversa. Detectar o idioma nos primeiros segundos de fala e defini-lo é um padrão melhor — e permite alternar de forma fluida sem exigir nenhuma ação do usuário.
- Separe seu modelo de alternância de turnos do LLM. Usar o LLM para decidir quando um usuário terminou de falar aumenta a latência e o custo a cada turno. Um modelo dedicado de alternância de turnos lida com isso de forma mais rápida e precisa, e vale a pena tratá-lo como um componente distinto na arquitetura.
Quanto da infraestrutura você deve ter
A resposta certa depende do que já existe. Se você tem um agente de chat funcional, adicionar uma camada de voz por cima — mantendo seu LLM, sua orquestração e sua lógica de negócio intactos — normalmente é o caminho mais rápido e com menor risco.
Você não está reconstruindo nada. Está adicionando uma interface de áudio a algo que já funciona.
Se os requisitos incluem telefonia, gerenciamento de canais de implantação, testes integrados e análises, faz sentido delegar uma parte maior da infraestrutura a uma plataforma de agentes de voz. As duas abordagens não são mutuamente exclusivas — as equipes podem começar com uma camada de voz leve e incorporar recursos da plataforma à medida que o caso de uso amadurece.
Demo: adicionando voz a um chatbot existente
Esta demonstração acompanha um usuário que está no meio de uma conversa com um chatbot de planejamento de viagens baseado em texto, pedindo recomendações de bairros e comida para uma viagem ao Japão.
O que abordamos:
- O chatbot recebeu uma camada de voz sem nenhuma alteração no agente subjacente.
- O usuário passou de digitar para falar no meio da conversa — o agente manteve todo o contexto nas duas modalidades.
- O usuário falou em holandês; o agente detectou a mudança de idioma automaticamente
- Quando o agente foi interrompido e solicitado a voltar ao inglês no meio da frase, ele fez isso — e terminou a resposta com um leve sotaque holandês, sem receber instruções para isso.
- Durante toda a conversa, a detecção de interrupções permitiu que o usuário falasse naturalmente por cima do agente, sem que ele concluísse seu turno.
Por que isso importa:
A demonstração não mostrava um agente de voz criado especificamente para isso. Mostrava um agente de texto que já funcionava, com uma camada de voz adicionada por cima. O tratamento de contexto, a detecção de idioma e o comportamento diante de interrupções vieram todos da camada de voz — o agente de texto subjacente permaneceu inalterado.
Assista à sessão completa
Assista ao webinar completo aqui.
Paul faz parte do time de Crescimento para Desenvolvedores na ElevenLabs, em Valência, Espanha, onde atua como Engenheiro de Experiência do Desenvolvedor, focado em advocacy e ferramentas para a plataforma. Antes da ElevenLabs, ele liderou Relações com Desenvolvedores na Stripe, trabalhou com DX na WorkOS e passou anos criando aplicações web full-stack e ferramentas para desenvolvedores.