Integração com a API de Transformar Texto em Áudio: streaming, processamento em lote e tentativas
- Publicado
- Última atualização
OuvirOuça este artigo
Integrar uma API de Text to Speech é simples… depois de tomar algumas decisões concretas: qual modo de transferência usar, como escolher um modelo e formato de saída, como fazer streaming, como processar um alto volume sem exceder seu limite de simultaneidade, como armazenar em cache e tentar novamente para nunca pagar pela renderização do mesmo áudio duas vezes e como comparar o tempo até o primeiro byte com outro provedor.
Para ajudar você a integrar uma API de Text to Speech, detalhamos cada uma dessas decisões de arquitetura e o que fazer. Este guia ajudará você a integrar a API de Text to Speech da ElevenLabs e escalar, com trechos de código que você pode colar em produção para começar.
Para uma base completa sobre os conceitos mencionados aqui, consulte nossos guias sobre entender o streaming de áudio, otimizar a latência e a visão geral dos modelos da ElevenLabs.
Resumo
- Há um endpoint da API de Text to Speech da ElevenLabs, que você pode acessar de três formas: conversão em lote, streaming por HTTP e WebSocket stream-input.
- Em HTTP, cada solicitação em andamento conta para o seu limite de simultaneidade; no WebSocket, apenas a geração ativa conta.
- Mantenha o paralelismo um pouco abaixo do limite do seu plano e armazene em cache um hash de cada parâmetro que afeta a saída para nunca cobrar pelo mesmo texto duas vezes.
- Tente novamente erros 429 e 5xx com recuo exponencial e jitter completo para reduzir o ritmo antes de atingir o limite de simultaneidade.
Três formas de integrar a API de Text to Speech
Há um endpoint de Text to Speech, mas a forma como você o integra define sua latência, complexidade e custo.
A mesma chamada POST /v1/text-to-speech/{voice_id} funciona de três maneiras, cada uma adequada a uma tarefa um pouco diferente. Veja as três formas de integrar a API de Text to Speech:
- O lote (convert) é a integração mais simples: você envia uma solicitação e recebe uma resposta de áudio. É a opção menos complexa e tem o maior tempo até o primeiro áudio, pois todo o clipe é sintetizado antes que qualquer byte retorne.
- O streaming HTTP (stream) mantém a mesma solicitação, mas divide a resposta em partes: você acrescenta /stream ao caminho, chama o método stream e o áudio retorna como uma resposta fragmentada. O código é praticamente idêntico, e a latência percebida é muito menor.
- O WebSocket (stream-input) mantém uma conexão persistente: você envia texto incrementalmente e recebe trechos de áudio à medida que avança. Ele foi criado para agentes interativos e para converter a saída de um LLM em fala conforme os tokens são produzidos, antes de a frase terminar.
O streaming não faz o modelo gerar áudio mais rápido; o tempo de inferência não muda. O que o streaming altera é quando você recebe o primeiro trecho: ele é enviado antes que todo o clipe esteja pronto, então a espera percebida pelo usuário é menor, embora o trabalho total seja o mesmo.
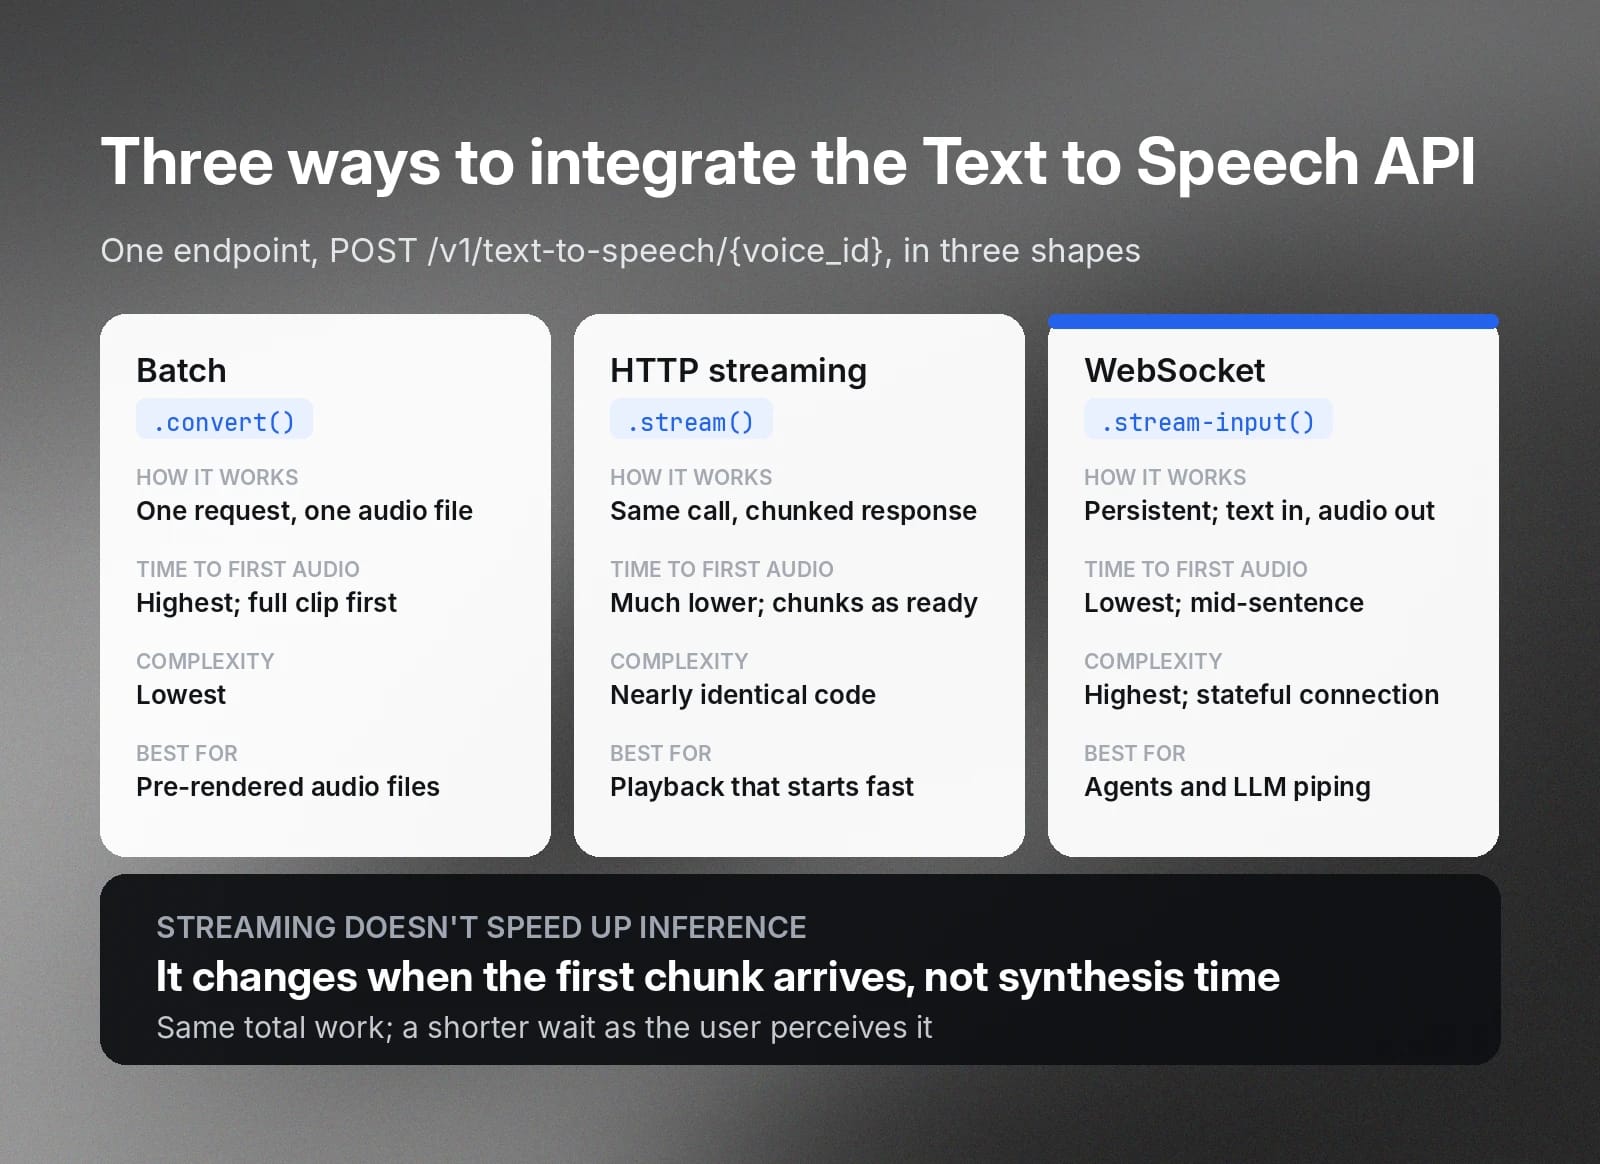
Tabela de decisão: lote vs. streaming vs. WebSocket
Ao decidir entre esses três métodos, há diversos fatores que você deve considerar.
Como guia rápido: escolha lote para renderização offline, streaming HTTP para texto conhecido que um usuário está aguardando e WebSocket para agentes e conversão de LLM em fala ao vivo.
A tabela abaixo detalha as concessões entre as dimensões que importam em escala.
Em HTTP, seja em lote ou streaming, cada solicitação em andamento conta para o limite de simultaneidade do seu plano durante toda a sua duração. Em um WebSocket, apenas o tempo em que o modelo está gerando áudio ativamente conta; um socket aberto, mas ocioso, praticamente não custa nada.
Para um agente de voz em cascata que mantém uma conexão aberta durante toda uma conversa, mas gera áudio apenas nos turnos do agente, essa diferença é grande e é o principal motivo para usar WebSockets ao criar agentes. O protocolo completo está documentado no guia de WebSocket de Text to Speech em tempo real.
Como escolher um modelo e um formato de saída
Duas escolhas definem o áudio que você recebe da integração com sua API de TTS. Primeiro, o modelo, que determina qualidade e velocidade. Segundo, o formato de saída, que define o contêiner, a taxa de bits e a taxa de amostragem.
Acertar ambos desde o início garante que tudo o que vem depois, como latência e compatibilidade com telefonia, funcione corretamente.
Modelos
Oferecemos vários modelos de Text to Speech. Eles não são classificados do melhor ao pior; cada um faz concessões diferentes.
O valor de ~75 ms se refere à inferência do modelo em condições representativas, sem incluir a latência da rede e da aplicação. Ele aumenta com entradas mais longas e sob carga. Sempre meça a partir da sua aplicação, não de um número de benchmark.
Os modelos Flash são menores e usam aproximações mais agressivas para reduzir o tempo de inferência. Eleven v4 e Multilingual v2 são modelos maiores que dedicam mais tempo por caractere para gerar uma saída mais rica.
Para um fluxo em tempo real ou de agentes, use eleven_flash_v2_5; é a opção multilíngue com menor latência. Para narração, audiolivros ou locução de marketing, use eleven_multilingual_v2 quando quiser alta fidelidade estável, ou eleven_v4 quando precisar de máxima expressividade e amplitude emocional.
Quando a pronúncia importa, como em números de telefone, datas ou valores monetários, faça você mesmo a normalização dos números na aplicação antes que o texto chegue à API. Escreva por extenso a forma falada que você quer.
Fazer a normalização você mesmo mantém a pronúncia previsível entre os modelos e evita depender de padrões específicos de cada modelo, que podem mudar.
Formato de saída
O parâmetro output_format controla o contêiner, a taxa de amostragem e a taxa de bits do áudio que você recebe. Os valores que você mais usará são:
Configurações de voz
As configurações a seguir controlam como a fala gerada é entregue:
- Estabilidade: controla a consistência em relação à expressividade. Valores mais baixos produzem uma fala mais variada e expressiva, enquanto valores mais altos produzem uma entrega mais estável e previsível.
- SimilarityBoost: controla o quanto a saída segue a voz de referência.
- Estilo: exagera o estilo de fala natural da voz quando aumentado.
- useSpeakerBoost: aumenta a semelhança com o locutor original, com um pequeno custo de latência.
- Velocidade: ajusta o ritmo da fala em torno do valor padrão de 1.0.
Entre essas configurações, Stability normalmente tem o maior impacto na qualidade percebida. Valores mais baixos criam uma saída mais expressiva, mas menos consistente, enquanto valores mais altos priorizam consistência e previsibilidade.
Ao escolher uma voz, a combinação de menor latência é Flash com uma Clonagem de Voz instantânea ou uma voz padrão; as Clonagens de Voz Profissionais soam excelentes, mas adicionam uma sobrecarga por geração que você deve considerar.
Neste guia, o ID da voz de exemplo é JBFqnCBsd6RMkjVDRZzb (George).
Integração de streaming (HTTP e WebSocket)
Nesta seção, abordamos o núcleo prático da integração com a API de Text to Speech. Mostramos como instalar o SDK, abrir um stream e consumir o áudio conforme ele chega. O fluxo HTTP abrange a maior parte da reprodução na web e em apps, enquanto o fluxo WebSocket atende agentes e saída de LLM ao vivo.
Ambos os caminhos pressupõem que você tenha inicializado o cliente da ElevenLabs abaixo.
O fluxo de streaming abre um stream e consome trechos conforme eles chegam. voiceId é o primeiro argumento posicional, seguido por um objeto de opções com chaves em camelCase (modelId, outputFormat, voiceSettings):
Para a variante WebSocket, conecte-se a wss://api.elevenlabs.io/v1/text-to-speech/{voice_id}/stream-input, envie uma primeira mensagem com suas configurações de voz e um espaço inicial, depois envie mensagens de texto conforme elas se tornarem disponíveis e leia os frames JSON de retorno, cujo campo audio contém trechos codificados em base64.
Processamento em lote e limites de simultaneidade para alto volume
A integração de alto volume é definida pela simultaneidade, que é o número de solicitações gerando áudio no mesmo instante. Cada plano tem um limite por família de modelos.
Cada plano inclui um limite de simultaneidade distinto:
- Grátis: 4 solicitações Flash simultâneas.
- Starter: 6 solicitações Flash simultâneas.
- Creator: 10 solicitações Flash simultâneas.
- Pro: 20 solicitações Flash simultâneas.
- Scale e Business: 30 solicitações Flash simultâneas, com limites personalizados para Enterprise.
Os limites do Multilingual v2 são cerca de metade dos valores acima.
Um pool limitado resolve isso restringindo quantas solicitações são executadas ao mesmo tempo:
Defina MAX_CONCURRENCY um pouco abaixo do limite do seu plano, em vez de exatamente nele. Essa margem absorve qualquer outro tráfego que compartilhe a mesma chave e mantém você abaixo do limite em que um 429 é retornado.
Limites de caracteres e divisão de textos longos
Todo modelo limita a quantidade de caracteres que aceita em uma única solicitação. Qualquer integração de conteúdo longo precisa dividir o texto e unir o áudio novamente.
Estes são os limites de caracteres por solicitação para cada modelo:
- Flash v2.5: aceita até 40.000 caracteres por solicitação.
- Flash v2: aceita até 30.000 caracteres por solicitação.
- Multilingual v2: aceita até 10.000 caracteres por solicitação.
- Eleven v3: aceita até 5.000 caracteres por solicitação.
- Eleven v4: aceita até 10.000 caracteres por solicitação.
Textos mais longos precisam ser divididos em várias solicitações. Procure dividir nos limites das frases para que a prosódia seja preservada na junção entre os trechos.
Renderize os trechos na ordem correta e concatene o áudio. Para narração longa em que cada trecho é independente, as duas partes se compõem diretamente: envie a saída de splitText ao pool limitado acima e deixe-o cuidar do restante.
Cache e idempotência
A saída de Text to Speech é suficientemente determinística para que renderizar novamente o mesmo texto com a mesma voz, modelo e configurações seja um desperdício. Armazene o resultado em cache com base em um hash das entradas que afetam o áudio, e a mesma chave também serve como token de idempotência em novas tentativas.
Veja como fazer ambos.
A regra para isso funcionar é que todo parâmetro que altera o áudio deve estar na chave, incluindo outputFormat e as configurações de voz. Feito corretamente, a mesma chave também serve como token de idempotência. Quando um cliente tenta novamente uma solicitação que já foi concluída, você retorna os bytes armazenados em cache em vez de gerar tudo outra vez.
Tratamento de erros e limites de taxa (429)
Um cliente de produção precisa de novas tentativas com recuo e jitter, além de tratamento que varia conforme o código de status, pois algumas falhas valem uma nova tentativa e outras não.
A tabela abaixo associa cada status à ação correta, e a seção explica por que um 429 é um limite flexível, não uma barreira rígida.
Um 429 não é uma barreira rígida, e é útil entender o mecanismo. Quando você excede o limite de simultaneidade, as solicitações primeiro entram em fila por prioridade, o que normalmente adiciona cerca de 50 ms. Você só recebe um 429 se continuar acima da capacidade depois disso.
A resposta também inclui os cabeçalhos current-concurrent-requests e maximum-concurrent-requests, que mostram sua margem disponível em tempo real. Assim, você pode consultá-los e reduzir o ritmo antes de atingir o limite.
Quando você precisa de mais margem, e não de um comportamento melhor de novas tentativas, faça upgrade do seu plano. Clientes Enterprise podem solicitar limites maiores por meio de seu gerente de conta.
Benchmark de latência e tempo até o primeiro byte
A latência depende da sua região, da sua entrada e da carga atual. Isso significa que o único número de latência em que vale a pena confiar é aquele que você mediu no seu próprio ambiente.
Esta seção fornece o tempo até o primeiro byte (TTFB) para o endpoint de streaming Flash e foi estruturada para que você possa usar o mesmo harness com outro provedor e compará-los em condições idênticas.
Trate isto como uma metodologia, não como um resultado publicado. Uma única execução não garante nada.
Veja alguns pontos importantes ao avaliar a latência de uma integração com API de Text to Speech:
- Inclua a ida e volta da rede: o TTFB depende da sua localização e do cluster mais próximo do provedor, então execute o teste de onde seus servidores normalmente operam.
- Descarte uma execução de aquecimento: a primeira solicitação em uma conexão fria é mais lenta e pode distorcer seus números.
- Mantenha as entradas fixas: o comprimento da entrada, a voz, o modelo e a carga influenciam o resultado, portanto mantenha-os idênticos entre os provedores.
- Informe uma distribuição: os números variam de uma execução para outra, então publique a mediana e o p95, em vez de um único valor.
Com esses pontos em mente, você está pronto para fazer o benchmark.
Para comparar com outro provedor, escreva uma função com a mesma estrutura. Depois, execute ambas com um pequeno runner que descarta uma chamada de aquecimento, coleta cerca de 20 amostras cronometradas espaçadas para que não concorram entre si e informa a mediana e o p95 em milissegundos.
Uma comparação justa depende de controlar as variáveis.
Execute ambos os provedores na mesma máquina e rede, de preferência em um servidor na região em que você realmente faz a implantação, e não em um laptop usando banda larga residencial. Use o mesmo texto de entrada e mantenha o áudio curto para que a inferência do modelo domine o número, e não a duração da geração. Informe a mediana e o p95 de várias execuções, porque uma única medição é ruído.
Lembre-se de que o TTFB pela internet pública inclui de 20 a 200 ms de ida e volta da rede, o que não tem relação com o modelo. Atendemos a partir de clusters na América do Norte, Europa e Sudeste Asiático e direcionamos você ao mais próximo. Portanto, localize seu cliente de teste de acordo, ou você estará principalmente medindo a distância até o data center.
Principais aprendizados para sua integração com a API de Text to Speech
Uma integração de produção com a API de Text to Speech depende de algumas decisões importantes.
Se você acertar estas decisões, todo o resto se encaixa:
- Escolha o modelo pela tarefa: use Flash v2.5 para tudo que for interativo e um modelo de maior fidelidade, como Multilingual v2 ou Eleven v4 para renderização offline, em que a latência importa menos.
- Use streaming sempre que um usuário estiver esperando: use streaming HTTP para texto conhecido e um WebSocket para agentes, para que o tempo ocioso não consuma seu orçamento de simultaneidade.
- Limite seu paralelismo ao limite do plano: restrinja as solicitações simultâneas a um valor pouco abaixo do limite do seu plano e armazene em cache com base em um hash de cada parâmetro que afeta a saída para que o mesmo áudio nunca seja cobrado duas vezes.
- Tente novamente 429 e 5xx com recuo exponencial e jitter completo: reduza o ritmo em 429 e 5xx com jitter completo e monitore os cabeçalhos de simultaneidade para saber o quão perto você está do limite.
- Divida textos longos nos limites das frases: divida nos limites das frases respeitando o limite de caracteres de cada modelo para que a prosódia sobreviva à junção.
Se quiser se aprofundar ainda mais, confira o guia prático de streaming, conceito de streaming de áudio, autenticação e tokens de uso único para uso no lado do cliente.
Crie sua integração de Text to Speech com a ElevenAPI
Depois de ler este guia, você tem todos os padrões necessários para uma integração de produção com a API de Text to Speech. Em streaming, processamento em lote, cache, novas tentativas e até benchmarks, você está pronto para colocar tudo em operação.
Comece aprendendo mais sobre a API de Text to Speech ou crie sua conta para fazer sua primeira chamada com a ElevenAPI hoje.
Perguntas frequentes sobre a integração com a API de Text to Speech

Tadas Petra é engenheiro de Relações com Desenvolvedores e ajuda desenvolvedores a criar com a suíte de produtos da ElevenLabs. Ele também é fundador da Hungrimind, uma plataforma de educação para desenvolvedores. Antes disso, foi Líder de Advocacia para Desenvolvedores na Agora e instrutor na Zero To Mastery.