Como são criadas vozes sintéticas para uma fala natural?
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
Os sofisticados modelos de IA atuais criam vozes sintéticas que soam como fala natural. Treinados com enormes conjuntos de dados de vozes humanas reais, esses modelos usam redes neurais avançadas para identificar e reproduzir padrões autênticos de fala. A criação de uma voz sintética também é chamada de síntese de fala ou síntese de voz, enquanto o áudio produzido é chamado de fala sintética.
Para criar uma nova voz sintética, o usuário grava a própria fala. Enquanto isso, o modelo de IA analisa seus padrões fonéticos e sua entonação únicos e usa esses dados para reproduzir sua voz. Em seguida, o usuário pode ajustar características vocais, como sotaque, tom e ritmo, para criar o resultado final. Algumas vozes sintéticas são um clone direto da fala de uma pessoa, enquanto outras combinam várias vozes. As vozes também podem ser criadas a partir de uma descrição em texto, sem nenhuma gravação.
As vozes sintéticas abrem uma ampla variedade de possibilidades criativas para podcasts, audiolivros, jogos eletrônicos e publicidade. Neste artigo, vamos explorar como as vozes sintéticas são criadas, o que as faz soar naturais e como criar sua própria voz sintética com a ElevenLabs.
Resumo
- Vozes sintéticas são criadas com modelos de IA neural que analisam e reproduzem padrões de fala humana.
- Vozes sintéticas ajudam a narrar audiolivros, gerar diálogos para jogos eletrônicos, criar podcasts e locuções em escala, desenvolver agentes de IA para atendimento ao cliente ou até preservar vozes que correm risco de se perder.
- A clonagem de voz funciona analisando gravações da voz de uma pessoa específica e reproduzindo seu sotaque e seus padrões de fala únicos.
- As vozes de IA modernas soam naturais porque reproduzem a prosódia humana e compreendem o contexto, em vez de apenas reproduzir palavras ou sílabas isoladas.
Como as vozes sintéticas são criadas, passo a passo
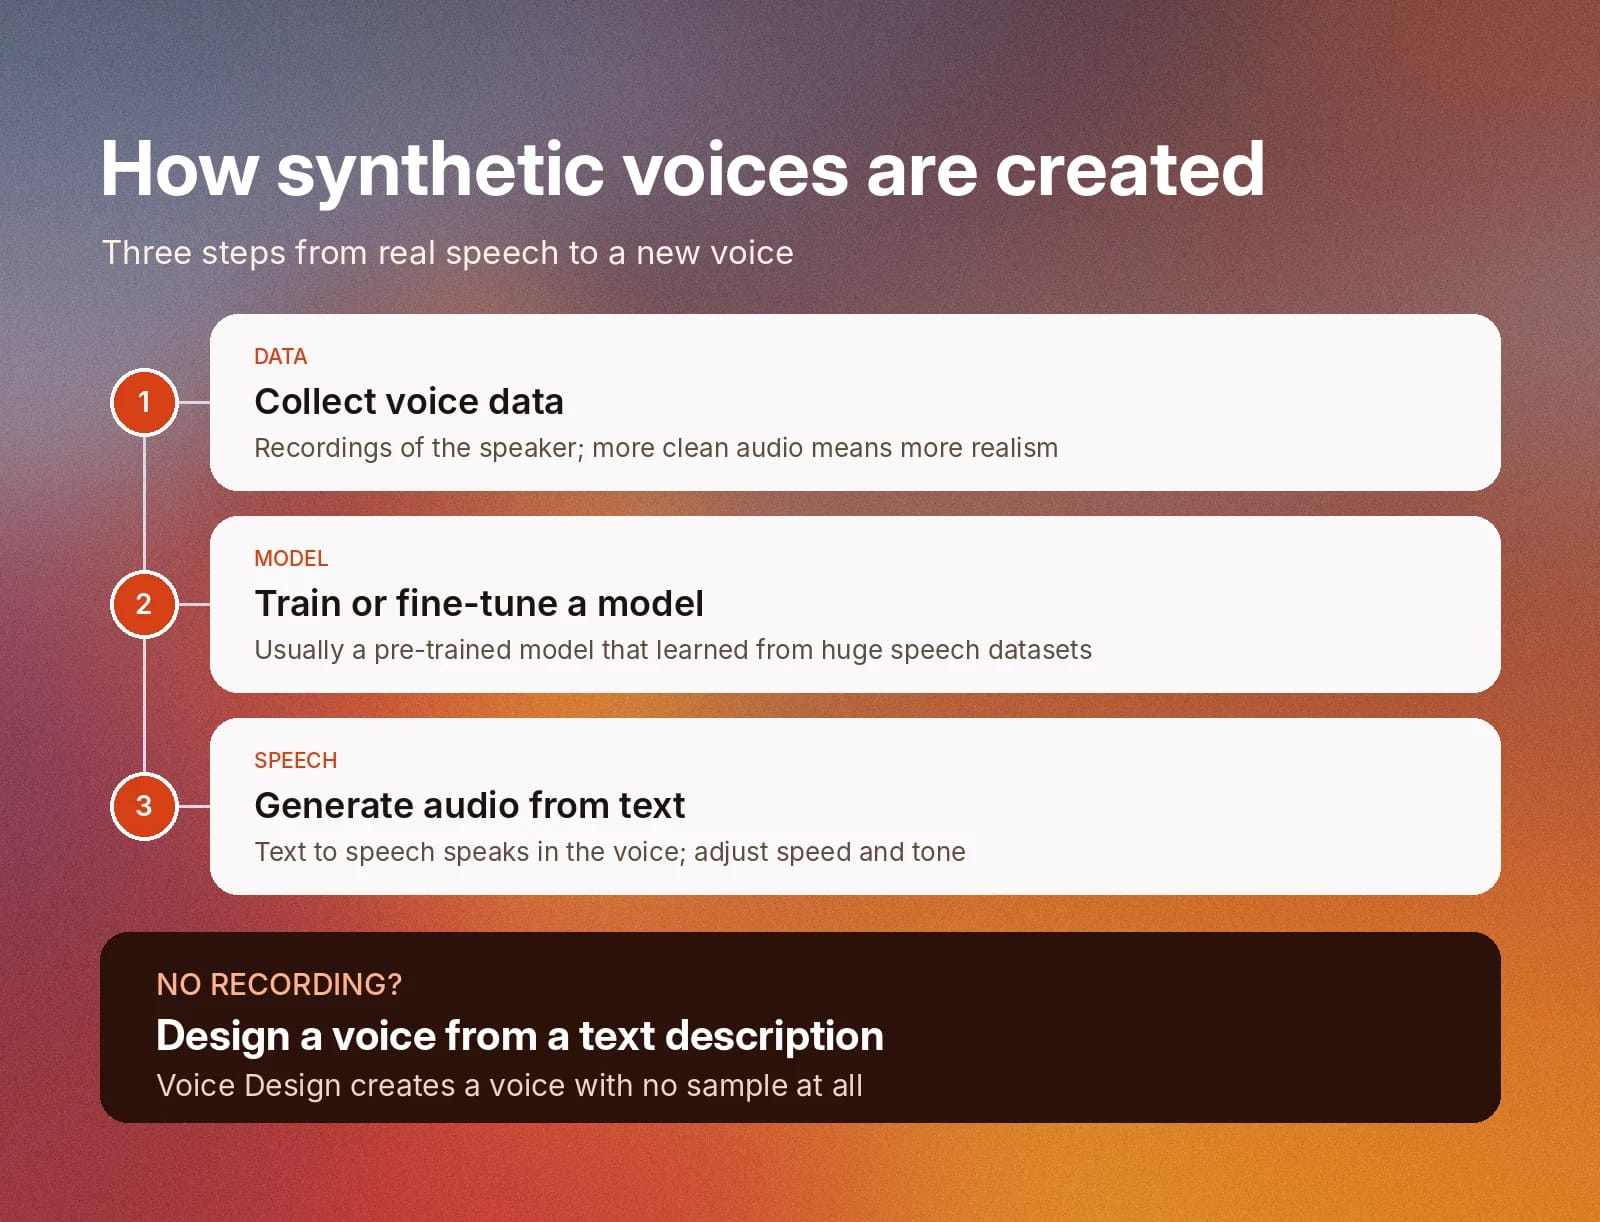
A criação de uma voz sintética é um processo de três etapas.
Veja como isso funciona na prática:
- Etapa 1: coletar dados de voz: Vozes sintéticas começam com a fala humana real. Para criar uma nova voz, você precisará de gravações de áudio das pessoas que deseja reproduzir. Quanto mais dados fornecer, mais precisa e realista será a voz final. Confira algumas práticas recomendadas para clonagem de voz.
- Etapa 2: treinar ou fazer o ajuste fino de um modelo de IA: Para criar vozes sintéticas, os modelos de IA primeiro analisam grandes conjuntos de dados com uma ampla variedade de gravações de fala. Os modelos usam esses dados para compreender padrões de fala humana. Depois que um modelo de IA é treinado, ele pode clonar vozes reais usando uma única gravação de fala. Na maioria dos casos, você usará um modelo pré-treinado em vez de criar o seu do zero.
- Etapa 3: gerar áudio a partir de texto: Vozes sintéticas usam Text to Speech para gerar áudio. Você pode ajustar fatores como velocidade e tom conforme suas preferências. Para se aprofundar, leia nosso guia sobre como funciona a tecnologia de Text to Speech.
Dos dados de fala ao Text to Speech neural
Modelos neurais de Text to Speech são treinados com diversos conjuntos de dados de gravações de fala reais. Esses conjuntos incluem gravações em diferentes idiomas, sotaques, emoções e alturas de voz. O Text to Speech neural é uma forma de síntese de fala amplamente usada hoje.
Os modelos tradicionais uniam gravações existentes de palavras, sílabas e fonemas. Os resultados eram muito robóticos, pois não conseguiam reproduzir as variações de altura, ritmo e expressão que fazem a fala soar humana.
Em vez de apenas aprender como letras e sílabas soam, os modelos modernos de Text to Speech neural aprendem padrões naturais de pronúncia humana e ritmos de fala. Ao converter texto em fala, esses modelos analisam o texto, convertem-no em características acústicas e usam essas características para gerar formas de onda.
Como características acústicas, como altura, ritmo e tom, estão incorporadas aos modelos de IA neural, a fala resultante soa muito mais natural e autêntica do que nos modelos do passado.
Os resultados também são personalizáveis: você pode alterar fatores como velocidade, emoção e até sotaque para obter exatamente a voz que procura. Por exemplo, sua marca pode usar a mesma voz sintética em todo o site, mas transmitir entusiasmo e urgência em conteúdos de marketing e tranquilidade nas interações de atendimento ao cliente.
Text to Speech padrão, neural e generativo
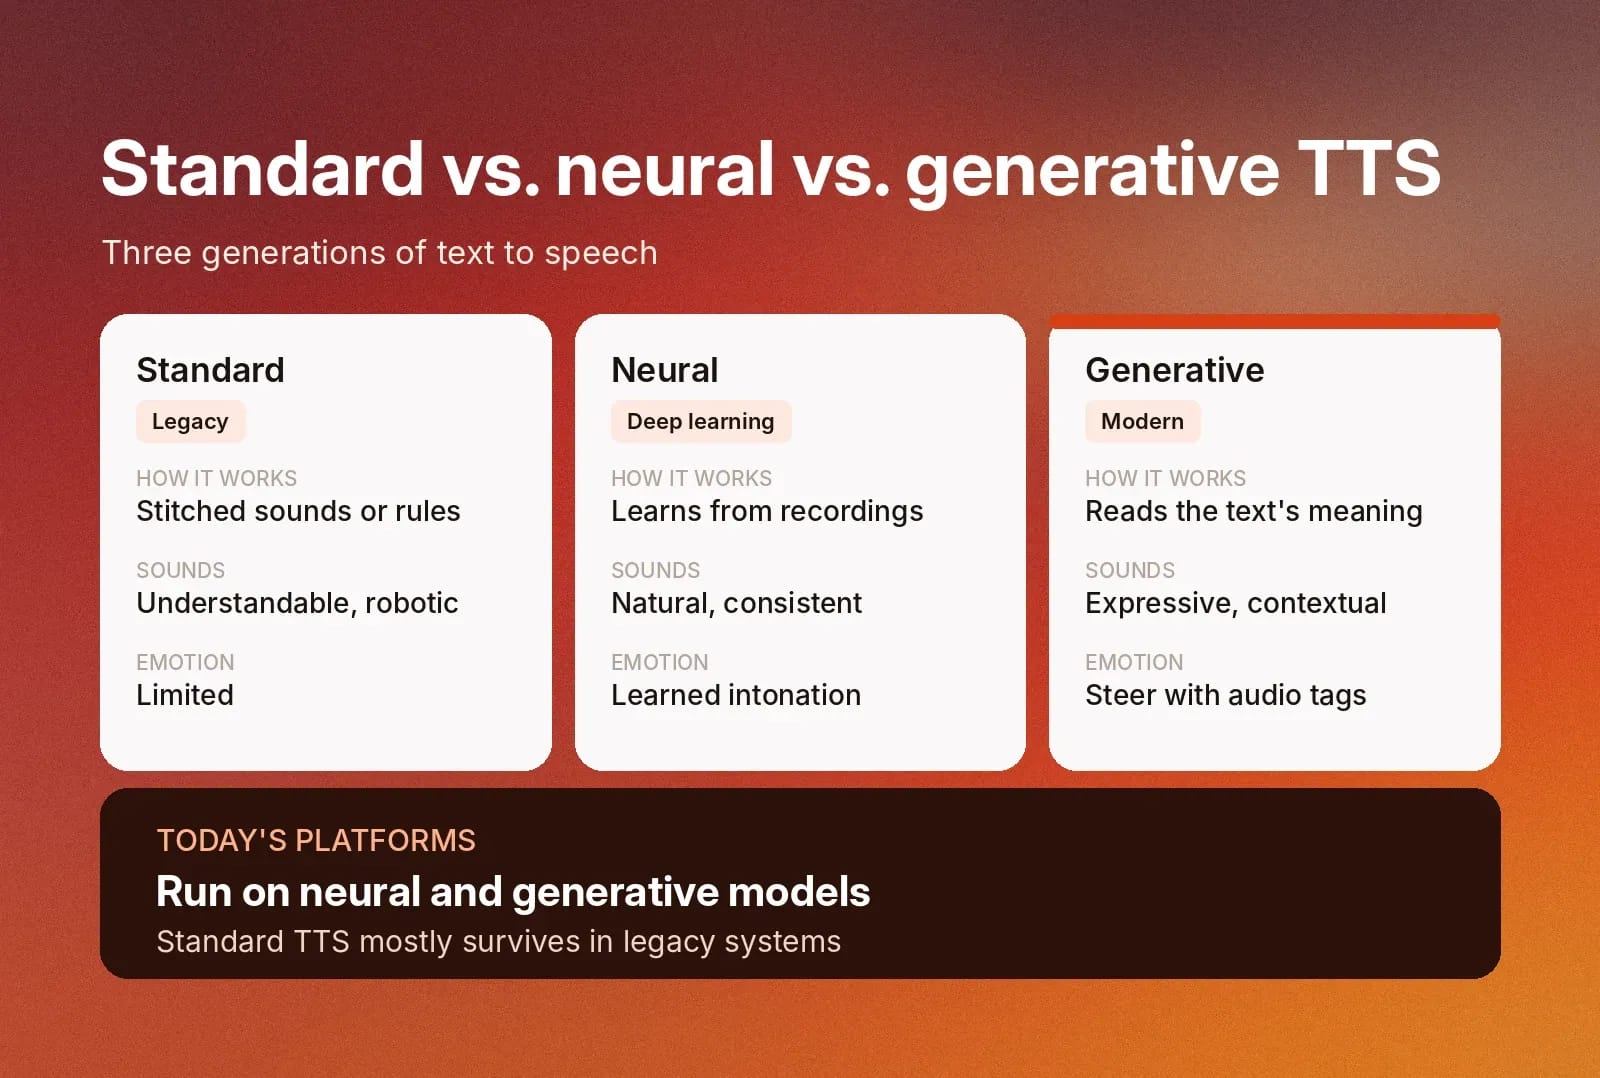
Os modelos de Text to Speech se dividem em três grandes gerações.
Entender as diferenças entre elas ajuda a contextualizar por que modelos modernos, como o Text to Speech da ElevenLabs, podem soar tão naturais.
- Text to Speech padrão: esses sistemas unem sons pré-gravados ou seguem regras e modelos estatísticos para pronunciar textos. O resultado é compreensível, mas robótico e com emoção limitada.
- Text to Speech neural: modelos de deep learning aprendem pronúncia, ritmo e entonação com grandes conjuntos de gravações e geram falas muito mais naturais e consistentes.
- Text to Speech generativo: modelos generativos são treinados com dados de fala ainda maiores e mais variados e usam o significado do texto para definir emoção, ritmo e ênfase. Você pode orientar a entrega com instruções, como tags de áudio.
As plataformas de voz modernas dependem de modelos neurais e generativos, enquanto o Text to Speech padrão sobrevive principalmente em sistemas legados.
O que faz a geração de voz por IA soar natural?
Vozes sintéticas geradas por IA soam muito parecidas com vozes humanas. Na verdade, pode ser difícil distinguir entre elas se você não estiver ouvindo com atenção.
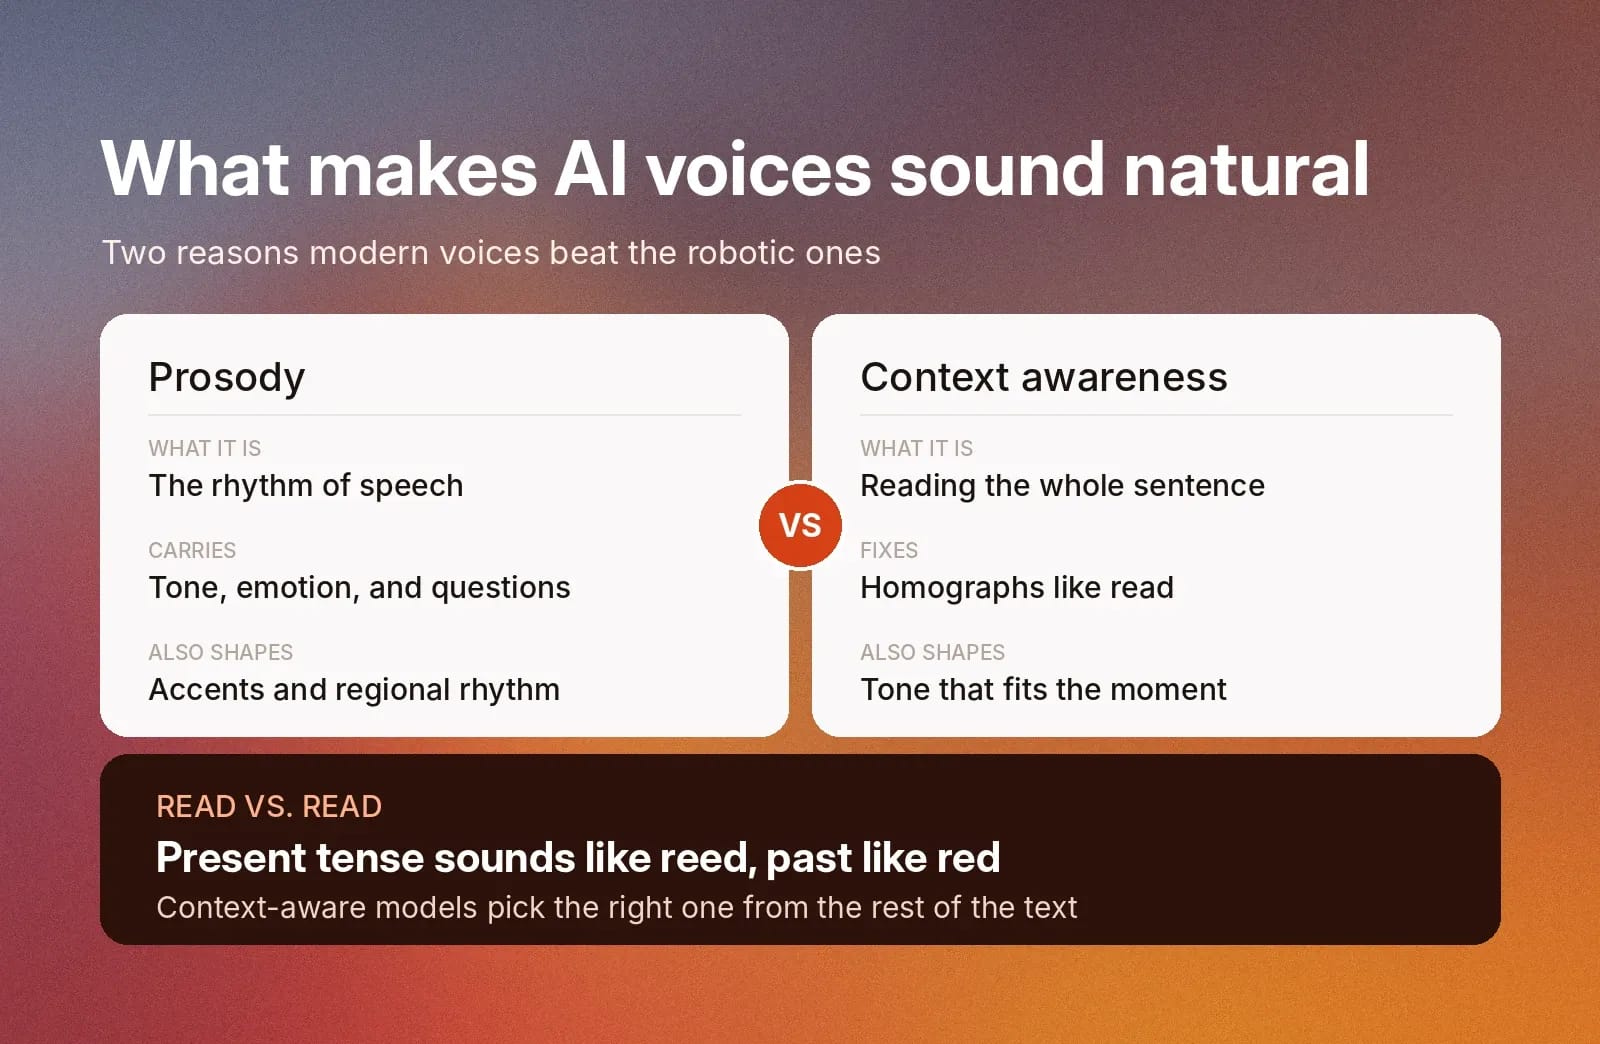
Há dois motivos pelos quais vozes geradas por IA soam mais naturais do que as vozes robóticas do passado: prosódia e compreensão de contexto.
Prosódia
A prosódia é o ritmo da fala humana natural. Pequenas mudanças na entonação e na velocidade transmitem tom e emoção enquanto falamos. Por exemplo, falar rapidamente pode transmitir estresse ou entusiasmo, enquanto elevar o tom no fim de uma frase transforma uma afirmação em pergunta.
Os modelos de voz por IA atuais são treinados para entender e reproduzir a prosódia. Isso significa que o resultado reflete o fluxo de uma conversa humana natural, em vez de soar rígido ou monótono.
Se você usa uma voz sintética para narrar um audiolivro ou criar diálogos para jogos eletrônicos, ela usará a prosódia para refletir as emoções do personagem. Se estiver criando uma locução para conteúdo educacional ou um agente de IA para atendimento ao cliente, o modelo de IA ajustará a prosódia para uma entrega calma e empática.
Ao entender a prosódia, os modelos de IA também podem reproduzir sotaques únicos. Por exemplo, o ritmo de um sotaque inglês norte-americano soa muito diferente de um sotaque inglês britânico, escocês ou irlandês, embora todos falem o mesmo idioma.
Compreensão de contexto
Em vez de processar cada palavra individualmente, os modelos de TTS com IA analisam a frase, a sentença ou a conversa inteira e ajustam a entrega com base no contexto.
Por exemplo, há muitas palavras escritas da mesma forma, mas pronunciadas de maneiras diferentes conforme o tempo verbal e o contexto. Em inglês, por exemplo, a palavra “read” é pronunciada como “reed” no presente, mas como “red” no passado.
Como as vozes de IA compreendem o contexto, elas identificam a pronúncia adequada com base no restante do texto. Elas também ajustam a entrega para que o tom e a emoção sejam adequados à situação.
Como funciona a clonagem de voz?
A clonagem de voz funciona usando IA para analisar a voz de uma pessoa real e depois aplicar suas características vocais à fala sintética.
Primeiro, a pessoa que está clonando a própria voz precisa fornecer uma pequena amostra de áudio. O modelo de IA usa essa amostra para identificar o sotaque, a altura, o tom e a cadência da pessoa. O modelo usa essas características para criar uma réplica digital da voz. Os usuários podem gerar novas falas com essa voz usando a tecnologia de Text to Speech.
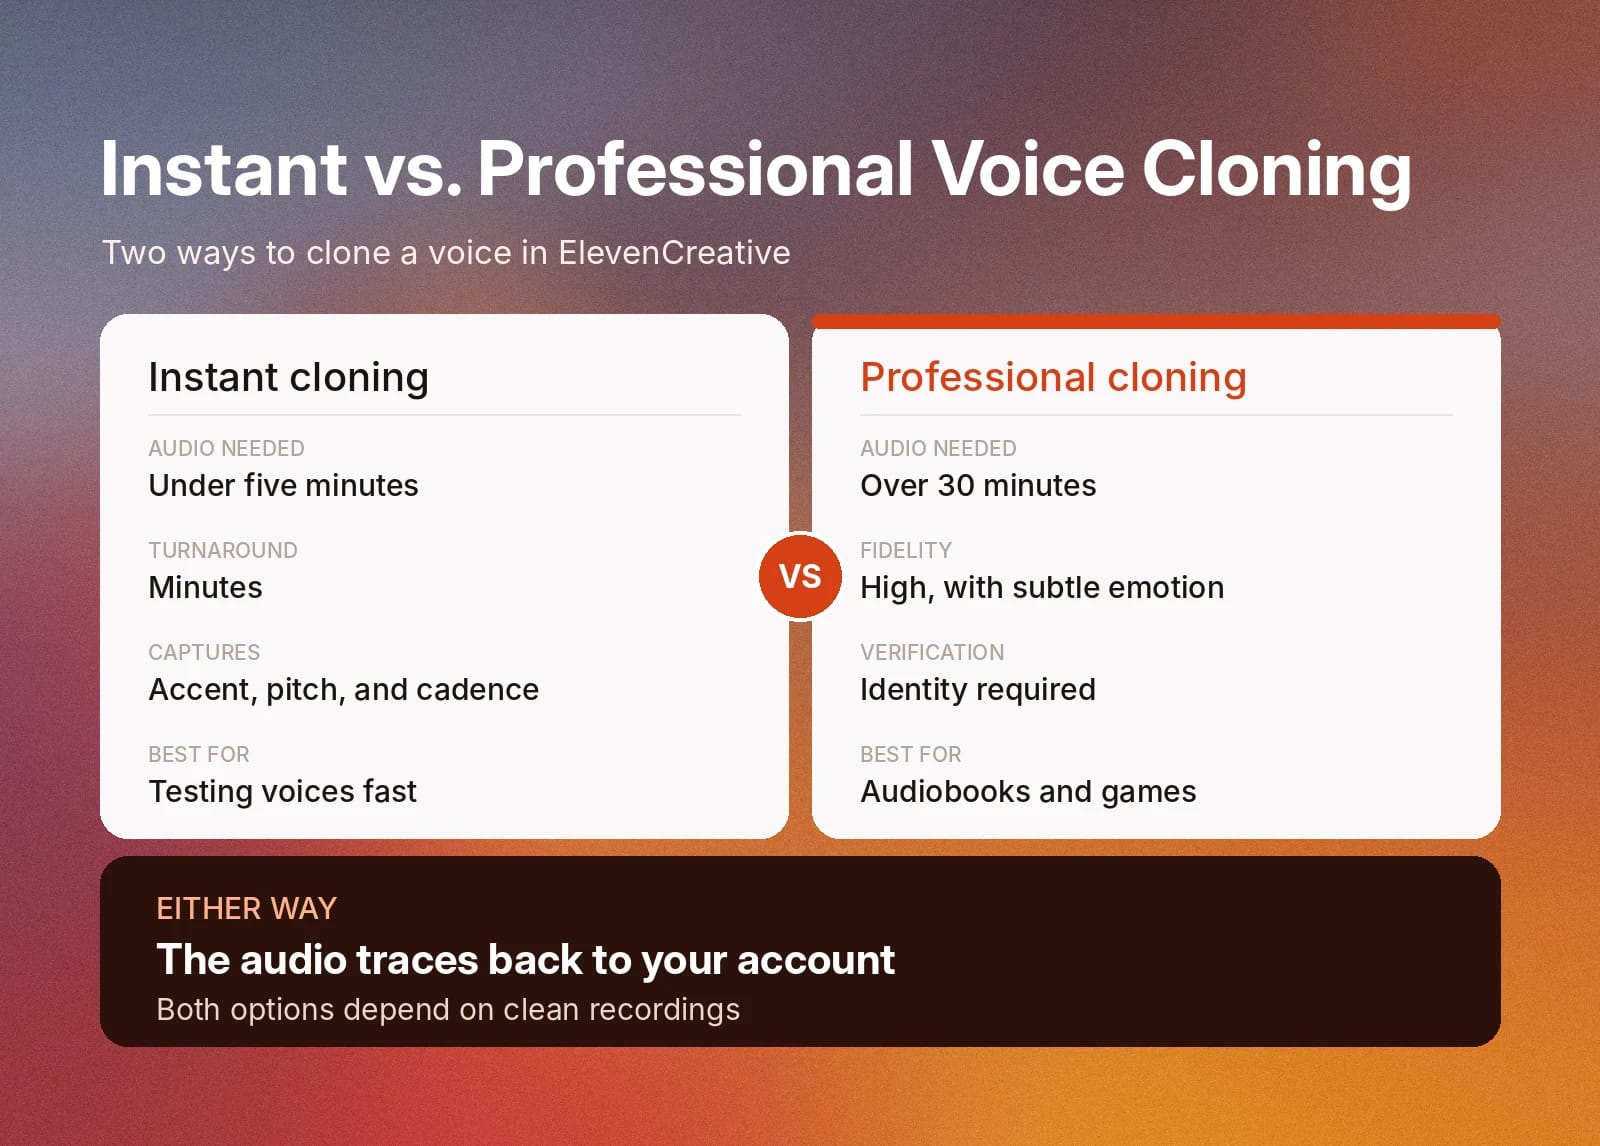
Há dois tipos de clonagem de voz: Instantânea e Profissional. A clonagem instantânea cria uma réplica da voz com menos de dois minutos de áudio de amostra. Isso facilita testar opções de voz antes de se comprometer com um projeto maior.
A clonagem profissional usa entre 30 minutos e três horas de amostras de áudio para criar um clone de voz de alta fidelidade. Clones de Voz Profissionais preservam detalhes sutis, como emoção e entonação, que não estão presentes em Clones Instantâneos. Eles também exigem verificação de identidade.
A clonagem de voz tem vários casos de uso, desde gerar locuções rapidamente até preservar vozes que poderiam se perder de outra forma.
Como gravar boas amostras de voz para síntese de fala
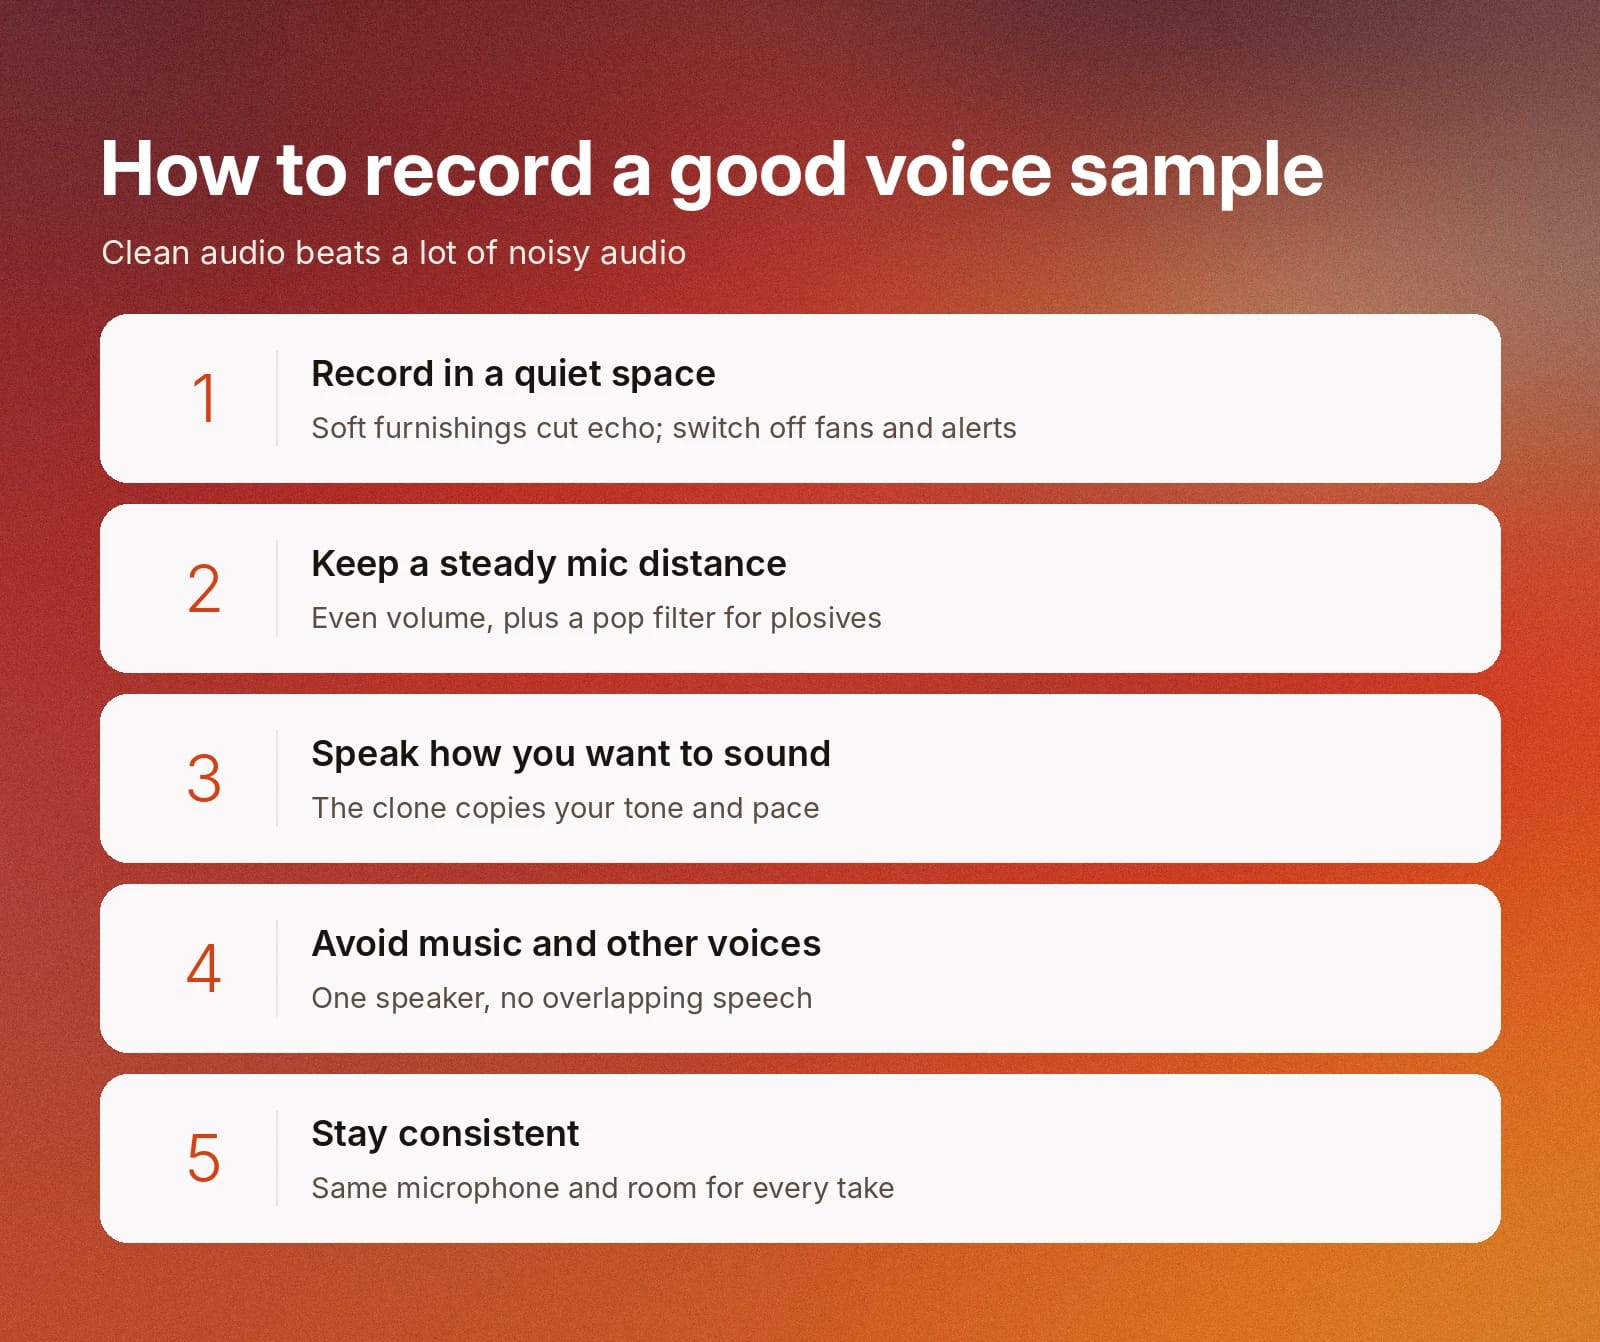
A qualidade de um clone de voz depende da qualidade da gravação. Mesmo sem equipamentos de gravação caros, há muitas pequenas ações que você pode tomar para melhorar o som do seu clone de voz.
Estes hábitos ajudam você a capturar amostras limpas:
- Grave em um ambiente silencioso: itens macios, como cortinas e tapetes, reduzem o eco, e desligar ventiladores e notificações elimina o ruído de fundo.
- Mantenha o microfone a uma distância constante: uma distância consistente mantém o volume uniforme, e um filtro pop reduz sons plosivos fortes.
- Fale como você quer que o clone soe: o clone copia sua forma de falar. Grave no tom e no ritmo que pretende usar.
- Evite música e outras vozes: use um único locutor, sem música de fundo nem falas sobrepostas.
- Mantenha a consistência: use o mesmo microfone e ambiente em todas as gravações.
Embora a Clonagem Instantânea precise de menos áudio e a Clonagem Profissional precise de mais, ambas dependem de gravações limpas. Um áudio limpo com a duração adequada oferece resultados melhores do que uma grande quantidade de áudio com ruído.
Como criar uma voz sem gravar: Voice Design
Nem toda voz sintética começa com uma gravação. Com o Voice Design, você descreve em texto a voz que deseja, incluindo detalhes como idade, gênero, sotaque, tom e ritmo, e o modelo de IA gera opções de voz que correspondem à sua descrição. Você pode ouvir as opções, escolher a que mais gostar e salvá-la na sua biblioteca de vozes.
O Voice Design é útil quando você precisa de uma voz para um personagem, uma marca ou um produto e não há uma pessoa real para clonar. Leia a documentação do Voice Design para aprender a escrever descrições de voz eficazes.
Como saber se uma voz foi gerada por IA
Não há um único sinal que comprove que uma voz foi gerada por IA. Combinar uma escuta atenta, ferramentas de detecção e uma verificação da origem do áudio funciona melhor do que depender de apenas um desses recursos.
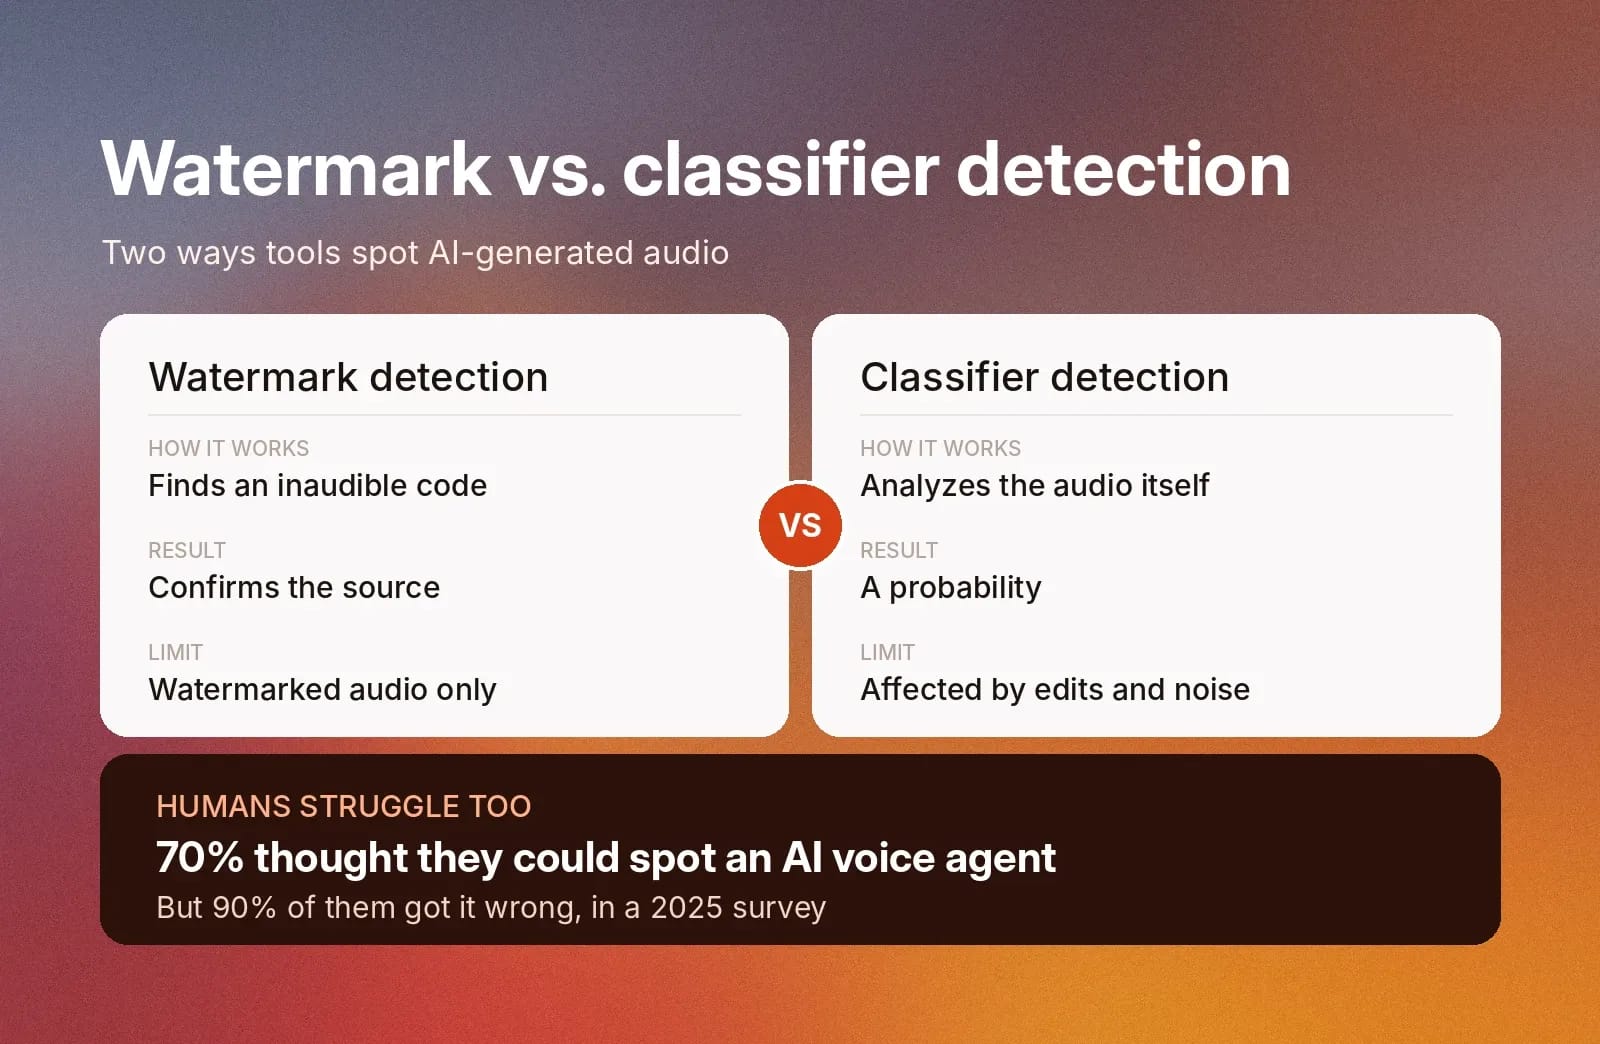
Muitas pessoas acham que conseguem distinguir uma voz real de uma gerada por IA, mas nem sempre acertam. Uma pesquisa de 2025 descobriu que 70% dos consumidores acreditavam conseguir identificar corretamente um agente de voz IA, mas 90% deles não conseguiram fazer isso corretamente.
Em vez de depender do ouvido humano, você pode usar uma ferramenta de detecção. As ferramentas de detecção funcionam de duas formas principais:
- Detecção de marca-d'água: alguns provedores de IA inserem uma marca-d'água, um código que humanos não conseguem ouvir, no áudio que geram. Um detector pode encontrar a marca-d'água e confirmar a origem do áudio. Isso só funciona em áudios que contêm uma marca-d'água.
- Detecção baseada em classificador: um classificador analisa o áudio e estima a probabilidade de ele ter sido gerado por IA. Ele pode sinalizar áudios sem marca-d'água, mas o resultado é uma probabilidade e pode ser afetado por compressão, ruído de fundo ou edição.
Nenhum dos métodos é perfeito. Trate o resultado de uma detecção como uma evidência e verifique-o com base no que você sabe sobre a origem. Escrevemos um guia sobre detecção de deepfakes de áudio, que aprofunda esse tema.
O ElevenLabs Speech Classifier é uma ferramenta que identifica a probabilidade de uma amostra de áudio ter sido gerada com modelos de voz IA da ElevenLabs. A ElevenLabs também firmou parceria com a Reality Defender em iniciativas de detecção de deepfakes para identificar e prevenir fraudes por voz.
O que ouvir
As ferramentas de detecção nem sempre estão disponíveis, por isso é útil conhecer os sinais mais comuns de uma voz sintética.
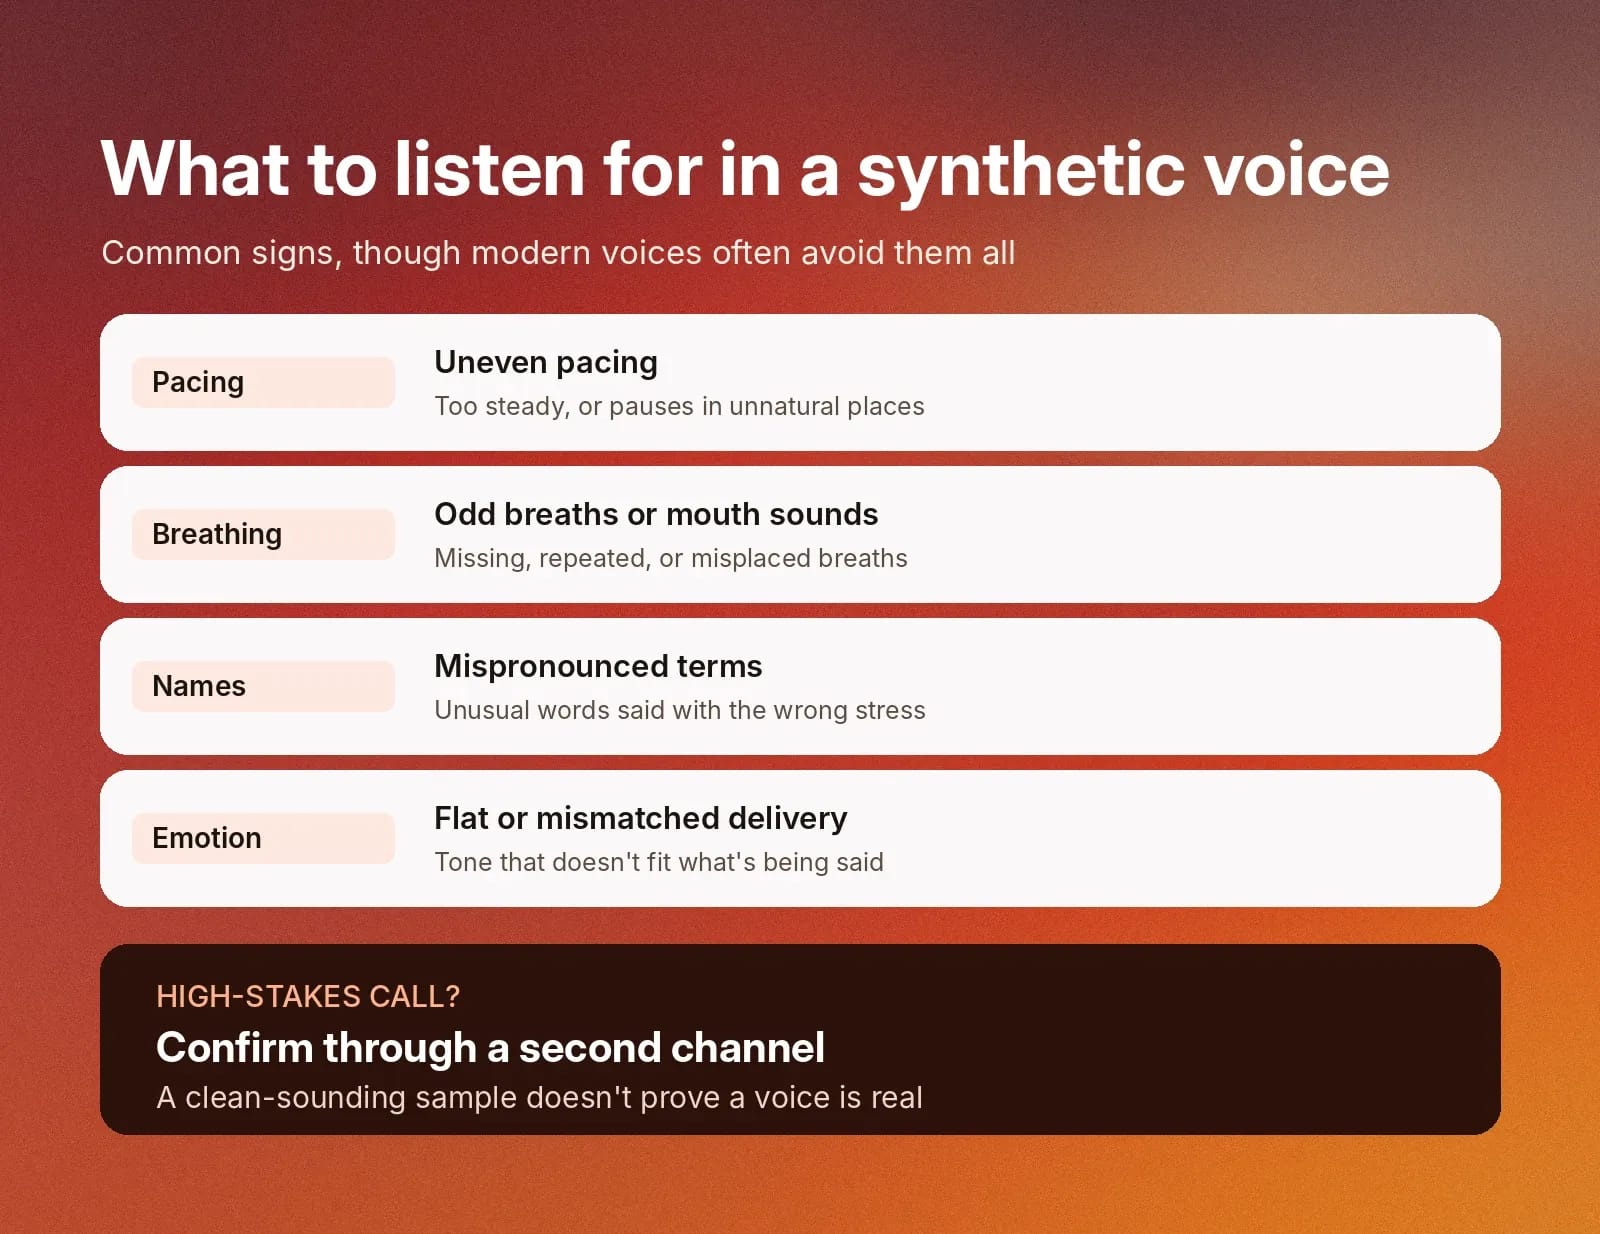
Preste atenção a:
- Ritmo irregular: fala excessivamente constante ou com pausas em lugares não naturais.
- Sons estranhos de respiração ou boca: respirações ausentes, repetidas ou fora de lugar. Isso pode indicar artefatos de áudio gerados involuntariamente por um modelo.
- Nomes ou termos pronunciados incorretamente: palavras incomuns ditas com a ênfase errada. Isso é ainda mais comum em idiomas que usam sinais diacríticos para enfatizar certas sílabas nas palavras, como o espanhol.
- Emoção monótona ou inadequada: uma entrega que não combina com o significado das palavras. Isso demonstra falta de compreensão do próprio texto, um problema comum em modelos de TTS legados.
As vozes sintéticas modernas muitas vezes evitam todos esses sinais. Uma amostra com som limpo não prova que uma voz é real. Para situações de alto risco, como uma ligação pedindo dinheiro, confirme por outro canal.
Crie experiências de voz personalizadas com o ElevenCreative
O ElevenCreative ajuda você a criar experiências de voz personalizadas para seus projetos criativos. Escolha em uma ampla biblioteca com mais de 20.000 vozes prontas ou crie a sua com clonagem de voz precisa e segura.
Use o ElevenCreative para reproduzir sua voz com a Clonagem de Voz Instantânea ou a Clonagem de Voz Profissional. A Clonagem de Voz Instantânea funciona em minutos e ajuda você a testar opções de voz ou lançar projetos pessoais rapidamente. A Clonagem de Voz Profissional usa amostras de áudio mais longas para criar vozes de alta qualidade, ideais para projetos extensos, como audiolivros, jogos eletrônicos ou podcasts. Independentemente da opção escolhida, o áudio é vinculado à sua conta por segurança.
A ElevenCreative oferece uma Voice Library personalizável e ferramentas de clonagem de voz para ajudar você a dar vida aos seus projetos criativos. Cadastre-se no ElevenCreative para explorar vozes icônicas ou criar a sua.
Perguntas frequentes

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.