Apresentamos o Eleven v4, nosso modelo mais expressivo
- Publicado
- Última atualização
OuvirOuça este artigo
Uma linha de texto pode mudar muito dependendo de como é dita. “Preciso que você mantenha a calma” deve soar diferente dependendo de quem a diz: um médico falando suavemente com um paciente assustado ou um personagem de jogo gritando para seu esquadrão antes de entrar em combate.
Hoje, estamos lançando o Eleven v4, nosso modelo de Text to Speech mais expressivo até hoje, e sua variante de baixa latência, o Eleven v4 Turbo.
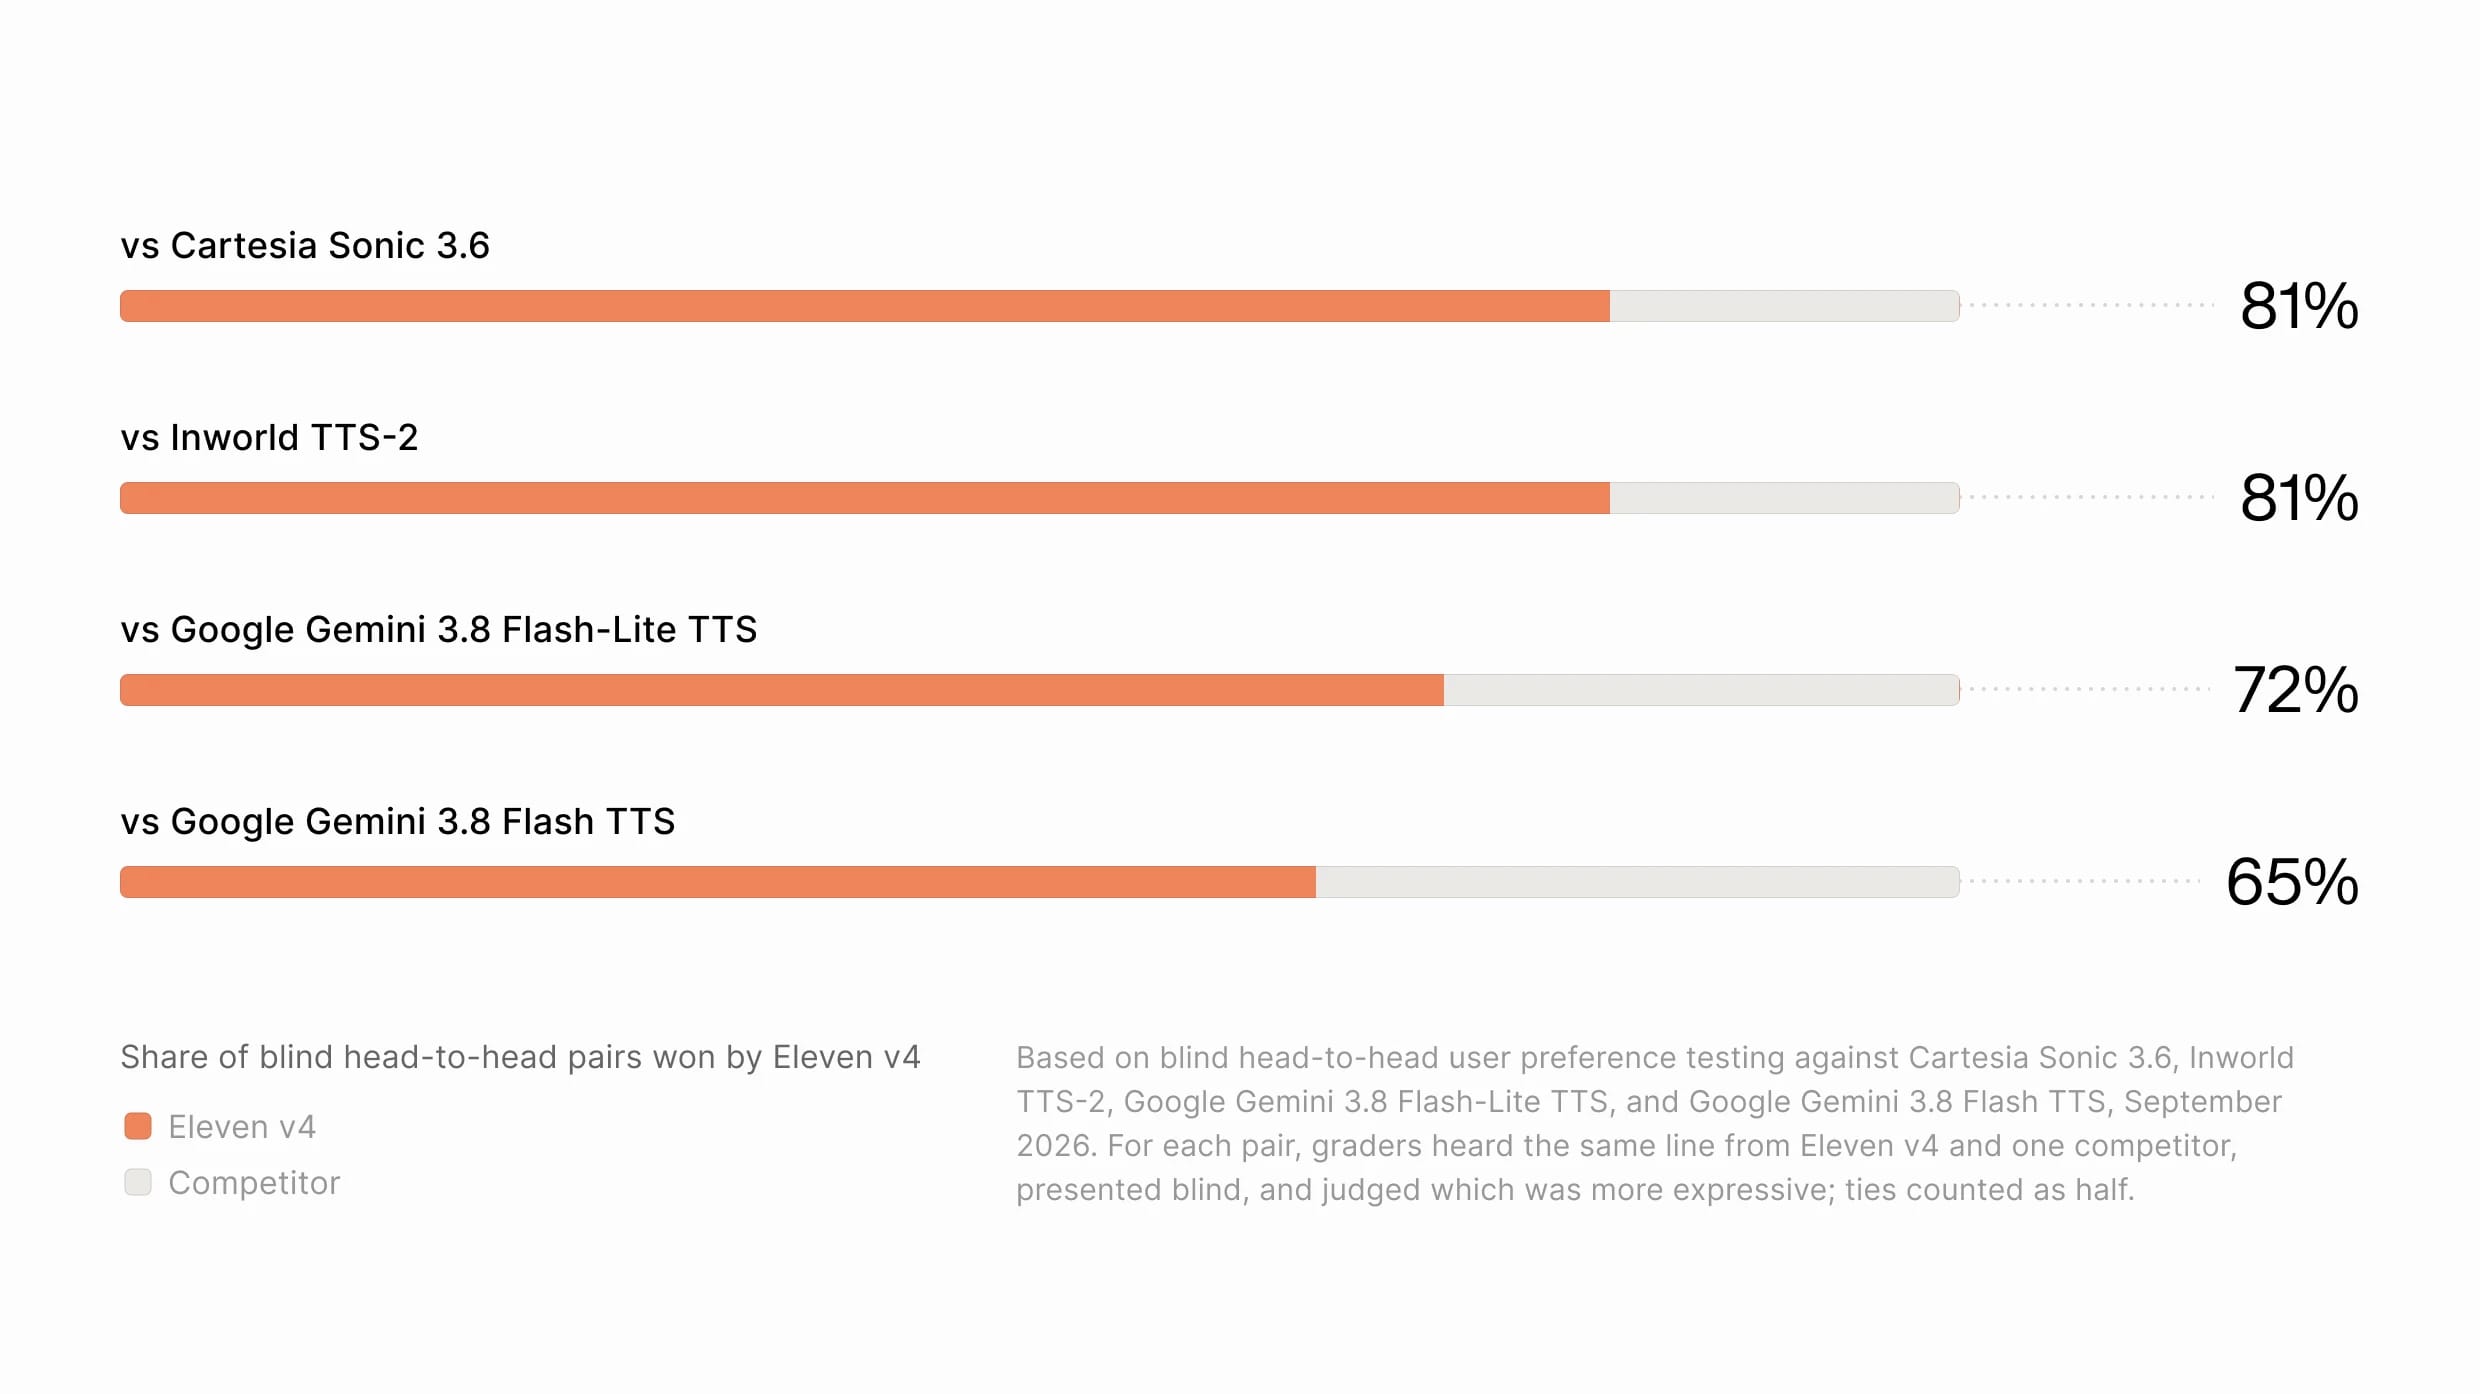
Classificado em 1º lugar pela Artificial Analysis1 e preferido por cerca de 75% dos ouvintes em testes comparativos às cegas em relação a modelos concorrentes2, o Eleven v4 foi projetado para interpretar tom, ritmo, emoção, personagem e contexto. Ele gera fala que pode soar dramática, delicada, urgente, cômica ou conversacional, mantendo a identidade de quem fala. Dinâmicas mais naturais entre vários interlocutores fazem as conversas parecerem responsivas, em vez de linhas separadas montadas umas às outras. Os interlocutores respondem ao contexto da conversa, gerando diálogos e interações entre personagens mais naturais.
Uma nova arquitetura desenvolvida para desempenho
Criado com uma arquitetura totalmente nova, o Eleven v4 é nosso modelo de Text to Speech mais expressivo, classificado em 1º lugar pela Artificial Analysis1. O Eleven v4 Turbo leva essa mesma tecnologia a casos de uso de baixa latência, como agentes. Com uma latência mediana de inferência de cerca de 100 ms, ele pode responder mais rápido do que a pausa média entre duas pessoas conversando.
Os dois modelos podem gerar fala que transmite emoção, em vez de soar mecânica. A fidelidade de áudio subjacente também é maior em todos os aspectos, com resultados mais limpos e naturais.
As gerações anteriores de modelos de conversão de texto em voz conseguem ler textos em voz alta, mas o Eleven v4 dá à fala uma profundidade emocional muito mais natural. O modelo consegue interpretar o tom pretendido, o ritmo da fala, o estilo do texto e seu contexto para gerar uma fala emocionalmente envolvente.
Os usuários também têm controle detalhado sobre os resultados e podem descrever, em linguagem natural, como uma linha deve ser apresentada. Eles também podem adicionar instruções específicas sobre como dizer determinadas frases, qual emoção devem transmitir e até mesmo efeitos sonoros, usando tags inline como [laughs], [said angrily in French accent], [light rain] ou [phone buzzing]. O Eleven v4 segue essas tags de áudio e instruções de direção com mais precisão do que os modelos anteriores, para que a apresentação que você descreve seja a que você recebe. Isso facilita dirigir narrações, desenvolver personagens e seus diálogos, além de outros contextos em que a forma de falar importa.
A documentação para desenvolvedores da ElevenLabs aborda toda a sintaxe das tags e como aplicá-las pela API. O suporte aos fonemas do Alfabeto Fonético Internacional (IPA) também melhorou significativamente, para que pronúncias personalizadas funcionem de forma mais confiável.
O Eleven v4 também traz melhorias na consistência e em conversas dinâmicas entre vários interlocutores. Usando um novo método para capturar as identidades dos interlocutores, o Eleven v4 preserva as características únicas de cada voz. Ele consegue manter a fala consistente em conversas de agentes, audiolivros ou anúncios. Como o modelo entende o contexto de uma cena inteira, ele gera diálogos naturais em que os interlocutores respondem ao que acabou de ser dito, em vez de unir linhas isoladas.
Um modelo Turbo para casos de uso de baixa latência
Modelos de voz de alta qualidade costumam ser mais lentos para gerar fala, o que obriga os usuários a escolher entre agentes de voz rápidos ou expressivos. Muitos optaram por agentes competentes, mas monótonos, que podem parecer robóticos para um cliente aflito que só quer resolver seu problema.
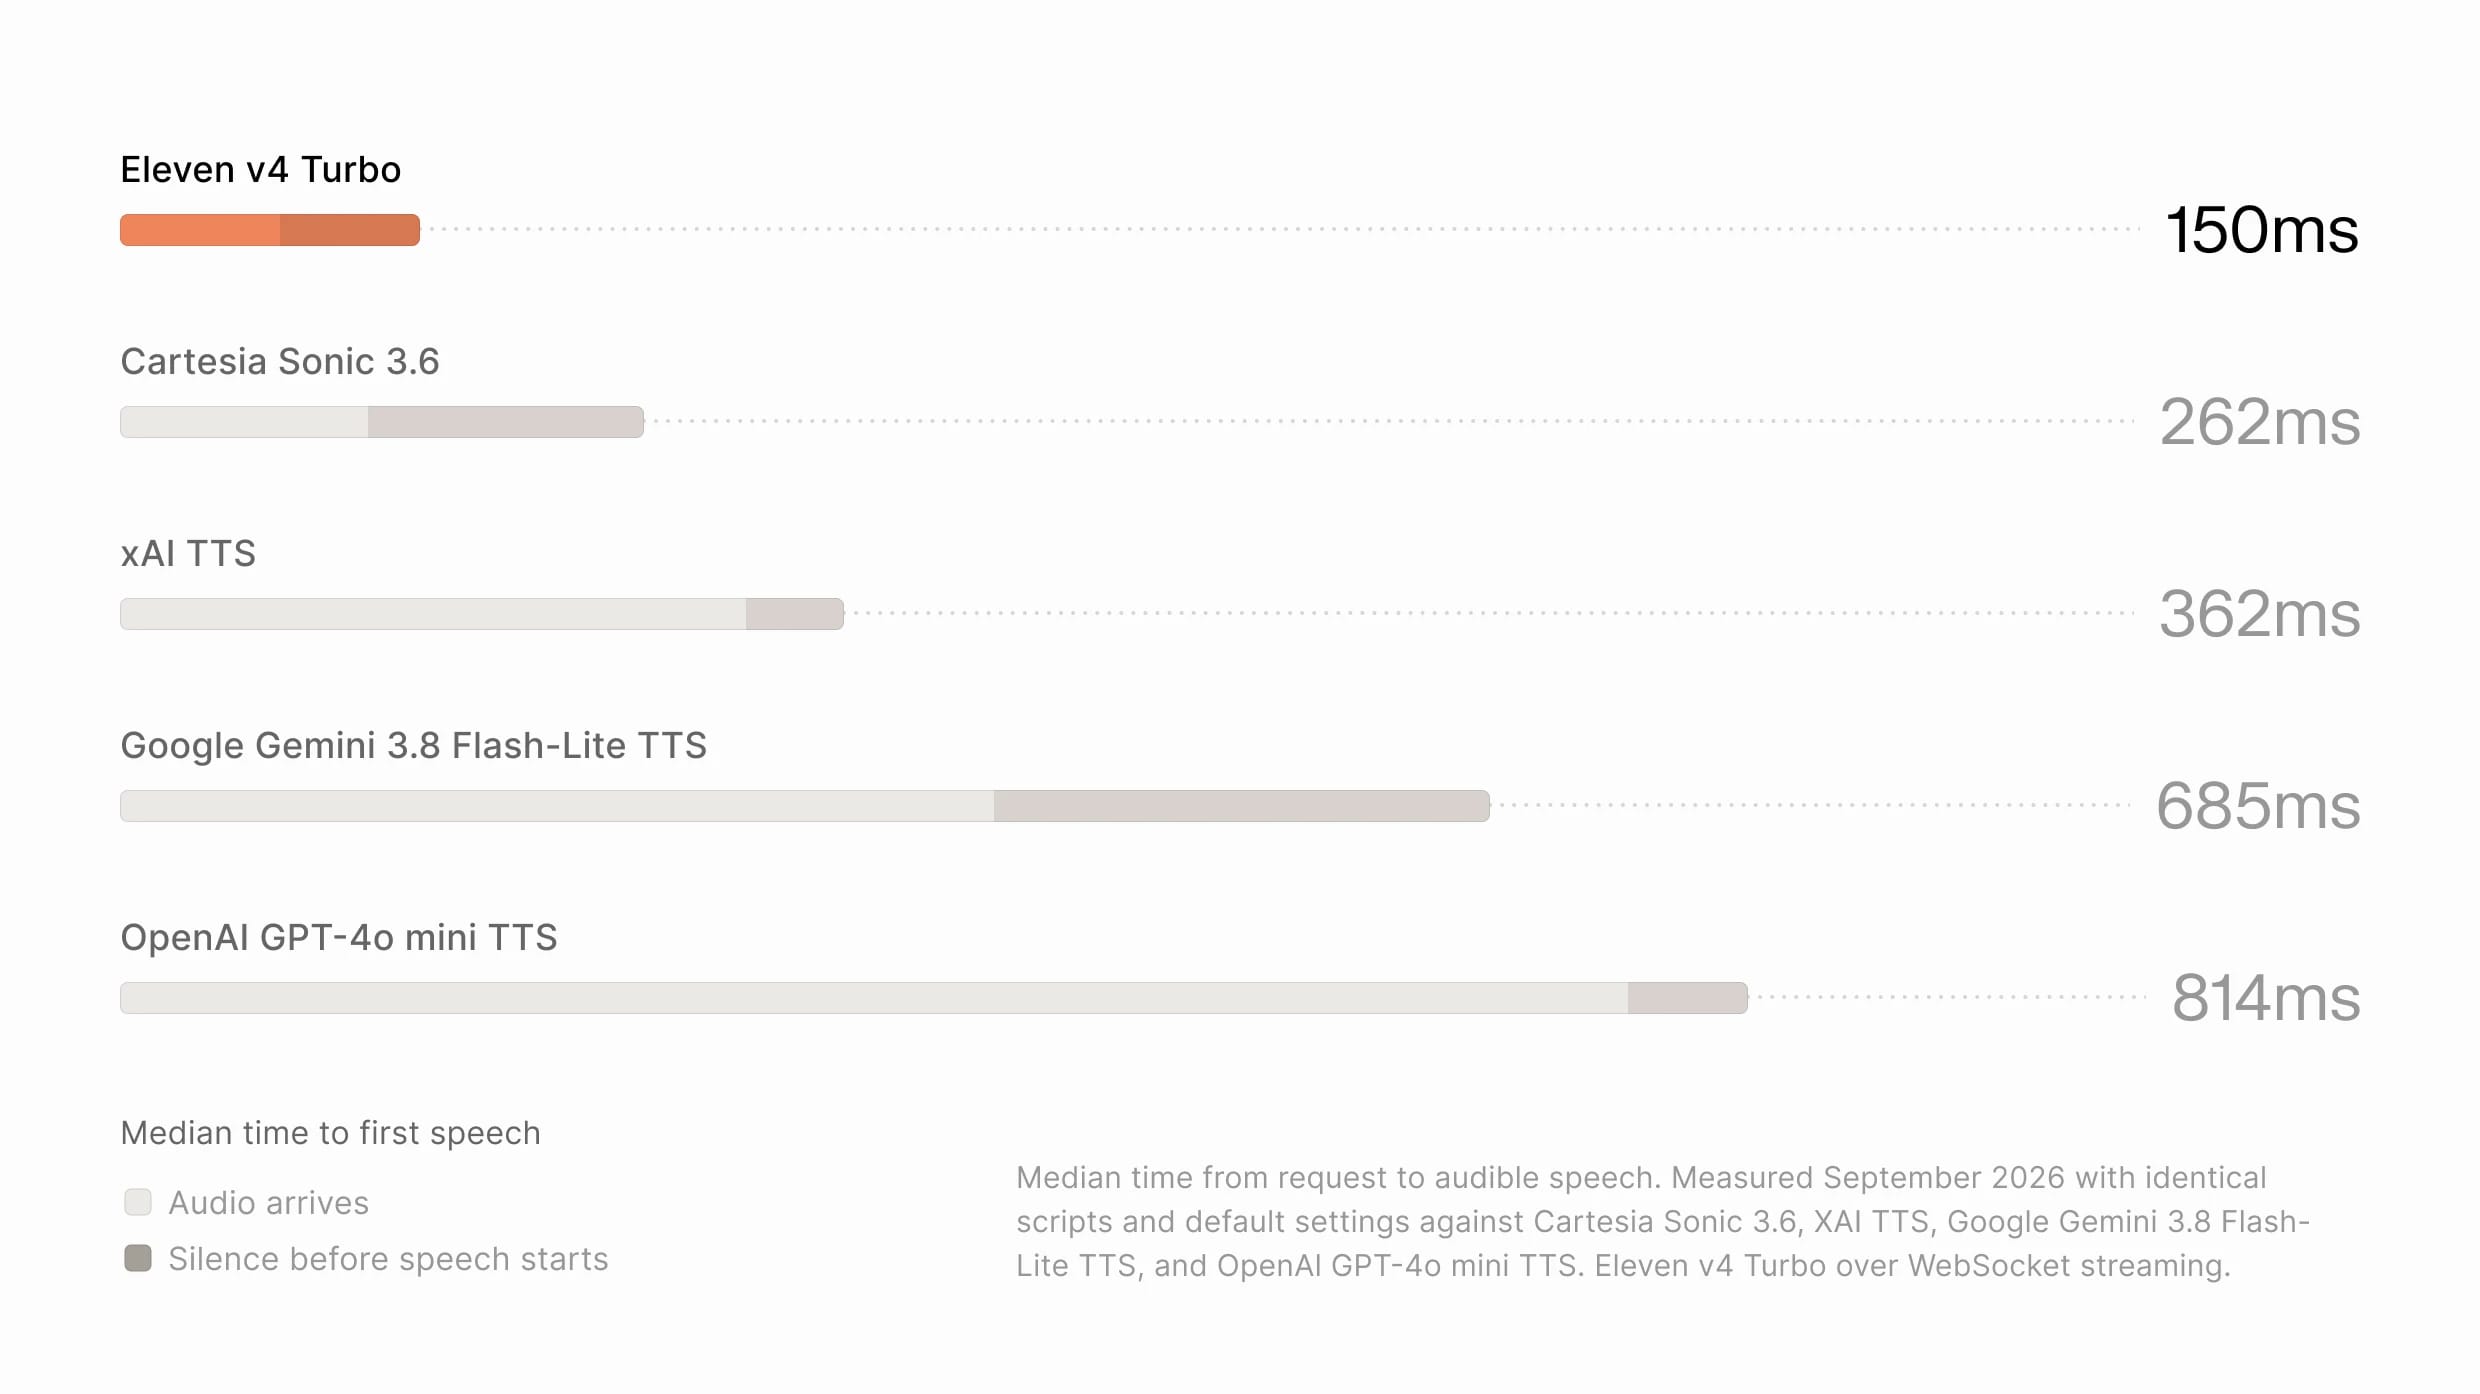
O Eleven v4 Turbo combina velocidade e emoção, com um tempo mediano até a primeira fala de cerca de 150 ms3, possibilitando implementar agentes poderosos em inúmeros setores: desde agentes acolhedores e tranquilizadores que pronunciam termos médicos corretamente na área da saúde até agentes que falam rápido e usam gírias para entreter jogadores em games.
O modelo Eleven v4 Turbo foi desenvolvido para funcionar com a plataforma de agentes conversacionais da ElevenLabs, o ElevenAgents. Outros criadores de agentes combinam modelos e softwares de diferentes fornecedores, deixando os usuários sem uma maneira de refinar ou melhorar os resultados dos modelos para seus casos de uso específicos. As equipes de pesquisa e engenharia da ElevenLabs otimizaram o Eleven v4 Turbo e o ElevenAgents juntos como um único sistema, oferecendo agentes mais expressivos, confiáveis e de baixa latência.
Uma voz, muitos idiomas
A forma como nos comunicamos varia conforme o contexto, o lugar e até a hora do dia. Criar fala expressiva que reflita isso em diferentes idiomas continua sendo um dos maiores desafios da IA de áudio.
O Eleven v4 representa um avanço em todas essas áreas, e as melhorias vão além da forma como o modelo pronuncia frases. O Eleven v4 capta melhor o ritmo, a emoção e a forma de falar em diferentes idiomas, ajudando criadores a produzir fala que soe natural para o idioma e o contexto. Por exemplo, a forma como você falaria com um idoso desconhecido no Japão é bem diferente de como falaria com ele na Itália.
Tanto o Eleven v4 quanto o Eleven v4 Turbo oferecem suporte a mais de 90 idiomas. Agora, uma voz gravada em um idioma também fala qualquer outro com fluência, adotando o sotaque de um falante nativo e mantendo a identidade da voz original. Essa fidelidade ao sotaque está visivelmente maior do que antes, para que a voz não volte gradualmente ao sotaque de origem ao longo de uma geração.
Catalão
Espanhol
Para dublagem e localização, isso significa que a voz da marca que você escolheu — seja a de um ator famoso com quem você trabalha ou um tom que melhor combine com o estilo da sua empresa — soará muito bem em qualquer idioma compatível com o Eleven v4.
Clonagem de voz mais autêntica e consistente
A clonagem de voz é mais autêntica, avançada e consistente no Eleven v4 e no Eleven v4 Turbo, com similaridade significativamente maior entre o interlocutor e a voz original. Agora, as Clonagens Instantâneas de Voz podem capturar vozes em alta fidelidade usando apenas 10 segundos de áudio.
Voz real
Eleven v4
O Eleven v4 também preserva a identidade de quem fala com mais confiabilidade entre gerações, diálogos, narrações e linhas regeneradas. Isso significa que, em projetos longos, os personagens, narradores e vozes clonadas permanecem consistentes durante toda a produção. O Eleven v4 também adiciona suporte para Clonagens Profissionais de Voz (PVC), para casos de uso de clonagem que exigem a mais alta fidelidade.
O encadeamento de solicitações — que conecta gerações para conteúdos mais longos — também é significativamente mais confiável no Eleven v4, melhorando a experiência de trabalhar no Estúdio ElevenLabs e no app ElevenLabs Reader.
Ouça a diferença você mesmo
O Eleven v4 e o Eleven v4 Turbo são o resultado de nossas pesquisas mais recentes em geração de fala expressiva. Eles foram criados para conteúdos em que a forma de falar importa tanto quanto as próprias palavras, sejam audiolivros, atuações de personagens, locuções, dublagem ou localização de agentes conversacionais.
Os dois modelos já estão disponíveis no ElevenAgents, ElevenCreative e pela ElevenAPI. Crie uma conta grátis para começar a gerar conteúdo com o Eleven v4 ou o Eleven v4 Turbo hoje.
- Artificial Analysis, ranking Provider Voice Arena, set. de 2026
- Com base em testes comparativos às cegas de preferência dos usuários contra Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS e Google Gemini 3.8 Flash TTS, em setembro de 2026. Em cada par, os avaliadores ouviram a mesma linha do Eleven v4 e de um concorrente, apresentadas às cegas, e julgaram qual era mais expressiva e qual soava mais natural; os empates contaram como metade.
- Tempo mediano entre a solicitação e a fala audível. Medido em setembro de 2026 com roteiros idênticos e configurações padrão contra Cartesia Sonic 3.6, xAI TTS, Google Gemini 3.8 Flash-Lite TTS e OpenAI GPT-4o mini TTS; a latência de rede foi medida e removida em todos os sistemas. Eleven v4 Turbo via streaming por WebSocket.