Como sua transcrição sabe onde cada palavra é falada
- Escrito por
- Mike Murphy
- Publicado
OuvirOuça este artigo
Se você já assistiu a um filme na TV em que houve algum problema na transmissão e as falas dos atores estavam completamente fora de sincronia com as legendas, sabe o quanto isso pode distrair e tirar você da história. Vídeos e softwares que usam modelos de voz têm o mesmo problema: uma legenda que aparece um segundo atrasada ou uma transcrição que destaca a palavra errada pode parecer igualmente falha.
“Os humanos são muito bons em sincronizar mídias, pelo menos no nível das palavras”, disse Danila Kozlov, pesquisador da ElevenLabs que trabalha com alinhamento. “Muitas vezes, temos uma noção intuitiva de onde uma palavra começa, mas, no nível dos caracteres e com precisão de menos de um milissegundo, é muito mais difícil.”
Hoje, a ElevenLabs compartilha mais detalhes sobre o Cue, um modelo de alinhamento forçado que posiciona cada caractere de um arquivo de áudio em uma linha do tempo precisa. O Cue é usado pela família de modelos Scribe da ElevenLabs e, em gravações do mundo real, é mais preciso do que todos os alinhadores testados pela ElevenLabs nos 29 idiomas do benchmark. Ele também processa gravações de qualquer duração em uma única passagem e alinha uma hora de áudio em menos de um segundo.
O que é alinhamento forçado?
Imagine que alguém entrega a você um vídeo e uma transcrição e pede que associe cada palavra ao momento em que ela é falada. Isso é alinhamento forçado. Quando você clica em uma palavra em uma transcrição da ElevenLabs e o player vai para aquele ponto exato, um alinhador está fazendo esse trabalho.
O alinhamento forçado, porém, é diferente do conceito mais amplo de alinhamento de IA. Esse conceito trata de criar sistemas de IA cujo comportamento corresponda aos sistemas de valores e às preferências de negócios das pessoas. No alinhamento forçado, estamos falando apenas de sincronizar texto e som.
O Cue é a última etapa do pipeline de Speech to Text. O Scribe, o modelo de Speech to Text da ElevenLabs, transcreve o áudio, e o alinhador define a temporização. Todas as solicitações ao Scribe passam por ele. O mesmo modelo também é usado em legendas, dublagem e sincronização de letras de músicas, além de estar disponível separadamente pela API de alinhamento forçado.
Como muitos produtos dependem dele, um alinhador precisa ser preciso em todos os idiomas compatíveis, extremamente rápido e capaz de processar muitas solicitações ao mesmo tempo.
Onde os alinhadores tradicionais ficam aquém
Antes do novo modelo, a equipe criou o modelo de alinhamento que havia sido usado em todos os produtos da ElevenLabs até então. Embora fosse poderoso, eles sabiam que poderiam tornar uma nova versão ainda melhor. Quando Kozlov entrou para a equipe, ele e o time começaram entrevistando clientes e usuários internos da ElevenLabs sobre o que os frustrava ao trabalhar com o alinhador anterior. As reclamações correspondiam às limitações das ferramentas open source testadas pela equipe.
A duração é o primeiro grande problema. Muitos alinhadores atuais funcionam bem com clipes de cerca de 30 segundos, mas arquivos mais longos precisam ser divididos em partes. Cada nova parte pode adicionar um pequeno erro de temporização, e unir essas partes pode acrescentar ainda mais erros. Em gravações completas, o erro médio de temporização do Cue é de apenas 179 milissegundos, enquanto o das ferramentas open source variou de 283 ms a mais de 6.000 ms.
Áudios gravados no mundo real são um desafio ainda maior. Ruídos de fundo, falas sobrepostas e música ambiente fazem muitas ferramentas perderem o ponto ao associar o texto ao áudio. Mas esses são os tipos de arquivos que muitas pessoas realmente querem transcrever, já que todos tendemos a viver em lugares que não são perfeitamente silenciosos. Em gravações em inglês com problemas de fundo, o erro médio do Cue é de 57 ms, em comparação com 65 ms a 920 ms das outras ferramentas.
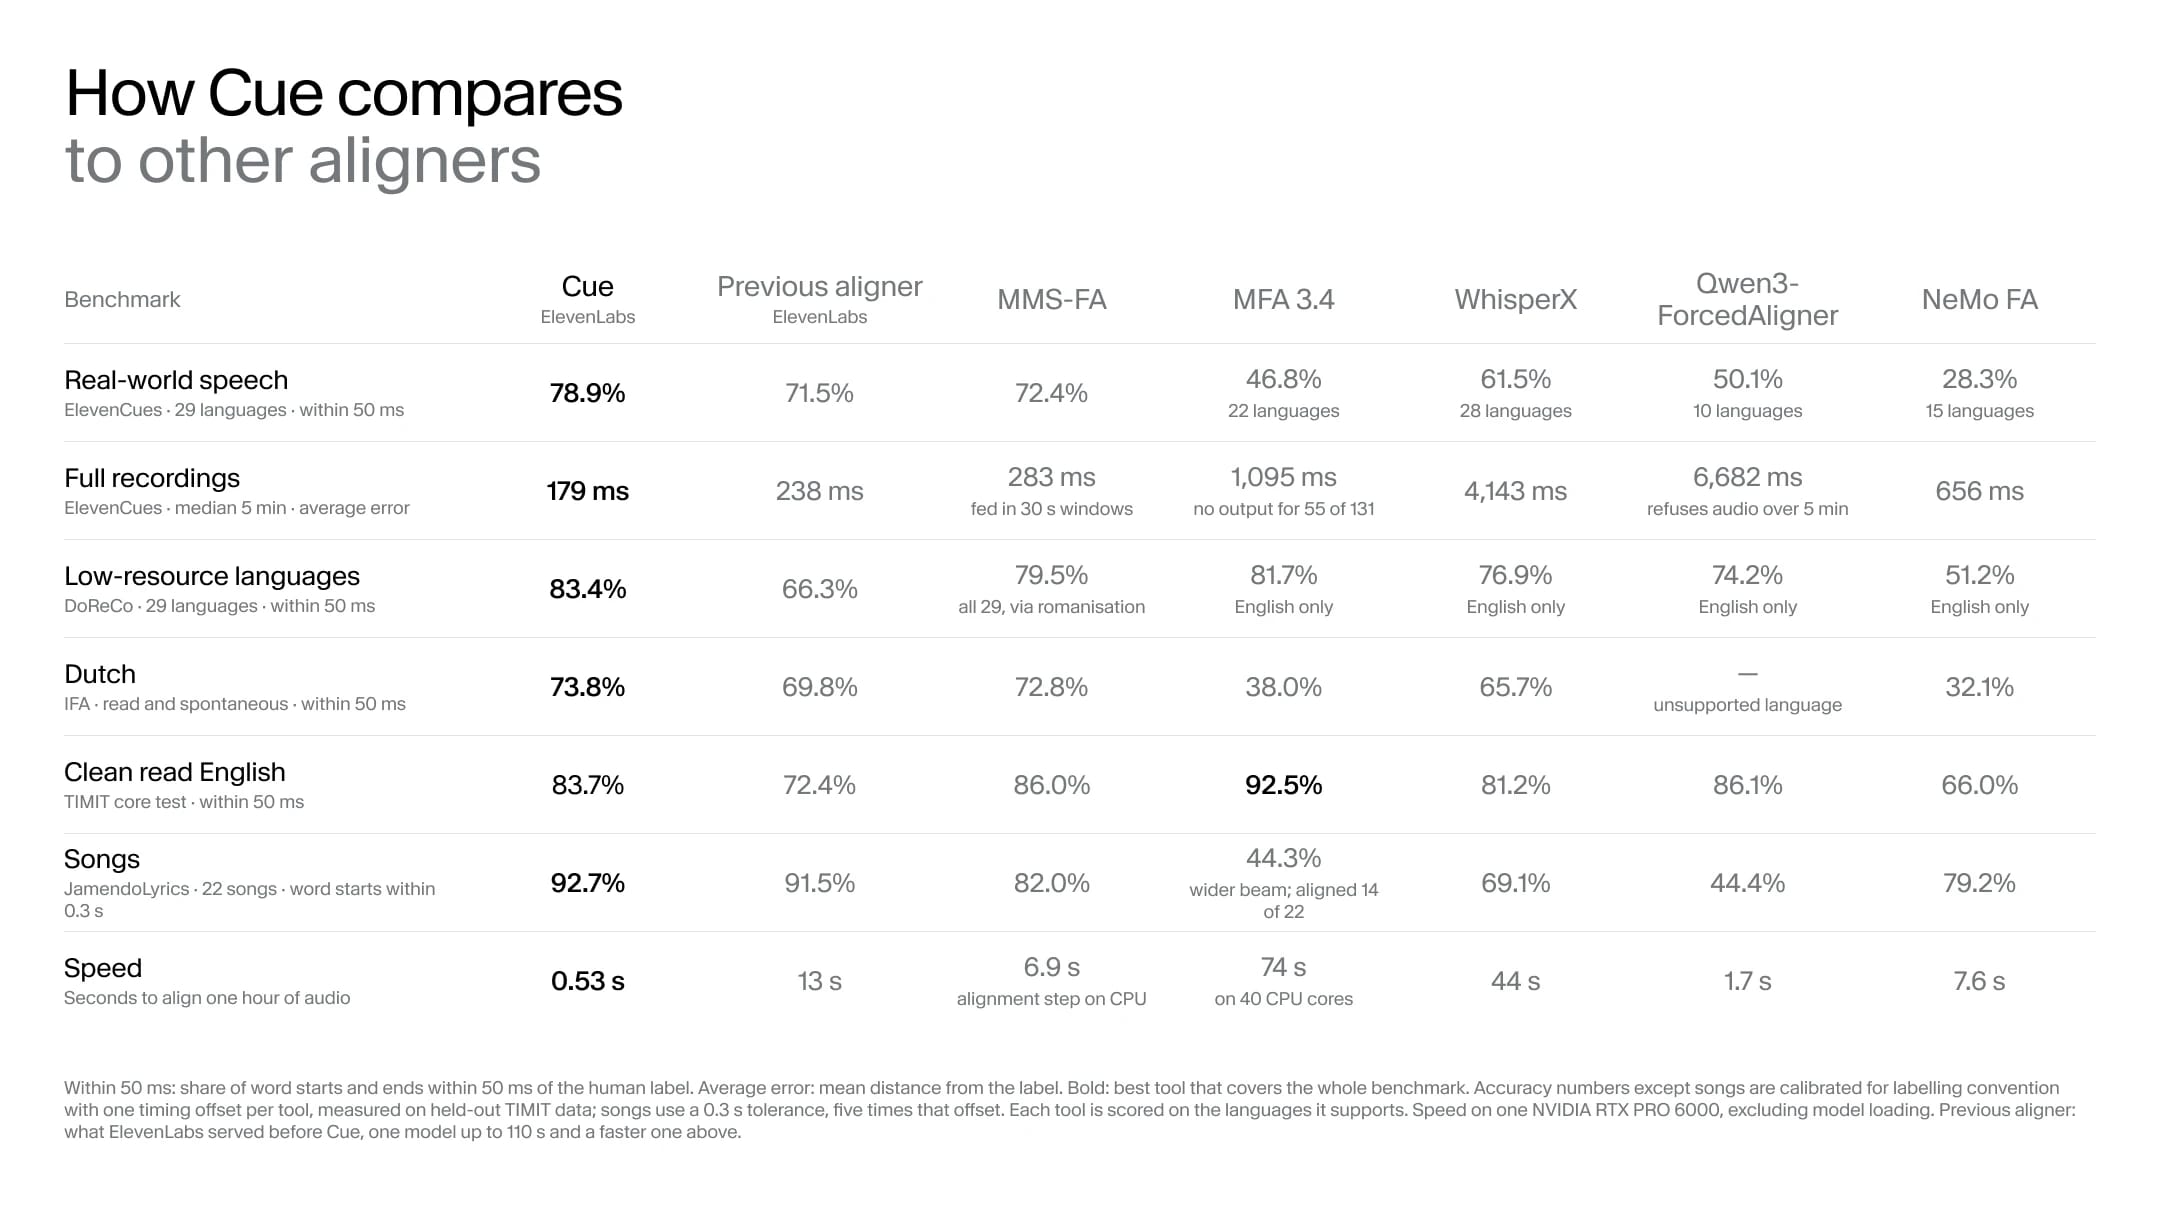
O suporte a idiomas é outra limitação. A maioria dos alinhadores open source precisa de um modelo separado para cada idioma compatível, então idiomas com menos dados de treinamento muitas vezes não têm o mesmo desempenho ou simplesmente não são compatíveis. MMS-FA é a única outra ferramenta que processa todos os 29 idiomas do benchmark e, em comparação, o Cue geralmente foi mais rápido para identificar os limites entre palavras.
A velocidade também é um problema para esses modelos, já que alinhar grandes volumes de áudio pode ficar caro rapidamente. O Cue consegue alinhar uma hora de áudio em cerca de meio segundo na nossa GPU de produção. A segunda ferramenta mais rápida, Qwen3-ForcedAligner, leva quase 2 segundos, enquanto a mais lenta testada levou bem mais de um minuto.
Como o Cue é diferente
O Cue é um único modelo que abrange mais de 90 idiomas do benchmark, ao contrário da maioria de seus concorrentes. Ele também pode processar gravações de qualquer duração em uma única passagem, evitando a divisão em partes que faz os erros de temporização se acumularem em arquivos longos.
Use o gesto de pinça ou Control + rolagem para ampliar. Deslize horizontalmente ou use Shift + rolagem para mover. Com uma palavra em foco, use mais e menos para ampliar ou Shift + seta para a esquerda ou direita para mover.
Selecione uma palavra para ver seus caracteres
Enquanto a maioria dos modelos ficou maior à medida que ganhou desempenho, o Cue é menor do que o alinhador anterior da ElevenLabs, disse Kozlov. Ele ainda é executado em uma GPU, mas alinha uma hora de áudio em cerca de meio segundo.
A equipe desenvolveu o Cue com base nos tipos de áudio que as pessoas realmente enviam. Usando o alinhador anterior como referência, criou um benchmark a partir de solicitações reais e avaliou todas as ferramentas da mesma forma, contando como erro cada palavra que uma ferramenta não conseguiu posicionar. O Cue funciona no nível dos caracteres, mais detalhado do que os rótulos no nível das palavras usados pela maioria dos benchmarks, por isso essas pontuações provavelmente subestimam sua precisão.
“Em algum momento, você alcança o nível das habilidades humanas”, disse Kozlov sobre os modelos de alinhamento. “Nosso alinhador atual vai além desse nível, então fica muito mais difícil verificar se ele está totalmente correto ou quão preciso ele é, porque não existe um benchmark ideal para isso. Tivemos de usar benchmarks no nível das palavras para avaliar um sistema no nível dos caracteres, o que não necessariamente demonstra todo o potencial do Cue.”
A qualidade do Cue também reflete a rapidez com que a ElevenLabs consegue agir com base no feedback dos usuários. Pouco depois do lançamento do Cue, um cliente avisou a equipe que o georgiano e alguns outros idiomas com menos recursos tinham desempenho abaixo do esperado. A ElevenLabs mantém a pesquisa próxima das equipes e dos clientes que usam seus produtos, o que permitiu identificar o problema rapidamente, pesquisar possíveis melhorias no modelo, treinar uma nova versão e lançá-la — tudo em menos de 24 horas desde que o cliente relatou o problema pela primeira vez.
Alinhando músicas
A música é difícil porque o canto alonga e torna as palavras menos nítidas, e poucos modelos conseguem lidar bem com isso. A equipe não esperava que o Cue fosse lidar tão bem com isso. O Cue conseguiu alinhar um subconjunto de músicas do conjunto de dados JamendoLyrics MultiLang licenciado sob Creative Commons. Ele conseguiu fazer isso em inglês, francês, espanhol e alemão — em uma única passagem — com uma precisão surpreendente. Posicionou 92,7% das palavras a até 0,3 segundo do rótulo, em comparação com 82,0% da segunda melhor ferramenta.
O erro médio de início do Cue foi de 0,82 segundo, cerca de metade do erro do concorrente mais próximo. Ele foi mais preciso do que todas as outras ferramentas em pelo menos 19 das 22 músicas. O potencial de cantar suas novas músicas favoritas no karaokê no dia em que forem lançadas é enorme.
Experimente o Cue hoje
O Cue já está por trás de todas as transcrições de Speech to Text da ElevenLabs. Para usá-lo diretamente, experimente a API de alinhamento forçado.
Agradecimentos
O trabalho nos modelos de alinhamento da ElevenLabs não teria sido possível sem muitas pessoas de toda a empresa. A equipe gostaria de agradecer a todos que trabalharam na versão anterior e na nova versão do modelo, incluindo o cofundador e CTO Piotr Dąbkowski; os pesquisadores Danila Kozlov, Luca Lanzendörfer, Flavio Schneider, Max Levi, Tim von Känel e Angelos Perivolaropoulos; Ani Janelidze, da equipe de Operações de Dados; nossas equipes de Forward Deployed Engineer e Suporte; e Lorenzo Dossi, por seu trabalho na visualização deste blog.
Mike Murphy é editor-chefe e redator do blog da ElevenLabs, onde transforma pesquisas e tecnologias complexas em histórias claras e envolventes. Antes de entrar para a ElevenLabs, trabalhou por anos como repórter de tecnologia, inclusive na Quartz, e liderou o conteúdo do IBM Research. Ele tem mestrado em jornalismo pela Northwestern.