Detecção de deepfakes de áudio: como funciona e como verificar áudios da ElevenLabs
- Escrito por
- Jack Limebear
- Publicado
OuvirOuça este artigo
A detecção de deepfakes de áudio é o processo de analisar áudios de voz para determinar se a fala é autêntica. Sintetizadores de voz com IA que geram deepfakes estão cada vez mais acessíveis. Tornou-se importante, tanto na vida pública quanto nos negócios, identificar rapidamente se a fala que você está ouvindo é genuína ou foi manipulada por alguém mal-intencionado.
Neste artigo, vamos explorar como funciona a detecção de deepfakes de áudio, os diferentes tipos de detecção, seus pontos fortes e limitações e como integrar a detecção de deepfakes a estruturas de detecção de fraude em larga escala.
Resumo
- A fala sintetizada por deepfake está cada vez mais difícil de detectar apenas ouvindo. Ela representa um risco significativo tanto na vida pública quanto nos negócios.
- Existem vários tipos de software de detecção de deepfakes. Ferramentas convencionais usam análise estatística para avaliar a probabilidade de uma amostra de áudio ter sido gerada por IA.
- Uma nova tecnologia de marca d'água permite obter uma resposta definitiva de sim ou não sobre se uma amostra de voz foi sintetizada.
- A marca d'água é altamente precisa, mas os detectores funcionam apenas com os áudios do próprio provedor. Por exemplo, o Audio Detector da ElevenLabs consegue identificar com alta precisão marcas d'água geradas por seus próprios produtos, mas não as de outras empresas.
- A marca d'água é um recurso importante para organizações que precisam detectar deepfakes em larga escala, mas deve ser apenas uma entre várias ferramentas em sua estrutura de detecção de deepfakes.
O que é detecção de deepfakes de áudio?
A detecção de deepfakes de áudio é o processo de determinar se um áudio de voz foi gerado ou manipulado por inteligência artificial.
Um deepfake é qualquer tipo de mídia — mais frequentemente imagem, vídeo ou áudio — criada por um aplicativo de IA generativa com o objetivo de falsear o que alguém diz ou faz. Deepfakes de áudio têm muitos usos mal-intencionados. Podem ser usados para fraude, para tentar acessar contas pessoais, como propaganda política ou para se passar secretamente por um cônjuge ou familiar em disputas domésticas.
Com base nas tendências atuais, as vítimas de golpes com deepfakes de áudio provavelmente serão:
- Políticos e outras figuras públicas: Pessoas com muitas amostras de voz disponíveis online para treinamento podem ter sua voz replicada por deepfake por adversários ou terceiros para enganar o público.
- Familiares: Alguém mal-intencionado pode tentar usar gravações de voz encontradas para enganar familiares idosos com pedidos de dinheiro feitos por deepfake.
- Executivos corporativos: Entrevistas, apresentações e teleconferências de resultados falsificadas podem ser usadas para prejudicar a marca de uma empresa.
- Equipes de atendimento ao cliente: Golpistas podem usar amostras de voz coletadas para enganar equipes de atendimento ao cliente e conseguir acesso a contas privadas.
Infelizmente, humanos não são detectores confiáveis de deepfakes. Em contextos de pesquisa controlada, a capacidade das pessoas de identificá-los não é melhor do que o acaso, e essa pesquisa é de 2024. Desde então, a mídia generativa se tornou significativamente mais sofisticada.
Educação e legislação ajudarão muito a proteger a sociedade contra a influência dos deepfakes, mas métodos confiáveis de detecção ainda são necessários.
Como funciona a detecção de deepfakes de áudio?
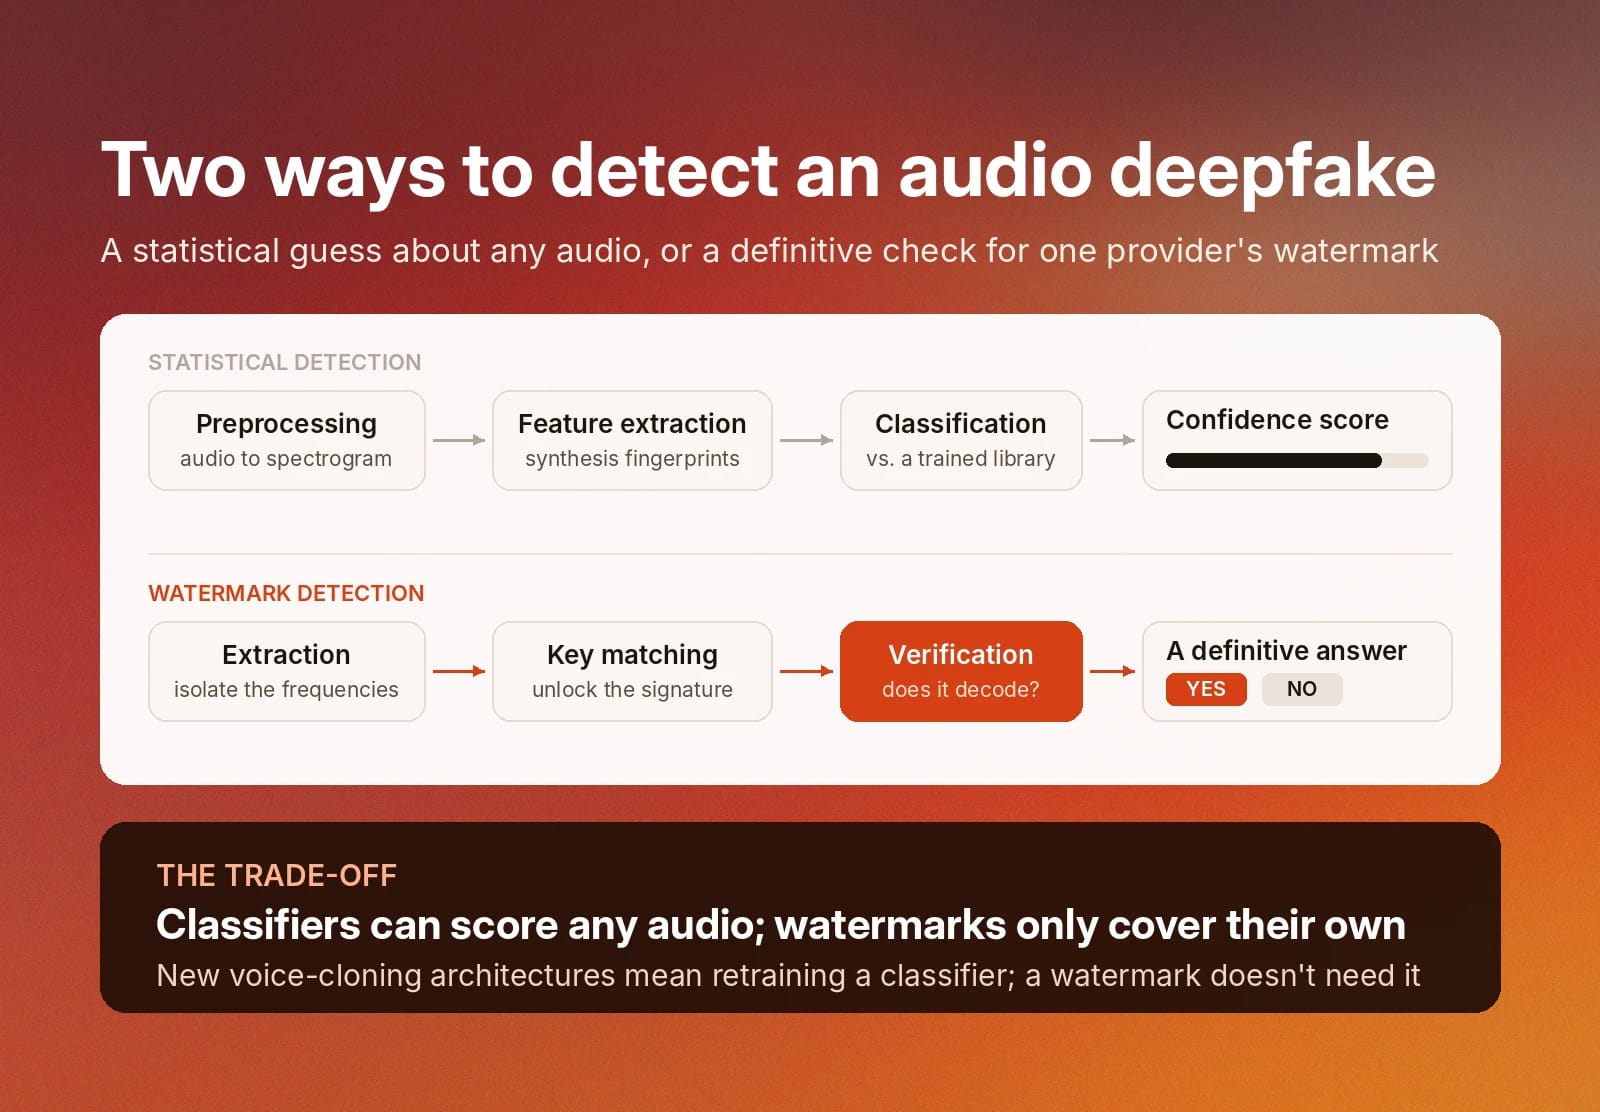
A detecção convencional de deepfakes usa análise estatística para medir a probabilidade de uma mídia ter sido gerada por IA. Uma ferramenta de detecção usa técnicas de aprendizado de máquina para reconhecer os padrões subjacentes em diferentes tipos de fala sintetizada.
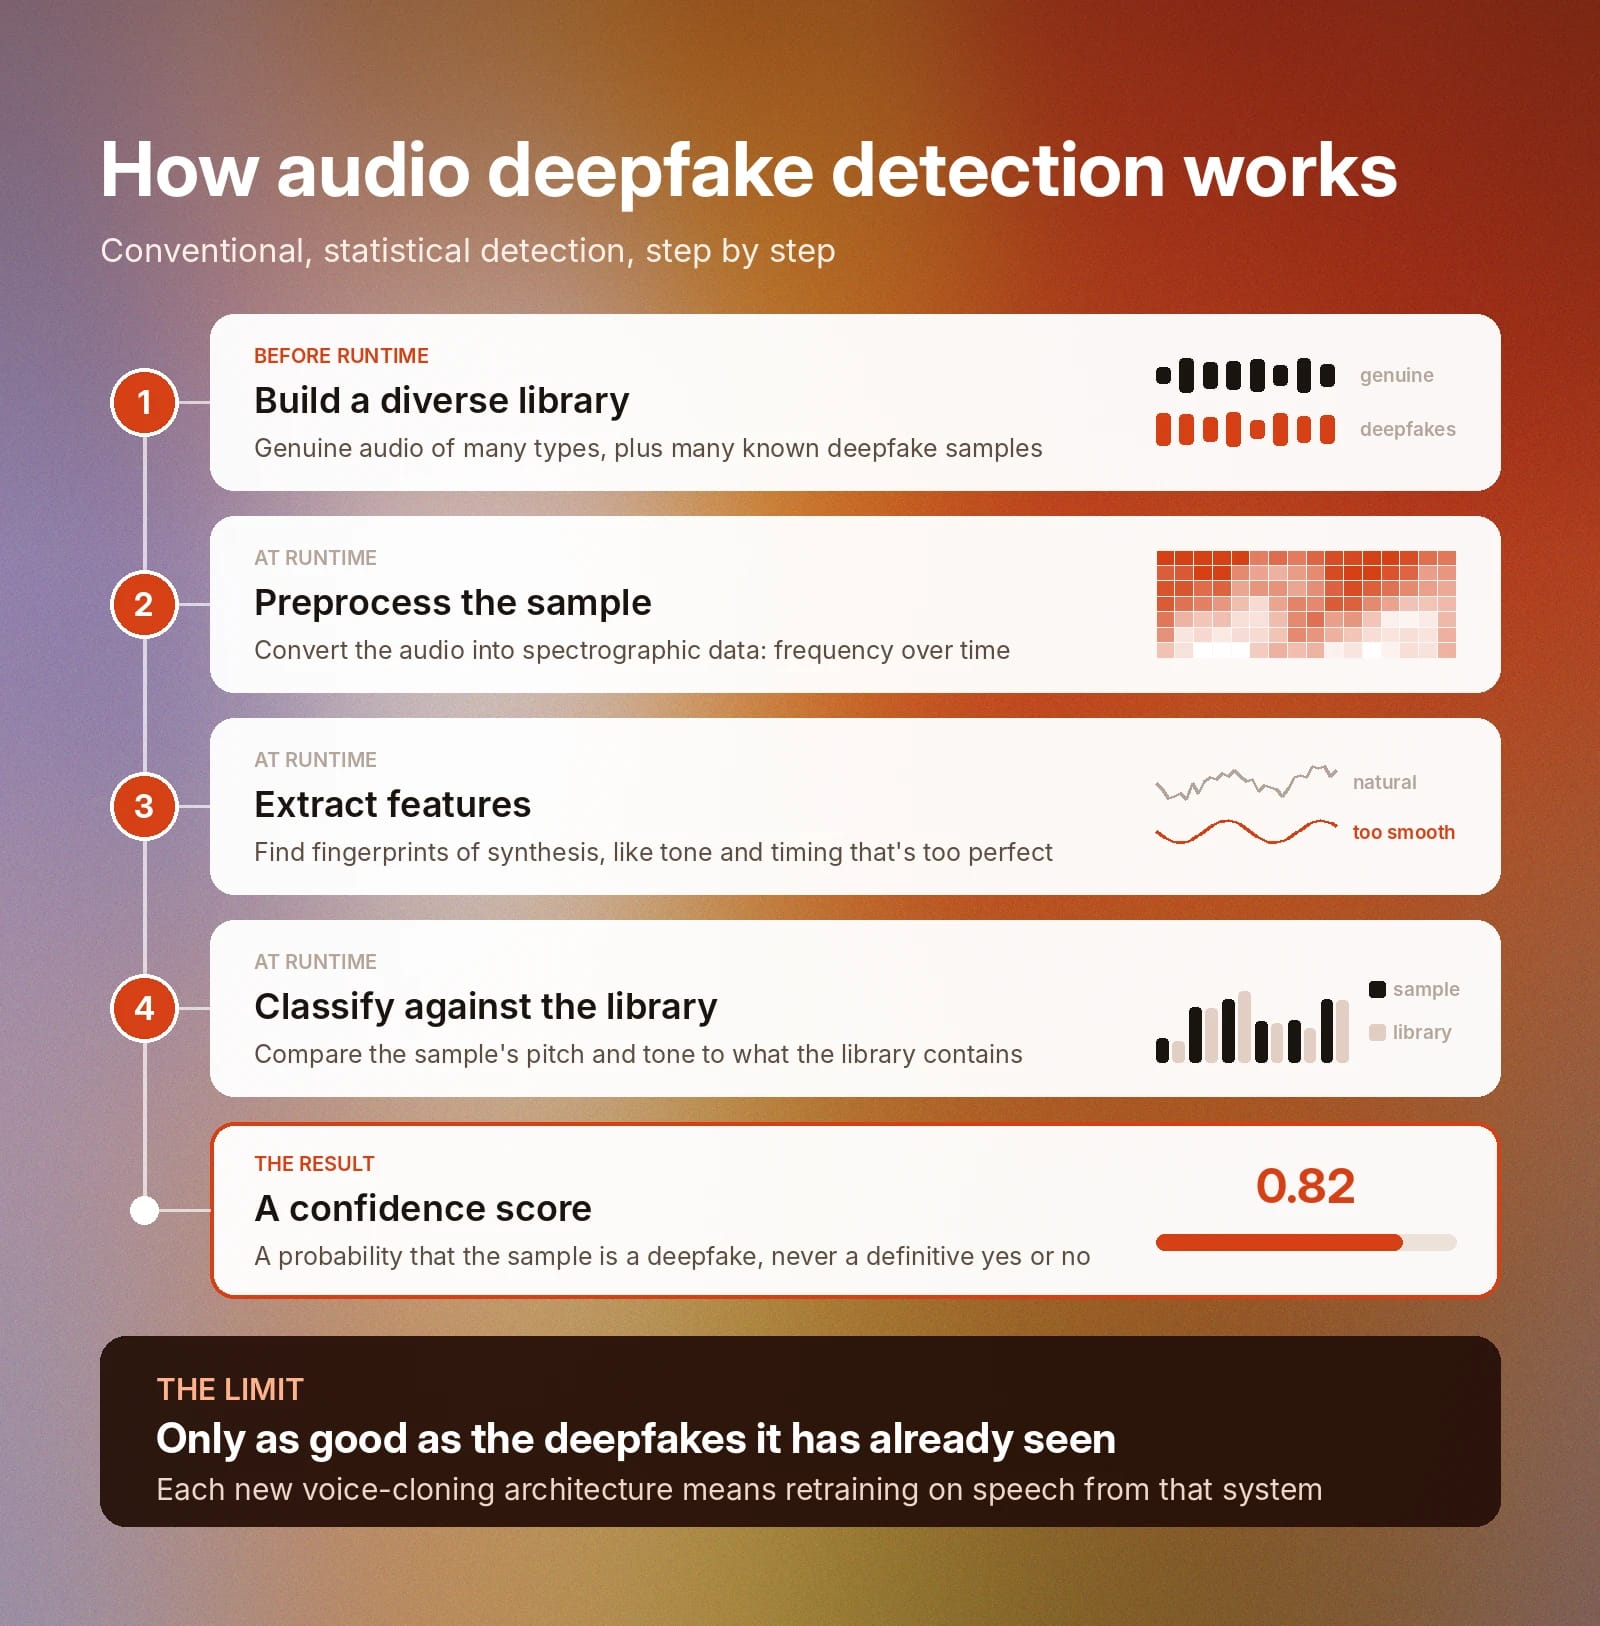
O primeiro passo é criar uma biblioteca de conteúdo de áudio para comparar com possíveis deepfakes. Ela deve conter um conjunto diversificado de dados, incluindo amostras de áudio genuínas de vários tipos e muitas amostras conhecidas de deepfakes para ajudar a realizar detecções positivas.
Durante a execução, o processo segue três etapas: pré-processamento, extração de características e classificação.
Pré-processamento de áudio
Quando você fornece uma amostra de áudio a uma ferramenta de detecção treinada, ela a converte em dados espectrográficos, ou uma representação matemática das mudanças de frequência ao longo do tempo.
Extração de características
Em seguida, a ferramenta de detecção extrai características dos dados da amostra que funcionam como impressões digitais da fala sintetizada. Por exemplo, a fala de IA às vezes é perfeita demais e não tem as irregularidades de tom e ritmo encontradas na fala natural. Comparar a altura e o tom de voz do falante com sua biblioteca também ajuda a ferramenta a identificar outros sinais de alerta.
Classificação
Como a detecção convencional de deepfakes ocorre por análise estatística, ela não pode dar uma resposta definitiva de “sim” ou “não” à pergunta de se uma amostra é um deepfake. Em vez disso, ela gera uma pontuação de confiança, ou probabilidade, de que a amostra seja um deepfake.
Como medem semelhanças entre uma amostra e uma biblioteca de áudio existente, as ferramentas convencionais são limitadas pelas amostras conhecidas de deepfakes que têm disponíveis. Sempre que alguém lança uma nova arquitetura de clonagem de voz, é preciso retreinar a ferramenta de detecção com falas sintetizadas nesse novo sistema para detectá-las com precisão.
Qual é a diferença entre marca d'água e detecção estatística?
Marca d'água é uma abordagem totalmente diferente para a classificação de fala. Um classificador de aprendizado de máquina faz uma estimativa probabilística sobre se uma amostra é autêntica com base no que sabe, a partir de seus dados de treinamento, sobre a fala natural — por exemplo, como peso emocional e ênfase reais aparecem nos dados espectrográficos e quais tipos de mudanças de tom e ritmo são naturais.
A marca d'água é determinística. Uma marca d'água é uma assinatura matemática inserida nos dados de áudio pelo sintetizador em níveis que um ouvinte humano não consegue ouvir. Um detector de marca d'água verifica, sim ou não, se encontra essa assinatura oculta.
Um detector opera em três etapas simples:
- Extração: A ferramenta extrai dados espectrográficos e isola as frequências em que espera encontrar uma marca d'água.
- Correspondência de chave: Ela tenta desbloquear a assinatura com uma chave.
- Verificação: Se o sinal for decodificado corretamente, a ferramenta confirma que o Gerador de Voz IA em questão gerou o áudio.
Processo de detecção de marca d'água da ElevenLabs
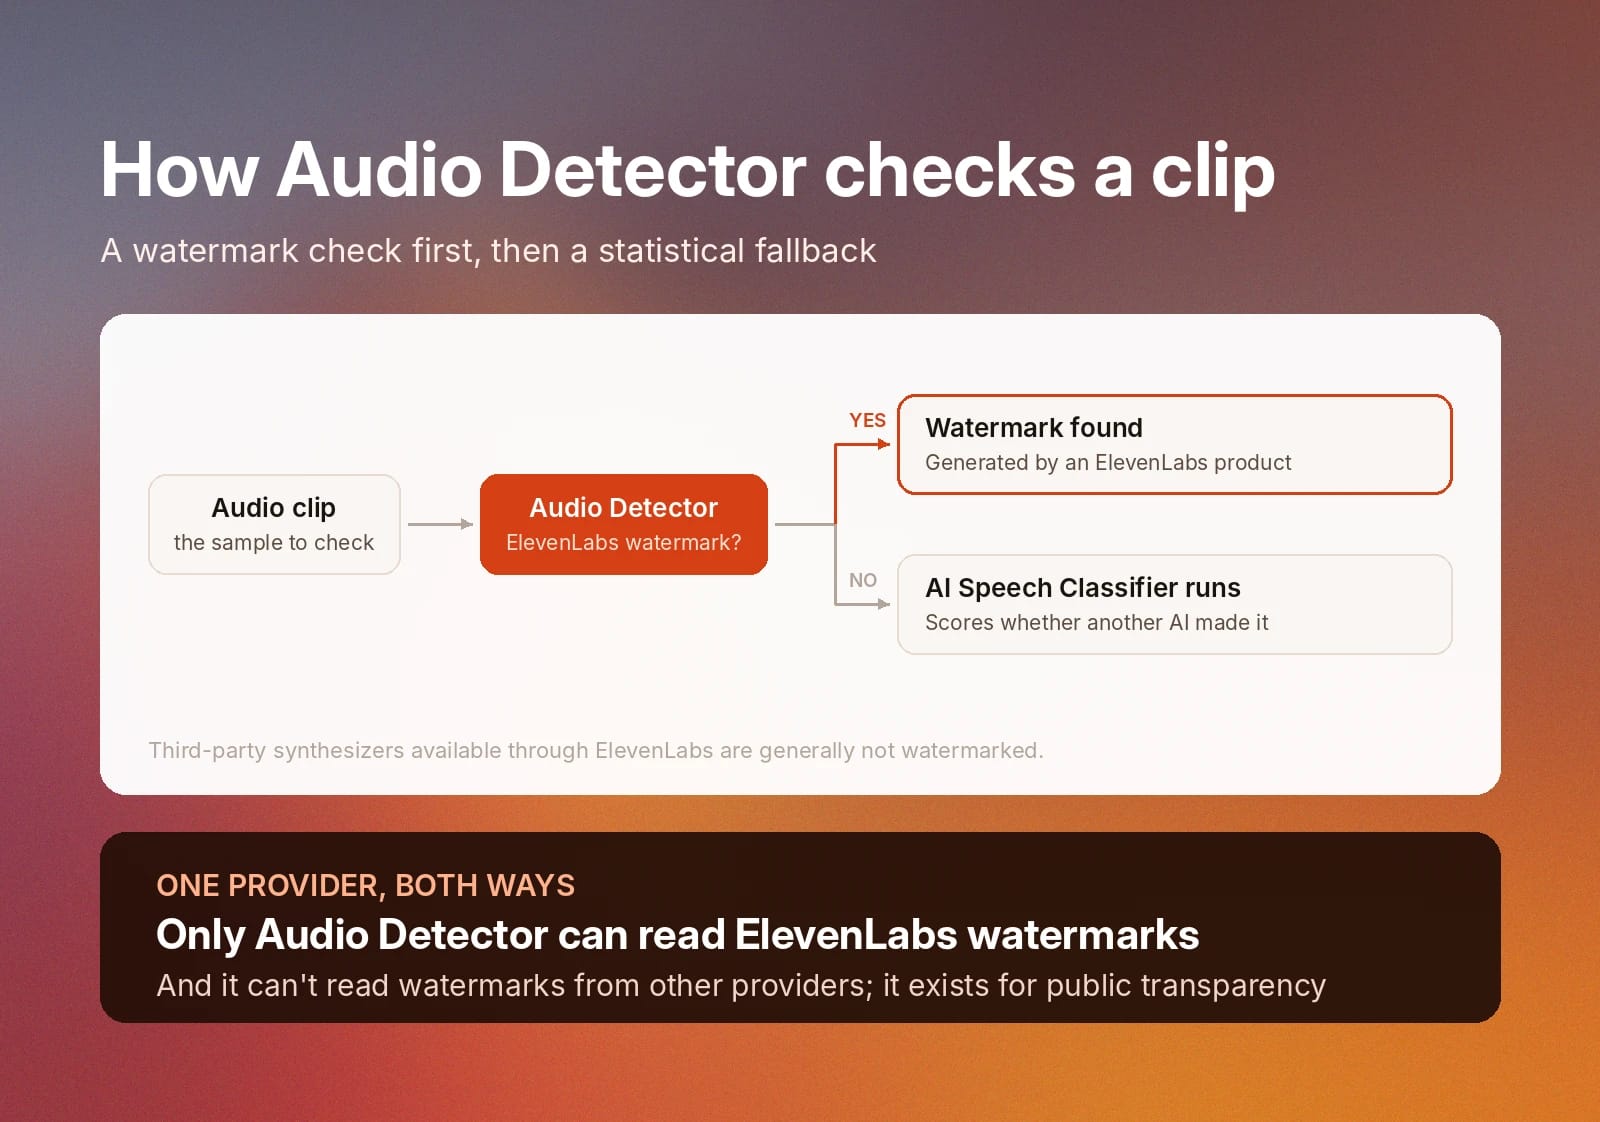
A ferramenta de marca d'água da ElevenLabs é o Audio Detector. Ela analisa amostras de áudio e verifica se o conteúdo foi gerado por um produto da ElevenLabs. Se não encontrar uma marca d'água, executa o AI Speech Classifier estatístico para avaliar se o áudio foi gerado por IA de outra fonte.
Devido à forma como a marca d'água funciona, o Audio Detector da ElevenLabs detecta apenas áudios gerados pela ElevenLabs. Atualmente, ele não consegue identificar marcas d'água de outros provedores de voz IA.
E, por outro lado, somente o Audio Detector da ElevenLabs consegue detectar marcas d'água da ElevenLabs.
Observe também que conteúdos gerados por sintetizadores de terceiros disponíveis pela ElevenLabs geralmente não recebem marca d'água.
Outras opções para detectar áudios gerados pela ElevenLabs
O ElevenCreative AI Speech Classifier está disponível gratuitamente e sem necessidade de login. Ele analisa o primeiro minuto de uma amostra de áudio e fornece uma pontuação de confiança sobre a probabilidade de o áudio ter sido gerado por um modelo da ElevenLabs.
Observe que ele não consegue classificar de forma confiável áudios do Eleven v3. É mais eficaz para classificar áudios gerados por modelos TTS mais antigos da ElevenLabs. Sua precisão também diminui ao analisar conteúdo de fala muito comprimido ou editado.
Como detectar vozes sintéticas em larga escala?
Algumas equipes empresariais precisam detectar deepfakes em larga escala e quase em tempo real. Considere o exemplo da equipe de atendimento ao cliente de um banco nacional. Seus representantes interagem com milhares de clientes por dia. Os membros da equipe precisam compartilhar e atualizar regularmente dados privados de contas.
A liderança dessa equipe se importa muito com a rapidez para identificar tanto um interlocutor fraudulento quanto responder a clientes legítimos. Ela precisa de uma estrutura de detecção de voz capaz de identificar, ao vivo durante as chamadas, áudios de todos os principais mecanismos de geração de voz.
Criando uma estrutura completa de detecção de voz
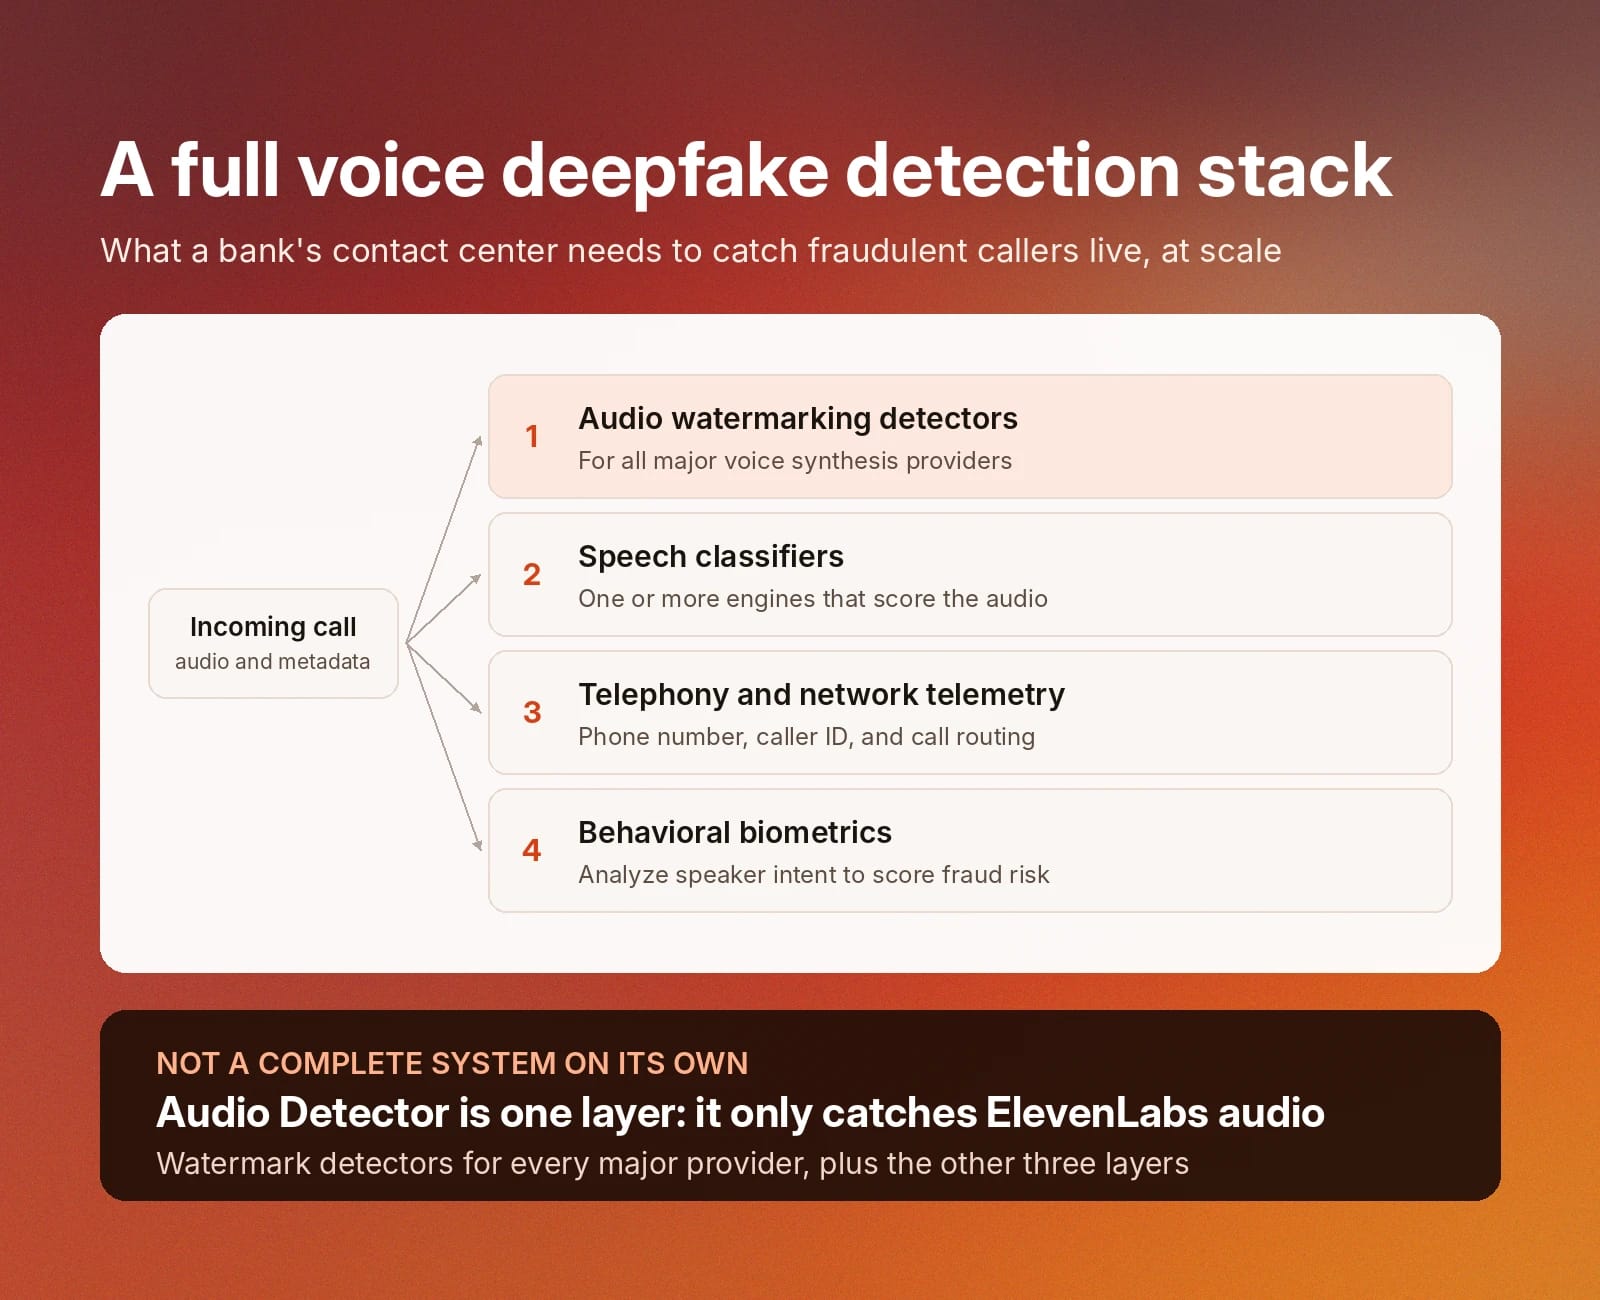
O Audio Detector da ElevenLabs desempenha um papel importante aqui, mas é importante reforçar que ele detecta apenas áudios com marca d'água da ElevenLabs. Por si só, não é um sistema completo de detecção de voz. Organizações que querem recursos completos de detecção de voz precisam reunir vários tipos de ferramentas:
- Detectores de marca d'água de áudio: Para todos os principais provedores de síntese de voz.
- Classificadores de fala: Um ou mais mecanismos de classificação capazes de pontuar dados de áudio.
- Telemetria de telefonia e rede: Análises de metadados de chamadas, como número de telefone, identificador de chamada e roteamento de chamadas.
- Biometria comportamental: Software para analisar a intenção do falante e avaliar o risco de fraude.
Comece a usar a detecção de deepfakes da ElevenLabs
A ElevenLabs está comprometida em contribuir positivamente para a vida pública, tanto por meio de serviços relevantes de geração de voz quanto oferecendo ao público as ferramentas necessárias para identificar deepfakes e outros usos mal-intencionados de áudio gerado por IA.
Você tem um clipe de áudio que quer testar em busca de deepfakes? Cadastre-se para experimentar o Audio Detector da ElevenLabs ou comece a usar o AI Speech Classifier hoje.
Perguntas frequentes

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.