Apresentamos o Scribe v3 e o v3 Live, nossos modelos de Speech to Text mais precisos
- Escrito por
- Min Kim
- Publicado
- Última atualização
OuvirOuça este artigo
Produtos baseados em áudio começam com uma transcrição: anotações de reuniões, agentes de voz, dublagem, documentação clínica e arquivos de transmissão que abrangem décadas de conteúdo. Acertar essa transcrição logo na primeira vez importa, porque cada erro segue adiante e custa muito mais para corrigir.
Mas o áudio do mundo real é complexo. São várias pessoas falando ao mesmo tempo em uma reunião, um cliente em uma rua movimentada que pausa no meio de uma frase ou uma chamada de suporte em que nenhuma das pessoas fala sua língua materna.
Hoje, a ElevenLabs está lançando dois novos modelos de Speech to Text desenvolvidos exatamente para essas condições:
- Scribe v3, para áudio gravado, comete 27% menos erros de palavras que o Scribe v2 em 102 idiomas e tem as identificações de locutores mais precisas entre todos os modelos que testamos,
- Scribe v3 Live é a variante de baixa latência para áudio em tempo real e comete 43% menos erros do que o Scribe v2 Realtime. Ele também inclui diarização de locutores pela primeira vez (identificando quem disse o quê) e uma detecção de turnos aprimorada.
O Scribe v3 Live está disponível hoje no ElevenAgents. Os dois modelos também estão disponíveis na ElevenAPI, onde migrar do Scribe v2 requer apenas alterar o ID do modelo em uma linha.
Os feedbacks que moldaram o Scribe v3
O Scribe já viabilizou centenas de milhões de horas de transcrição para apps de anotações de reuniões, centrais de atendimento, ferramentas de documentação clínica e agentes de voz. Em todos os casos de uso, as equipes que o utilizavam continuavam pedindo as mesmas cinco coisas.
Equipes de reuniões e anotações queriam uma diarização melhor em conversas rápidas e com três ou mais locutores. Equipes de agentes de voz disseram que um temporizador de silêncio interrompe as pessoas quando elas pausam no meio de uma frase ou falam mais devagar para ditar um número. Equipes que desenvolviam produtos ao vivo abriam mão de precisão para ganhar velocidade, já que o modo em tempo real tinha desempenho claramente inferior ao processamento em lote. Clientes na Índia queriam que o desempenho em hindi fosse equivalente ao inglês, mesmo quando as pessoas alternavam entre os dois idiomas no meio de uma frase. E muitos queriam mais controle sobre a saída, desde números escritos como “123” até listas de termos-chave longas o bastante para um catálogo de produtos ou uma lista de nomes de medicamentos.
Identificação de locutores, detecção de turnos e mais controle sobre a saída
Diarização que funciona bem em ambientes cheios
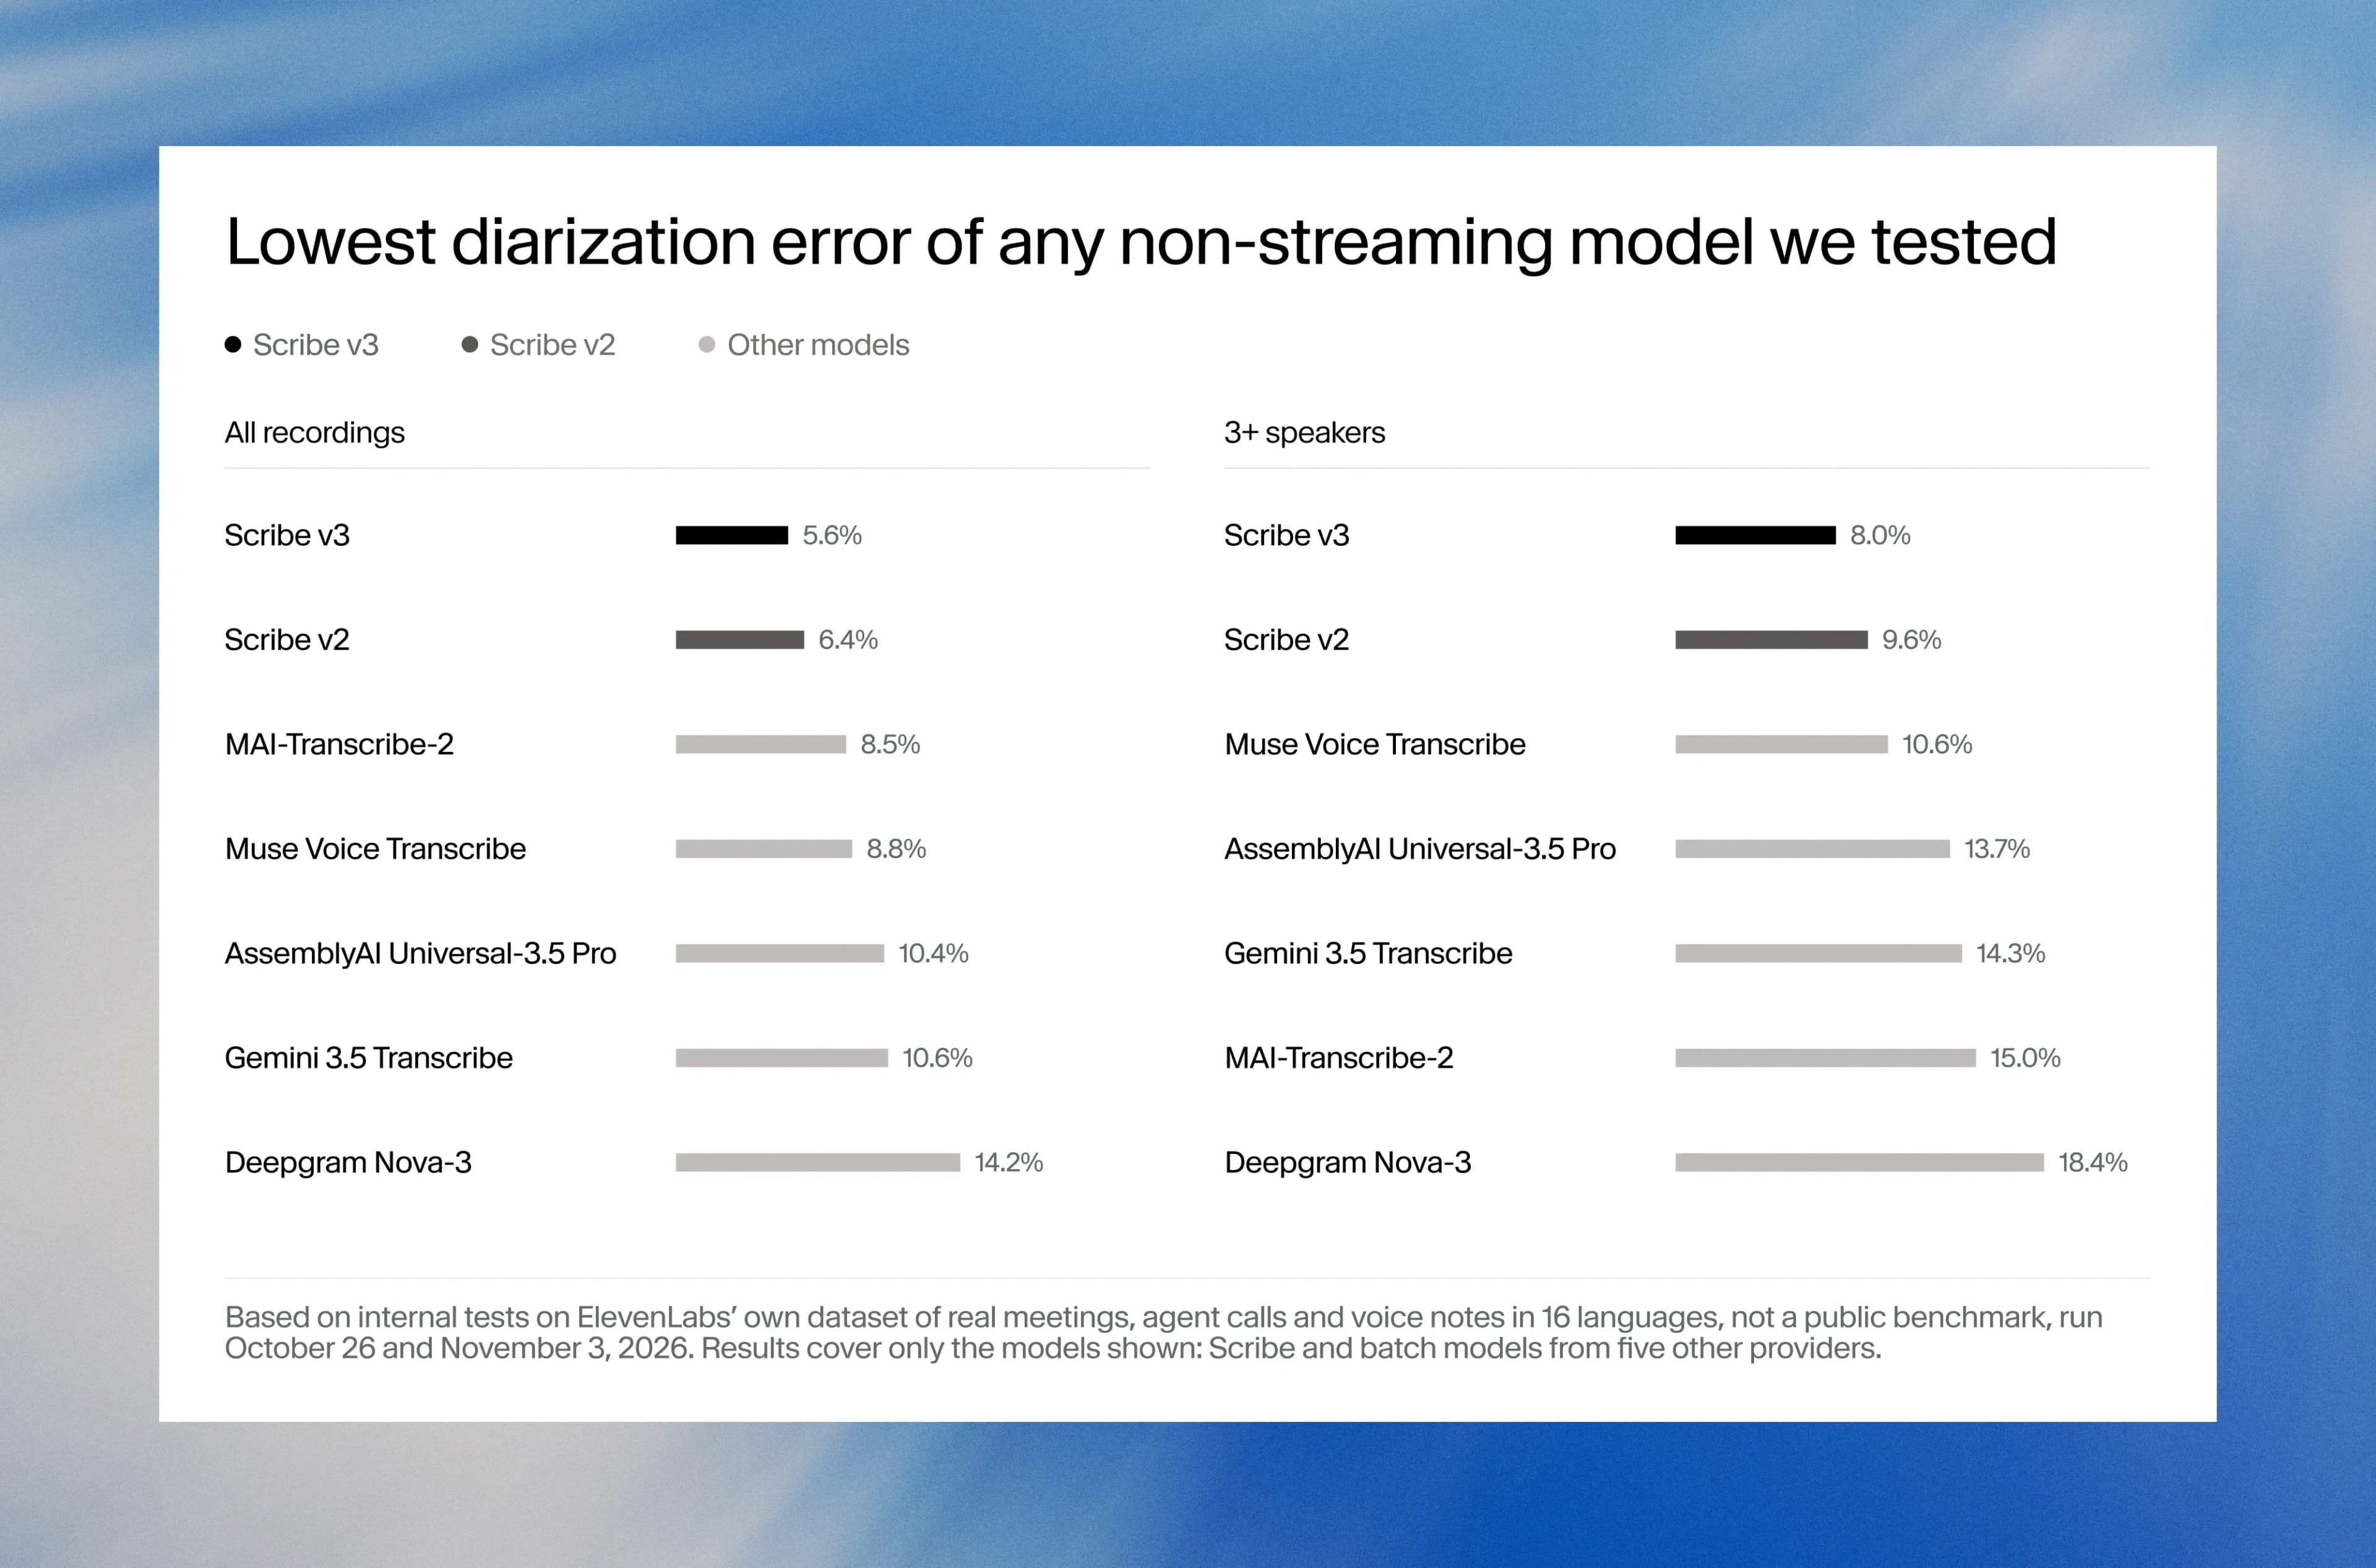
Em uma transcrição de reunião, identificar o locutor certo é tão importante quanto registrar as palavras certas. O Scribe v3 comete 17% menos erros de diarização que o Scribe v2 em gravações com três ou mais locutores, justamente o tipo de gravação em que a maioria dos modelos existentes falha. O Scribe v3 Live também traz a diarização para a transcrição em tempo real pela primeira vez, com 39% menos erros de diarização que o segundo melhor modelo em tempo real que testamos.
Detecção de turnos que acompanha a conversa
Para que as conversas pareçam naturais, os agentes de voz precisam prever com precisão quando um locutor terminou de falar. Sistemas tradicionais de alternância de turnos fazem isso com base em períodos de silêncio. Mas o silêncio por si só exige uma escolha: definir um limite curto pode interromper pessoas que pausam no meio de uma frase, enquanto um limite longo faz o agente parecer lento. O Scribe v3 Live usa o contexto da conversa, além do áudio, para que uma pessoa que pausa no meio de um número não seja interrompida. Essa é a mesma detecção de turnos que o ElevenAgents já usa, agora disponível na ElevenAPI.
Mais controle sobre idiomas, terminologia e formatação
O Scribe v3 consegue inferir quais idiomas uma gravação pode conter e permite escolher se os números são retornados como dígitos ou por extenso. O prompt de termos-chave aceita até 1.000 termos que você sabe que vão aparecer, como nomes de marcas, siglas e jargões, e as edições da transcrição aplicam regras de formatação escritas em inglês simples, como “escreva todas as datas como YYYY-MM-DD”.
O Scribe v3 Live adiciona um modo multilíngue para conversas que alternam de idioma no meio da frase. Ele também adiciona uma biblioteca de termos-chave para vocabulários grandes demais para uma lista. Enquanto o prompt de termos-chave abrange termos que você sabe que vão aparecer, a biblioteca de termos-chave guarda milhares que podem aparecer, e o modelo a consulta apenas quando ouve uma provável correspondência.
Como o Scribe v3 se compara
A ElevenLabs avaliou ambos os modelos em comparação ao Scribe v2, Scribe v2 Realtime e outros modelos populares de Speech to Text, pontuando cada um nos mesmos conjuntos de dados. A precisão multilíngue foi medida em uma versão interna do benchmark FLEURS, que testa falas curtas, claras e lidas em 102 idiomas. O FLEURS não consegue medir diarização, pois cada clipe tem um locutor, então também criamos nosso próprio conjunto de dados com reuniões reais, chamadas com agentes e mensagens de voz em 16 idiomas. Em breve, vamos disponibilizá-lo como código aberto.
Diarização de locutores
O Scribe v3 tem o menor erro de diarização entre todos os modelos que testamos, com 12% menos erros que o Scribe v2 no geral e 17% menos em gravações com três ou mais locutores.
Precisão de transcrição multilíngue
Apresentamos a taxa de erro de palavras (WER) junto à WER semântica, que considera um erro apenas quando o significado da transcrição muda.
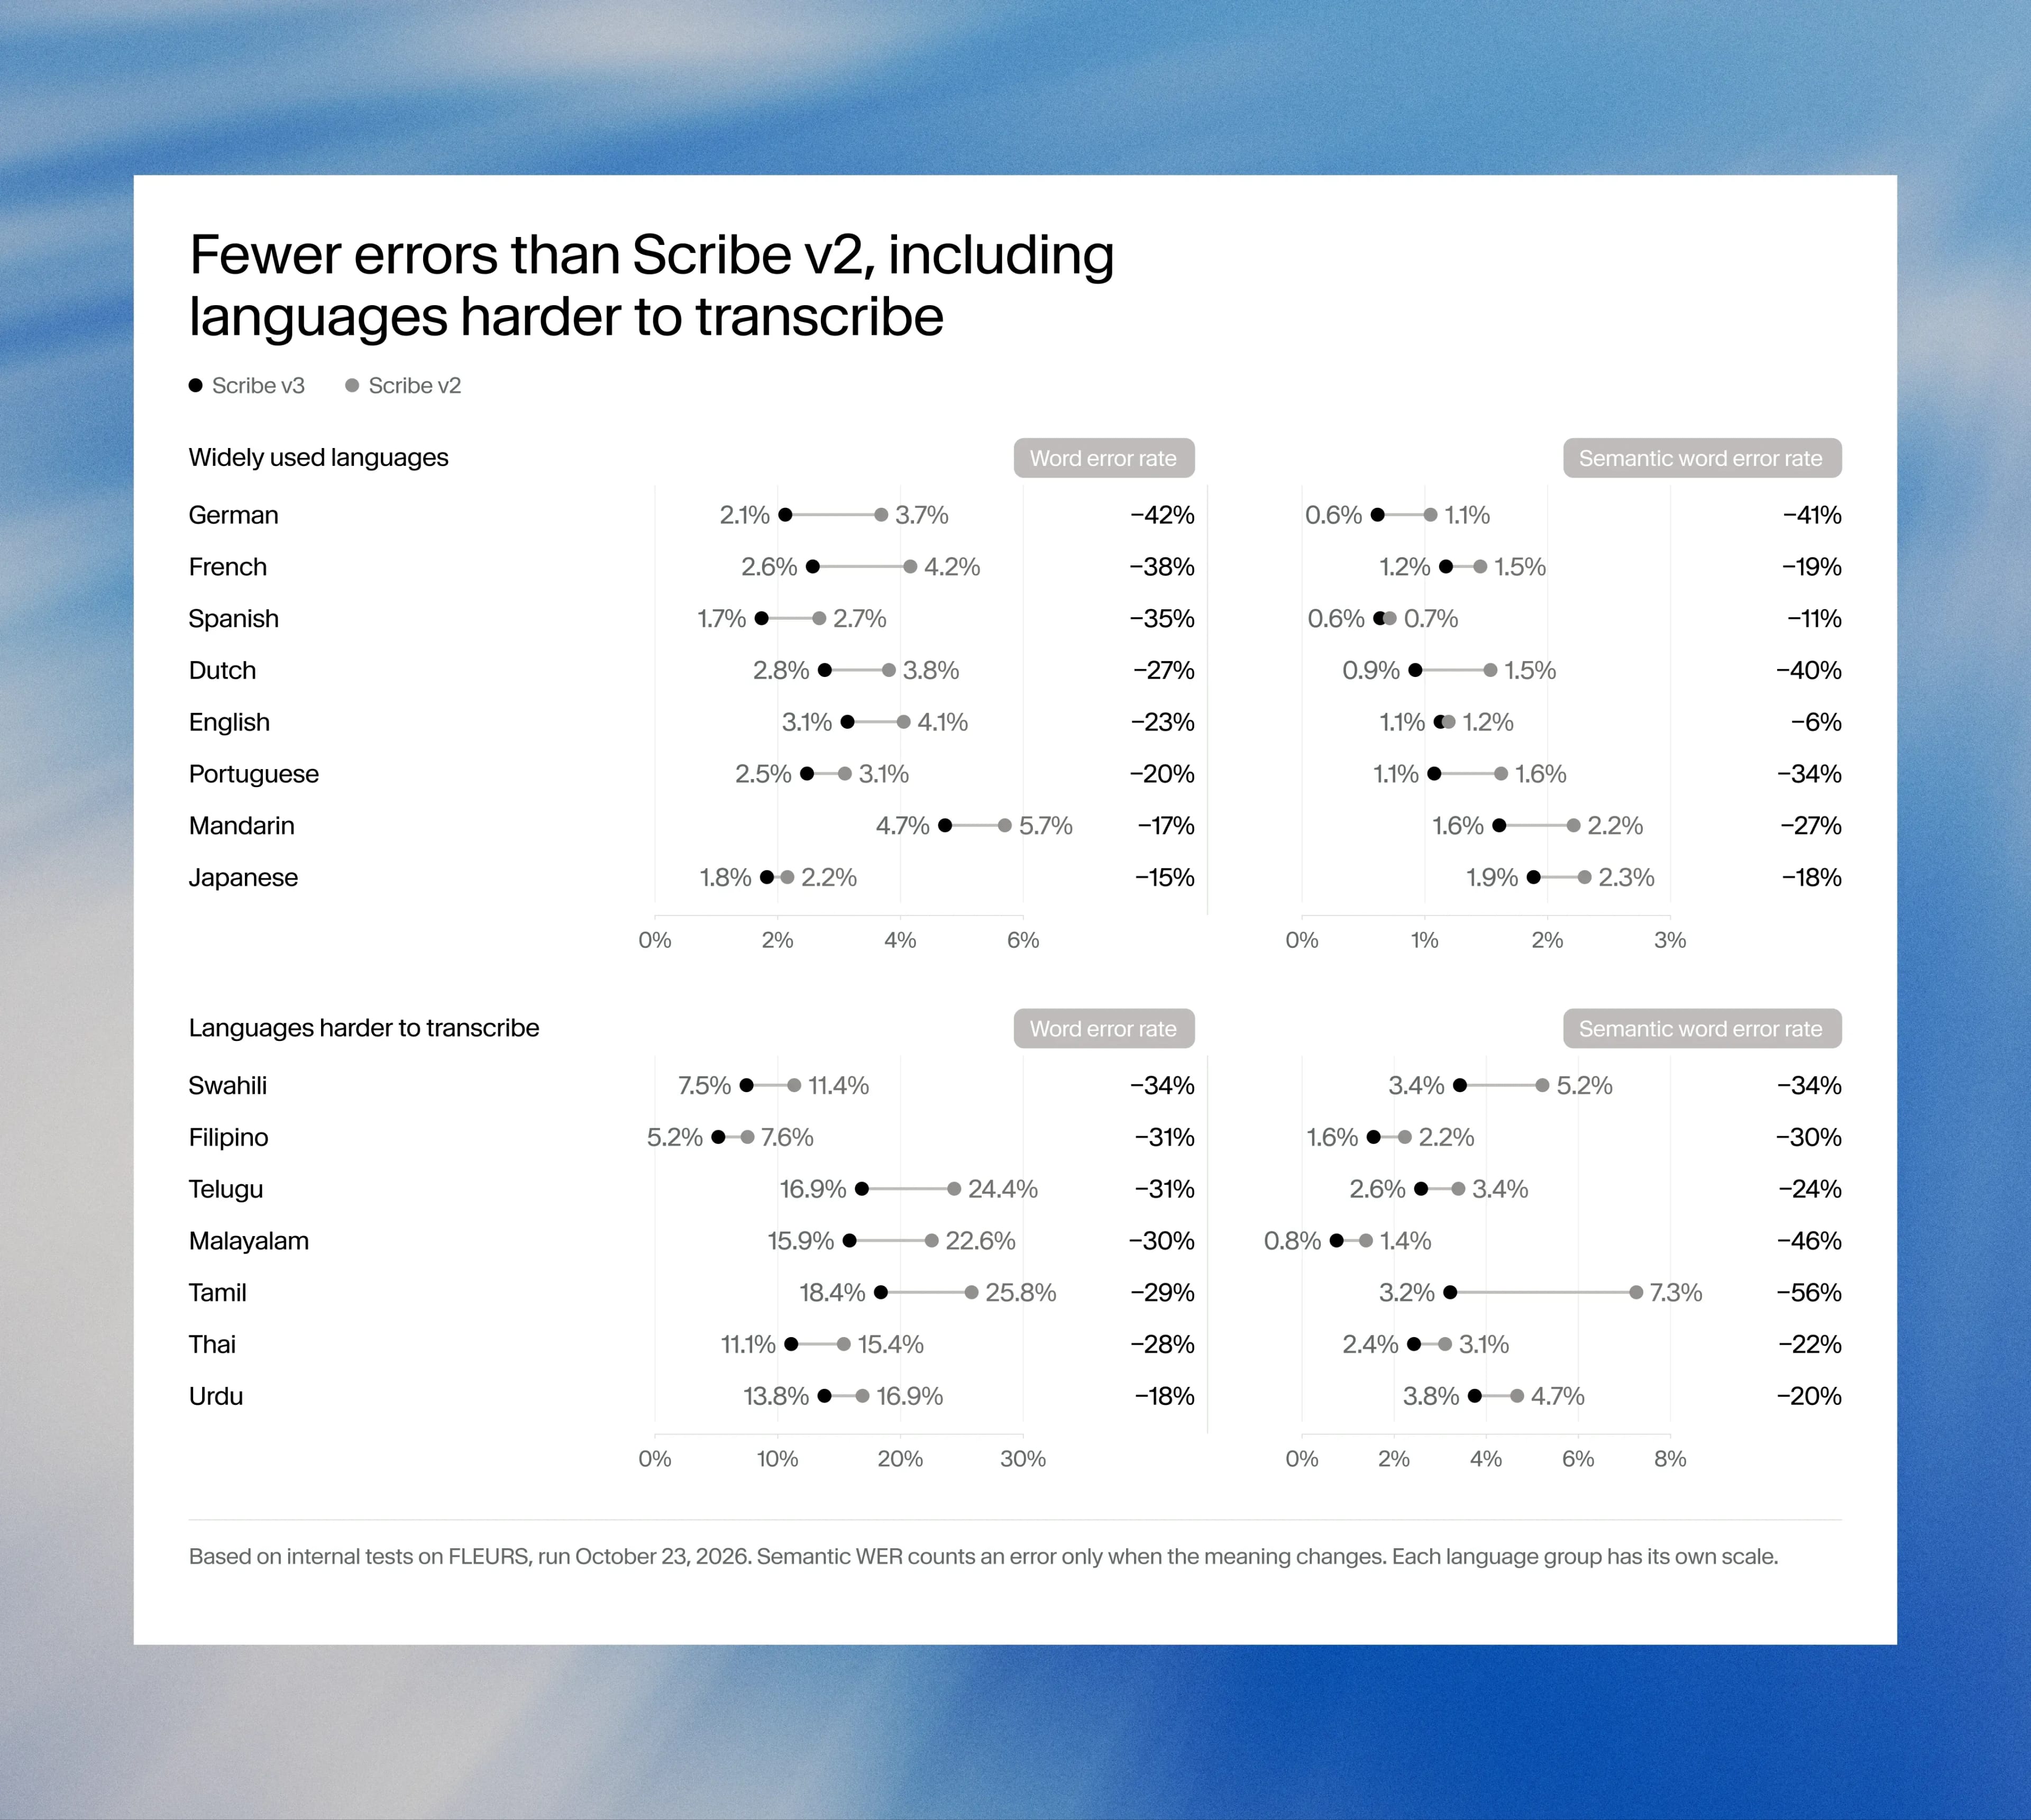
Nos 102 idiomas do FLEURS, o Scribe v3 reduz a WER em 27% em comparação ao Scribe v2 e melhora em todos os idiomas testados. Nos idiomas mais fáceis de transcrever, o alemão melhorou 42%, o espanhol 35% e o inglês 23%. As melhorias são maiores nos idiomas mais difíceis de transcrever: o suaíli reduz 34%, o tâmil 29% e o tailandês 28%.
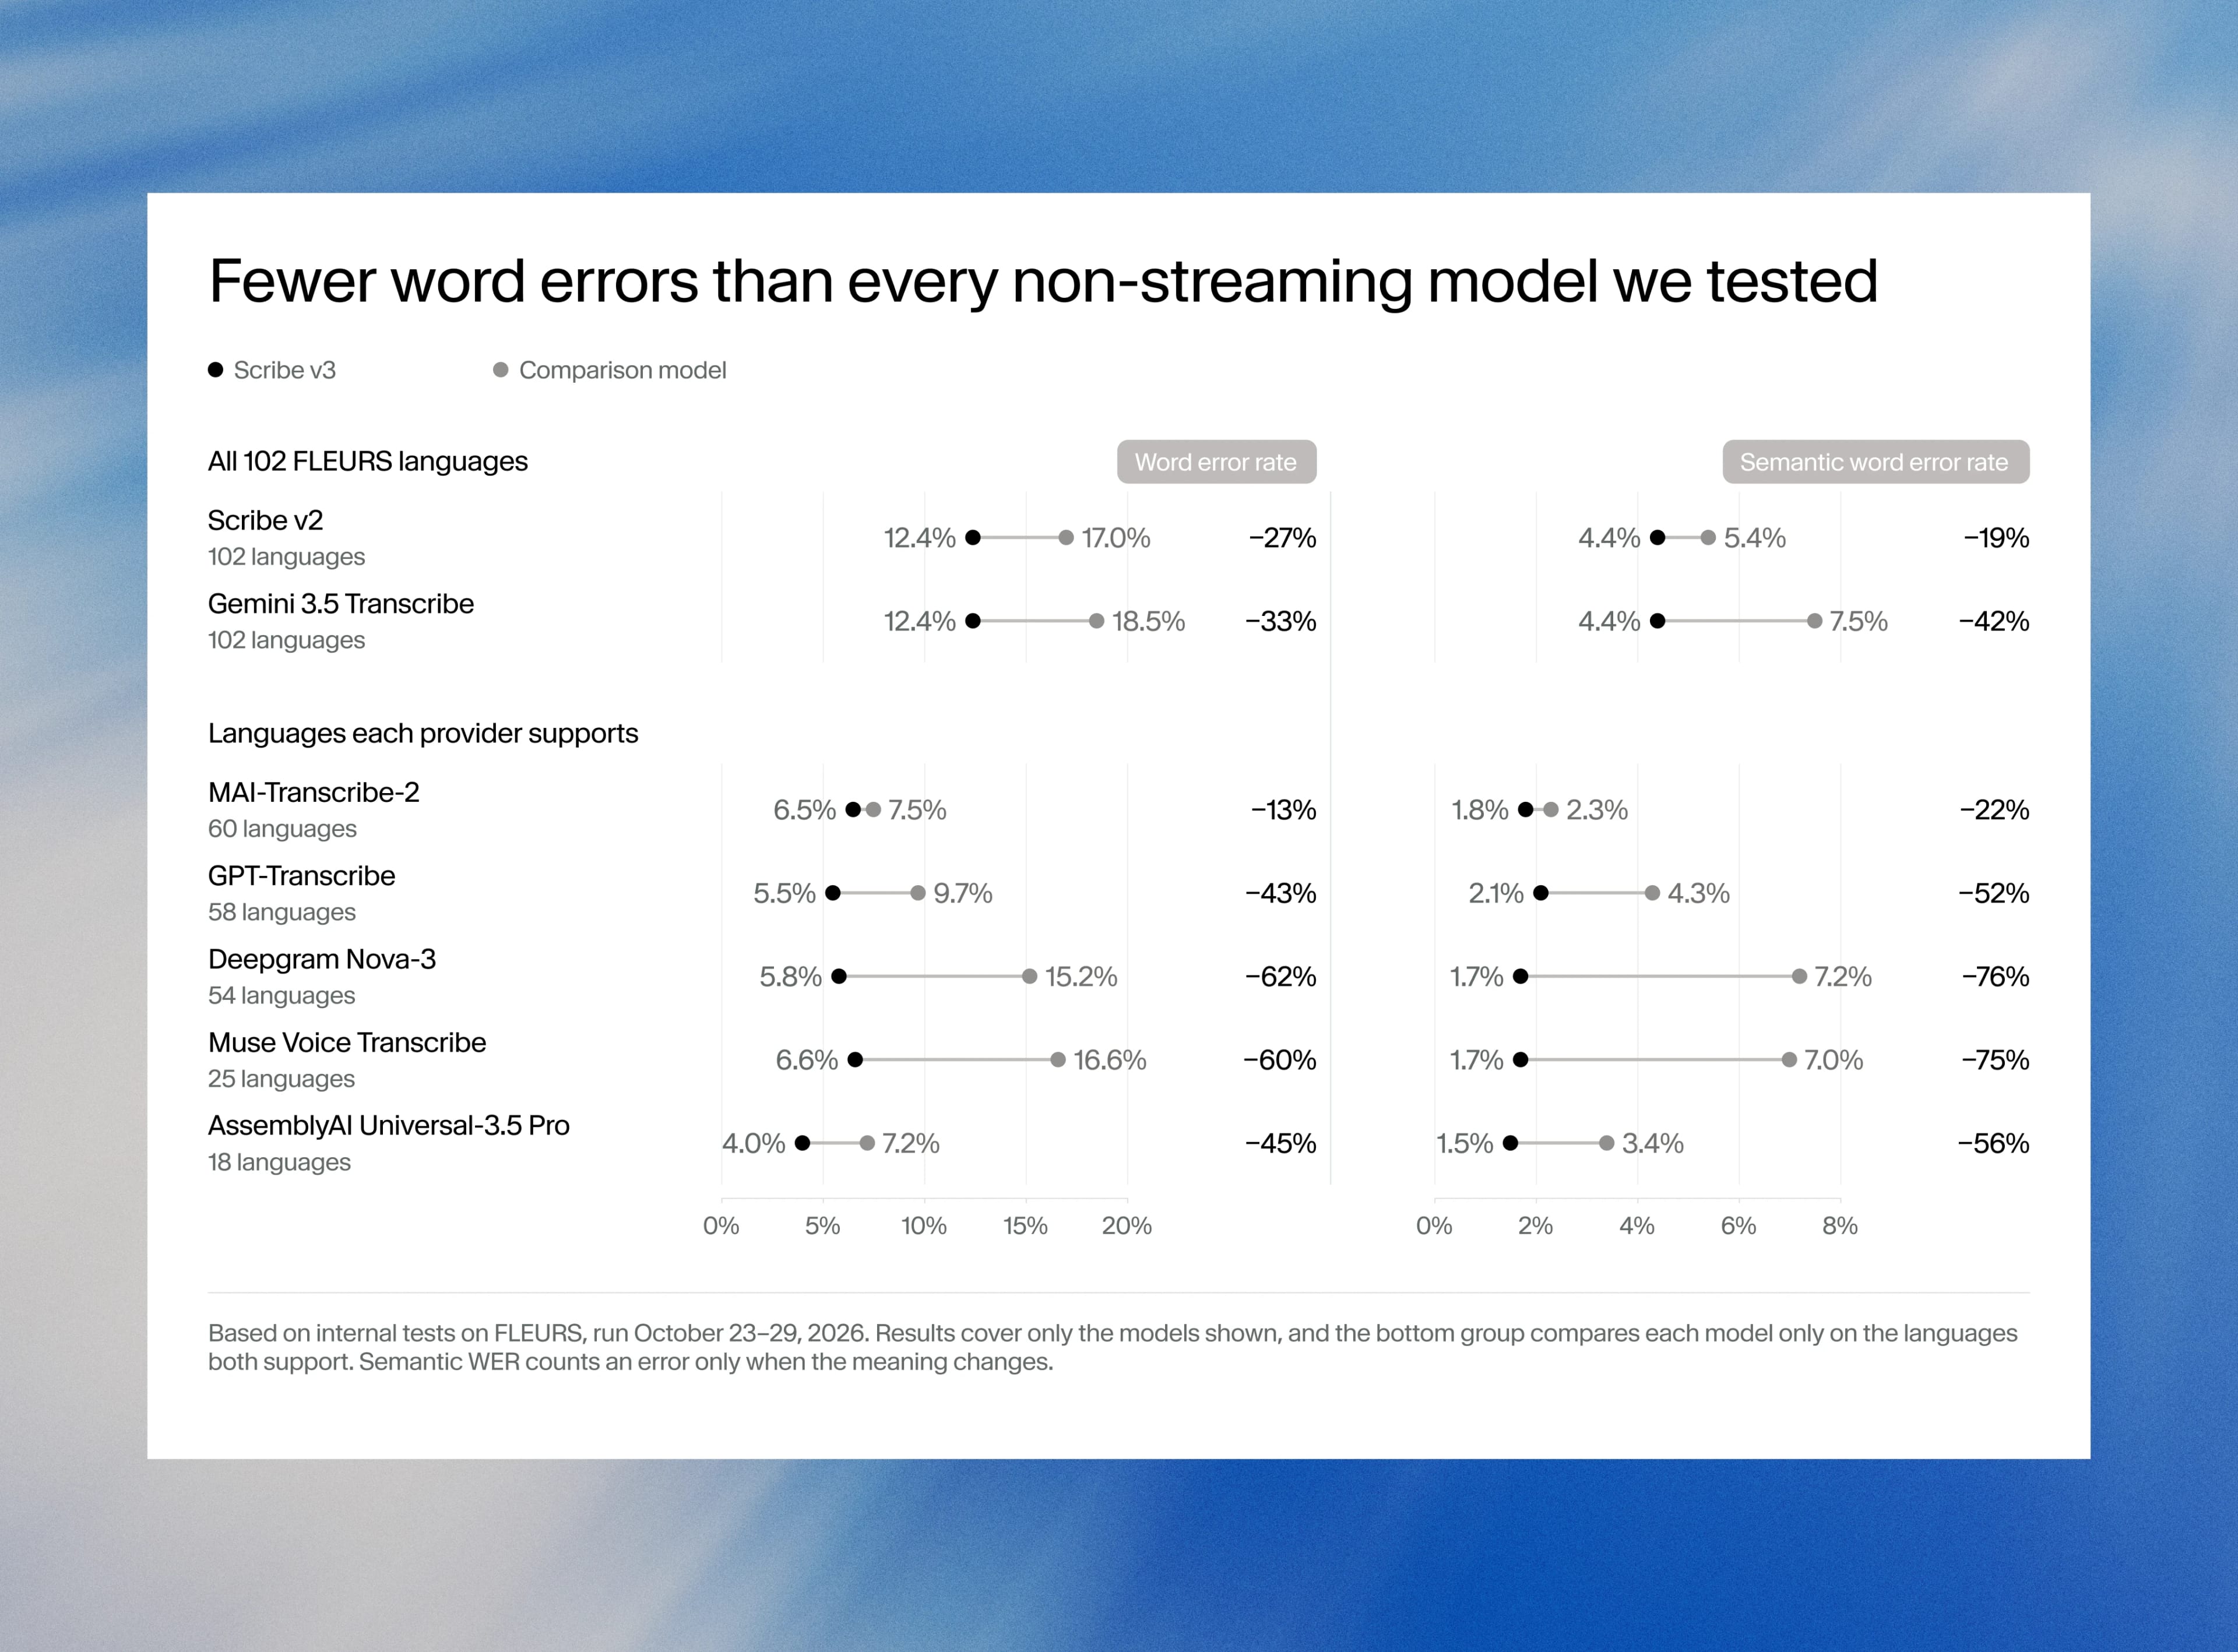
O Scribe v3 também comete menos erros de palavras que todos os outros modelos em lote (sem streaming) que testamos, comparando cada um nos idiomas compatíveis com ambos os modelos.
Diarização de locutores em tempo real
Na parte em inglês do nosso conjunto de dados reais em 16 idiomas, o Scribe v3 Live tem uma taxa de erro de diarização de 3,1%, em comparação com 5,9% a 7,3% dos outros modelos em tempo real que testamos.
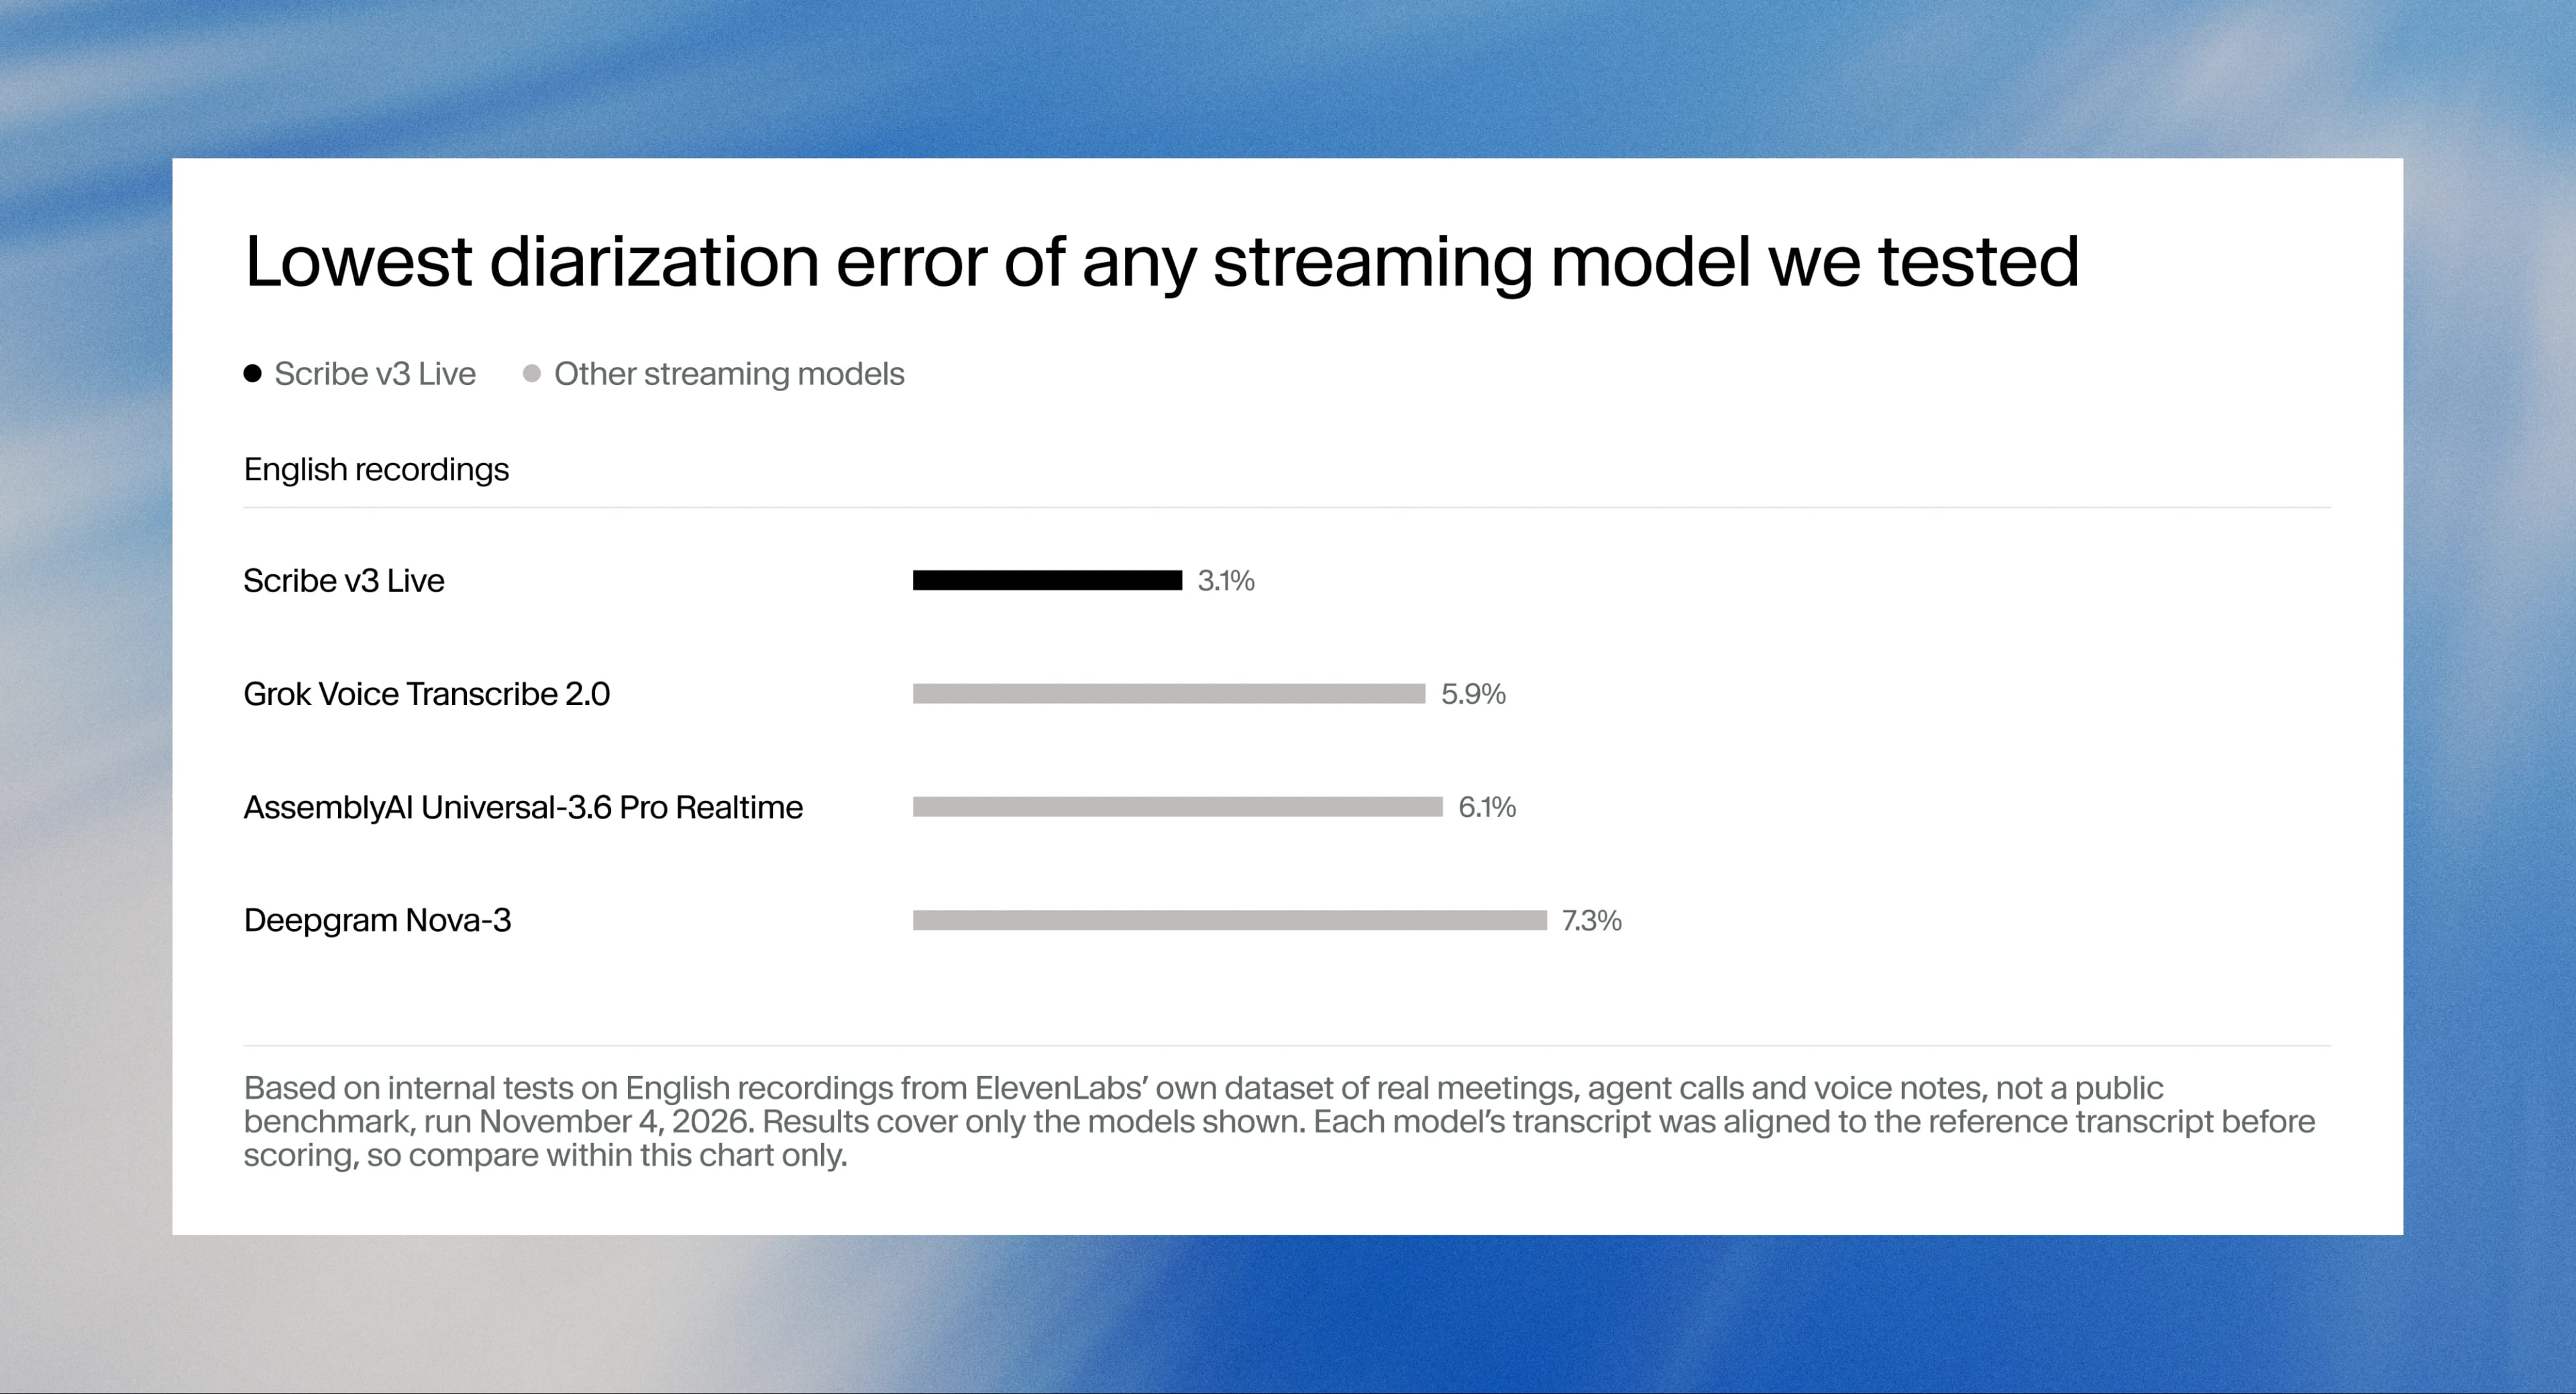
As métricas padrão de diarização também contam erros de transcrição, como palavras omitidas, e os modelos em tempo real omitem mais palavras que os modelos em lote. Para medir apenas se cada palavra foi atribuída ao locutor correto, alinhamos a transcrição de cada modelo à referência antes de calcular a pontuação. Isso reduz a taxa de erro de todos os modelos, portanto estes resultados não podem ser comparados aos resultados de diarização em lote acima.
Precisão multilíngue em tempo real
Para modelos em tempo real, priorizamos a WER semântica. Um modelo de streaming escreve o texto antes de ouvir a frase inteira, e cada provedor formata números, pontuação e letras maiúsculas de forma diferente durante o processo. A WER padrão contabiliza essas diferenças como erros, mesmo quando o significado é o mesmo, por isso a WER semântica é uma comparação mais justa.
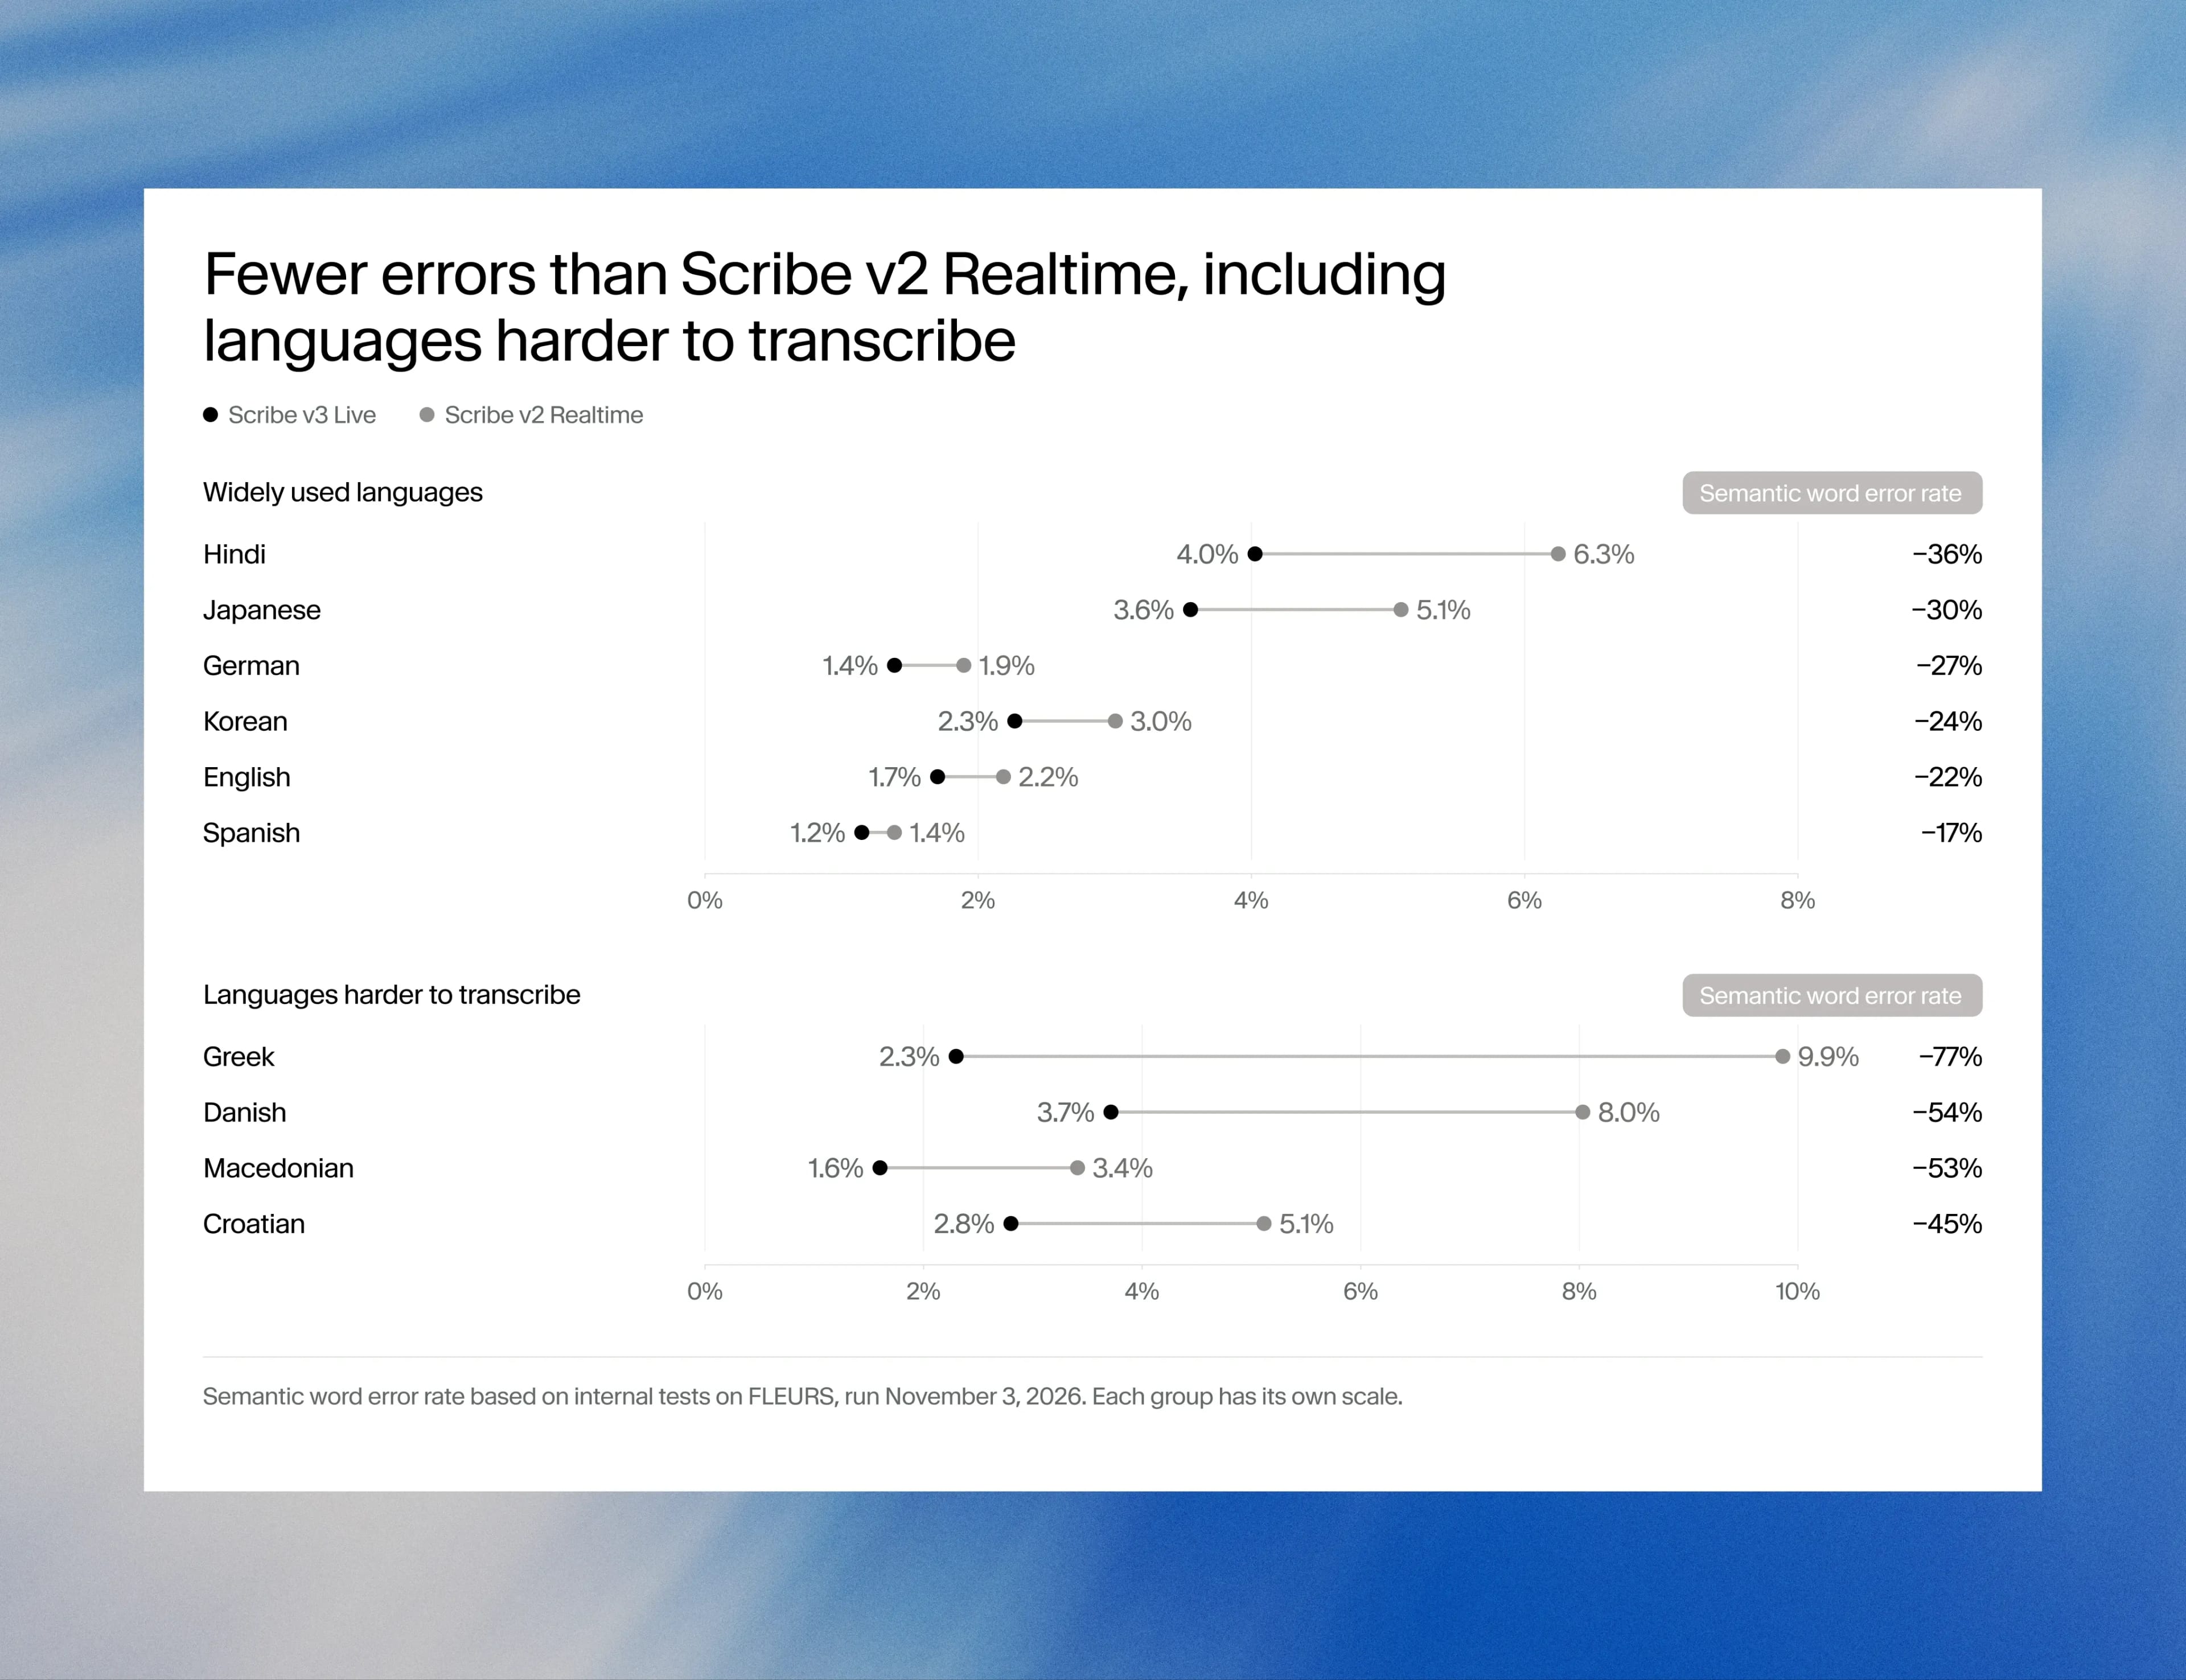
Em 102 idiomas, o Scribe v3 Live reduz a WER semântica em 43% e a WER em 31% em comparação ao Scribe v2 Realtime. Ele melhora em todos os idiomas e tem uma taxa de erro menor que todos os outros modelos em tempo real que testamos.
As melhorias são maiores onde a transcrição em tempo real ficou mais para trás: o grego melhora 77%, o dinamarquês 54% e o croata 45%, enquanto o hindi melhora 36%.
Uma observação sobre o método: pontuamos cada idioma individualmente antes de calcular a média, para que todos os 102 idiomas tenham o mesmo peso. Muitos resultados publicados agrupam todos os clipes em uma única pontuação, o que tende a gerar números menores; por isso, resultados medidos de formas diferentes não são diretamente comparáveis.
O valor de alguns pontos de precisão
Todo lançamento de modelo vem com porcentagens, inclusive este, e, no papel, é difícil perceber o que alguns pontos significam em cenários reais. Uma reunião de uma hora, com 150 palavras por minuto, tem cerca de 9.000 palavras; portanto, a diferença entre uma taxa de erro de palavras de 4% e uma de 2% é de 180 palavras erradas, três a cada minuto de fala. O erro de diarização é medido em tempo, não em palavras, então, nessa mesma reunião, cada ponto representa 36 segundos de fala atribuída ao nome errado.
O custo desses erros depende de onde eles ocorrem. Na transcrição de um podcast, uma palavra errada é um erro de digitação, mas, em uma teleconferência de resultados, “quinze” ouvido como “cinquenta” acaba no modelo de um analista. Os erros também se concentram em nomes, números, siglas e jargões, justamente as palavras que um resumo ou um agente mais precisa acertar.
Acertando logo na primeira vez no ElevenAgents
Os agentes de voz sentem isso mais intensamente, porque um único dígito entendido errado pode fazer falhar a verificação que inicia a chamada. A Eneco, que fornece energia para mais de 2 milhões de residências e empresas nos Países Baixos, opera seu agente de voz no ElevenAgents e testou o Scribe v3 Live antes do lançamento. Em chamadas reais de clientes, o agente reconheceu corretamente códigos postais holandeses na primeira tentativa 40% mais vezes e números de casas 15% mais vezes.
“A ElevenLabs é uma verdadeira parceira da Eneco. Junto com seus engenheiros alocados em campo, estamos trabalhando para aprimorar ainda mais nosso agente de voz”, disse Ruud Huigsloot, Gerente Sênior de Produto da Eneco. “É ótimo ver resultados significativos tão cedo, e estamos animados para continuar colaborando.”
Desenvolvido para empresas
O Scribe v3 e o Scribe v3 Live são executados nos EUA por padrão e oferecidos em ambientes isolados na UE, Índia e Singapura para clientes empresariais com requisitos de residência de dados. O Modo de Retenção Zero exclui o áudio e o texto assim que uma solicitação é concluída. Ambos os modelos são cobertos pelos nossos programas SOC 2, ISO 27001 e PCI DSS Nível 1, são elegíveis para HIPAA com um Acordo de Associado Comercial e estão disponíveis para implantação privada.
Comece hoje
O Scribe v3 Live está disponível no ElevenAgents, e tanto o v3 quanto o v3 Live são o padrão no app da ElevenLabs. Cadastre-se para experimentar.
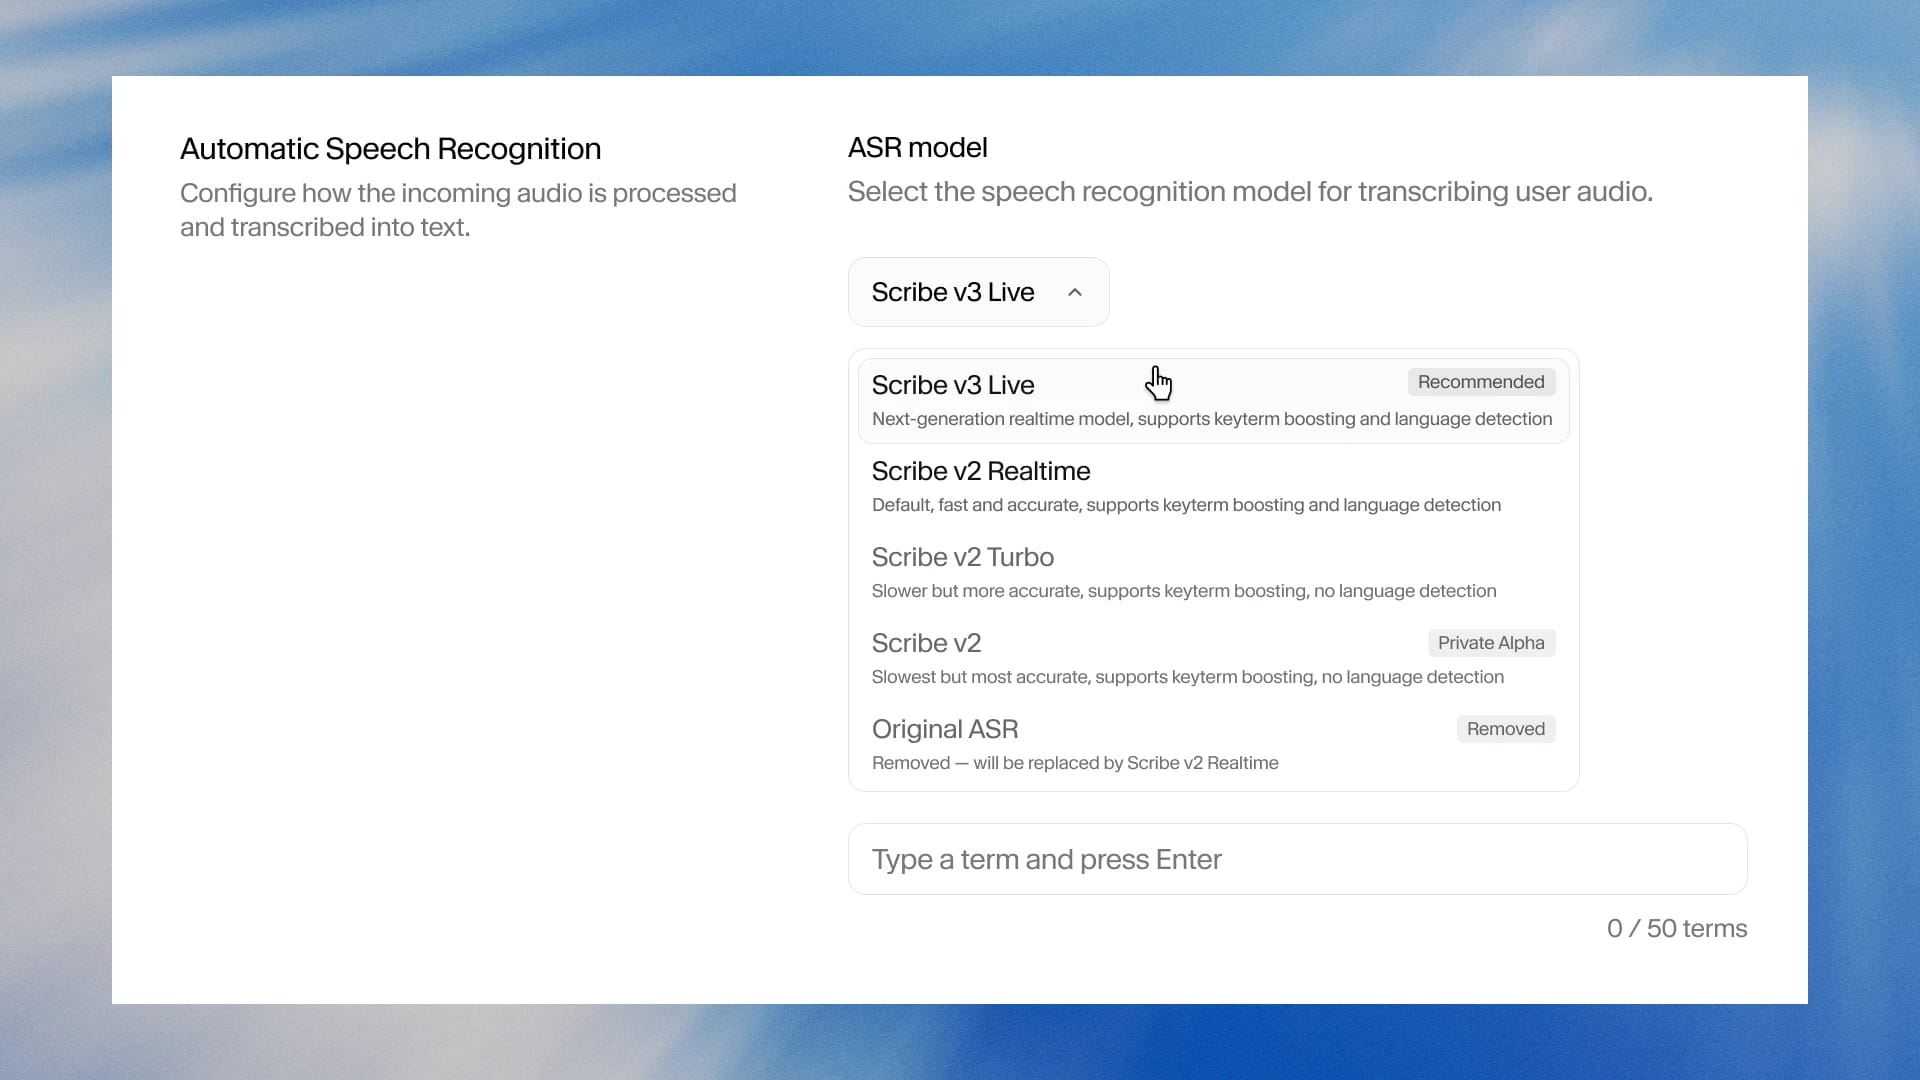
Ambos os modelos também estão disponíveis hoje na ElevenAPI. As integrações existentes são atualizadas ao alterar o ID do modelo para scribe_v3 ou scribe_v3_live.
Para equipes de saúde, também estamos lançando uma versão do Scribe v3 Live otimizada para conversas médicas no ElevenAgents.
Min faz parte da equipe de Growth da ElevenLabs, responsável pela ElevenAPI e pelas soluções On-Prem/On-Device. Antes, liderou o marketing de produto na Stainless como a segunda contratação de GTM e, anteriormente, foi um dos primeiros PMMs da WorkOS, onde impulsionou lançamentos, capacitação, conteúdo e crescimento.