다국어 전사란 무엇이며, 어떻게 작동하나요?
- 게시일
- 최종 업데이트
국제 콘퍼런스를 주최하든, 어떤 언어로든 고객 지원 대화의 정확한 기록이 필요하든, 다국어 트랜스크립션은 그 어느 때보다 중요해졌습니다.
다국어 트랜스크립션 도구는 오디오 데이터를 정확하고 검색 가능한 텍스트로 변환하여 대화를 활용 가능한 기록으로 바꿉니다. 여러 언어에 걸친 트랜스크립션 기술은 음성 텍스트 변환(STT) 모델 연구의 발전과 함께 성숙해 왔습니다. 이제 개발자는 복잡한 다국어 트랜스크립션 파이프라인을 위해 강력한 STT API를 workflow에 통합할 수 있습니다.
이 글에서는 다국어 트랜스크립션의 개념을 살펴보고, 데스크톱 앱과 API를 통한 작동 방식을 간단히 알아보며, 전 세계 기업에 왜 필수적인지 설명합니다.
요약
- 다국어 트랜스크립션은 오디오 파일을 여러 언어의 텍스트로 변환합니다.
- 최고의 다국어 트랜스크립션 도구는 화자 분리, 키텀 프롬프팅, 엔터티 감지와 같은 추가 기능을 제공합니다.
- 다국어 트랜스크립션 도구를 온라인에서 사용하거나 음성 텍스트 변환 API 통합을 통해 개발 workflow에 활용할 수 있습니다.
- 자동 트랜스크립션은 속도와 규모를 처리하며, 여러 화자가 겹쳐 말하는 복잡한 경우에는 사람에 의한 트랜스크립션이 유용할 수 있습니다.
- 다국어 트랜스크립션의 정확도는 언어별로 달라지는 단어 오류율(WER)로 측정합니다.
다국어 트랜스크립션이란 무엇이며 왜 중요한가요?
다국어 트랜스크립션은 음성 오디오를 두 가지 이상의 언어로 된 텍스트로 변환합니다. AI 시스템은 사용 중인 언어를 자동으로 감지하고 오디오를 트랜스크립션합니다. 다국어 STT의 결과물은 원문 그대로의 전사문일 수도 있고, 입력 언어를 공통 출력 언어로 통합하는 번역 레이어를 포함할 수도 있습니다.
예를 들어 글로벌 콘퍼런스에서는 발표자가 모국어로 질문을 받을 수 있습니다. 다국어 음성 텍스트 변환 도구는 각 발표자의 말을 해당 언어로 직접 전사하거나, 청중이 읽을 수 있도록 대상 언어로 하나의 결과물을 만들 수 있습니다. 조직은 이러한 STT 도구를 사용해 행사 접근성을 높일 수 있습니다.
ElevenLabs는 다국어 STT 기능을 텍스트 음성 변환 Scribe v2 모델에 직접 구축했습니다. Scribe v2는 자동 언어 감지를 지원하므로 하나의 파일에 여러 언어가 포함될 수 있습니다. 오디오 클립에 포함된 언어를 지정하거나 설정을 “감지”로 두면 시스템이 업로드된 파일에 있는 언어를 식별합니다.
ElevenAPI 사용 시 language_code 파라미터는 기본적으로 자동 예측으로 설정됩니다. 포함된 언어를 이미 알고 있다면 미리 제공하여 성능을 높일 수 있습니다.
다국어 트랜스크립션이 중요한 이유
최근 연구에 따르면 전 세계 트랜스크립션 서비스 시장은 2035년까지 60억 달러에 이를 것으로 예상됩니다. 성장세를 가속하는 요인 중 하나는 다국어 STT를 활용하는 폭넓은 사용 사례입니다.
다국어 트랜스크립션이 중요한 실질적인 이유는 다음과 같습니다.
- 접근성: 자막과 캡션은 번역이나 더빙을 시작하기 전에 정확한 다국어 트랜스크립션이 필요합니다. 다국어 STT는 사용자 접근성을 크게 높일 수 있습니다.
- 검색 가능성: 트랜스크립션된 오디오는 색인 가능한 텍스트가 되어 지원 통화나 회의를 다른 사람에게 유용한 리소스로 만들 수 있습니다. AI 시스템이 내부 문서에서 더 많은 데이터를 찾아내기 시작하면서 검색 가능성은 특히 중요해지고 있으며, 명확한 트랜스크립션은 포괄적인 입력 참조 자료를 구축하는 데 도움이 됩니다.
- 규정 준수: 많은 규제 산업에서는 음성 상호작용에 대한 감사 가능한 서면 기록이 필요합니다. 다국어 STT를 사용하면 고객이 사용하는 모든 언어에서 이를 지원할 수 있습니다. 예를 들어 금융감독청은 금융기관이 전화 대화의 녹음과 전사문을 보관해야 한다고 명시합니다.
- 글로벌 콘텐츠 파이프라인: 더빙이든 자막 제작이든, workflow는 항상 작업의 기반이 될 매우 정확한 초기 전사문으로 시작합니다. 고품질 다국어 트랜스크립션 도구는 더 광범위한 글로벌 콘텐츠 배포 workflow의 첫 단계를 가능하게 합니다.
다국어 트랜스크립션은 다양한 산업에서 필수적입니다. 통신사는 지원 통화를 전사하고, 금융 서비스 기업은 규정 준수 요건을 충족하며, 의료팀은 환자 상호작용을 기록하고, 영화 스튜디오는 콘텐츠를 현지화합니다. SaaS, 여행, 공공 서비스 등 어느 분야에서든 강력한 시스템을 갖추면 결과 전사문의 품질과 정확성을 일관되게 유지할 수 있습니다.
다국어 트랜스크립션 솔루션에서 살펴볼 핵심 기능
다국어 트랜스크립션 도구는 처리하는 오디오 입력에 맞춰 적응하고, 언어를 동적으로 식별하여 높은 정확도로 전사할 수 있어야 합니다.
고품질 다국어 트랜스크립션 솔루션에서 살펴봐야 할 주요 기능은 다음과 같습니다.
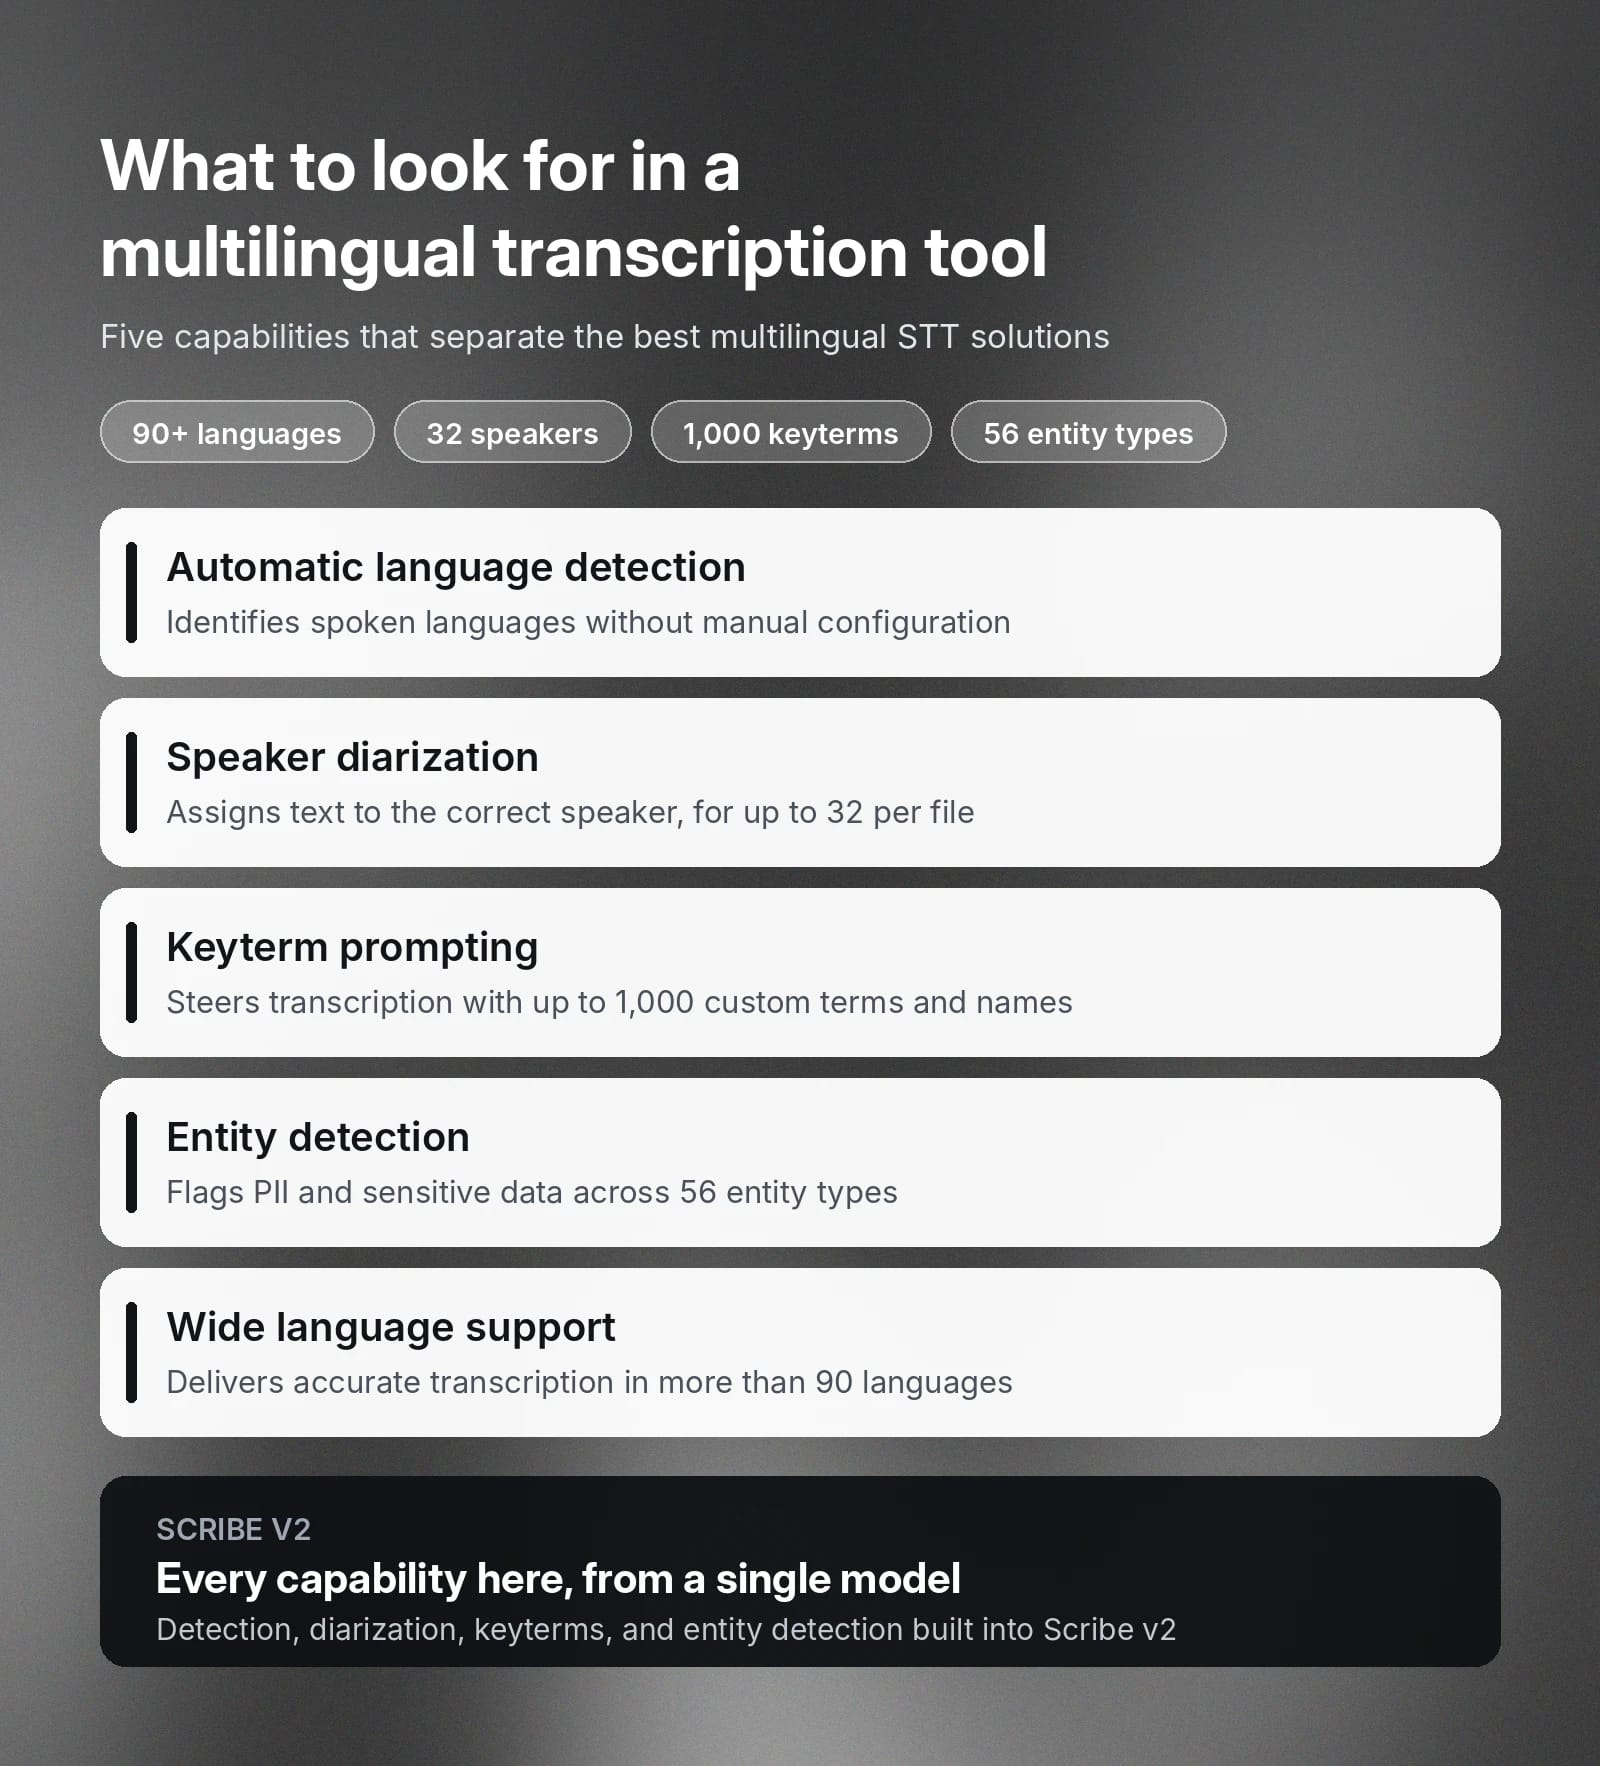
- 자동 언어 감지: 시스템은 사용자가 원본 언어를 입력할 때까지 트랜스크립션을 막는 대신, 음성 언어를 스스로 식별해야 합니다. 입력 언어를 알 수 없거나 하나의 클립에 여러 언어가 포함된 상황에서 자동 언어 감지를 사용하면 수동 설정 없이 여러 언어를 관리할 수 있습니다.
- 화자 분리: 화자 분리는 파일 속 전사 텍스트를 올바른 화자에게 할당하는 기능으로, 여러 화자가 포함된 모든 오디오 트랜스크립션에서 중요합니다. 예를 들어 패널에 여러 사람이 있어 구분해야 할 수 있고, 고객과 지원 담당자가 말하는 시점을 명확히 구분해야 할 수도 있습니다. Scribe v2는 단일 파일에서 최대 32명의 화자를 분리할 수 있습니다.
- 키텀 프롬프팅: 키텀을 사용하면 제품명이나 고유명사처럼 정확한 전사를 위해 필요한 특정 어휘를 사용자가 직접 입력할 수 있습니다. 배치 시스템에서 Scribe v2는 최대 키텀 1,000개를 지원하며, 실시간 트랜스크립션용 Scribe v2 Realtime은 최대 50개를 지원합니다.
- 엔터티 감지: 엔터티 감지는 전사문에서 특정 단어를 식별하며, 민감한 데이터를 보호하기 위한 규정 준수 및 보안 작업에 필수적입니다. 지원되는 56가지 엔터티 유형의 전체 분석은 ElevenLabs 엔터티 감지 문서에서 확인하세요.
- 광범위한 언어 지원: 당연히 최고의 다국어 STT 솔루션은 매우 폭넓은 언어의 트랜스크립션을 지원합니다. Scribe v2는 90개 이상의 언어에서 정확한 트랜스크립션을 제공합니다.
이러한 기능을 함께 활용하면 폭넓은 사용 사례를 지원하고, 여러 언어를 정확하게 처리하는 신뢰할 수 있는 STT 시스템을 사용할 수 있습니다.
여러 언어의 오디오를 효율적으로 트랜스크립션하는 방법
서로 다른 언어의 오디오를 가장 효과적으로 트랜스크립션하는 방법은 작업량에 따라 달라집니다. 일회성 배치 파일의 경우 ElevenLabs 텍스트 음성 변환 페이지에서 파일을 업로드하고 빠르게 전사문을 받을 수 있습니다.
ElevenCreative에서 오디오 트랜스크립션은 다음처럼 간단합니다.
- 오디오 업로드: 텍스트 음성 변환으로 이동해 “파일 전사”를 클릭합니다.
- 옵션 선택: 기본 언어를 선택하거나 “감지”로 두고, 웃음이나 기타 비음성 이벤트에 태그를 지정하려면 오디오 이벤트를 켜고, 필요하다면 키텀을 추가합니다.
- 결과 확인: 파일을 업로드하면 오디오 파일명을 클릭하여 전사문을 볼 수 있습니다. 여기에서 트랜스크립트 에디터에서 전사문을 직접 검토하고 다듬은 후, 이후 각 workflow에 필요한 형식으로 내보낼 수 있습니다.
프로그래밍 방식 또는 대용량 트랜스크립션에는 텍스트 음성 변환 API를 사용하세요. 프로덕션 파이프라인을 구성하는 데 활용할 수 있는 몇 가지 세부 사항은 다음과 같습니다.
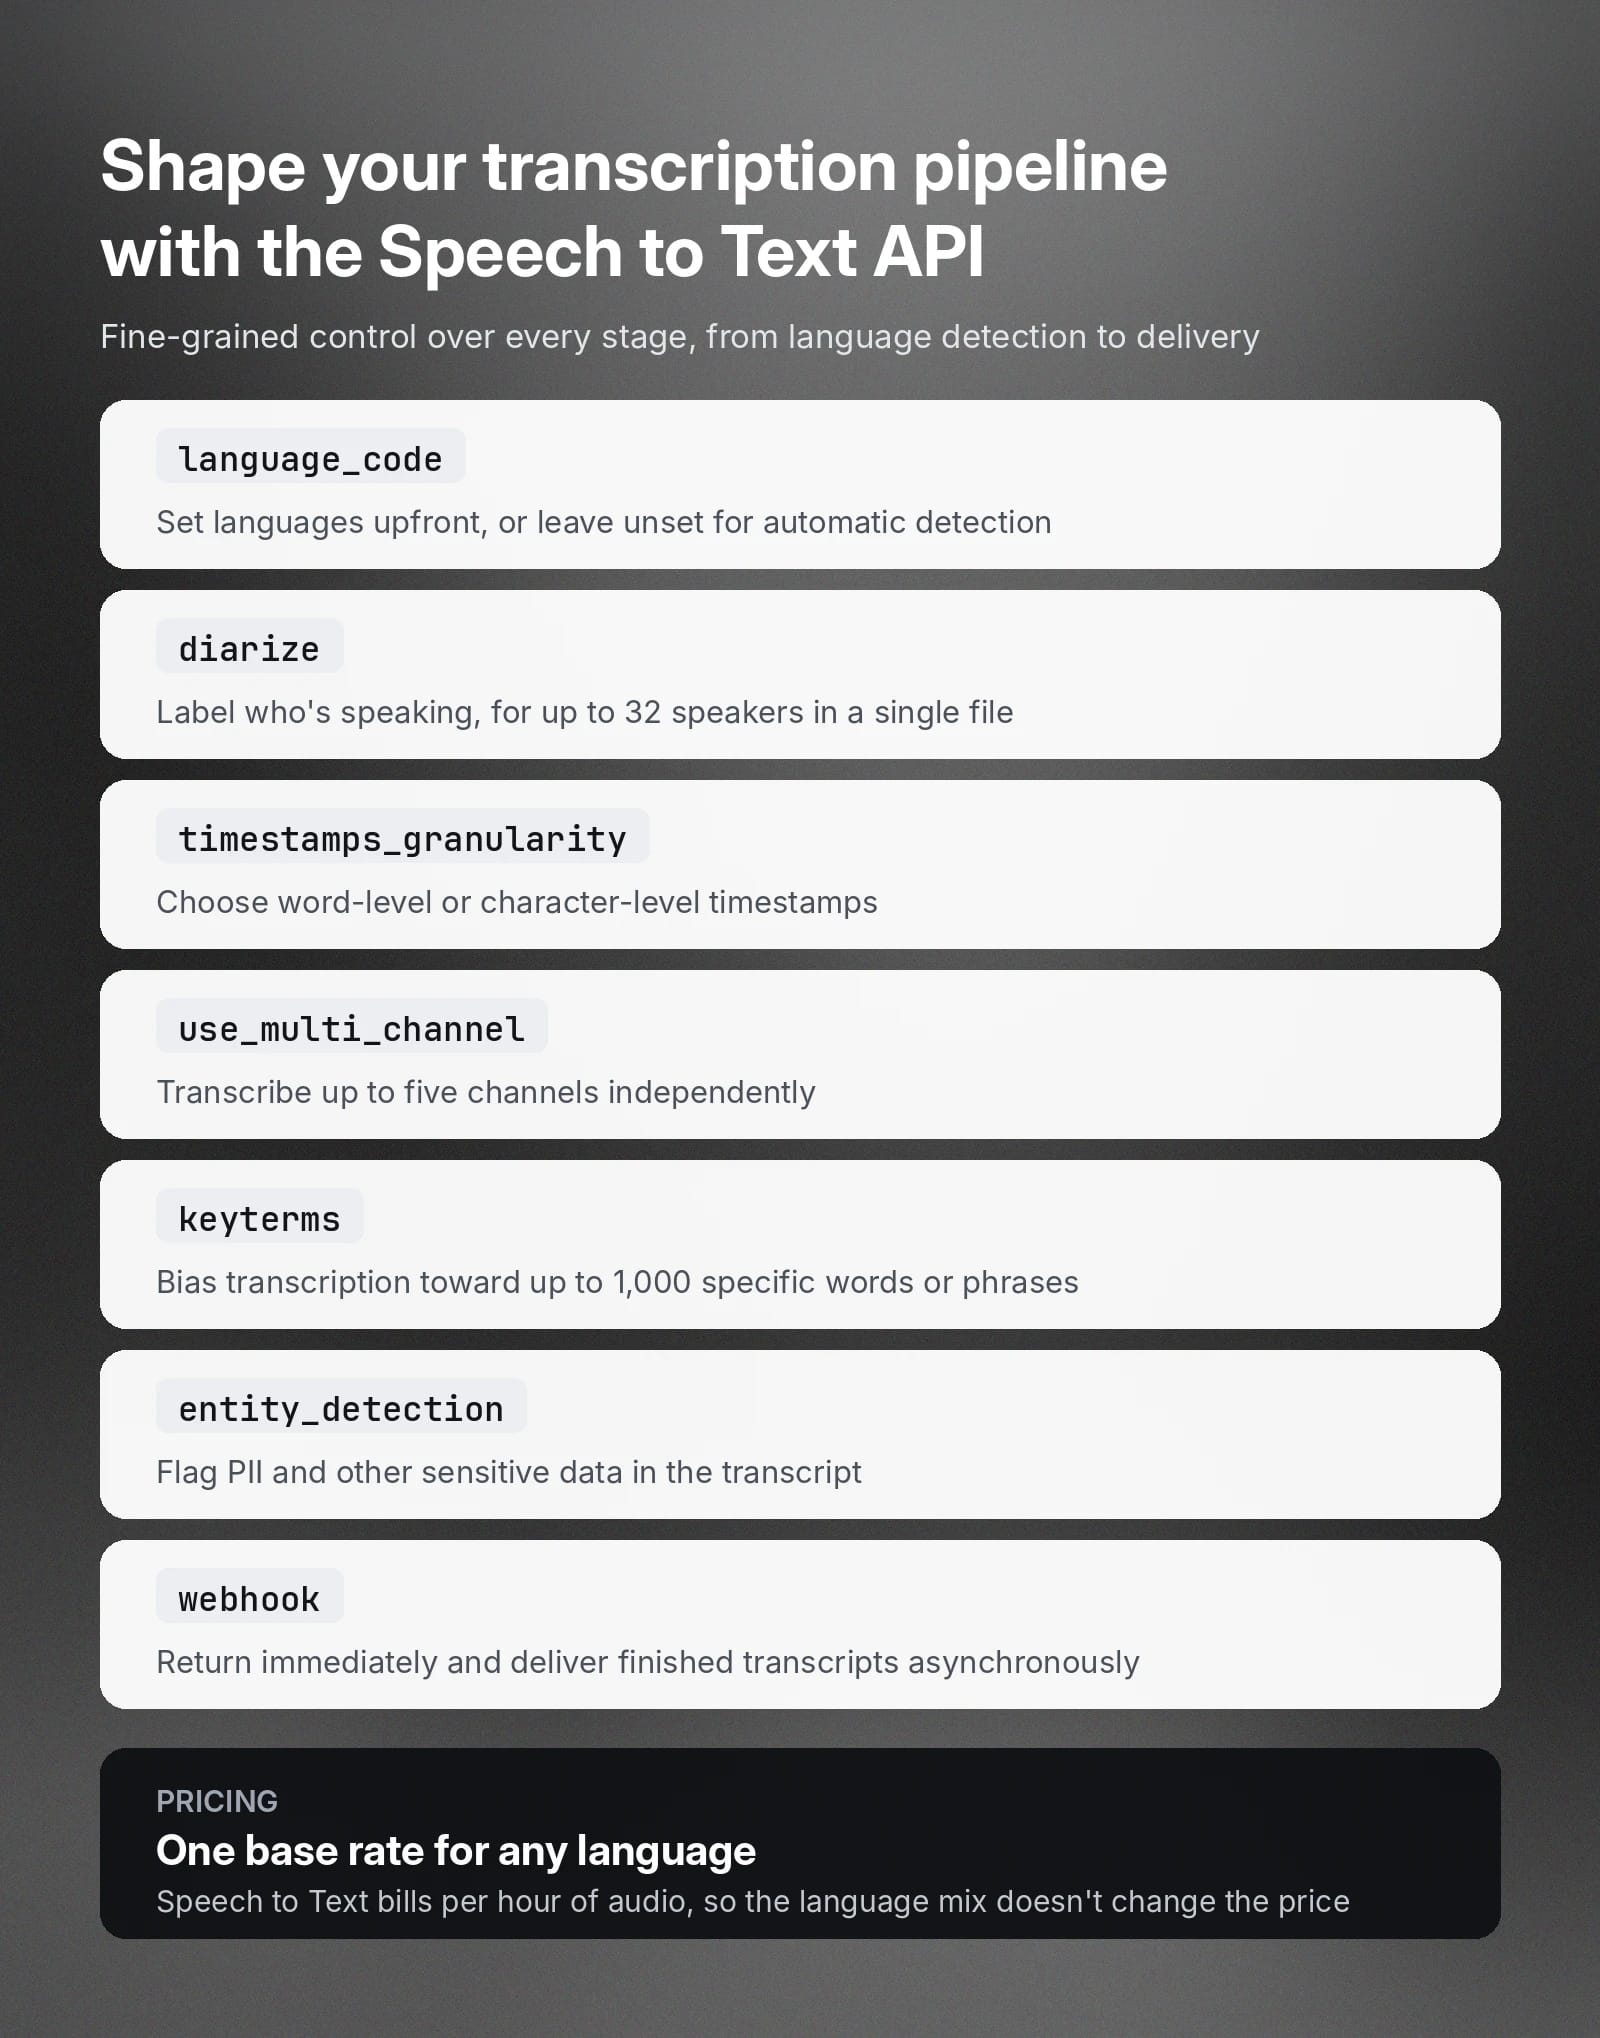
- 모델 선택: model_id 파라미터는 scribe_v2와 scribe_v1 중에서 선택하므로, 시간이 지나 변경될 수 있는 기본값에 의존하지 않고 파이프라인에서 특정 모델을 지정할 수 있습니다.
- 언어 처리: language_code 파라미터는 ISO-639-1 또는 ISO-639-3 코드를 허용하며, 설정하지 않으면 기본적으로 자동 감지를 사용합니다. 언어를 직접 지정하면 성능이 향상될 수 있습니다.
- 화자 분리 제어: diarize를 true로 설정하면 현재 말하는 화자를 표시합니다. num_speakers 파라미터로 화자 수를 1명에서 32명 사이로 제한할 수 있습니다. 더 세밀한 제어를 위해 diarization_threshold 파라미터를 사용해 서로 다른 화자 간의 균형을 조정할 수 있습니다.
- 타임스탬프 정밀도: timestamps_granularity 파라미터는 출력 세부 수준을 제어하며, 단어 수준 또는 문자 수준 타임스탬프(또는 없음) 옵션을 제공합니다.
- 대규모 비동기 처리: webhook을 true로 설정하면 즉시 응답을 반환하고, 처리가 완료되면 완성된 전사문을 설정된 webhook으로 전달합니다. webhook_metadata 필드는 내부 작업 ID 등의 맞춤 추적 데이터를 각 webhook 응답에 연결합니다.
- 멀티채널 오디오: use_multi_channel을 true로 설정하면 최대 5개 채널을 각각 독립적으로 전사하고, 모든 단어에 channel_index 필드를 태그합니다.
- 특수 콘텐츠 처리: keyterms 파라미터는 최대 1,000개의 특정 단어나 구문에 맞춰 트랜스크립션을 유도하고, entity_detection은 PII 및 기타 민감한 데이터를 표시하며, no_verbatim은 출력에서 군더더기 말과 잘못 시작한 발화를 제거합니다.
이러한 파라미터를 함께 사용하면 파이프라인의 모든 단계를 세밀하게 제어할 수 있습니다. 언어 감지와 화자 라벨링부터 출력 형식과 전달까지, 텍스트 음성 변환 API는 프로덕션 요구 사항에 맞춰 적용됩니다.
트랜스크립션 서비스의 지원 언어 알아보기
언어 지원 범위는 최고의 다국어 트랜스크립션 도구를 구분하는 주요 요소입니다. ElevenLabs Scribe v2와 Scribe v2 Realtime은 모두 90개 이상의 언어를 지원하며, 텍스트 음성 변환 문서에서 지원 언어 전체 목록을 확인할 수 있습니다.
영어, 스페인어, 이탈리아어, 폴란드어, 프랑스어, 독일어 등은 학습 데이터가 더 많아 일반적으로 정확도가 더 높은 STT를 제공합니다. 암하라어, 간다어, 요루바어, 줄루어 같은 일부 언어는 위 언어들보다 정확도가 낮습니다.
ElevenLabs Scribe 모델은 36개 언어에서 5% 미만의 단어 오류율을 기록하며, 그 외 21개 언어에서 10% 미만의 WER을 기록합니다. 지원 언어 및 각 언어의 WER에 대한 자세한 내용은 ElevenLabs 언어 지원 세부 정보를 참조하세요.
다국어 트랜스크립션 비용은 얼마인가요?
일반적으로 자동 트랜스크립션 요금은 단어 수나 포함된 언어 수가 아니라 오디오 파일의 길이를 기준으로 책정됩니다. ElevenLabs는 오디오 길이를 기준으로 텍스트 음성 변환 요금을 부과하며, 오디오 시간당 청구합니다. 구체적인 요금은 요금제와 모델에 따라 다릅니다.
다국어 트랜스크립션 요금에 영향을 주는 주요 요소는 다음과 같습니다.
- 추가 트랜스크립션 기능: 일부 제공업체는 엔터티 감지 같은 특정 기능을 활성화할 때 추가 요금을 부과합니다.
- 멀티채널 오디오는 채널별로 청구: use_multi_channel을 활성화하면 각 채널이 별도로 청구되므로, 2채널 녹음은 단일 채널 녹음보다 비용이 약 두 배입니다.
- 언어는 기본 요금에 영향을 주지 않음: 길이 기반 요금제에서는 다국어 STT가 어떤 언어든 동일한 시간당 요금으로 지원하므로, 여러 언어를 다루는 팀의 예산 수립이 간편해집니다.
ElevenLabs 텍스트 음성 변환 비용에 관한 자세한 내용은 요금 페이지를 참조하세요.
정확한 다국어 트랜스크립션을 위한 ElevenAPI 시작하기
ElevenAPI는 몇 단계만으로 모든 프로덕션 workflow에 다국어 트랜스크립션을 도입합니다. 글로벌 미디어 아카이브용 콘텐츠, 고객 지원 상호작용, 회의 또는 연구 인터뷰를 전사하거나, 수십 개 언어에서 정확한 음성 인식을 찾고 있다면 강력한 다국어 STT 엔진이 도움이 됩니다.
ElevenAPI 텍스트 음성 변환 API의 모든 기능을 살펴보거나, ElevenLabs 계정 만들기를 통해 지금 다국어 오디오 트랜스크립션을 시작하세요.
다국어 트랜스크립션 FAQ

Jack Limebear는 Growth 팀에서 블로그와 인사이트 페이지의 콘텐츠 작가이자 전략가로 활동하고 있습니다. ElevenLabs에 합류하기 전에는 빠르게 성장하는 SaaS 스타트업부터 포춘 500대 기업까지 다양한 조직에서 10년 넘게 콘텐츠 전략을 이끌었습니다. 케임브리지 대학교에서 영문학 석사 학위를 취득했습니다.