애플리케이션에 텍스트 음성 변환을 통합하는 방법
- 게시일
텍스트 음성 변환을 애플리케이션에 통합하려면 API 키를 만들고 ElevenLabs SDK를 설치한 다음, 음성과 모델을 지정해 TTS 엔드포인트로 텍스트를 전송하고 반환된 오디오를 재생하세요.
이 가이드에서는 Python과 TypeScript로 각 단계를 안내하고, 적합한 TTS 통합 방식을 선택하는 방법과 흔히 발생하는 오류 해결 방법을 소개합니다.
텍스트 음성 변환 API란 무엇인가요?
텍스트 음성 변환 API를 사용하면 개발자가 자체 TTS 모델을 호스팅하지 않고도 작성된 텍스트를 자연스러운 오디오로 프로그래밍 방식으로 변환할 수 있습니다. 애플리케이션에 TTS API를 통합한 후에는 API에 요청을 보내고 오디오를 받아 애플리케이션에 손쉽게 음성 레이어를 추가할 수 있습니다.
ElevenAPI와 같은 우수한 텍스트 음성 변환 API는 최종 오디오의 사운드를 세밀하게 제어할 수 있게 해 줍니다. 텍스트 구간을 읽는 음성 선택부터 전달하는 감정까지 조절할 수 있습니다. 애플리케이션의 사용 사례에 따라 일괄 및 스트리밍 처리 옵션 중에서 선택해 오디오 샘플을 만들 수도 있습니다.
텍스트 음성 변환 API 요청의 작동 방식
TTS API를 호출하면 오디오를 제공하기 위해 백그라운드에서 몇 가지 단계가 진행됩니다.
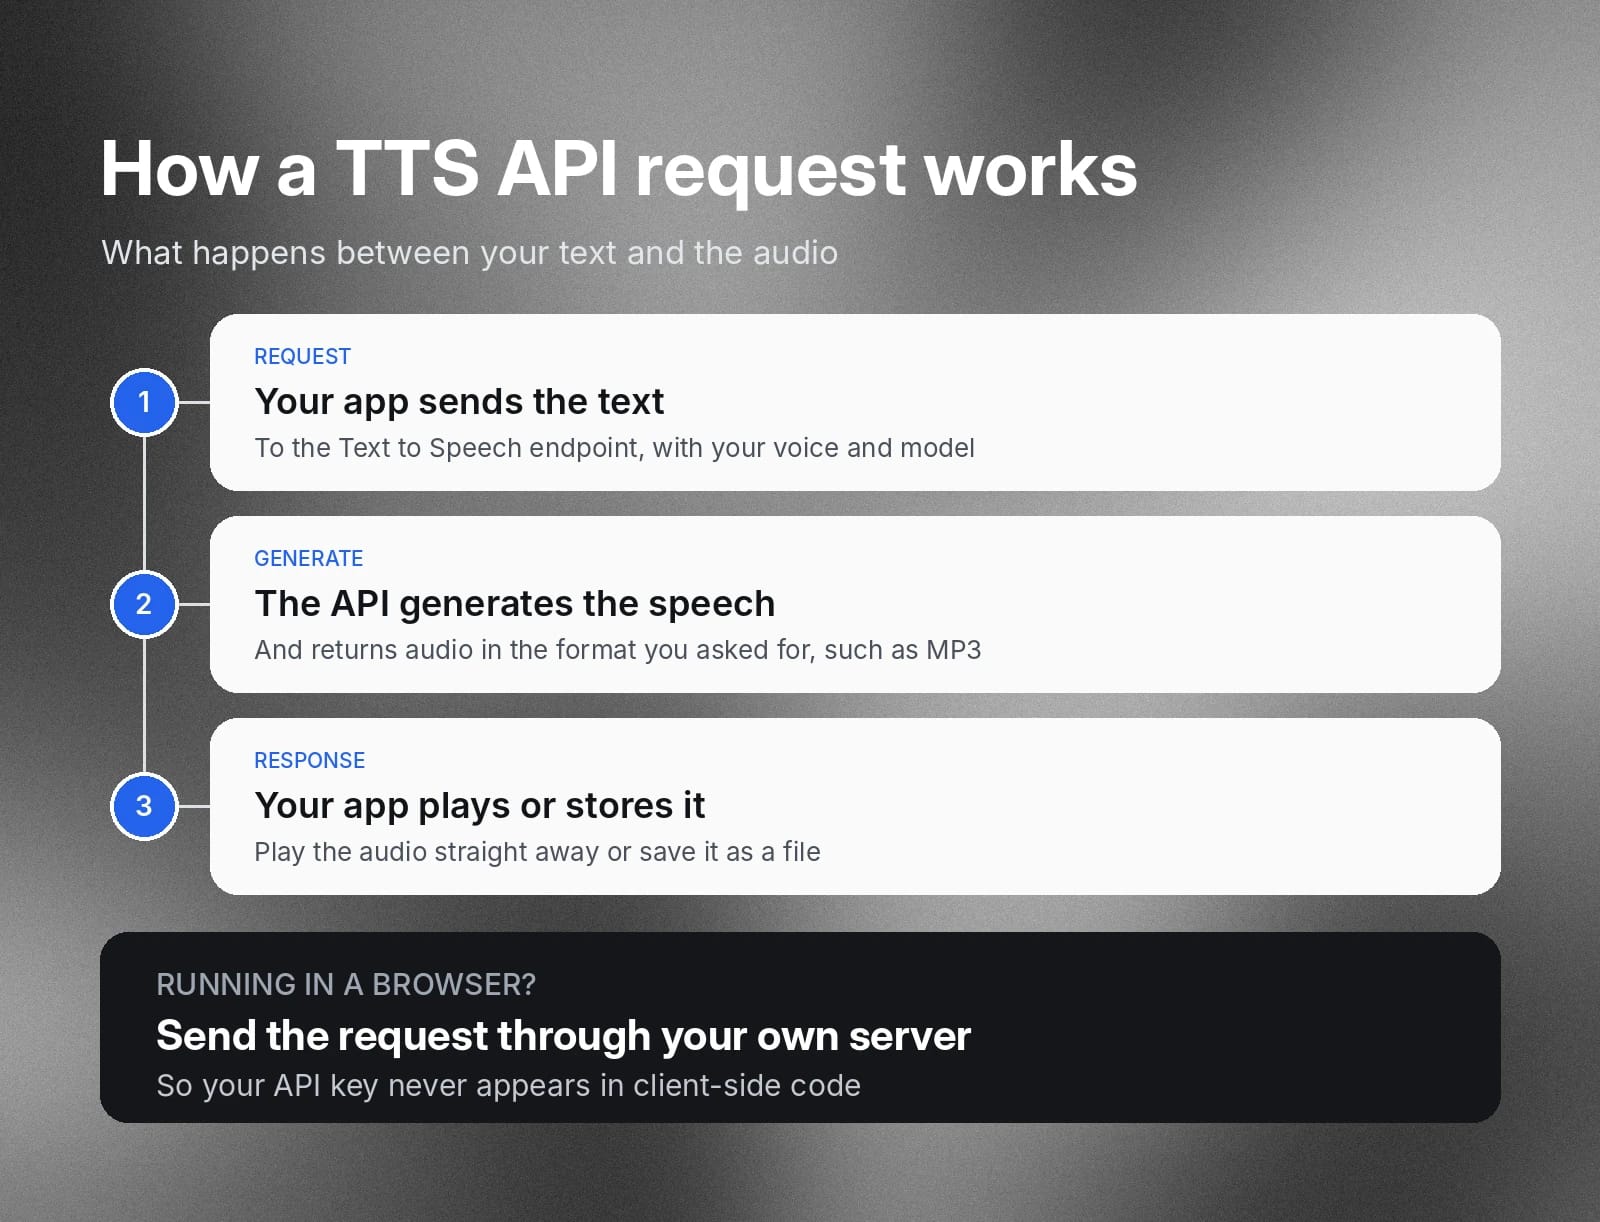
텍스트 음성 변환 API 요청은 다음과 같이 작동합니다.
- 애플리케이션이 선택한 음성 및 모델과 함께 텍스트를 텍스트 음성 변환 엔드포인트로 전송합니다.
- API가 음성을 생성하고 MP3와 같이 요청한 출력 형식으로 오디오를 반환합니다.
- 애플리케이션이 오디오를 재생하거나 파일로 저장합니다.
애플리케이션이 브라우저에서 실행되는 경우에는 API 키가 클라이언트 측 코드에 노출되지 않도록 자체 서버를 통해 요청을 보내야 합니다.
애플리케이션에 TTS를 통합하기 전에 필요한 항목 체크리스트
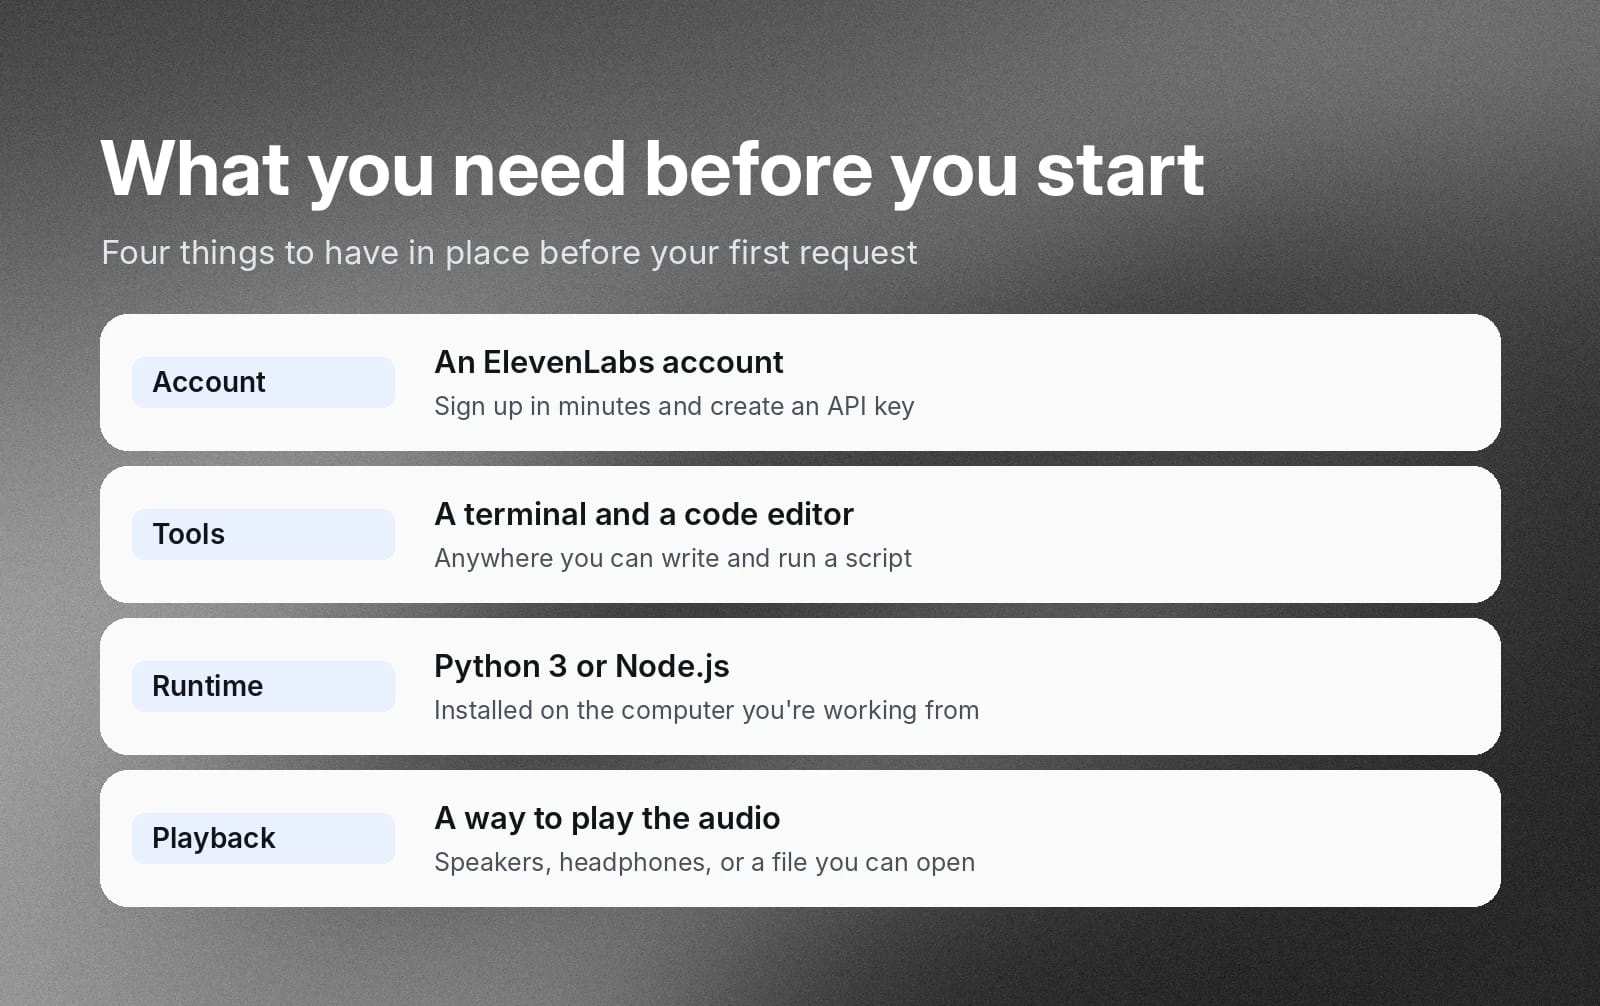
애플리케이션에 텍스트 음성 변환을 통합하기 전에 먼저 다음 항목을 갖추었는지 확인하세요.
- ElevenLabs 계정. 몇 분 안에 가입할 수 있습니다.
- 터미널과 코드 에디터.
- 작업 중인 컴퓨터에 설치된 Python 3 또는 Node.js.
- 수신한 오디오를 재생할 방법.
이 모든 항목을 준비했다면 이제 앱에 TTS를 구축할 준비가 되었습니다.
애플리케이션에 텍스트 음성 변환을 통합하는 방법
ElevenAPI를 사용하면 애플리케이션에 TTS API를 통합하는 데 몇 분밖에 걸리지 않습니다. 이미 계정에 가입했다면 바로 아래 단계를 진행할 수 있습니다. 아직이라면 시작하려면 가입하세요.
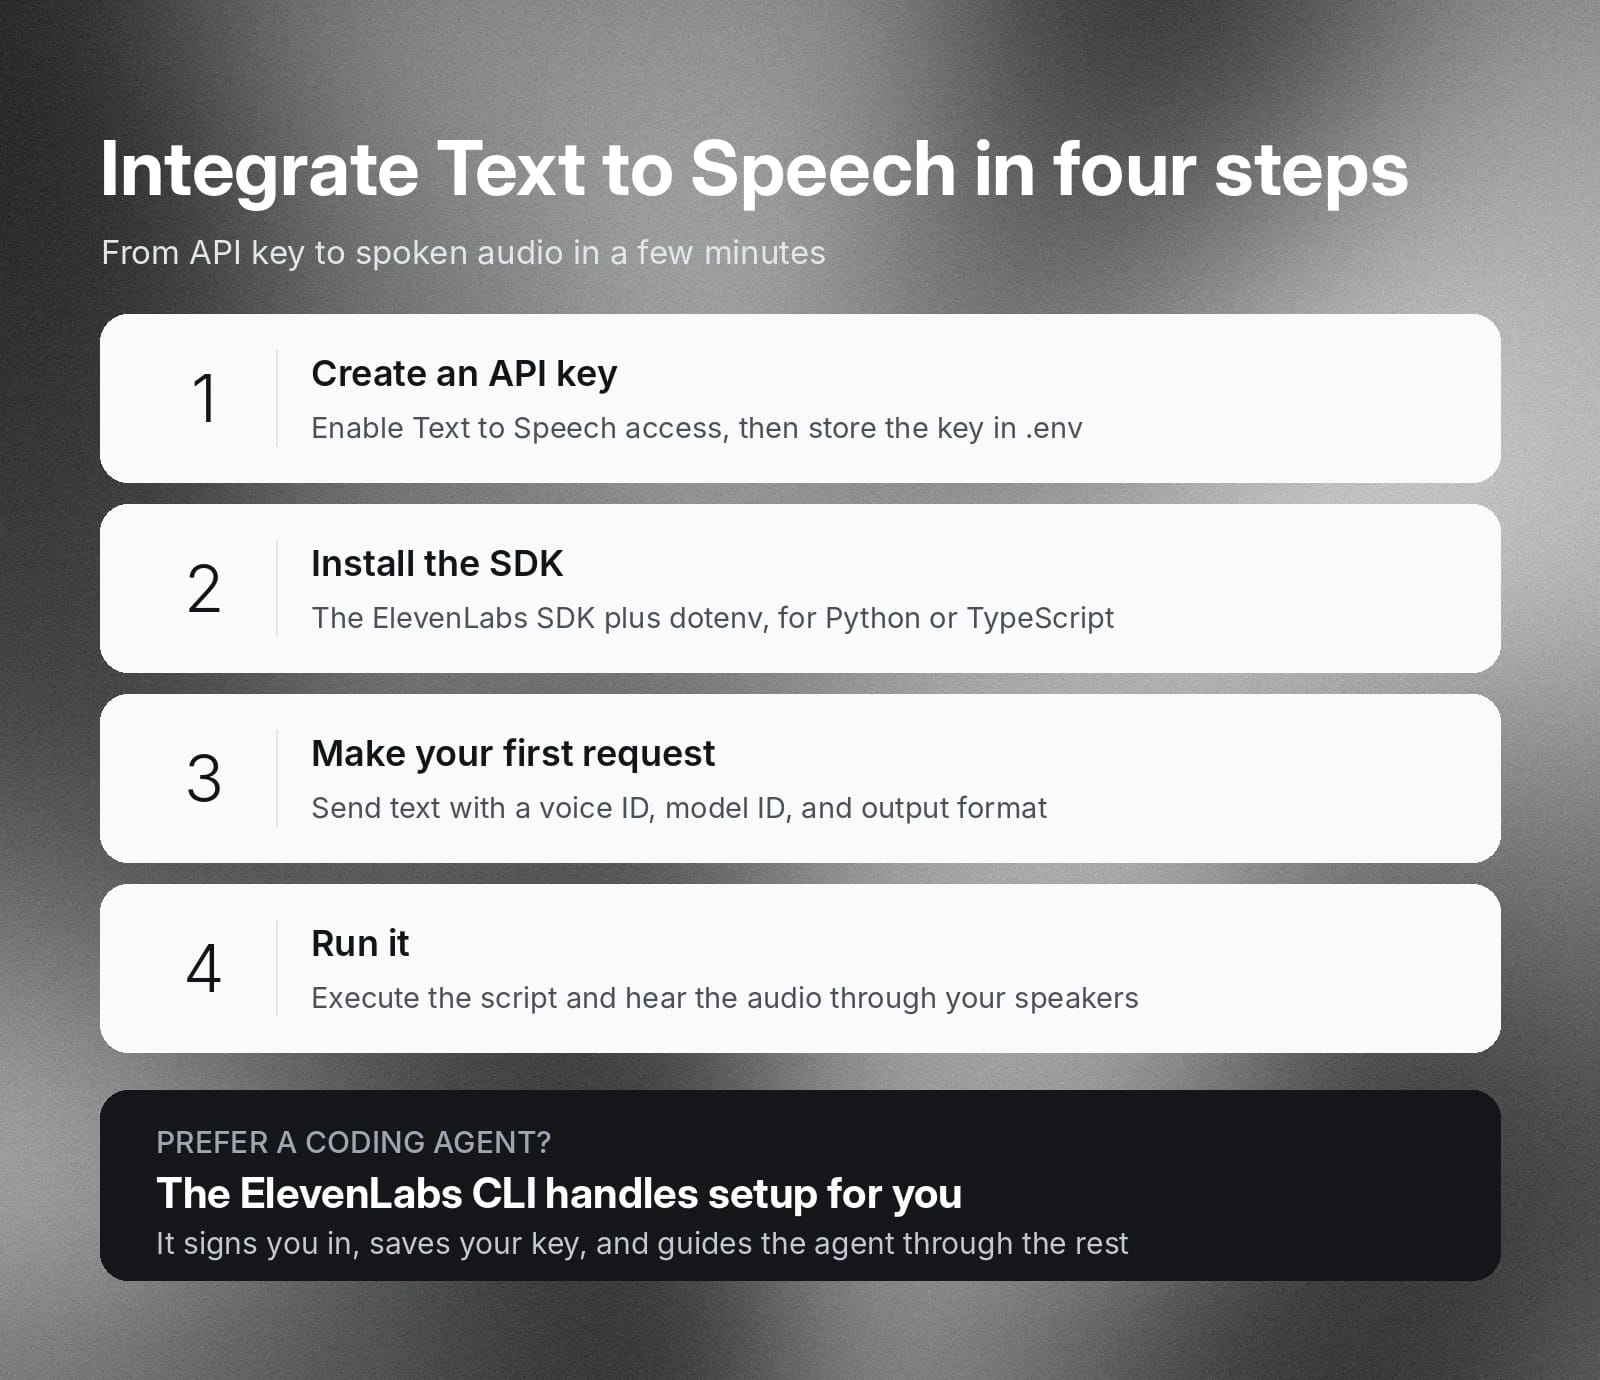
단계는 다음과 같습니다.
- API 키 생성
- SDK 설치
- 첫 요청 보내기
- 실행
각 단계를 자세히 살펴보겠습니다.
API 키 생성
ElevenLabs API 대시보드에서 API 키를 가져오세요. 'Create Key'를 클릭하면 설정할 API 유형을 구성할 수 있습니다. 이 사용 사례에서는 TTS가 'Access'로 활성화되어 있는지 확인하세요.
API 키를 복사해 .env의 환경 변수로 붙여넣으세요(또는 앱 아키텍처에 따라 앱 구성에 직접 추가하세요). .env 파일에 저장하면 키를 비밀로 유지하면서 스크립트가 런타임에 키를 로드할 수 있습니다.
코딩 에이전트가 설정을 처리하도록 하고 싶으신가요? 에이전트에 다음을 붙여넣으세요: npx -y @elevenlabs/cli@latest onboard init. ElevenLabs CLI는 브라우저를 열어 로그인할 수 있게 하고, 프로젝트의 env 파일에 키를 저장하며, 에이전트가 남은 단계를 진행하도록 안내합니다. npx를 사용하려면 Node.js가 필요합니다. 자세한 내용은 퀵스타트를 참조하세요.
SDK 설치
텍스트 음성 변환 API를 설정할 때 설치해야 하는 주요 패키지는 2개입니다. 첫 번째는 API 호출을 처리하는 ElevenLabs SDK입니다. 두 번째는 1단계에서 구성한 .env 파일에서 API 키를 로드하는 dotenv입니다.
CLI에서 작업 중이라면 TTS API 문서에서 더 구체적인 안내와 사용할 수 있는 옵션을 확인하세요.
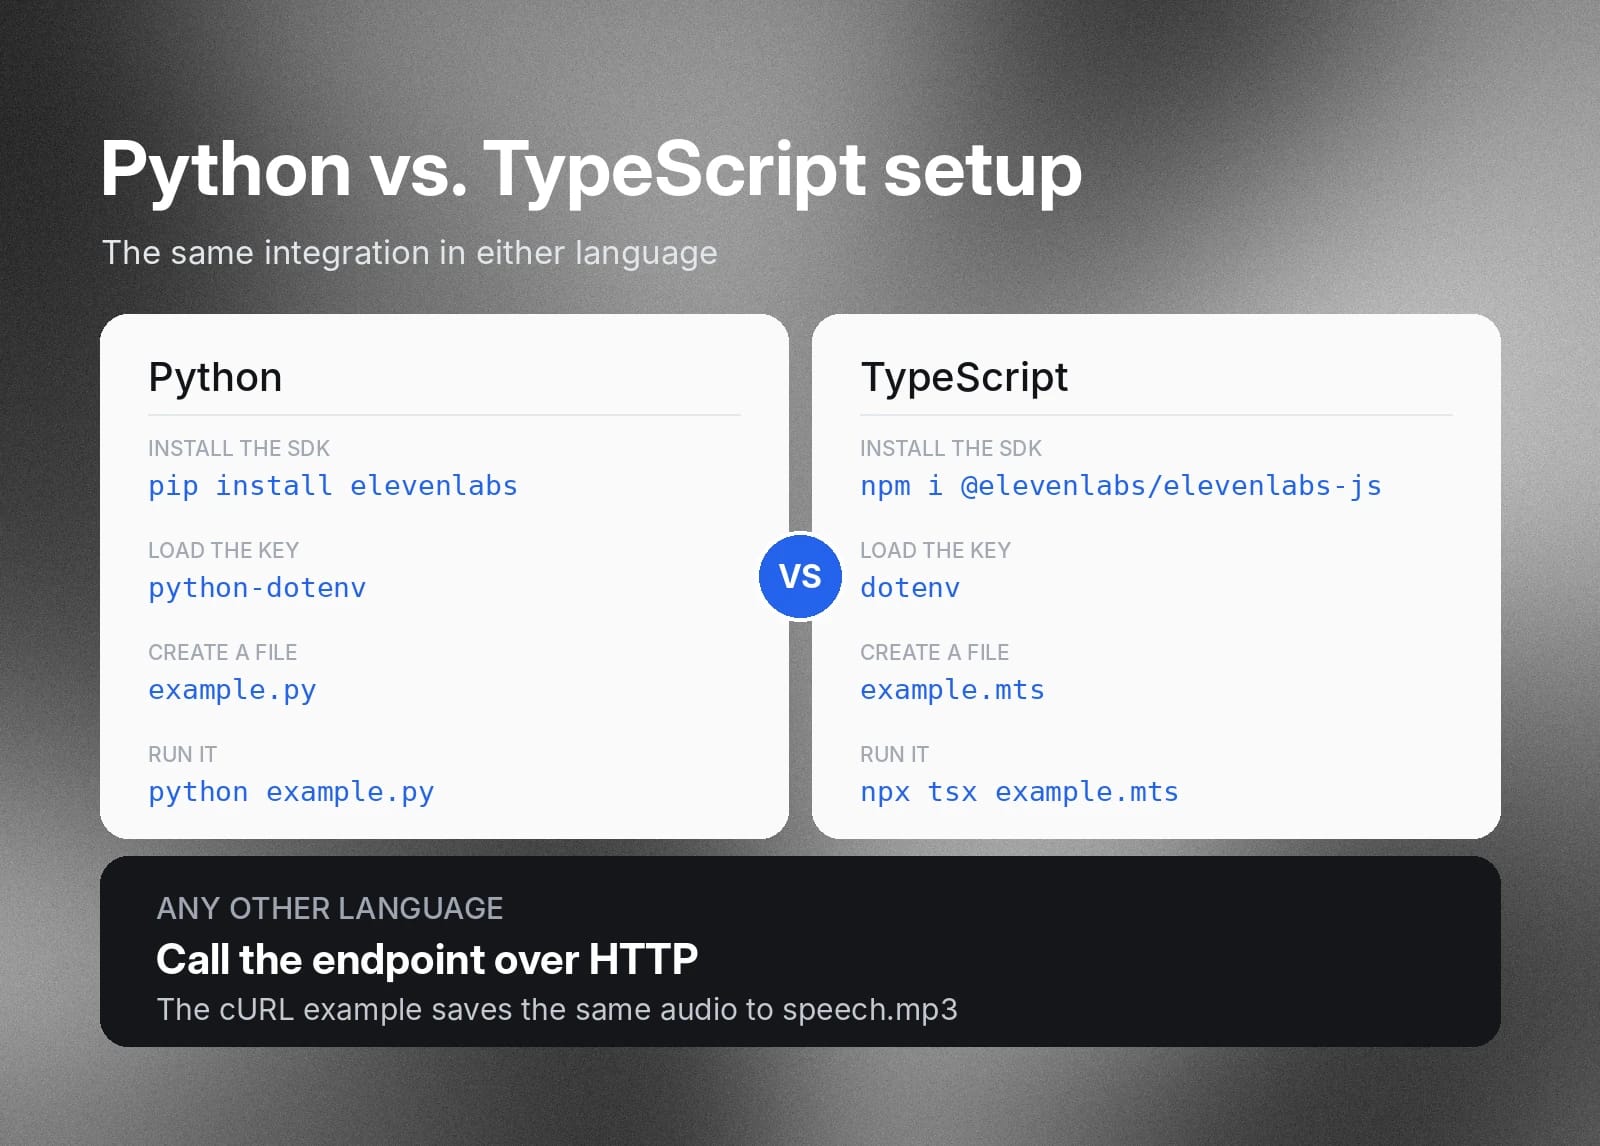
TTS API용 SDK와 dotenv를 Python 및 TypeScript에서 설치하는 방법은 다음과 같습니다.
Python
TypeScript
첫 요청 보내기
다음으로 클라이언트를 만드세요. 클라이언트는 ElevenAPI를 감싸는 객체입니다. 사용하는 프로그래밍 언어에 따라 .py 또는 .mts 파일을 만드세요.
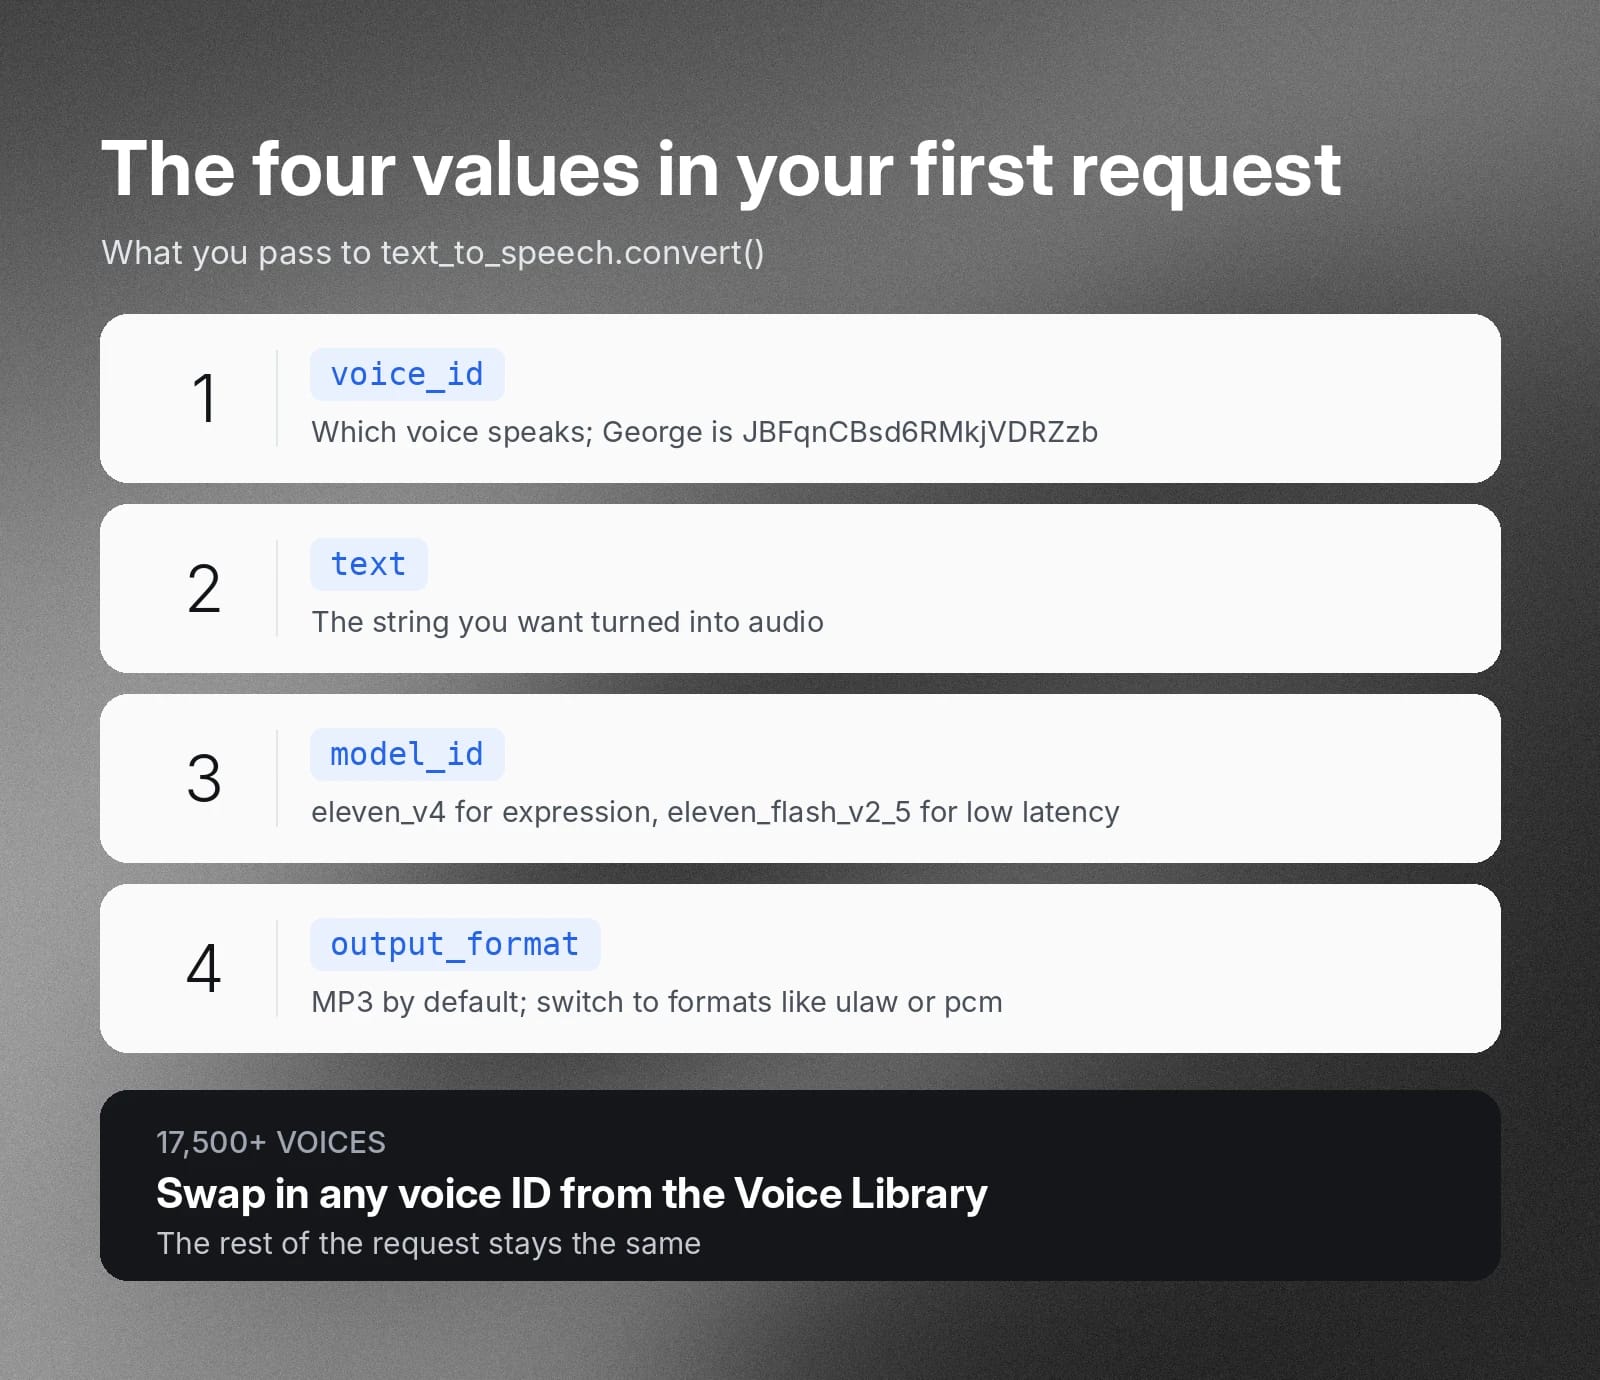
출력에 영향을 주는 주요 값은 4가지입니다.
- 음성 ID: ElevenLabs는 보이스 라이브러리에서 선택할 수 있는 17,500개 이상의 음성을 제공합니다. 애플리케이션을 가장 잘 나타내거나 사용 사례에 맞는 음성을 선택하세요. 아래 퀵스타트 코드 블록에서는 음성 ID가 “JBFqnCBsd6RMkjVDRZzb”인 “George”를 사용합니다.
- 텍스트: ElevenAPI TTS 모델이 오디오 파일로 변환할 텍스트 문자열입니다.
- 모델 ID: 오디오 생성에 선택하는 특정 모델입니다. 아래 예시에서는 eleven_v4를 사용했지만, 사용 사례에 더 적합하다면 텍스트 음성 변환 모델 중에서 선택할 수도 있습니다. 예를 들어 낮은 지연 시간을 위해 Eleven Flash v2.5(모델 ID 필드의 eleven_flash_v2_5)를 선택할 수 있습니다.
- 출력 형식: TTS API에서 반환받을 오디오 인코딩을 지정하세요. 기본값은 mp3이지만 ulaw나 pcm과 같은 형식으로 변경할 수 있습니다.
다음은 Python과 TypeScript에서 TTS API 파일을 작성한 모습입니다. 아래 두 예시는 모두 eleven_v4 모델을 사용합니다.
Python
TypeScript
cURL
HTTP 요청을 보낼 수 있는 모든 언어에서 엔드포인트를 호출할 수도 있습니다. 다음 cURL 예시는 같은 텍스트를 전송하고 오디오를 파일로 저장합니다.
실행
이제 TTS API 파일을 실행할 준비가 되었습니다. Python 또는 TypeScript 중 사용하는 언어에 따라 다음 명령 중 하나를 실행하세요.
Python
TypeScript
스피커를 통해 오디오가 재생되는 것을 들을 수 있습니다. cURL 예시에서는 대신 speech.mp3를 여세요.
일반적인 TTS 통합 오류 문제 해결
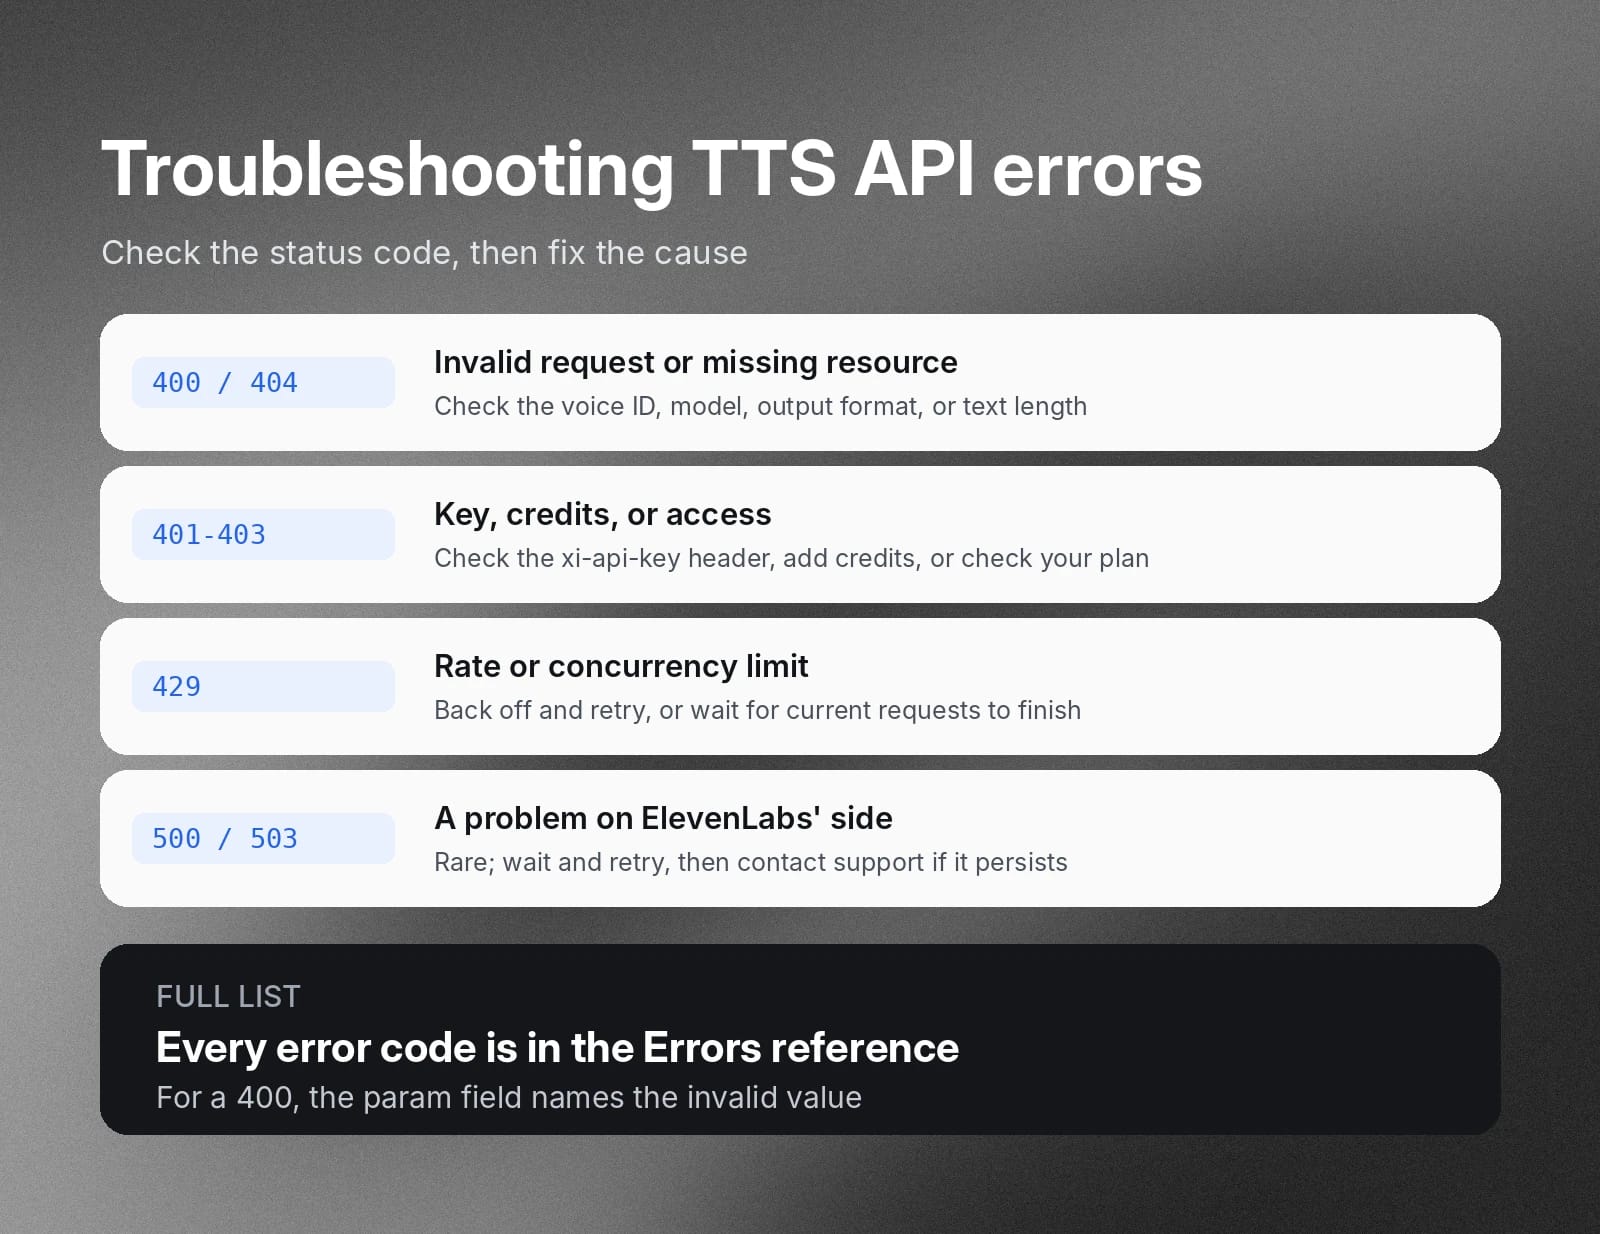
첫 요청이 실패하면 수신한 상태 코드를 아래의 संभाव한 오류 목록과 비교해 확인하세요.
상태
의미
조치 방법
400 또는 404
validation_error, invalid_request 또는 not_found: 요청이 유효하지 않거나 음성 또는 기타 리소스가 존재하지 않음
재시도하기 전에 요청을 수정하세요. 오류의 param 필드는 유효하지 않은 값을 표시합니다. 일반적인 원인으로는 유효하지 않은 음성 ID(invalid_voice_id 또는 존재하지 않는 ID의 voice_not_found), 지원되지 않는 모델 또는 출력 형식, 너무 긴 텍스트(text_too_long)가 있습니다.
401, 402 또는 403
authentication_error, payment_required 또는 authorization_error: API 키, 크레딧 또는 액세스 관련 문제
401의 경우 API 키와 xi-api-key 헤더를 확인하세요. 402의 경우 크레딧을 추가하세요(insufficient_credits). 403의 경우 요금제에 해당 기능이나 모델이 포함되는지 확인하세요(feature_not_available 또는 model_access_denied).
429
rate_limit_error: 속도 제한(rate_limit_exceeded) 또는 동시성 제한(concurrent_limit_exceeded)을 초과함
속도 제한의 경우 지수 백오프로 재시도하세요. 동시성 제한의 경우 현재 요청이 완료된 후 새 요청을 보내거나 더 높은 동시성 제한을 제공하는 요금제로 변경하세요.
500 또는 503
internal_error 또는 service_unavailable: 드물게 발생하는 ElevenLabs 측 문제
잠시 기다린 후 재시도하세요. 500 오류가 계속되면 지원팀에 문의하세요.
전체 오류 목록은 오류 레퍼런스 페이지에서 자세히 확인하세요.
텍스트 음성 변환 API 통합의 이점
애플리케이션에 음성 인터페이스를 추가하면 사용자가 상호작용할 새로운 방식을 제공할 수 있습니다. 시각 장애가 있는 사용자처럼 일부에게는 이것이 애플리케이션을 사용할 수 있는 유일한 실용적 방법일 수 있습니다.
애플리케이션에 TTS API를 통합하면 다음과 같은 이점이 있습니다.
- 접근성: 음성 오디오는 애플리케이션과 상호작용하는 새로운 방법을 제공하여 화면에서 쉽게 읽기 어려운 사용자도 이용할 수 있게 합니다.
- 참여도: 소리 내어 읽기 및 함께 듣기 기능을 사용하면 사용자가 다른 일을 하면서도 콘텐츠를 접할 수 있으며, 이는 점점 주요한 탐색 방식이 되고 있습니다.
- 음성 우선 경험: 음성 응답은 챗봇과 앱 내 가이드가 사용자에게 자연스럽게 답할 수 있는 방법을 제공합니다.
- 다국어 지원: Eleven v4는 90개 이상의 언어를 지원하므로 전 세계 사용자에게 서비스를 제공할 수 있습니다.
설정이 매우 간편하다는 점까지 고려하면, 애플리케이션에 TTS API를 통합하는 것은 앱을 더 인터랙티브하고 표현력 있게 만드는 강력한 방법입니다.
적합한 통합 방식 및 모델 선택
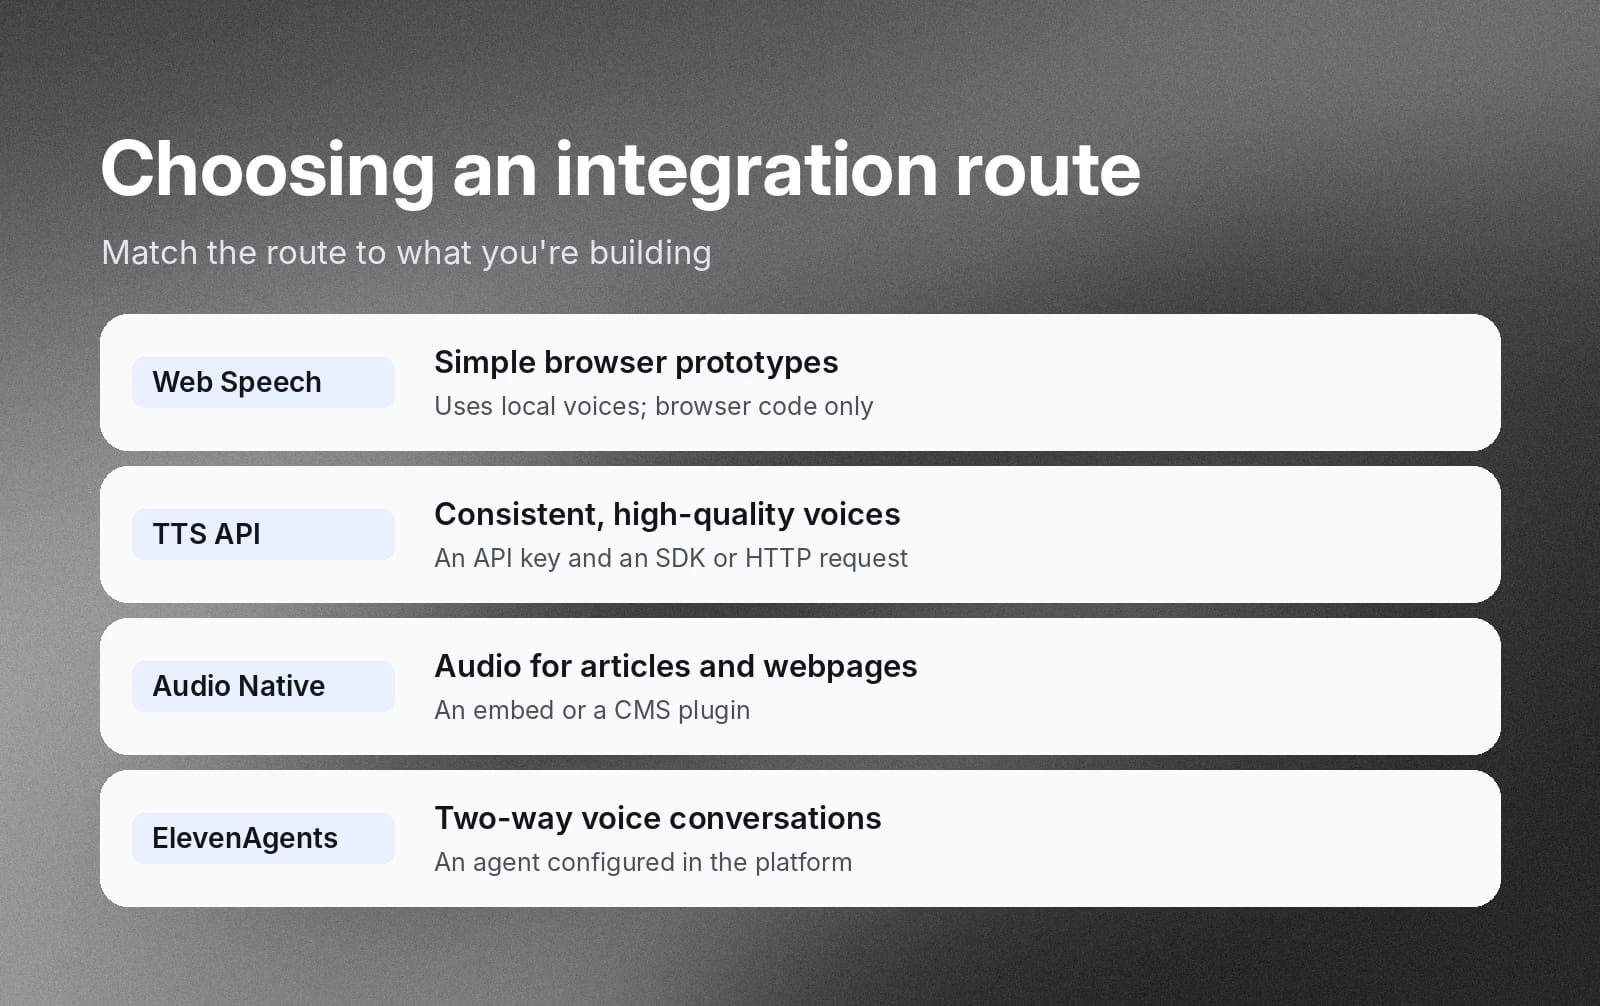
ElevenAPI는 애플리케이션에 음성을 추가하는 가장 빠르고 쉬운 방법 중 하나이지만, 필요에 따라 선택할 수 있는 다른 방식도 있습니다.
선택할 수 있는 몇 가지 TTS 통합 방법은 다음과 같습니다.
방식
적합한 용도
필요한 항목
브라우저 음성 합성(Web Speech API)
로컬 음성을 사용하는 간단한 브라우저 프로토타입
브라우저 코드만
ElevenAPI를 선택한다면 요청에 포함할 모델도 선택해야 합니다. 사용 가능한 ElevenLabs TTS 모델을 간단히 안내합니다.
모델
적합한 용도
언어
eleven_v4
가장 표현력 있는 음성
90+
eleven_flash_v2_5
실시간 사용, 에이전트 및 대용량 작업
32
eleven_multilingual_v2
안정적인 고음질 내레이션
29
또한 보이스 라이브러리에서 17,500개 이상의 음성 중 선택할 수 있습니다. 코드 스니펫의 예시 ID를 원하는 ID로 바꾸기만 하면 됩니다.
애플리케이션에서 텍스트 음성 변환 API를 활용하는 일반적인 사례
첫 요청이 작동하면 같은 호출로 다양한 기능을 구현할 수 있습니다.
애플리케이션에서 TTS API를 사용하는 몇 가지 예시는 다음과 같습니다.
- 앱 내 읽기: 텍스트를 청크로 전송하고 오디오를 순서대로 재생하세요. 자세한 내용은 API 배치 통합 가이드를 읽어보세요.
- 오디오 챗봇 응답: 챗봇의 각 응답을 API로 전달하고 오디오를 스트리밍하여 사용자에게 반환하면 더 인터랙티브한 경험을 제공할 수 있습니다.
- 전화 시스템: 전화 통신에는 ulaw_8000 출력 형식을 요청하세요. 자세한 내용은 Twilio TTS 통합 가이드를 따르세요.
음성 에이전트를 구축하여 양방향 대화를 만들고 싶다면 ElevenAgents가 적합합니다. 전체 음성 파이프라인을 직접 구성하는 대신 플랫폼에서 에이전트를 구성하고 에이전트를 배포할 수 있습니다. 자세한 내용은 ElevenAgents를 살펴보세요.
ElevenAPI로 애플리케이션에 TTS API 구축하기
텍스트 음성 변환 통합은 네 가지 주요 단계로 이루어집니다. API 키를 생성하고 SDK를 설치한 후 첫 요청을 보내고 실행하면 됩니다. 동일한 호출은 TypeScript, Python 또는 HTTP 요청을 보낼 수 있는 다른 모든 언어에서 작동합니다. 애플리케이션에 맞는 모델과 음성도 선택할 수 있습니다.
애플리케이션에 TTS를 구축할 준비가 되었다면 가입하여 오늘 ElevenAPI로 첫 요청을 보내거나 텍스트 음성 변환 API에 대해 자세히 알아보세요.
FAQ

Jack Limebear는 Growth 팀에서 블로그와 인사이트 페이지의 콘텐츠 작가이자 전략가로 활동하고 있습니다. ElevenLabs에 합류하기 전에는 빠르게 성장하는 SaaS 스타트업부터 포춘 500대 기업까지 다양한 조직에서 10년 넘게 콘텐츠 전략을 이끌었습니다. 케임브리지 대학교에서 영문학 석사 학위를 취득했습니다.