텍스트 음성 변환(TTS) API 연동: 스트리밍, 배치, 재시도
- 게시일
- 최종 업데이트
텍스트 음성 변환 API 통합은 간단합니다… 몇 가지 구체적인 결정을 내린 뒤에는 말이죠. 어떤 전송 모드를 사용할지, 모델과 출력 형식을 어떻게 선택할지, 어떻게 스트리밍할지, 동시성 한도를 초과하지 않고 대량의 요청을 처리하는 방법, 동일한 오디오를 두 번 렌더링하는 비용을 내지 않도록 캐싱하고 재시도하는 방법, 다른 제공업체와 첫 바이트 수신 시간(TTFB)을 벤치마킹하는 방법을 결정해야 합니다.
텍스트 음성 변환 API 통합을 지원하기 위해 이러한 아키텍처 결정과 각 상황에서 해야 할 일을 하나하나 정리했습니다. 이 가이드는 ElevenLabs 텍스트 음성 변환 API를 통합하고 확장하는 데 도움이 됩니다. 바로 프로덕션에 적용할 수 있는 코드 스니펫도 제공합니다.
여기서 언급한 개념에 관한 종합적인 배경 지식은 다음 가이드를 참고하세요. 오디오 스트리밍 이해하기, 지연 시간 최적화, 그리고 ElevenLabs 모델 개요.
요약
- ElevenLabs 텍스트 음성 변환 API 엔드포인트는 하나이며, 배치 변환, HTTP 스트림, stream-input WebSocket의 세 가지 방식으로 액세스할 수 있습니다.
- HTTP에서는 진행 중인 모든 요청이 동시성 한도에 포함되지만, WebSocket에서는 활성 생성만 포함됩니다.
- 병렬 처리 수준을 플랜 한도보다 조금 낮게 제한하고, 출력에 영향을 주는 모든 파라미터의 해시를 캐싱하여 같은 텍스트에 두 번 과금되지 않도록 하세요.
- 동시성 한도에 도달하기 전에 부하를 줄일 수 있도록 429와 5xx 오류는 지수 백오프와 전체 지터를 적용해 재시도하세요.
텍스트 음성 변환 API를 통합하는 세 가지 방법
텍스트 음성 변환 엔드포인트는 하나이지만, 통합 방식에 따라 지연 시간, 복잡성, 비용이 달라집니다.
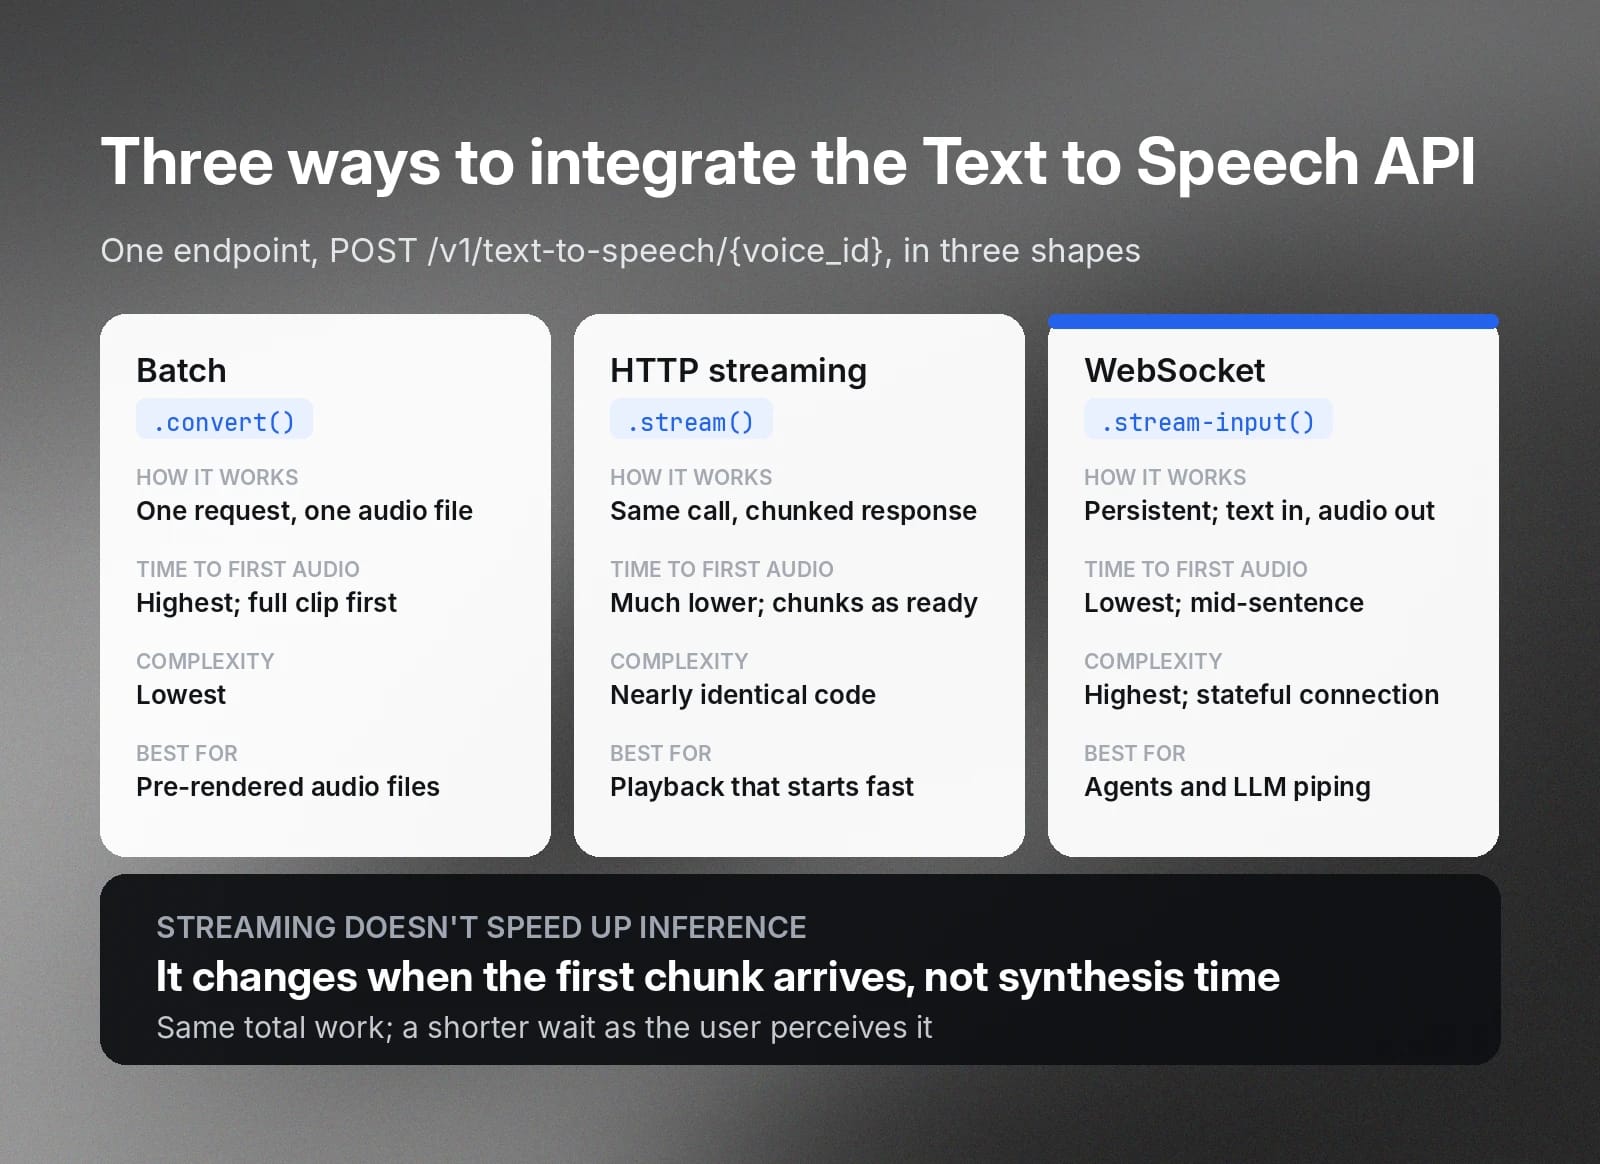
동일한 POST /v1/text-to-speech/{voice_id} 호출을 세 가지 형태로 사용할 수 있으며, 각각 조금씩 다른 용도에 적합합니다. 텍스트 음성 변환 API를 통합하는 세 가지 방법은 다음과 같습니다.
- 배치(convert)는 가장 간단한 통합 방식입니다: 요청 하나를 보내면 오디오 응답 하나를 받습니다. 가장 복잡도가 낮은 옵션이지만, 바이트가 반환되기 전에 전체 클립이 합성되므로 첫 오디오 수신 시간은 가장 깁니다.
- HTTP 스트리밍(stream)은 요청은 그대로 유지하면서 응답을 청크로 나눕니다: 경로에 /stream을 추가하고 stream 메서드를 호출하면 청크 응답으로 오디오가 반환됩니다. 코드는 거의 동일하지만 체감 지연 시간은 훨씬 짧습니다.
- WebSocket(stream-input)은 지속 연결을 유지합니다: 텍스트를 점진적으로 전송하고 그에 따라 오디오 청크를 받습니다. 대화형 에이전트와 문장이 끝나기 전 LLM이 토큰을 생성하는 대로 출력을 음성으로 연결하는 용도로 설계되었습니다.
스트리밍이 모델의 오디오 생성 속도를 더 빠르게 하지는 않습니다. 추론 시간은 변하지 않습니다. 스트리밍이 바꾸는 것은 첫 번째 청크를 받는 시점입니다. 전체 클립이 완성되기 전에 전송되므로 총 작업량은 같아도 사용자가 체감하는 대기 시간은 짧아집니다.
배치 vs. 스트리밍 vs. WebSocket 의사결정 표
이 세 가지 방식 중 하나를 선택할 때는 고려해야 할 요소가 여러 가지 있습니다.
간단히 안내하면, 오프라인 렌더링에는 배치, 사용자가 기다리는 알려진 텍스트에는 HTTP 스트리밍, 에이전트와 실시간 LLM 음성 변환에는 WebSocket을 선택하세요.
아래 표는 대규모 환경에서 중요한 기준별 트레이드오프를 정리한 것입니다.
HTTP에서는 배치든 스트리밍이든 진행 중인 모든 요청이 전체 실행 시간 동안 플랜의 동시성 한도에 포함됩니다. WebSocket에서는 모델이 실제로 오디오를 생성하는 시간만 포함되며, 열려 있지만 유휴 상태인 소켓에는 거의 비용이 들지 않습니다.
캐스케이드 음성 에이전트처럼 대화 전체에 걸쳐 연결을 열어 두지만 에이전트의 발화 차례에만 오디오를 생성하는 경우, 그 차이는 큽니다. 이것이 에이전트를 구축할 때 WebSocket을 사용하는 주된 이유입니다. 전체 프로토콜은 실시간 텍스트 음성 변환 WebSocket 가이드에 문서화되어 있습니다.
모델 및 출력 형식 선택하기
TTS API 통합으로 받는 오디오는 두 가지 선택에 의해 결정됩니다. 첫째는 품질과 속도를 정하는 모델입니다. 둘째는 컨테이너, 비트레이트, 샘플 레이트를 정하는 출력 형식입니다.
처음부터 이 두 가지를 올바르게 선택하면 지연 시간과 전화 시스템 호환성 등 이후의 모든 요소가 자연스럽게 갖춰집니다.
모델
ElevenLabs는 여러 텍스트 음성 변환 모델을 제공합니다. 최고부터 최저까지 순위가 매겨진 것이 아니라, 각각 서로 다른 트레이드오프를 제공합니다.
참고로 약 75ms는 네트워크 및 애플리케이션 지연 시간을 제외한 대표적 조건에서의 모델 추론 시간입니다. 입력이 길어지거나 부하가 높으면 증가합니다. 벤치마크 수치가 아니라 반드시 애플리케이션에서 직접 측정하세요.
Flash 모델은 더 작고 추론 시간을 줄이기 위해 더 적극적인 근사 기법을 사용합니다. Eleven v4와 Multilingual v2는 더 풍부한 결과를 만들기 위해 문자당 더 많은 시간을 사용하는 대형 모델입니다.
실시간 또는 에이전트 경로에는 지연 시간이 가장 짧은 다국어 옵션인 eleven_flash_v2_5를 사용하세요. 내레이션, 오디오북, 또는 마케팅 보이스오버에는 안정적인 고품질이 필요할 때 eleven_multilingual_v2를, 최대한의 표현력과 감정 범위가 필요할 때 eleven_v4를 사용하세요.
전화번호, 날짜, 통화처럼 발음이 중요한 경우에는 텍스트가 API에 도달하기 전에 애플리케이션에서 직접 숫자를 정규화하세요. 원하는 발음 형태를 풀어서 작성하세요.
직접 정규화하면 모델 전반에서 발음을 예측 가능하게 유지하고, 변경될 수 있는 모델별 기본값에 의존하지 않을 수 있습니다.
출력 형식
output_format 파라미터는 반환되는 오디오의 컨테이너, 샘플 레이트, 비트레이트를 제어합니다. 가장 자주 사용할 값은 다음과 같습니다.
음성 설정
다음 설정은 생성된 음성이 전달되는 방식을 제어합니다.
- Stability: 일관성과 표현력 간의 균형을 제어합니다. 값이 낮을수록 변화가 풍부하고 표현력 있는 음성이 생성되며, 값이 높을수록 더 안정적이고 예측 가능한 전달이 이루어집니다.
- SimilarityBoost: 출력이 참조 음성을 얼마나 가깝게 따르는지 제어합니다.
- Style: 값을 높이면 음성의 자연스러운 말하기 스타일을 과장합니다.
- useSpeakerBoost: 약간의 지연 시간 비용으로 원본 화자와의 유사도를 높입니다.
- Speed: 기본값 1.0을 기준으로 전달 속도를 조절합니다.
이 설정 중 Stability는 일반적으로 체감 품질에 가장 큰 영향을 줍니다. 값이 낮을수록 더 표현력 있지만 일관성은 떨어지고, 값이 높을수록 일관성과 예측 가능성을 우선시합니다.
음성을 선택할 때 지연 시간이 가장 짧은 조합은 Flash와 Instant 음성 복제 또는 기본 음성을 함께 사용하는 것입니다. 프로페셔널 음성 복제는 뛰어난 음질을 제공하지만 생성당 추가 오버헤드가 있으므로 고려해야 합니다.
이 가이드 전체에서 사용하는 샘플 voice id는 JBFqnCBsd6RMkjVDRZzb(George)입니다.
스트리밍 통합(HTTP 및 WebSocket)
이 섹션에서는 텍스트 음성 변환 API 통합의 실무 핵심을 다룹니다. SDK 설치, 스트림 열기, 도착하는 오디오 소비 방법을 살펴봅니다. HTTP 경로는 대부분의 웹 및 앱 재생을 다루며, WebSocket 경로는 에이전트와 실시간 LLM 출력을 다룹니다.
두 경로 모두 아래와 같이 ElevenLabs 클라이언트를 초기화했다고 가정합니다.
스트리밍 경로는 스트림을 열고 도착하는 청크를 소비합니다. voiceId가 첫 번째 위치 인수이며, 그 뒤에 camelCase 키(modelId, outputFormat, voiceSettings)를 사용하는 옵션 객체가 옵니다.
WebSocket 방식에서는 wss://api.elevenlabs.io/v1/text-to-speech/{voice_id}/stream-input에 연결하고, 음성 설정과 앞쪽 공백을 포함한 첫 메시지를 보냅니다. 이후 텍스트가 준비되는 대로 메시지를 전송하고, audio 필드에 base64 인코딩 청크가 담긴 JSON 프레임을 읽어옵니다.
고처리량을 위한 배치 처리 및 동시성 한도
고처리량 통합은 같은 순간에 오디오를 생성하는 요청 수인 동시성에 의해 좌우됩니다. 각 플랜에는 모델 계열별 한도가 있습니다.
모든 플랜에는 서로 다른 동시성 한도가 포함됩니다.
- 무료: 동시 Flash 요청 4개.
- 스타터: 동시 Flash 요청 6개.
- 크리에이터: 동시 Flash 요청 10개.
- 프로: 동시 Flash 요청 20개.
- 스케일 및 비즈니스: 동시 Flash 요청 30개이며, 엔터프라이즈 한도는 맞춤 설정됩니다.
Multilingual v2의 한도는 위 수치의 약 절반입니다.
제한된 풀을 사용하면 동시에 실행되는 요청 수를 제한하여 이를 완화할 수 있습니다.
MAX_CONCURRENCY는 플랜 한도와 정확히 같게 설정하기보다 조금 낮게 설정하세요. 이 여유분은 같은 키를 공유하는 다른 트래픽을 흡수하고 429가 반환되는 임계값 아래를 유지해 줍니다.
문자 수 제한 및 긴 텍스트 분할
모든 모델은 한 번의 요청으로 받을 수 있는 문자 수에 제한이 있습니다. 긴 형식의 통합에서는 텍스트를 분할하고 오디오를 다시 이어 붙여야 합니다.
모델별 요청당 문자 수 제한은 다음과 같습니다.
- Flash v2.5: 요청당 최대 40,000자를 허용합니다.
- Flash v2: 요청당 최대 30,000자를 허용합니다.
- Multilingual v2: 요청당 최대 10,000자를 허용합니다.
- Eleven v3: 요청당 최대 5,000자를 허용합니다.
- Eleven v4: 요청당 최대 10,000자를 허용합니다.
이보다 긴 텍스트는 여러 요청으로 분할해야 합니다. 청크 사이의 경계에서도 운율이 유지되도록 문장 경계에서 분할하는 것이 좋습니다.
청크를 순서대로 렌더링한 뒤 오디오를 연결하세요. 각 청크가 독립적인 장문 내레이션에서는 두 작업이 직접 결합됩니다. splitText 출력을 위의 제한된 풀에 전달하고 나머지는 풀이 처리하도록 하면 됩니다.
캐싱 및 멱등성
텍스트 음성 변환 출력은 충분히 결정적이므로 같은 텍스트를 같은 음성, 모델, 설정으로 다시 렌더링하는 것은 낭비입니다. 오디오에 영향을 미치는 입력값의 해시를 키로 사용해 결과를 캐시하고, 같은 키를 재시도 시 멱등성 토큰으로도 사용하세요.
두 가지를 모두 구현하는 방법은 다음과 같습니다.
이 방식이 작동하는 규칙은 outputFormat과 음성 설정을 포함해 오디오를 변경하는 모든 파라미터가 키에 포함되어야 한다는 것입니다. 올바르게 구현하면 같은 키가 멱등성 토큰 역할도 합니다. 이미 성공한 요청을 클라이언트가 재시도하면 다시 생성하는 대신 캐시된 바이트를 반환합니다.
오류 처리 및 속도 제한(429)
프로덕션 클라이언트에는 백오프와 지터를 적용한 재시도, 그리고 상태 코드별로 달라지는 처리가 필요합니다. 재시도할 가치가 있는 실패도 있고 그렇지 않은 실패도 있기 때문입니다.
아래 표는 각 상태에 적합한 조치를 연결하며, 이 섹션에서는 429가 단단한 벽이 아니라 소프트 한도인 이유를 설명합니다.
429는 단단한 벽이 아니며, 그 메커니즘을 이해하면 도움이 됩니다. 동시성 한도를 초과하면 요청은 먼저 우선순위에 따라 대기열에 들어가며, 일반적으로 약 50ms가 추가됩니다. 그 이후에도 여전히 용량을 초과한 경우에만 429를 받게 됩니다.
응답에는 현재 사용 가능한 여유를 보여 주는 current-concurrent-requests 및 maximum-concurrent-requests 헤더도 포함되므로, 이를 읽고 한도에 도달하기 전에 부하를 줄일 수 있습니다.
더 나은 재시도 동작이 아니라 더 많은 여유 용량이 필요하다면 플랜을 업그레이드하세요. 엔터프라이즈 고객은 계정 관리자를 통해 상향된 한도를 요청할 수 있습니다.
지연 시간 및 첫 바이트 수신 시간 벤치마킹
지연 시간은 지역, 입력, 현재 부하에 따라 달라집니다. 따라서 신뢰할 수 있는 유일한 지연 시간 수치는 자체 환경에서 측정한 값입니다.
이 섹션에서는 Flash 스트리밍 엔드포인트의 첫 바이트 수신 시간(TTFB)을 다루며, 동일한 하니스를 다른 제공업체에 적용해 같은 조건에서 비교할 수 있도록 구성했습니다.
이를 공개된 결과가 아니라 방법론으로 생각하세요. 한 번의 실행 결과가 무엇도 보장하지는 않습니다.
텍스트 음성 변환 API 통합의 지연 시간을 벤치마킹할 때 중요한 몇 가지 유의 사항은 다음과 같습니다.
- 네트워크 왕복 시간 포함: TTFB는 지리적 위치와 제공업체의 가장 가까운 클러스터에 따라 달라지므로, 서버가 일반적으로 실행되는 위치에서 테스트하세요.
- 워밍업 실행 제외: 콜드 연결에 대한 첫 요청은 더 느리고 수치를 왜곡할 수 있습니다.
- 입력값 고정: 입력 길이, 음성, 모델, 부하는 모두 결과에 영향을 미치므로 제공업체 간 동일하게 유지하세요.
- 분포 보고: 수치는 실행마다 달라지므로 단일 값 대신 중앙값과 p95를 공개하세요.
이러한 사항을 고려했다면 벤치마킹할 준비가 되었습니다.
다른 제공업체와 비교하려면 같은 형태의 함수를 작성하세요. 그런 다음 워밍업 호출 1회를 제외하고, 서로 충돌하지 않도록 간격을 두고 약 20개의 시간 측정 샘플을 수집하며, 중앙값과 p95를 밀리초 단위로 보고하는 작은 러너로 두 제공업체를 실행하세요.
공정한 비교는 변수를 제어하는 데 달려 있습니다.
두 제공업체를 같은 머신과 네트워크에서 실행하세요. 가정용 광대역 인터넷에 연결된 노트북이 아니라 실제로 배포하는 지역의 서버가 이상적입니다. 같은 입력 텍스트를 사용하고, 생성 길이가 아니라 모델 추론이 수치를 좌우하도록 오디오는 짧게 유지하세요. 단일 측정값은 잡음이므로 여러 번 실행한 중앙값과 p95를 보고하세요.
공용 인터넷에서의 TTFB에는 모델과 무관한 20~200ms의 네트워크 왕복 시간이 포함된다는 점을 기억하세요. ElevenLabs는 북미, 유럽, 동남아시아의 클러스터에서 서비스를 제공하고 가장 가까운 클러스터로 라우팅하므로, 테스트 클라이언트도 이에 맞춰 같은 지역에 배치하세요. 그렇지 않으면 대부분 데이터 센터까지의 거리를 벤치마킹하게 됩니다.
텍스트 음성 변환 API 통합의 핵심 요점
프로덕션 환경의 텍스트 음성 변환 API 통합은 영향력 있는 몇 가지 결정으로 귀결됩니다.
다음 사항을 올바르게 처리하면 나머지도 자연스럽게 갖춰집니다.
- 용도에 따라 모델 선택: 상호작용이 필요한 모든 작업에는 Flash v2.5를 사용하고, 지연 시간이 덜 중요한 오프라인 렌더링에는 Multilingual v2 또는 Eleven v4 같은 고충실도 모델을 사용하세요.
- 사용자가 기다릴 때는 항상 스트리밍 사용: 알려진 텍스트에는 HTTP 스트리밍을, 에이전트에는 WebSocket을 사용하여 유휴 시간이 동시성 예산에 포함되지 않도록 하세요.
- 병렬 처리 수준을 플랜 한도로 제한: 동시 요청 수를 플랜 한도보다 조금 낮게 제한하고, 출력에 영향을 주는 모든 파라미터의 해시를 캐싱하여 같은 오디오에 두 번 과금되지 않도록 하세요.
- 429 및 5xx 오류에 지수 백오프와 전체 지터 적용: 429와 5xx 오류에서는 전체 지터를 적용해 백오프하고, 동시성 헤더를 확인하여 한도에 얼마나 근접했는지 파악하세요.
- 긴 텍스트는 문장 경계에서 분할: 각 모델의 문자 수 제한 내에서 문장 경계로 분할하여 운율이 청크 경계에서도 유지되도록 하세요.
더 깊이 알아보고 싶다면 스트리밍 방법 가이드, 오디오 스트리밍 개념, 인증, 그리고 클라이언트 측 사용을 위한 일회용 토큰을 참고하세요.
ElevenAPI로 텍스트 음성 변환 통합 구축하기
이 가이드를 읽었다면 프로덕션용 텍스트 음성 변환 API 통합에 필요한 모든 패턴을 갖춘 것입니다. 스트리밍, 배치 처리, 캐싱, 재시도, 벤치마킹까지 실제 운영에 적용할 준비가 되었습니다.
텍스트 음성 변환 API에 대해 자세히 알아보거나 가입하여 오늘 ElevenAPI로 첫 호출을 시작하세요.
텍스트 음성 변환 API 통합 FAQ

Tadas Petra는 ElevenLabs 제품군을 활용해 개발자들이 더 쉽게 개발할 수 있도록 지원하는 개발자 관계 엔지니어입니다. 또한 개발자 교육 플랫폼 Hungrimind의 창립자이기도 합니다. 이전에는 Agora에서 리드 개발자 에반젤리스트로, Zero To Mastery에서 강사로 활동했습니다.