会話型AIエージェントのテスト
- 執筆者
- Anna Neely
- 公開日
- 最終更新日
聴くこの記事を聴く
会話型音声エージェントを本番運用した後、どうすれば大規模にモニタリングできるでしょうか?意図どおりに動作していないことを、どう検知すればよいでしょうか?変更を加えた後は、どうテストすればよいでしょうか?
こうした問いが、El、というドキュメントアシスタントの開発を形作りました。Elは会話型AIを活用しています。Elの進化に伴い、モニタリング、評価、そしてテストを行うシステムを構築しました。このシステムは、評価基準と会話シミュレーションを基盤としています。
基盤づくり:信頼できる評価基準
あらゆるエージェントの改善は、実際の環境でどのように振る舞うかを理解することから始まります。そのため、評価基準を見直し、エージェントのパフォーマンスをモニタリングできるだけの正確性と信頼性を確保しました。エージェントが誤った情報を提供する、またはユーザーが目的を達成できるよう支援できない会話を、失敗した会話と定義しています。
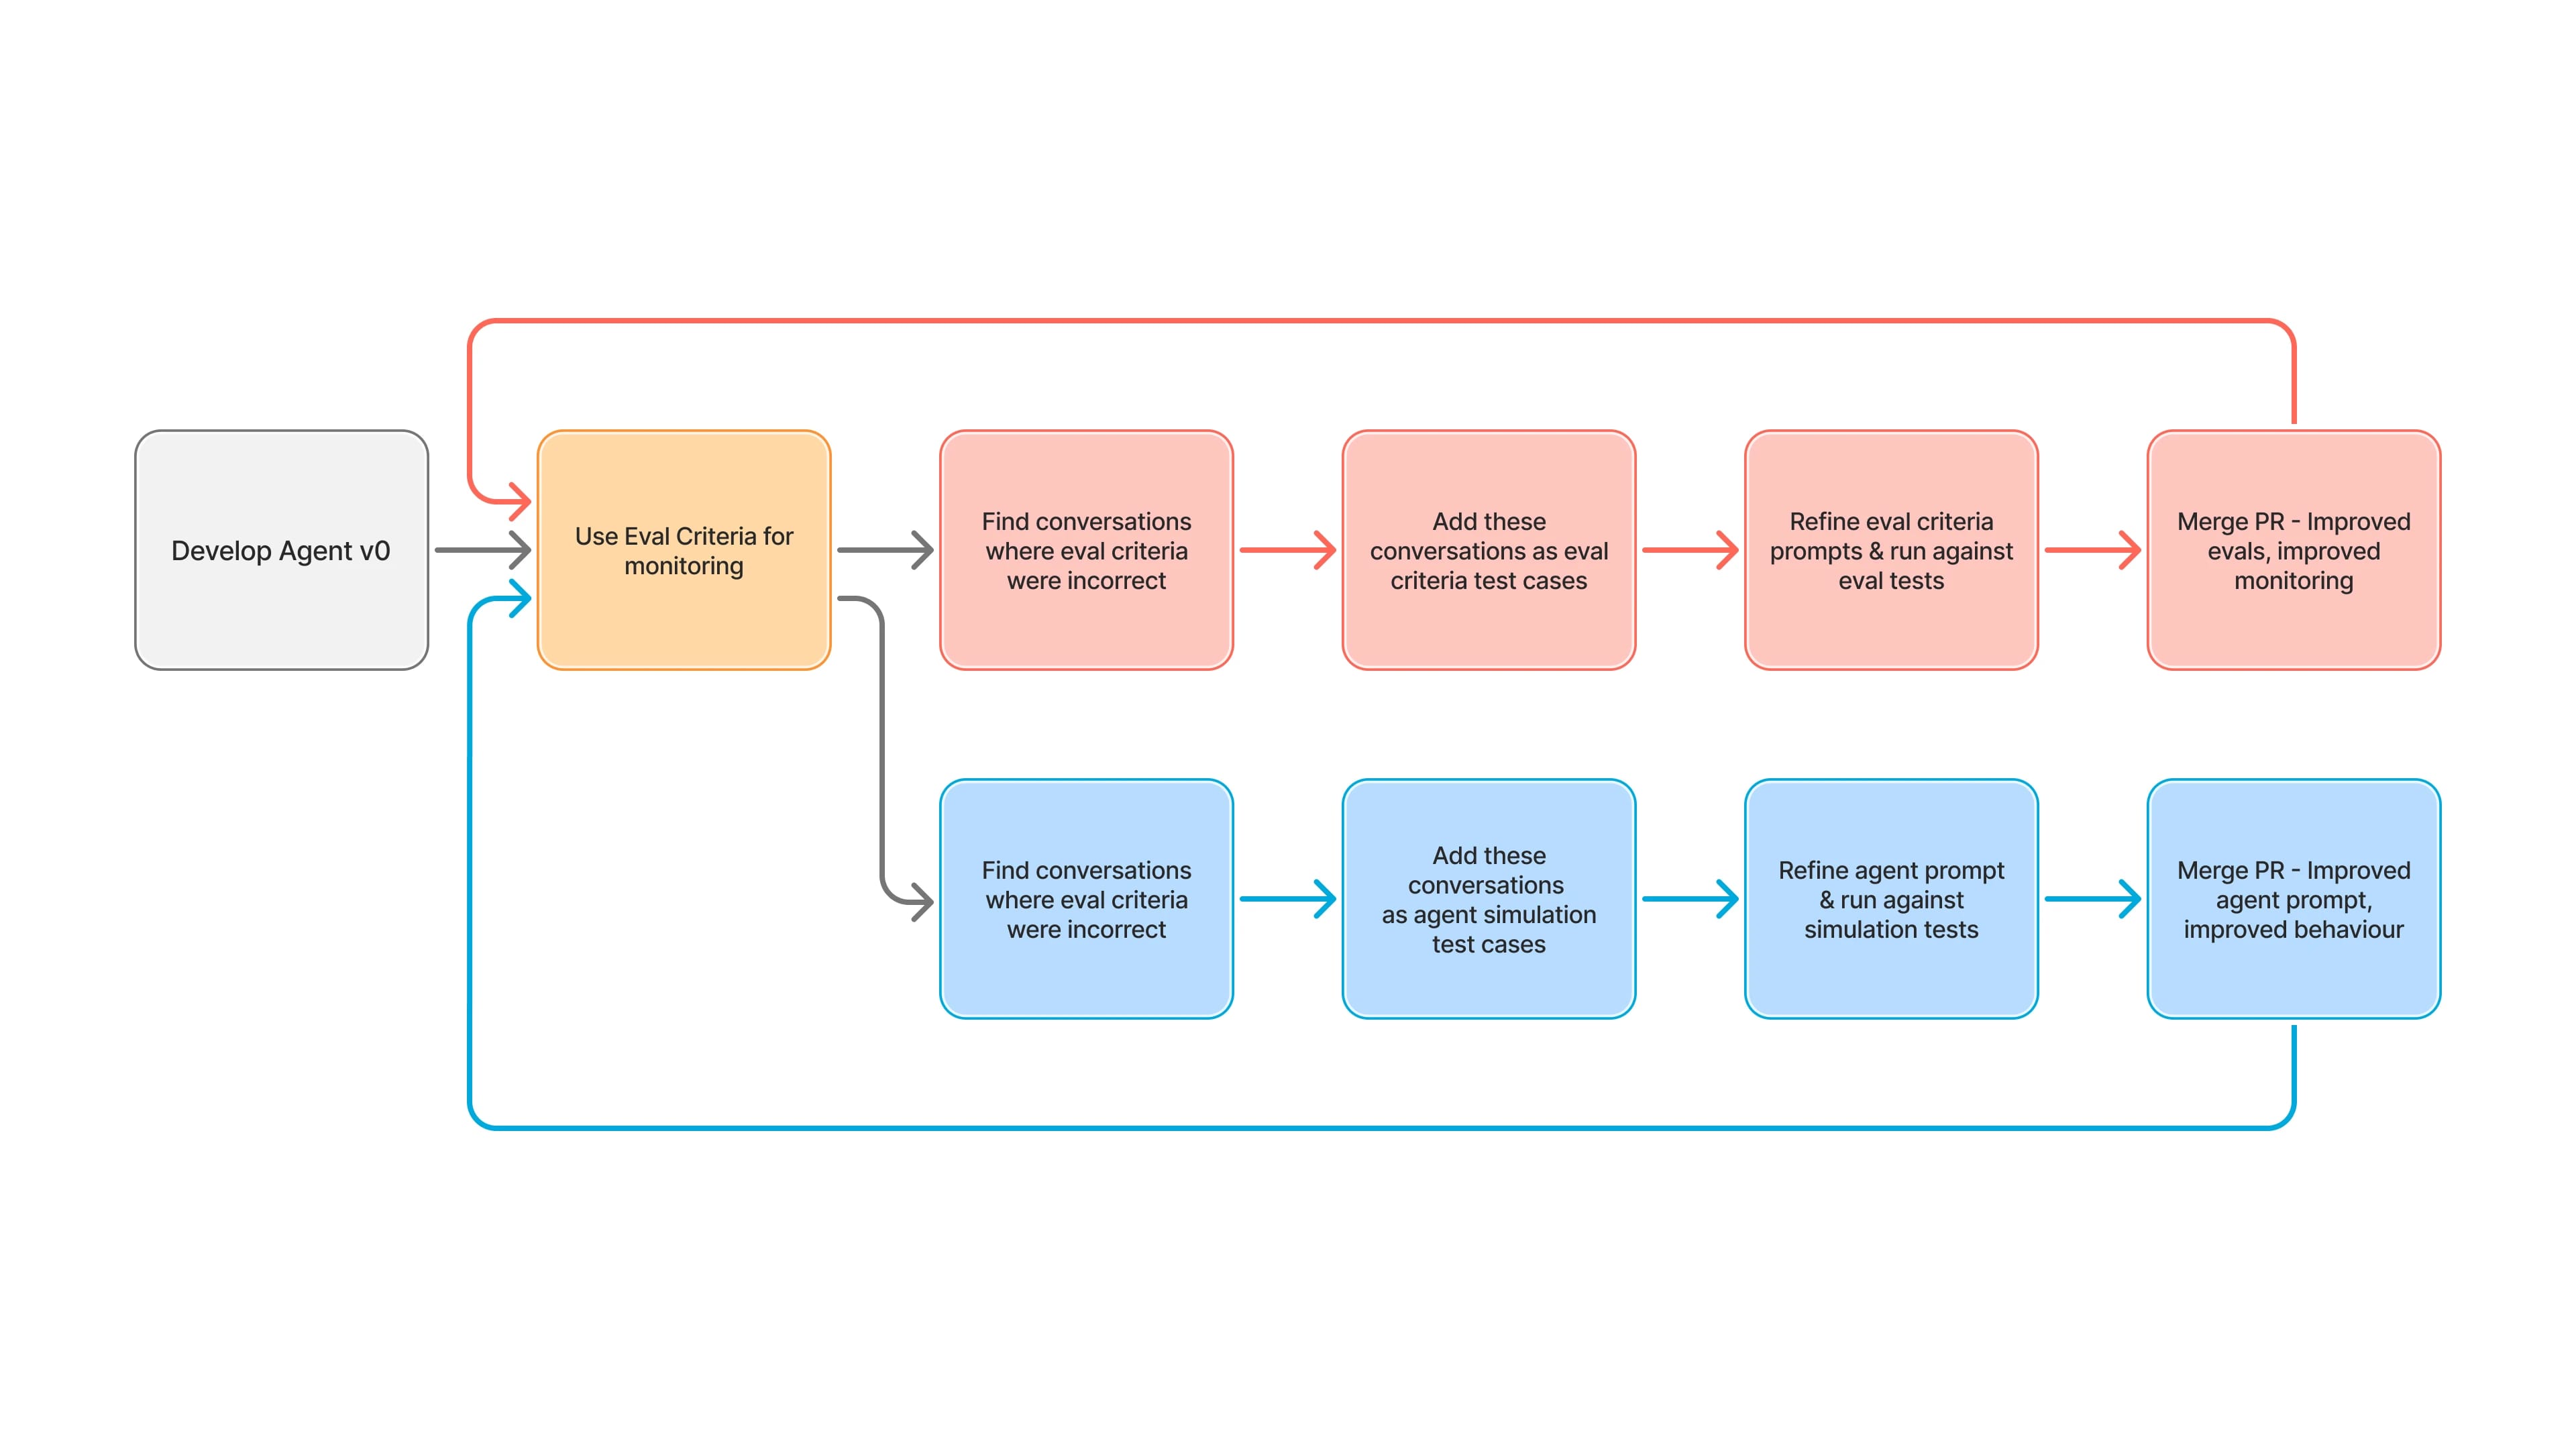
以下の評価基準を策定しました:
- インタラクション:有効な会話か、ユーザーは関連する質問をしたか、会話は意味が通っているか?
- ポジティブなインタラクション: ユーザーは満足して会話を終えたか、それとも混乱や不満を感じていたか?
- 根本原因の把握: エージェントはユーザーが抱える根本的な問題を正しく特定できたか?
- ユーザーの問い合わせの解決: エージェントはユーザーの問題を解決したか、または別のサポート方法を提供したか?
- ハルシネーション: エージェントはナレッジベースにない情報を生成していないか?
インタラクションが失敗した場合、会話そのものが有効ではありません。ほかの基準で失敗した場合は、さらに詳しく調査します。その調査結果をもとに、エージェントをどのように改善するかを決めます。ツールの利用方法やタイミングを見直すこともあります。サポート対象外のアクションを防ぐため、ガードレールを追加することもあります。
確信を持って反復する:会話シミュレーションAPI
改善すべき点を特定したら、次はテストです。そこで活用するのが、会話シミュレーションAPIです。エンドツーエンドのシナリオと特定セグメントのシナリオの両方で、現実的なユーザーシナリオをシミュレートします。また、本番環境と同じ基準で結果を自動評価します。ツールのモックとカスタム評価に対応しているため、特定の挙動も柔軟にテストできます。
2つのアプローチを使用しています:
- 完全シミュレーション: 会話全体をテストします。開始から終了までを対象にします。
- 部分シミュレーション: 会話の途中から開始し、意思決定ポイントやサブフローを検証します。これはユニットテストで主に使う手法で、迅速な反復と的を絞ったデバッグを可能にします。
明確で焦点を絞ったシナリオにより、LLMのテスト対象をコントロールでき、エッジケース、ツールの利用、フォールバックロジックを網羅できます。
スケールのための自動化:CI/CDへのテスト組み込み
最後の要素は自動化です。ElevenLabsのオープンAPIを使用し、評価とシミュレーションをCI/CDパイプラインに組み込むことで、GitHub DevOpsフローと連携しました。すべての更新はデプロイ前に自動でテストされます。これによりリグレッションを防ぎ、実運用でのパフォーマンスについて迅速にフィードバックを得られます。
結果:より強力で、よりスマートなEl
このプロセスにより、Elの構築・運用方法が大きく変わりました。実際の利用状況と、構造化された評価、的を絞ったテスト、自動検証を結び付けるフィードバックループを構築したことで、より迅速かつ確信を持って改善をリリースできるようになりました。
そしてこのフレームワークは、今後構築するあらゆるエージェントに適用できます。
アンナ・ニーリーはプロダクト戦略を担当し、エンタープライズ顧客と連携してソリューションの設計や導入を行っています