Scribe v3 और v3 Live पेश हैं, हमारे सबसे सटीक स्पीच टू टेक्स्ट मॉडल
- लेखक
- Min Kim
- प्रकाशित
सुनेंइस आर्टिकल को सुनें
ऑडियो पर बने प्रोडक्ट्स की शुरुआत ट्रांसक्रिप्ट से होती है: मीटिंग नोट्स, वॉइस एजेंट्स, डबिंग, क्लिनिकल डॉक्यूमेंटेशन और दशकों के कंटेंट वाले ब्रॉडकास्ट आर्काइव्स। उस ट्रांसक्रिप्ट का पहली बार में सही होना मायने रखता है, क्योंकि हर त्रुटि आगे बढ़ती जाती है, जहां उसे ठीक करने की लागत कहीं अधिक होती है।
लेकिन असल दुनिया का ऑडियो जटिल होता है। इसमें मीटिंग में एक-दूसरे के ऊपर बोलते कई लोग, व्यस्त सड़क पर कोई ग्राहक जो वाक्य के बीच में रुक जाता है, या ऐसी सपोर्ट कॉल हो सकती है जिसमें कोई भी व्यक्ति अपनी पहली भाषा में नहीं बोल रहा होता।
आज ElevenLabs इन्हीं परिस्थितियों के लिए बनाए गए दो नए स्पीच टू टेक्स्ट मॉडल लॉन्च कर रहा है:
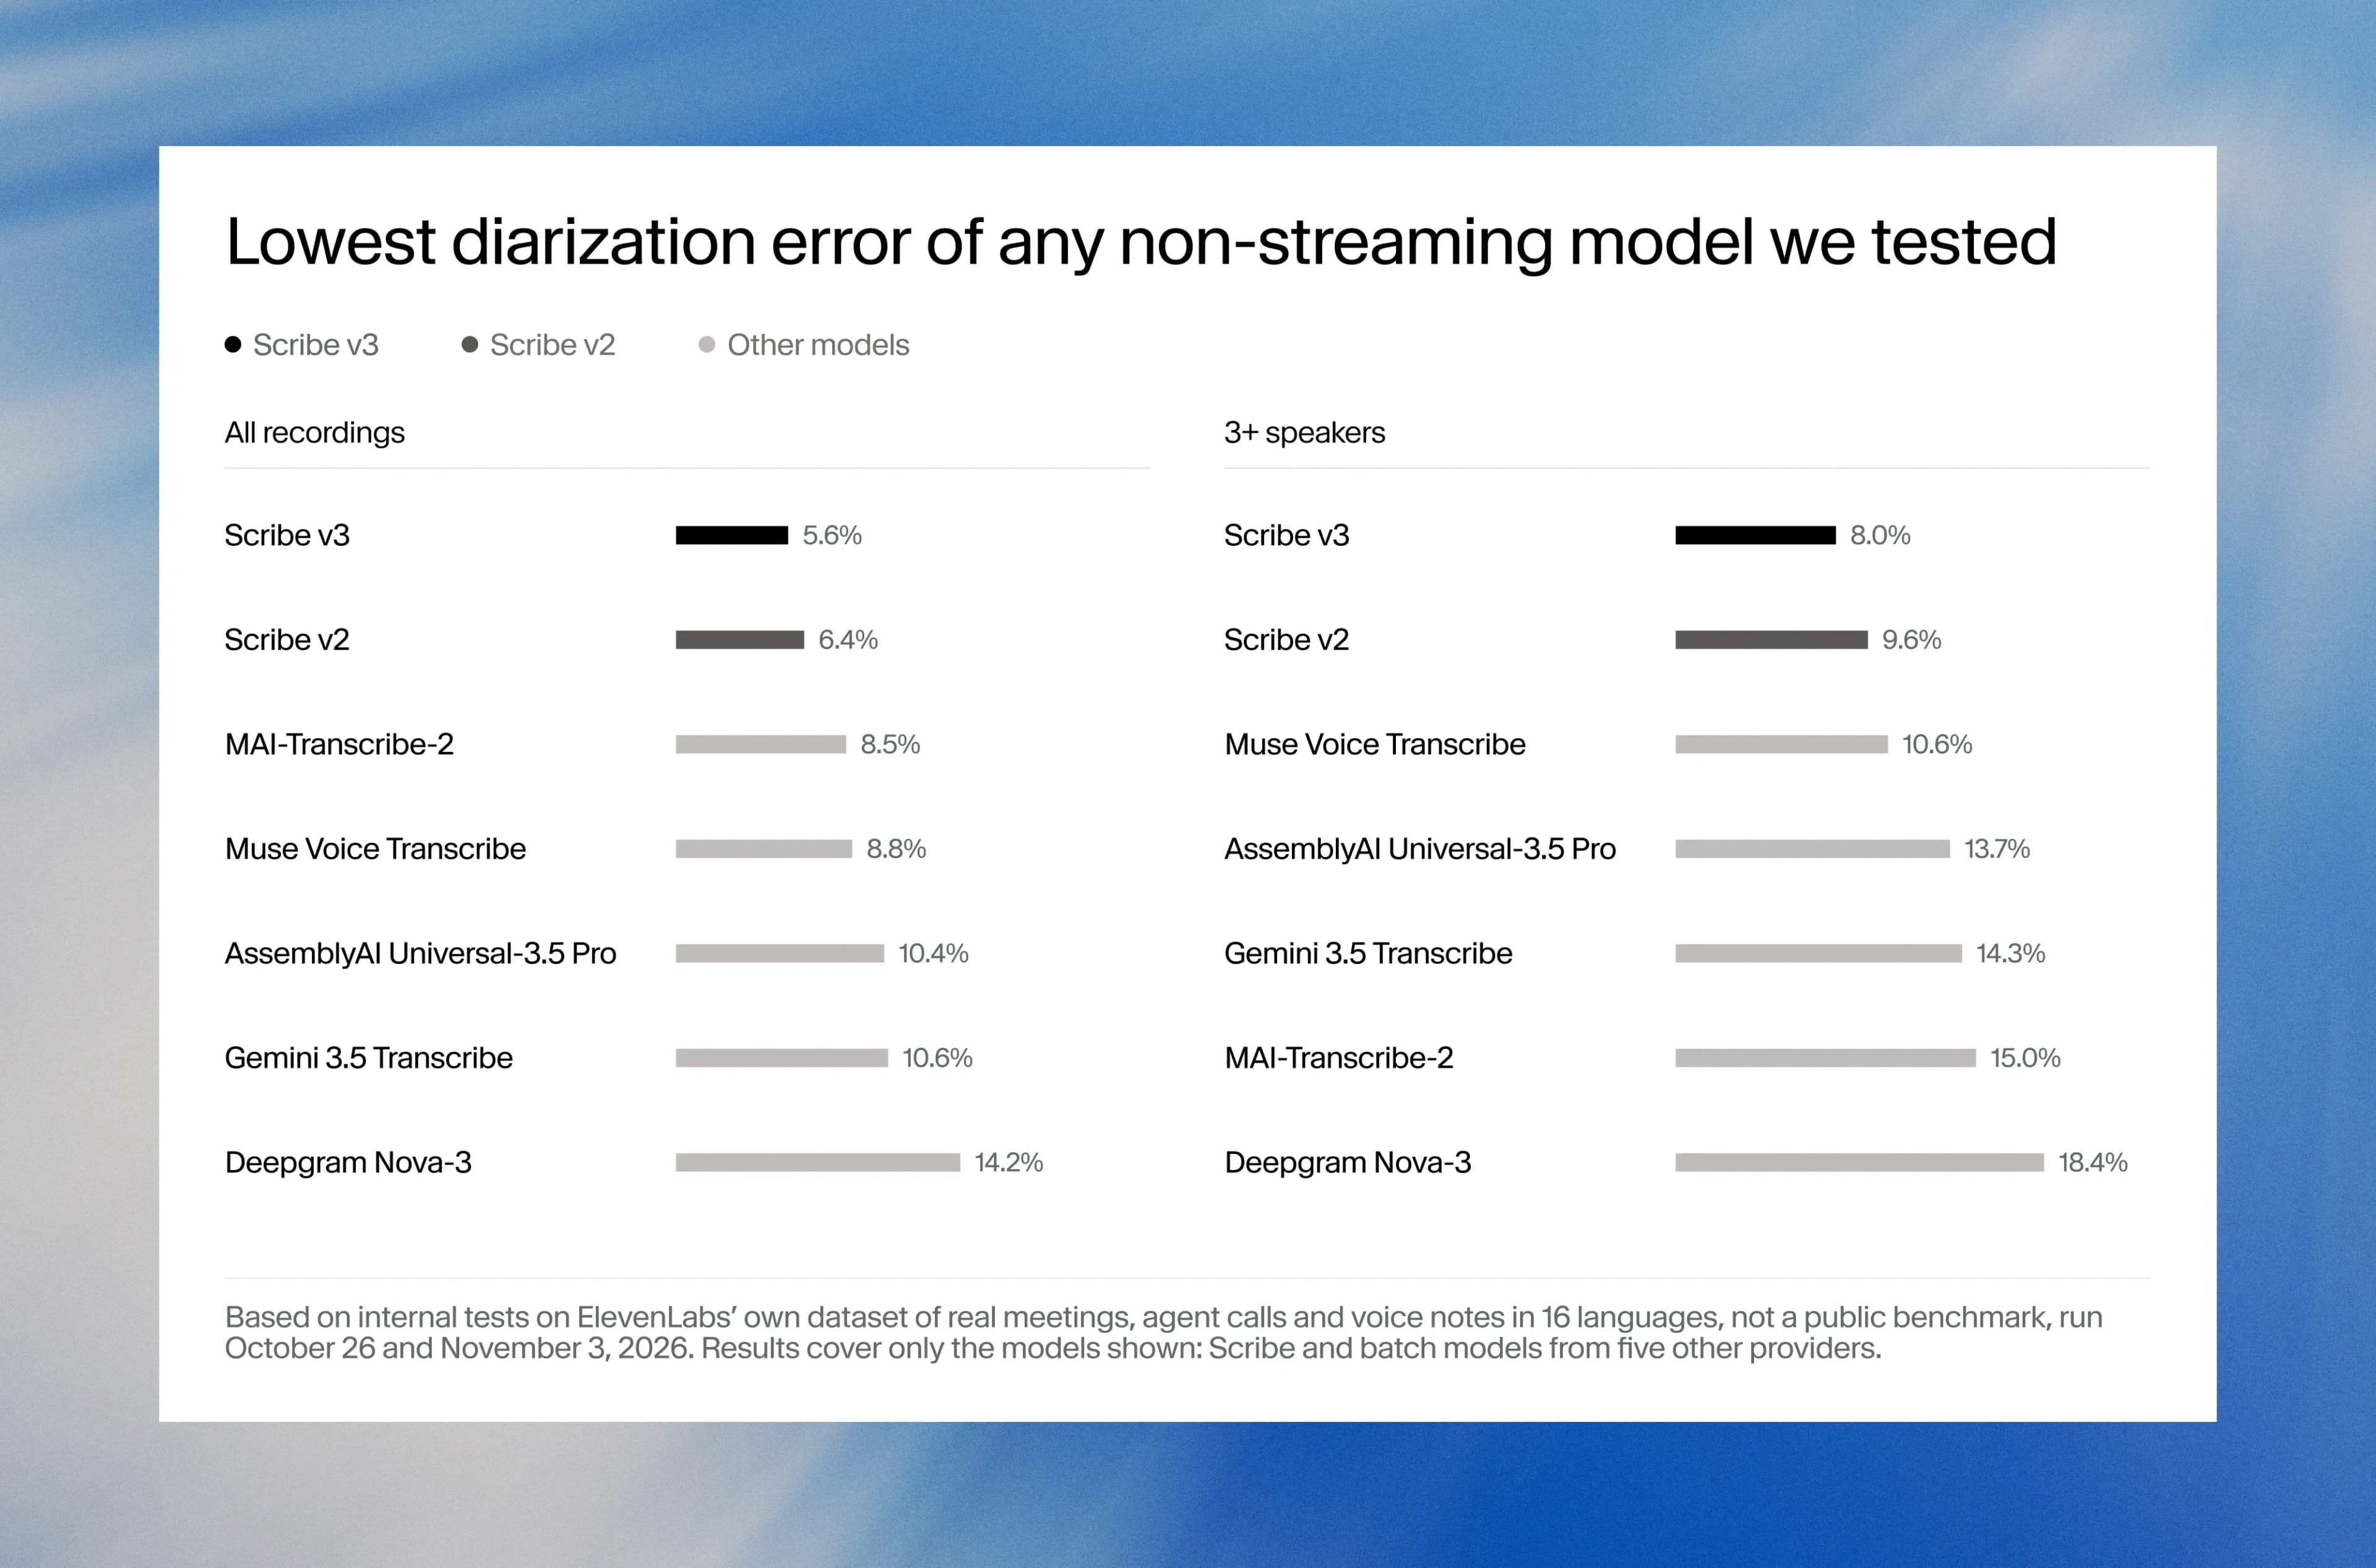
- रिकॉर्ड किए गए ऑडियो के लिए Scribe v3, 102 भाषाओं में Scribe v2 की तुलना में 27% कम शब्द त्रुटियां करता है और हमारे टेस्ट किए गए सभी मॉडलों में सबसे सटीक स्पीकर लेबल देता है,
- Scribe v3 Live रीयलटाइम ऑडियो के लिए कम-लेटेंसी वाला वेरिएंट है और Scribe v2 Realtime की तुलना में 43% कम गलतियां करता है। इसमें पहली बार स्पीकर डायरीकरण (किसने क्या कहा, इसकी पहचान) और बेहतर टर्न डिटेक्शन भी शामिल है।
Scribe v3 Live आज ElevenAgents में उपलब्ध है। दोनों मॉडल ElevenAPI में भी उपलब्ध हैं, जहां Scribe v2 से स्विच करने के लिए मॉडल ID में सिर्फ एक लाइन बदलनी होती है।
वह फीडबैक जिसने Scribe v3 को आकार दिया
Scribe ने मीटिंग-नोट्स ऐप्स, कॉन्टैक्ट सेंटर्स, क्लिनिकल डॉक्यूमेंटेशन टूल्स और वॉइस एजेंट्स के लिए करोड़ों घंटों के ट्रांसक्रिप्शन को पावर दिया है। अलग-अलग उपयोग मामलों में, इसे बनाने वाली टीमें लगातार वही पांच चीजें मांग रही थीं।
मीटिंग और नोट-टेकिंग टीमों को तेज़ बातचीत और तीन या उससे अधिक स्पीकर्स के साथ बेहतर डायराइज़ेशन चाहिए था। वॉइस एजेंट टीमों ने बताया कि जब कॉलर वाक्य के बीच में रुकते हैं या कोई नंबर पढ़ने के लिए धीमे होते हैं, तो साइलेंस टाइमर उन्हें बीच में ही रोक देता है। लाइव प्रोडक्ट्स बनाने वाली टीमें स्पीड के लिए सटीकता से समझौता कर रही थीं, क्योंकि रियलटाइम का प्रदर्शन बैच की तुलना में काफी खराब था। भारत के ग्राहक चाहते थे कि हिंदी, अंग्रेज़ी जितनी ही सटीक हो, भले ही कॉलर वाक्य के बीच में दोनों भाषाओं के बीच स्विच करें। और कई लोग आउटपुट पर ज्यादा नियंत्रण चाहते थे—“123” जैसे अंकों से लेकर प्रोडक्ट कैटलॉग या दवाओं के नामों की सूची के लिए पर्याप्त लंबी की टर्म सूचियों तक।
स्पीकर लेबल, टर्न डिटेक्शन और आउटपुट पर ज्यादा नियंत्रण
भीड़ भरे कमरे में भी सटीक डायराइज़ेशन
मीटिंग ट्रांसक्रिप्ट में सही शब्दों जितना ही सही स्पीकर की पहचान करना भी महत्वपूर्ण है। तीन या उससे अधिक स्पीकर्स वाली रिकॉर्डिंग्स में Scribe v3, Scribe v2 की तुलना में 17% कम डायराइज़ेशन त्रुटियां करता है—यही वे रिकॉर्डिंग्स हैं जहां अधिकतर मौजूदा मॉडल विफल होते हैं। Scribe v3 Live भी पहली बार रियलटाइम ट्रांसक्रिप्शन में डायराइज़ेशन लाता है, और हमारे टेस्ट किए गए अगले सबसे अच्छे रियलटाइम मॉडल की तुलना में 39% कम डायराइज़ेशन त्रुटियां करता है।
टर्न डिटेक्शन जो बातचीत को समझता है
बातचीत को स्वाभाविक महसूस कराने के लिए, वॉइस एजेंट्स को सटीक रूप से अनुमान लगाना होता है कि स्पीकर ने कब बोलना खत्म कर दिया है। पारंपरिक टर्न-टेकिंग सिस्टम साइलेंस की अवधि के आधार पर ऐसा करते हैं। लेकिन सिर्फ साइलेंस एक समझौता मजबूर करता है: छोटी थ्रेशोल्ड रखने से वाक्य के बीच में रुकने वाले लोगों की बात कट सकती है, और लंबी थ्रेशोल्ड एजेंट को धीमा महसूस कराती है। Scribe v3 Live ऑडियो के साथ-साथ बातचीत के संदर्भ का भी उपयोग करता है, इसलिए नंबर के बीच में रुकने वाले कॉलर की बात नहीं कटती। यही टर्न डिटेक्शन ElevenAgents पहले से इस्तेमाल करता है, और अब यह ElevenAPI में भी उपलब्ध है।
भाषाओं, शब्दावली और फ़ॉर्मैटिंग पर ज्यादा नियंत्रण
Scribe v3 यह अनुमान लगा सकता है कि रिकॉर्डिंग में कौन-सी भाषाएं हो सकती हैं और आपको चुनने देता है कि नंबर अंकों में आएं या शब्दों में। कीटर्म प्रॉम्प्टिंग में आप ऐसे अधिकतम 1,000 शब्द जोड़ सकते हैं जिनके आने की आपको जानकारी है, जैसे ब्रांड नाम, संक्षिप्ताक्षर और विशेष शब्दावली। ट्रांसक्रिप्ट एडिट्स सादे अंग्रेज़ी में लिखे फ़ॉर्मैटिंग नियम लागू करते हैं, जैसे “हर तारीख YYYY-MM-DD के रूप में लिखें।”
Scribe v3 Live उन बातचीतों के लिए मल्टीलिंगुअल मोड जोड़ता है जिनमें वाक्य के बीच में भाषाएं बदलती हैं। यह उन शब्दावली के लिए कीटर्म लाइब्रेरी भी जोड़ता है जो एक सूची के लिए बहुत बड़ी है। जहां कीटर्म प्रॉम्प्टिंग उन शब्दों को कवर करती है जिनके आने की आपको जानकारी है, वहीं कीटर्म लाइब्रेरी में ऐसे हजारों शब्द होते हैं जो आ सकते हैं, और मॉडल केवल संभावित मिलान सुनने पर ही इसे देखता है।
Scribe v3 का प्रदर्शन कैसा है
ElevenLabs ने दोनों मॉडलों का मूल्यांकन Scribe v2, Scribe v2 Realtime और अन्य लोकप्रिय स्पीच टू टेक्स्ट मॉडलों के मुकाबले किया और सभी को एक ही डेटासेट पर स्कोर किया। मल्टीलिंगुअल सटीकता को FLEURS बेंचमार्क के एक आंतरिक संस्करण पर मापा गया, जो 102 भाषाओं में छोटे, साफ़ पढ़े गए भाषण को टेस्ट करता है। FLEURS डायराइज़ेशन को नहीं माप सकता, क्योंकि हर क्लिप में एक स्पीकर होता है। इसलिए हमने 16 भाषाओं में वास्तविक मीटिंग्स, एजेंट कॉल्स और वॉइस नोट्स का अपना डेटासेट भी बनाया। हम इसे जल्द ही ओपन सोर्स करेंगे।
स्पीकर डायराइज़ेशन
हमारे टेस्ट किए गए सभी मॉडलों में Scribe v3 की डायराइज़ेशन त्रुटि सबसे कम है—कुल मिलाकर Scribe v2 से 12% कम और तीन या उससे अधिक स्पीकर्स वाली रिकॉर्डिंग्स में 17% कम।
मल्टीलिंगुअल ट्रांसक्रिप्शन सटीकता
हम वर्ड एरर रेट (WER) के साथ सेमांटिक WER भी रिपोर्ट करते हैं, जो केवल तब त्रुटि गिनता है जब ट्रांसक्रिप्ट का अर्थ बदलता है।
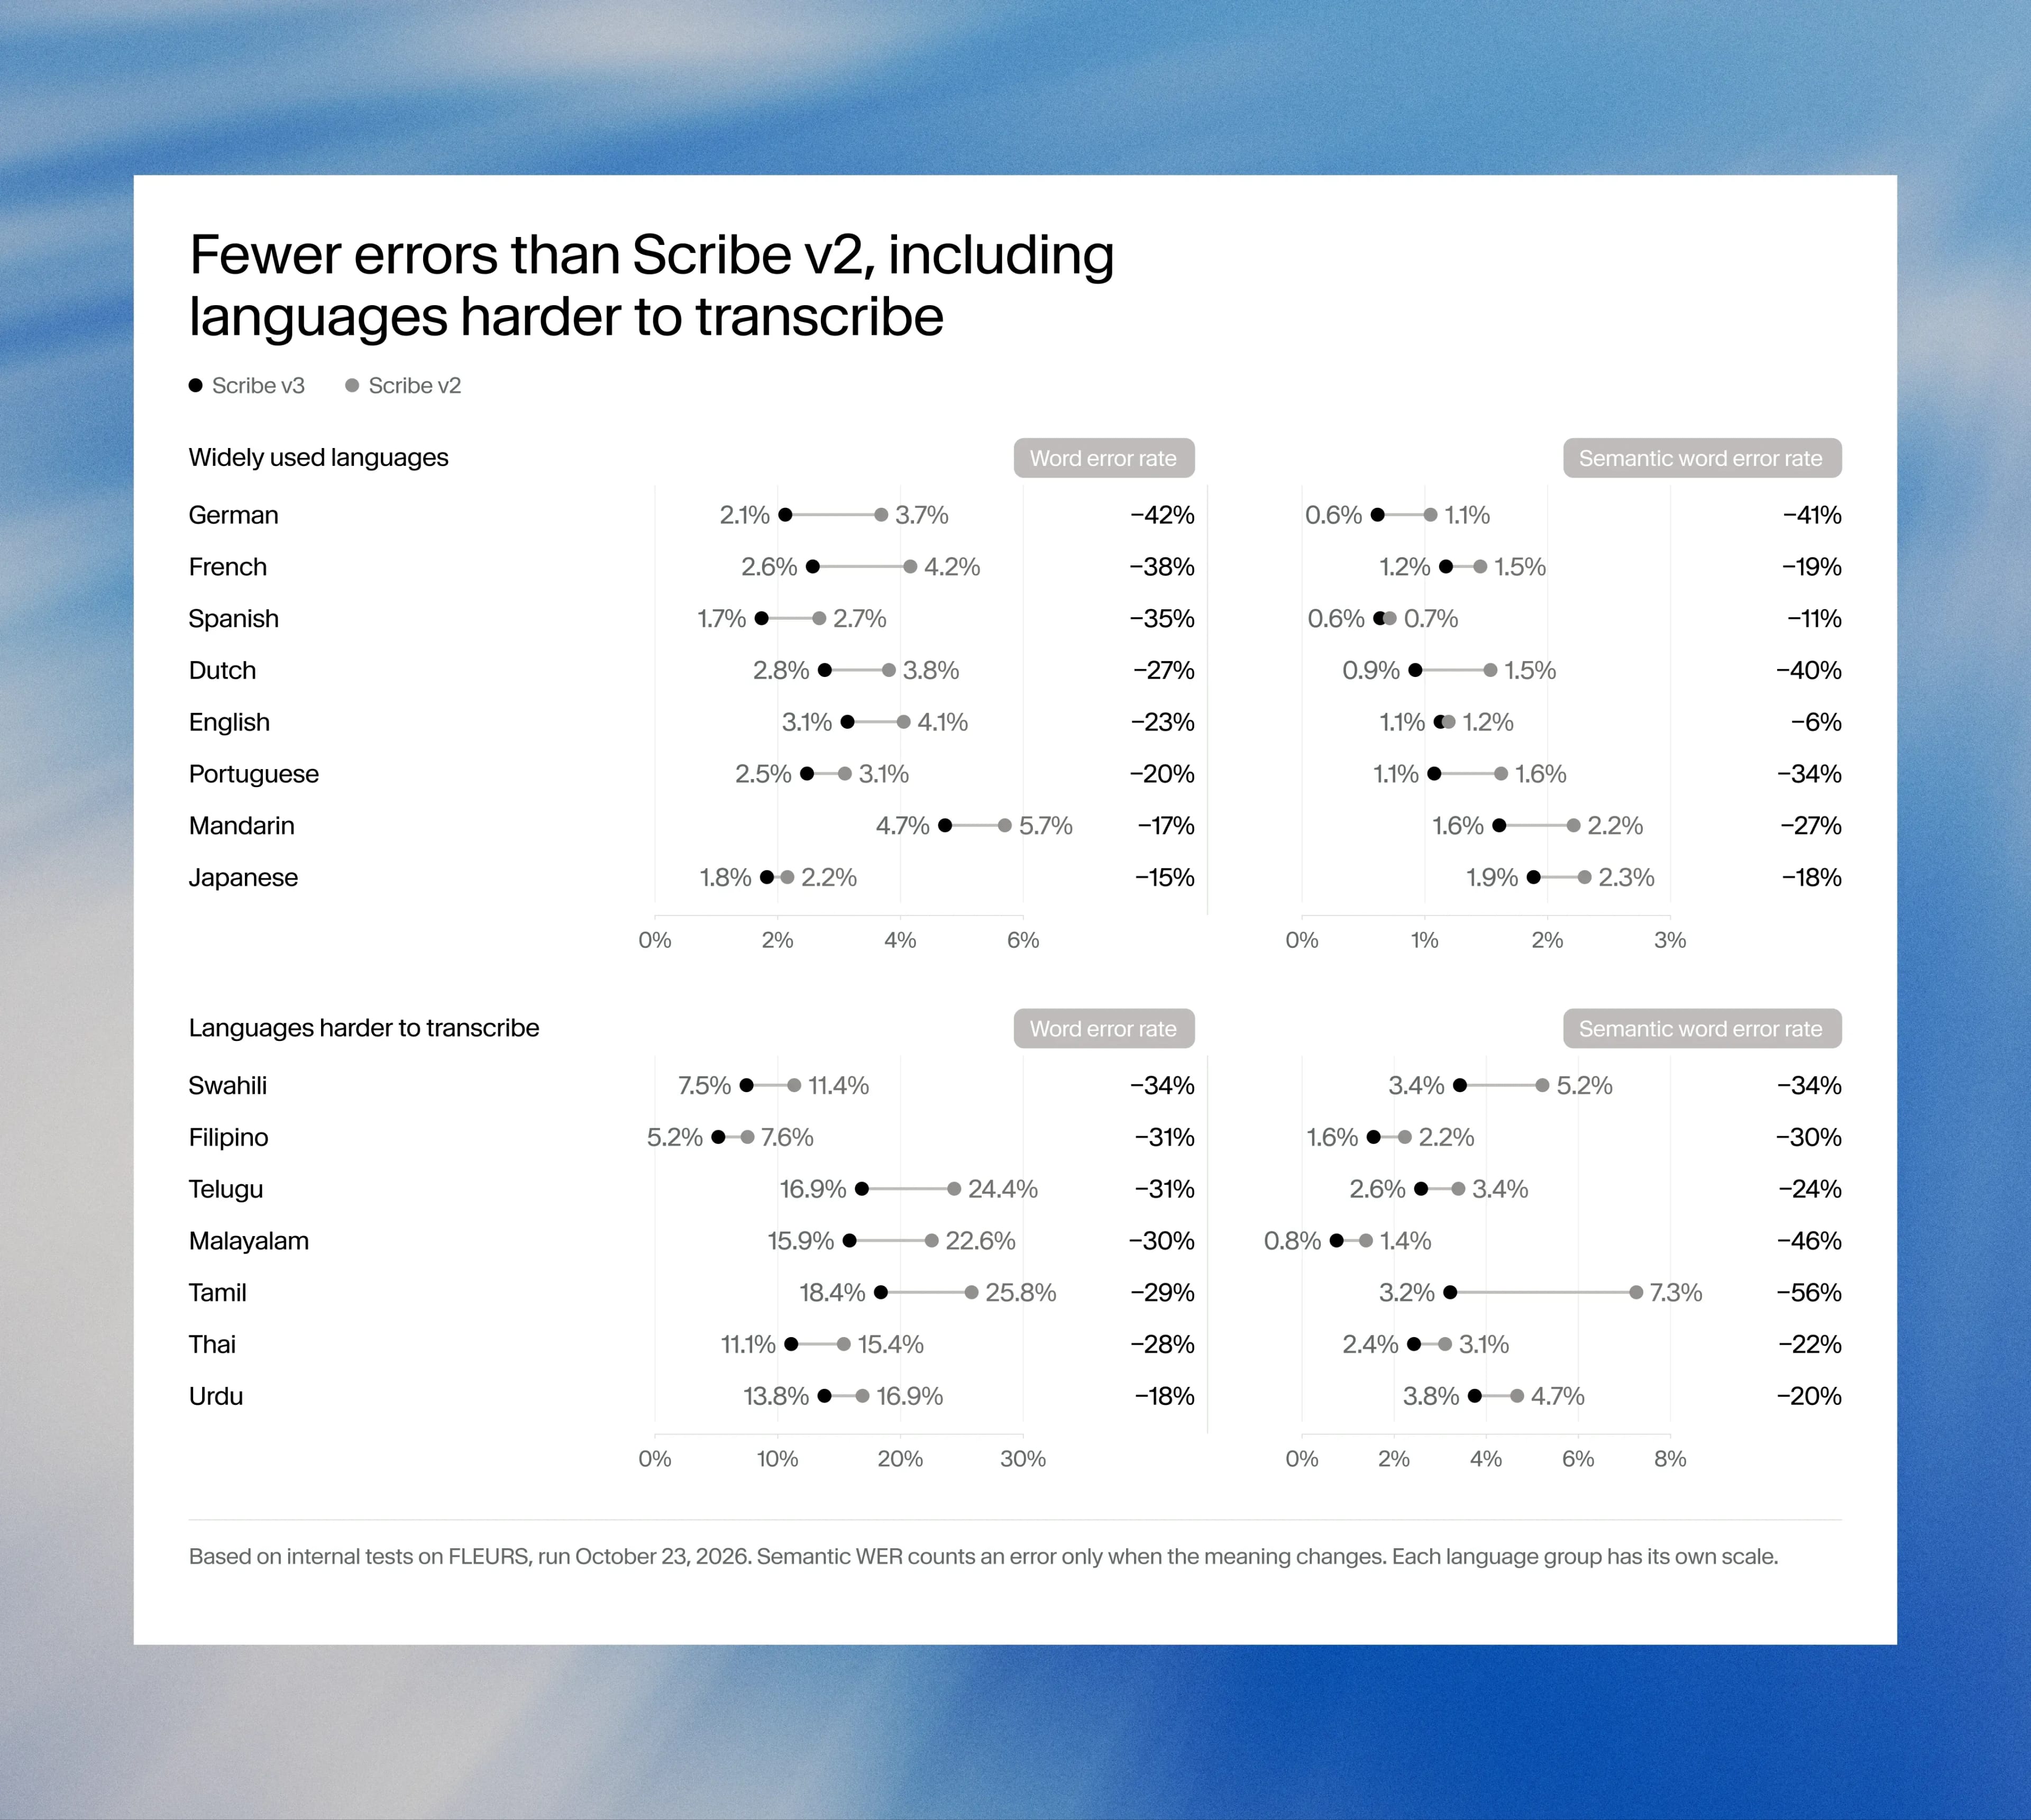
FLEURS पर 102 भाषाओं में, Scribe v3, Scribe v2 की तुलना में WER को 27% घटाता है और टेस्ट की गई हर भाषा में बेहतर प्रदर्शन करता है। ट्रांसक्राइब करने में आसान भाषाओं में जर्मन में 42%, स्पैनिश में 35% और अंग्रेज़ी में 23% सुधार हुआ। ट्रांसक्राइब करने में कठिन भाषाओं में सुधार और भी बड़ा है: स्वाहिली में 34%, तमिल में 29% और थाई में 28% की कमी आई।
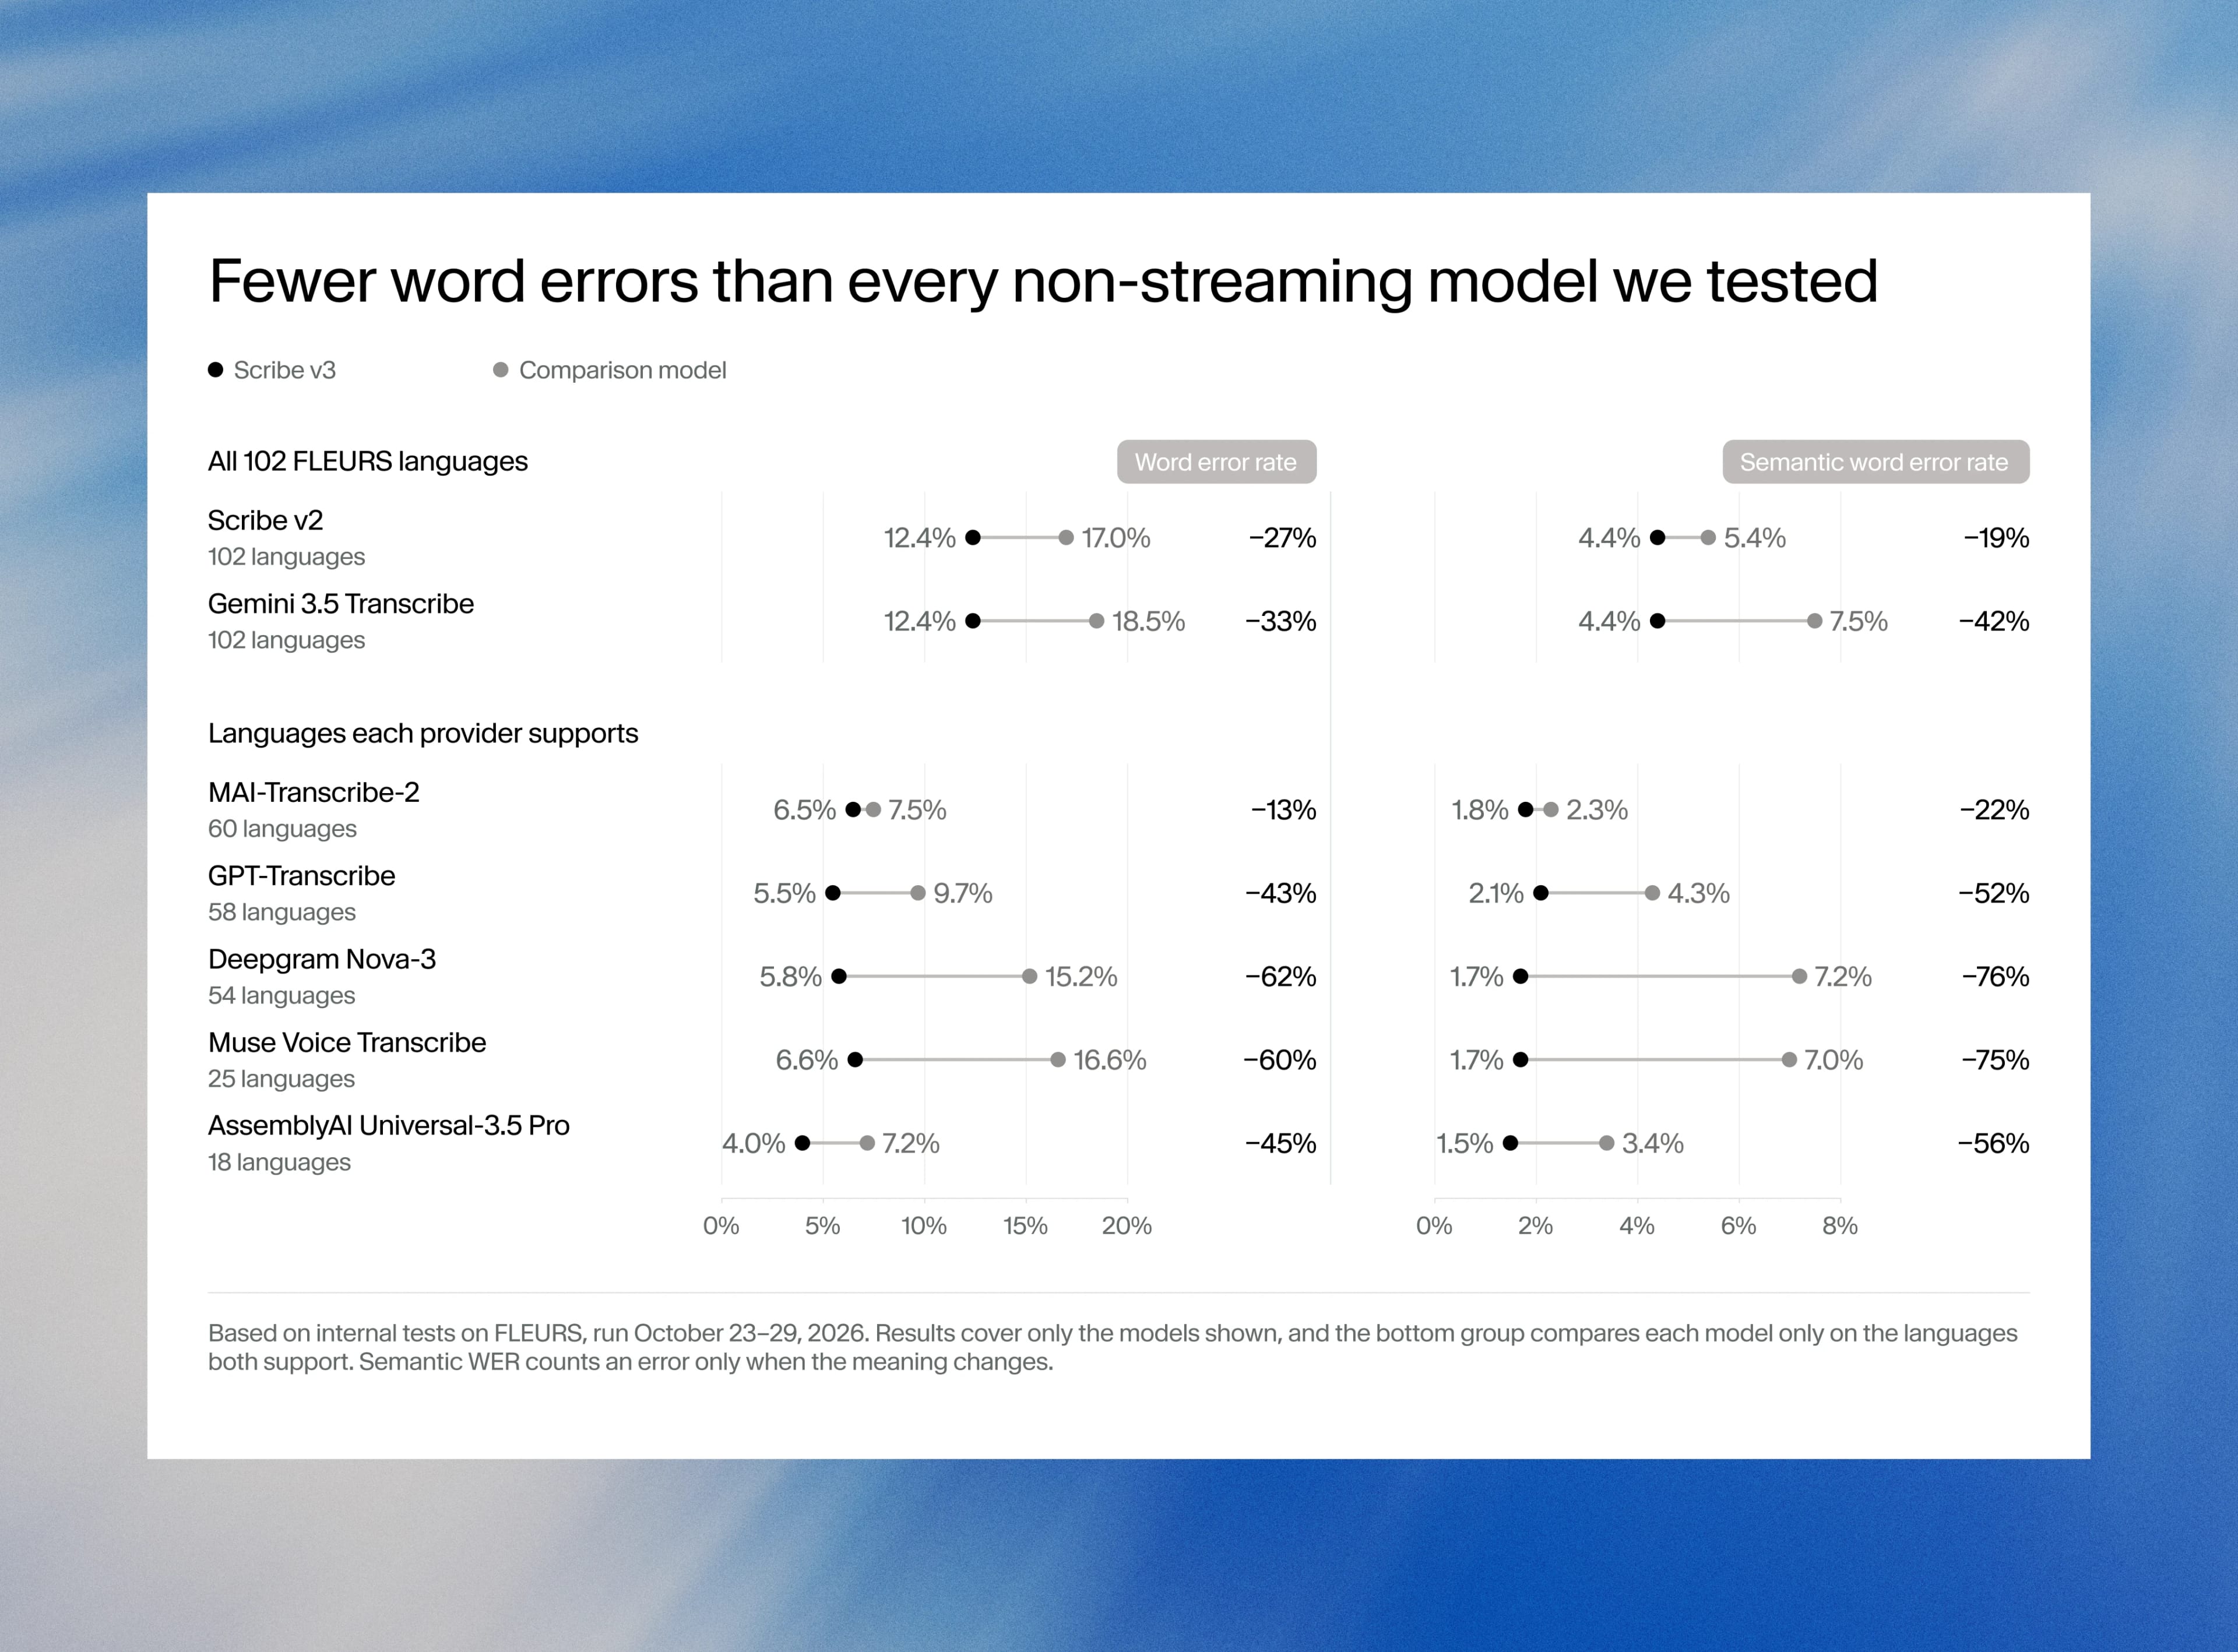
Scribe v3, हमारे टेस्ट किए गए हर दूसरे बैच (नॉन-स्ट्रीमिंग) मॉडल से भी कम शब्द त्रुटियां करता है। हमने प्रत्येक की तुलना उन भाषाओं पर की है जिन्हें दोनों मॉडल सपोर्ट करते हैं।
रियलटाइम में स्पीकर डायराइज़ेशन
हमारे 16-भाषा वाले वास्तविक दुनिया के डेटासेट के अंग्रेज़ी हिस्से में, Scribe v3 Live की डायराइज़ेशन एरर रेट 3.1% है, जबकि हमारे टेस्ट किए गए अन्य रियलटाइम मॉडलों की 5.9% से 7.3% है।
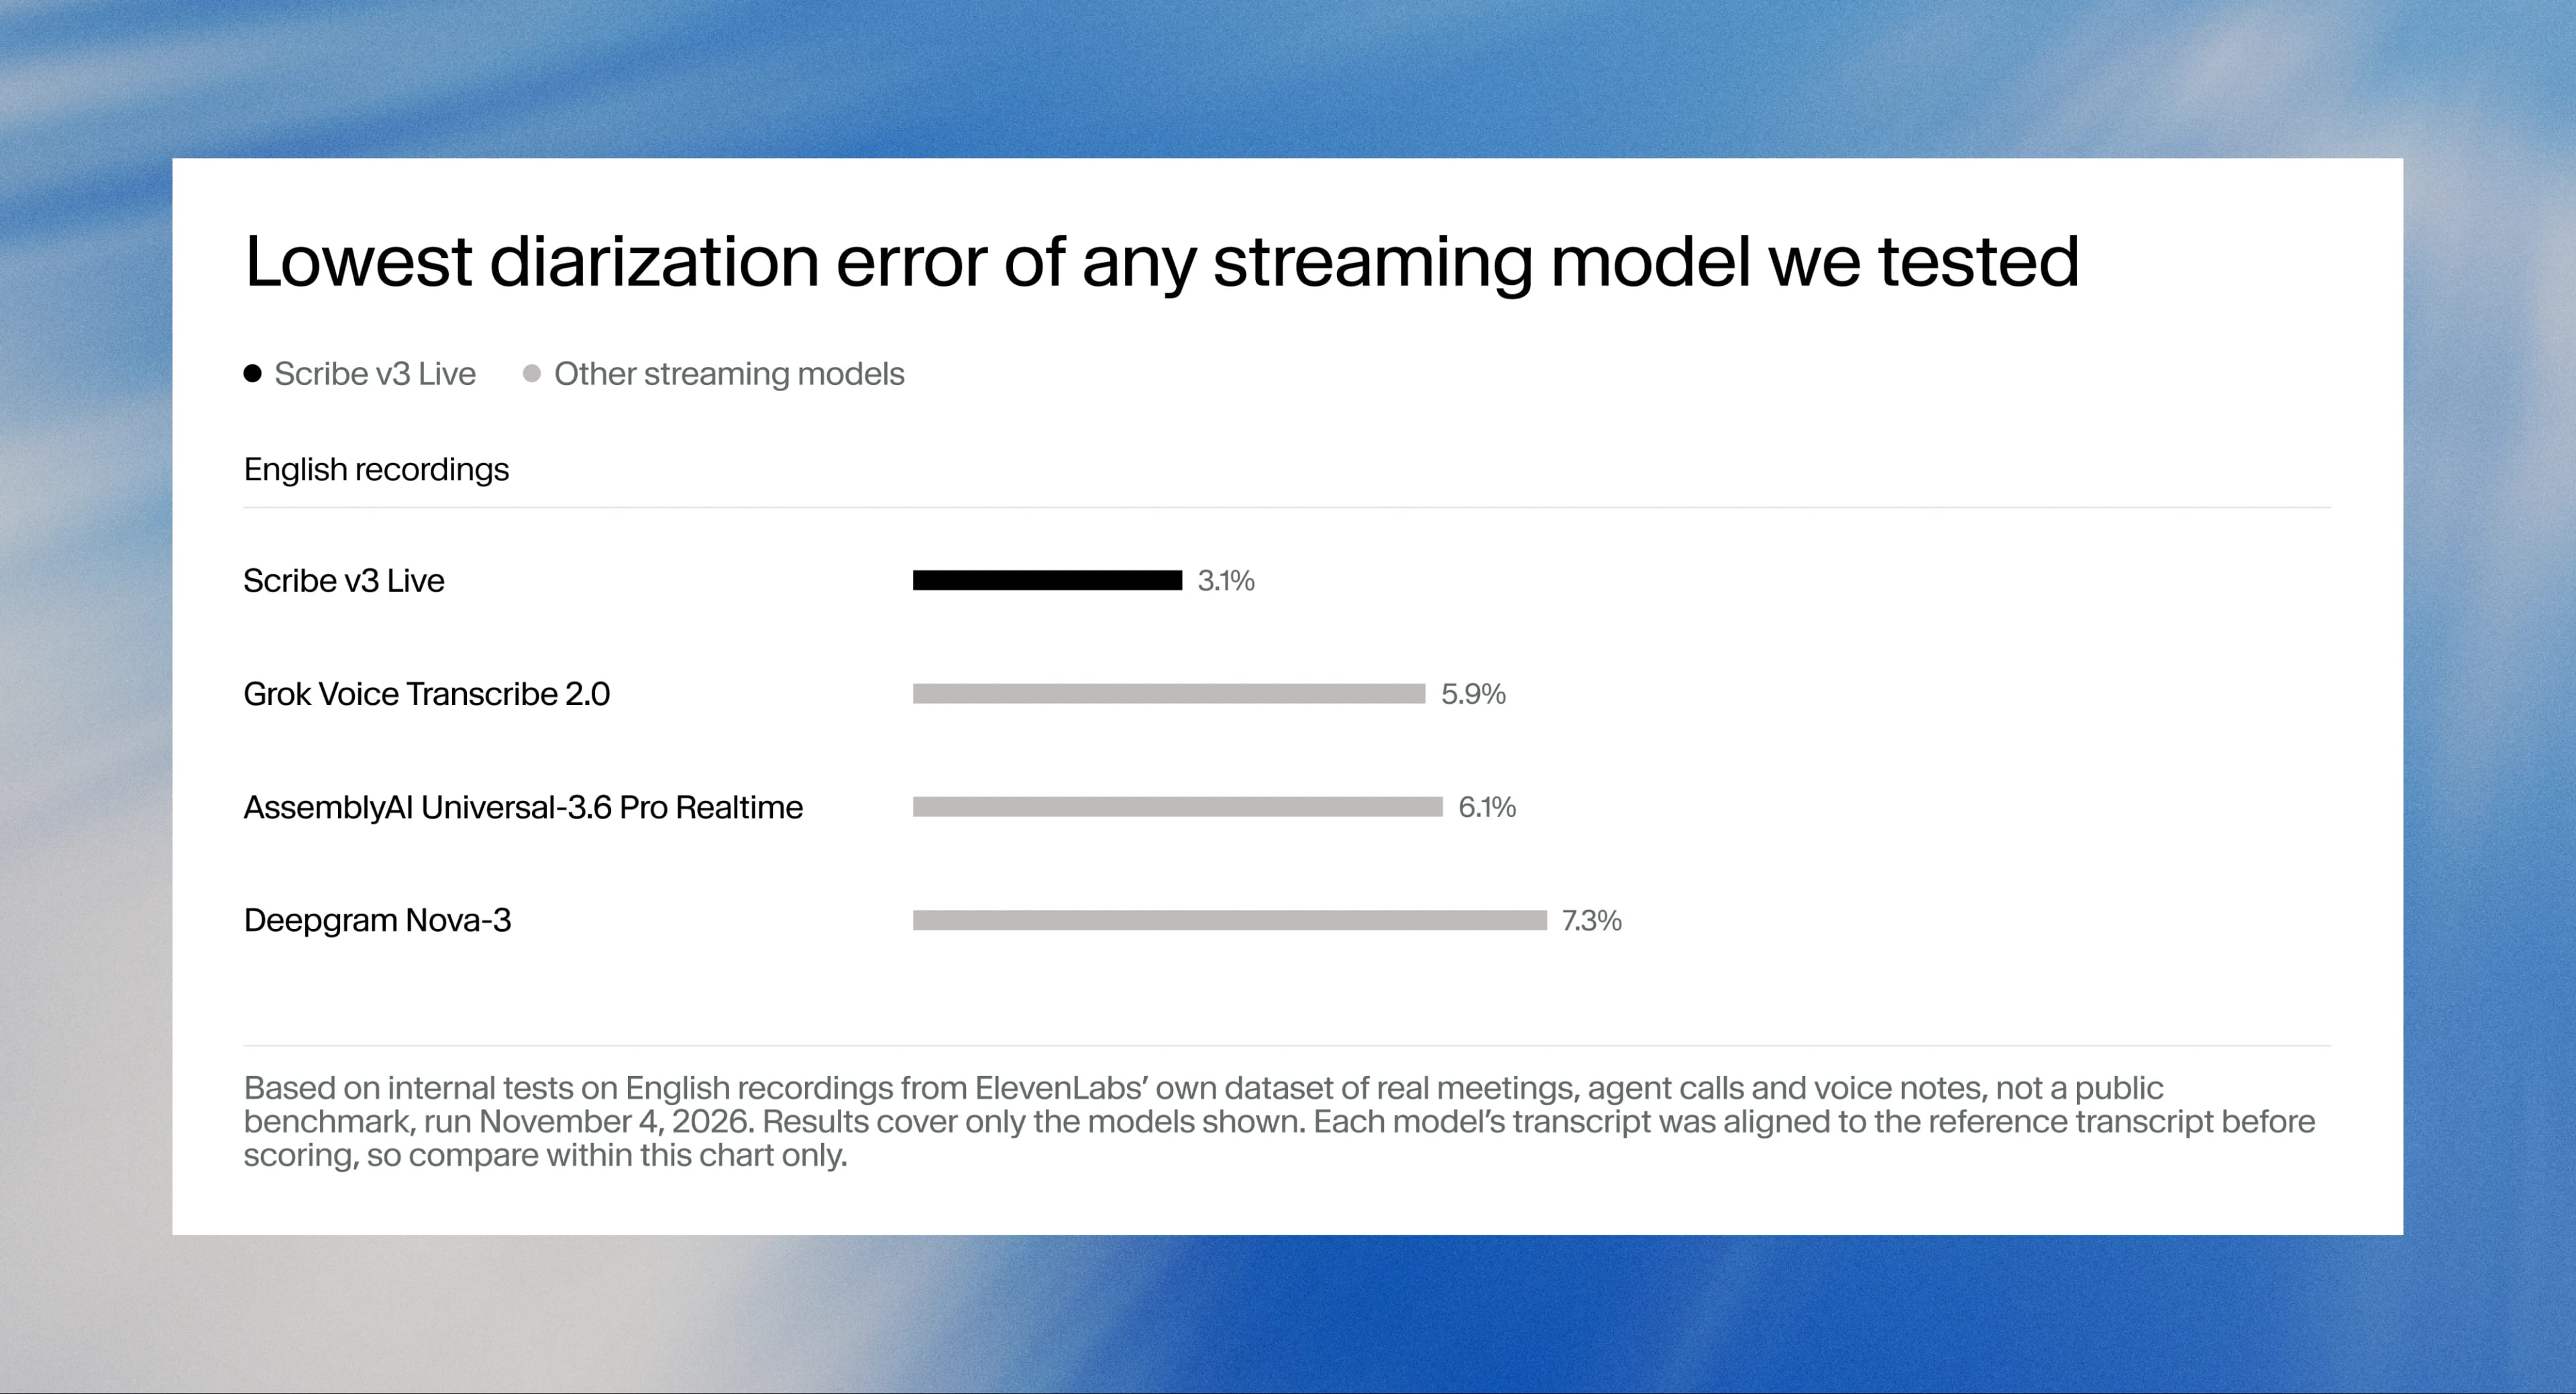
मानक डायराइज़ेशन स्कोर ट्रांसक्रिप्शन की गलतियां भी गिनते हैं, जैसे छूटे हुए शब्द, और रियलटाइम मॉडल बैच मॉडलों से ज्यादा शब्द छोड़ते हैं। केवल यह मापने के लिए कि हर शब्द सही स्पीकर को दिया गया था या नहीं, हमने स्कोरिंग से पहले हर मॉडल के ट्रांसक्रिप्ट को रेफरेंस के साथ अलाइन किया। इससे हर मॉडल की एरर रेट कम हो जाती है, इसलिए इन नतीजों की तुलना ऊपर दिए बैच डायराइज़ेशन नतीजों से नहीं की जा सकती।
रियलटाइम में मल्टीलिंगुअल सटीकता
रियलटाइम मॉडलों के लिए हम सेमांटिक WER को प्राथमिकता देते हैं। एक स्ट्रीमिंग मॉडल पूरा वाक्य सुनने से पहले ही टेक्स्ट लिखता है, और हर प्रोवाइडर नंबर, विराम चिह्न और अक्षरों के केस को अलग तरह से फ़ॉर्मैट करता है। मानक WER इन अंतरों को, अर्थ समान होने पर भी, त्रुटि मानता है, इसलिए सेमांटिक WER अधिक निष्पक्ष तुलना है।
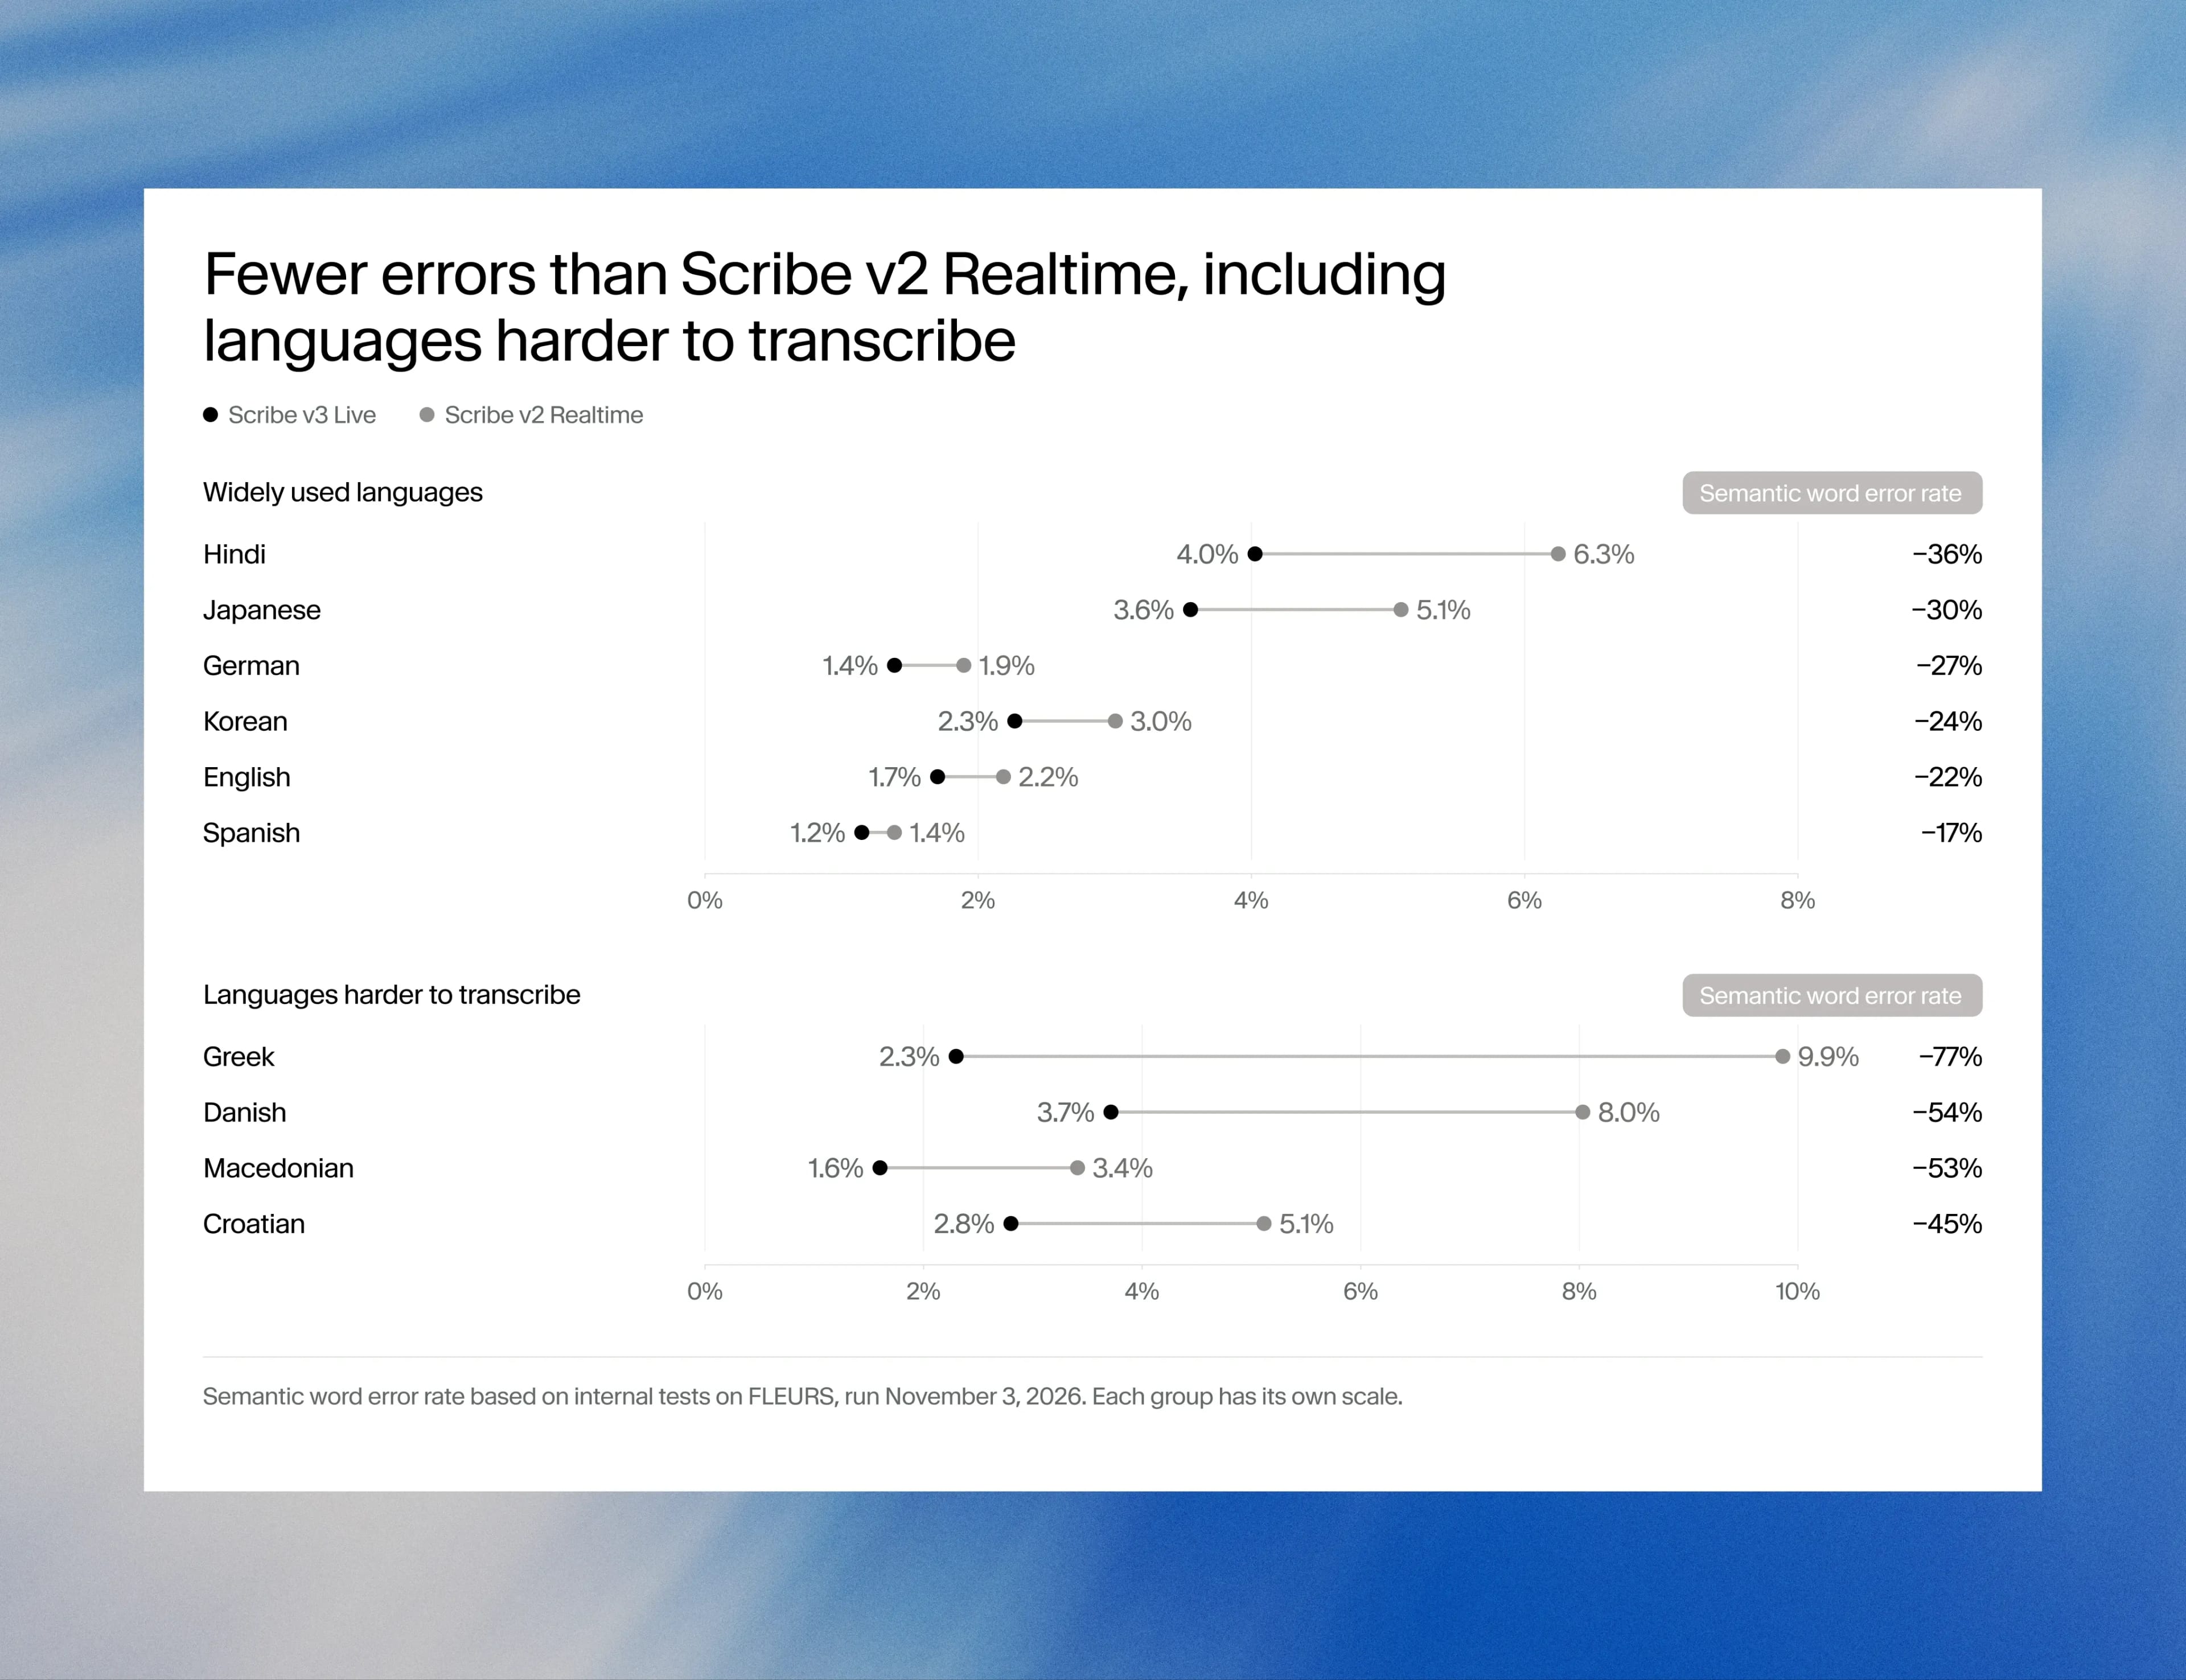
102 भाषाओं में, Scribe v3 Live, Scribe v2 Realtime की तुलना में सेमांटिक WER को 43% और WER को 31% कम करता है। यह हर भाषा में बेहतर प्रदर्शन करता है और हमारे टेस्ट किए गए हर दूसरे रियलटाइम मॉडल से इसकी एरर रेट कम है।
सुधार उन जगहों पर सबसे बड़े हैं जहां रियलटाइम ट्रांसक्रिप्शन पीछे रहा है: ग्रीक में 77%, डेनिश में 54% और क्रोएशियन में 45% सुधार हुआ, जबकि हिंदी में 36% सुधार हुआ।
तरीके पर एक नोट: औसत निकालने से पहले हमने हर भाषा को अलग-अलग स्कोर किया, इसलिए सभी 102 भाषाओं का महत्व बराबर है। कई प्रकाशित नतीजों में हर क्लिप को मिलाकर एक ही स्कोर बनाया जाता है, जिससे आंकड़े कम होते हैं। इसलिए अलग-अलग तरीकों से मापे गए नतीजों की सीधे तुलना नहीं की जा सकती।
सटीकता के कुछ पॉइंट्स का महत्व
हर मॉडल लॉन्च के साथ प्रतिशत आते हैं, इसमें भी, लेकिन कागज़ पर यह समझना मुश्किल है कि वास्तविक परिस्थितियों में कुछ पॉइंट्स का क्या अर्थ होता है। 150 शब्द प्रति मिनट की रफ्तार वाली एक घंटे की मीटिंग में करीब 9,000 शब्द होते हैं, इसलिए 4% और 2% वर्ड एरर रेट के बीच का अंतर 180 गलत शब्दों का है—जब कोई बोल रहा हो, उसके हर मिनट के तीन शब्द। डायराइज़ेशन त्रुटि शब्दों के बजाय समय में मापी जाती है, इसलिए उसी मीटिंग में हर पॉइंट का मतलब है कि 36 सेकंड का भाषण गलत नाम के तहत दर्ज हुआ।
इन त्रुटियों की लागत इस बात पर निर्भर करती है कि वे कहां होती हैं। पॉडकास्ट ट्रांसक्रिप्ट में गलत शब्द एक टाइपो है, लेकिन अर्निंग्स कॉल में “fifteen” को “fifty” सुन लिया जाए तो वह किसी एनालिस्ट के मॉडल में पहुंच जाता है। त्रुटियां नामों, नंबरों, संक्षिप्ताक्षरों और विशेष शब्दावली में भी अधिक होती हैं—यही वे शब्द हैं जिन्हें किसी सारांश या एजेंट को सबसे सही समझना होता है।
ElevenAgents में पहली बार में सही परिणाम
वॉइस एजेंट्स पर इसका असर सबसे ज्यादा पड़ता है, क्योंकि गलत सुना गया एक अंक भी कॉल शुरू करने वाला चेक फेल कर सकता है। नीदरलैंड्स में 20 लाख से अधिक घरों और व्यवसायों को ऊर्जा देने वाली Eneco अपने वॉइस एजेंट को ElevenAgents पर चलाती है और उसने लॉन्च से पहले उस पर Scribe v3 Live का टेस्ट किया। वास्तविक ग्राहक कॉल्स में एजेंट ने पहली कोशिश में डच पोस्टकोड को 40% अधिक बार और घर के नंबरों को 15% अधिक बार सही पहचाना।
Eneco के सीनियर प्रोडक्ट मैनेजर Ruud Huigsloot ने कहा, “ElevenLabs, Eneco का सच्चा पार्टनर है। उनके फॉरवर्ड डिप्लॉयड इंजीनियर्स के साथ मिलकर हम अपने वॉइस एजेंट को और बेहतर बनाने पर काम कर रहे हैं। इतनी जल्दी महत्वपूर्ण नतीजे देखना शानदार है और हम आगे भी सहयोग जारी रखने को लेकर उत्साहित हैं।”
एंटरप्राइज़ के लिए बनाया गया
Scribe v3 और Scribe v3 Live डिफ़ॉल्ट रूप से अमेरिका में चलते हैं और डेटा रेजिडेंसी की ज़रूरत वाले एंटरप्राइज़ ग्राहकों के लिए अलग EU, भारत और सिंगापुर एनवायरनमेंट्स में उपलब्ध हैं। Zero Retention Mode अनुरोध पूरा होते ही ऑडियो और टेक्स्ट हटा देता है। दोनों मॉडल हमारे SOC 2, ISO 27001 और PCI DSS Level 1 प्रोग्राम्स के अंतर्गत आते हैं, Business Associate Agreement के साथ HIPAA-eligible हैं और प्राइवेट डिप्लॉयमेंट के लिए उपलब्ध हैं।
आज ही शुरू करें
Scribe v3 Live ElevenAgents में उपलब्ध है, और v3 व v3 Live दोनों ElevenLabs ऐप में डिफ़ॉल्ट हैं। इसे आज़माने के लिए Sign up करें।
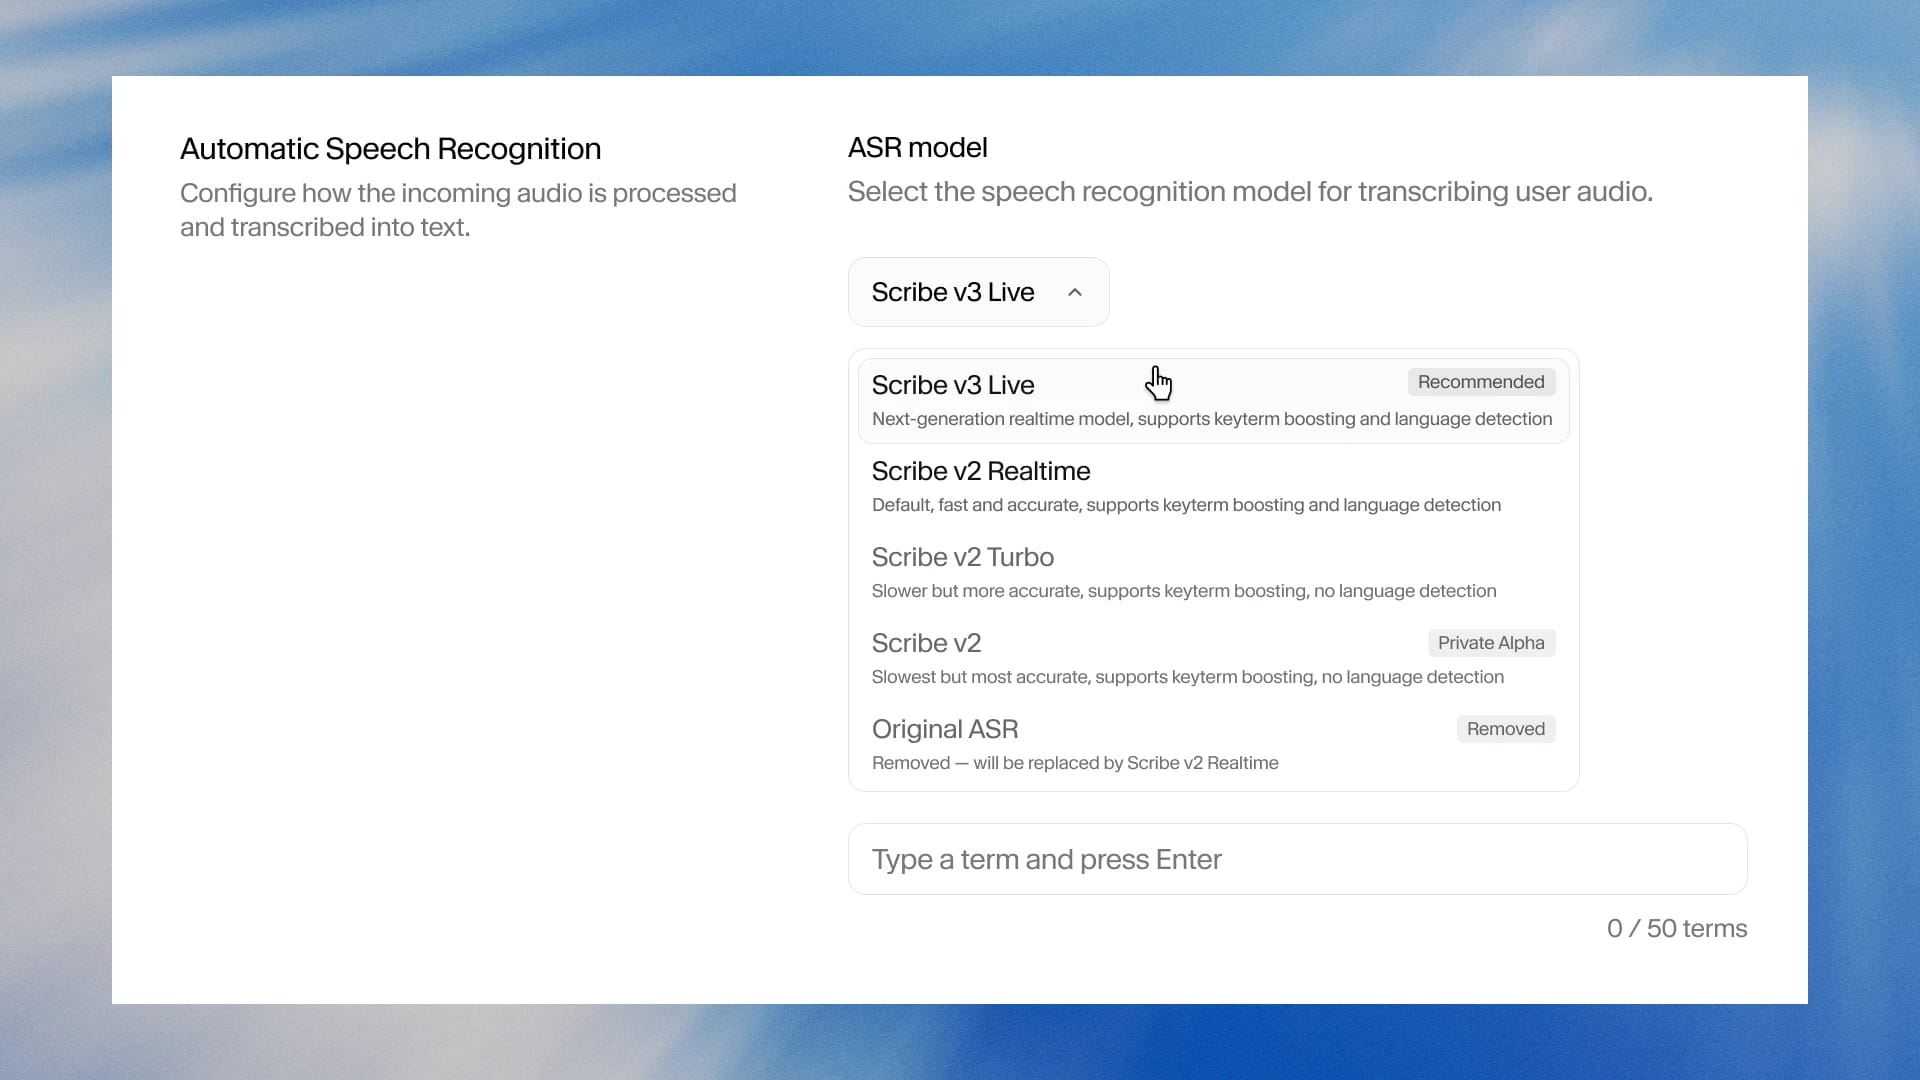
दोनों मॉडल आज ElevenAPI में भी उपलब्ध हैं। मौजूदा इंटीग्रेशन्स मॉडल ID को scribe_v3 या scribe_v3_live में बदलकर अपग्रेड कर सकते हैं।
हेल्थकेयर टीमों के लिए, हम ElevenAgents में चिकित्सा संबंधी बातचीत के लिए ऑप्टिमाइज़ किया गया Scribe v3 Live का एक वर्जन भी जारी कर रहे हैं।
Min, ElevenLabs की ग्रोथ टीम में हैं और ElevenAPI व ऑन-प्रेम/ऑन-डिवाइस पर काम करते हैं। इससे पहले, वे Stainless में दूसरी GTM हायर के रूप में प्रोडक्ट मार्केटिंग लीड करते थे। उससे पहले वे WorkOS में शुरुआती PMM थे, जहाँ उन्होंने लॉन्च, एनेबलमेंट, कंटेंट और ग्रोथ को आगे बढ़ाया।