Scribe v2 Medical ya está disponible para todos
- Escrito por
- Min Kim
- Publicado
EscucharEscucha este artículo
El audio clínico es una de las pruebas más difíciles para el reconocimiento de voz preciso. Los nombres de medicamentos son largos, poco frecuentes y fáciles de confundir (hydroxyzine y hydralazine se diferencian por una sílaba mal interpretada). El vocabulario es denso, con dosis, unidades y términos de anatomía y patología que pueden aparecer en rápida sucesión. Además, hay más en juego, ya que un error de transcripción podría afectar a la atención de un paciente.
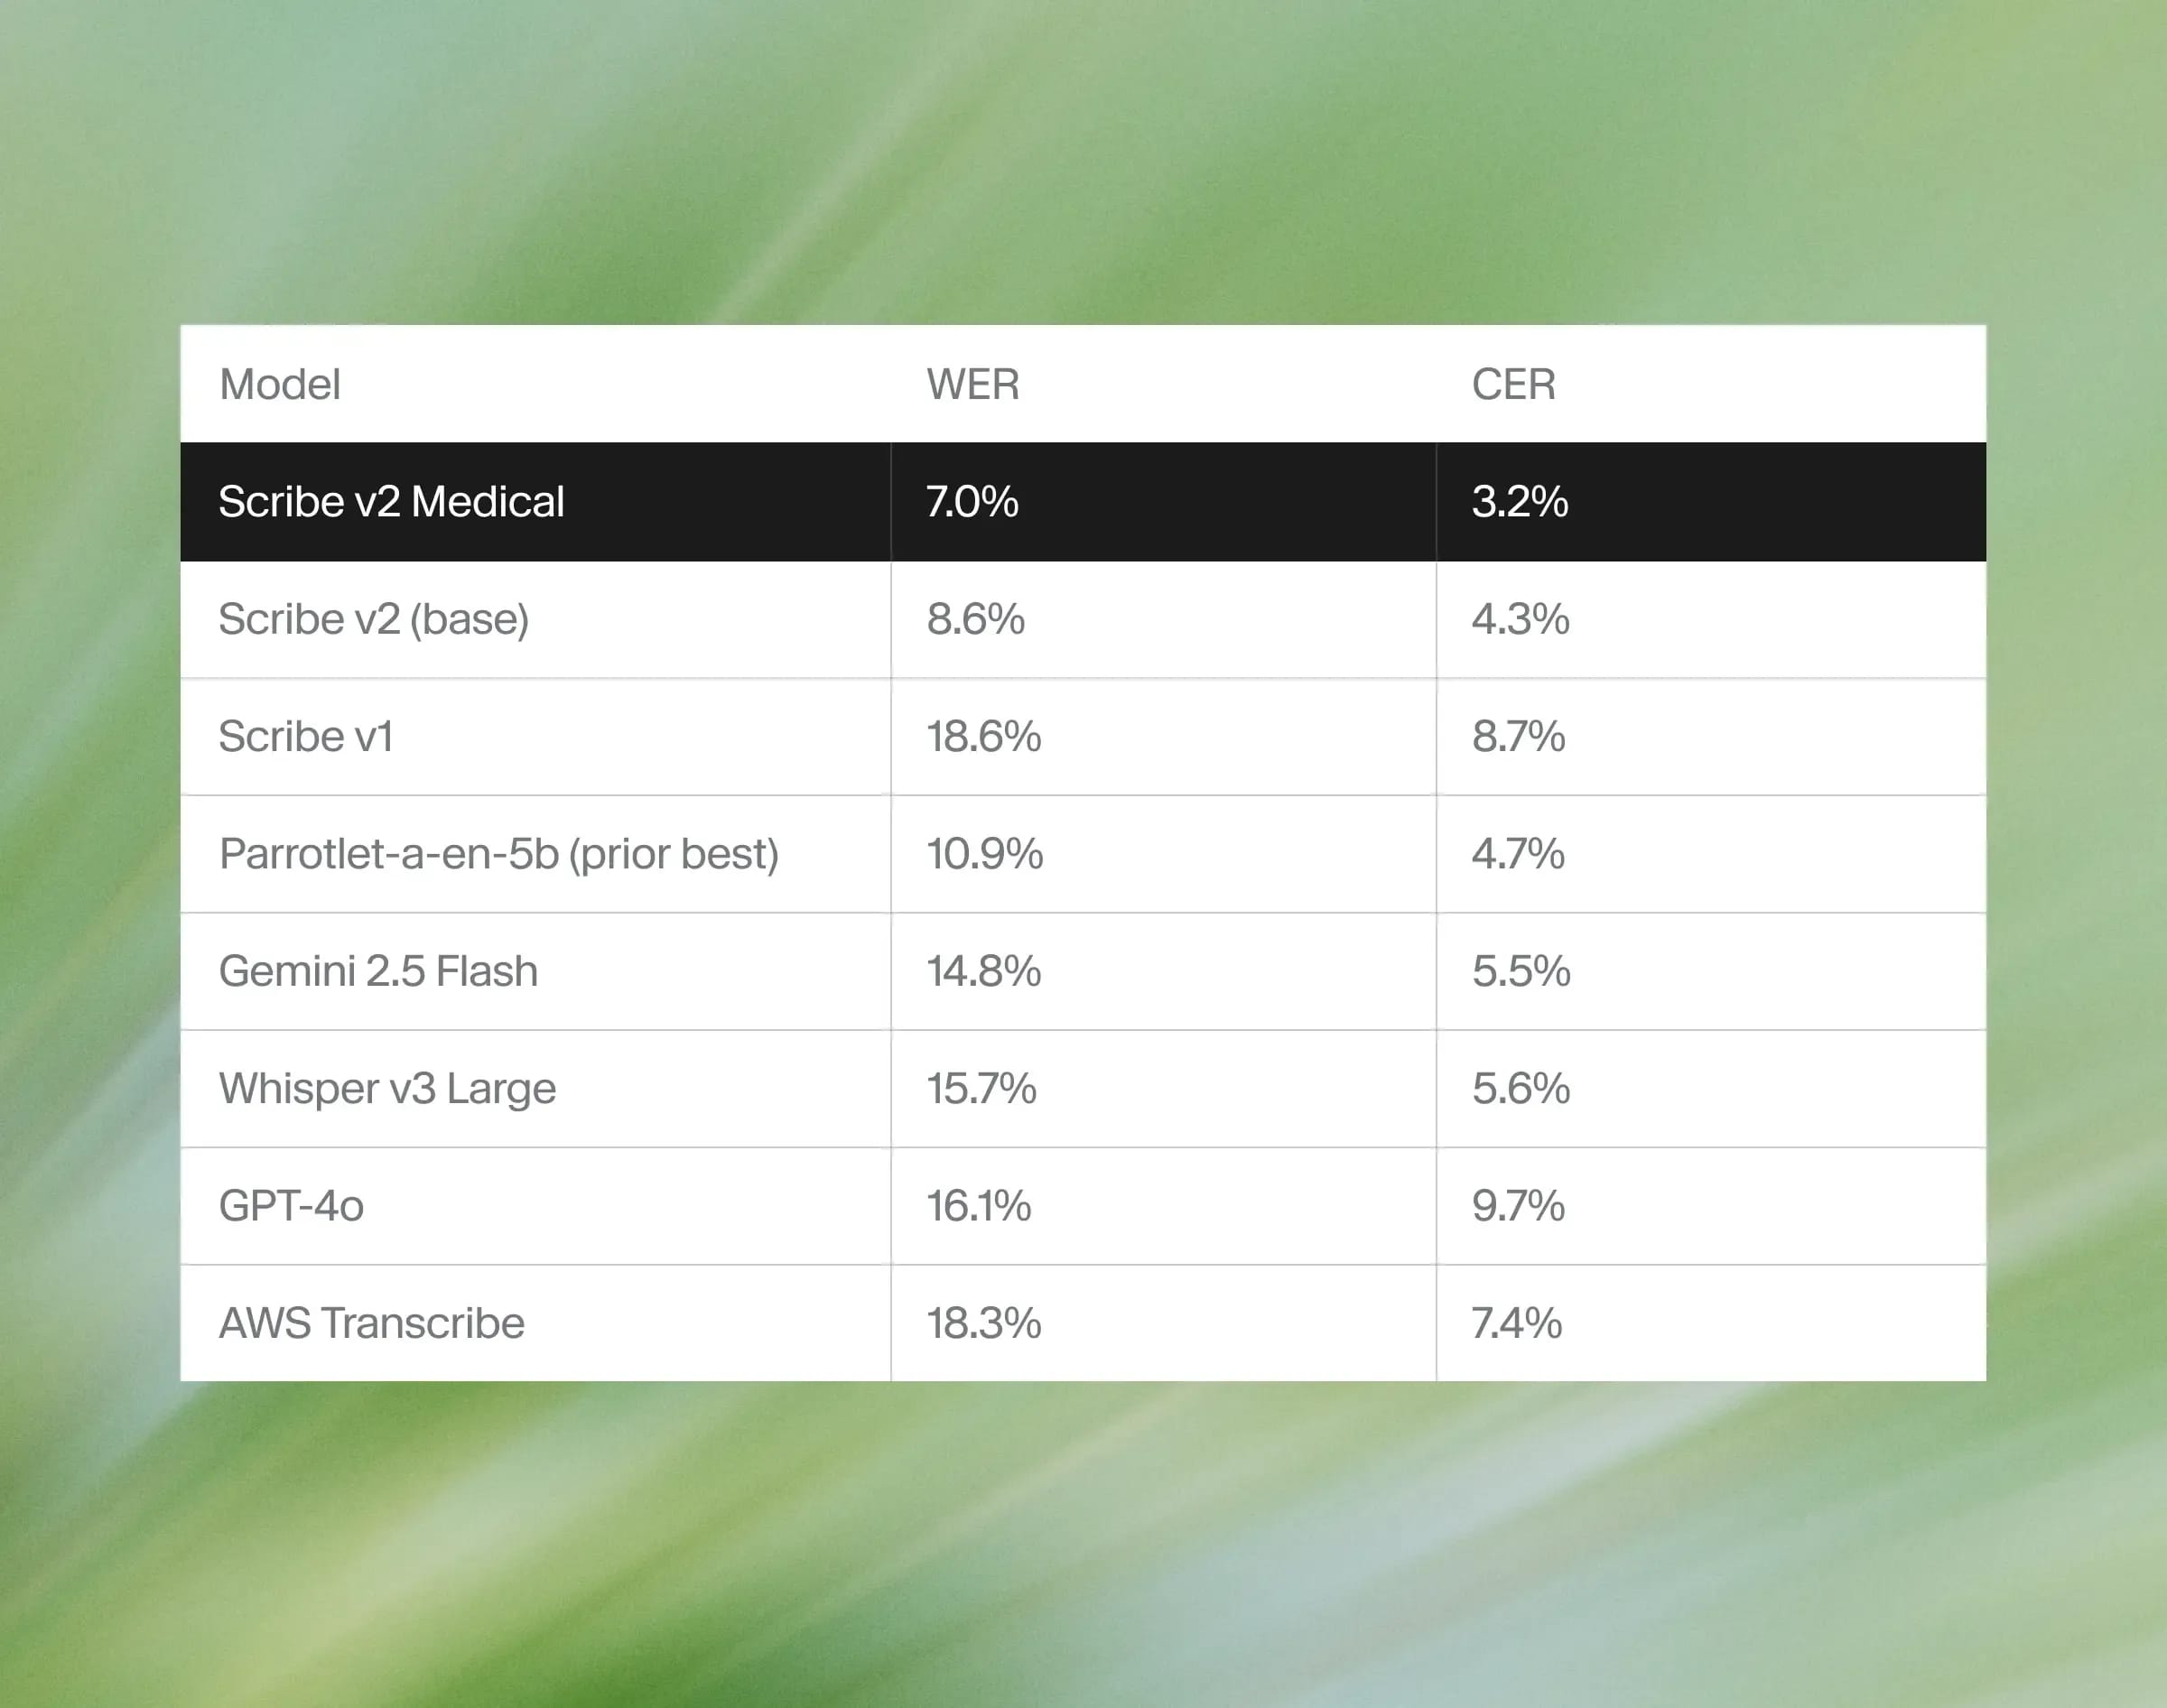
Por eso, ElevenLabs lanza hoy Scribe v2 Medical, nuestro modelo de Voz a Texto ajustado para audio clínico, que ya está disponible de forma general en ElevenAPI. En las pruebas de ElevenLabs, logra la tasa de error de palabras (WER) más baja en benchmarks de ASR médico y reduce el WER en audio clínico un 18 % frente a nuestro modelo base Scribe v2.
Los modelos de propósito general gestionan muy bien el habla cotidiana, pero pierden rendimiento justo donde más los necesitan los flujos de trabajo clínicos. Entrenamos un ajuste médico de Scribe v2 centrado en nombres de medicamentos y dictado clínico, con benchmarks públicos que cualquiera puede reproducir.
Scribe v2 Medical es la opción clara para casos de uso clínicos
Benchmark de ASR médico de Eka
En pruebas internas, Scribe v2 Medical logra un WER más bajo en las pruebas de ElevenLabs que cualquier resultado publicado en el benchmark de ASR médico de Eka. El conjunto de datos de evaluación contiene 3619 muestras de audio clínico en inglés —con nombres aislados de medicamentos y enfermedades, frases clínicas y conversaciones entre profesionales sanitarios y pacientes—, con anotaciones por término y una clasificación publicada en la ficha del conjunto de datos.
Benchmark de Voz a Texto médico de Omi Health
El rendimiento se demuestra más allá de un único benchmark. Omi Health mantiene una clasificación pública de 30 sistemas de voz a texto evaluados con 1513 clips clínicos en inglés (7,2 horas repartidas en 57 consultas).
Omi evaluó Scribe v2 Medical directamente en este benchmark. Registra el WER global más bajo de los 30 sistemas probados (5,88 %) y mejora sustancialmente la precisión de las dosis frente a Scribe v2 base (86,2 % frente a 79,8 %).
El benchmark de Omi se actualizará con los resultados de Scribe v2 Medical el 25 de septiembre, y compartimos las cifras anteriores con su permiso antes de esa actualización.
Clientes en producción
Clientes ya están usando Scribe v2 Medical en producción y observando mejoras en el audio clínico.
«Desde que cambiamos de Deepgram a ElevenLabs Scribe v2 Medical, estamos viendo una precisión mucho mayor en la terminología clínica, y eso ha cambiado la forma de trabajar del equipo», afirma Mendel Erlenwein, CEO y fundador de CareCo. «Cuando nuestros coordinadores confían en las transcripciones, pueden dedicar menos tiempo a corregir notas y más a hablar por teléfono con pacientes. Nuestros pacientes siguen tratamientos complejos, y la nota que lee el equipo de atención tiene que ser correcta».
Mejoras que más importan
El WER de una transcripción completa a veces puede ocultar lo que más importa en un entorno clínico, porque incluso las conversaciones clínicas se componen principalmente de habla cotidiana. Eka anota los términos médicos de cada muestra, por lo que es posible evaluar solo esos términos. En el WER de términos médicos, Scribe v2 Medical comete un 14 % menos de errores que el modelo base (9,5 % frente a 11,1 %), y las mejoras son mayores cuando los términos aparecen dentro de frases completas (7,5 % frente a 9,9 %).
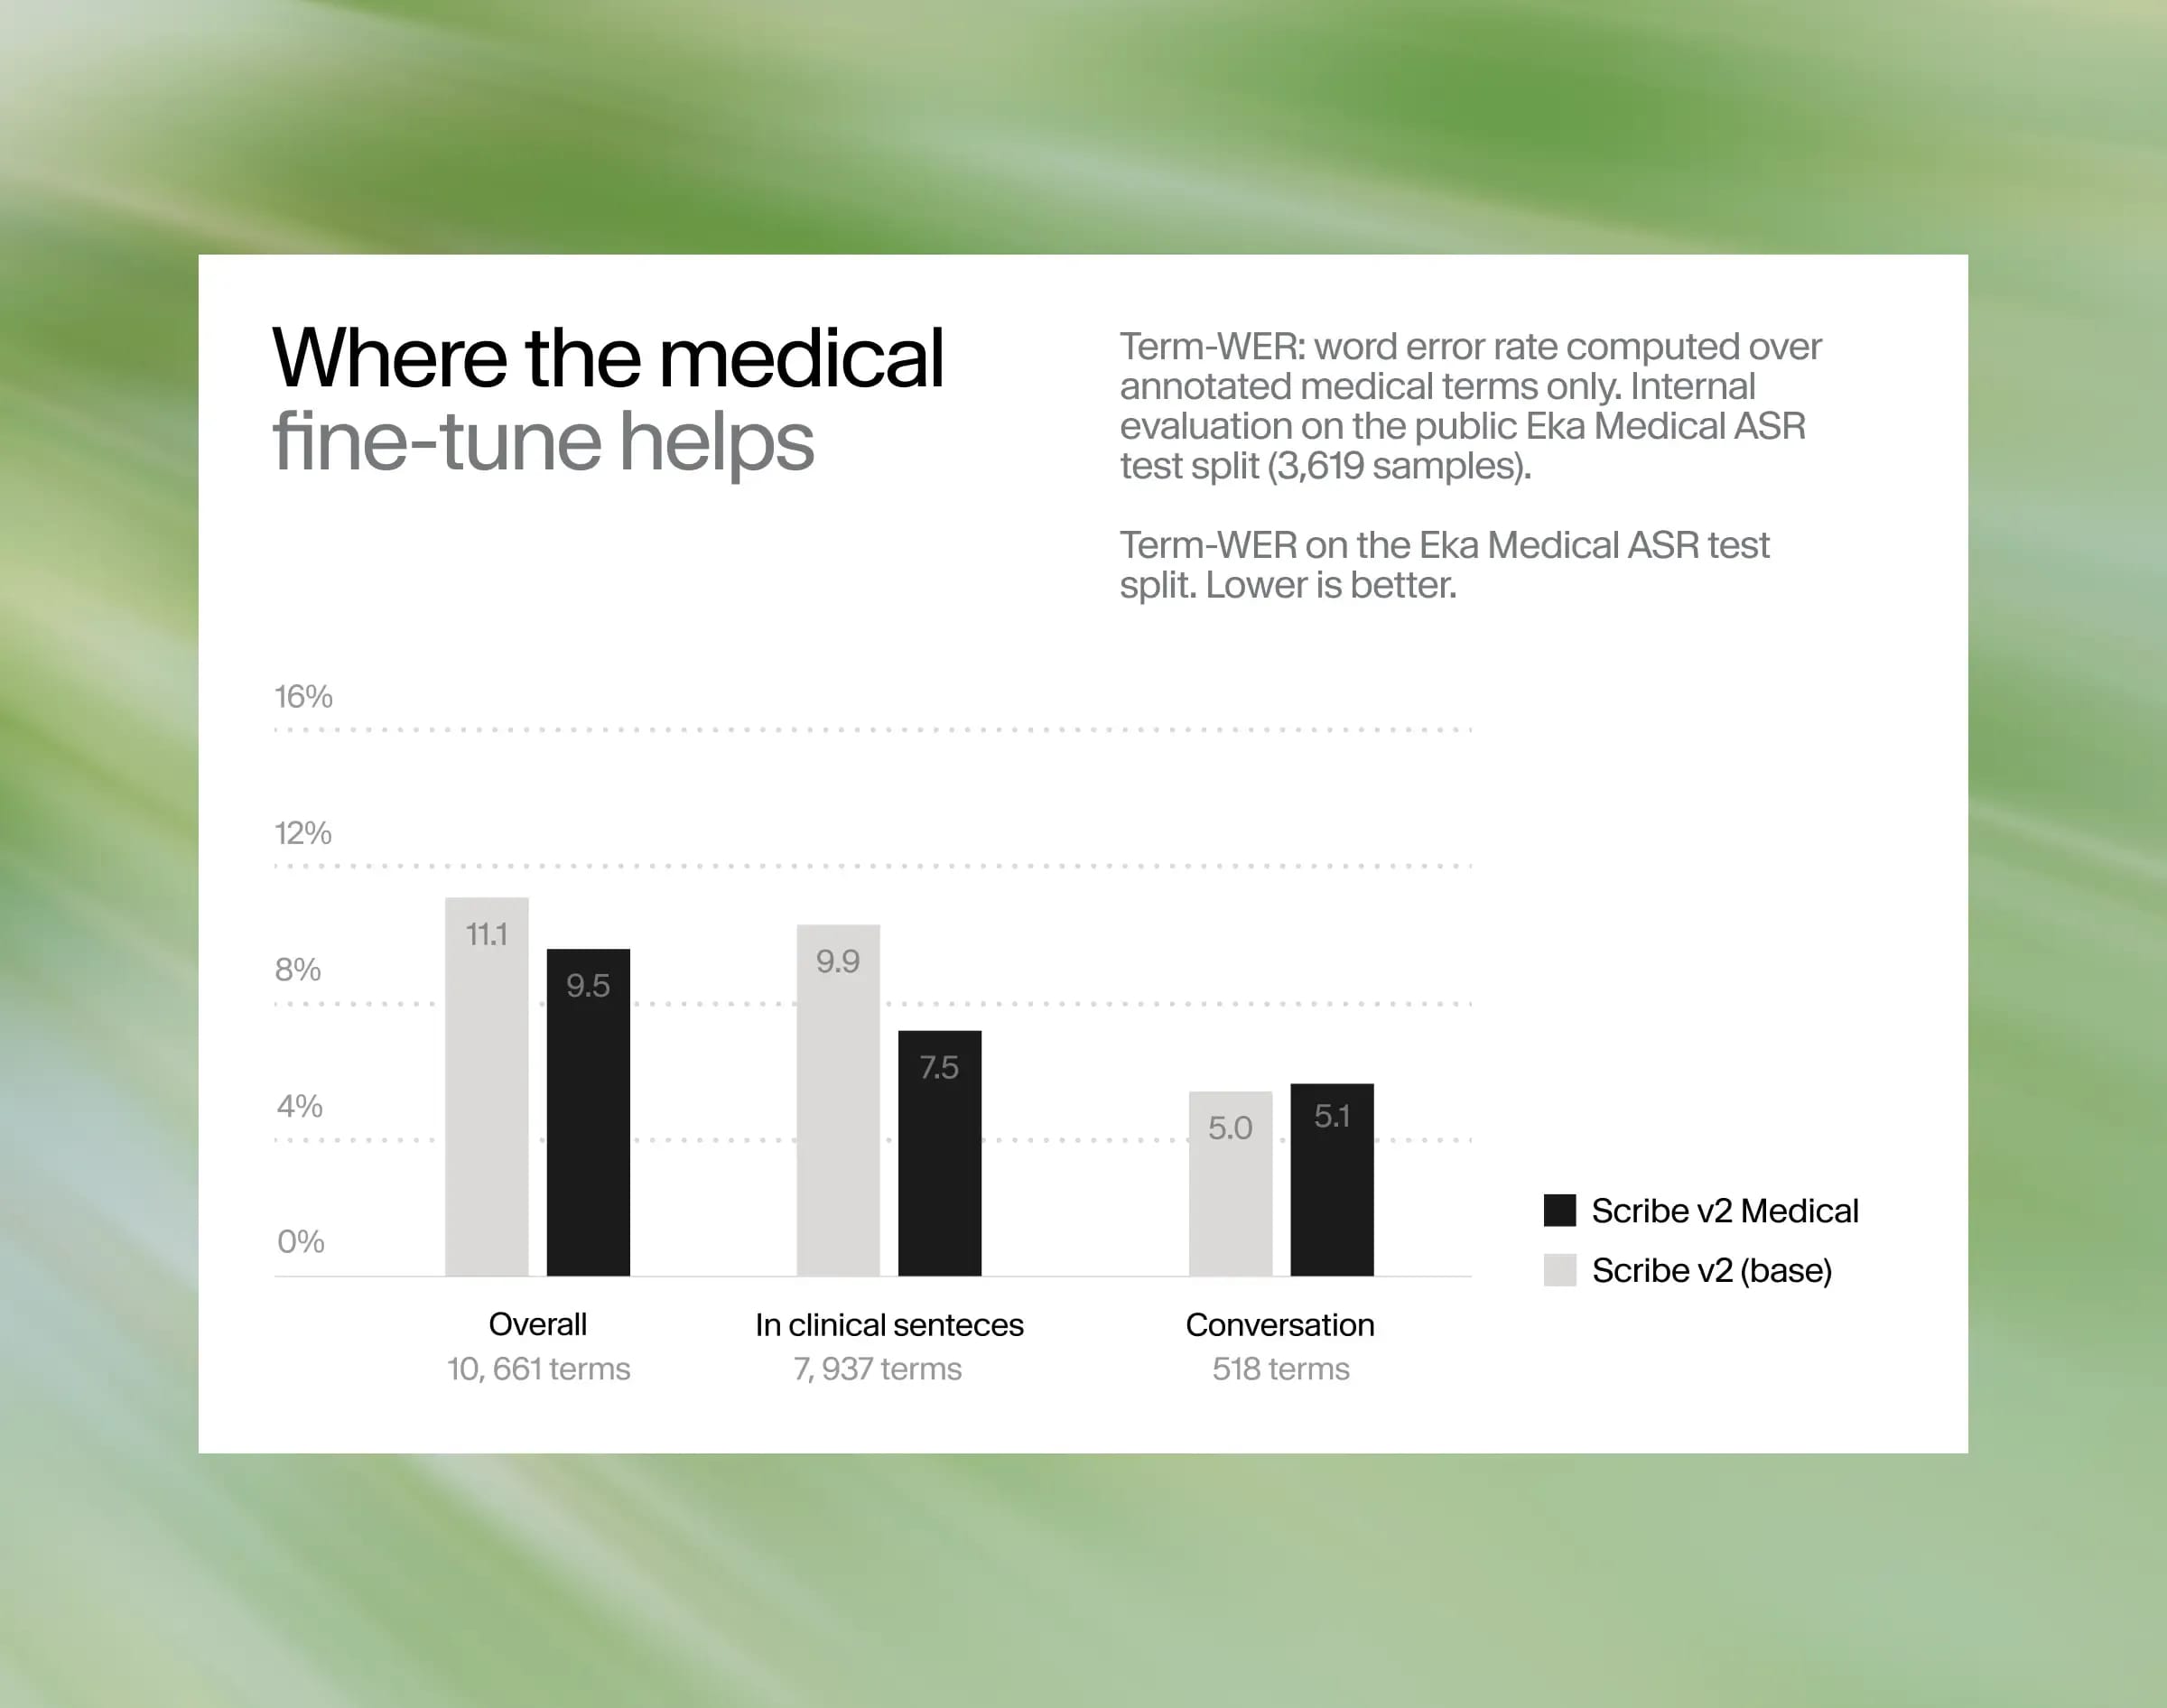
Una advertencia de estos mismos datos es que los clips aislados de una sola palabra —un nombre de medicamento sin contexto alrededor— siguen siendo el caso más difícil para todos los modelos de la clasificación, incluido Scribe v2 Medical. Obtuvo un WER del 14,3 % en términos aislados, frente al 7,5 % cuando esos términos aparecen en frases. Sin contexto, una sílaba mal interpretada puede provocar errores memorables:
- etodolac (un AINE) → «It'll do the luck»
- levomilnacipran (un antidepresivo) → «Leave me alone now, Sephora.»
- methdilazine (un antihistamínico) → «Let's play our scene.»
Una forma de reducir estos errores es mediante prompting de términos clave, que te permite destacar nombres de medicamentos o frases médicas para orientar al modelo a transcribirlos correctamente.
Más allá del benchmark principal
La precisión de v2 Medical se mantiene más allá del inglés.
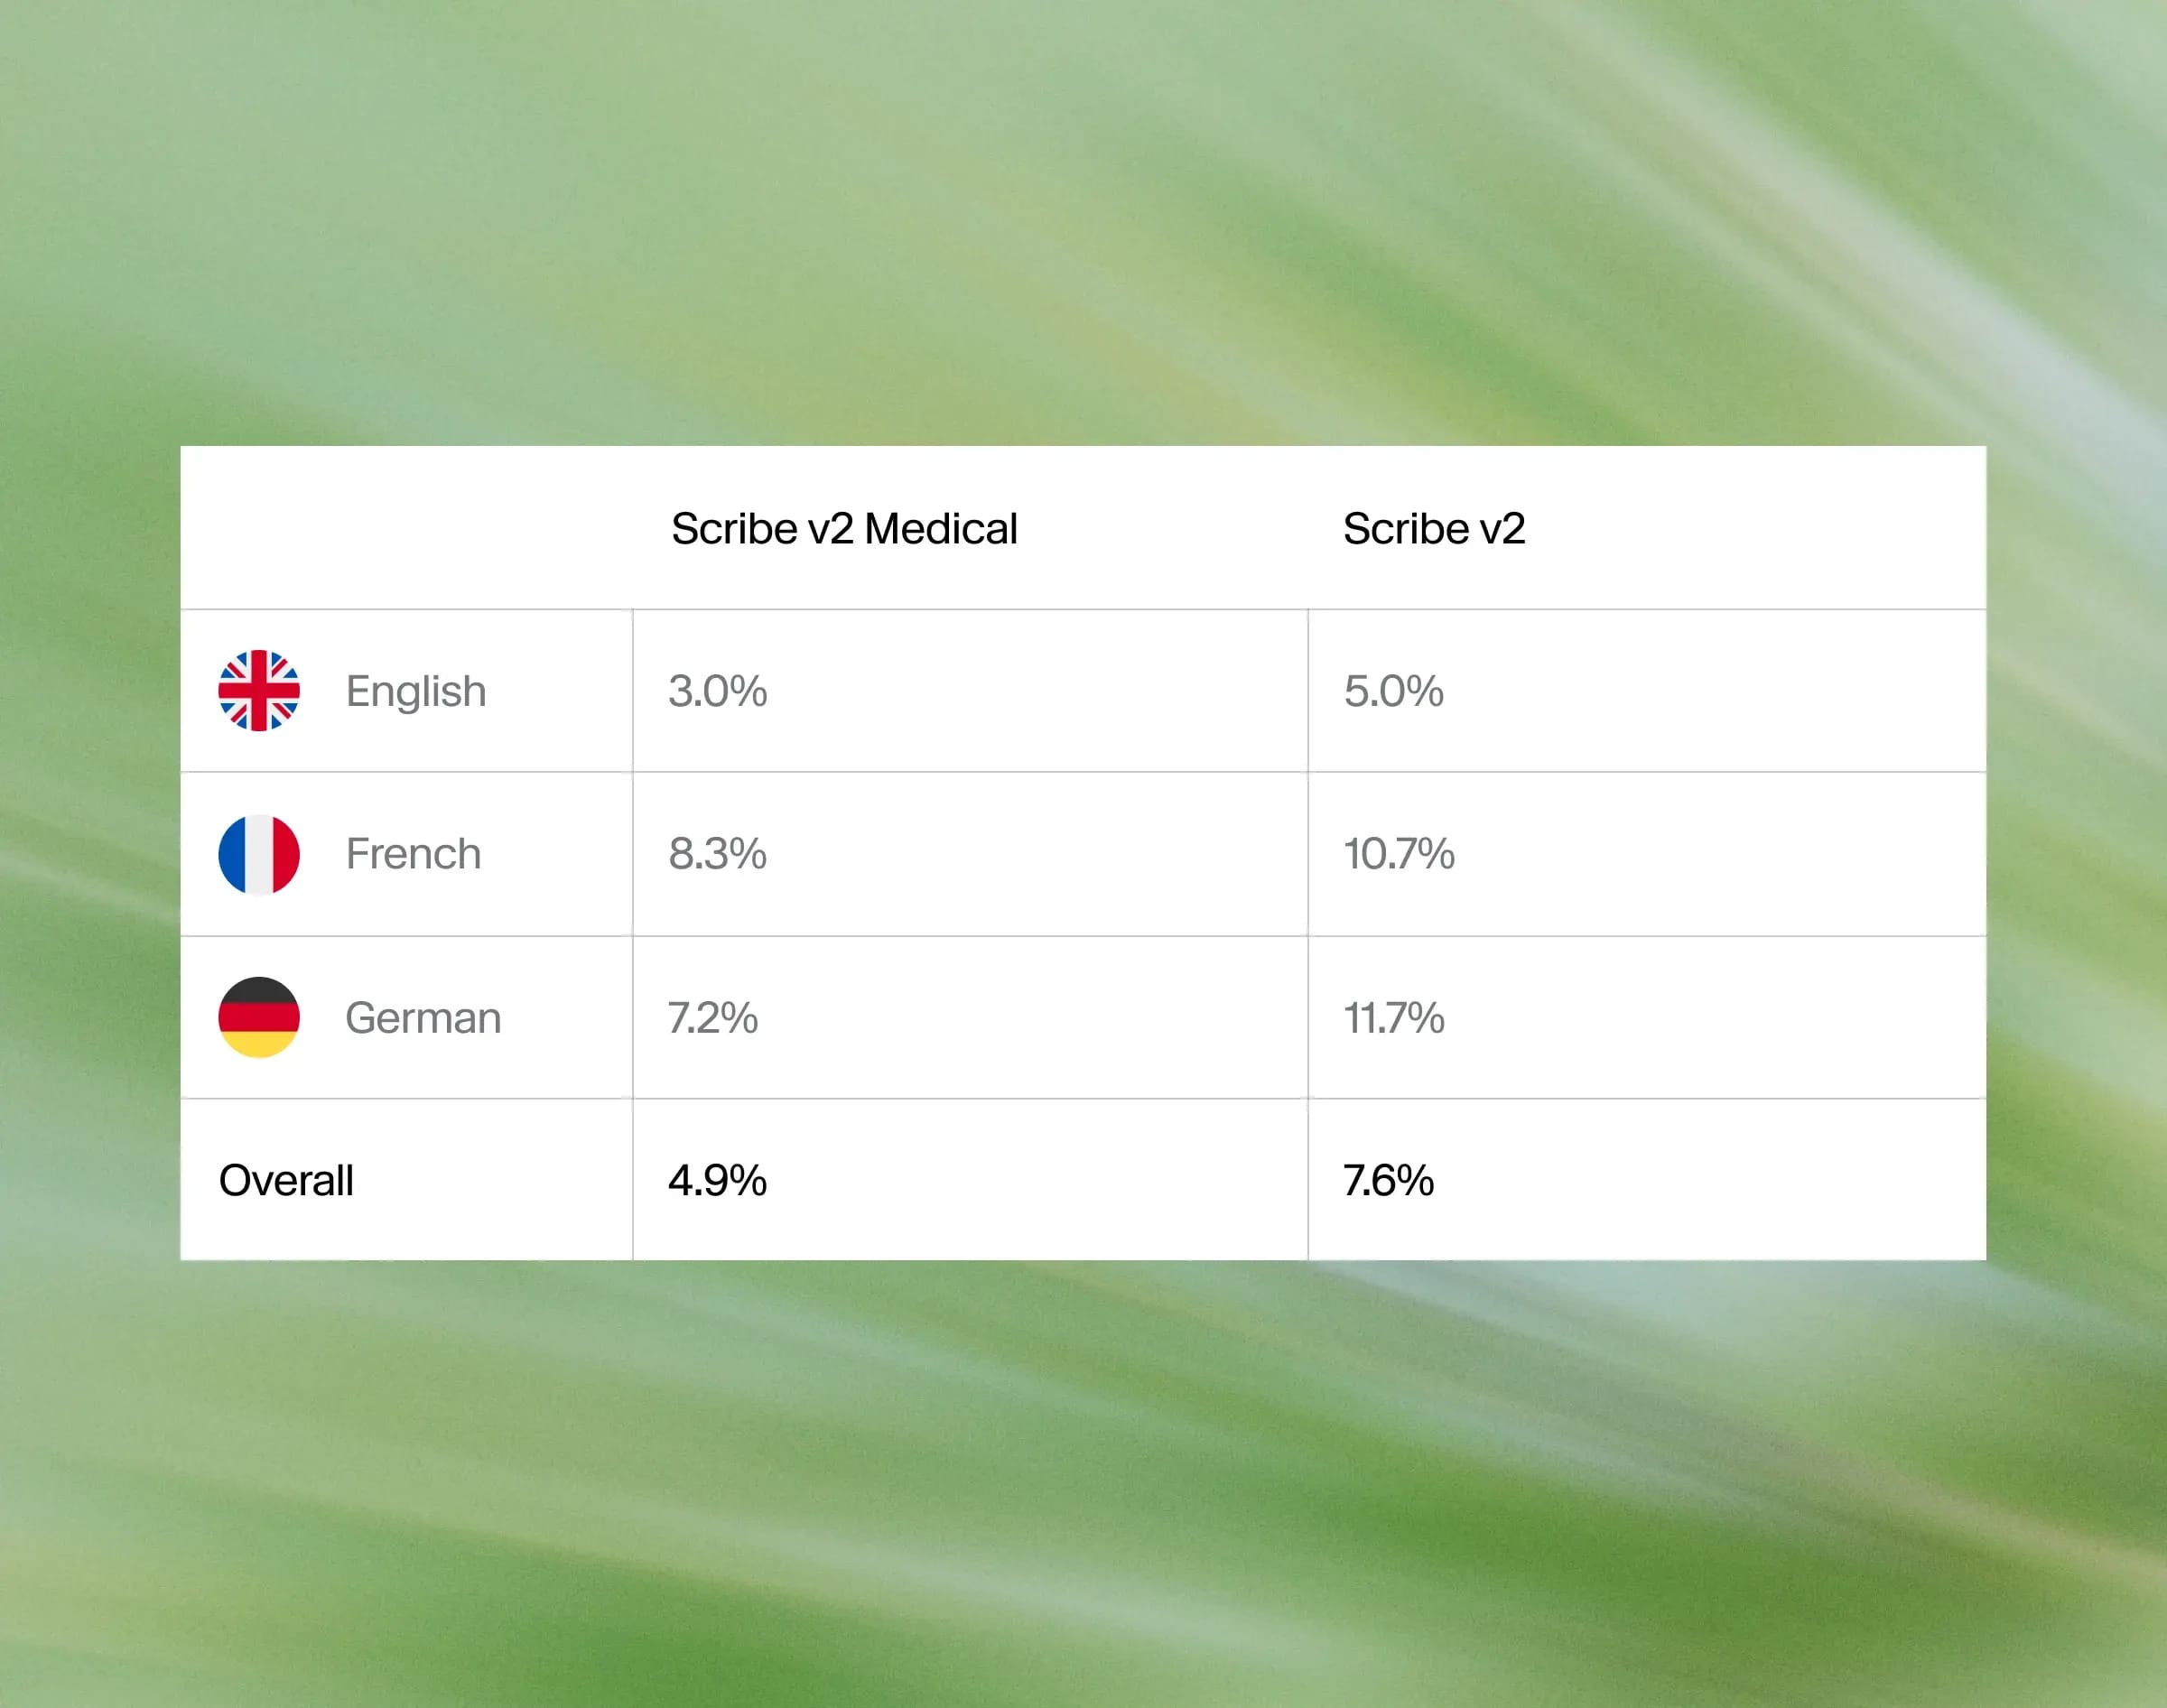
En el benchmark MedDictate de Corti, un conjunto de datos público de dictado clínico, Scribe v2 Medical reduce el WER aproximadamente un 36 % en comparación con el modelo base Scribe v2, y la mejora se mantiene en los tres idiomas:
El equipo también verificó que el ajuste médico no reduce el rendimiento en otras áreas. En 6000 muestras de habla cotidiana no médica derivadas de CommonVoice, Scribe v2 Medical obtiene la misma puntuación que Scribe v2 base al redondear: un WER del 5,3 % en ambos casos. Así que, con v2 Medical, obtienes las ventajas de un modelo médico especializado sin renunciar a la precisión en este benchmark.
Diseñado para información sanitaria protegida
Scribe v2 Medical cumple los requisitos de HIPAA para clientes empresariales que tengan acuerdos de asociado empresarial (BAA) y Zero Retention Mode (ZRM) activado.
Con ZRM activado para solicitudes de la API de Voz a Texto, la entrada de audio y la salida de texto se eliminan inmediatamente después de que se complete cada solicitud. ElevenLabs no conserva ninguna de ellas, y tu aplicación recibe la respuesta completa de la API y controla cómo se conservan las transcripciones.
Primeros pasos
Scribe v2 Medical está disponible en la API de Voz a Texto. Solo tienes que pasar el nuevo ID de modelo: scribe_v2_medical
El modelo funciona en la ruta de API de Voz a Texto por lotes.