Cómo solucionar problemas de precisión de Texto a Voz
- Escrito por
- Jack Limebear
- Publicado
EscucharEscucha este artículo
Aunque se entrenan con enormes conjuntos de datos de voz y pueden generar audio de alta fidelidad de forma constante, la mayoría de los modelos de texto a voz (TTS) aún pueden pronunciar mal palabras o presentar otros problemas de voz. Las pronunciaciones incorrectas ocurren cuando un motor de TTS encuentra palabras y expresiones fuera del rango de habla de su conjunto de datos de entrenamiento. Suele pasar sobre todo con jerga del sector, nombres de marcas o nombres propios.
Los motores de TTS también pueden generar una voz apresurada, entrecortada o robótica cuando los fragmentos de texto son largos o están puntuados para su lectura, en lugar de estructurados para decirlos en voz alta.
También puedes encontrarte con algunos problemas técnicos habituales al conectar tus aplicaciones a motores de TTS mediante una API.
En este artículo, exploraremos estas tres categorías de problemas y las formas más habituales de resolver cada una.
Resumen
- Los fallos de Texto a Voz generalmente se dividen en pronunciaciones incorrectas, ritmo o cadencia poco naturales y errores técnicos de ejecución de la API.
- La forma más eficaz de corregir pronunciaciones incorrectas es con diccionarios Pronunciation Lexicon Specification (PLS) estándar del W3C, o ajustándolas individualmente mediante etiquetas fonéticas insertadas en tus guiones.
- Puedes ayudar a controlar la naturalidad de la voz resultante dando el formato y la puntuación adecuados a tu guion. El texto preparado para hablar suele diferir del texto pensado solo para leer.
- Puedes diagnosticar fallos de la API mediante los códigos de estado HTTP estándar.
- Probar de antemano y de forma aislada la pronunciación de marcas, nombres propios y expresiones nuevas puede ahorrarte mucho trabajo de diagnóstico posterior.
¿Por qué no funciona Texto a Voz?
En general, los problemas de Texto a Voz se dividen en tres categorías.
Tipos de problemas de TTS
Pronunciaciones incorrectas
El modelo de TTS interpreta mal palabras o expresiones nuevas, como el nombre de tu marca, jerga del sector, acrónimos u homógrafos.
Entonación y cadencia poco naturales
La voz resultante es monótona, hace pausas en lugares extraños o se precipita en pasajes que necesitan una entonación más lenta.
Fallos de integración y API
Tu aplicación no genera voz por uno o varios motivos técnicos, como IDs de voz omitidos, límites de carga de trabajo o claves de API no válidas.
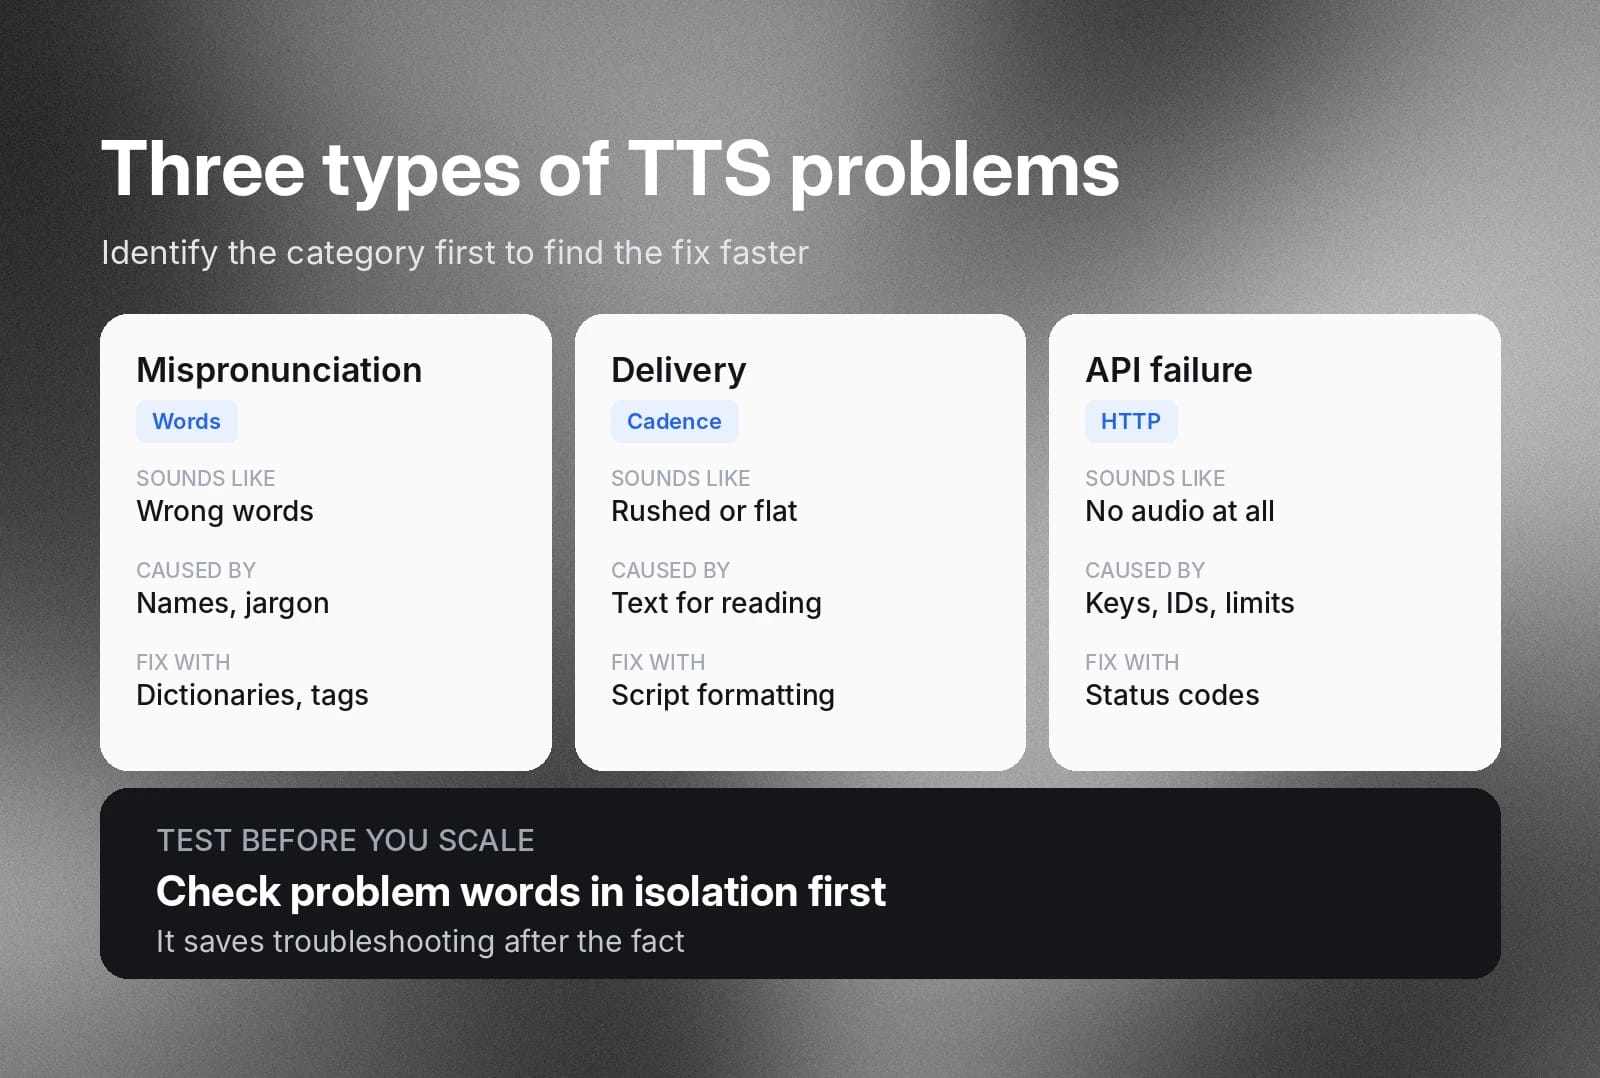
Esta guía detalla estos tres problemas para que entiendas exactamente a qué tipo de problema técnico o de calidad de salida te enfrentas. Entenderlos te ayudará a identificar antes la solución adecuada.
Cómo solucionar problemas de precisión de Texto a Voz: pronunciaciones incorrectas y entonación poco natural
Ingenieros entrenan los modelos modernos de voz neuronal con enormes conjuntos de datos de habla. Son capaces de generar voz natural con combinaciones casi innumerables de palabras. Sin embargo, ningún conjunto de datos de entrenamiento es universal. Siempre habrá pronunciaciones excepcionales y palabras poco comunes o nombres propios que el modelo no dirá correctamente.
No ocurrirá a menudo, pero cualquiera que use modelos de TTS con regularidad debe estar preparado para saber cómo actuar cuando suceda. Primero, es importante entender por qué se producen estas pronunciaciones incorrectas.
Causas habituales de los errores de voz
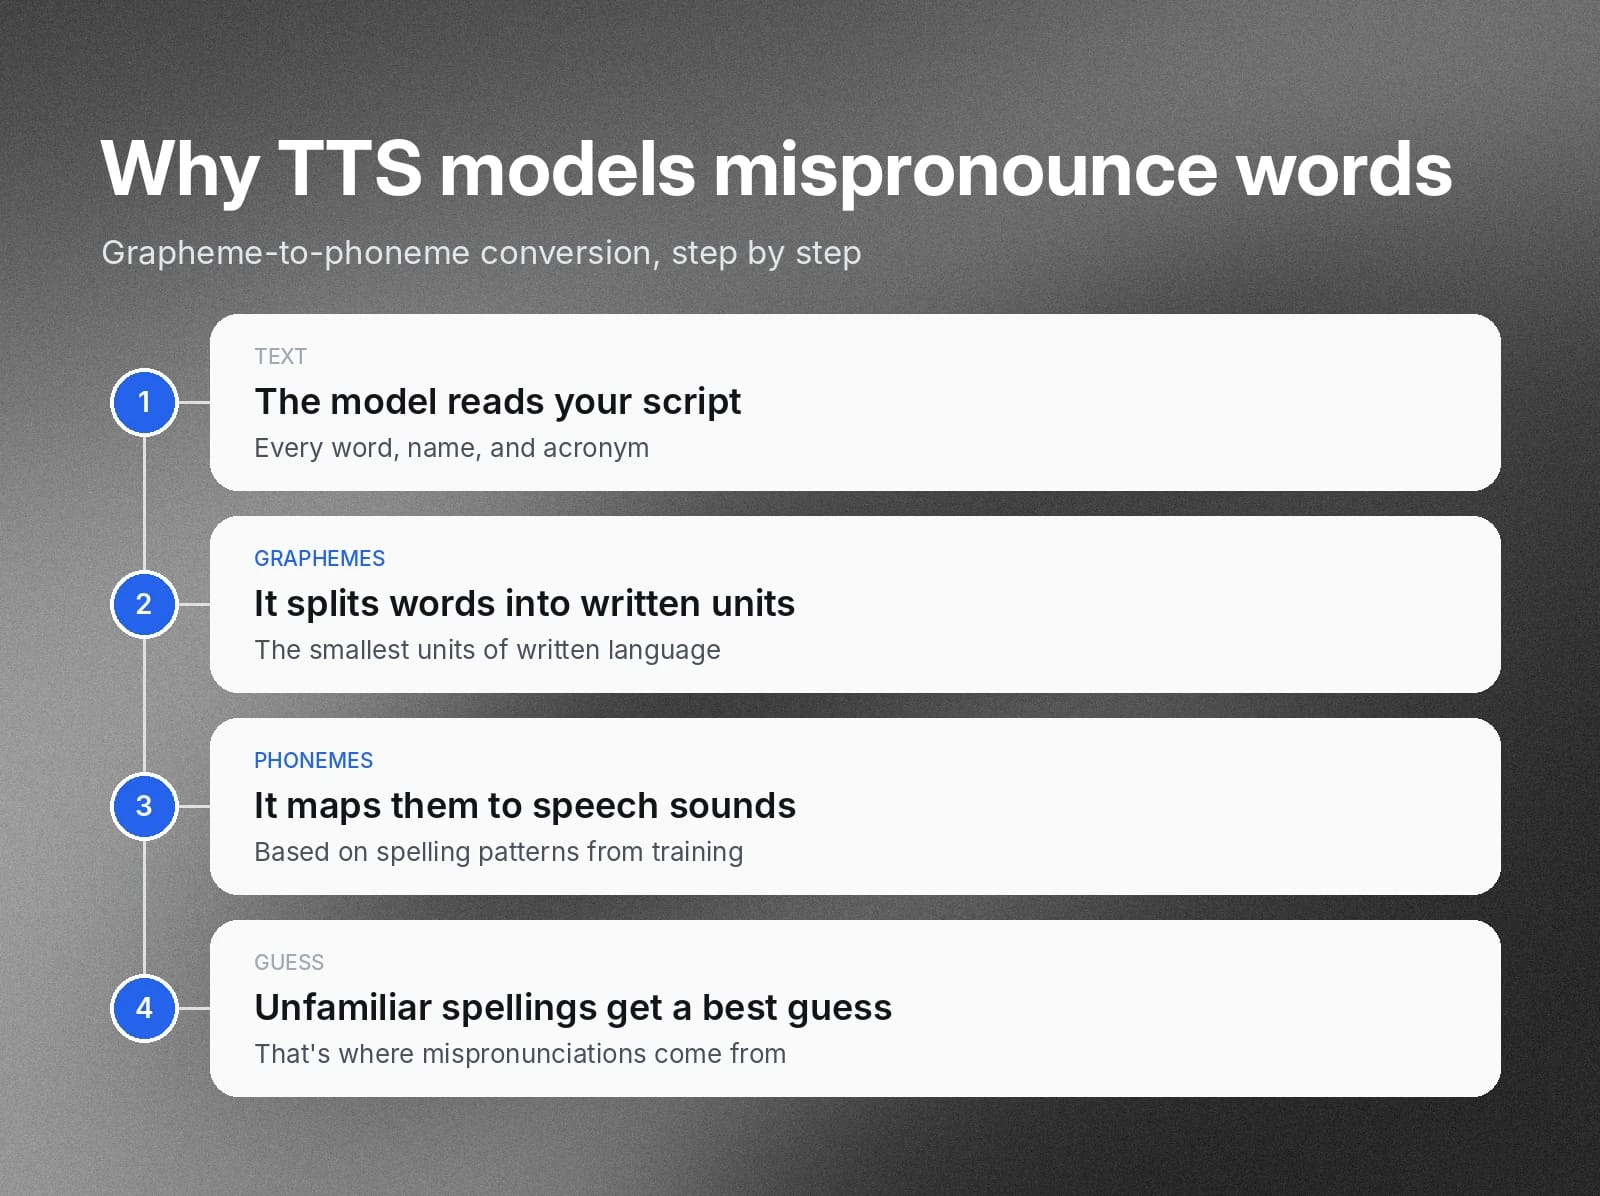
Los modelos de síntesis de voz funcionan convirtiendo texto en voz mediante un proceso llamado conversión de grafemas a fonemas (G2P). Los fonemas son las unidades más pequeñas del sonido hablado. Los grafemas son las unidades más pequeñas del lenguaje escrito, normalmente una letra, que representan un fonema.
Cuando el texto introducido no coincide con los patrones ortográficos que los modelos encontraron en los datos de entrenamiento, estos hacen su mejor estimación de la pronunciación fonética. A veces, esto provoca pronunciaciones incorrectas.
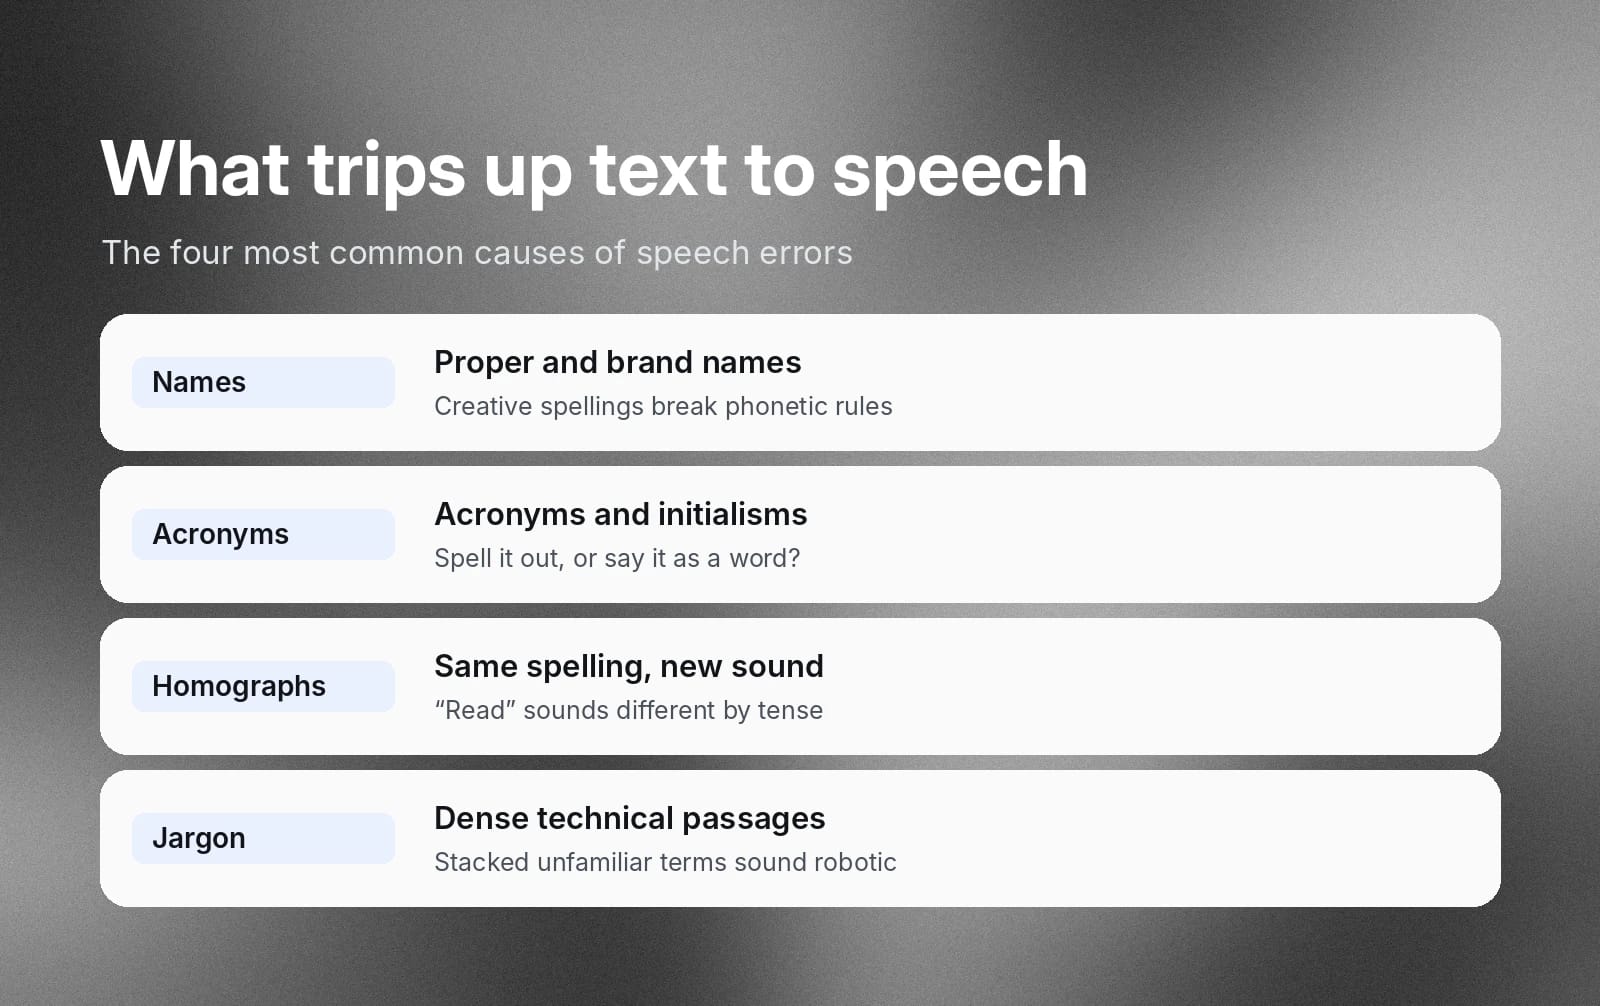
Nombres propios y nombres de marcas
Las empresas suelen usar grafías creativas para los nombres de sus marcas. Llaman la atención, pero a menudo también confunden a los modelos de síntesis de voz. Lo mismo puede ocurrir con nombres y apellidos creativos, por el mismo motivo.
Cuando un modelo encuentra un nombre desconocido, intenta aplicar las reglas fonéticas básicas que ha aprendido. La voz resultante puede alejarse mucho de lo que buscas.
Acrónimos y siglas
Piensa en el acrónimo NASA. Imagina que nunca lo has visto, como podría ocurrirle a un modelo de voz. ¿Lo pronuncias «N.A.S.A.» o «nasa»? ¿Y una API de software? ¿Es «A.P.I.» o «api»? ¿Qué ocurre si tu empresa vende una nueva herramienta de software con un acrónimo nuevo? Puedes dar por hecho que no está en los datos de entrenamiento de un modelo de voz. Por tanto, el modelo tendría que adivinar cómo quieres que se pronuncie, salvo que le des instrucciones personalizadas.
Homógrafos
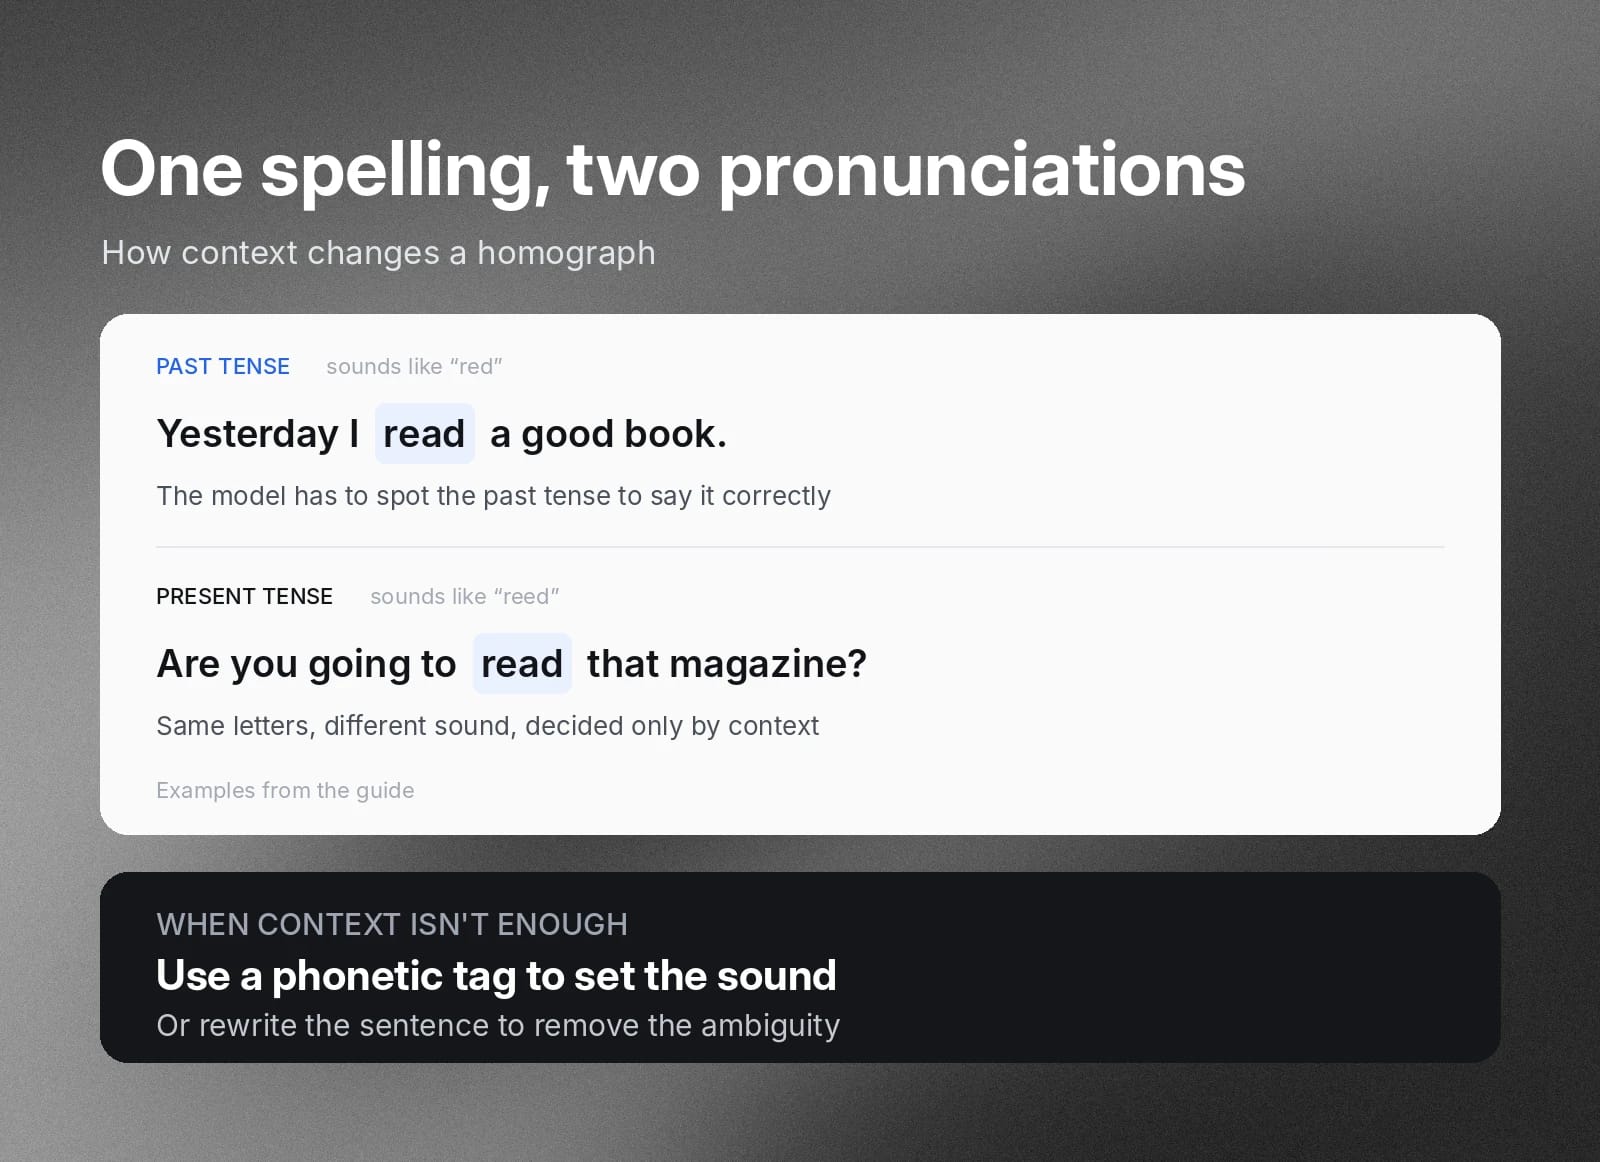
Los homógrafos son palabras que comparten grafía, pero tienen pronunciaciones distintas según el contexto. Por ejemplo, la palabra inglesa «read» se escribe igual, pero se pronuncia de forma diferente en pasado y en presente.
- «Ayer leí un buen libro».
- «¿Vas a leer esa revista?»
Un modelo de voz necesitará suficiente comprensión contextual para determinar cómo pronunciar los homógrafos como deseas.
Patrones de acentuación poco naturales
Las frases largas llenas de jerga técnica pueden acumular rápidamente palabras poco comunes, pronunciaciones específicas y acrónimos. Lo que por sí solo podría ser un error imperceptible puede convertirse enseguida en una voz plana y robótica mientras el modelo intenta analizar muchas palabras y formulaciones desconocidas.
Dos formas de controlar la pronunciación de la voz
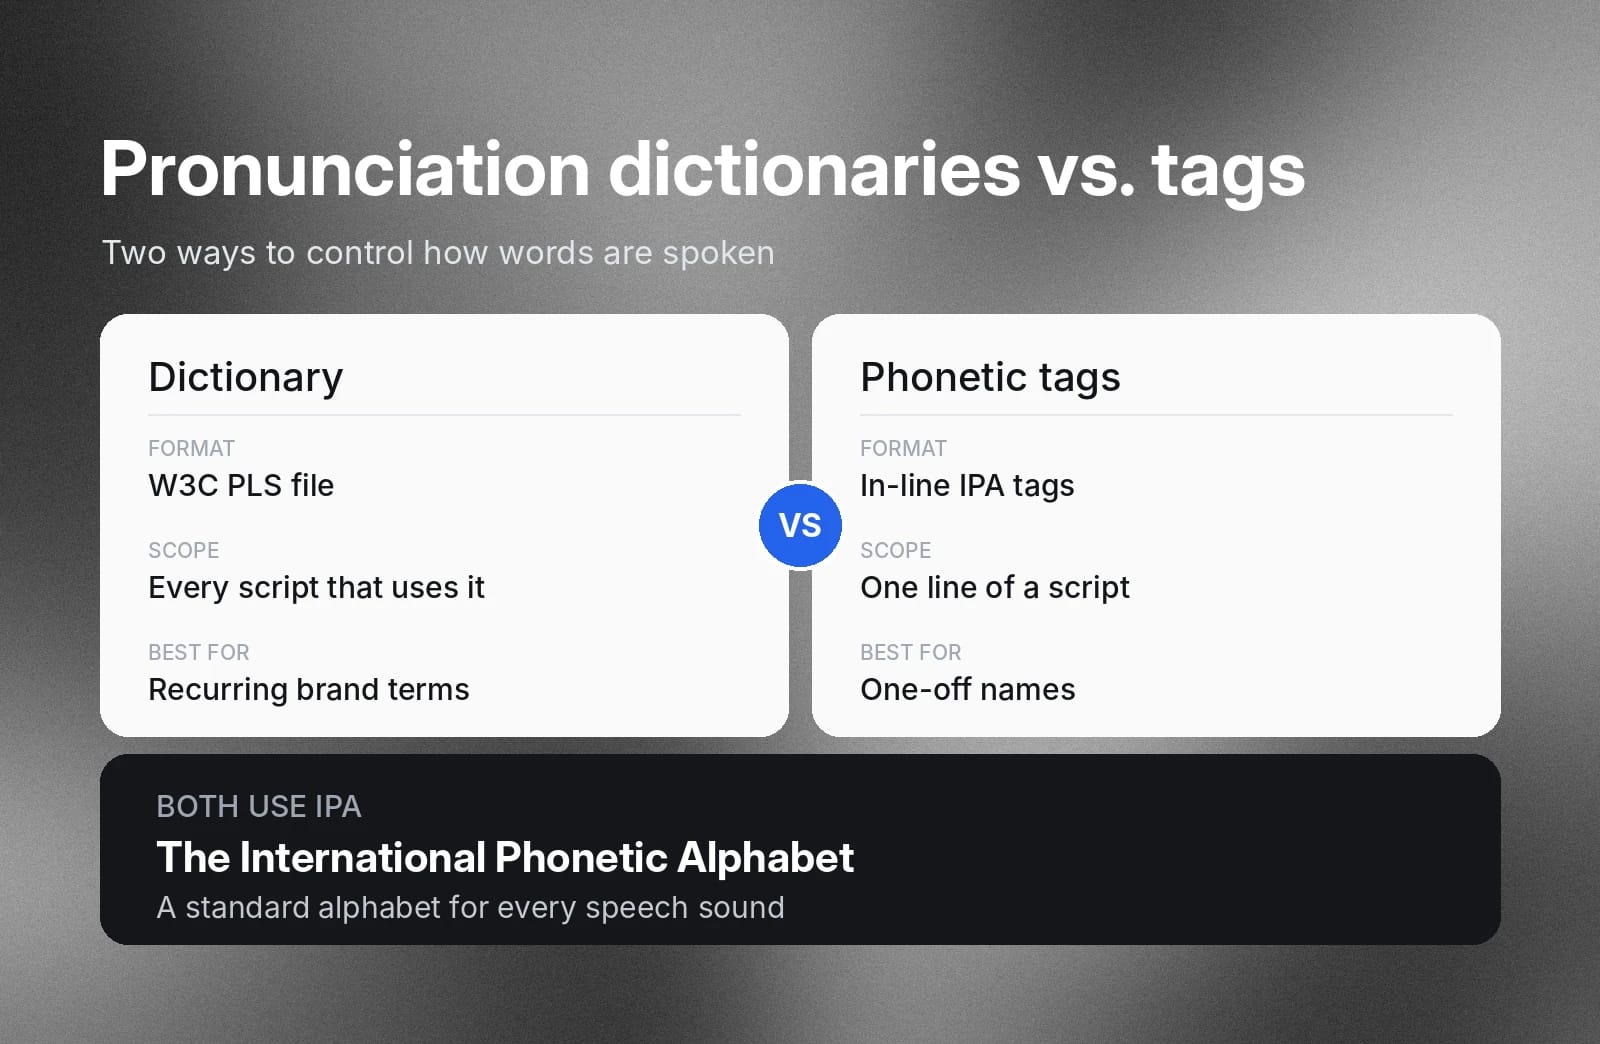
No necesitas reescribir por completo tus guiones para evitar estas situaciones. Los modelos modernos de voz neuronal incluyen dos herramientas para resolverlas de forma eficiente, caso por caso: diccionarios de pronunciación y etiquetas fonéticas en el guion.
Diccionarios de pronunciación de Texto a Voz
Los diccionarios son la mejor opción cuando tienes un conjunto de pronunciaciones personalizadas que se repiten regularmente en tus proyectos de TTS. Por ejemplo, si tu empresa vende dispositivos médicos y tus guiones incluyen con frecuencia términos técnicos, procedimientos médicos y otro contenido específico del sector.
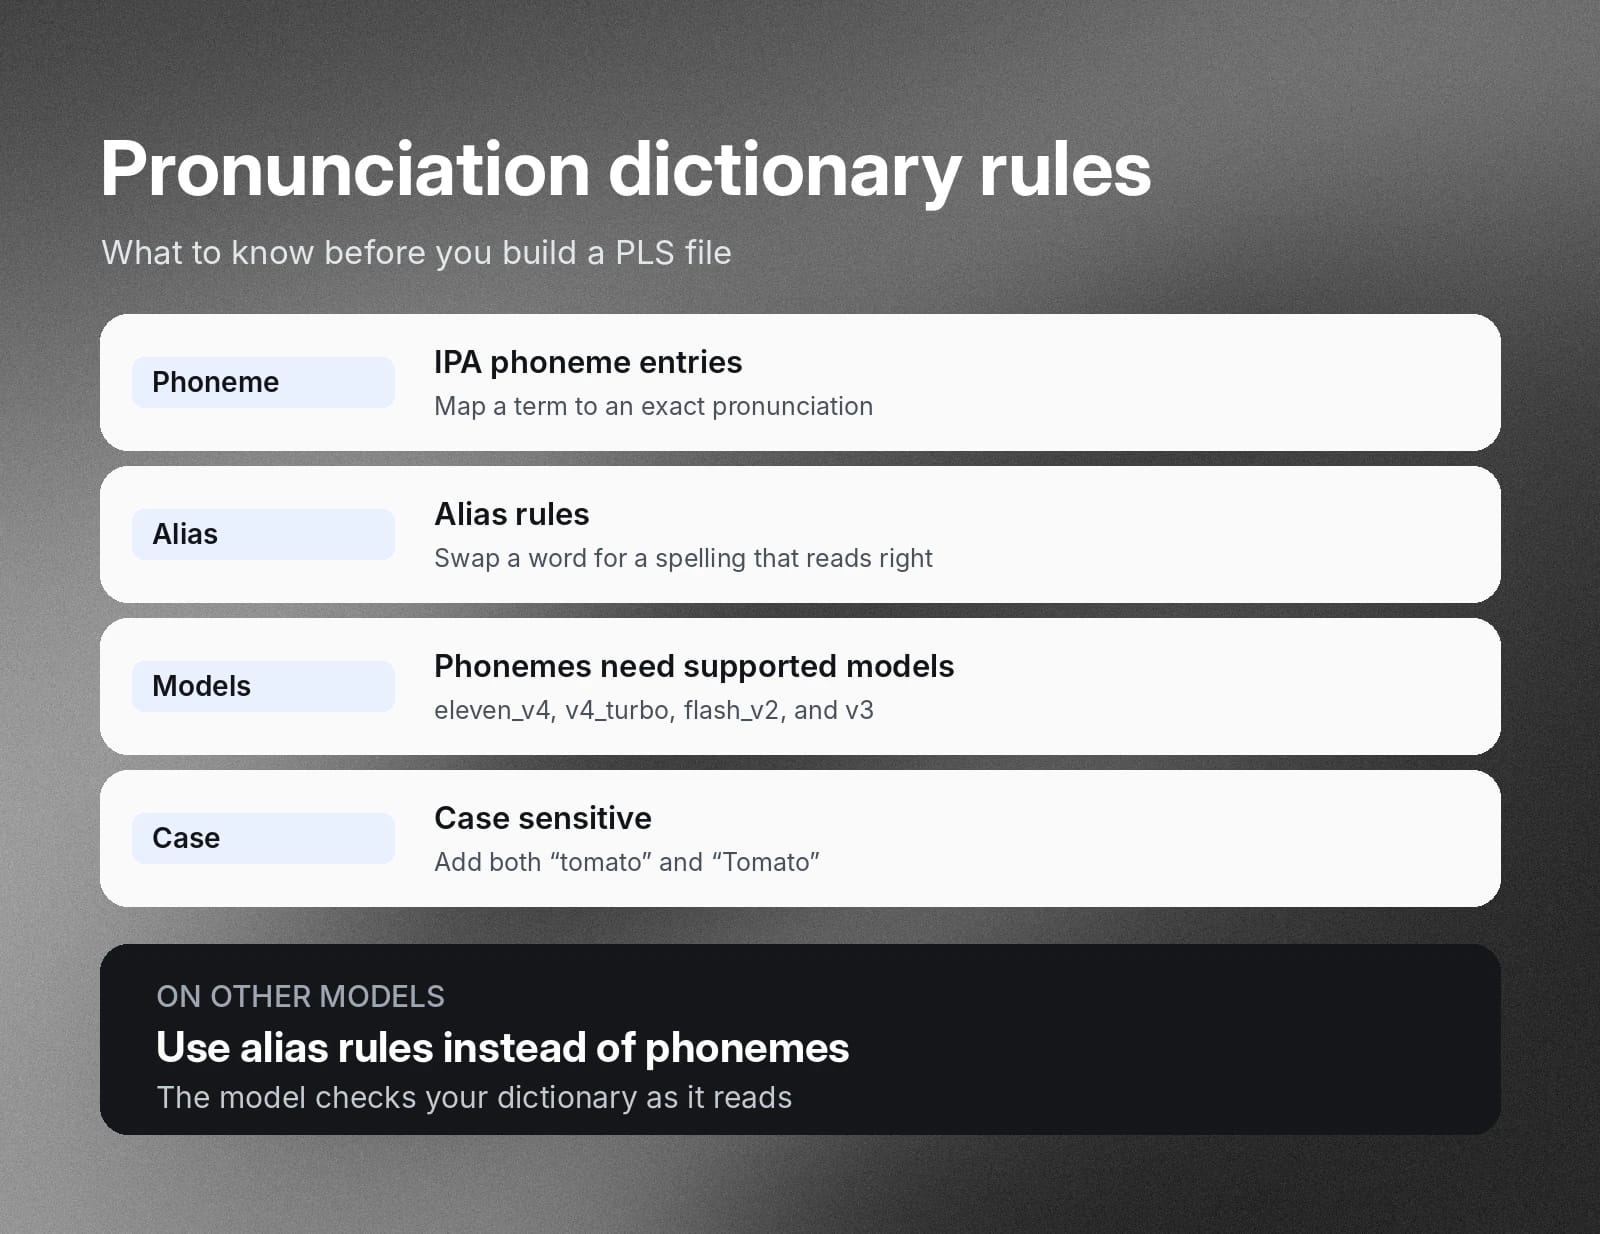
El formato estándar del W3C Pronunciation Lexicon Specification (PLS) ofrece una estructura para asignar a esos términos pronunciaciones fonéticas específicas mediante la notación del Alfabeto Fonético Internacional (AFI). El Alfabeto Fonético Internacional es un alfabeto estandarizado de todos los sonidos posibles del habla. El modelo de voz consulta tu diccionario mientras lee el guion y recurre a las pronunciaciones indicadas cada vez que encuentra palabras de tu diccionario. Las entradas de fonemas solo funcionan con los modelos eleven_v4, eleven_v4_turbo, eleven_flash_v2 y eleven_v3. En otros modelos, usa reglas de alias. Los archivos PLS distinguen entre mayúsculas y minúsculas, así que añade tanto «tomato» como «Tomato» si necesitas ambas.
Etiquetas fonéticas en el guion
Las etiquetas fonéticas suelen ser la mejor opción cuando necesitas ajustar líneas concretas de un guion. En lugar de crear un diccionario, usas etiquetas fonéticas insertadas que indican al modelo de voz cómo quieres que diga una palabra según el AFI.
Por ejemplo, imagina que estás escribiendo el guion de un pódcast y quieres mencionar a una experta del sector dos o tres veces. En vez de añadir su nombre a tu diccionario de pronunciación corporativo, solo tienes que etiquetarlo con la pronunciación correcta cuando lo uses en el guion.
Escribe y da formato a guiones que suenen naturales al decirlos en voz alta
Los diccionarios y las etiquetas son útiles para gestionar problemas con palabras individuales en la voz resultante, pero no resuelven la entonación, la cadencia y la dinámica general del habla. Al escribir un guion, es importante plantear el texto entendiendo que se dirá en voz alta. La elección de palabras, los giros y la puntuación a menudo deben ser distintos de los de un texto pensado simplemente para leer.
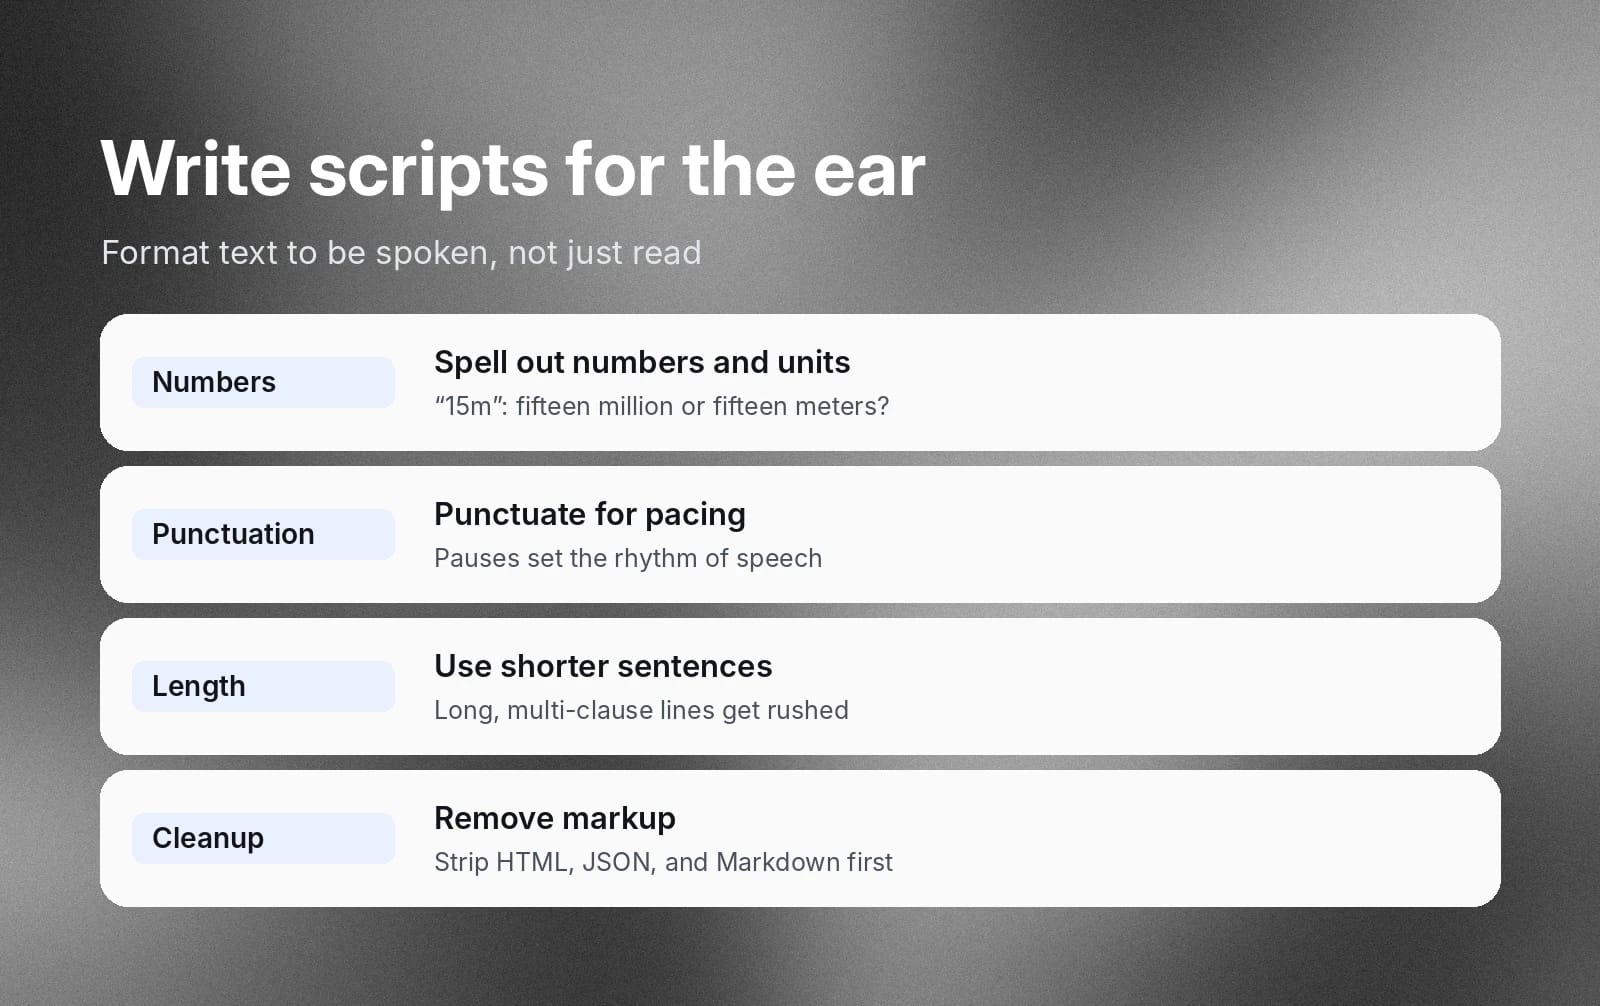
Escribe para el oído, no para la vista
Aborda la escritura de tu guion con la mentalidad de quien redacta un discurso: «¿Cómo quiero que se diga esto en voz alta? ¿Dónde hacemos una pausa para lograr un efecto dramático? ¿Dónde aceleramos?». Estas preguntas se aplican a un guion para modelos avanzados de voz neuronal tanto como a un guion que escribirías para una persona.
Escribe los números, las divisas y las fechas con todas sus letras
No conviene dejar ambigüedades en tus guiones. Los modelos de voz neuronal entienden bien el contexto, pero funcionan mejor cuando no tienen que adivinar. Las abreviaturas y formas abreviadas son elementos habituales con los que pueden tropezar.
Por ejemplo, un guion podría decir: «Buscas una cifra cercana a 15 m». ¿Quiere el redactor que el motor de TTS diga «quince millones» o «quince metros»? Escríbelo completo para que el modelo no tenga que adivinarlo por el contexto.
Usa la puntuación habitual para controlar el ritmo
La puntuación desempeña un papel importante en el texto escrito, pero importa aún más en la síntesis de texto a voz. La puntuación controla el ritmo. Representa distintos tipos de pausas que puedes usar para dividir ideas complejas o simplemente mantener una cadencia natural más cómoda de escuchar.
- Usa comas para pausas breves dentro de una frase.
- Usa puntos para cerrar una idea.
- Usa puntos suspensivos y rayas para añadir una pausa en medio de ideas complejas y evitar que el modelo suene apresurado.
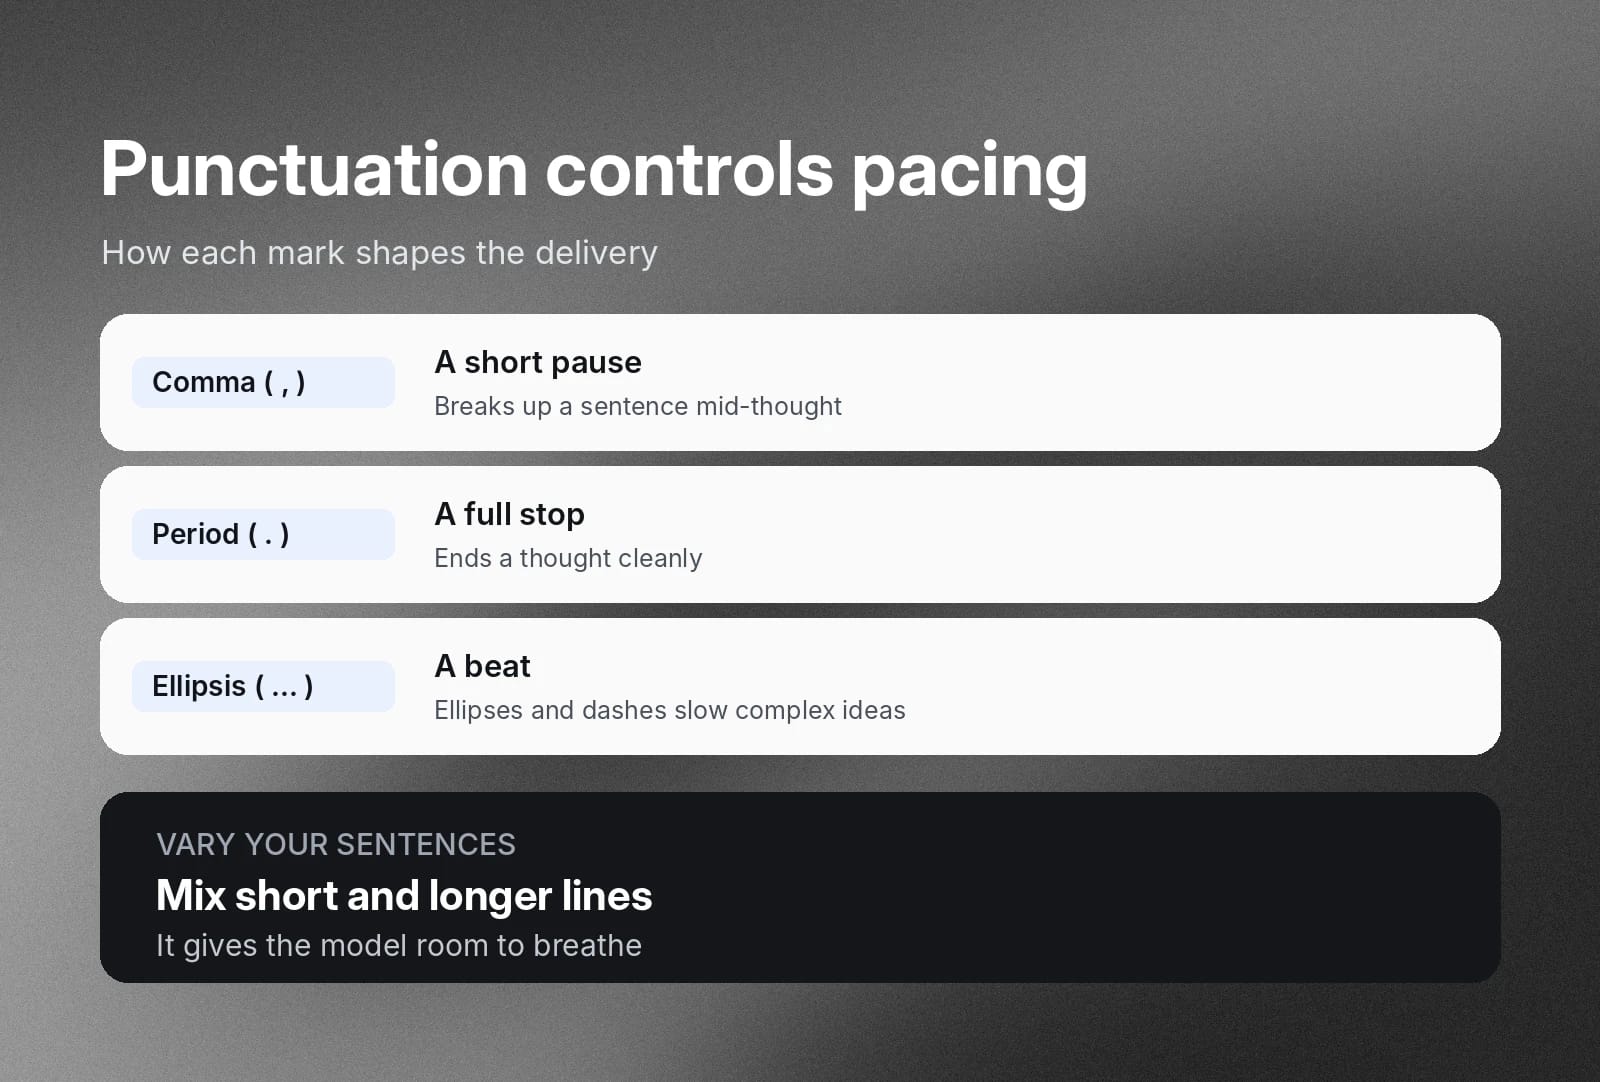
Las frases cortas son mejores
Es más probable que los modelos tropiecen o se precipiten con frases largas, condicionales y con varias cláusulas. Divídelas en enunciados más cortos de distinta longitud. Así el modelo tiene más margen y no se apresura al intentar encontrar la cadencia de frases largas y encadenadas.
Elimina el formato y los restos de Markdown
Si sintetizas voz extraída de un sistema de gestión de contenido u otro sistema empresarial, puede contener HTML, JSON, Markdown u otros formatos. Elimínalos y dale formato de texto para conseguir una voz más natural. Los modelos de voz pueden tener dificultades para saber cuándo ignorar esas etiquetas, leerlas literalmente o incorporarlas de forma contextual a su salida.
Puedes consultar más información sobre las pronunciaciones incorrectas y otros problemas en la guía de solución de problemas de ElevenLabs.
Soluciona errores habituales de la API de ElevenLabs
Los equipos que producen audio de voz a escala suelen conectar sus aplicaciones a un modelo de síntesis de voz mediante una API. Esto hace que la producción sea más eficiente en general, pero añade una capa técnica que debes gestionar además de la salida de voz del modelo.
La referencia de códigos de error de la API de ElevenLabs explica detalladamente los códigos de respuesta, pero estos son los cuatro códigos de estado HTTP más habituales al solucionar problemas en integraciones de texto a voz y cómo resolverlos.
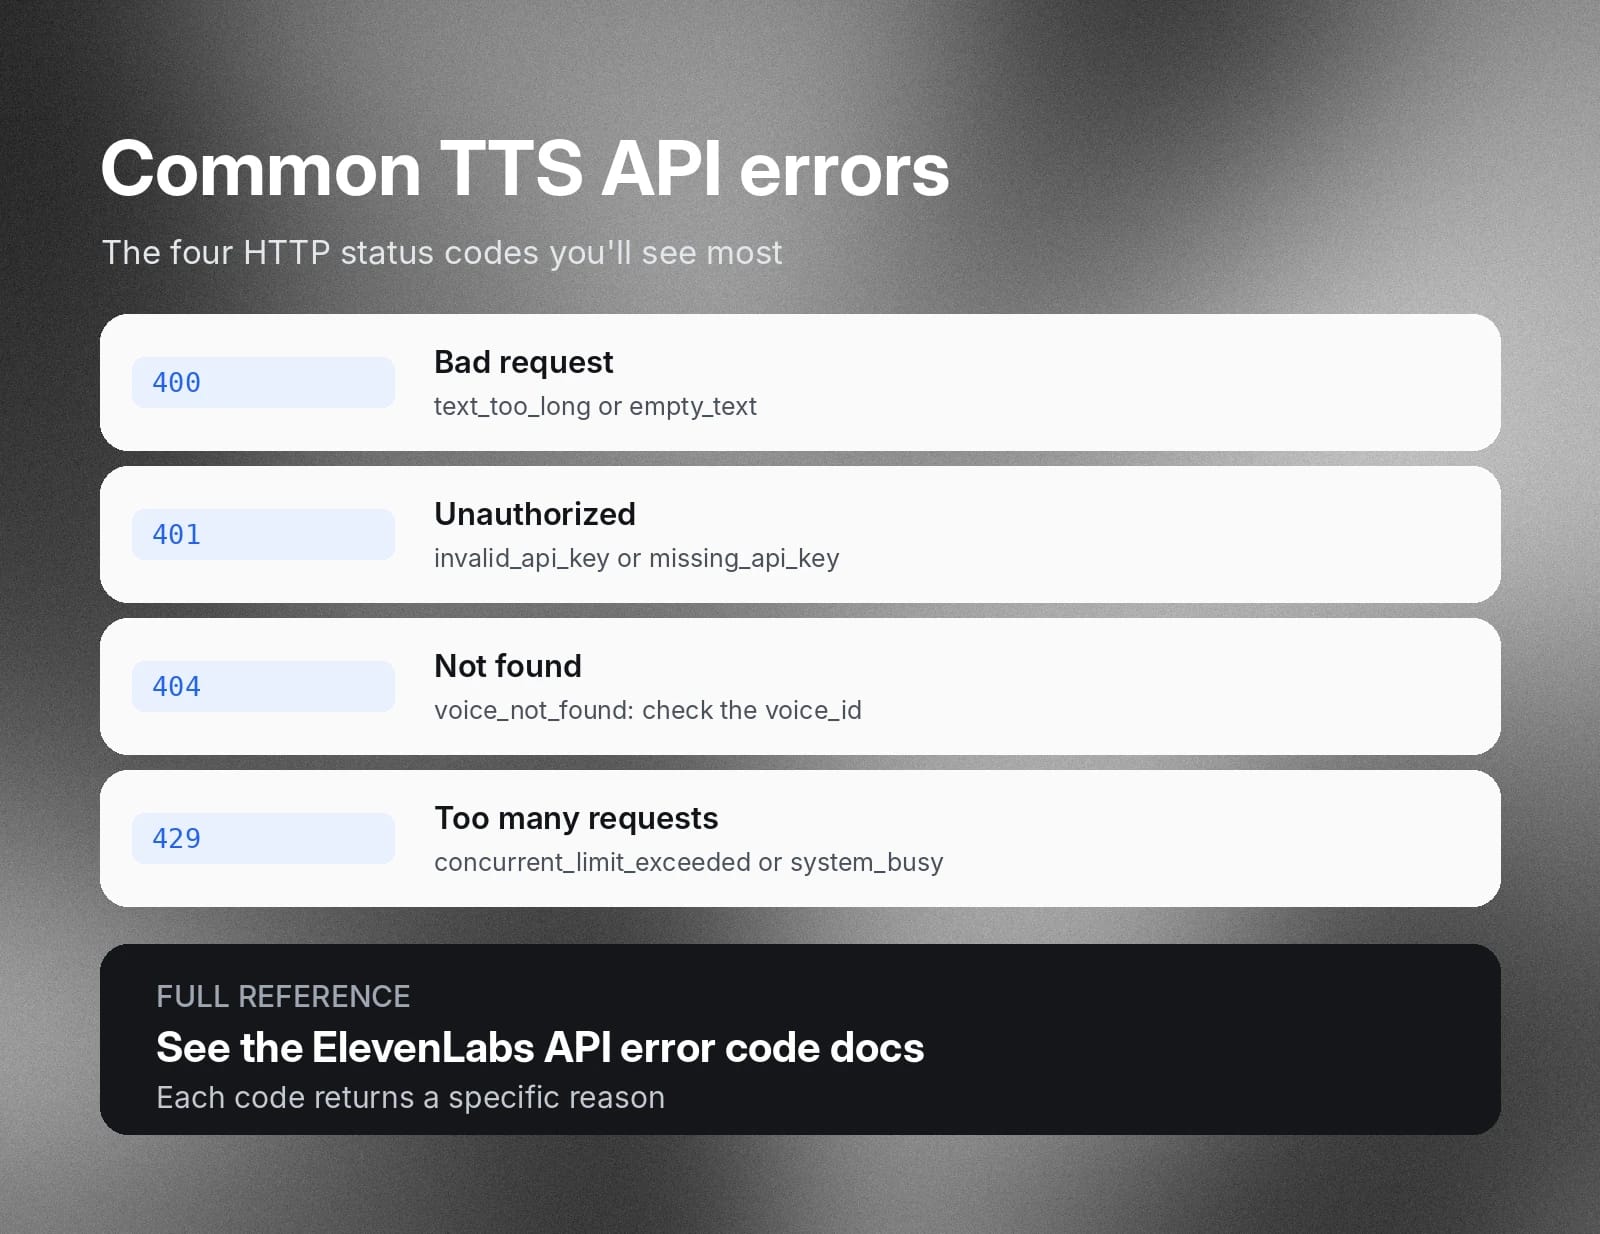
400 Bad Request (errores de carga útil)
Una respuesta con código de estado 400 de una API de modelo de voz significa que tu aplicación ha enviado datos que el modelo no ha podido procesar. En los flujos de trabajo de TTS, normalmente se debe a que se han alcanzado los límites de caracteres o a que se han enviado entradas vacías por error.
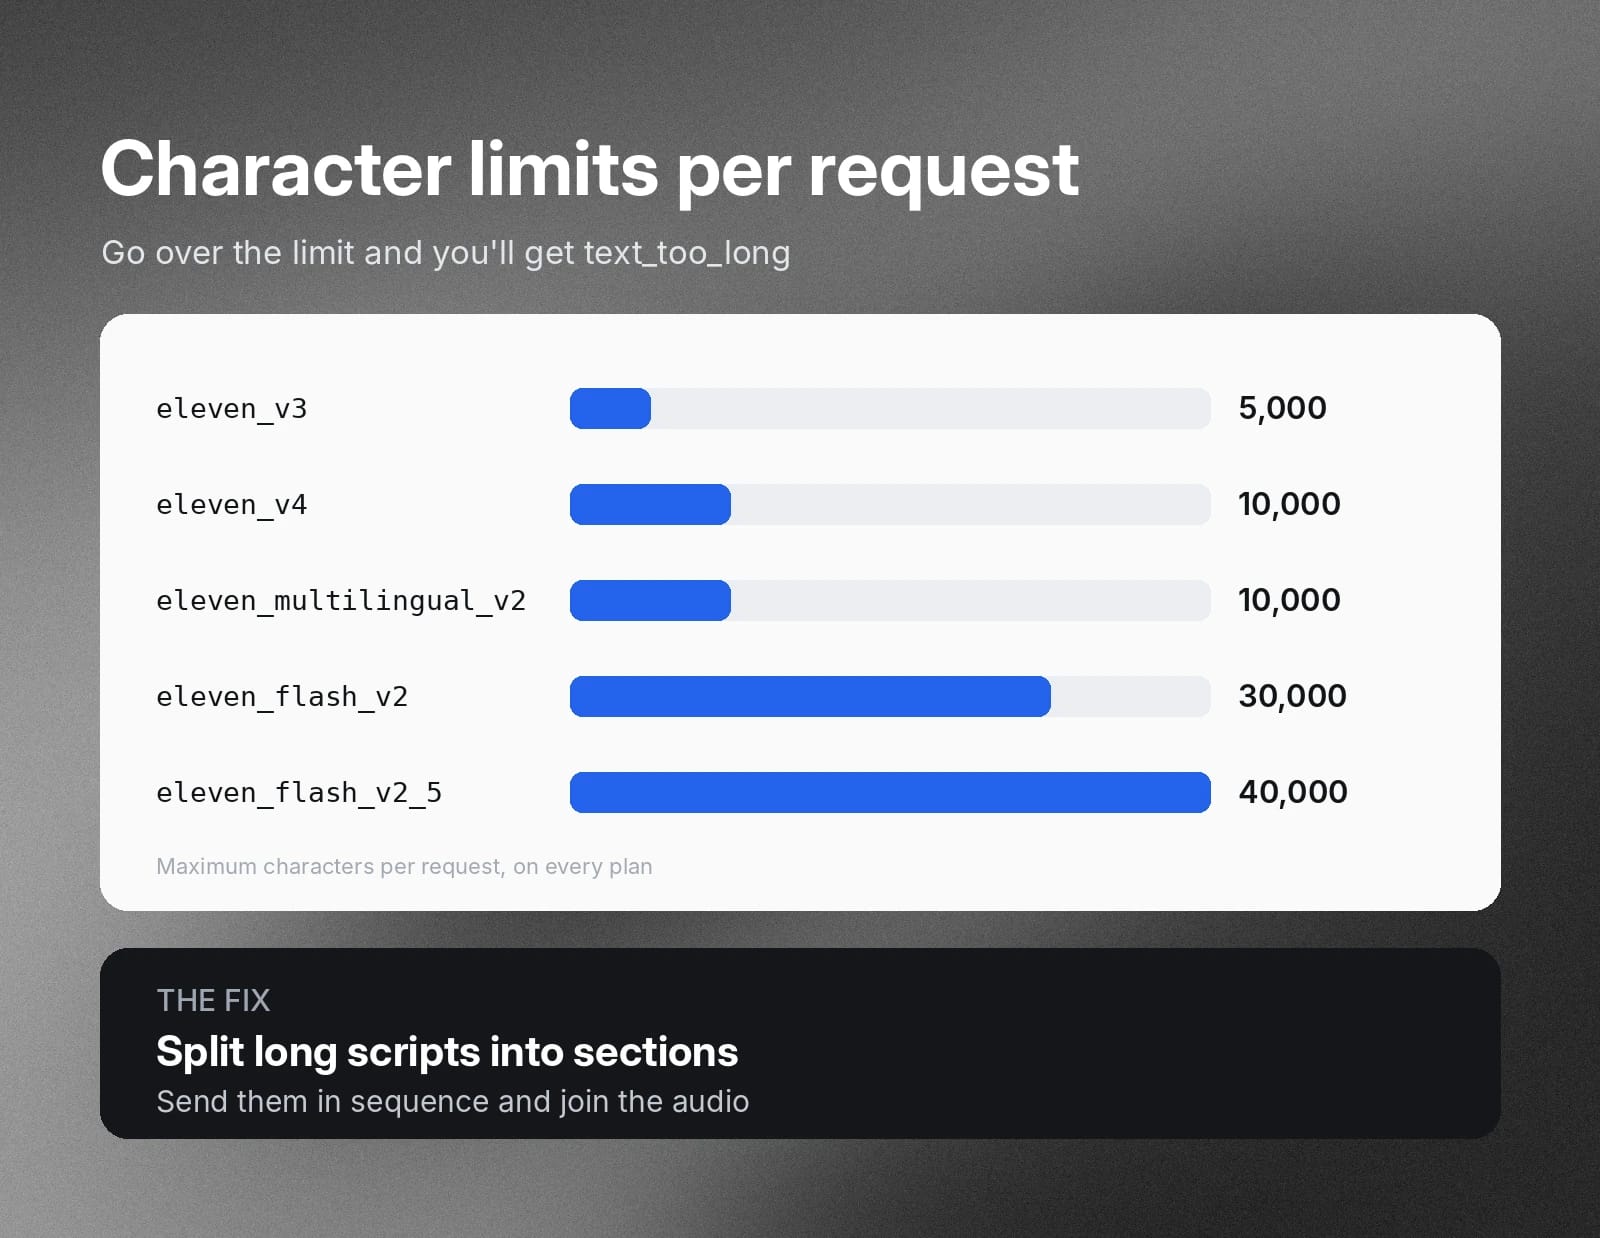
Límite de caracteres superado (text_too_long)
Cada solicitud de TTS que envías tiene un límite de caracteres establecido por el modelo. Si intentas enviar más texto del que permite el límite del modelo, el servidor de TTS devolverá este error. Los límites por solicitud son 10.000 caracteres para eleven_v4 y eleven_multilingual_v2, 5.000 para eleven_v3, 30.000 para eleven_flash_v2 y 40.000 para eleven_flash_v2_5, en todos los planes. Para resolver este problema, divide los guiones más largos en varias secciones que el modelo pueda procesar de forma secuencial.
Texto de entrada vacío
Un motor de TTS rechazará cualquier carga útil que contenga cadenas vacías (empty_text). Incluye pasos de limpieza en tu canal de entrada para eliminar las líneas vacías y evitar que el servidor rechace una carga útil que, por lo demás, sería válida.
401 Unauthorized (problemas de autenticación)
Un código de error 401 significa que la puerta de enlace de la API rechazó tus credenciales y tu carga útil no se envió al modelo. Esto ocurre cuando hay un problema con la clave de API.
Clave de API no válida
Tu solicitud al servidor del modelo debe incluir una xi-api-key válida. Si no la incluye, el servidor devolverá un error 401. Comprueba que tu clave esté presente en la solicitud y que no se haya revocado, caducado o truncado en los encabezados durante el despliegue. La API devuelve invalid_api_key cuando la clave es incorrecta y missing_api_key cuando no se envía ninguna.
404 Not Found (discordancias en el identificador de voz)
Recibes un error 404 cuando la ruta de API no puede encontrar el recurso de TTS especificado en la solicitud URL. Esto puede ocurrir si envías un parámetro voice_id incorrecto o si simplemente falta en la URL de la solicitud. Asegúrate de haber recibido el voice_id correcto. Comprueba que esté presente en los parámetros de ruta y que no tenga errores tipográficos. La API devuelve voice_not_found cuando el ID de voz no existe.
429 Too Many Requests
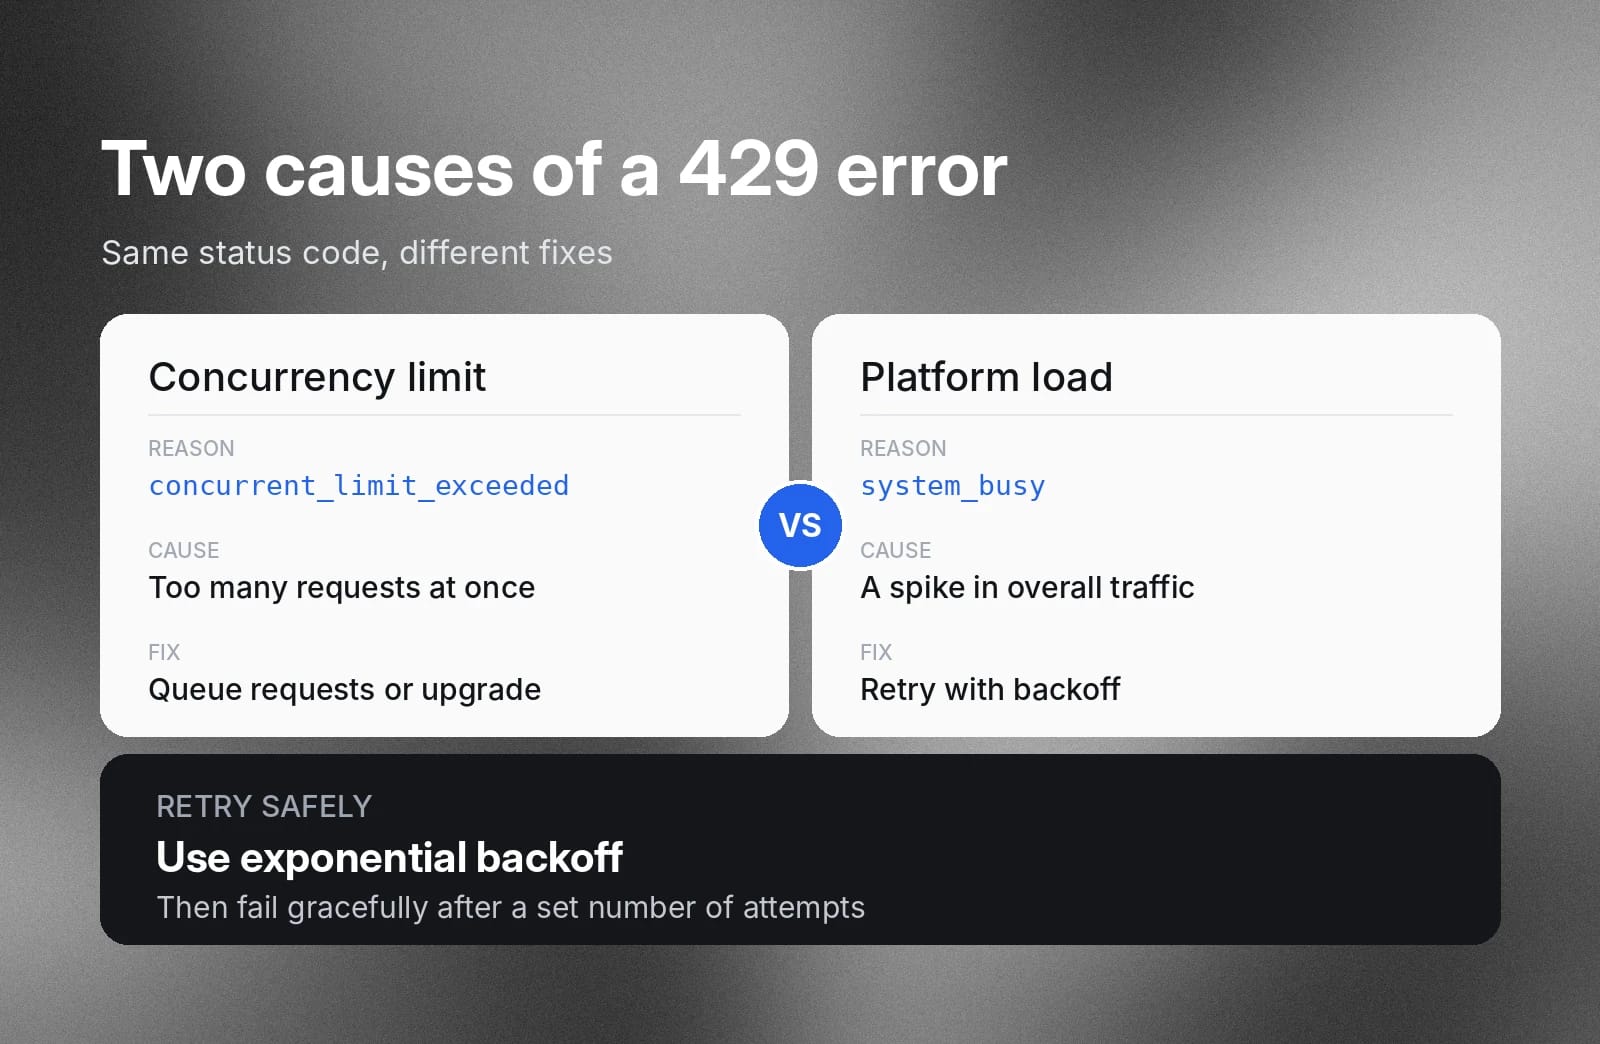
Este error tiene dos causas distintas: has alcanzado el límite de solicitudes simultáneas de tu nivel de servicio o la plataforma de TTS está limitando las solicitudes para gestionar un pico de tráfico.
Límites de simultaneidad (concurrent_limit_exceeded)
Cada nivel de suscripción de un motor de TTS especifica un número fijo de solicitudes simultáneas que puedes enviar. Si tus aplicaciones superan ese límite, el servidor devolverá este tipo de error 429.
Crea una capa de colas asíncrona con un servicio como Redis para regular tus cargas útiles salientes y que no superen los límites de tu nivel. También puedes evaluar si una suscripción de nivel superior compensa el coste.
Picos de carga de la plataforma (system_busy)
Con mucha carga, un servidor de TTS puede limitar las solicitudes entrantes para mantener el rendimiento. Incorpora lógica de reintento automatizado en el cliente de API de tu aplicación. Asegúrate de que pueda reintentar con retroceso exponencial y que luego falle de forma controlada tras un número máximo de intentos.
Prueba voces, idiomas y ajustes antes de publicar
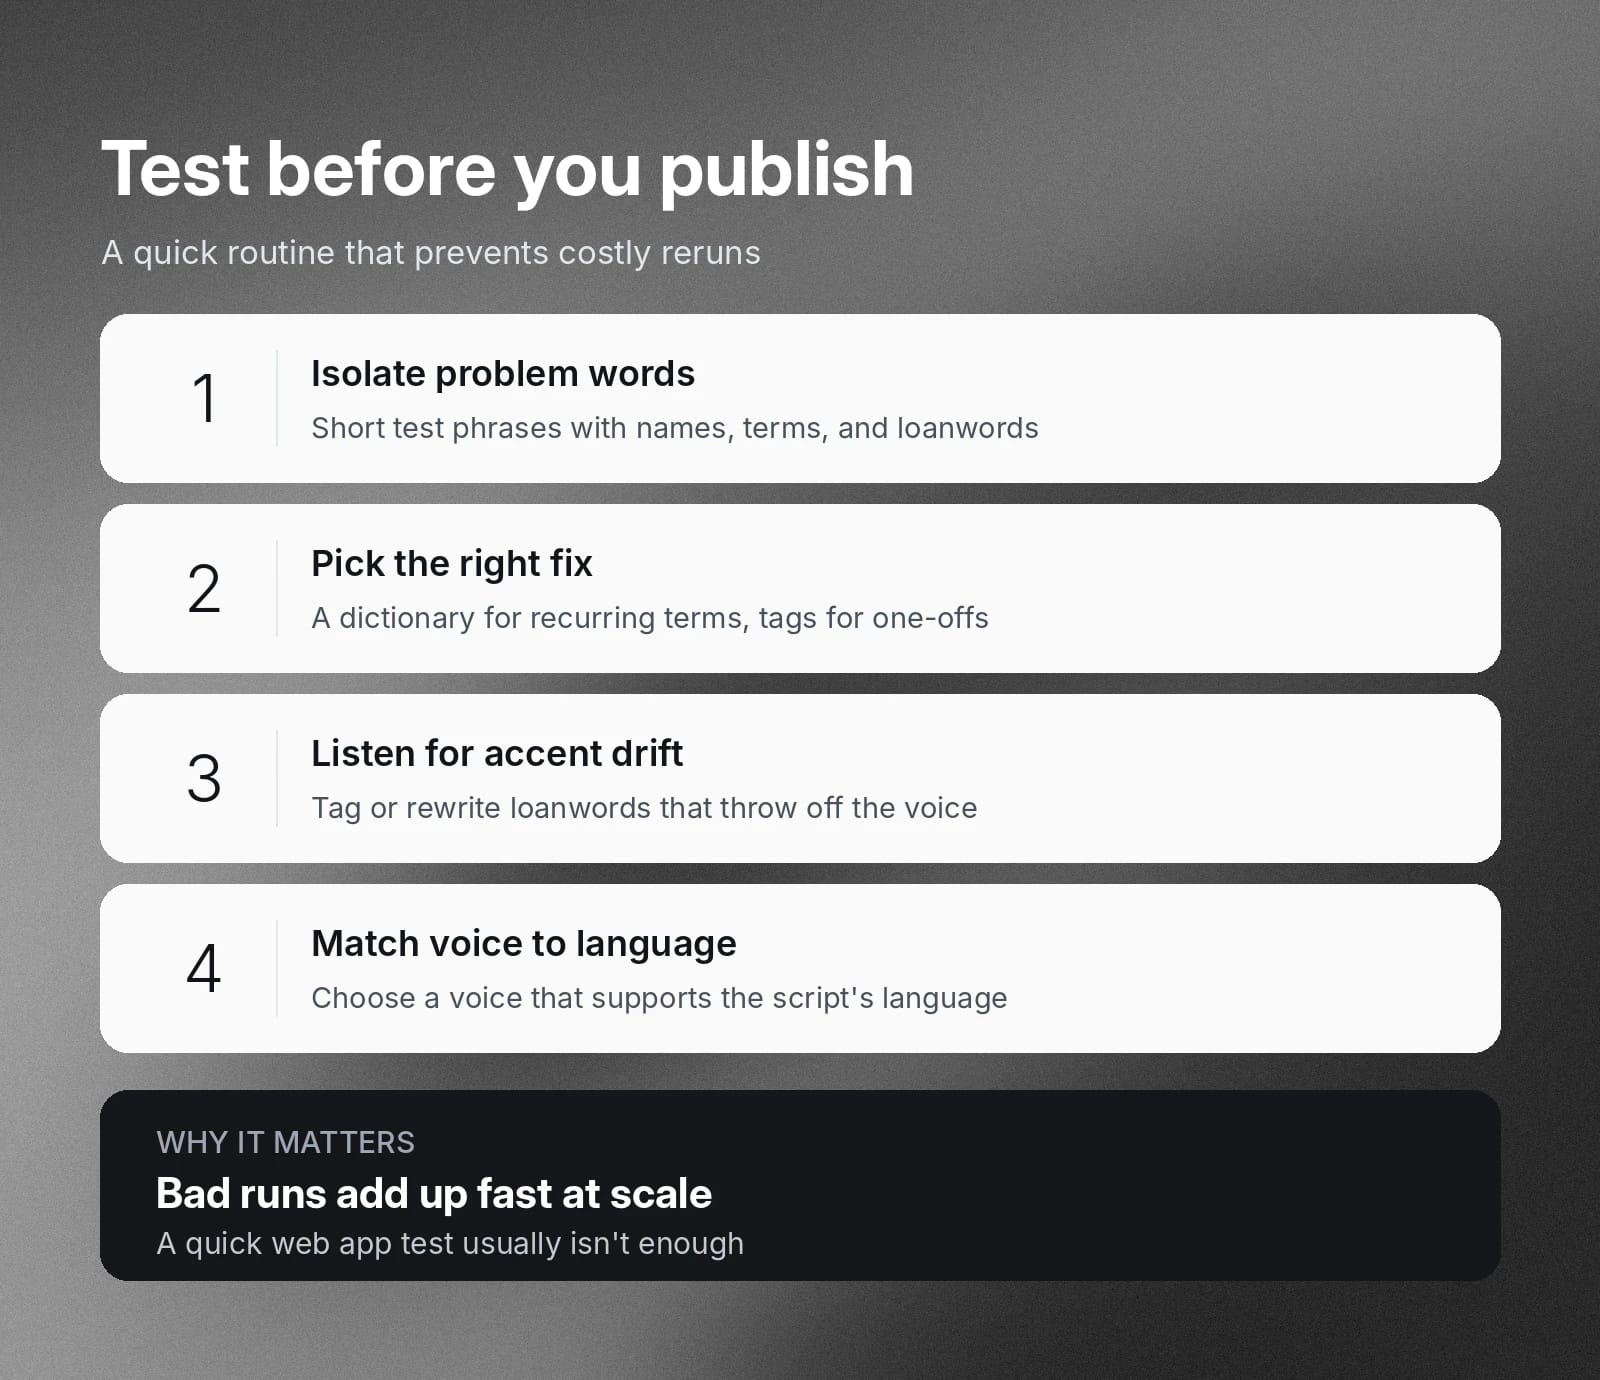
Una prueba rápida en una app web suele ser un control de calidad insuficiente para cargas útiles de TTS a gran escala. El coste de ejecuciones defectuosas puede acumularse rápidamente. Prueba tu guion en una serie de iteraciones controladas antes de enviarlo. Esta preparación previa te ayudará a producir audio de voz de la máxima calidad de la forma más eficiente.
Prueba las palabras problemáticas de forma aislada
Normalmente, los problemas estarán en pasajes concretos o solo en palabras o nombres específicos, en lugar de ser algo generalizado. Crea frases de prueba de cinco a diez palabras que incluyan tus marcas, términos técnicos o expresiones en idiomas extranjeros. Según los resultados, decide si quieres usar un diccionario de pronunciación o solo etiquetas fonéticas para cada caso.
Identifica posibles desviaciones de idioma o acento
Los modelos de voz pueden adoptar ocasionalmente una cadencia extraña o lenta a mitad de una frase. Suele ocurrir cuando el modelo tiene que adivinar cómo pronunciar un pasaje distinto de lo que vio durante el entrenamiento.
- Préstamos lingüísticos: El texto que usa préstamos poco comunes de un idioma extranjero puede alterar la correspondencia de grafemas del modelo y hacer que toda la voz posterior suene con un acento extraño. Usa etiquetas fonéticas en el préstamo o reescribe el texto.
- Voz poco fluida en idiomas distintos del inglés: Un modelo optimizado para inglés puede tartamudear o sonar robótico al leer un guion traducido. Selecciona un perfil de voz que también admita el idioma nativo.
Empieza a usar ElevenAPI para obtener una voz más fiable
Cuando sabes en qué fijarte, generarás contenido de voz de alta calidad más rápido y con menos complicaciones. Aprende a gestionar los problemas de salida y los problemas técnicos de API que podrían bloquear la producción.
Descubre cómo generar contenido de TTS preciso y de alta calidad con ElevenAPI u obtén tu clave de API hoy mismo para empezar.
Preguntas frecuentes sobre problemas de texto a voz

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.