Crear agentes de voz duraderos: algunas lecciones de la ingeniería de despliegue en cliente
- Publicado
- Última actualización
EscucharEscucha este artículo
Durante mucho tiempo, las soluciones puntuales para atención al cliente se han medido, en la mayoría de organizaciones, por su capacidad de derivación. Esto implica reducir el volumen de llamadas y minimizar las interacciones con agentes humanos. Pero derivar no equivale a resolver, y es en esa diferencia donde se deteriora la experiencia de clientes. Para cerrar esa brecha, hacen falta agentes que no solo accedan a datos, sino también a los sistemas necesarios para actuar con ellos. Como resultado, los agentes pueden procesar reembolsos, guiar a clientes durante el proceso de pago y transferir la conversación a un agente humano con todo el contexto cuando la situación lo requiere. Esto permite a las empresas gestionar interacciones con clientes a escala, reduciendo de forma significativa la carga de los equipos de soporte humanos y mejorando la experiencia en ambos lados de la llamada. En una implementación reciente con Revolut, una empresa fintech que atiende a 70 millones de clientes en todo el mundo, esto se tradujo en una reducción de 8 veces en el tiempo de resolución y una tasa de éxito de llamadas del 99,7 %.
Las organizaciones deben abordar cambios de esta magnitud de forma iterativa, estrechamente vinculados a la misión principal de la empresa e impulsados por un sólido respaldo de la dirección. A nivel técnico, razonar en un entorno no estructurado conlleva riesgos inherentes que deben gestionarse con cuidado. Dar a un agente la capacidad de actuar en el sistema de gestión de relaciones con clientes (CRM), modificar un pedido en el sistema de punto de venta o escalar un caso implica que el modelo de gobernanza importa tanto como el propio modelo. Por tanto, la cuestión ya no es si los agentes pueden realizar trabajo real, sino qué mecanismos se necesitan para desplegarlos de forma segura y repetida.
En este artículo compartimos, basándonos en nuestra experiencia, qué hace que los agentes tengan éxito desde el primer despliegue hasta su escalado en toda la operación de atención al cliente de una organización.
Desplegar agentes frente a desplegar software
Antes de profundizar en la creación de agentes, conviene comparar el despliegue de agentes de voz con el del software tradicional, algo que las empresas llevan haciendo décadas. Desde esta perspectiva, los agentes se pueden separar en dos componentes distintos: el software tradicional y el orquestador central.
Software


Orquestador central
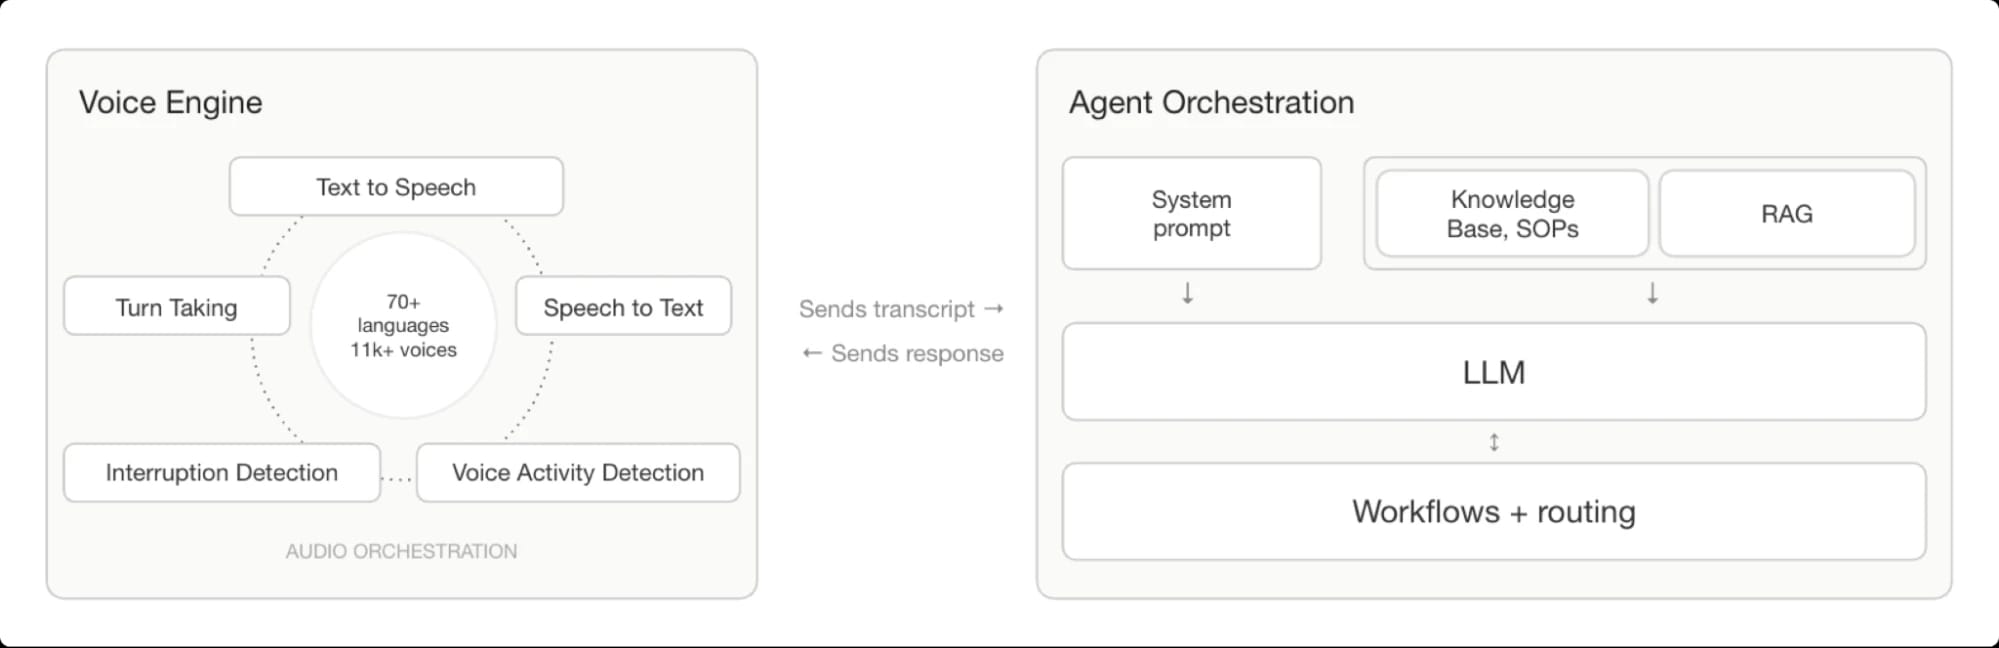
Los componentes de software tradicional están orientados principalmente a mejorar la entrega y el rendimiento del agente. En ElevenAgents, esto incluye funcionalidades como control de versiones, pruebas A/B, telefonía y la configuración del primer mensaje, entre otras. Estos componentes presentan poca o ninguna desviación tras el despliegue, por lo que su comportamiento es muy predecible. Mediante prácticas de ingeniería sólidas, las organizaciones pueden desarrollar estas funcionalidades con rapidez y comprender en profundidad su rendimiento en producción mediante un riguroso conjunto de métricas, trazas y registros. Las mejoras de latencia en esta capa siguen patrones bien conocidos: la caché, la agrupación de conexiones, el escalado de infraestructura y la optimización de protocolos son palancas fiables con resultados deterministas.
Los componentes del orquestador central son, por naturaleza, más difíciles de predecir, pero determinan el rendimiento del agente en tiempo de ejecución, tanto en calidad de respuesta como en latencia percibida. A diferencia del software tradicional, estos componentes operan con lenguaje natural y audio, donde el espacio de entrada es prácticamente ilimitado y pequeños cambios en la redacción, el contexto, el ruido de fondo o el comportamiento del usuario pueden generar resultados notablemente distintos con el tiempo. Por eso, las pruebas convencionales no bastan por sí solas: un agente puede funcionar a la perfección en cientos de casos de prueba y aun así fallar en producción de formas difíciles de anticipar.
La latencia en esta capa también es menos determinista, ya que depende de los tiempos de inferencia del modelo, la incorporación de artefactos auditivos, las cadenas de llamadas a herramientas y la variabilidad inherente a los sistemas generativos. Gestionar bien estos componentes exige otra disciplina: marcos de evaluación, monitorización en producción y la voluntad de iterar continuamente a partir de datos de conversaciones reales, no solo de supuestos previos al despliegue.
Esta distinción define cómo deben abordar las organizaciones la adopción: empezar con casos de uso relevantes para la organización pero de bajo riesgo, y escalar deliberadamente a medida que crece la confianza en el sistema.
Ciclo de lanzamiento
Seleccionar casos pioneros
Para los equipos que empiezan a adoptar agentes de voz, elegir los casos pioneros adecuados es una de las decisiones iniciales más importantes. Además, tiene menos que ver con la tecnología de lo que la mayoría espera. Los equipos que consiguen éxitos tempranos y evitan el interminable abismo de las pruebas de concepto suelen tener algo en común: pueden responder con claridad a las siguientes preguntas.
- ¿Cómo genera este caso de uso un valor empresarial medible? El caso de uso adecuado para empezar no es el más interesante técnicamente, sino el que tiene más probabilidades de mejorar un resultado que ya importa al negocio. Se mide por el impacto en ingresos, la reducción de costes, la satisfacción del cliente y otras métricas que los responsables ya siguen y de las que rinden cuentas. Sin esa conexión directa con el valor empresarial, resulta difícil justificar los ciclos de iteración necesarios para perfeccionar el agente, y es probable que el impulso se estanque antes de que la tecnología pueda demostrar su valor.
- ¿Entienden inmediatamente usuarios cuál es el alcance y el propósito del agente? La ambigüedad en el alcance es una de las fuentes más habituales de desviación entre desarrollo y producción. Usuarios que no entienden qué puede y qué no puede hacer un agente pondrán a prueba sus límites de formas que la suite de evaluación nunca anticipó. Un agente con un alcance bien definido establece expectativas desde el primer mensaje y gestiona con naturalidad las solicitudes que quedan fuera de su ámbito.
- ¿Cómo son las interacciones buenas y malas, y se pueden codificar en un conjunto concreto de criterios de evaluación? Una buena interacción no es simplemente aquella en la que el agente completa la tarea, sino aquella en la que el usuario se siente escuchado, la escalada ocurre en el momento adecuado y el resultado se ajusta a la intención del negocio. Los criterios de evaluación se dividen en dos categorías: métricas cuantitativas recogidas por la plataforma, como la tasa de finalización de tareas y la tasa de escalada, y criterios basados en transcripciones que requieren analizar la propia conversación. Definir pronto los criterios basados en transcripciones da al equipo un objetivo concreto hacia el que trabajar. También establece un umbral natural para salir a producción. Cuando tu agente cumple sistemáticamente sus criterios de evaluación y las métricas de la plataforma se han estabilizado, puedes pasar a producción con confianza. Sin criterios definidos, salir a producción queda a juicio de cada cual.
- ¿Qué concesiones hay entre rendimiento y control, y cuál importa más en esta fase? Cuanta más autonomía se concede a un agente, más naturales y flexibles se vuelven las interacciones, pero mayor es el riesgo de actuar fuera de los límites validados. Un control más estricto mediante prompts acotados y una lógica de escalada más rigurosa reduce ese riesgo, pero puede hacer que el agente resulte rígido. Ninguno de los extremos es correcto. Las organizaciones que restringen demasiado pronto terminan con una IVR con pretensiones. Las que avanzan demasiado rápido antes de generar confianza crean cargas de soporte que superan los beneficios. Comprender dónde debe situarse este equilibrio en cada fase de madurez determinará la configuración del modelo, la lógica de escalada y qué parte del conocimiento del agente reside en el prompt frente a fuentes recuperadas o estructuradas.
Con estas preguntas resueltas, una organización está lista para pasar de la estrategia a la ejecución y empezar a definir el alcance de la implementación.
Sentar las bases de la implementación inicial
Al pasar a la ejecución, los equipos pueden recurrir a metodologías casi tan antiguas como el propio software. El desarrollo guiado por pruebas (TDD) proporciona la estructura necesaria para mantener los agentes alineados con las métricas principales durante toda la implementación.
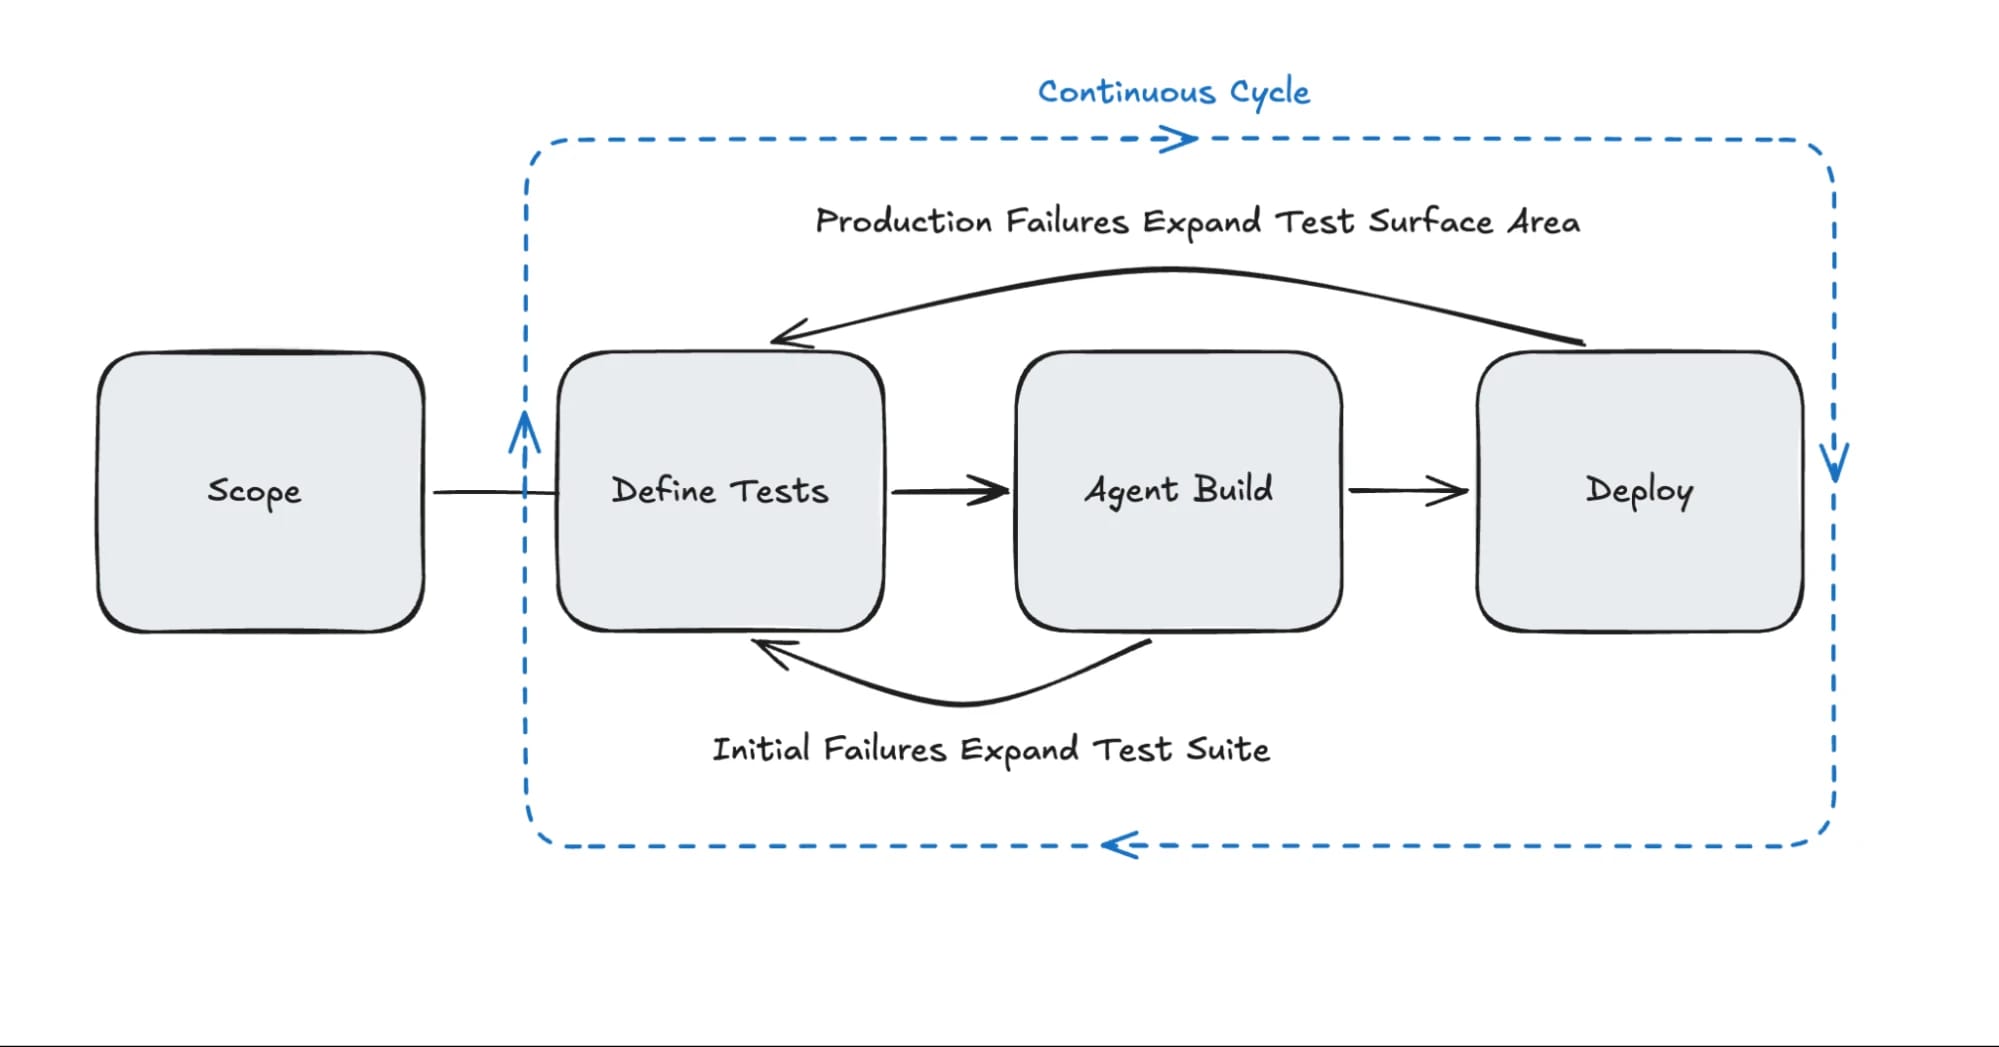
En concreto, los equipos de desarrollo y las partes interesadas del negocio deben definir y crear conjuntamente dos elementos fundamentales: Criterios de evaluación del éxito, que establecen cómo es un buen resultado tanto a nivel de llamada individual como agregado, y Pruebas de agentes, que verifican repetidamente comportamientos específicos que se espera que el agente muestre. El primer elemento se fundamenta mejor revisando llamadas reales realizadas por humanos, una vez que se producen. El segundo se construye de forma incremental: empieza con un conjunto inicial de comportamientos esperados y se amplía a medida que se introducen otros nuevos y se descubren casos límite.
Con un conjunto inicial de pruebas preparado, el desarrollo del agente empieza por el prompt de sistema. Aquí se definen las reglas, el tono y el enfoque del agente: qué debe hacer, qué no debe hacer y cómo debe comportarse en los límites de su función. Un prompt de sistema bien elaborado depende tanto de la estructura como del contenido. Separar las instrucciones en secciones claramente etiquetadas, mantener juntas las indicaciones relacionadas y evitar formulaciones condicionales marcan una diferencia importante en la consistencia con la que actúa el agente. En esta fase recurrimos a menudo a la guía de prompting.
Junto al prompt de sistema, se configuran los componentes principales del agente: el LLM, el modelo de texto a voz (TTS) y la voz. La elección del LLM es principalmente una concesión entre latencia y rendimiento: los modelos optimizados para velocidad suelen sacrificar cierta capacidad de razonamiento, y viceversa. Para TTS, la opción adecuada depende de lo que más exija el caso de uso, ya sea una entonación expresiva, baja latencia o compatibilidad multilingüe. Sin embargo, la voz es tanto una decisión de marca como técnica. Define cómo se presenta una organización ante cada persona que llama, por lo que es una de las pocas decisiones de configuración que corresponde tanto a los equipos de marca y marketing como a los ingenieros que crean el agente. Esto permite seleccionar la voz en paralelo al resto del proceso de desarrollo, en lugar de convertirlo en un cuello de botella al principio o al final. ElevenAgents ofrece acceso a más de 10.000 voces, y, si ninguna encaja, los equipos pueden clonar o crear la suya propia.
A partir de aquí, los agentes se pueden ampliar opcionalmente con una Base de conocimientos, herramientas y configuraciones de canales. Cada incorporación desbloquea nuevas capacidades, pero también introduce una nueva superficie que probar. Ya sea integración de telefonía, acceso a bases de datos externas o capacidad para actuar en nombre de un cliente, merece la pena poner estas decisiones a prueba frente a los criterios de evaluación antes de ampliar el alcance. Al añadir herramientas, el prompt de sistema y la descripción de la herramienta indican explícitamente cuándo y cómo invocar cada una, para que el agente las use de forma coherente y en el contexto adecuado.
Con estas bases listas, el agente está preparado para ponerse a prueba.
Hacia la preparación para producción
Con las pruebas y los criterios de evaluación definidos durante la fase de preparación y ejecutándose ya contra un agente creado, el desarrollo se convierte en un ciclo estrecho: añadir más pruebas, identificar fallos, actualizar el prompt de sistema o la configuración y volver a ejecutar. La mayoría de los fallos en esta fase no son fallos del modelo, sino del prompt. Una instrucción que parecía clara de forma aislada resulta ambigua cuando el agente la encuentra a mitad de conversación. Aparecen casos límite que la suite de pruebas inicial no anticipó. Cada uno se convierte en una nueva prueba de Next Turn que puede crearse a partir de la propia conversación. La cuestión de cuándo dejar de iterar tiene una respuesta concreta: cuando el agente cumple sistemáticamente sus criterios de evaluación en varias ejecuciones y las métricas de la plataforma, como la tasa de finalización de tareas y la tasa de escalada, se han estabilizado dentro de rangos aceptables. Por eso es tan importante definir esos criterios antes de crear el agente. Sin ellos, la preparación queda a juicio de cada cual y la meta no deja de moverse.
En la práctica, la mayoría de equipos descubre que un pequeño conjunto de patrones de fallo recurrentes explica la mayoría de problemas. Los más habituales son la ambigüedad del prompt, cuando el agente recibe instrucciones contradictorias o insuficientemente especificadas y adopta comportamientos impredecibles; el uso incorrecto de herramientas, cuando el agente invoca una herramienta en un contexto equivocado o no la invoca cuando debería; y la desviación en las escaladas, cuando el agente escala con demasiada facilidad o retiene conversaciones que debería haber transferido. Cada uno tiene una solución a nivel de prompt. Normalmente basta con precisar la instrucción relevante, añadir un ejemplo explícito o ajustar el umbral de escalada. El riesgo está en no detectarlos antes de salir a producción.
El error más habitual de los equipos es tratar una suite de pruebas aprobada como una garantía y no como una señal. Una suite que solo cubre el camino ideal aprobará fácilmente y aportará muy poco. La cobertura de rechazos, cambios de dirección a mitad de conversación, entradas ambiguas e interacciones que usan muchas herramientas es lo que da peso a los resultados. Del mismo modo, los equipos que omiten las pruebas de simulación y dependen únicamente de pruebas a nivel de turno pasan por alto una clase de fallos que solo surgen en una conversación completa, como la desviación de contexto, cuando el agente pierde el hilo de los turnos anteriores, o los errores acumulativos, cuando un pequeño error al inicio de la llamada deriva en un mal resultado. Una vez resueltos los patrones de fallo recurrentes y cuando el agente gestiona con naturalidad —aunque no a la perfección— la larga cola de casos límite, el valor marginal de seguir iterando en preproducción disminuye. En ese momento, la señal más valiosa procede de conversaciones reales.
Salir a producción no significa que la iteración haya terminado. Significa que el centro del aprendizaje pasa de las pruebas sintéticas a las transcripciones de producción. Los criterios de evaluación que definieron la salida a producción se convierten en la referencia con la que se mide el rendimiento real, y el ciclo continúa desde ahí.
Bucles de retroalimentación, evaluación y cuándo dejar de iterar
Una vez definidas y en marcha las pruebas, las carencias de la canalización se hacen visibles rápidamente. Mediante Análisis de conversaciones, los equipos pueden identificar el momento exacto en que una interacción salió mal y usar esa señal para crear una nueva prueba y determinar qué debe cambiar. Las intervenciones más comunes se realizan a nivel de prompt: precisar las descripciones de las llamadas a herramientas, añadir instrucciones más explícitas para casos límite o aclarar condiciones de escalada que resultaron ambiguas en la práctica. En algunos casos, el problema está más abajo y hay que revisar la configuración del modelo subyacente si la latencia o la calidad del razonamiento no alcanzan lo que exige el caso de uso.
La disciplina más importante en esta fase es validar los cambios en lugar de darlos por supuestos. Una solución que resuelve un fallo puede introducir silenciosamente otro. ElevenAgents permite el control de versiones, lo que permite a los equipos probar nuevas iteraciones con un pequeño porcentaje de usuarios antes de extenderlas a una población más amplia. Así se puede confirmar que las mejoras realmente mejoran los resultados, en lugar de desplazar el modo de fallo a otro lugar.
Qué puede salir mal
El error con mayores consecuencias en esta fase es omitir los lanzamientos por ramas y aplicar los cambios directamente a toda la población de usuarios. Sin lanzamientos graduales, se pierde la capacidad de aislar el impacto de cada cambio y, a escala, resulta casi imposible entender qué está impulsando realmente las mejoras o los retrocesos en las métricas de la plataforma. Tratar a toda la base de usuarios como entorno de pruebas no solo es arriesgado; elimina la observabilidad necesaria para tomar decisiones con confianza en adelante.
Además de la estrategia de lanzamiento, conviene protegerse frente a otros dos modos de fallo. El primero es dar demasiado peso a los fallos recientes. Cuando una conversación muy visible sale mal, surge el impulso natural de corregirla de inmediato y de forma generalizada, pero los cambios reactivos en el prompt realizados sin ejecutar la suite de pruebas completa suelen provocar regresiones en comportamientos que antes eran estables. Cada cambio, por menor que sea, debe tratarse como una nueva iteración y probarse en consecuencia. El segundo es la desviación de la evaluación. Con el tiempo, los equipos pueden rebajar inconscientemente el listón de lo que cuenta como una prueba aprobada, especialmente bajo la presión de lanzar. Los criterios de evaluación definidos durante la definición del alcance deben seguir siendo el ancla. Si empiezan a parecer demasiado estrictos, la respuesta correcta es revisarlos y actualizarlos deliberadamente, no dejar que los estándares se deterioren de manera informal.
Escalar con confianza
Aumentar el tráfico es una decisión basada en la confianza, no en el tiempo. La señal para ampliar es que el agente cumple sistemáticamente sus criterios de evaluación en varias ejecuciones de prueba, las métricas de la plataforma se han estabilizado y los lanzamientos por ramas no han mostrado regresiones significativas frente al grupo de control.
Una pregunta habitual en esta fase es cuánto tráfico basta para extraer una conclusión. Los lotes de menos de 100 llamadas por rama generan demasiada variación para evaluar resultados de forma fiable. Una tasa de aprobación del 60 % en 25 llamadas y una tasa de aprobación del 60 % en 100 llamadas representan niveles de confianza muy distintos. Además de alcanzar un número definido, el lote debe ser lo bastante grande como para reflejar toda la gama de entradas realistas, incluidos casos límite probables, intenciones poco comunes y modos de fallo que solo aparecen con volumen y rara vez se muestran en muestras pequeñas.
Más tráfico amplifica tanto lo que funciona como lo que no. Ampliar antes de resolver los patrones de fallo principales crea una carga de soporte difícil de revertir.
Repetir el proceso
Saber dónde parar es tan importante como saber qué corregir. La iteración ofrece rendimientos decrecientes, y la señal adecuada para hacer una pausa es que el agente cumple sistemáticamente los criterios de evaluación establecidos durante la definición del alcance. En ese punto, los cambios adicionales conllevan más riesgo que beneficio.
El significado de «cumplir sistemáticamente los criterios» varía según el contexto. Los equipos con acceso limitado a datos o integraciones incompletas pueden considerar que unas tasas de escalada cercanas al 50 % son un límite realista hasta resolver esas restricciones. Cuando el acceso a datos es sólido, los despliegues con mejor rendimiento suelen aspirar a una finalización de tareas superior al 80 % y a una escalada inferior al 20 %. Más importante que cualquier cifra aislada es la estabilidad: un rendimiento constante durante varias semanas de tráfico de producción, sin regresiones significativas entre ejecuciones de prueba, es la señal real. Cuando la mejora marginal de la siguiente iteración es menor que el riesgo de regresión, es momento de parar.
Eso no significa que el trabajo haya terminado. Cuando surgen nuevos requisitos, el proceso vuelve a empezar desde arriba. Las preguntas de definición del alcance de la primera implementación siguen siendo igual de relevantes para la segunda. La diferencia es que los equipos que entran en un segundo ciclo lo hacen con una suite de pruebas, una referencia de evaluación y una experiencia operativa que el primer ciclo tuvo que crear desde cero. Esa ventaja acumulativa es lo que distingue a las organizaciones que obtienen un valor duradero de los agentes de voz agentes de aquellas que siguen atrapadas en una prueba de concepto.
Conclusión
Los equipos que hemos visto cerrar la brecha entre derivación y resolución son los que definen cómo es un buen resultado antes de empezar a crear, mantienen la disciplina durante el ciclo de iteración y tratan cada despliegue como la base del siguiente. Los agentes conversacionales no son un despliegue puntual: las conversaciones reales revelan casos límite que ninguna suite de pruebas anticipa por completo, y el trabajo de mejora no termina al salir a producción.
ElevenAgents se ha creado en torno a esta realidad. Las Pruebas de agentes, el Análisis de conversaciones y los lanzamientos por ramas son la base que transforma una prueba de concepto en un sistema que resuelve de verdad los problemas de clientes a escala, no que se limita a derivarlos. Esa es la brecha que merece la pena cerrar.


