实用指南:开源智能体框架与 ElevenAgents
- 发布时间
- 最近更新
收听收听本文
在上一篇文章《将外部智能体集成到 ElevenLabs 语音编排》中,我们介绍了团队如何通过 Custom LLM 将现有的文本智能体编排接入 ElevenLabs。本指南将在此基础上,演示如何调整领先的开源智能体框架,并部署在 Custom LLM 接口之后。由此形成的灵活架构,可在不影响状态管理、工具编排或应用专属控制的前提下,为成熟的智能体系统添加语音功能。无论使用哪种框架,我们都遵循相同的 3 步模式:创建生成请求、提取最终文本响应,并重新格式化为兼容 OpenAI 的服务器发送事件(SSE)格式。ElevenLabs 同时支持 Chat Completions 和 Responses 格式。尽管本指南介绍了 4 个广泛采用的框架,但这些模式适用于任何能生成兼容 OpenAI 流式输出的运行时。
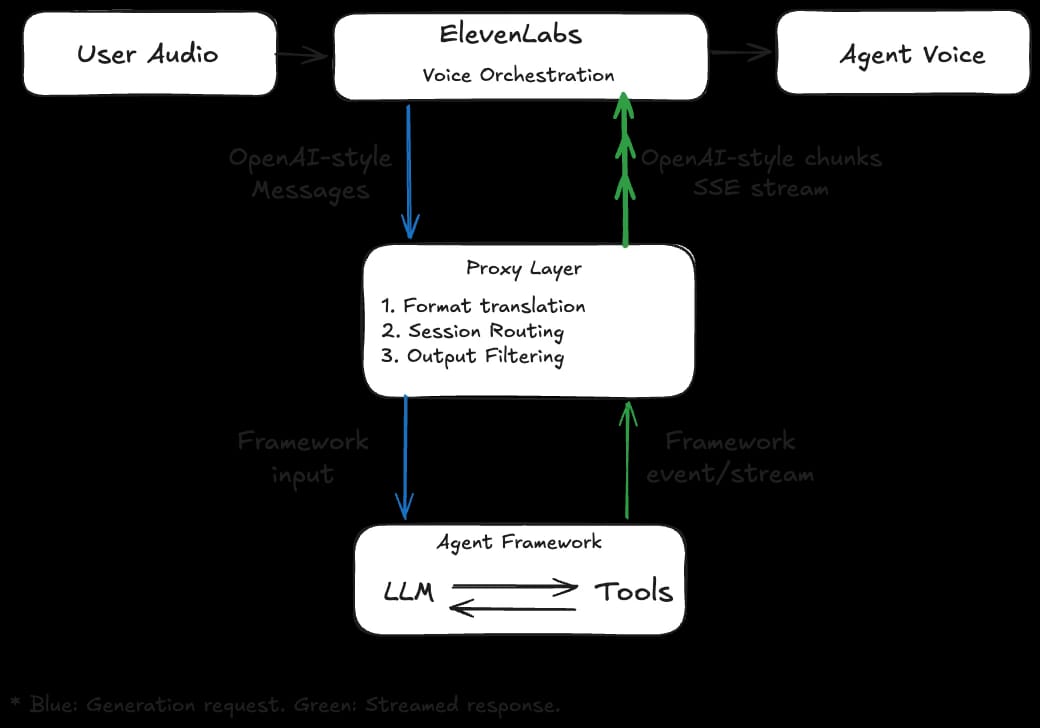
通用设置
本节示例使用 Python 和 FastAPI,但任何能处理 HTTP POST 请求和流式 SSE 响应的技术栈都可以。ElevenLabs 的语音编排检测到可能的轮次结束时,会向配置的 Custom LLM 端点发起生成请求。本节将介绍这一转换层的核心组件:让语音编排与智能体框架使用相同语言的桥接层或代理。
不同客户选择框架,通常是因为熟悉它,或因为它能满足特定需求。例如,LlamaIndex 最初旨在简化检索增强生成(RAG)的搭建;CrewAI 则诞生于智能体时代,旨在自动化执行明确的任务。不同设计目标会产生不同的响应结构,需要分别处理。让 LLM 在生成时就流式传输内容块,而不是等待完整轮次结束,至关重要:这样文本转语音(TTS)模型能更早开始生成语音,从而降低感知延迟。我们将重点介绍 4 个常用框架:LangGraph、Google ADK、CrewAI 和 LlamaIndex。
关于共享代码
每个框架都必须以兼容 OpenAI 的 SSE 块流式传输响应。我们先介绍一个在各示例中通用的小型辅助函数,用于构建这些块。
基础准备就绪后,我们从 LangGraph 开始。
LangGraph
LangGraph 将 智能体 建模为图:节点代表各个步骤,边定义它们之间的控制流。最小化配置很简单:初始化聊天模型、定义智能体工具,然后创建智能体图运行时。
每次生成请求时,LangGraph Agent 都会收到完整的对话历史,从而在内部维护所需状态。LangGraph 支持通过 Checkpoints 实现服务端持久化,但为保持实现精简,本文不展开介绍。
状态管理完成后,下一个 LangGraph 专属决策点是流式模式。LangGraph 提供两种选项,各自适用于不同场景:
- stream_mode="values" 提供图状态快照。它实现更简单,但每次响应都包含更完整的消息状态,会增加实时对话流程的延迟。
- stream_mode="messages" 会流式传输模型逐步生成的消息块。实时语音交互通常更适合使用它,因为它能缩短 ElevenLabs 编排层的首段音频生成时间。
更具体地说,智能体循环的 messages 实现包含 工具调用 等不应朗读的中间步骤更新。代理会将其过滤,只把面向用户的响应文本传给 TTS 层。以下是一个启用工具的轮次示例。
[1] 模型决定调用工具(tool_calls=["get_price"])[2] 工具执行并返回数据(result="$24.99") [3] 模型使用结果生成响应(content="价格是 $24.99")
显然,SSE 流中应只转发步骤 3 的内容块。实际操作中,流式循环通过两项保护检查完成过滤:一项仅保留 langgraph_node == "model" 事件,另一项跳过空内容。两者结合,可确保只有面向用户的助手文本以 SSE 形式转发到 ElevenLabs。综合这些概念,下面给出一个轻量级请求代理实现。
这样可确保只有面向用户的模型内容块被转发到 ElevenLabs。由于 LangGraph 会通过状态流公开其内部工具执行过程,过滤规则明确且由代理控制。
接下来,我们深入了解使用 Google Agent Development Kit(ADK)时的细节
Google ADK
Google 的 ADK 将运行时循环抽象为几个核心原语:Agent、Runner 和 SessionService。ADK 的 Runner 位于 HTTP 层与智能体定义之间,负责消息路由、工具编排、会话生命周期和事件流传输。
初始化智能体、会话后端和运行器后,代理会为每个传入请求解析或创建 ADK 会话。在 ADK 中,session_id 控制记忆持久化:跨轮次复用同一个 session_id,会自动保留历史记录、工具调用和之前的响应。由于对话身份由 ElevenLabs 上游维护,代理需要明确处理这种映射。为生成请求传入正确标识符后,SDK 就能在内部处理先前上下文。我们会在发起对话时,通过传入请求正文的 额外参数 传递任意标识符。
准备好消息和会话后,即可调用运行器。工具调用和工具结果在执行期间仍会以内部 ADK 事件出现,但它们被视为中间编排步骤,而非面向用户的输出。相比工具调用会以用户可见文本出现的框架,这无需手动过滤。
下面的处理器是简化实现,内联包含会话解析和获取或创建逻辑。
接下来看看 CrewAI,它在设计上更以任务为中心。
CrewAI
CrewAI 旨在围绕结构化任务(研究、写作、总结)编排 多智能体工作流,而不是处理开放式对话循环。智能体由角色、目标和背景故事定义。执行过程以 Task 对象为核心,每个对象都有明确描述和预期输出。
不同于 LangGraph 和 ADK 使用的智能体循环模型,CrewAI 通常会为每个请求构建 Task 和 Crew,用来定义该对话轮次的工作单元。我们通过占位符将先前轮次注入下一个任务,以延续对话上下文。每次请求都会用持续累积的对话历史填充 {crew_chat_messages} 变量,并在执行时将其插入任务描述。为生成干净、可直接朗读的文本,我们还会明确过滤中间追踪模式(Thought、Action、Action Input、Observation),只输出最终答案文本。
下面的处理器整合了按请求构建任务、插入历史记录、Crew 级流式传输、追踪过滤和输出格式化。
接下来看看 LlamaIndex,它采用了另一种路径,重点是原生事件驱动流式模型。
LlamaIndex
与本文介绍的其他框架不同,LlamaIndex 的设计目标是将 LLM 连接到外部数据源(文档存储、索引、检索管道)。其智能体层 FunctionAgent 建立在这一基础上,用于检索和推理结构化上下文,而非开放式对话或任务执行。
为保持对话连续性,代理会将传入消息转换为 LlamaIndex 聊天消息,再拆分为最新用户轮次(user_msg)和之前的轮次(chat_history)。每个 AgentStream 事件的 event.delta 字段都包含下一个文本片段,可直接映射为 OpenAI 风格的 delta.content 块。非空 delta 可原样转发,因此这是本指南中最直接的流式桥接方式。流中既包含编排事件(工具调用、结果),也包含语音事件(助手文本增量)。为保持语音输出干净,代理仅保留 AgentStream 事件,并跳过空 delta。
[1] AgentStream(delta='') ← 已忽略[2] ToolCall ← 已忽略[3] ToolCallResult ← 已忽略[4] AgentStream(delta='它') ← 已转发 ✓[5] AgentStream(delta=' 的价格')← 已转发 ✓[6] AgentStream(delta=' $49.99')← 已转发 ✓
这种分离方式能让中间工具机制不进入朗读输出,同时保留低延迟的增量语音。下面可直接使用的处理器整合了这些步骤。
与内置编排层更重的框架相比,LlamaIndex 对端到端对话运行时模式的规定较少。对于生产部署,客户通常需要自行实现会话处理、响应护栏、工具编排和追踪。
结语
本指南中的每个框架都通过同一约定连接到 ElevenLabs:接收 OpenAI 风格的 Completions 或 Responses 请求,并流式返回 SSE 内容块。这样团队只需做少量改动,就能在现有智能体实现之上添加语音编排,既保留已有成果,又能实现实时 对话式 AI。这种模块化是 ElevenAgents 平台的核心理念。无论组织是在扩展现有智能体,还是从头构建语音原生应用,ElevenAgent 的语音编排都能适配其当前需求。
如果你已使用开源框架运行智能体,并希望启用语音功能,不妨试试这种方法,并告诉我们你的体验。



