如何解决文本转语音准确性问题
- 发布时间
尽管经过海量语音数据集训练,并能稳定生成高保真音频,大多数文本转语音(TTS)模型仍可能误读单词或出现其他语音问题。当 TTS 引擎遇到超出训练数据集语音范围的词语或短语时,就会出现误读。这最常见于行业术语、品牌名称或专有名词。
如果文本段落很长,或标点是为阅读而非朗读设计,TTS 引擎也可能生成过快、生硬或机械的语音。
通过 API 将应用连接到 TTS 引擎时,也可能遇到一些常见技术问题。
本文将探讨这 3 类问题及其常见解决方法。
摘要
- 文本转语音故障通常分为发音错误、语速或节奏不自然,以及技术性 API 执行错误。
- 解决误读最有效的方法是使用符合 W3C 标准的发音词典规范(PLS)词典,或通过脚本内联音标标签逐个调整。
- 通过恰当排版和添加标点,可帮助控制语音输出的自然度。为朗读而写的文本通常不同于仅供阅读的文本。
- 可通过标准 HTTP 状态码诊断 API 故障。
- 提前单独测试品牌名称、专有名词和新造短语的发音,能省去后续大量排查工作。
为什么文本转语音无法使用?
文本转语音问题大致分为 3 类。
TTS 问题类型
发音错误
TTS 模型误读了新词或短语,例如品牌名称、行业术语、缩略词或同形异音词。
表达和节奏不自然
输出语音单调、在不该停顿处停顿,或快速读过需要放慢的段落。
集成和 API 故障
应用因一个或多个技术原因无法生成语音,例如遗漏音色 ID、超出工作负载限制或 API 密钥失效。
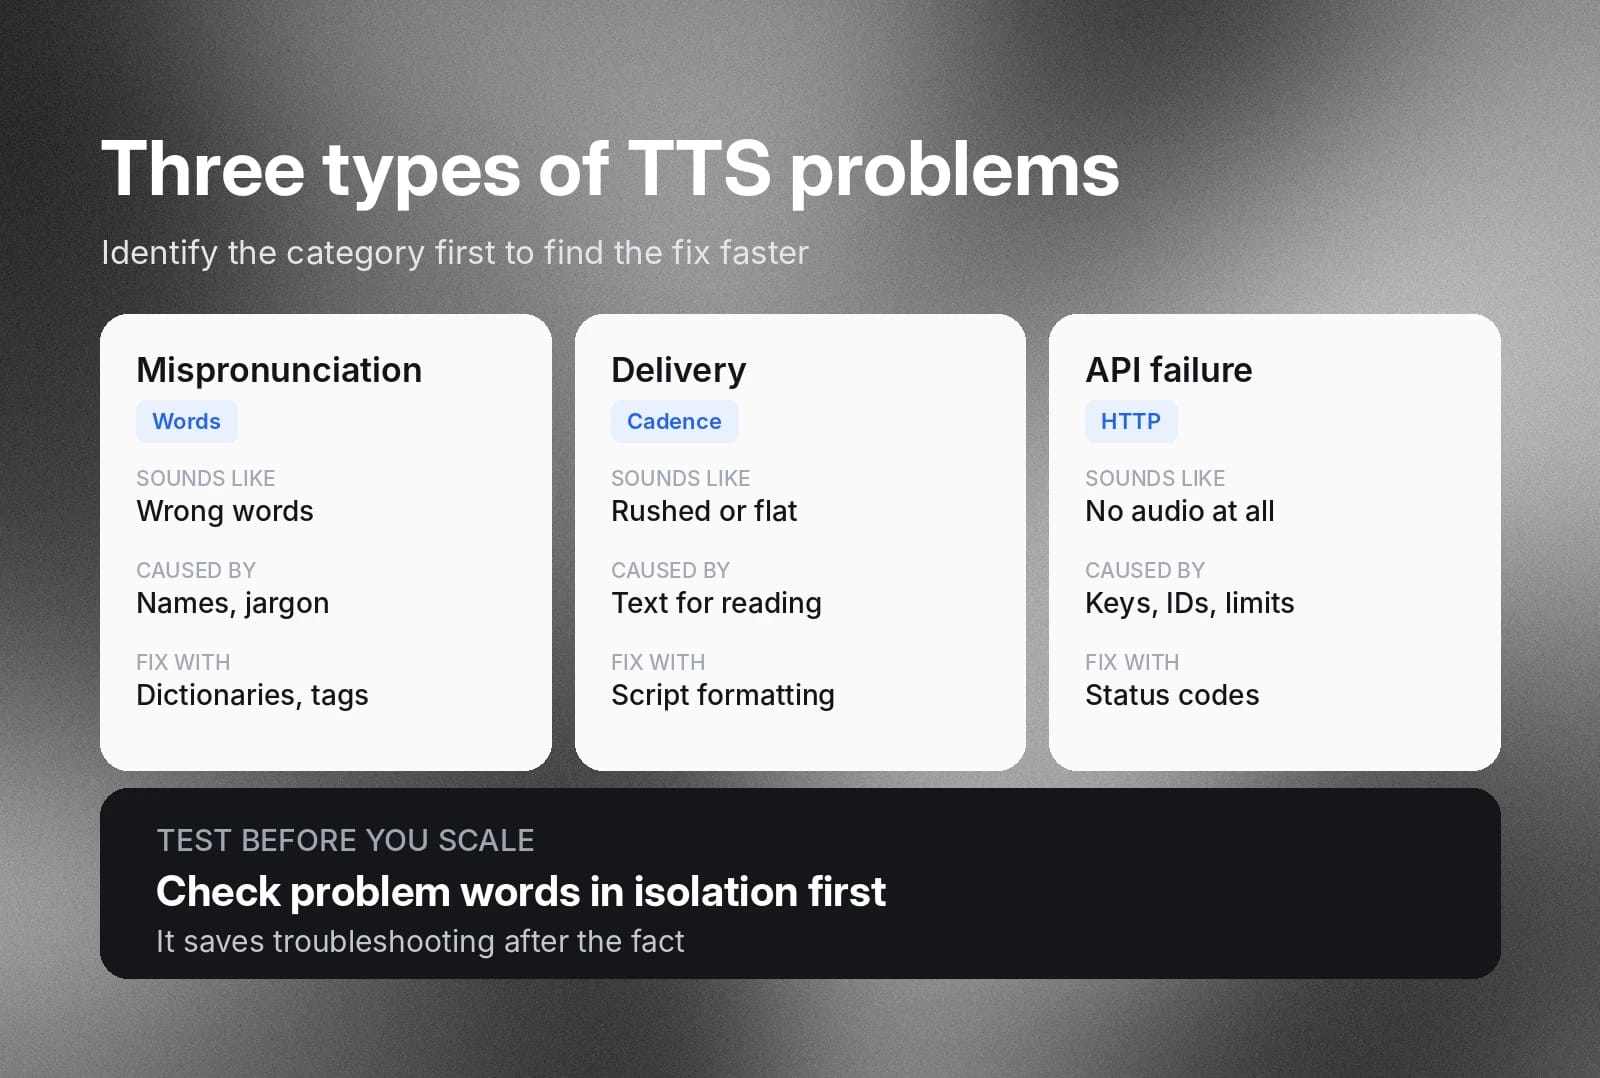
本指南将详细拆解这 3 类问题,帮助你准确了解所面对的输出质量或技术问题。理解这些问题后,能更快找到正确解决方案。
如何解决文本转语音准确性问题:发音错误和表达不自然
工程师使用海量语音数据集训练现代神经语音模型。它们能以近乎无数种词语组合生成自然语音。但没有任何训练数据集能涵盖一切。总会有边缘发音、生僻词或专有名词是模型无法正确朗读的。
这种情况并不常见,但经常使用 TTS 模型的人都应了解发生时该如何处理。首先,重要的是理解这些误读为何发生。
语音错误的常见根本原因
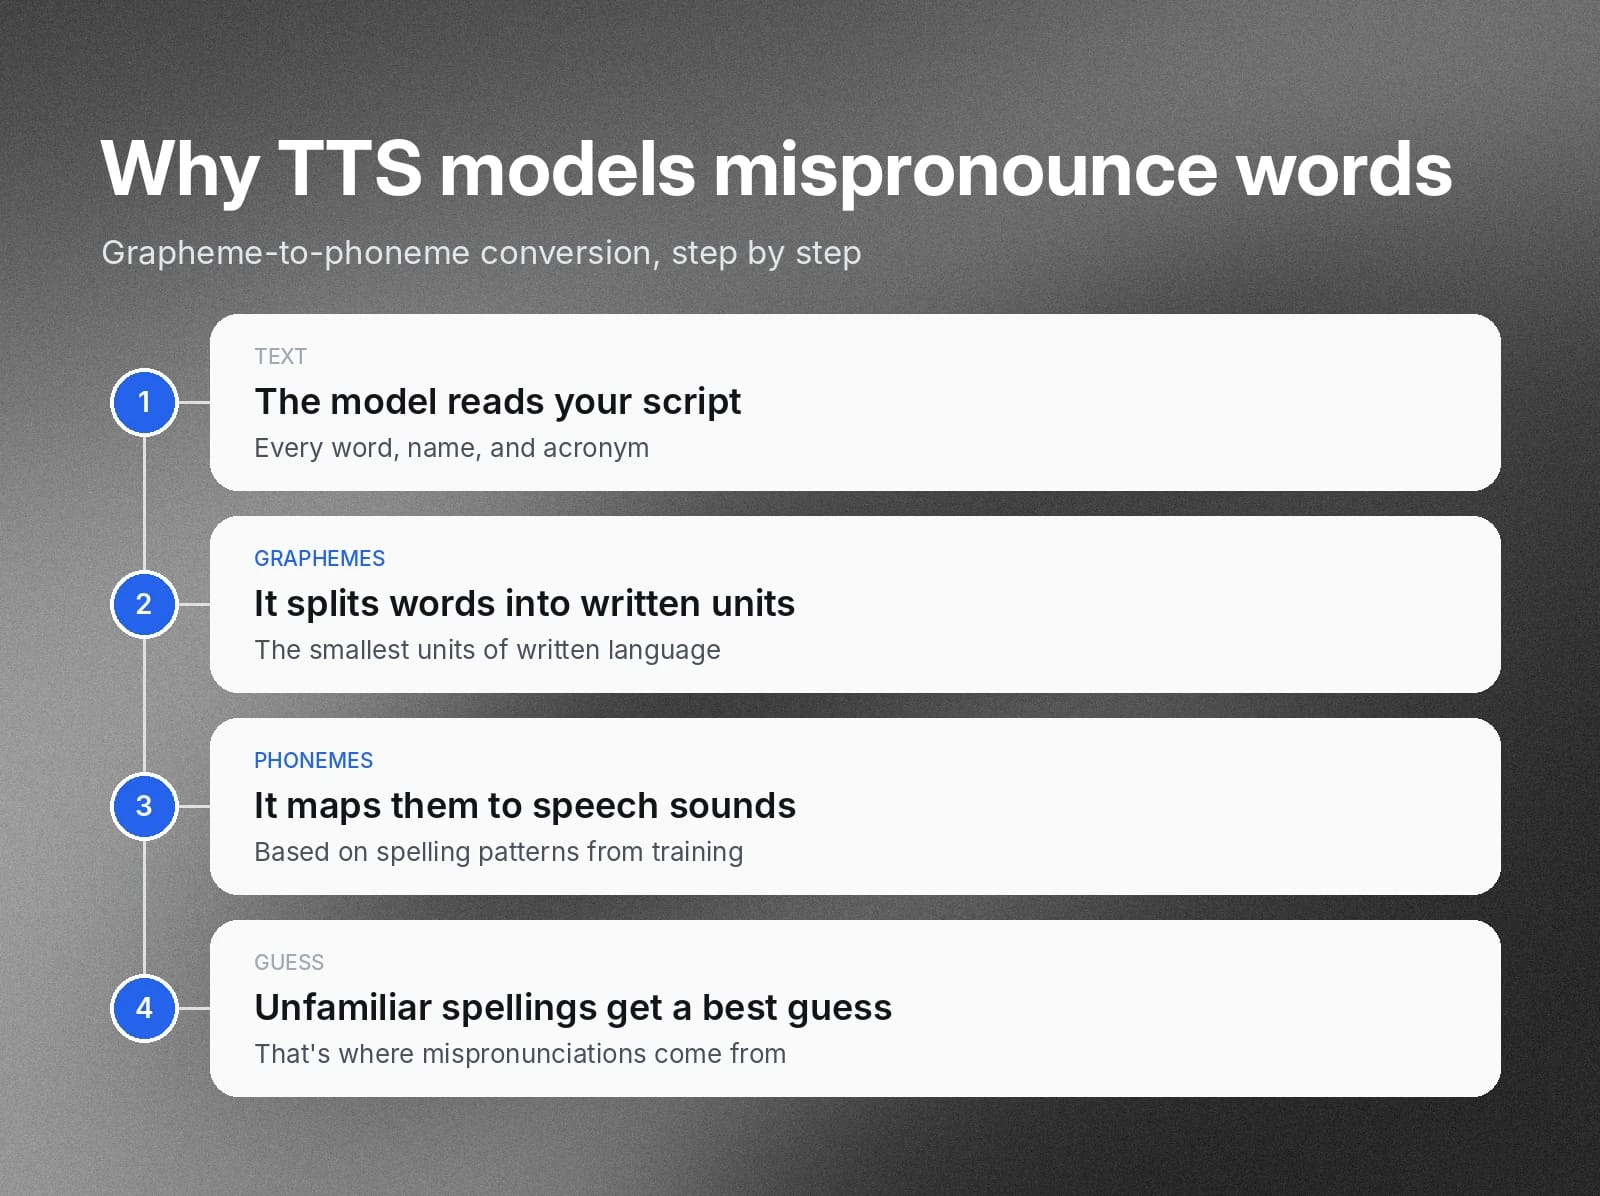
语音合成模型通过一种称为字素到音素(G2P)转换的过程,将文本转换为语音。音素是语音中最小的声音单位。字素是书面语言中最小的单位,通常是代表一个音素的字母。
当文本输入不符合模型在训练数据中见过的拼写模式时,模型会尽力猜测其语音发音,有时便会导致误读。
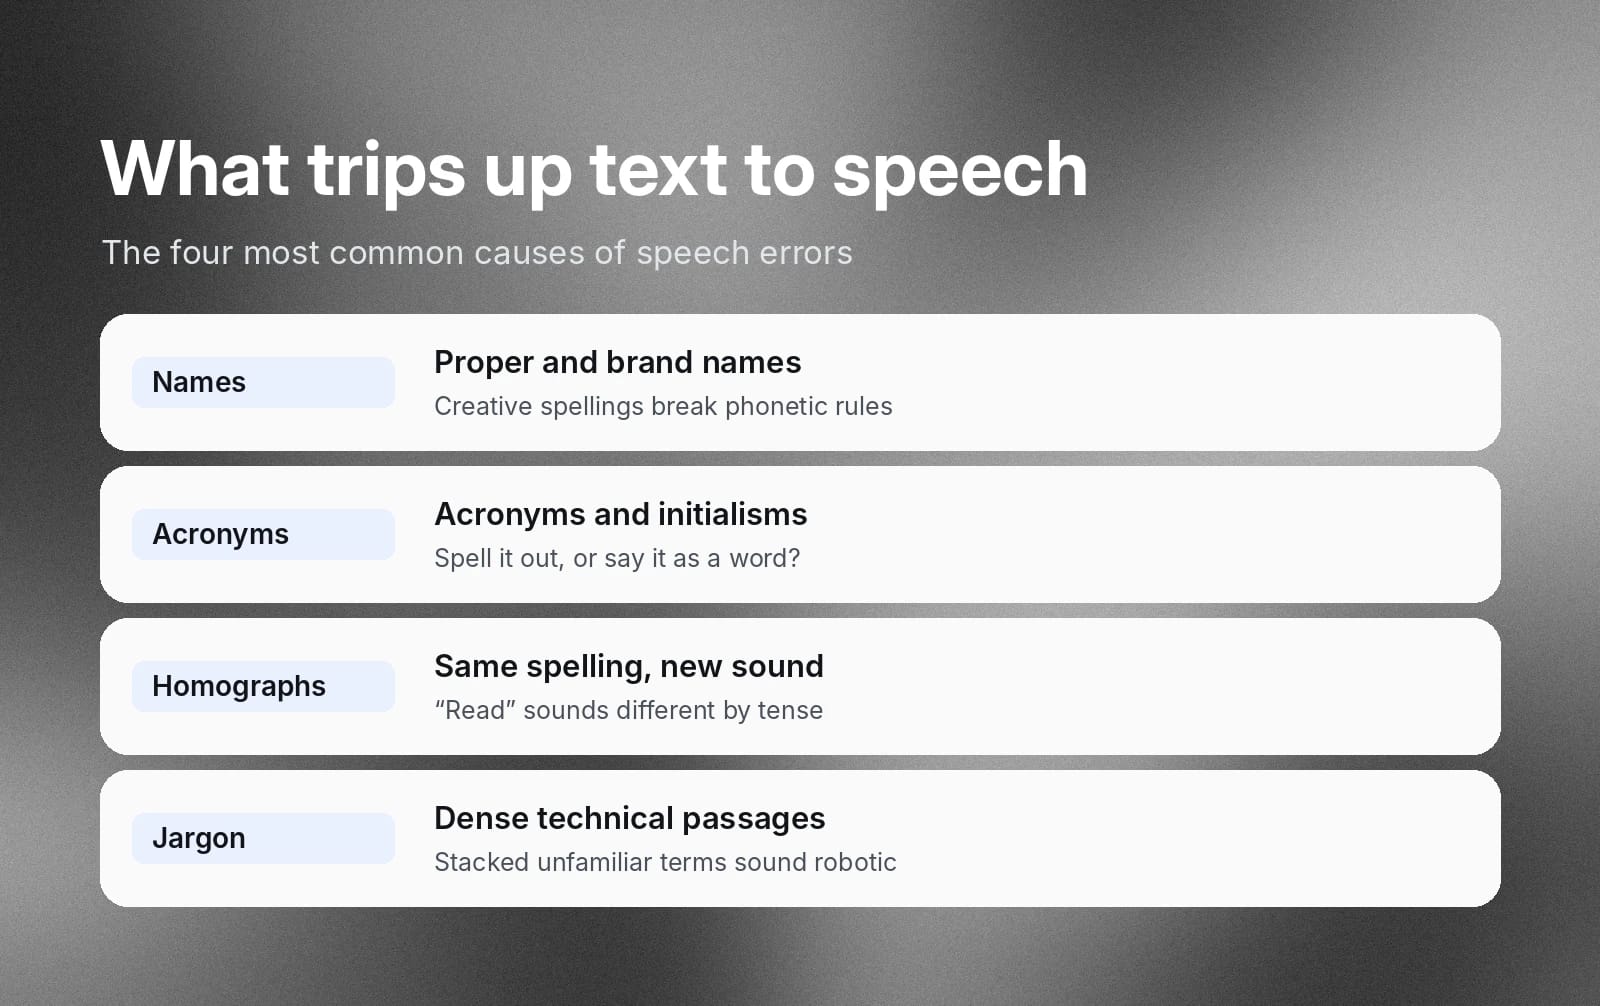
专有名词和品牌名称
企业常为品牌名称采用创意拼写。它们很吸睛,却也常让语音合成模型困惑。创意名字和姓氏同样如此。
模型遇到陌生名称时,会尝试应用学到的基本发音规则。生成的语音可能与预期相去甚远。
首字母缩略词和字母缩写词
想想缩略词 NASA。假设你从未见过它,就像语音模型一样。你会读成“N.A.S.A.”还是“nasuh”?软件 API 呢?是“A.P.I.”还是“apee”?如果公司正在销售一款采用新缩略词的全新软件工具,该缩略词肯定不在语音模型的训练数据中。因此,除非提供自定义指令,模型只能猜测你希望如何发音。
同形异音词
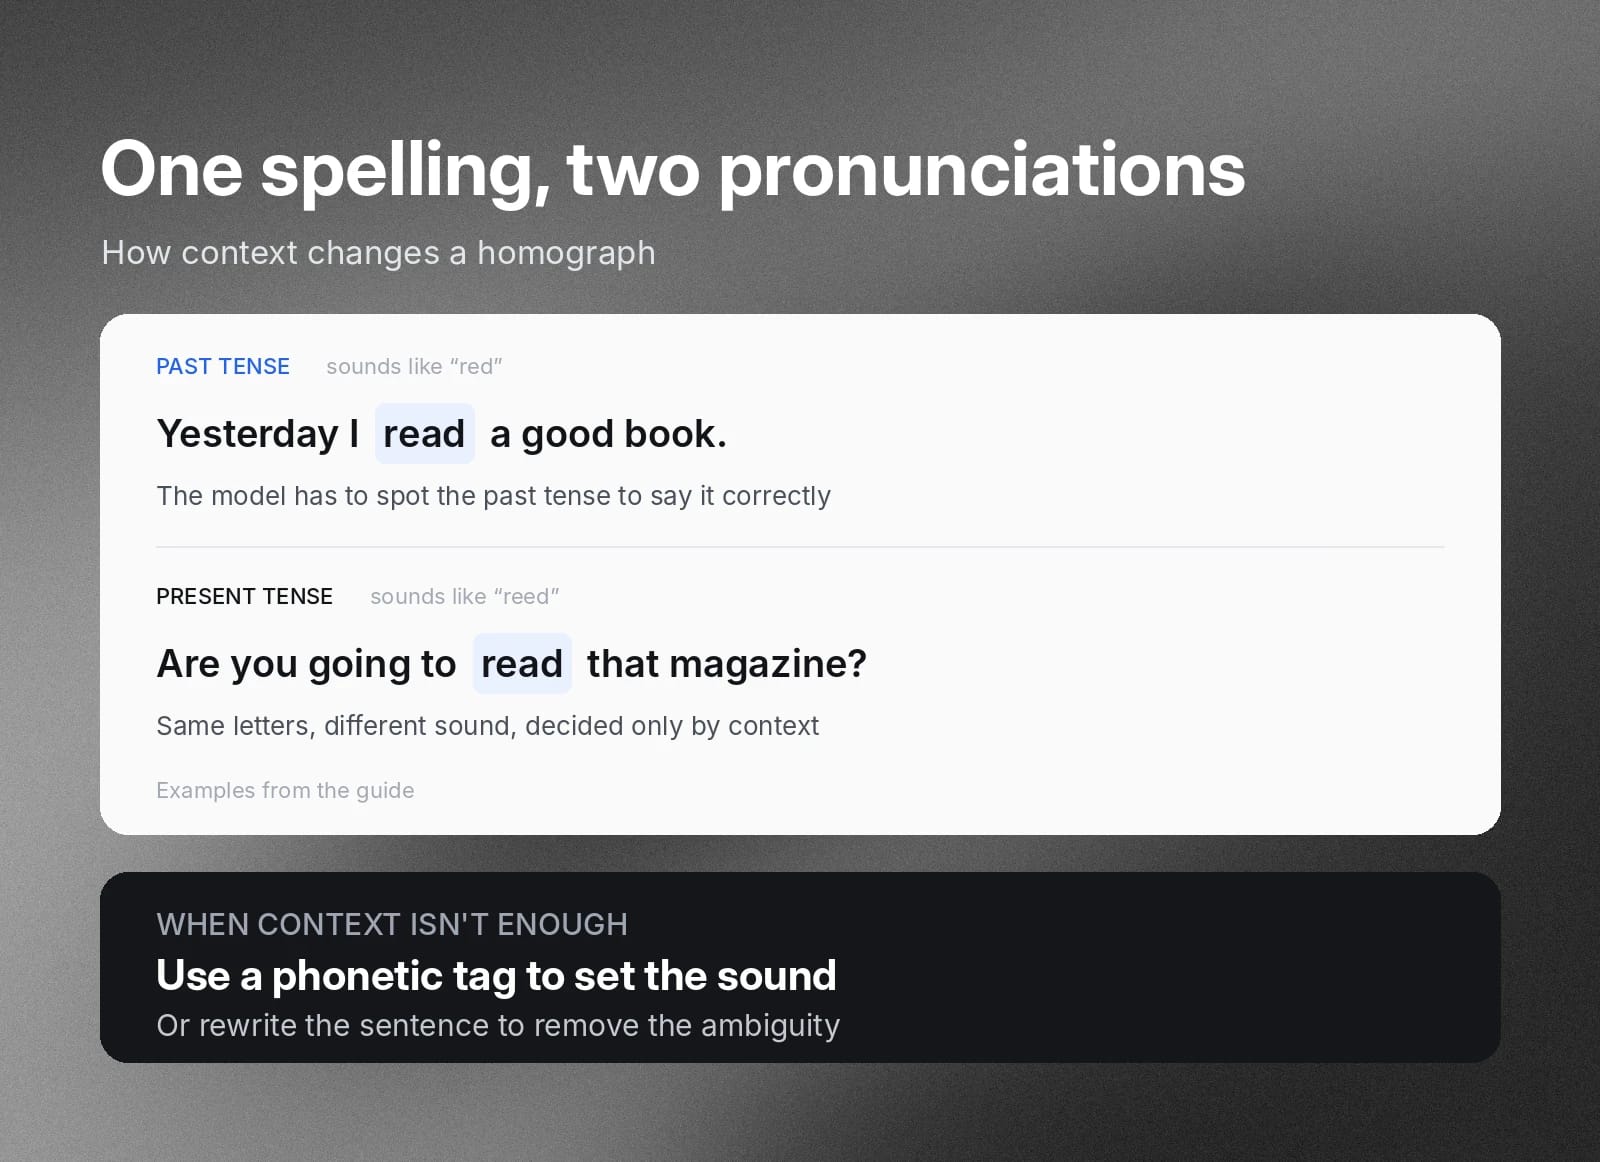
同形异音词指拼写相同但会随上下文有不同发音的单词。例如,“read”拼写相同,但过去时和现在时的发音不同。
- “昨天我读了一本好书。”
- “你要读那本杂志吗?”
语音模型需要充分理解上下文,才能按你的期望发音同形异音词。
重音模式不自然
包含大量技术术语的长句,可能迅速堆叠生僻词、特定发音和缩略词。模型尝试解析许多陌生词语和表达时,原本不易察觉的单个错误很快会融入平淡、机械的语音中。
控制语音发音的两种方法
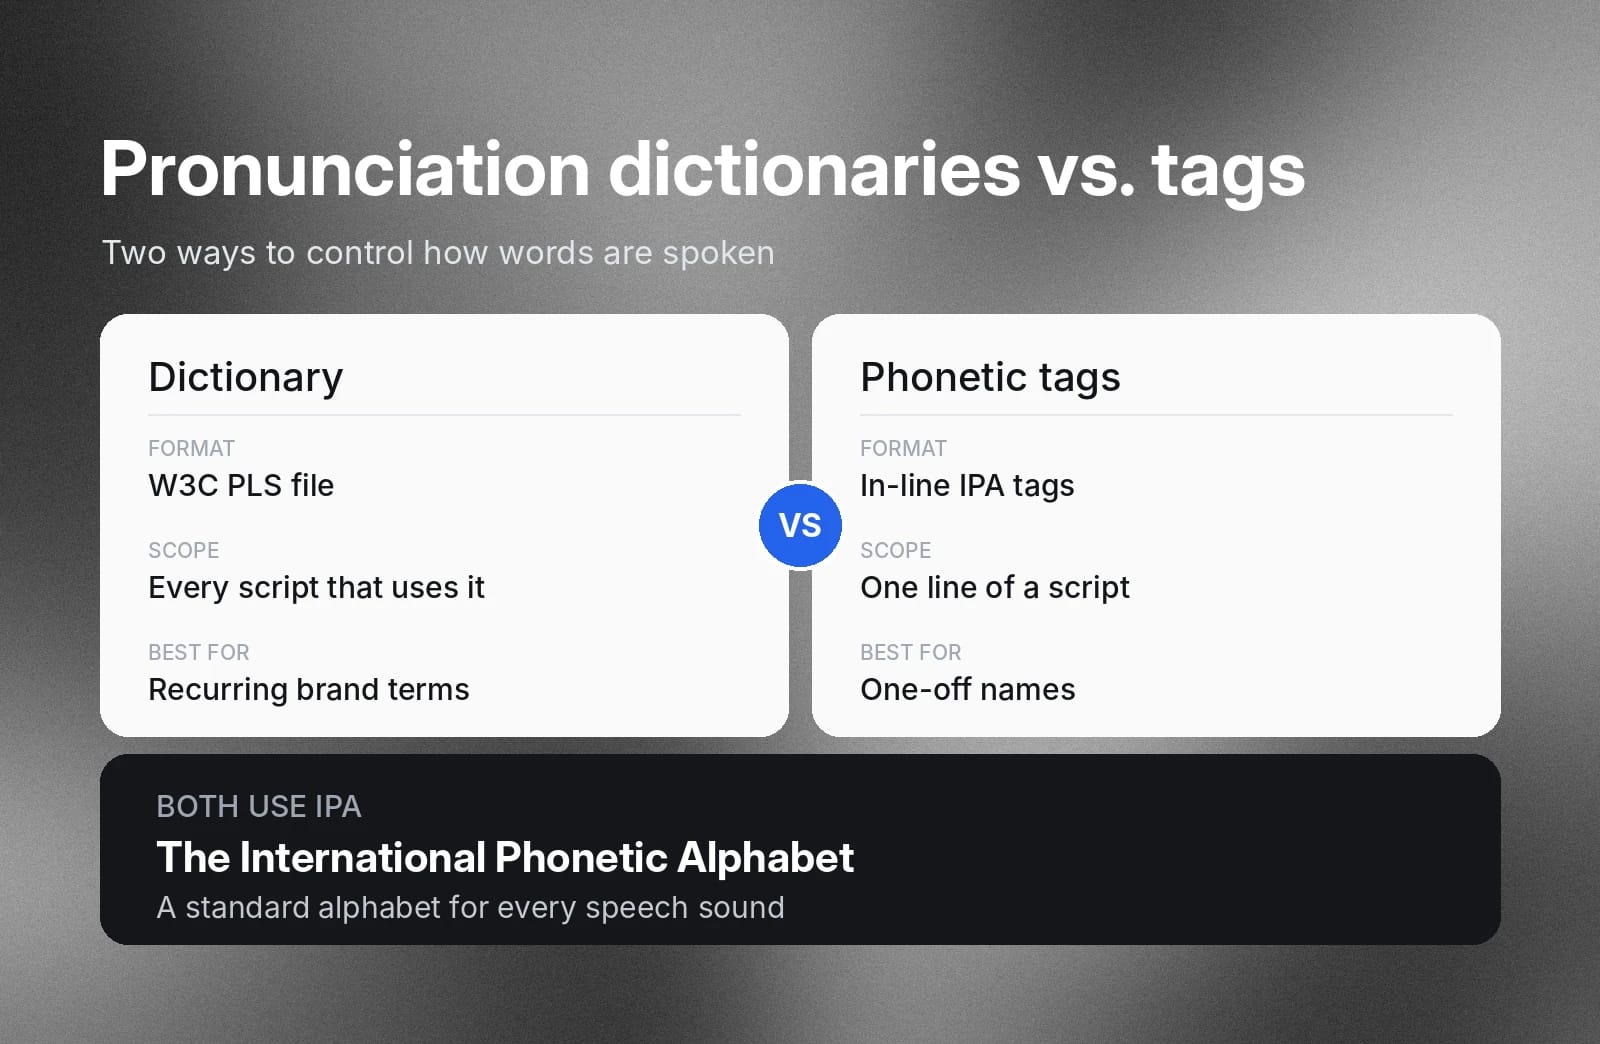
无需完全重写脚本来避免这些情况。现代神经语音模型提供两种工具,可高效逐项解决问题:发音词典和音标脚本标签。
文本转语音发音词典
如果有一批会在 TTS 项目中经常重复出现的自定义发音,词典是最佳选择。例如,公司销售医疗设备,脚本经常包含技术术语、医疗程序及其他领域特定内容。
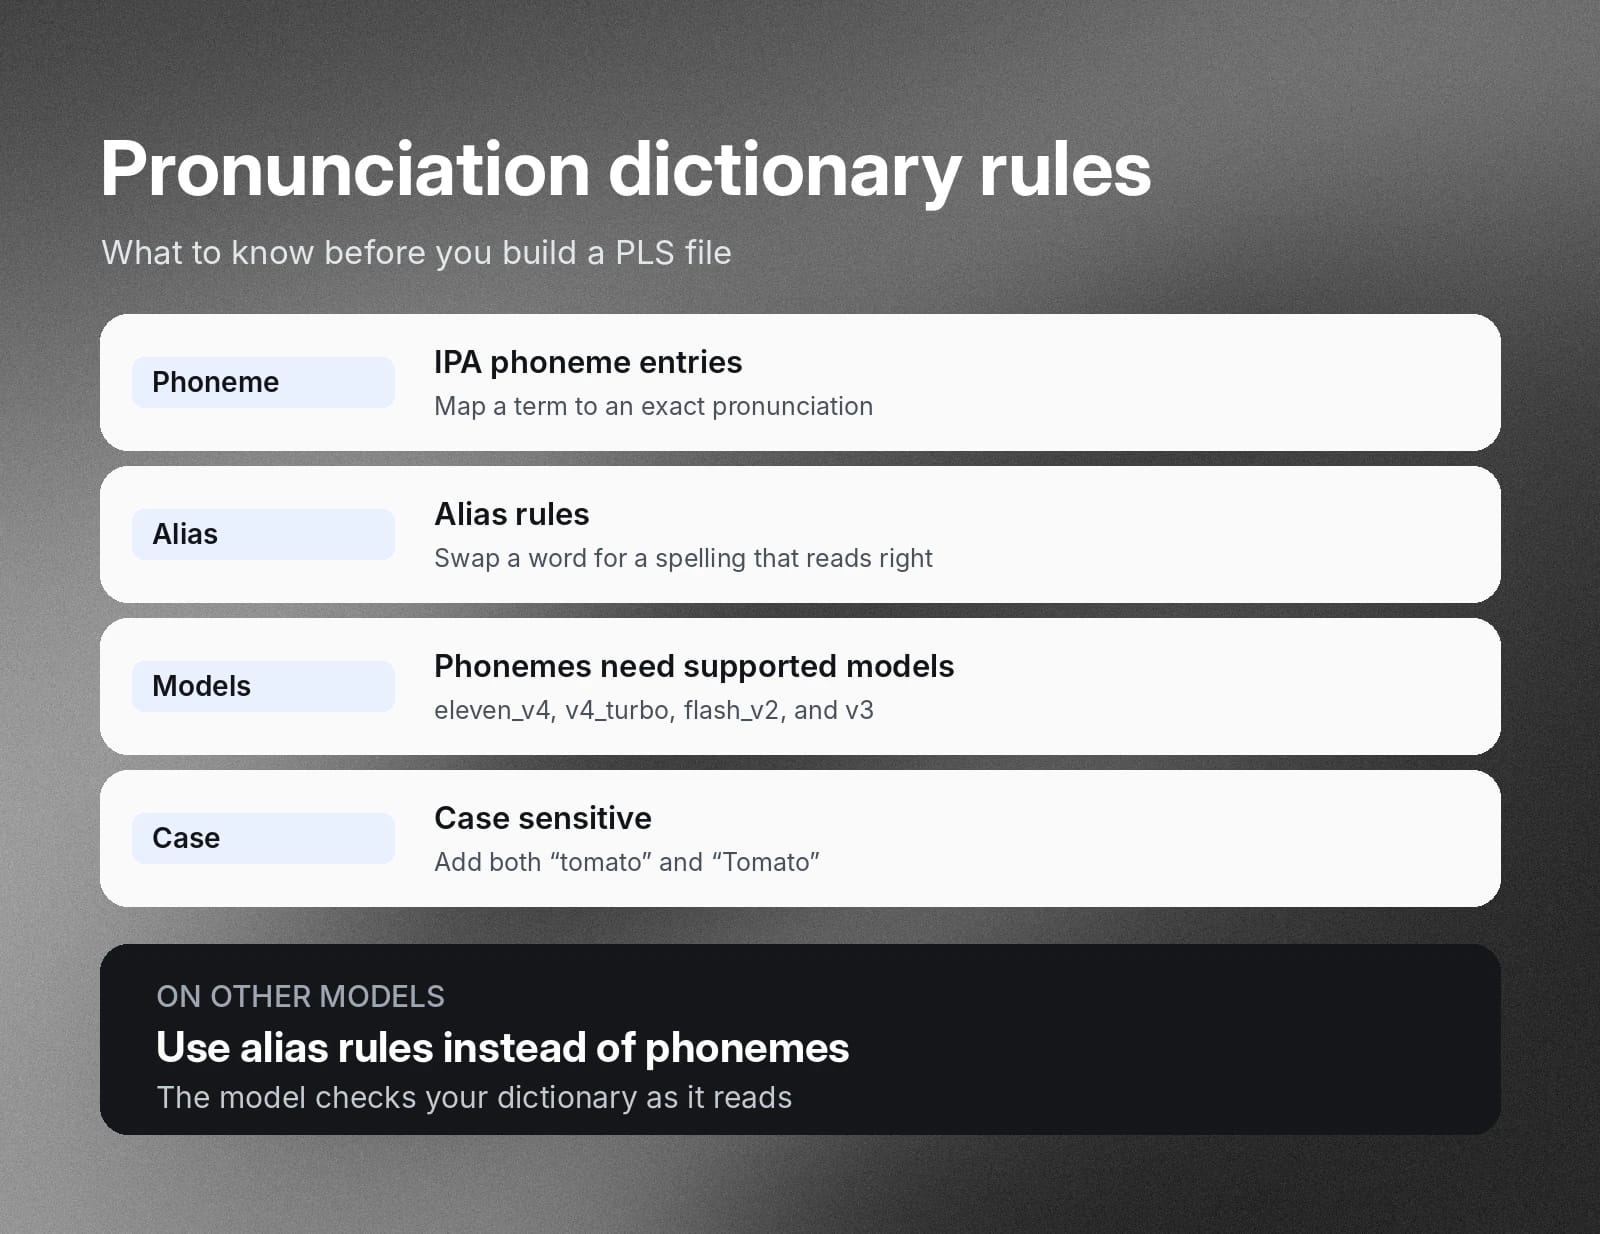
符合 W3C 标准的发音词典规范(PLS)格式,可通过国际音标(IPA)标记将这些术语映射到特定发音。国际音标是涵盖所有可能语音的标准化字母表。语音模型朗读脚本时会检查词典,遇到词典中的词时便采用列出的发音。音素条目仅适用于 eleven_v4、eleven_v4_turbo、eleven_flash_v2 和 eleven_v3 模型。其他模型请改用别名规则。PLS 文件区分大小写,因此如果两种形式都需要,应同时添加“tomato”和“Tomato”。
音标脚本标签
如果只需调整脚本中的单行内容,音标标签通常是更好的选择。无需创建词典,只需使用内联音标标签,按 IPA 指示语音模型以你想要的方式朗读单词。
例如,假设正在编写播客脚本,需要提及一位行业专家 2 到 3 次。无需将其加入公司发音词典,只需在脚本中使用她的名字时标注正确发音。
编写并格式化朗读时听起来自然的脚本
词典和标签适合处理语音输出中个别词语的问题,但无法解决整体表达、节奏和语音动态。编写脚本时,需明确文本将被朗读。措辞、表达方式和标点通常应不同于仅供阅读的文本。
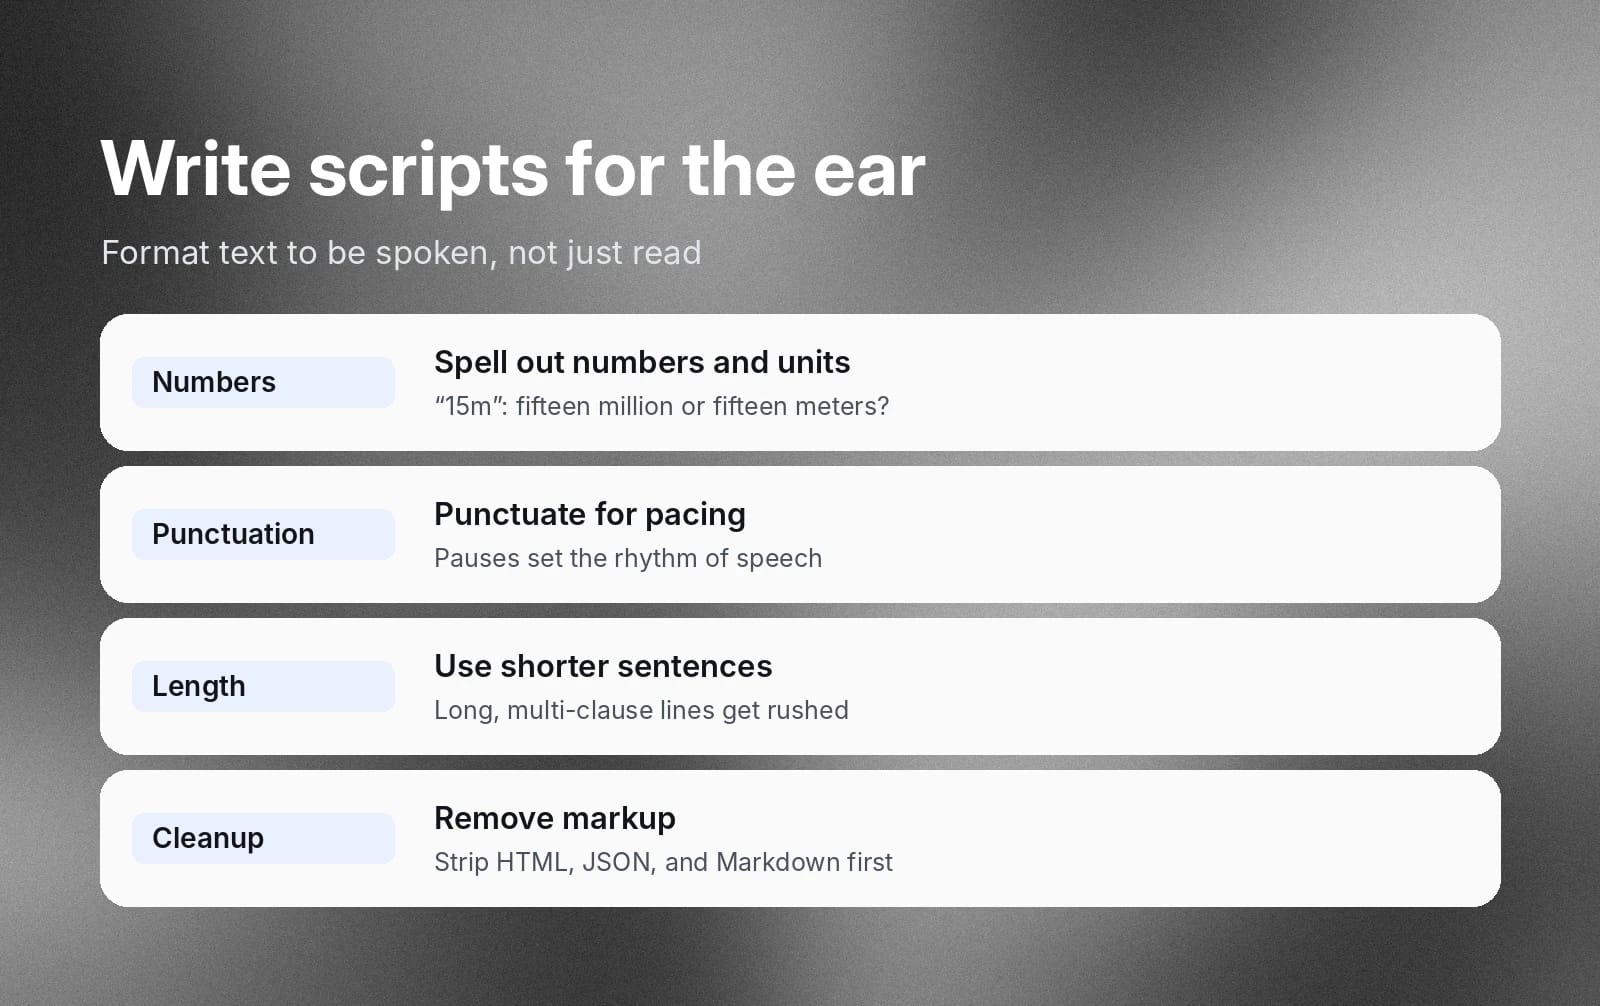
为耳朵而写,而非为眼睛而写
请以演讲稿作者的思维编写脚本:“我希望怎样朗读这段内容?哪里该停顿以加强效果?哪里该加快速度?”这些问题既适用于高级神经语音模型的脚本,也适用于为真人撰写的脚本。
完整写出数字、货币和日期
不要在脚本中留下任何歧义。神经语音模型很擅长理解上下文,但无需猜测时表现最佳。缩写和简写是它们常会读错的内容。
例如,脚本可能写着:“你在寻找接近 15m 的数值。”作者是希望 TTS 引擎读成“1500 万”,还是“15 米”?请完整写出,让模型无需根据上下文猜测。
使用常规标点控制节奏
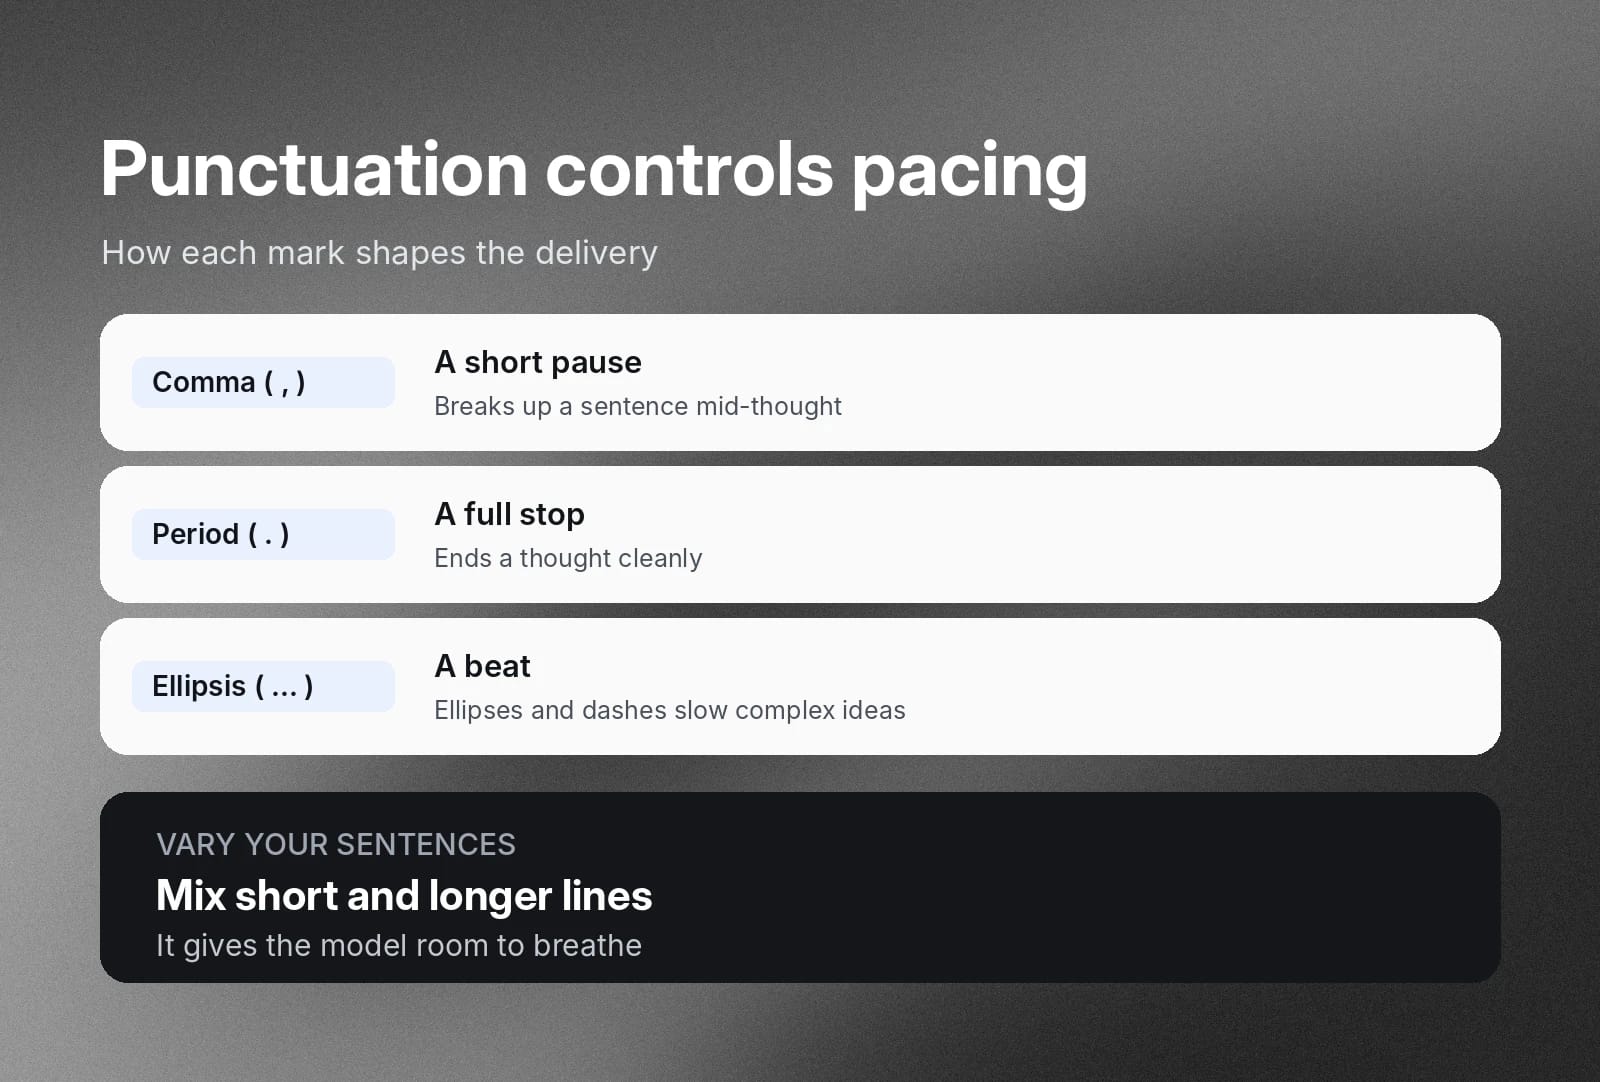
标点在书面文本中很重要,在文本转语音合成中更是如此。标点控制节奏,代表不同类型的停顿,可用于拆分复杂想法,或维持听起来更舒适的自然节奏。
- 使用逗号在句中短暂停顿。
- 使用句号结束一个完整想法。
- 使用省略号和破折号,在复杂想法中间加入停顿,让模型听起来不那么仓促。
短句更好
模型最容易在冗长、带条件且包含多个分句的句子上出错或读得太快。将这类句子拆成长度各异的短句。这样能给模型更多喘息空间,避免它在处理冗长句子节奏时语速过快。
移除格式和 Markdown 残留
如果要合成从内容管理系统或其他业务系统提取的语音,其中可能包含 HTML、JSON、Markdown 或其他格式。移除这些内容并将其格式化为纯文本,可获得最自然的语音。语音模型可能难以判断何时应忽略这些标签、逐字朗读,或将其结合上下文纳入输出。
可在ElevenLabs 故障排查指南中进一步了解误读和其他问题。
解决常见 ElevenLabs API 错误
大规模生成语音音频的团队通常通过 API 将应用连接到语音合成模型。这能提高整体生产效率,但也增加了除模型语音输出外需要管理的技术层。
ElevenLabs API 错误代码参考详细介绍了响应代码,以下是排查文本转语音集成时最常遇到的 4 种 HTTP 状态码及其处理方式。
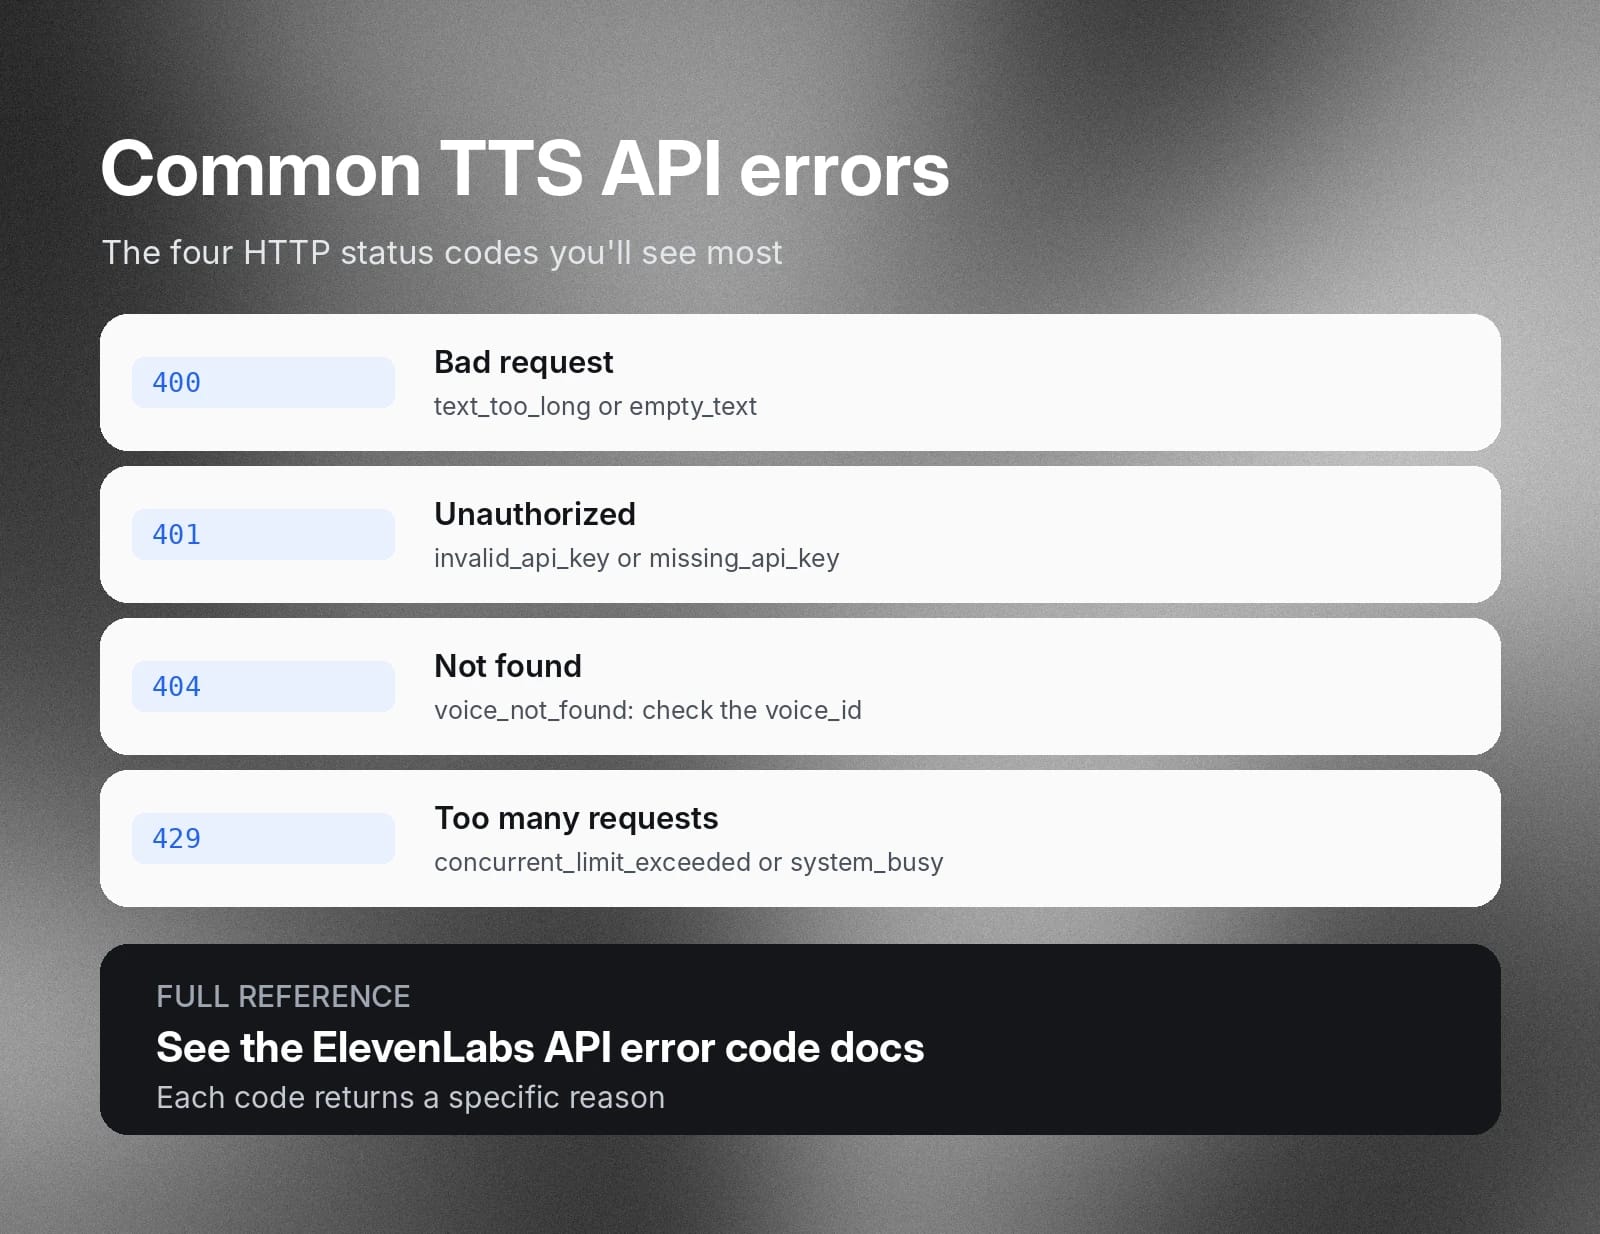
400 Bad Request(请求负载错误)
语音模型 API 返回 400 状态码,表示应用发送了模型无法处理的数据。在 TTS workflow 中,通常是超出字符限制或意外发送了空输入所致。
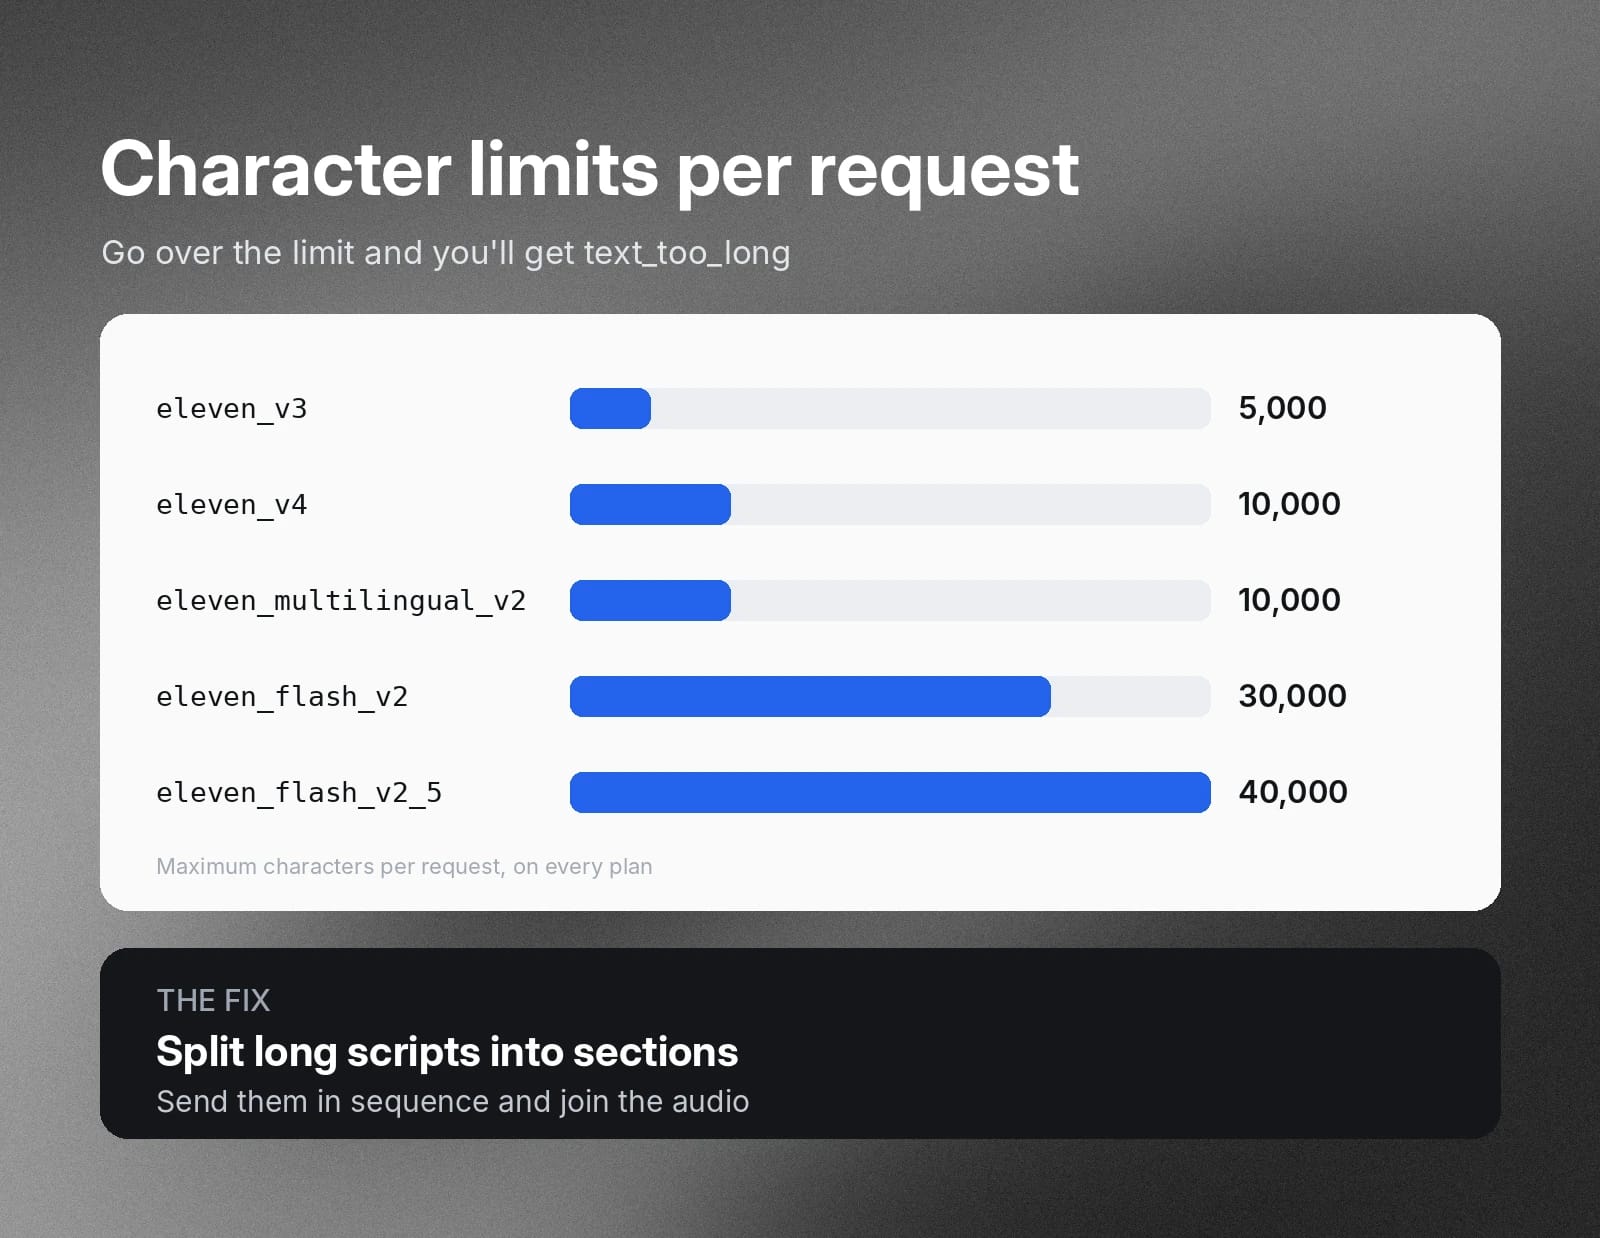
超出字符限制(text_too_long)
发送的每个 TTS 请求都有模型设定的字符限制。如果发送的文本超过模型允许的上限,TTS 服务器就会返回此错误。所有套餐中,每个请求的限制为:eleven_v4 和 eleven_multilingual_v2 为 10,000 个字符,eleven_v3 为 5,000 个字符,eleven_flash_v2 为 30,000 个字符,eleven_flash_v2_5 为 40,000 个字符。要解决此问题,请将较长脚本拆分为多个可由模型依次处理的部分。
空输入文本
TTS 引擎会拒绝包含空字符串(empty_text)的所有请求负载。在输入管道中加入清理步骤,移除空行,以免服务器拒绝原本可用的请求负载。
401 Unauthorized(身份验证问题)
401 错误代码表示 API 网关拒绝了凭据,请求负载未传递给模型。这通常是 API 密钥有问题。
无效的 API 密钥
发送至模型服务器的请求必须包含有效的 xi-api-key。否则服务器将返回 401 错误。确认请求中确实包含密钥,且部署时未被撤销、过期或从请求头中截断。密钥错误时,API 返回 invalid_api_key;未发送密钥时,返回 missing_api_key。
404 Not Found(音色标识符不匹配)
当端点找不到 URL 请求中指定的 TTS 资源时,会收到 404 错误。如果发送了错误的 voice_id 参数,或请求 URL 中缺少该参数,便可能发生这种情况。请确保获取了正确的 voice_id,并确认它确实存在于路径参数中且未拼错。音色 ID 不存在时,API 返回 voice_not_found。
429 Too Many Requests
此错误有两种不同原因:已达到服务套餐的并发请求限制,或 TTS 平台正为应对流量激增而限制请求。
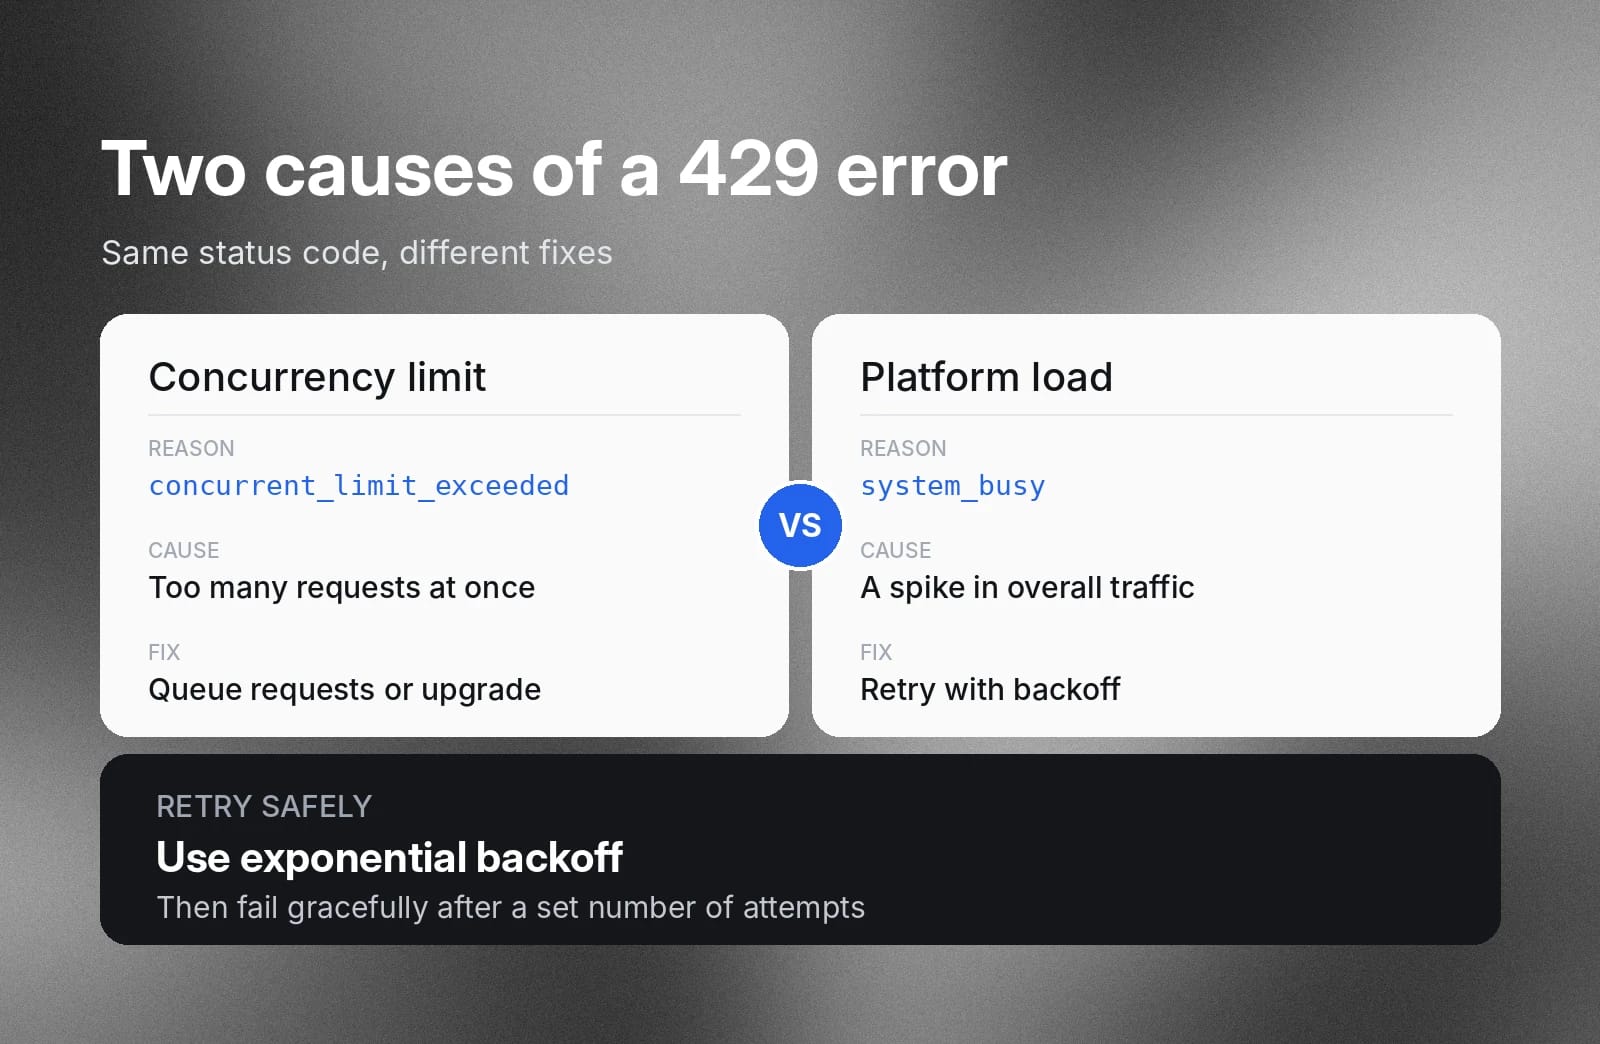
并发限制(concurrent_limit_exceeded)
每个 TTS 引擎订阅套餐都规定了可发送的固定并发请求数。如果应用超出该限制,服务器将返回这类 429 错误。
使用 Redis 等服务构建异步队列层,对发出的请求负载进行节流,避免超出套餐限制。或者评估升级至更高套餐是否具有成本效益。
平台负载峰值(system_busy)
在高负载下,TTS 服务器可能会限制传入请求以维持性能。在应用的 API 客户端中构建自动重试逻辑。确保它能采用指数退避重试,并在达到最大尝试次数后妥善失败。
发布前测试音色、语言和设置
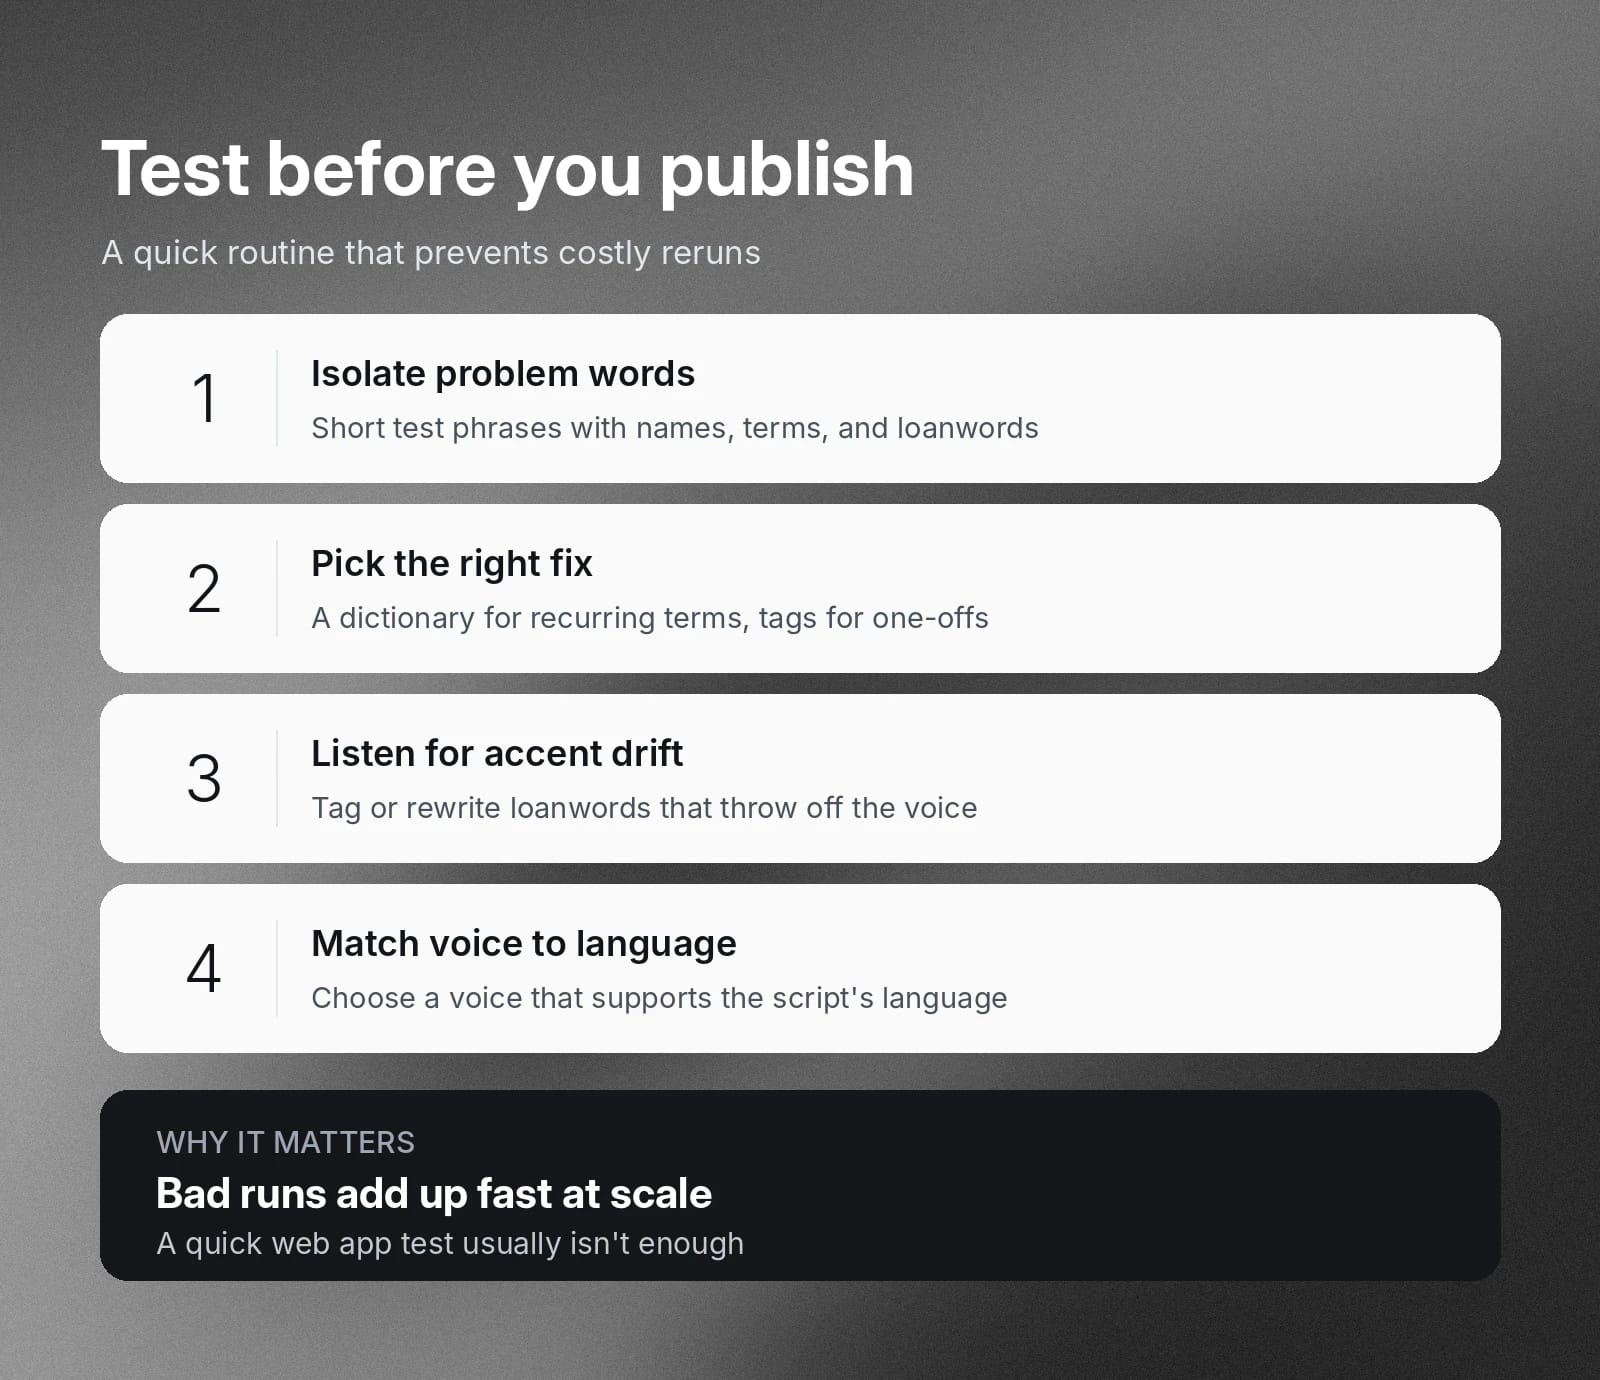
快速的网页应用测试通常不足以作为大规模 TTS 请求负载的质量控制。错误运行的成本会迅速累积。提交前,请通过一系列受控迭代测试脚本。这些前期准备能帮助你以最高效率生成最高质量的语音音频。
单独测试问题词语
问题通常出在特定段落、词语或名称,而非普遍存在。创建包含品牌名称、技术术语或外语短语的 5 到 10 个词测试短语。根据输出结果,决定每种情况使用发音词典还是音标标签。
识别可能的语言或口音漂移
语音模型有时会在句中采用奇怪或缓慢的节奏。这通常发生在模型必须猜测与训练中见过的内容不同的段落该如何发音时。
- 外来词:文本中使用生僻外语借词可能干扰模型的字素映射,使后续所有语音听起来带有奇怪口音。请为外来词使用音标标签或改写。
- 生硬的非英语语音:针对英语优化的模型在朗读翻译脚本时,可能结巴或听起来很机械。请选择同样支持该母语的音色配置。
使用 ElevenAPI 开始生成更可靠的语音输出
了解需要注意的事项后,就能更快、更省心地生成高质量语音内容。学会处理可能阻碍制作的输出问题和技术 API 问题。
立即通过ElevenAPI了解如何生成高质量、精准的 TTS 内容,或获取 API 密钥开始使用。
文本转语音问题常见问答

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。