Vi introducerar Scribe v3 och v3 Live, våra mest träffsäkra tal-till-text-modeller
- Skriven av
- Min Kim
- Publicerad
LyssnaLyssna på den här artikeln
Produkter som bygger på ljud börjar med en transkribering: mötesanteckningar, röstassistenter, dubbning, klinisk dokumentation och sändningsarkiv som sträcker sig över årtionden av innehåll. Det är viktigt att transkriberingen blir rätt från början, eftersom varje fel följer med längre fram och blir betydligt dyrare att rätta.
Men verkligt ljud är rörigt. Det kan vara flera personer som pratar i mun på varandra på ett möte, en kund på en trafikerad gata som gör paus mitt i en mening eller ett supportsamtal där ingen av personerna talar sitt förstaspråk.
I dag lanserar ElevenLabs två nya Speech to Text-modeller som är byggda för just dessa förhållanden:
- Scribe v3, för inspelat ljud, gör 27 % färre ordfel än Scribe v2 i 102 språk och har de mest träffsäkra talaretiketterna av alla modeller vi har testat,
- Scribe v3 Live är varianten med låg latens för ljud i realtid och ger 43 % färre fel än Scribe v2 Realtime. Den har också talardiarisering för första gången (märkning av vem som sa vad) och förbättrad turdetektering.
Scribe v3 Live finns tillgänglig i dag i ElevenAgents. Båda modellerna finns också i ElevenAPI, där du byter från Scribe v2 genom att ändra modell-ID:t på en enda rad.
Feedbacken som formade Scribe v3
Scribe har drivit hundratals miljoner timmar av transkribering för appar för mötesanteckningar, kontaktcenter, verktyg för klinisk dokumentation och röstassistenter. Oavsett användningsområde efterfrågade teamen som bygger med Scribe samma fem saker.
Team som arbetar med möten och anteckningar ville ha bättre diariseringsfunktioner vid snabba samtal fram och tillbaka och med tre eller fler talare. Team som bygger röstassistenter sa att en tystnadstimer avbryter uppringare när de pausar mitt i en mening eller saktar ned för att läsa upp ett nummer. Team som bygger liveprodukter kompromissade med träffsäkerheten för hastighetens skull, eftersom realtid presterade märkbart sämre än batchbearbetning. Kunder i Indien ville att hindi skulle hålla samma nivå som engelska, även när uppringare växlar mellan språken mitt i en mening. Många ville också ha mer kontroll över resultatet, från siffror skrivna som ”123” till termlistor som är tillräckligt långa för en produktkatalog eller en lista över läkemedelsnamn.
Talaretiketter, turdetektering och mer kontroll över resultatet
Diarisering som fungerar i ett fullt rum
I en mötestranskribering är det lika viktigt att identifiera rätt talare som att få rätt ord. Scribe v3 gör 17 % färre diariseringsfel än Scribe v2 på inspelningar med tre eller fler talare, vilket är de inspelningar där de flesta befintliga modeller misslyckas. Scribe v3 Live ger också transkribering i realtid diariseringsfunktioner för första gången, med 39 % färre diariseringsfel än den näst bästa realtidsmodellen vi testade.
Turdetektering som lyssnar på samtalet
För att samtal ska kännas naturliga måste röstassistenter kunna förutse exakt när en talare har pratat klart. Traditionella system för turordning gör det utifrån perioder av tystnad. Men enbart tystnad innebär en avvägning: en kort gräns kan avbryta personer som pausar mitt i en mening, medan en lång får en assistent att kännas långsam. Scribe v3 Live använder både samtalets sammanhang och ljudet, så att en uppringare som pausar mitt i ett nummer inte blir avbruten. Det är samma turdetektering som ElevenAgents redan använder, och den finns nu tillgänglig i ElevenAPI.
Mer kontroll över språk, terminologi och formatering
Scribe v3 kan dra slutsatser om vilka språk en inspelning kan innehålla och låter dig välja om siffror ska återges som siffror eller ord. Keyterm prompting hanterar upp till 1 000 termer som du vet kommer att förekomma, till exempel varumärkesnamn, förkortningar och facktermer, och redigeringar av transkriberingen tillämpar formateringsregler skrivna på vanlig engelska, till exempel ”skriv varje datum som ÅÅÅÅ-MM-DD”.
Scribe v3 Live lägger till ett flerspråkigt läge för samtal där språket växlar mitt i en mening. Den lägger också till ett keyterm-bibliotek för vokabulär som är för omfattande för en lista. Medan keyterm prompting täcker termer som du vet kommer att förekomma, innehåller keyterm-biblioteket tusentals som kan förekomma, och modellen använder det bara när den hör en trolig träff.
Så presterar Scribe v3
ElevenLabs utvärderade båda modellerna mot Scribe v2, Scribe v2 Realtime och andra populära Speech to Text-modeller och bedömde dem utifrån samma dataset. Flerspråkig träffsäkerhet mättes på en intern version av FLEURS-benchmarken, som testar kort, tydligt inläst tal på 102 språk. FLEURS kan inte mäta diarisering eftersom varje klipp har en talare, så vi skapade även ett eget dataset med verkliga möten, agentsamtal och röstanteckningar på 16 språk. Vi kommer snart att göra det tillgängligt som öppen källkod.
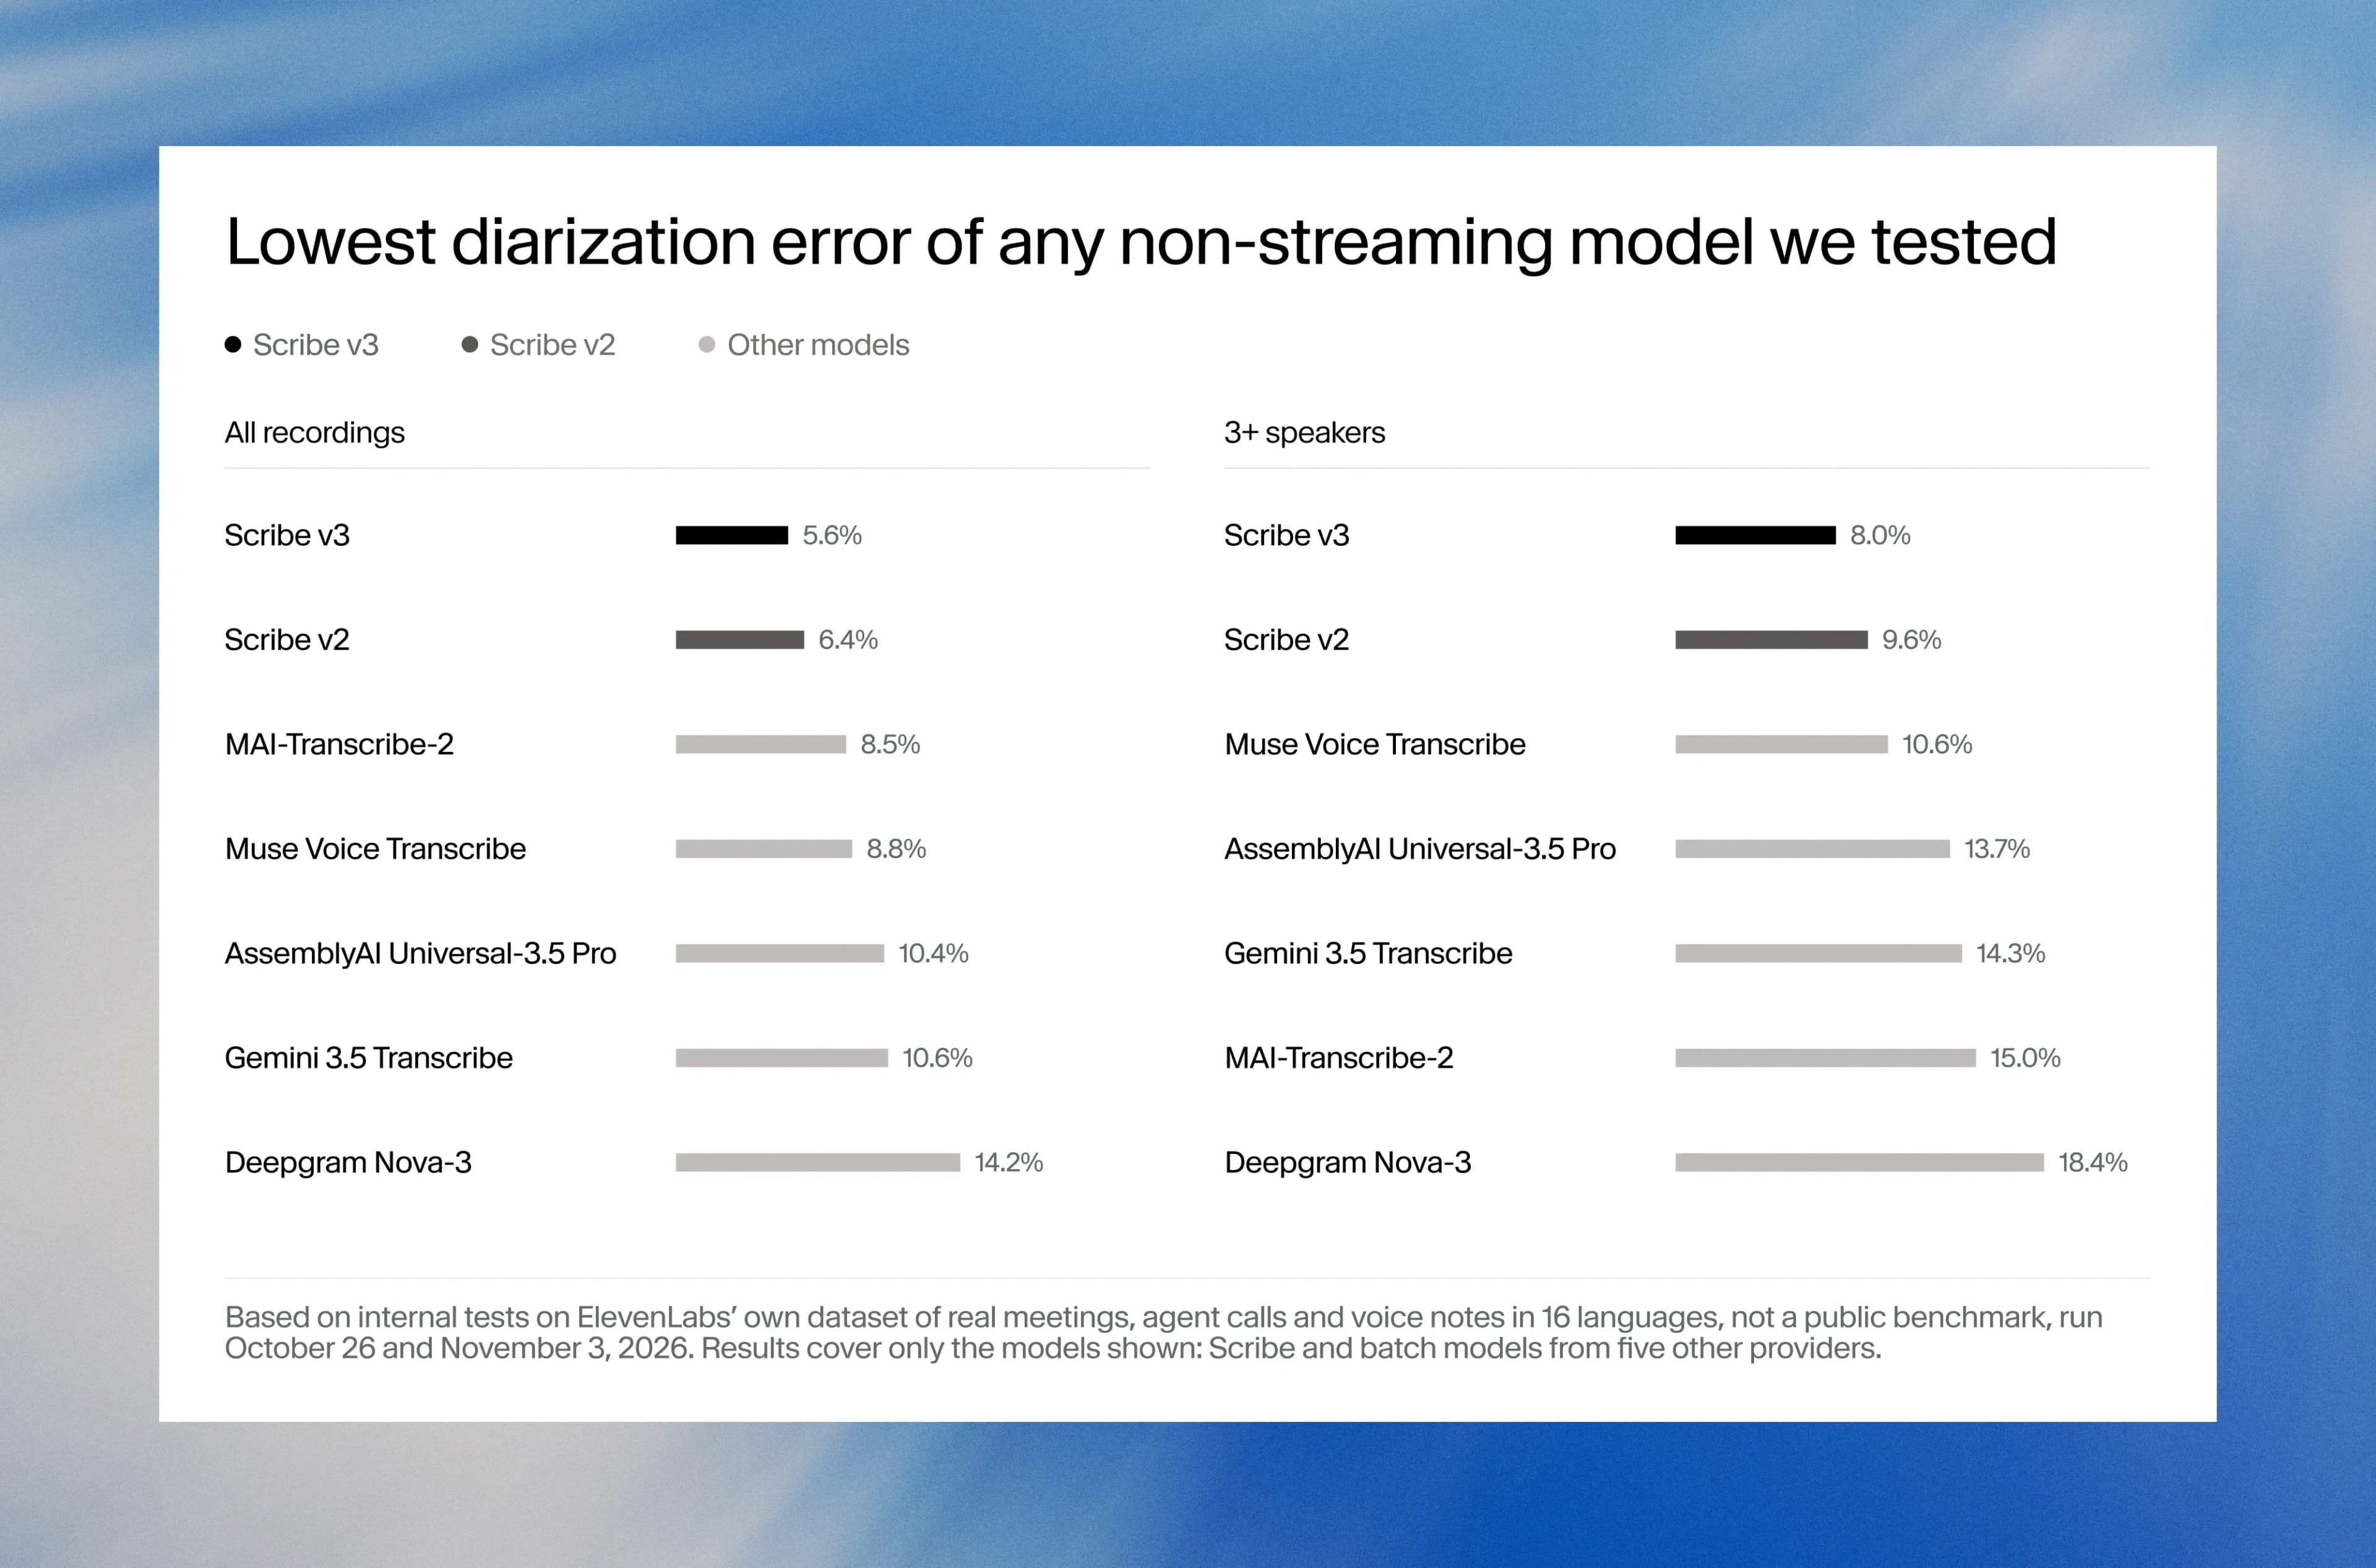
Talardiarisering
Scribe v3 har det lägsta diariseringsfelet av alla modeller vi har testat, med 12 % färre fel än Scribe v2 totalt och 17 % färre i inspelningar med tre eller fler talare.
Flerspråkig transkriberingsprecision
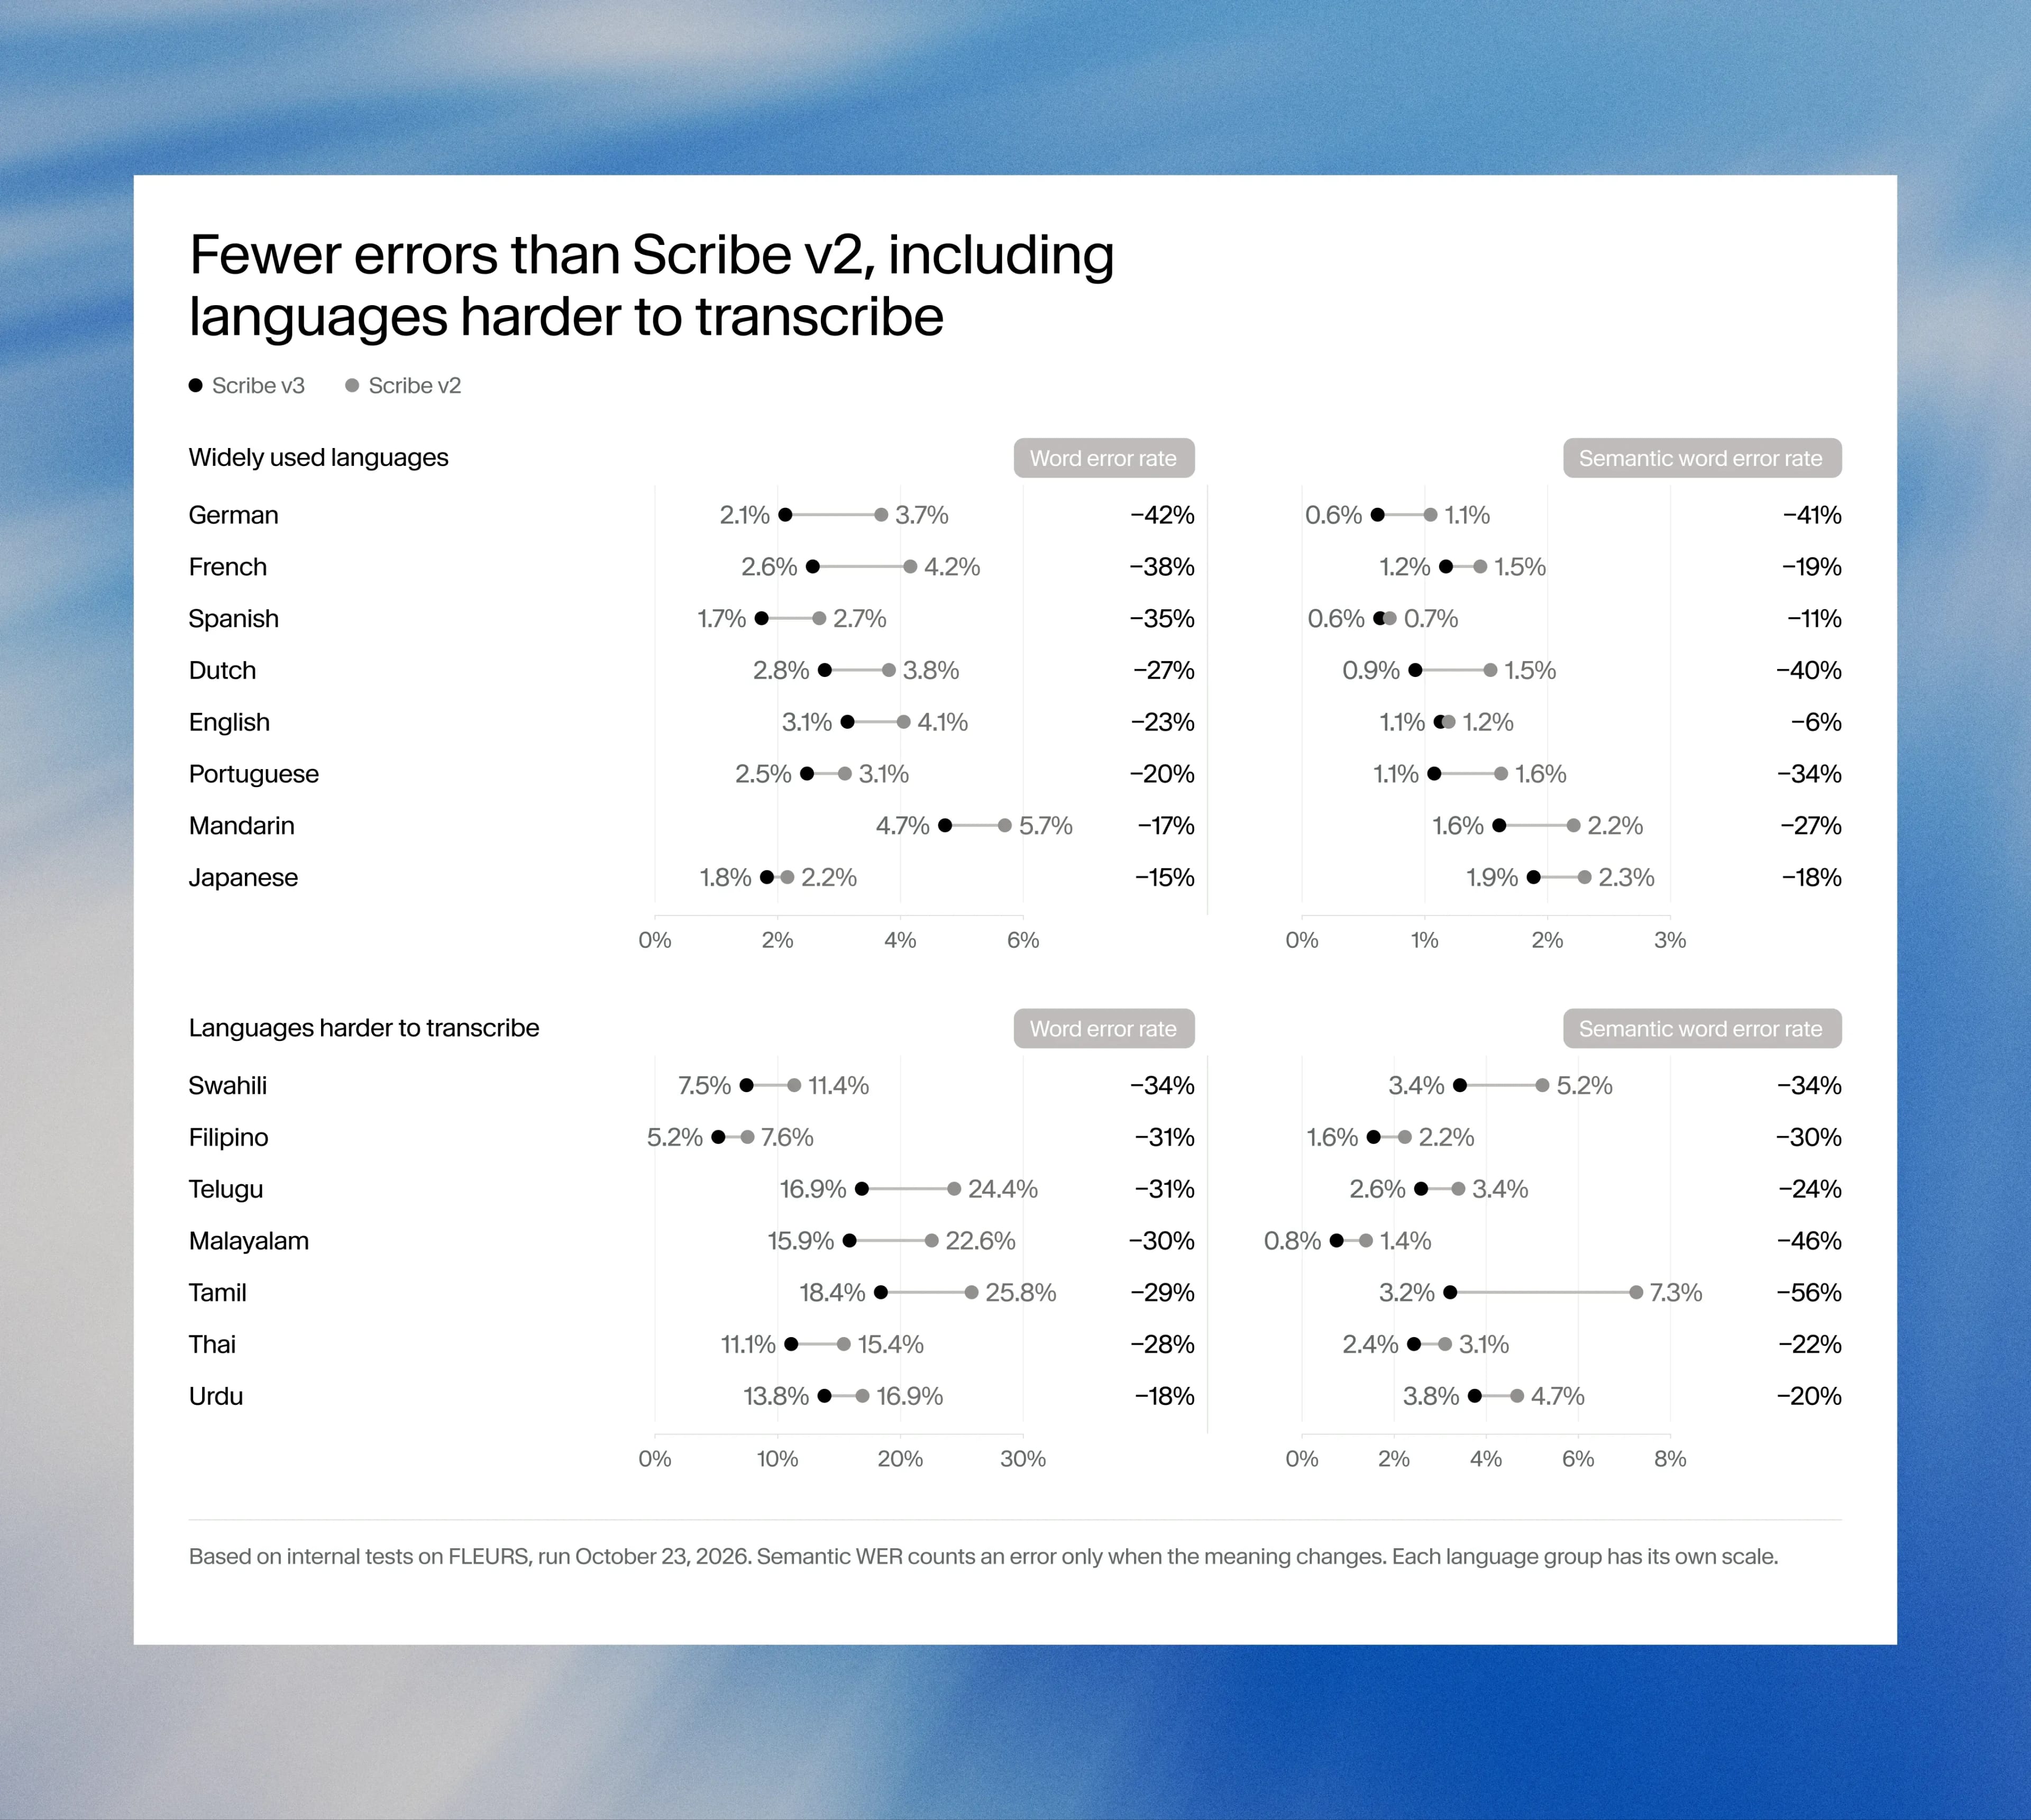
Vi redovisar ordfelsfrekvens (WER) tillsammans med semantisk WER, som bara räknar ett fel när innebörden i transkriberingen ändras.
På FLEURS, över 102 språk, minskar Scribe v3 WER med 27 % jämfört med Scribe v2 och förbättras i varje testat språk. I språk som är enklare att transkribera förbättrades tyska med 42 %, spanska med 35 % och engelska med 23 %. Förbättringarna är större i språk som är svårare att transkribera: swahili minskar med 34 %, tamil med 29 % och thailändska med 28 %.
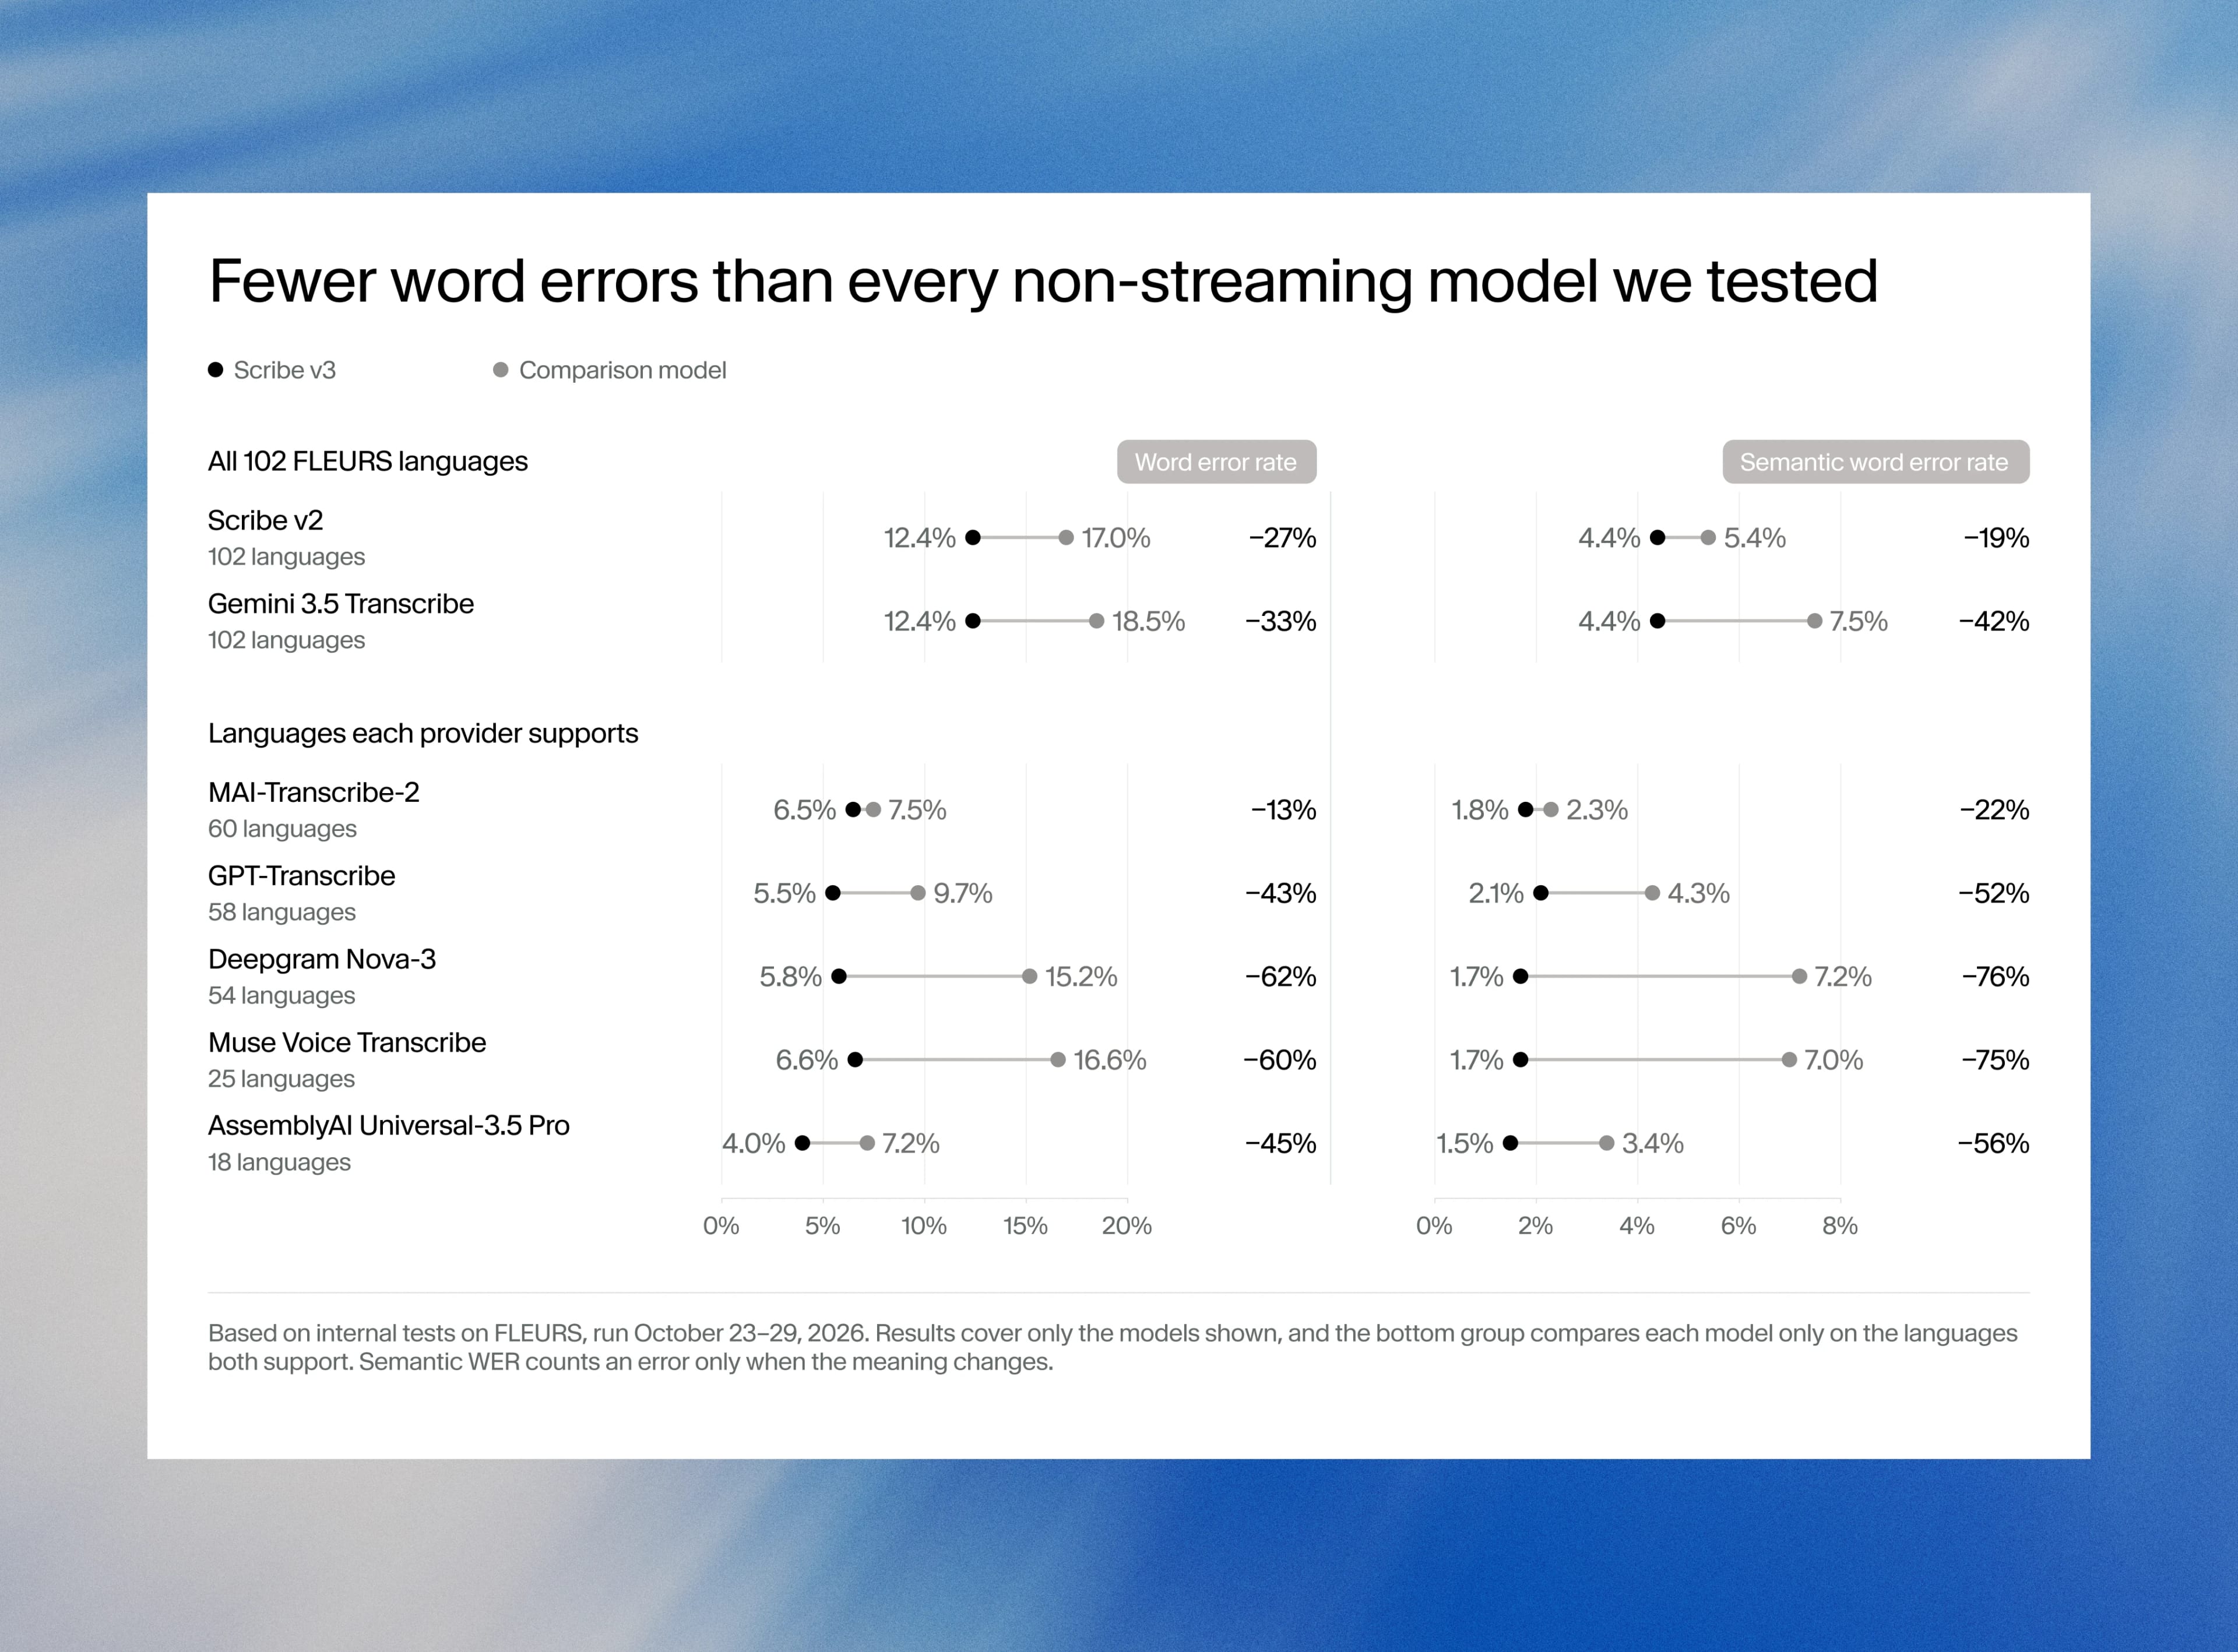
Scribe v3 gör också färre ordfel än alla andra batchmodeller (icke-streamande) vi testade, när varje modell jämförs på de språk som båda modellerna har stöd för.
Talardiarisering i realtid
I den engelska delen av vårt verkliga dataset med 16 språk har Scribe v3 Live en diariseringsfelfrekvens på 3,1 %, jämfört med 5,9 % till 7,3 % för de andra realtidsmodellerna vi testade.
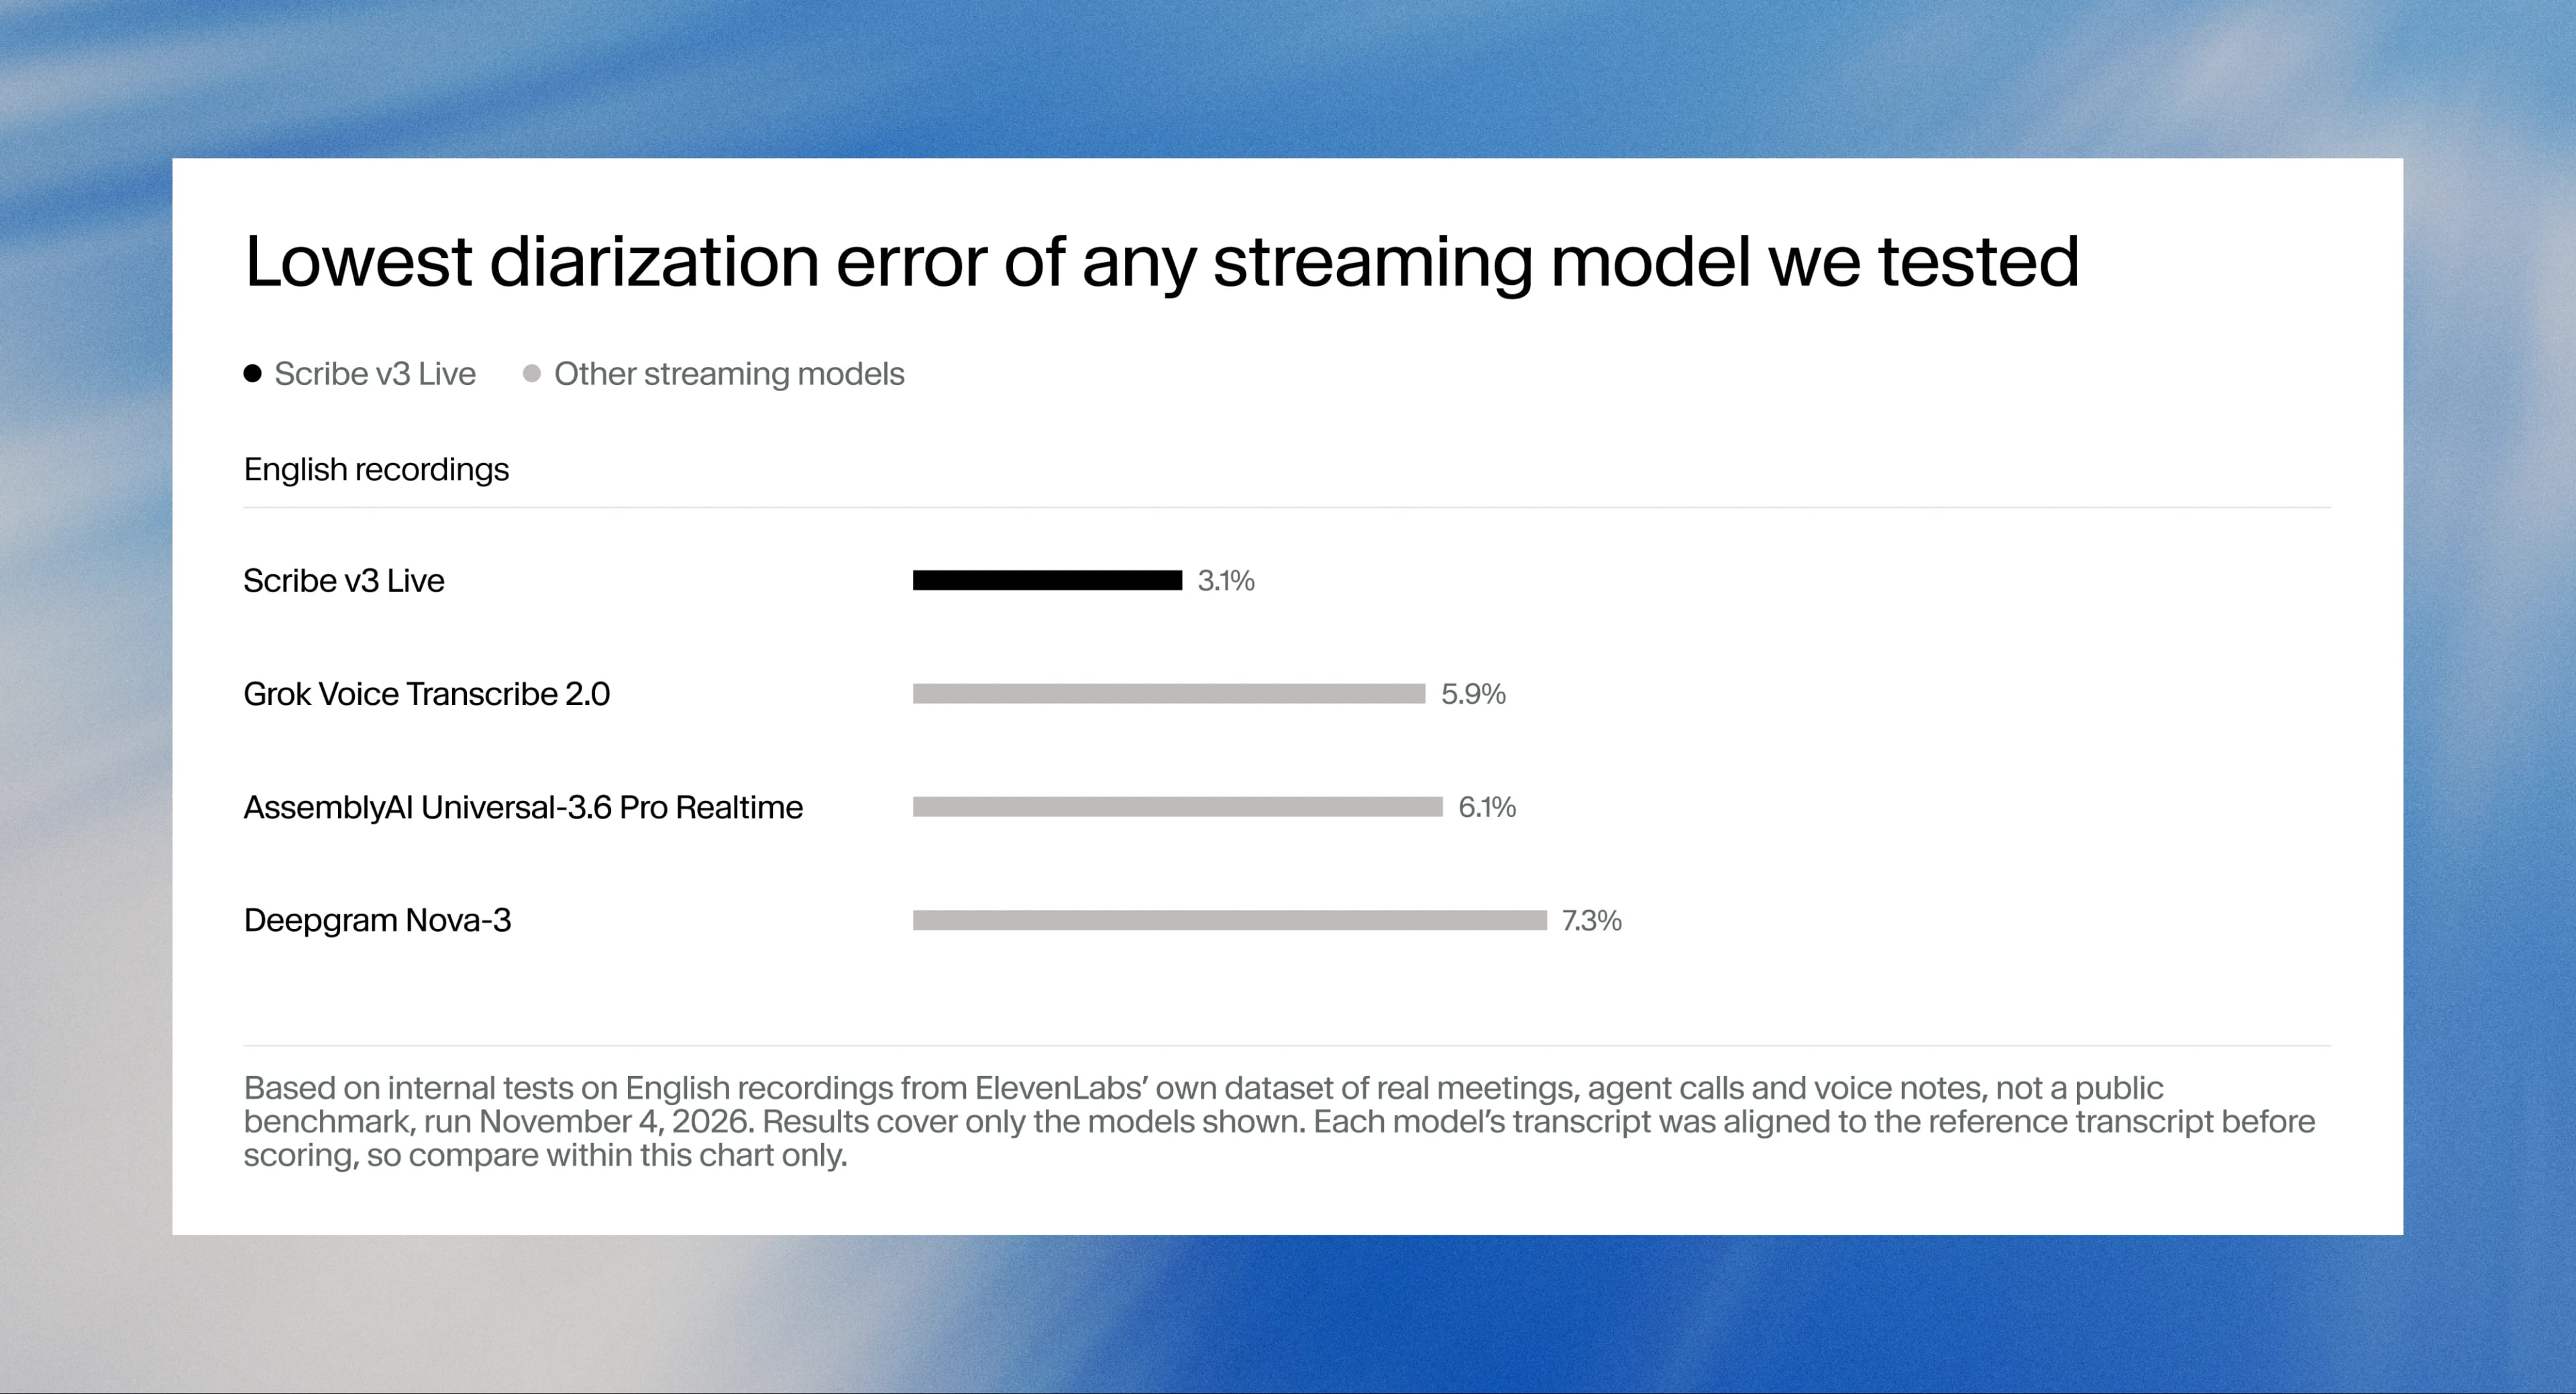
Vanliga diariseringstal räknar också transkriberingsmisstag, till exempel missade ord, och realtidsmodeller missar fler ord än batchmodeller. För att bara mäta om varje ord tillskrevs rätt talare justerade vi varje modells transkribering mot referensen före bedömningen. Det sänker felfrekvensen för varje modell, så resultaten kan inte jämföras med batchresultaten för diarisering ovan.
Flerspråkig precision i realtid
För realtidsmodeller utgår vi från semantisk WER. En streamande modell skriver text innan den har hört hela meningen, och varje leverantör formaterar siffror, skiljetecken och versaler/gemener på olika sätt under tiden. Standard-WER räknar dessa skillnader som fel även när innebörden är densamma, så semantisk WER är en rättvisare jämförelse.
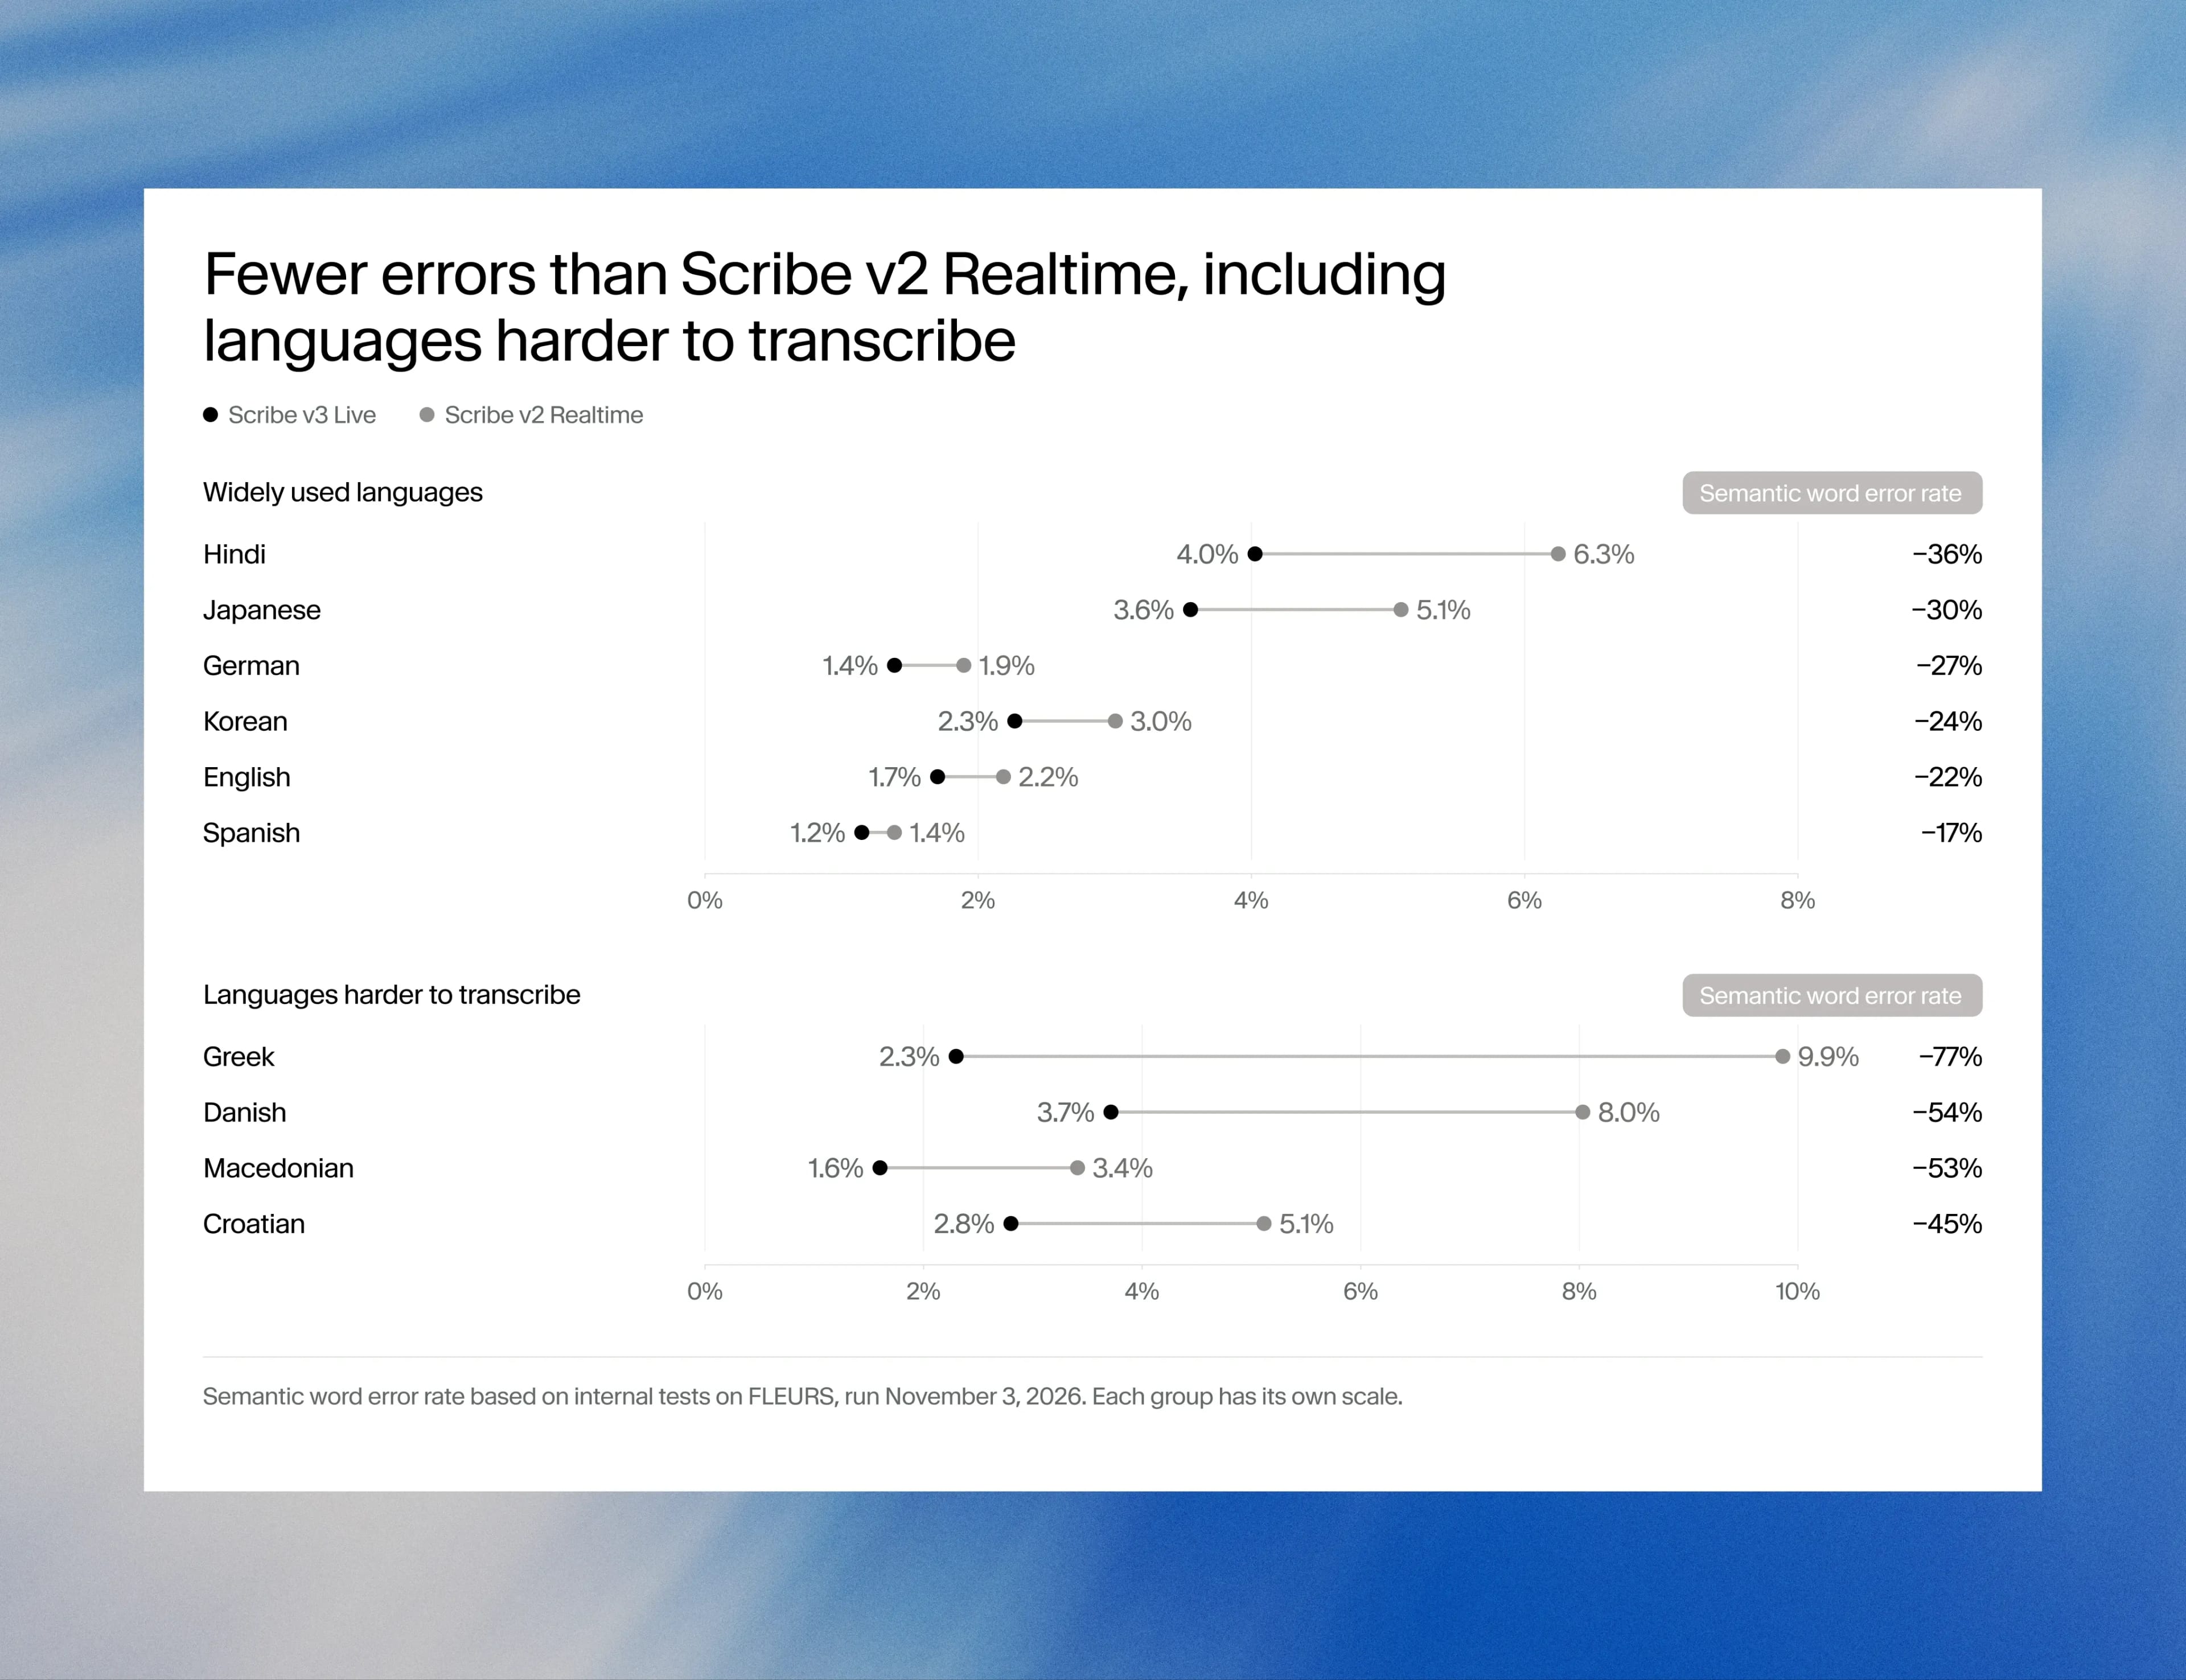
Över 102 språk minskar Scribe v3 Live semantisk WER med 43 % och WER med 31 % jämfört med Scribe v2 Realtime. Den förbättras i varje språk och har lägre felfrekvens än alla andra realtidsmodeller vi testade.
Förbättringarna är störst där realtidstranskribering har halkat efter: grekiska förbättras med 77 %, danska med 54 % och kroatiska med 45 %, medan hindi förbättras med 36 %.
En kommentar om metoden: Vi bedömde varje språk separat innan vi beräknade genomsnittet, så alla 102 språk väger lika tungt. Många publicerade resultat slår ihop alla klipp till ett enda resultat, vilket brukar ge lägre siffror, så resultat som har mätts på olika sätt är inte direkt jämförbara.
Vad några procentenheters precision är värda
Varje modellansering kommer med procenttal, även denna, och på papperet är det svårt att se vad några procentenheter betyder i verkliga situationer. Ett möte på en timme med 150 ord per minut omfattar ungefär 9 000 ord, så skillnaden mellan en ordfelsfrekvens på 4 % och 2 % är 180 felaktiga ord, tre för varje minut någon pratade. Diariseringsfel mäts i tid snarare än ord, så i samma möte motsvarar varje procentenhet 36 sekunders tal under fel namn.
Kostnaden för felen beror på var de hamnar. I en podcasttranskribering är ett felaktigt ord ett skrivfel, men i ett kvartalssamtal kan ”femton” som uppfattas som ”femtio” hamna i en analytikers modell. Fel samlas också kring namn, siffror, förkortningar och facktermer – just de ord som en sammanfattning eller agent behöver få rätt.
Få det rätt från början i ElevenAgents
Röstassistenter märker detta mest, eftersom en enda feluppfattad siffra kan göra att kontrollen som startar samtalet misslyckas. Eneco, som levererar energi till över 2 miljoner hem och företag i Nederländerna, kör sin röstassistent på ElevenAgents och testade Scribe v3 Live på den före lanseringen. I verkliga kundsamtal identifierade agenten nederländska postnummer rätt vid första försöket 40 % oftare och husnummer 15 % oftare.
”ElevenLabs är en verklig partner för Eneco. Tillsammans med deras ingenjörer som arbetar nära oss arbetar vi för att ytterligare förbättra vår röstassistent”, säger Ruud Huigsloot, Senior Product Manager på Eneco. ”Det är fantastiskt att se tydliga resultat så här tidigt, och vi ser fram emot att fortsätta samarbetet.”
Byggt för företag
Scribe v3 och Scribe v3 Live körs som standard i USA och erbjuds i isolerade miljöer i EU, Indien och Singapore för företagskunder med krav på datalagringsplats. Zero Retention Mode raderar ljud och text så snart en förfrågan är klar. Båda modellerna omfattas av våra program för SOC 2, ISO 27001 och PCI DSS Level 1, uppfyller kraven för HIPAA med ett Business Associate Agreement och är tillgängliga för privat driftsättning.
Kom igång i dag
Scribe v3 Live finns i ElevenAgents, och både v3 och v3 Live är standard i ElevenLabs-appen. Registrera dig för att prova.
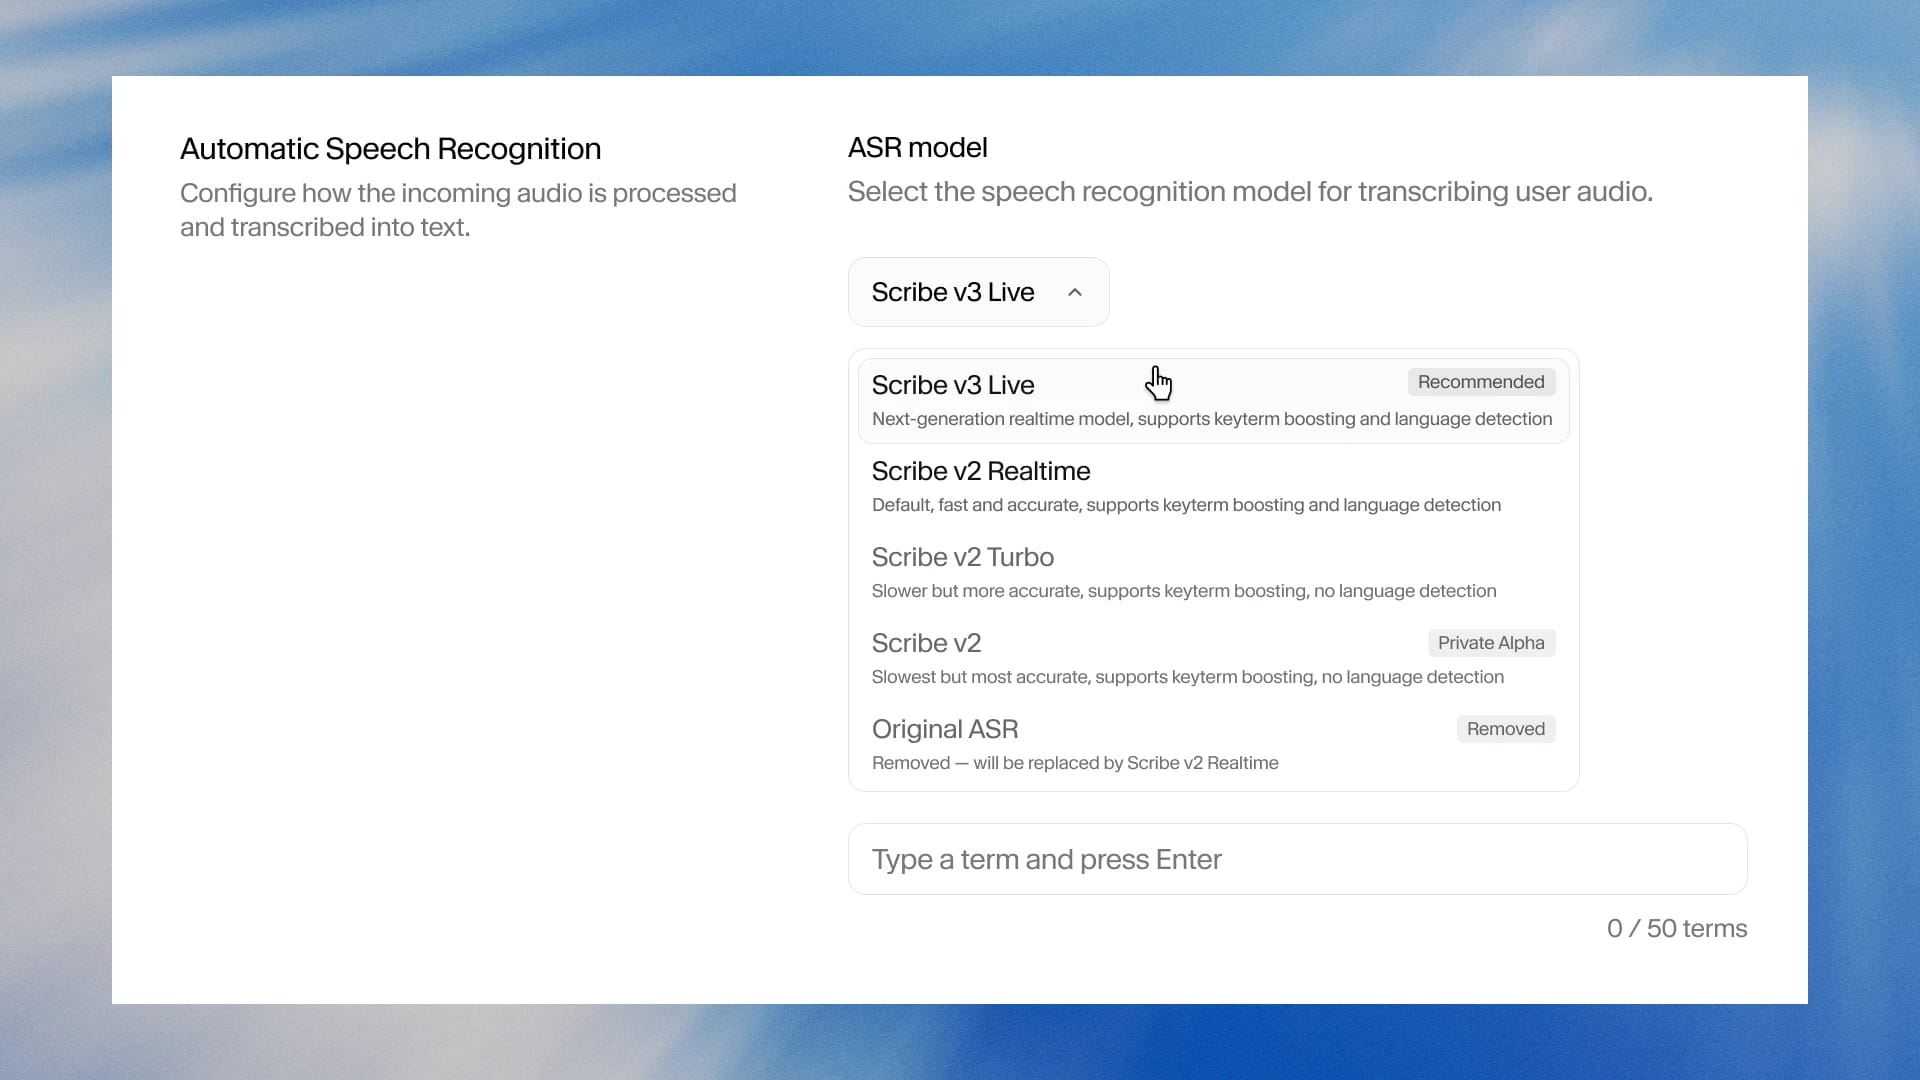
Båda modellerna finns också i ElevenAPI i dag. Befintliga integrationer uppgraderas genom att ändra modell-ID:t till scribe_v3 eller scribe_v3_live.
För vårdteam lanserar vi också en version av Scribe v3 Live som är optimerad för medicinska samtal i ElevenAgents.