Vi presenterar Eleven Realtime: ett enklare sätt att bygga naturliga röstagenter
- Skriven av
- Min Kim
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Att bygga en röstagent som låter naturlig i dag kräver många beslut. Du måste välja enskilda komponenter som taligenkänning, identifiering av röstaktivitet, turordning, den underliggande LLM:en och Text to Speech. Att bygga den här stacken är ett projekt i sig, och att få alla komponenter att fungera bra tillsammans kräver mer testning och finjustering.
Eleven Realtime är en ny typ av Speech to Speech-modeller som undanröjer de hindren. Varje modell är en komplett röstagent, optimerad för olika användningsområden. Båda stöder fler än 90 språk och kan använda vilken som helst av de över 17 000 rösterna i ElevenLabs bibliotek:
I dag lanserar vi:
- Eleven Realtime v1 Mini för naturliga samtal till låg kostnad. Det här är det bästa valet för AI-assistentar, lärare och interaktiva karaktärer, och räcker för de flesta användningsområden.
- Eleven Realtime v1 Max för komplexa uppgifter. Den är idealisk för kundsupport, kvalificering av leads och arbetsflöden i flera steg, där agenten måste följa en process och resonera sig igenom stegen.
Varför vi byggde realtime-modeller
Du ska inte behöva bli expert på konfigurering för att bygga en röstagent som låter naturlig. Att få en agent att kännas och låta rätt handlar om små bedömningar som kräver fingertoppskänsla, till exempel hur länge den ska vänta efter en paus innan den svarar, hur den ska hantera när användaren avbryter agenten och hur röst, prompter och modell samspelar. I ElevenAgents kan du justera alla dessa inställningar.
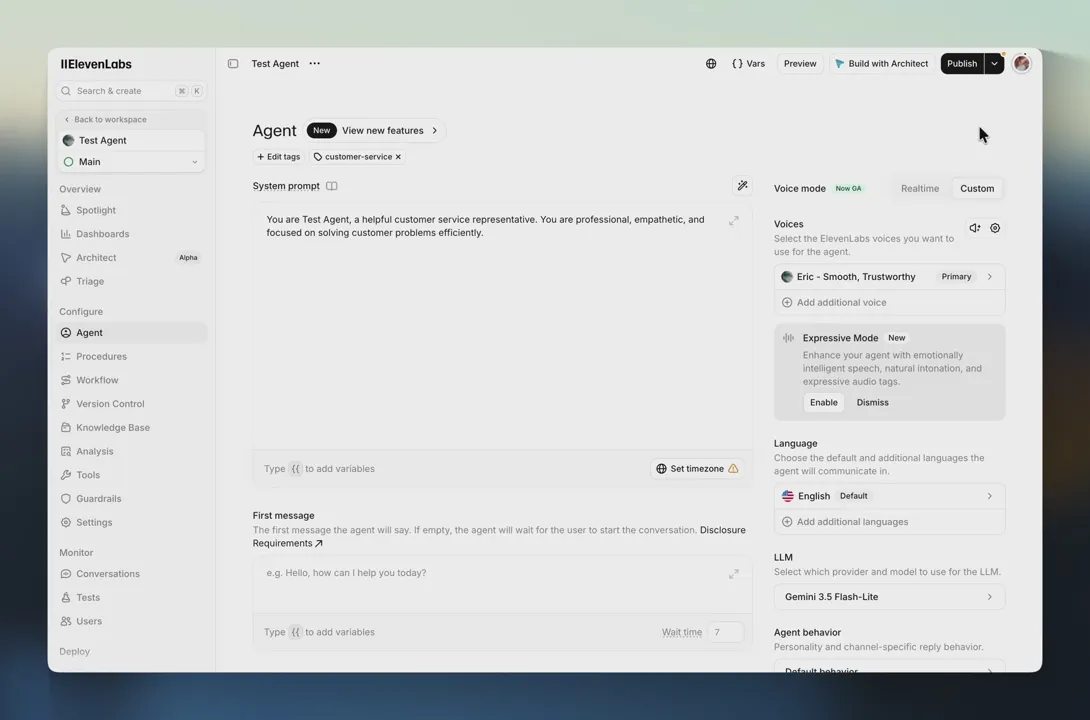
Detsamma gäller utvecklare som redan använder ett realtime-API. Vårt är kompatibelt med OpenAI:s Realtime API, så för att testa Eleven Realtime behöver du bara ändra endpointen och modellnamnet i koden du kanske redan har.
Byggt på en kaskadarkitektur
Eleven Realtime bygger på en kaskadarkitektur med komponenterna som beskrivs ovan, finjusterade från början till slut. Vi kallar dem Speech to Speech-modeller eftersom det är vad du får: ljud in, ljud ut, ett modell-ID och ett system som kan mätas på samma topplistor som fusionerade modeller och duplexmodeller.
Fusionerade modeller satte först ribban för hur naturlig en röstagent kan kännas, medan en kaskadlösning innebar högre latens vid varje överlämning och komponenter som aldrig finjusterades mot varandra. Realtime tar bort den kompromissen, och finjusteringen som tidigare var ditt projekt är redan klar.
Kaskadarkitekturen har också praktiska fördelar i produktion, eftersom varje steg genererar text. Du kan se vad agenten hörde och vad den beslutade att säga, så att du kan skilja ett felhört ord från ett felaktigt beslut. Samma text gör det möjligt för ElevenAgents att tillämpa skyddsräcken och maskering av PII för en Realtime-agent.
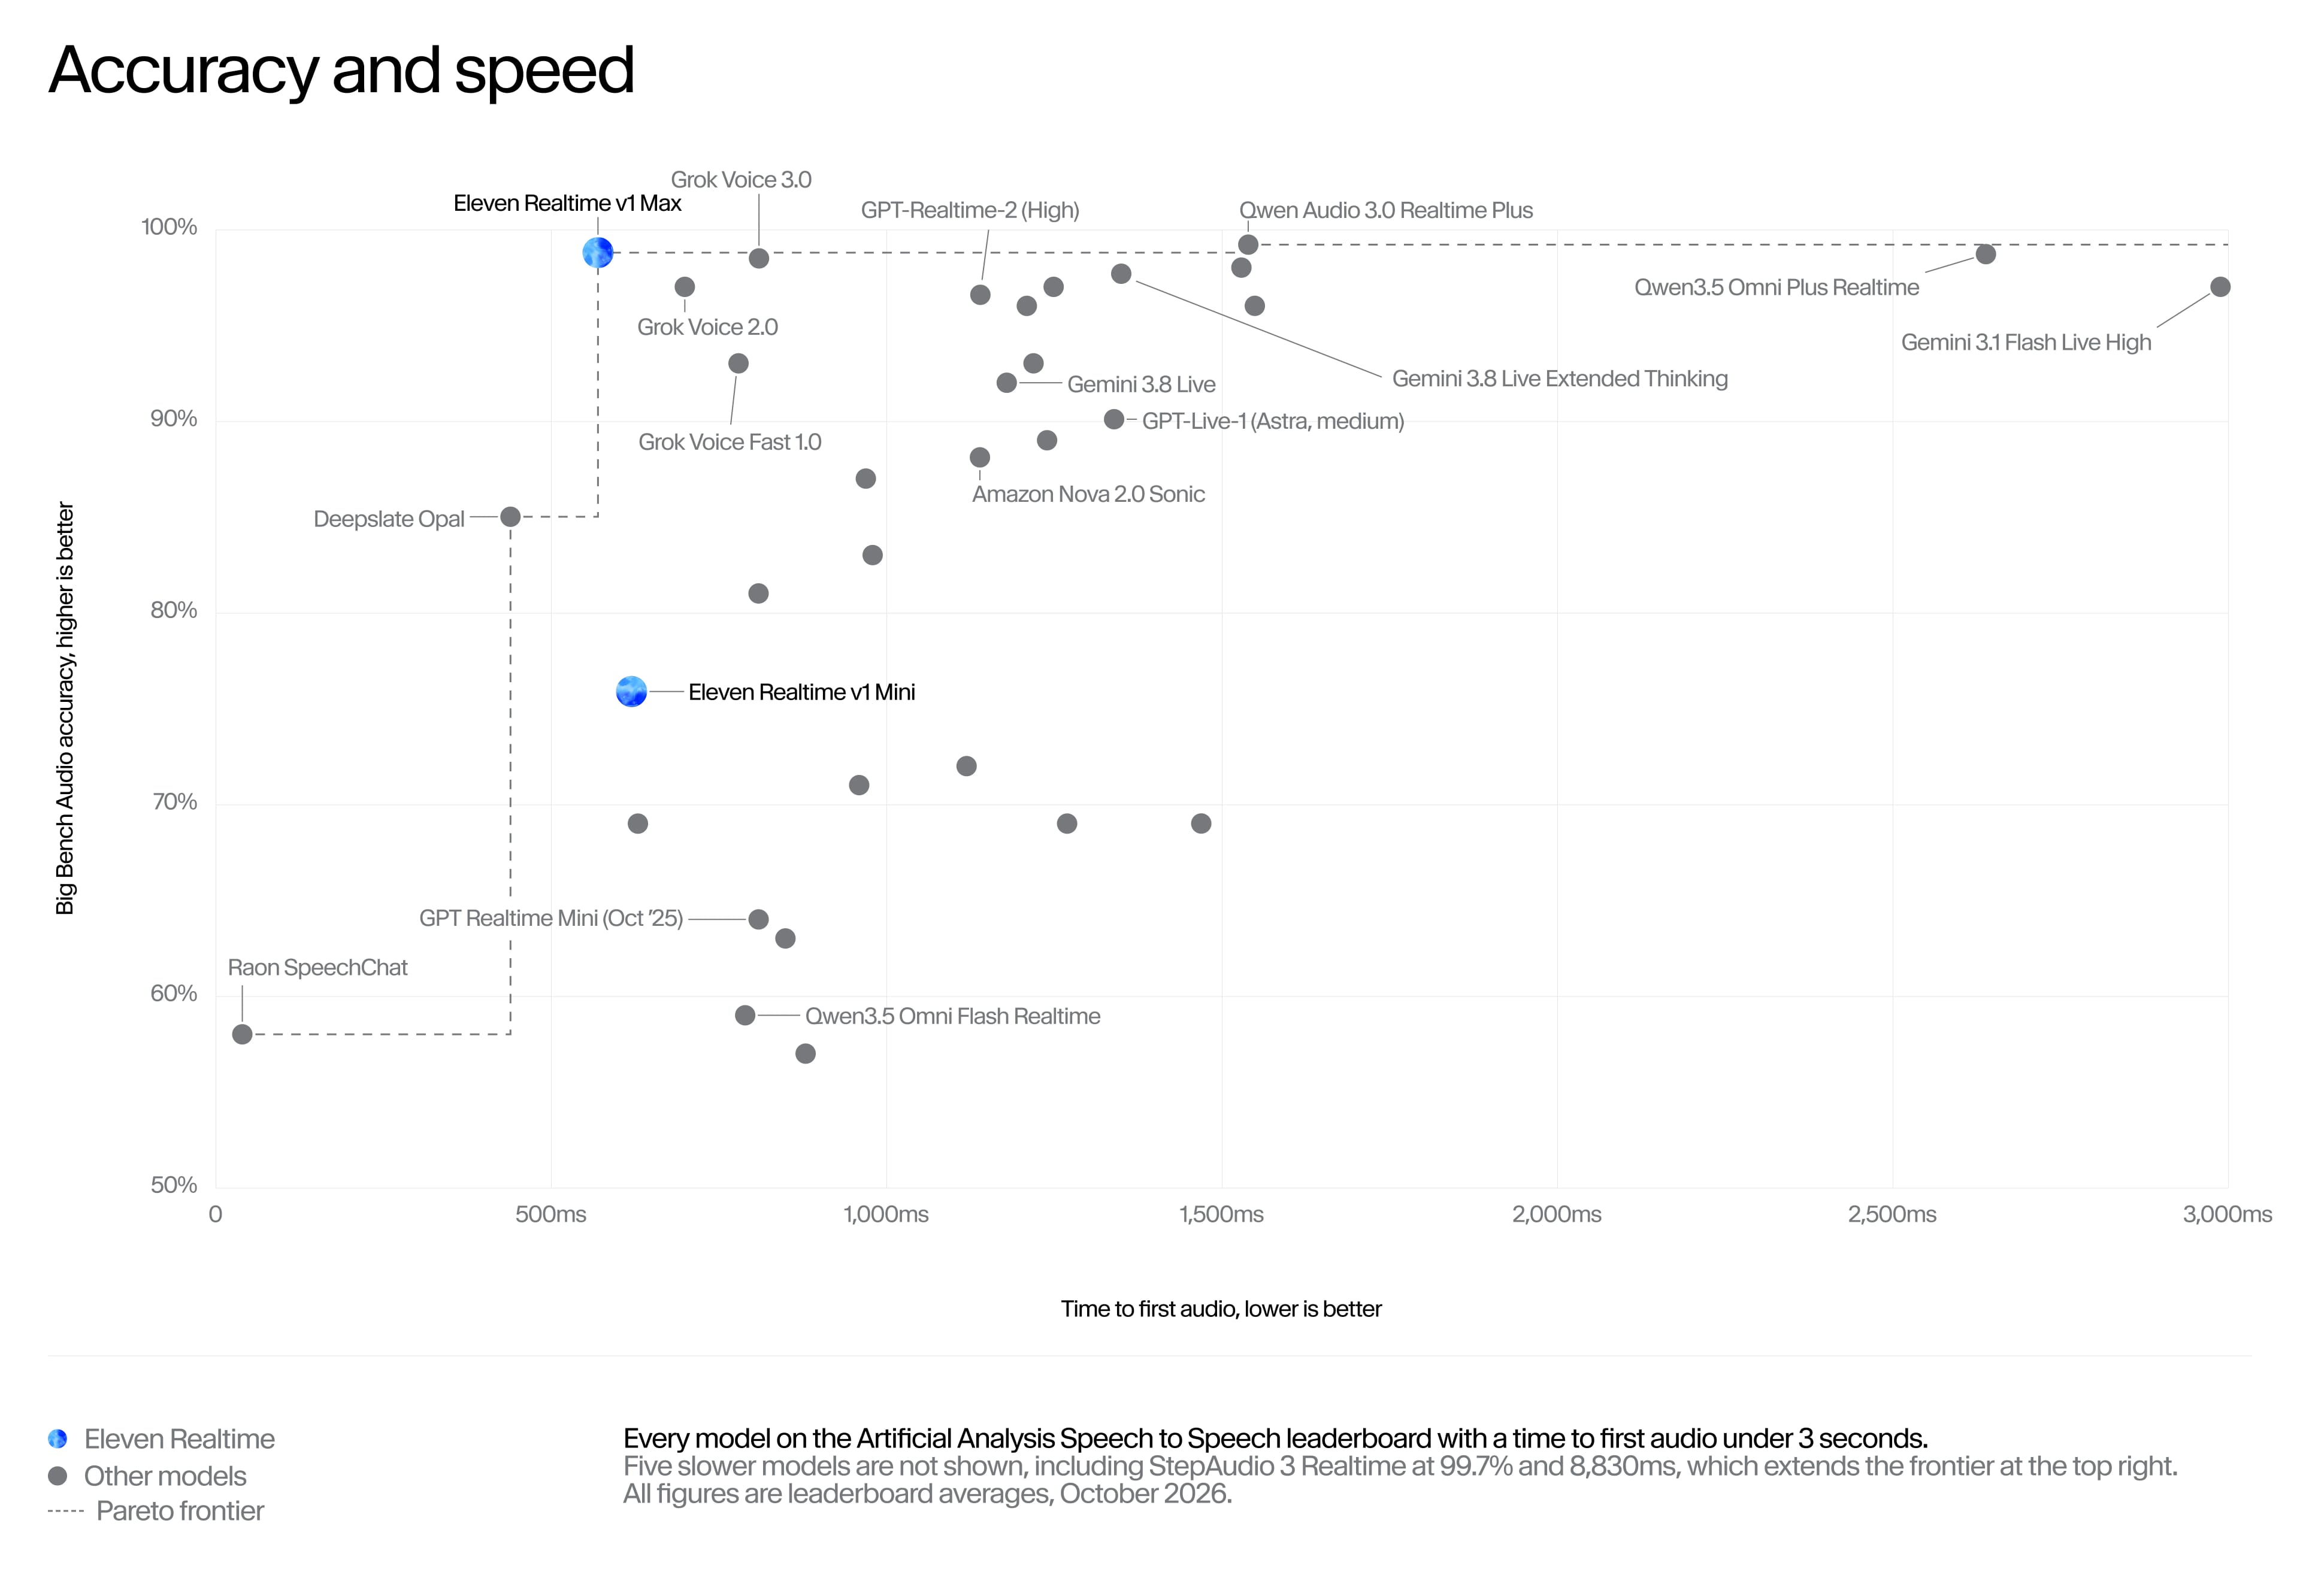
Riktmärkena nedan testar om den kompromissen verkligen är borta. När det gäller samtalsdynamik ligger båda modellerna i samma spann som fusionerade modeller. När det gäller både precision och hastighet är ingen modell på Artificial Analysis topplista både snabbare och mer precis än v1 Max.
Så presterar de
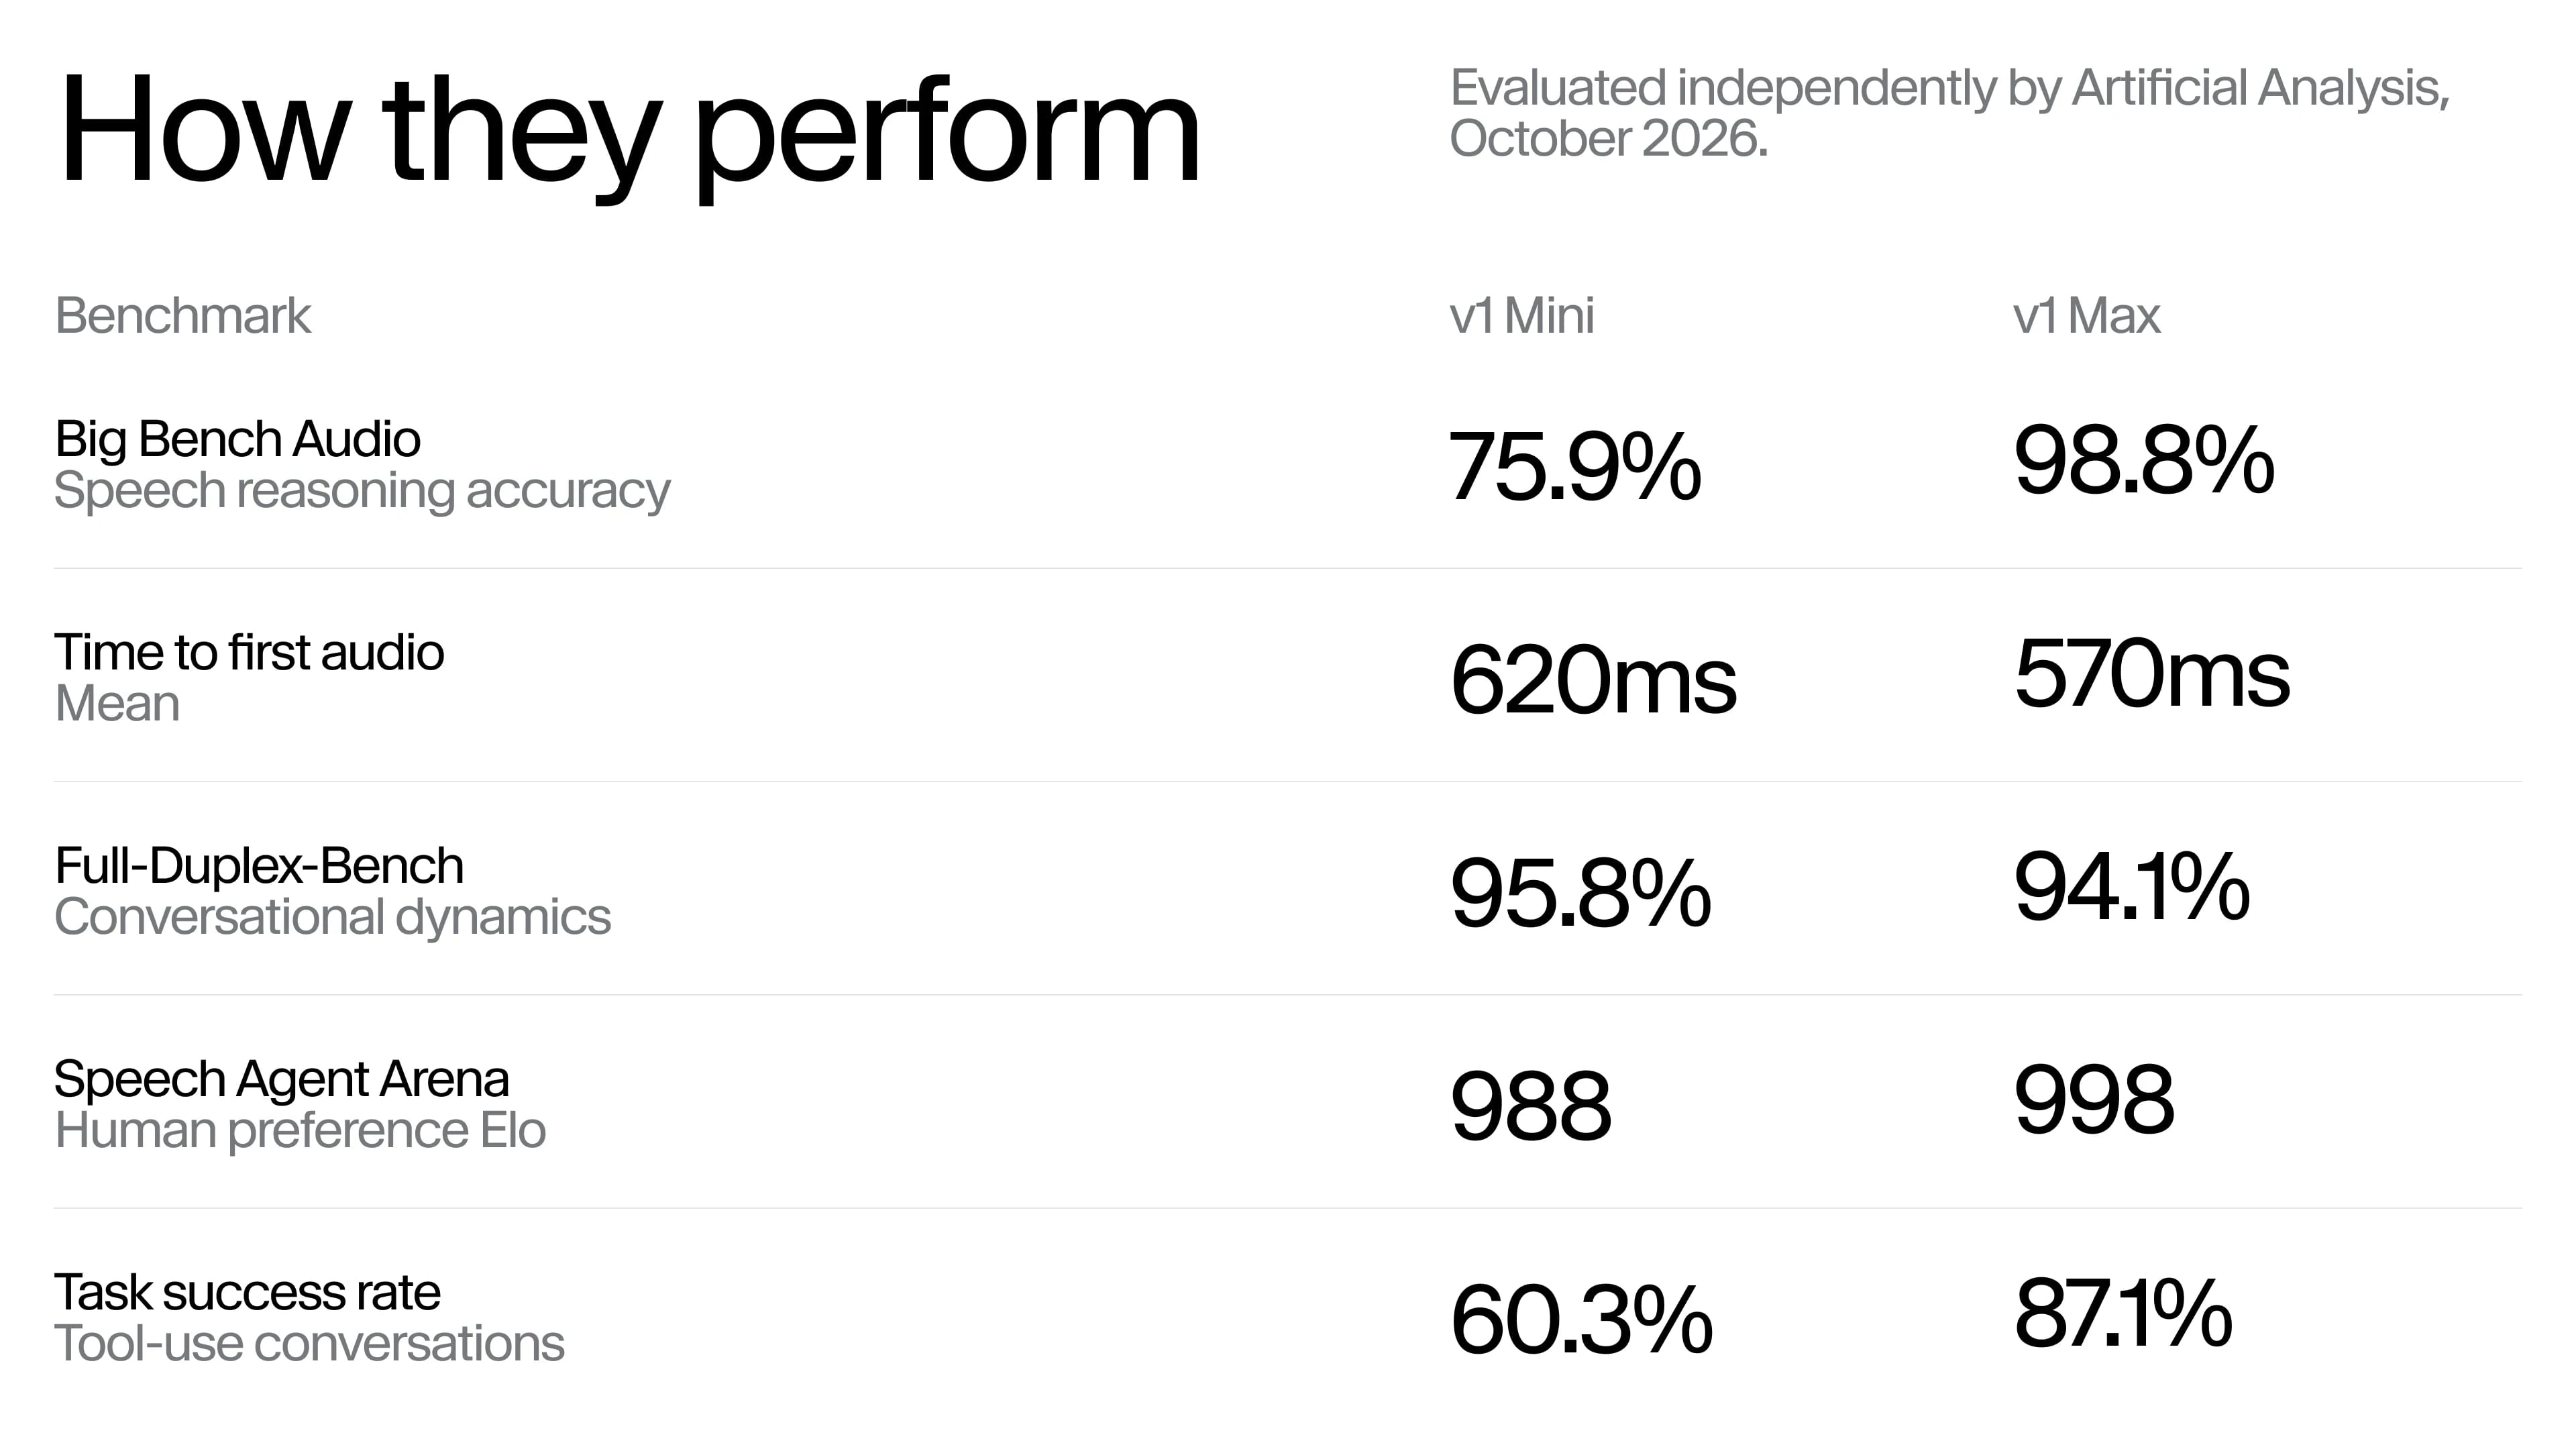
Artificial Analysis utvärderade båda modellerna oberoende i tre offentliga riktmärken: Big Bench Audio för talbaserat resonemang, Full-Duplex-Bench för samtalsdynamik och Speech Agent Arena för mänskliga preferenser och uppgiftsresultat.
Talbaserat resonemang
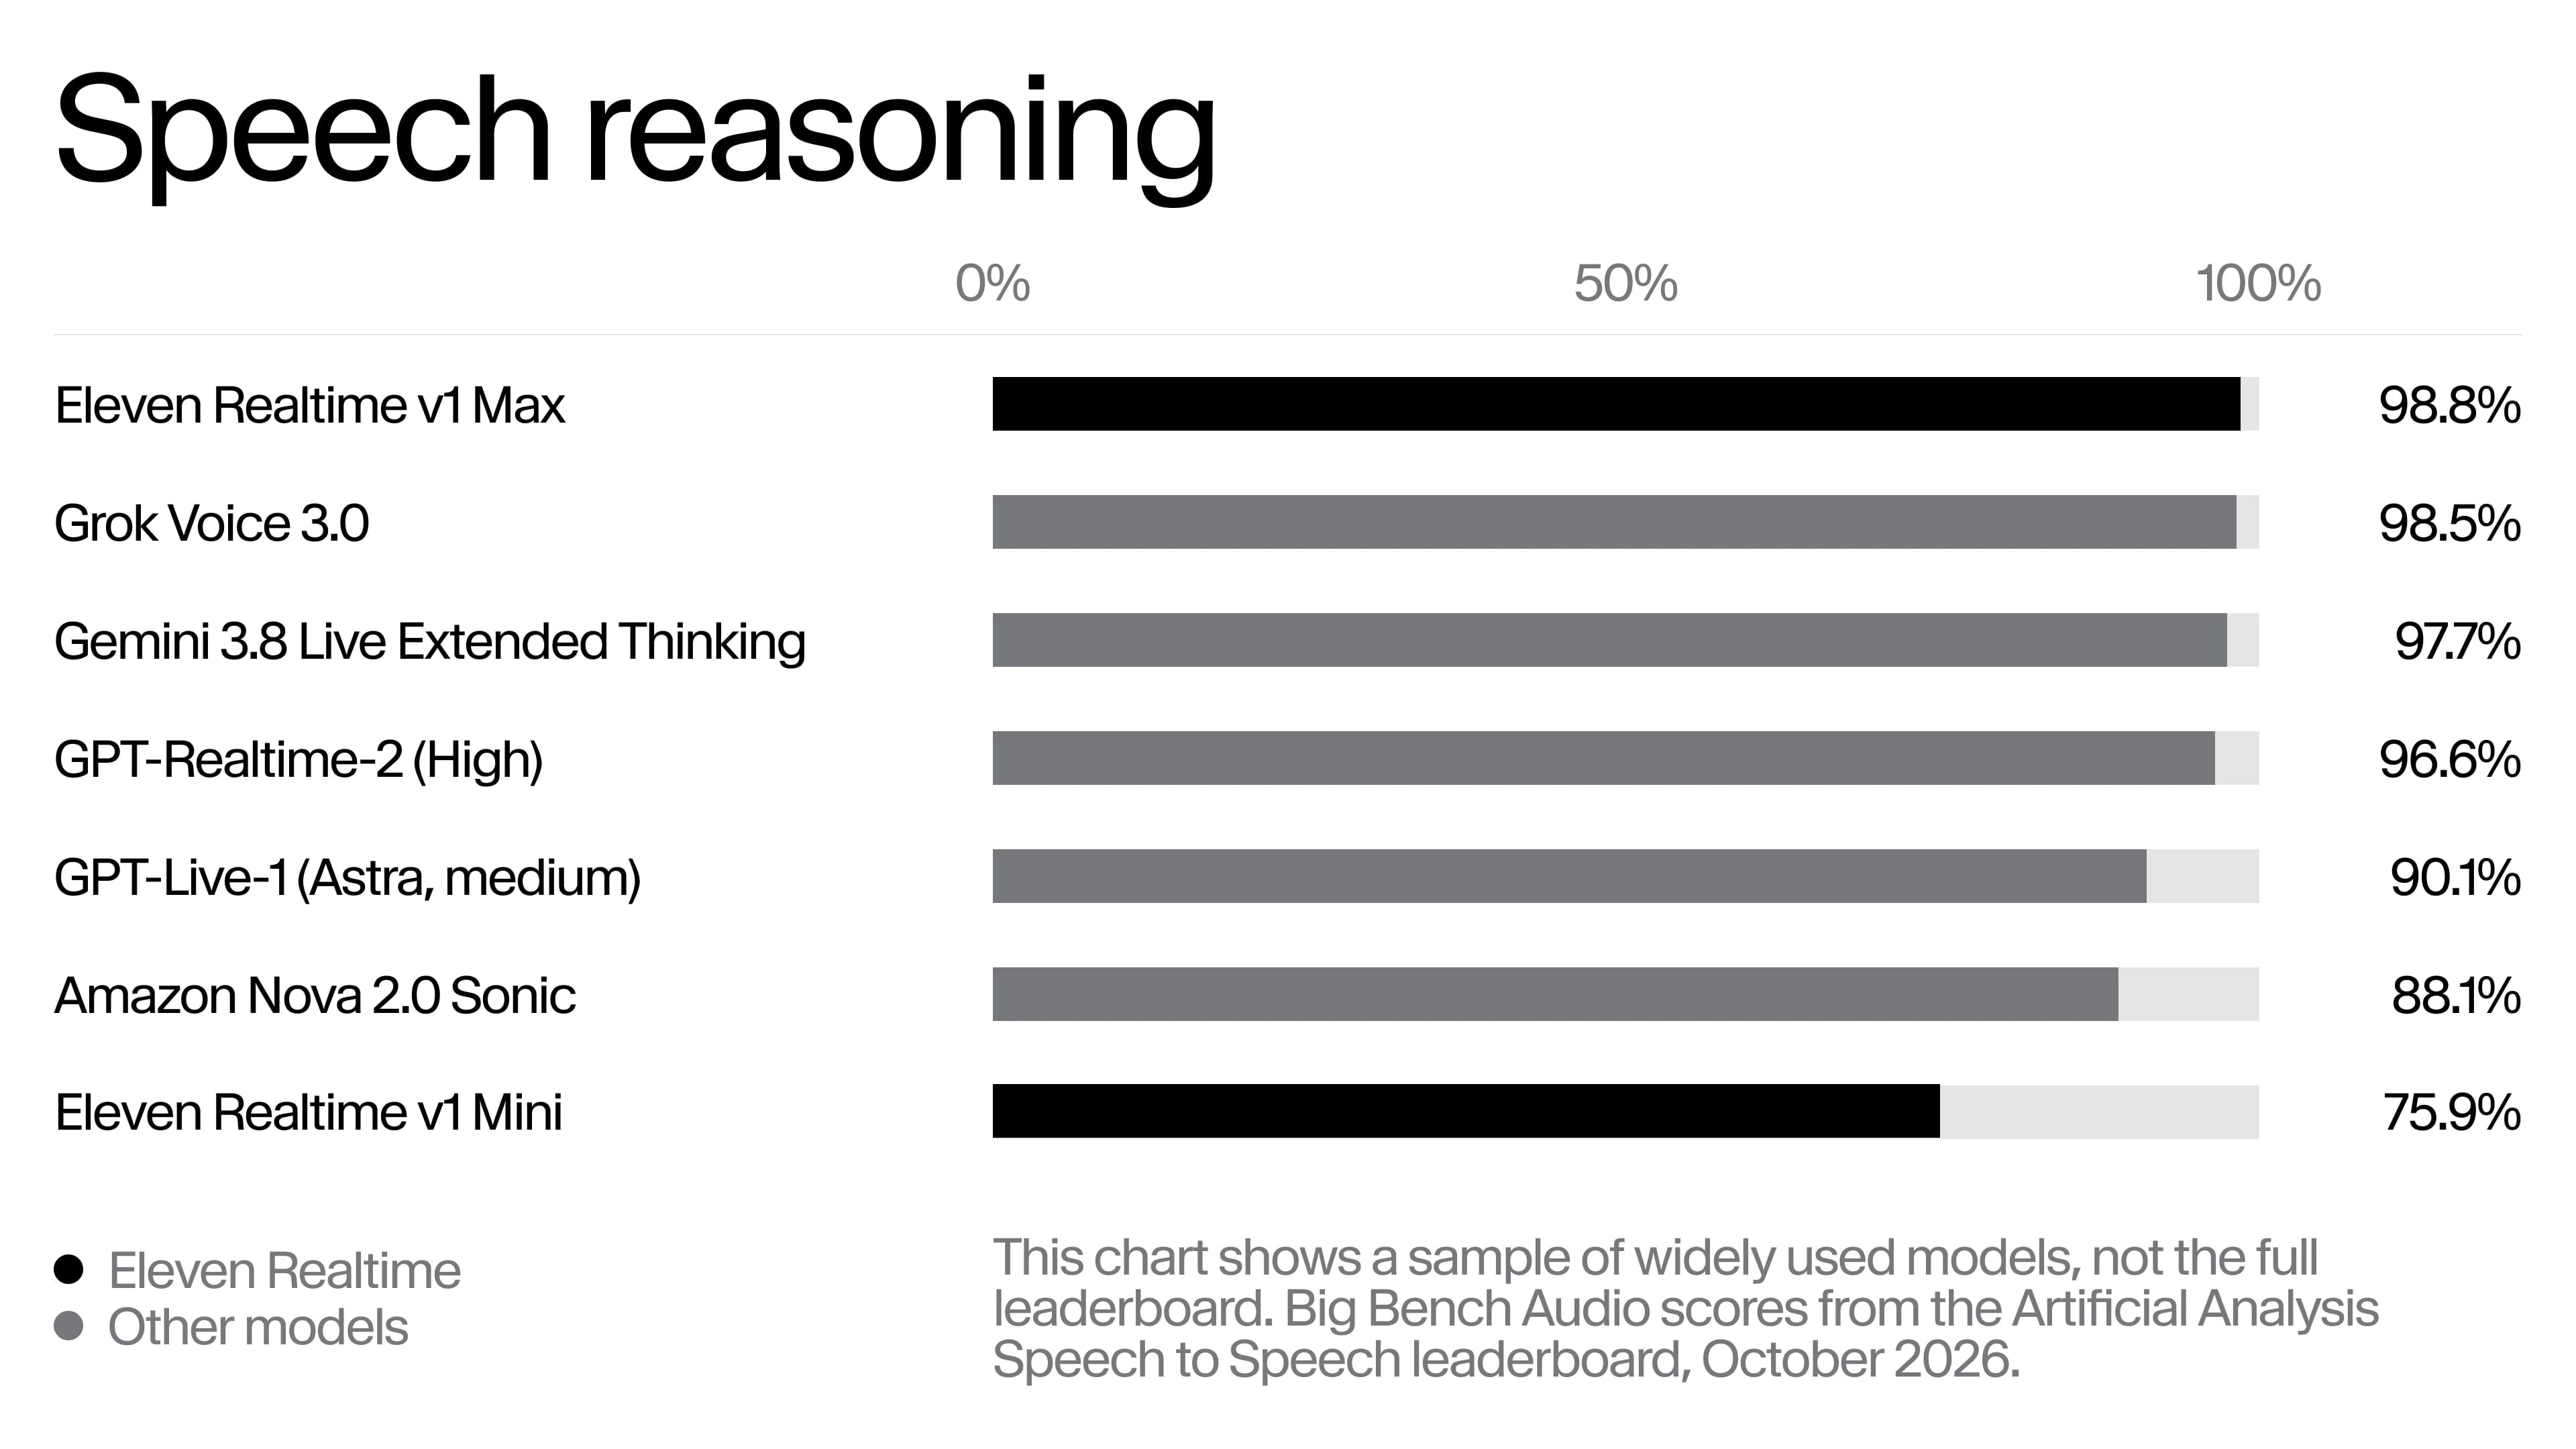
Big Bench Audio ställer 1 000 resonemangsfrågor med röst och poängsätter det talade svaret. Realtime v1 Max besvarade 98,8 % av frågorna korrekt, och v1 Mini besvarade 75,9 % korrekt.
Hastighet
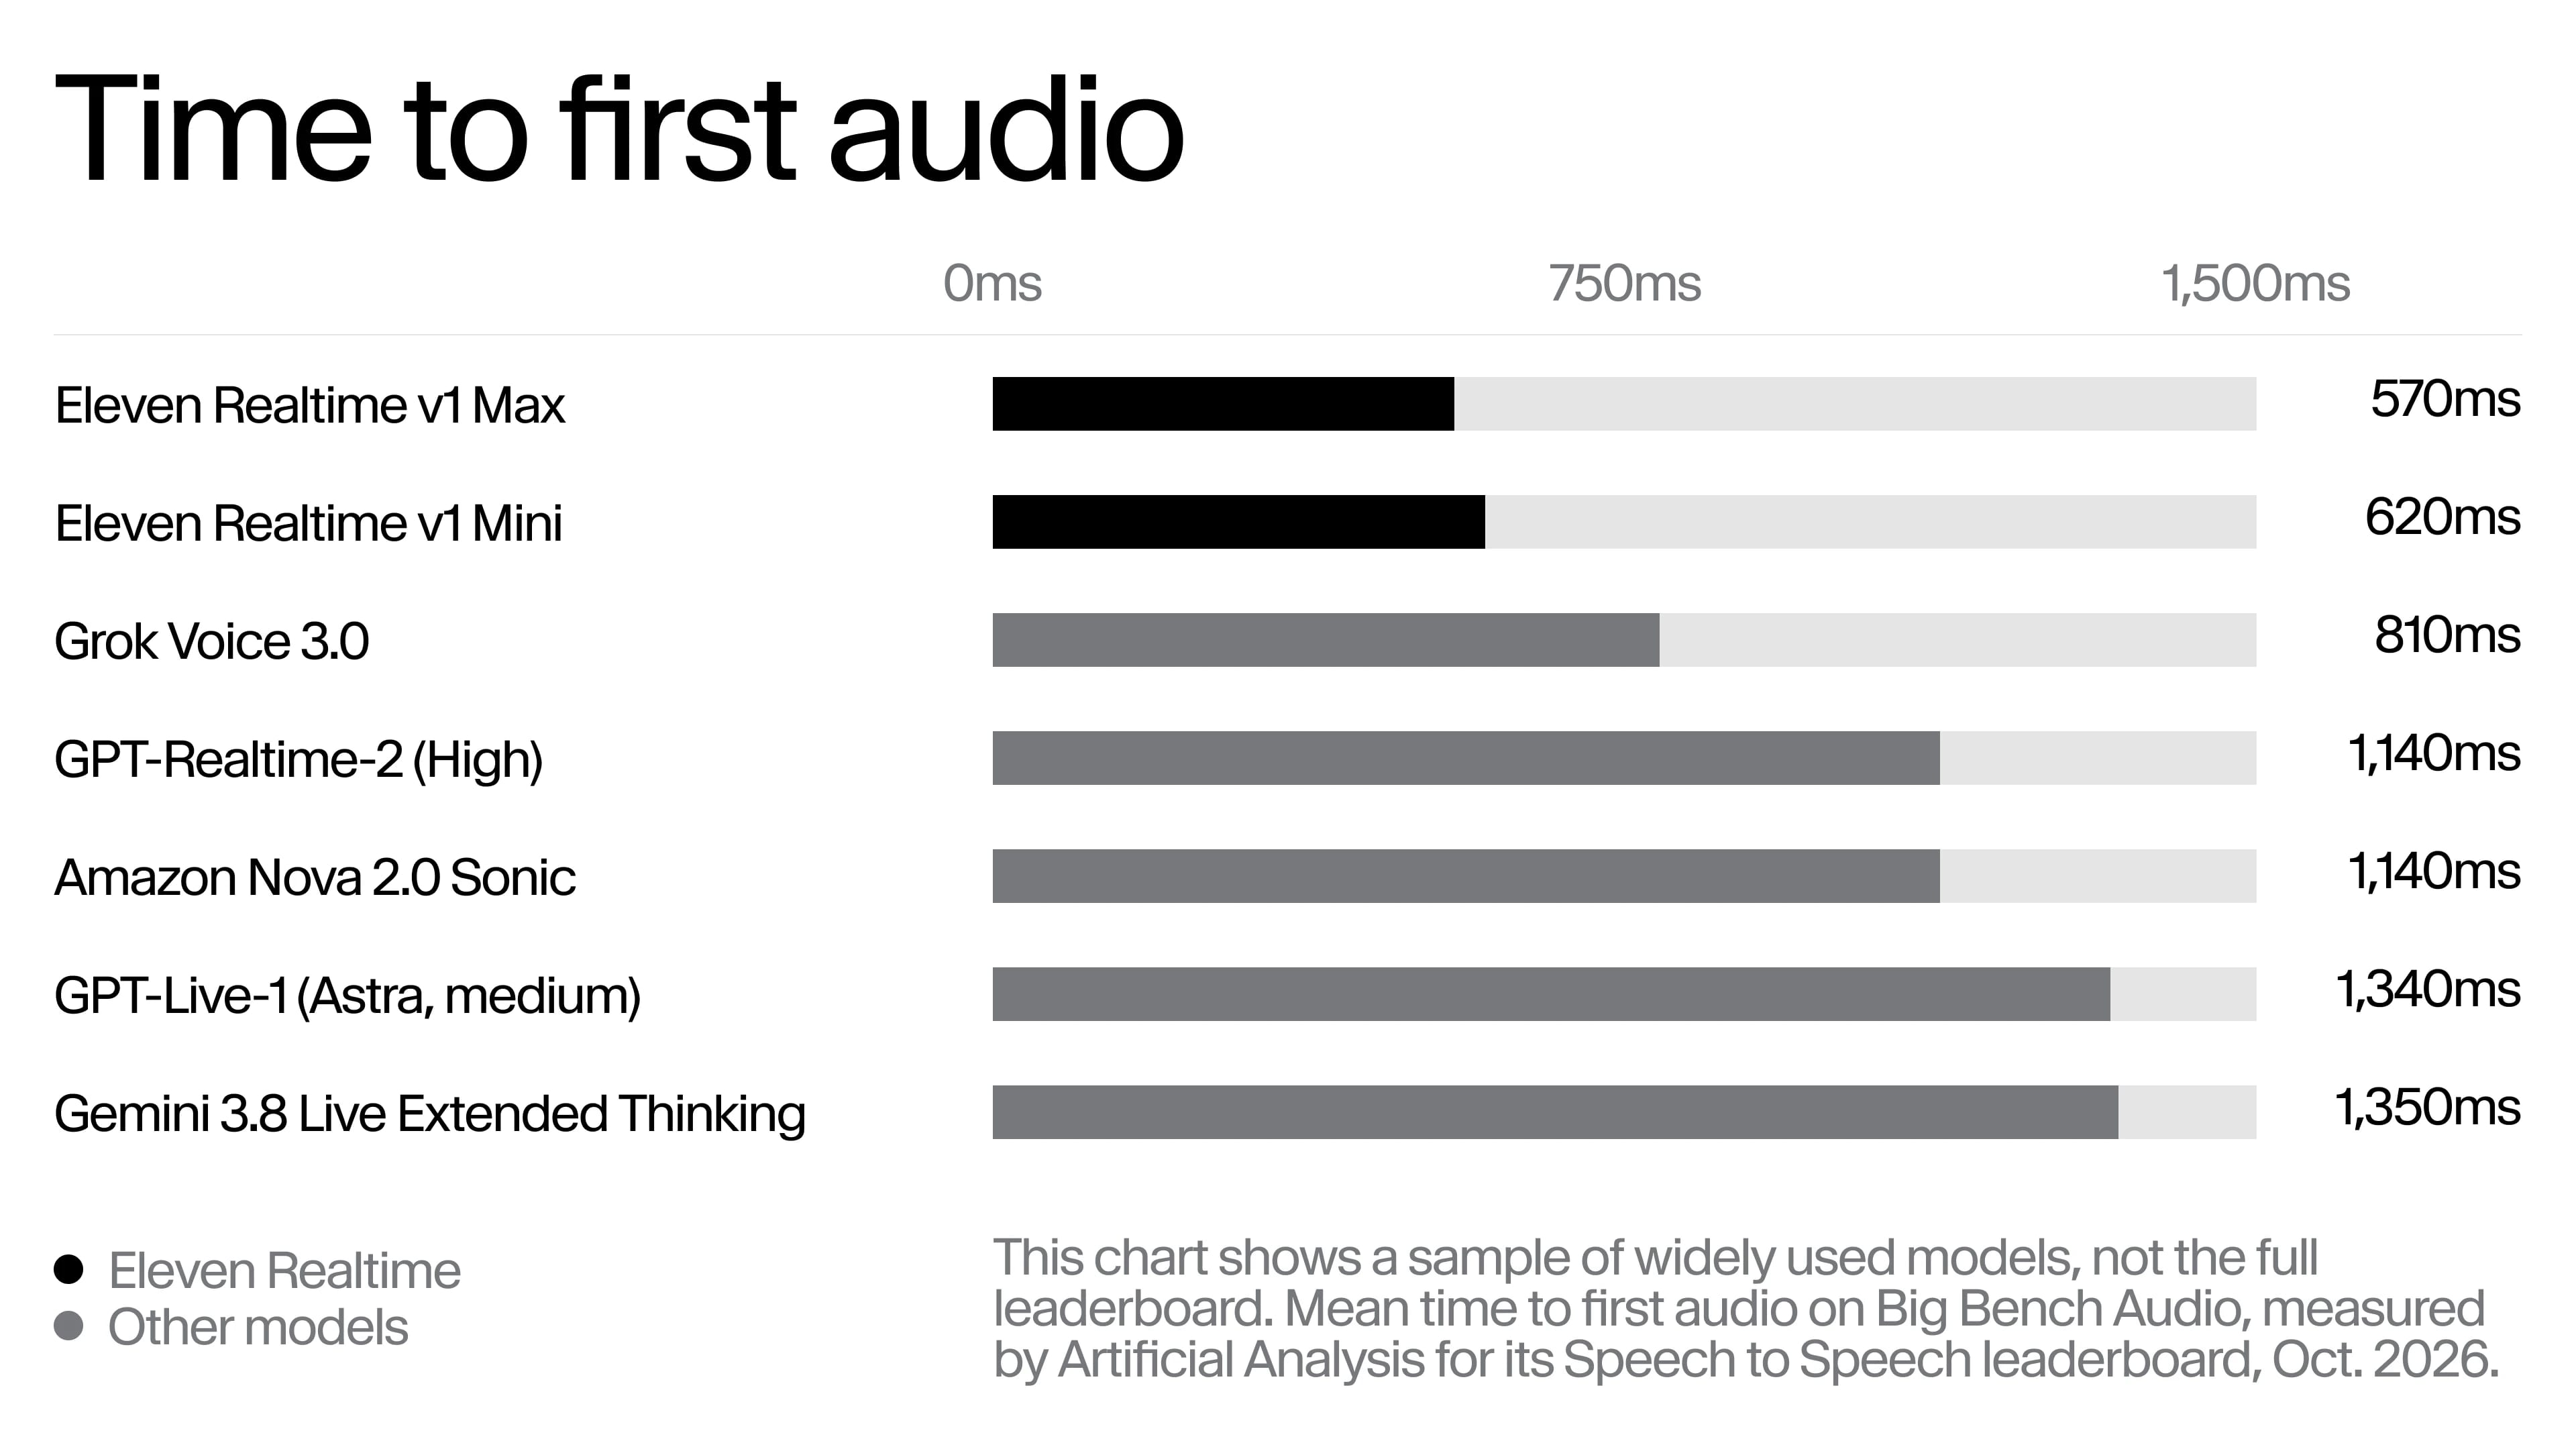
Big Bench Audio ställer 1 000 resonemangsfrågor med röst och poängsätter det talade svaret. V1 Max börjar tala efter i genomsnitt 0,57 sekunder, och v1 Mini efter 0,62 sekunder.
Paretofronten för precision och hastighet
Precision och hastighet ses vanligtvis som en avvägning. Modellerna som får högst poäng på Big Bench Audio tar längst tid på sig att svara, medan de snabbaste ger upp mycket precision. v1 Max utmärker sig i båda dessa mätvärden.
Samtalsdynamik och mänskliga preferenser
I Full-Duplex-Bench, som testar pauser, turordning, avbrott och återkopplingssignaler, får v1 Mini 95,8 % och v1 Max 94,1 %. I Speech Agent Arena, där människor jämför två modeller i blinda direktsamtal, fick v1 Max 998 och v1 Mini 988. I uppgifter med verktygsanvändning slutförde v1 Max 87,1 % och v1 Mini 60,3 %, vilket är varför vi rekommenderar Max för användningsområden med omfattande verktygsanrop.
Kom igång
I ElevenAgents (rekommenderas)
Skapa en agent eller öppna en befintlig och välj en Realtime-modell i rullgardinsmenyn. Därifrån har du allt som ElevenAgents erbjuder för att köra agenter i produktion. Det omfattar kanaler för telefon, webb, WhatsApp och CCaaS, arbetsflöden, en kunskapsbas, skyddsräcken, testning och övervakning.
Läs ElevenAgents dokumentation för mer information.
Via Realtime API
Om du redan har en integration med OpenAI:s Realtime API är det snabbaste sättet att testa Eleven Realtime att behålla din kod och ändra vart den pekar. Realtime API ansluter via WebSocket och följer OpenAI Realtime-specifikationerna, så OpenAI:s SDK fungerar som det är.
Realtime API ansluter endast via WebSocket, så en WebRTC-integration måste först flyttas till WebSocket. Det körs också separat från ElevenAgents, så om du behöver kanaler, en kunskapsbas eller andra plattformsfunktioner bör du bygga på ElevenAgents från början.
migreringsguiden beskriver stegen och skillnaderna jämfört med OpenAI:s API.