Como criar agentes de voz duradouros: algumas lições da engenharia de implantação avançada
- Publicado
- Última atualização
OuvirOuça este artigo
Para a maioria das organizações, soluções pontuais voltadas ao suporte há muito são avaliadas pela capacidade de desviar atendimentos. Isso significa reduzir o volume de chamadas e minimizar as interações com atendentes humanos. Mas desviar não é o mesmo que resolver, e é nessa diferença que a experiência do cliente se deteriora. Fechar essa lacuna exige agentes com acesso não apenas aos dados, mas também aos sistemas necessários para agir com base neles. Como resultado, os agentes podem processar reembolsos, orientar clientes durante o checkout e transferir para um atendente humano com todo o contexto sempre que a situação exigir. Isso permite que empresas lidem com interações com clientes em escala, reduzindo significativamente a carga das equipes de suporte humano e melhorando a experiência em ambos os lados da chamada. Em uma implantação recente com a Revolut, uma fintech que atende 70 milhões de clientes globalmente, isso resultou em uma redução de 8 vezes no tempo de resolução e uma taxa de sucesso de chamadas de 99,7%.
As organizações precisam abordar mudanças dessa magnitude de forma iterativa, mantendo uma conexão estreita com a missão central da empresa e contando com forte apoio executivo. No nível técnico, raciocinar em um ambiente não estruturado envolve riscos inerentes que precisam ser gerenciados com cuidado. Dar a um agente a capacidade de atuar em todo o Customer Relationship Management (CRM), modificar um pedido no sistema de ponto de venda ou escalar um caso significa que o modelo de governança importa tanto quanto o próprio modelo. O foco passa, então, a não ser se os agentes conseguem realizar trabalho real, mas quais mecanismos são necessários para implantá-los com segurança e de forma repetida.
Neste post, compartilhamos, com base na nossa experiência, o que torna os agentes bem-sucedidos desde a primeira implantação até a expansão por toda a operação de atendimento ao cliente de uma organização.
Lançar agentes vs. lançar software
Antes de nos aprofundarmos na criação de agentes, vale comparar a implantação de agentes de voz ao software tradicional, algo que as empresas fazem há décadas. Por essa perspectiva, os agentes podem ser separados em dois componentes distintos: software tradicional e orquestrador central.
Software


Orquestrador central
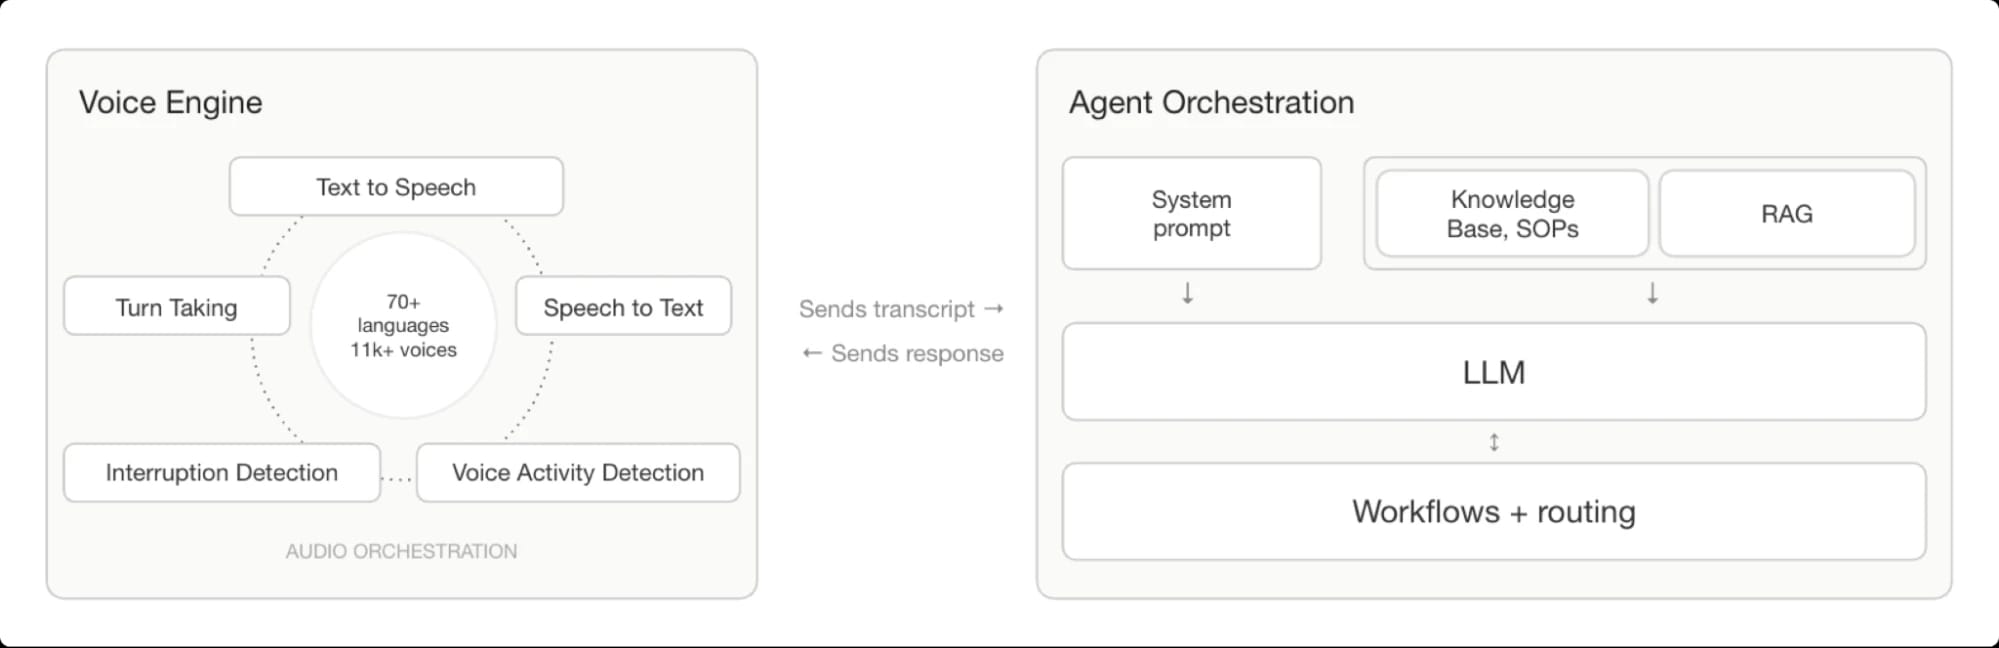
Os componentes tradicionais de software têm como objetivo principal melhorar a entrega e o desempenho do agente. No ElevenAgents, isso inclui recursos como controle de versões, testes A/B, telefonia e configuração da primeira mensagem, entre outros. Esses componentes apresentam pouca ou nenhuma deriva após a implantação, tornando seu comportamento altamente previsível. Com práticas robustas de engenharia, as organizações podem desenvolver rapidamente esses recursos e manter uma compreensão profunda de seu desempenho em produção por meio de um conjunto rigoroso de métricas, rastreamentos e logs. As melhorias de latência nessa camada seguem padrões bem conhecidos: cache, pool de conexões, escalabilidade da infraestrutura e otimização de protocolos são mecanismos confiáveis com resultados determinísticos.
Por natureza, os componentes do Orquestrador Central são mais difíceis de prever, mas determinam o desempenho do agente em tempo de execução, tanto em qualidade das respostas quanto em latência percebida. Diferentemente do software tradicional, esses componentes operam sobre linguagem natural e áudio, em que o espaço de entrada é praticamente ilimitado e pequenas mudanças na formulação, no contexto, no ruído de fundo ou no comportamento do usuário podem gerar resultados significativamente diferentes ao longo do tempo. Isso torna os testes convencionais insuficientes por si só: um agente pode ter desempenho impecável em centenas de casos de teste e ainda falhar em produção de maneiras difíceis de antecipar.
A latência nessa camada também é menos determinística, influenciada pelos tempos de inferência do modelo, pela inserção de artefatos auditivos, por cadeias de chamadas de ferramentas e pela variabilidade inerente aos sistemas generativos. Gerenciar bem esses componentes exige uma disciplina diferente, baseada em frameworks de avaliação, monitoramento de produção e disposição para iterar continuamente com base em dados de conversas reais, e não apenas em suposições anteriores à implantação.
Essa distinção define como as organizações devem abordar a adoção: começar com casos de uso relevantes para a organização, mas de baixo risco, e então escalar de forma deliberada à medida que a confiança no sistema cresce.
Ciclo de lançamento
Selecionando casos pioneiros
Para equipes que estão começando a adotar agentes de voz, escolher os casos pioneiros certos é uma das decisões iniciais mais importantes. E isso tem menos a ver com tecnologia do que a maioria imagina. As equipes que acumulam sucessos logo no início e evitam o abismo interminável da POC tendem a ter algo em comum: conseguem responder às perguntas a seguir com clareza.
- Como esse caso de uso gera valor mensurável para o negócio? O caso de uso ideal para começar não é o mais interessante tecnicamente, mas aquele com maior probabilidade de impactar um resultado que a empresa já considera importante. Isso é medido pelo impacto na receita, redução de custos, satisfação do cliente e outras métricas que as lideranças já acompanham e pelas quais são responsáveis. Sem essa ligação direta com o valor para o negócio, fica difícil justificar os ciclos de iteração necessários para acertar o agente, e o impulso provavelmente perde força antes que a tecnologia possa provar seu valor.
- Está imediatamente claro para os usuários qual é o escopo e o propósito do agente? A ambiguidade de escopo é uma das fontes mais comuns de deriva entre desenvolvimento e produção. Usuários que não entendem o que um agente pode e não pode fazer testarão seus limites de formas que a suíte de avaliação nunca previu. Um agente com escopo bem definido estabelece expectativas desde a primeira mensagem e lida bem com solicitações fora do escopo.
- Como são as interações boas e ruins, e é possível codificá-las em um conjunto concreto de critérios de avaliação? Uma boa interação não é simplesmente aquela em que o agente conclui a tarefa, mas aquela em que o usuário se sente ouvido, o escalonamento acontece no momento certo e o resultado está alinhado à intenção do negócio. Os critérios de avaliação se dividem em duas categorias: métricas quantitativas capturadas pela plataforma, como taxa de conclusão de tarefas e taxa de escalonamento, e critérios baseados em transcrições, que exigem analisar a própria conversa. Definir os critérios baseados em transcrições desde cedo dá à equipe um objetivo concreto para alcançar. Eles também estabelecem um limite natural para entrar em produção. Quando seu agente atende consistentemente aos critérios de avaliação e as métricas da plataforma se estabilizam, você tem confiança para ir para produção. Sem critérios definidos, entrar em produção é uma decisão baseada em julgamento.
- Quais são as compensações entre desempenho e controle, e qual deles importa mais nesta fase? Quanto mais autonomia é dada a um agente, mais naturais e flexíveis se tornam as interações, mas maior é o risco de operar fora dos limites validados. Um controle mais rígido, com prompts restritos e lógica de escalonamento mais estrita, reduz esse risco, mas pode fazer o agente parecer inflexível. Nenhum dos extremos é o ideal. Organizações que restringem demais cedo acabam com uma URA glorificada. As que avançam rápido demais antes de estabelecer confiança criam uma carga de suporte que supera os ganhos. Entender onde esse controle deve ficar em cada estágio de maturidade definirá a configuração do modelo, a lógica de escalonamento e quanto do conhecimento do agente estará no prompt em vez de em fontes recuperadas ou estruturadas.
Com essas perguntas respondidas, a organização está pronta para passar da estratégia à execução e começar a definir o escopo da implementação.
Estruturando a implementação inicial
Ao passar para a execução, as equipes podem recorrer a metodologias quase tão antigas quanto o próprio software. O Desenvolvimento Orientado a Testes (TDD) fornece a estrutura para manter os agentes alinhados às métricas principais durante toda a implementação.
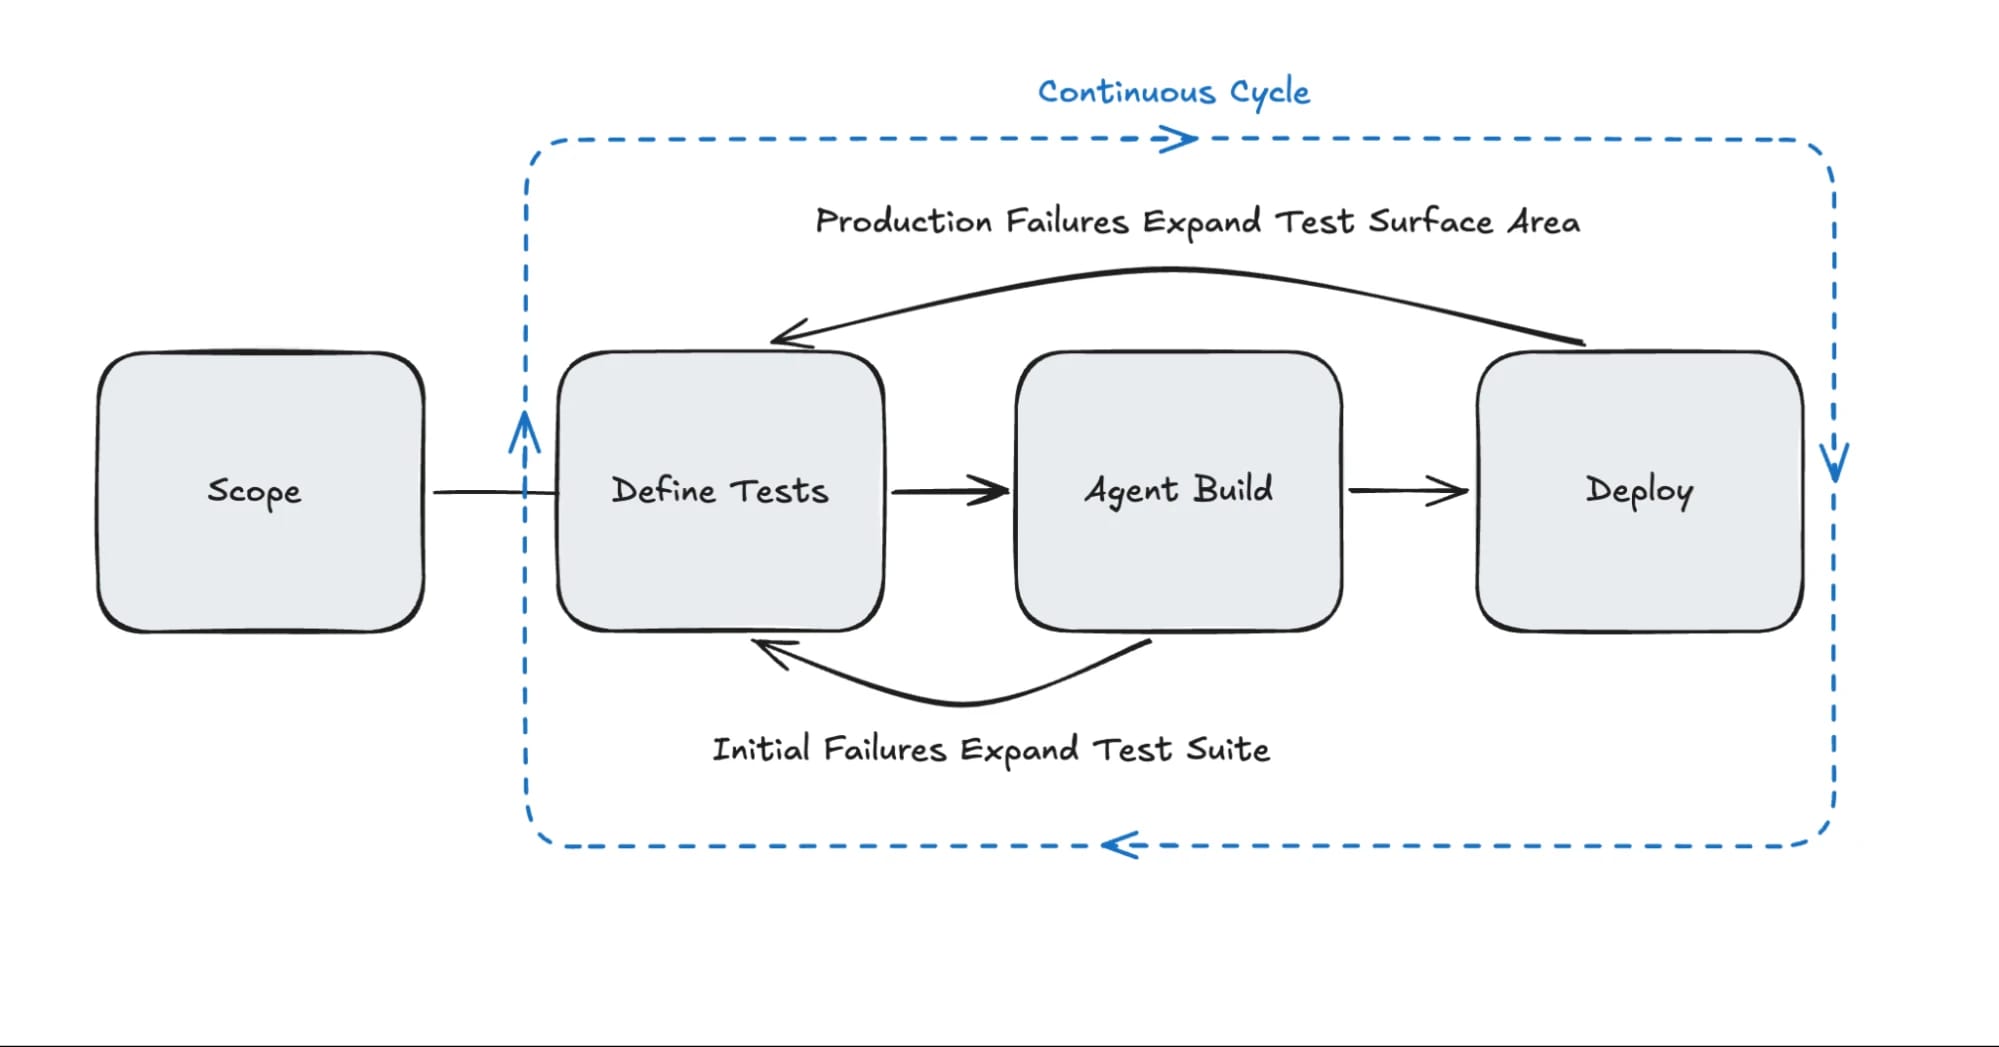
Na prática, as equipes de desenvolvimento e as partes interessadas do negócio devem definir e criar juntas dois artefatos fundamentais: Critérios de Avaliação de Sucesso, que estabelecem como é um bom resultado tanto no nível de cada chamada quanto no agregado, e Testes de Agente, que verificam repetidamente comportamentos específicos que o agente deve apresentar. O primeiro é mais bem informado pela análise de chamadas reais feitas por humanos, quando elas ocorrem. O segundo é criado de forma incremental, começando com um conjunto inicial de comportamentos esperados e expandindo à medida que novos comportamentos são introduzidos e casos extremos são descobertos.
Com um conjunto inicial de testes em vigor, o desenvolvimento do agente começa pelo prompt de sistema. É nele que são definidas as regras, o tom e a abordagem do agente: o que ele deve fazer, o que não deve fazer e como deve se comportar nos limites de sua função. Um prompt de sistema bem elaborado depende tanto da estrutura quanto do conteúdo. Separar as instruções em seções claramente identificadas, manter orientações relacionadas juntas e evitar formulações condicionais fazem uma diferença relevante na consistência do comportamento do agente. Nesta fase, frequentemente recorremos ao guia de prompting.
Junto ao prompt de sistema, são configurados os componentes centrais do agente: o LLM, o modelo de conversão de texto em voz (TTS) e a voz. A escolha do LLM é principalmente uma compensação entre latência e desempenho, em que modelos otimizados para velocidade geralmente sacrificam parte da capacidade de raciocínio, e vice-versa. Para TTS, a escolha certa depende do que o caso de uso mais exige: uma entrega expressiva, baixa latência ou suporte multilíngue. Já a voz é uma decisão tanto de marca quanto técnica. Ela define como uma organização é percebida por cada pessoa que liga, tornando-se uma das poucas decisões de configuração que pertencem tanto às equipes de marca e marketing quanto aos engenheiros que criam o agente. Isso permite que a seleção da voz ocorra em paralelo ao restante do processo de desenvolvimento, em vez de se tornar um gargalo no início ou no fim. O ElevenAgents oferece acesso a mais de 10.000 vozes, e, se nenhuma servir, as equipes podem clonar ou criar a própria voz.
A partir daí, os agentes podem ser opcionalmente ampliados com uma Base de Conhecimento, ferramentas e configurações de canal. Cada adição libera novas capacidades, mas também introduz novas áreas a testar. Seja integração de telefonia, acesso a bancos de dados externos ou capacidade de agir em nome de um cliente, vale testar essas decisões de forma rigorosa com os critérios de avaliação antes de ampliar o escopo. Quando ferramentas são adicionadas, o prompt de sistema e a descrição da ferramenta fornecem orientações explícitas sobre quando e como chamar cada uma delas, para que o agente as use de modo consistente e no contexto certo.
Com essas bases prontas, o agente está preparado para ser testado.
Em direção à prontidão para produção
Com os testes e critérios de avaliação definidos na fase de estruturação sendo executados contra um agente já criado, o desenvolvimento se torna um ciclo curto: adicionar mais testes, identificar falhas, atualizar o prompt de sistema ou a configuração e executar novamente. A maioria das falhas nesta fase não são falhas do modelo, mas do prompt. Uma instrução que parecia clara isoladamente se mostra ambígua quando o agente a encontra no meio da conversa. Surgem casos extremos que a suíte inicial de testes não previu. Cada um deles se torna um novo teste de Próximo Turno que pode ser criado a partir da própria conversa. A questão de quando parar de iterar tem uma resposta concreta: quando o agente atende consistentemente aos critérios de avaliação em várias execuções, e métricas da plataforma, como taxa de conclusão de tarefas e taxa de escalonamento, se estabilizam em faixas aceitáveis. É por isso que definir esses critérios antes de criar o agente é tão importante. Sem eles, a prontidão se torna uma decisão baseada em julgamento e a linha de chegada continua mudando.
Na prática, a maioria das equipes descobre que um pequeno conjunto de padrões recorrentes de falha responde pela maior parte dos problemas. Os mais comuns são ambiguidade no prompt, em que o agente recebe instruções conflitantes ou insuficientemente especificadas e assume comportamentos imprevisíveis; uso incorreto de ferramentas, em que o agente chama uma ferramenta no contexto errado ou deixa de chamá-la quando deveria; e deriva de escalonamento, em que o agente escala de forma agressiva demais ou mantém conversas que deveria ter transferido. Cada um desses problemas tem uma correção no nível do prompt. Tornar a instrução relevante mais precisa, acrescentar um exemplo explícito ou ajustar o limite de escalonamento geralmente é suficiente. O risco está em não identificá-los antes da entrada em produção.
A forma mais comum de as equipes errarem nisso é tratar uma suíte de testes aprovada como garantia, e não como sinal. Uma suíte que cobre apenas o caminho feliz será aprovada facilmente e significará muito pouco. A cobertura de recusas, mudanças de rumo no meio da conversa, entradas ambíguas e interações que usam muitas ferramentas é o que dá peso aos resultados. Da mesma forma, equipes que pulam os testes de simulação e dependem apenas de testes por turno deixam passar uma classe de falhas que só surge em uma conversa completa, como deriva de contexto, em que o agente perde o acompanhamento de turnos anteriores, ou erros cumulativos, em que um pequeno deslize no início da chamada se transforma em um resultado ruim. Quando os padrões recorrentes de falha são resolvidos e o agente lida bem, ainda que não perfeitamente, com a longa cauda de casos extremos, o valor marginal de novas iterações no ambiente de staging diminui. Nesse ponto, o sinal mais valioso vem de conversas reais.
Entrar em produção não significa que a iteração acabou. Significa que o foco do aprendizado muda dos testes sintéticos para as transcrições de produção. Os critérios de avaliação que definiram a entrada em produção se tornam a base para medir o desempenho ao vivo, e o ciclo continua a partir daí.
Ciclos de feedback, avaliação e como saber quando parar de iterar
Depois que os testes são definidos e começam a ser executados, as lacunas no pipeline se tornam visíveis rapidamente. Por meio da Análise de Conversas, as equipes podem identificar o momento exato em que uma interação deu errado e usar esse sinal para criar um novo teste e indicar o que precisa mudar. As intervenções mais comuns ocorrem no nível do prompt: tornar as descrições de chamadas de ferramentas mais precisas, adicionar instruções mais explícitas para casos extremos ou esclarecer condições de escalonamento que se mostraram ambíguas na prática. Em alguns casos, o problema é mais profundo, e a configuração do modelo subjacente precisa ser revisitada se a latência ou a qualidade do raciocínio ficarem abaixo do que o caso de uso exige.
A disciplina mais importante nesta fase é validar as mudanças em vez de presumir seus efeitos. Uma correção que resolve uma falha pode introduzir outra silenciosamente. O ElevenAgents oferece suporte a controle de versões, permitindo que as equipes testem novas iterações com uma pequena porcentagem dos usuários antes de lançá-las para um público maior. Isso permite confirmar que as melhorias realmente estão melhorando os resultados, em vez de apenas deslocar o modo de falha para outro lugar.
O que pode dar errado
O erro mais importante nesta fase é pular lançamentos segmentados e enviar mudanças diretamente para toda a população de usuários. Sem lançamentos graduais, você perde a capacidade de isolar o impacto de cada mudança e, em escala, fica quase impossível entender o que realmente está causando melhorias ou regressões nas métricas da plataforma. Tratar toda a base de usuários como ambiente de teste não é apenas arriscado; isso elimina a observabilidade necessária para tomar decisões confiantes no futuro.
Além da estratégia de lançamento, vale se proteger contra outros dois modos de falha. O primeiro é dar peso excessivo a falhas recentes. Quando uma conversa de alta visibilidade dá errado, é natural querer corrigi-la imediata e amplamente, mas mudanças reativas no prompt feitas sem executar toda a suíte de testes frequentemente causam regressões em comportamentos que antes eram estáveis. Toda mudança, por menor que seja, deve ser tratada como uma nova iteração e testada adequadamente. O segundo é a deriva de avaliação. Com o tempo, as equipes podem reduzir inconscientemente o padrão do que conta como um teste aprovado, especialmente sob pressão para lançar. Os critérios de avaliação definidos durante o escopo devem continuar sendo a referência. Se começarem a parecer rigorosos demais, a resposta certa é revisá-los e atualizá-los deliberadamente, e não permitir que os padrões se deteriorem informalmente.
Escalando com confiança
Aumentar o tráfego é uma decisão de confiança, não baseada em tempo. O sinal para expandir é quando o agente atende consistentemente aos critérios de avaliação em várias execuções de teste, as métricas da plataforma se estabilizaram e os lançamentos segmentados não mostraram regressão significativa em relação ao grupo de controle.
Uma pergunta comum nesta fase é quanto tráfego é suficiente para chegar a uma conclusão. Lotes com menos de 100 chamadas por ramificação produzem variação excessiva para avaliar os resultados de forma confiável. Uma taxa de aprovação de 60% em 25 chamadas e uma taxa de 60% em 100 chamadas representam níveis de confiança muito diferentes. Além de atingir um número definido, o lote também deve ser grande o suficiente para revelar toda a gama de entradas realistas, incluindo casos extremos prováveis, intenções incomuns e modos de falha que só aparecem em volume e raramente surgem em amostras pequenas.
Mais tráfego amplifica tanto o que está funcionando quanto o que não está. Expandir antes de resolver os padrões principais de falha cria uma carga de suporte difícil de reverter.
Repita o processo
Saber onde parar é tão importante quanto saber o que corrigir. A iteração tem retornos decrescentes, e o sinal certo para pausar é quando o agente atende consistentemente aos critérios de avaliação definidos durante o escopo. Nesse ponto, novas mudanças trazem mais riscos do que benefícios.
O que significa "atender consistentemente aos critérios" varia conforme o contexto. Equipes com acesso limitado a dados ou integrações incompletas podem considerar taxas de escalonamento em torno de 50% como um teto realista até que essas restrições sejam resolvidas. Onde o acesso a dados é forte, as implantações de melhor desempenho geralmente buscam conclusão de tarefas acima de 80% e escalonamento abaixo de 20%. Mais importante que qualquer número isolado é a estabilidade: desempenho consistente ao longo de várias semanas de tráfego em produção, sem regressão significativa nas execuções de teste, é o verdadeiro sinal. Quando o ganho marginal da próxima iteração é menor que o risco de regressão, é hora de parar.
Isso não significa que o trabalho terminou. Quando surgem novos requisitos, o processo recomeça do início. As perguntas de escopo da primeira implementação continuam tão relevantes para a segunda. A diferença é que as equipes que entram em um segundo ciclo o fazem com uma suíte de testes, uma referência de avaliação e uma experiência operacional que o primeiro ciclo precisou criar do zero. Essa vantagem cumulativa é o que separa as organizações que obtêm valor duradouro com agentes de voz daquelas que continuam presas à prova de conceito.
Conclusão
As equipes que vimos fechar a lacuna entre desvio e resolução são aquelas que definem como é um bom resultado antes de começar a criar, mantêm a disciplina durante o ciclo de iteração e tratam cada implantação como base para a próxima. Agentes conversacionais não são uma implantação única — conversas reais revelam casos extremos que nenhuma suíte de testes antecipa por completo, e o trabalho de melhoria não para na entrada em produção.
O ElevenAgents foi criado em torno dessa realidade. Testes de Agente, Análise de Conversas e lançamentos segmentados são a base que transforma uma prova de conceito em um sistema que realmente resolve problemas dos clientes em escala — e não apenas os desvia. Essa é a lacuna que vale a pena fechar.



