Voice cloning API: jak działa i na co zwrócić uwagę
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Od asystentów AI po obsługę klienta — głos to główny interfejs produktów cyfrowych. Zwłaszcza że organizacje obsługują odbiorców na całym świecie, asystenci głosowi muszą działać w wielu językach i regionach. Gdy jednak twoje systemy Text to Speech (TTS) korzystają z generycznych lub robotycznych głosów, osłabiają tożsamość marki.
API do klonowania głosu pozwala deweloperom generować syntetyczną mowę głosem konkretnej osoby za pomocą wywołania API. Zamiast generycznego głosu odczytującego tekst, wynik brzmi głosem wybranego mówcy. Masz pełną kontrolę nad brzmieniem systemów TTS i sposobem, w jaki reprezentują twoją markę.
Klonowanie głosu API otwiera nowe możliwości w wielu dziedzinach — od procesów dubbingowych zachowujących głos aktora w różnych językach po platformy obsługi klienta utrzymujące spójny głos marki na dużą skalę.
W tym przewodniku wyjaśniamy, jak działają API do klonowania głosu, co ocenić przed integracją oraz jak zarządzać zgodą i zabezpieczeniami związanymi z tą technologią.
Podsumowanie
- API do klonowania głosu generuje mowę głosem konkretnej osoby: przesyłasz próbki audio i podajesz uzyskany identyfikator głosu w żądaniach zamiany tekstu na mowę.
- Instant Voice Cloning tworzy gotowy do użycia głos w kilka sekund na podstawie 1–2 minut audio, a Professional Voice Cloning potrzebuje 3–6 godzin na dostrojenie na 30 minutach do 3 godzin audio, by zapewnić wyższą i bardziej spójną jakość.
- Odpowiedzialne korzystanie z klonowania głosu wymaga potwierdzenia zgody właściciela głosu, znakowania wodnego, które pozwala prześledzić źródło wygenerowanego audio, oraz procesów usuwania, które na żądanie całkowicie usuwają model głosu.
Czym jest API do klonowania głosu i jak działa?
API do klonowania głosu pozwala aplikacjom deweloperskim generować syntetyczną mowę przez wywołanie zewnętrznego systemu klonowania głosu. Umożliwia utworzenie nagrania głosem danej osoby w danej chwili.
Deweloperzy przesyłają próbki audio docelowego głosu, a API wyodrębnia jego cechy, takie jak barwa, rytm mowy i wymowa, aby utworzyć identyfikator głosu.
Każde żądanie zamiany tekstu na mowę zawierające ten identyfikator zwraca audio sklonowanym głosem, a uczeniem modelu, przechowywaniem parametrów i syntezą zajmuje się w całości dostawca.
ElevenAPI oferuje dwie metody klonowania. Instant Voice Cloning (IVC) wykorzystuje przesłane próbki audio do kierowania generowaniem w czasie rzeczywistym, więc gotowy do użycia klon jest dostępny w kilka sekund. Professional Voice Cloning (PVC) dostraja model na twoim audio, zapewniając lepsze i bardziej spójne rezultaty.
Używaj IVC do szybkich testów. PVC wybierz do klonowania głosu o jakości produkcyjnej.
Najważniejsze funkcje API do klonowania głosu
Klonowanie głosu API znacznie różnią się możliwościami. To, że dwóch dostawców oferuje API do klonowania głosu, nie oznacza, że zapewnią prędkość, jakość i kontrolę wymagane w twoim przypadku użycia.
Oceniając API do klonowania głosu, zwróć szczególną uwagę na poniższe funkcje.
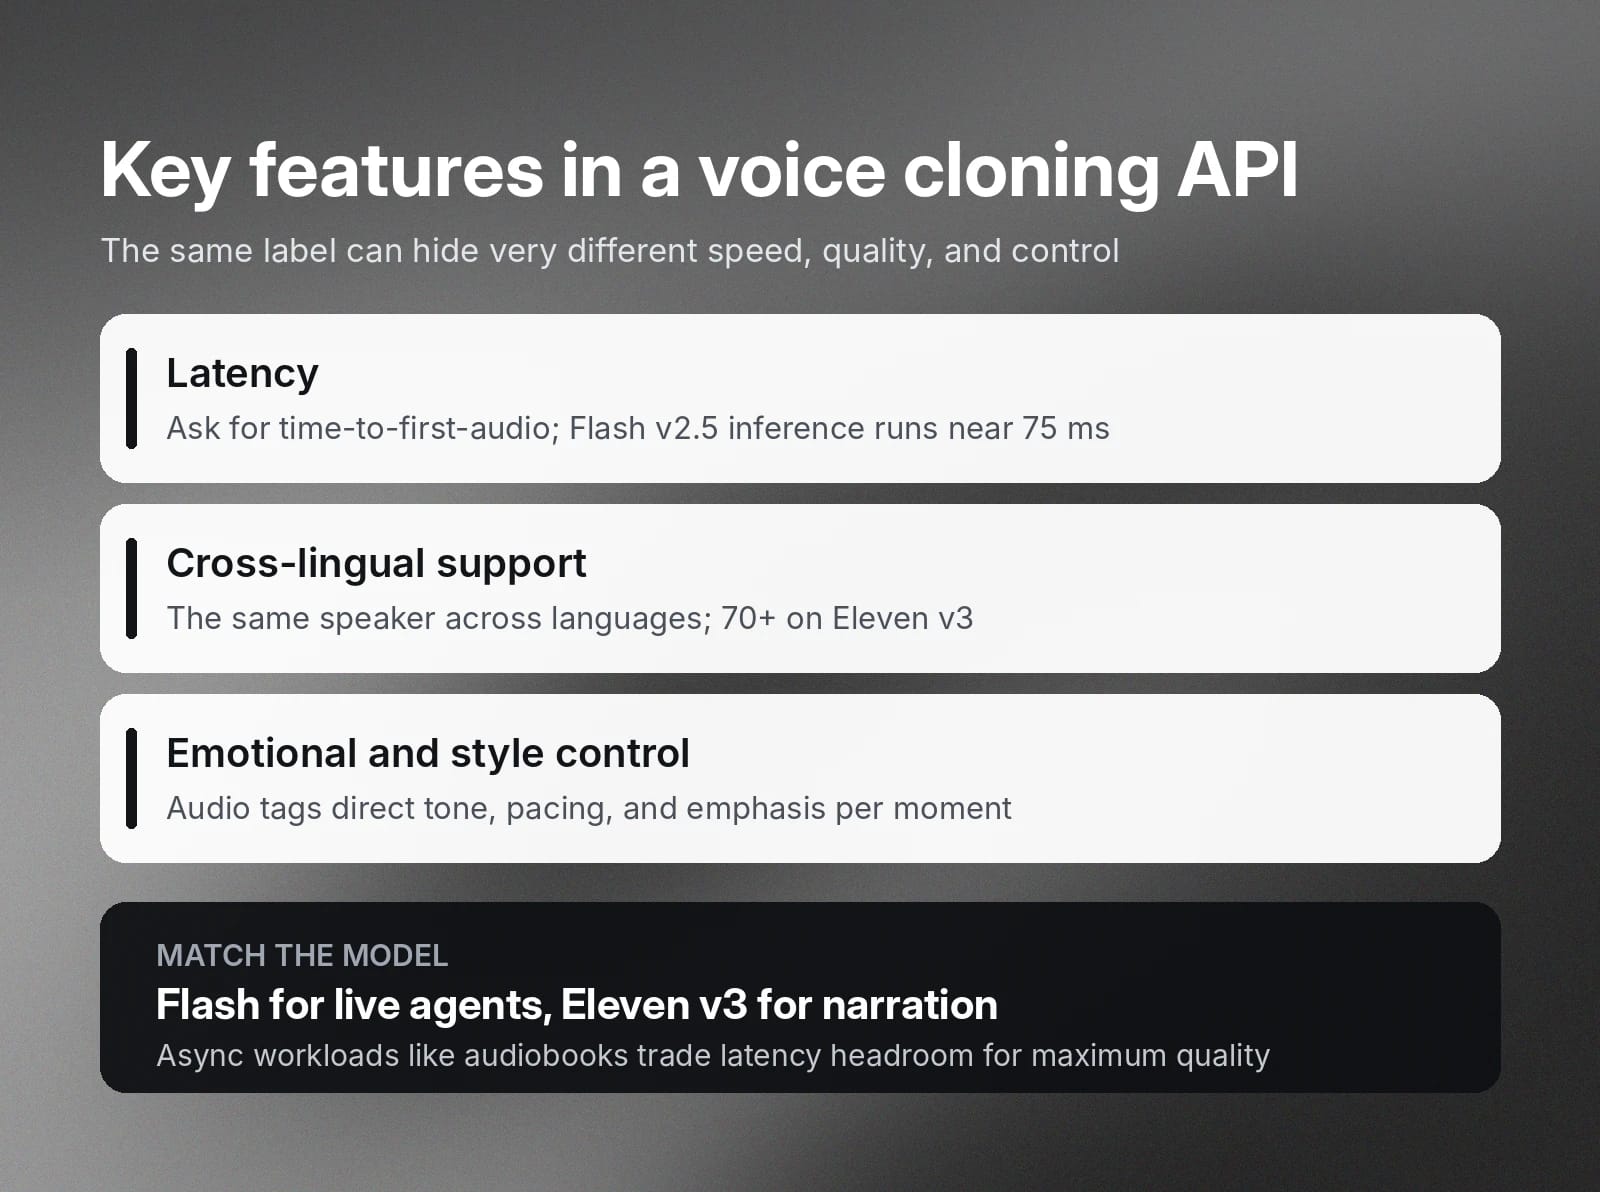
Opóźnienie
Jeśli twoja aplikacja obejmuje interakcję na żywo, np. głosowych agentów, dubbing w czasie rzeczywistym lub interaktywne postacie, opóźnienie jest ważnym czynnikiem do rozważenia. Szukaj publikowanych danych o czasie do pierwszego audio, a nie deklaracji marketingowych dostawcy API.
Eleven Flash v2.5 osiąga około 75 ms czasu inferencji modelu przy typowych krótkich danych wejściowych. Wartość ta nie obejmuje czasu transmisji sieciowej ani narzutu aplikacji, więc czas do pierwszego audio — wskaźnik decydujący o tym, czy rozmowa wydaje się odbywać na żywo — będzie wyższy na produkcji. Flash nadal jest stworzony do zastosowań w czasie rzeczywistym, gdzie liczy się każda milisekunda.
W przypadku asynchronicznych zadań, takich jak narracja audiobooka lub dubbing wideo, opóźnienie ma mniejsze znaczenie. W takich scenariuszach lepszym wyborem są modele zoptymalizowane pod jakość, takie jak Eleven v4.
Obsługa języków i wielu języków
Klonowanie międzyjęzykowe pozwala nagrać głos w jednym języku i generować mowę w innym. Oceniając API do klonowania głosu, sprawdź, czy głos wciąż brzmi jak ten sam mówca w różnych językach oraz czy wymowa jest naturalna, a nie mocno akcentowana lub maszynowo tłumaczona.
ElevenAPI obsługuje ponad 90 języków w Eleven v4, ponad 70 języków w Eleven v3 i 29 w Multilingual v2, który zachowuje spójną jakość głosu i akcent przy zmianie języka.
Kontrola emocji i stylu
Klon głosu, który potrafi mówić tylko w jednym stylu, ogranicza możliwości jego zastosowania, ponieważ każdy przypadek użycia brzmi płasko i jednolicie. Szukaj API, które pozwala kontrolować sposób wypowiedzi, w tym ton emocjonalny, tempo i akcenty.
Eleven v3 obsługuje tagi audio, które pozwalają aplikacji kierować konkretnymi momentami wypowiedzi. Ma to największe znaczenie dla treści narracyjnych, głosów postaci i każdej aplikacji, w której ten sam głos musi pasować do różnych kontekstów.
Przykłady zastosowań API do klonowania głosu w praktyce
API do klonowania głosu są najbardziej przydatne, gdy sam głos staje się częścią doświadczenia z produktem. Czasem celem jest spójność na dużą skalę. Innym razem — zachowanie tożsamości, poprawa dostępności lub ułatwienie lokalizacji treści.
Najlepsze zastosowania wykraczają poza efekt nowości i rozwiązują realne problemy w workflow zespołów wsparcia, zespołów treści, edukatorów oraz osób korzystających ze wspomagającej technologii głosowej.
Obsługa klienta i call center
Klonowanie głosu pomaga firmom utrzymać spójny głos marki w menu IVR, przypomnieniach wychodzących i agentach głosowych AI. Klienci przechodzący między kanałami oczekują spójnego doświadczenia, a głos pomaga zapewnić tę samą interakcję w różnych punktach kontaktu.
Twilio zintegrowało ElevenLabs ze swoją platformą ConversationRelay, dzięki czemu deweloperzy mogą tworzyć konwersacyjne doświadczenia głosowe bezpośrednio w infrastrukturze Twilio, z naturalnie brzmiącym audio sprawdzającym się przy produkcyjnej skali połączeń.
Bankowanie głosu
Dla pacjentów z chorobami zwyrodnieniowymi, takimi jak ALS, rak gardła czy SM, klonowanie głosu może zachować coś bardzo osobistego, zanim utracą mowę.
Della Larsen, u której w 2023 roku zdiagnozowano ALS, skorzystała z bankowania głosu, aby nagrać siebie czytającą 30 książek dla dzieci dla przyszłych wnuków. Zachowała swój głos, aby mogły usłyszeć, jak im czyta.
Wysoka jakość głosu pozwala osobom, które w przeciwnym razie całkowicie straciłyby głos, zachować go, póki jeszcze mogą. Tworzy trwały zapis ich głosu, z którego mogą korzystać przez wiele lat.
Więcej informacji o bankowaniu głosu i zaangażowaniu ElevenLabs w zachowanie 1 miliona głosów znajdziesz na naszej stronie Impact.
Edukacja i e-learning
Klonowanie głosu pozwala produktom edukacyjnym wykorzystać w nauczaniu znany, zaufany głos. Zwłaszcza początkujący uczniowie mogą poczuć się pewniej dzięki łagodniejszemu lub życzliwszemu głosowi.
Chess.com użyło ElevenLabs do wprowadzenia głosów arcymistrzów i popularnych twórców, w tym Hikaru Nakamury, Levy'ego Rozmana i Magnusa Carlsena, do funkcji Play Coach. Gracze otrzymują w czasie rzeczywistym informacje o ruchach głosami, które znają już z YouTube i Twitcha.
Bezpieczeństwo danych i odpowiedzialne korzystanie z AI w API do klonowania głosu
Klonowanie głosu może służyć do podszywania się pod prawdziwe osoby, tworzenia oszukańczych połączeń lub generowania audio z próbek głosu, które nigdy nie miały zostać sklonowane. Dostawcy powinni zawsze uwzględniać w platformie mechanizmy zgody, identyfikowalności i retencji.
Oto trzy zabezpieczenia, na które warto zwrócić uwagę.
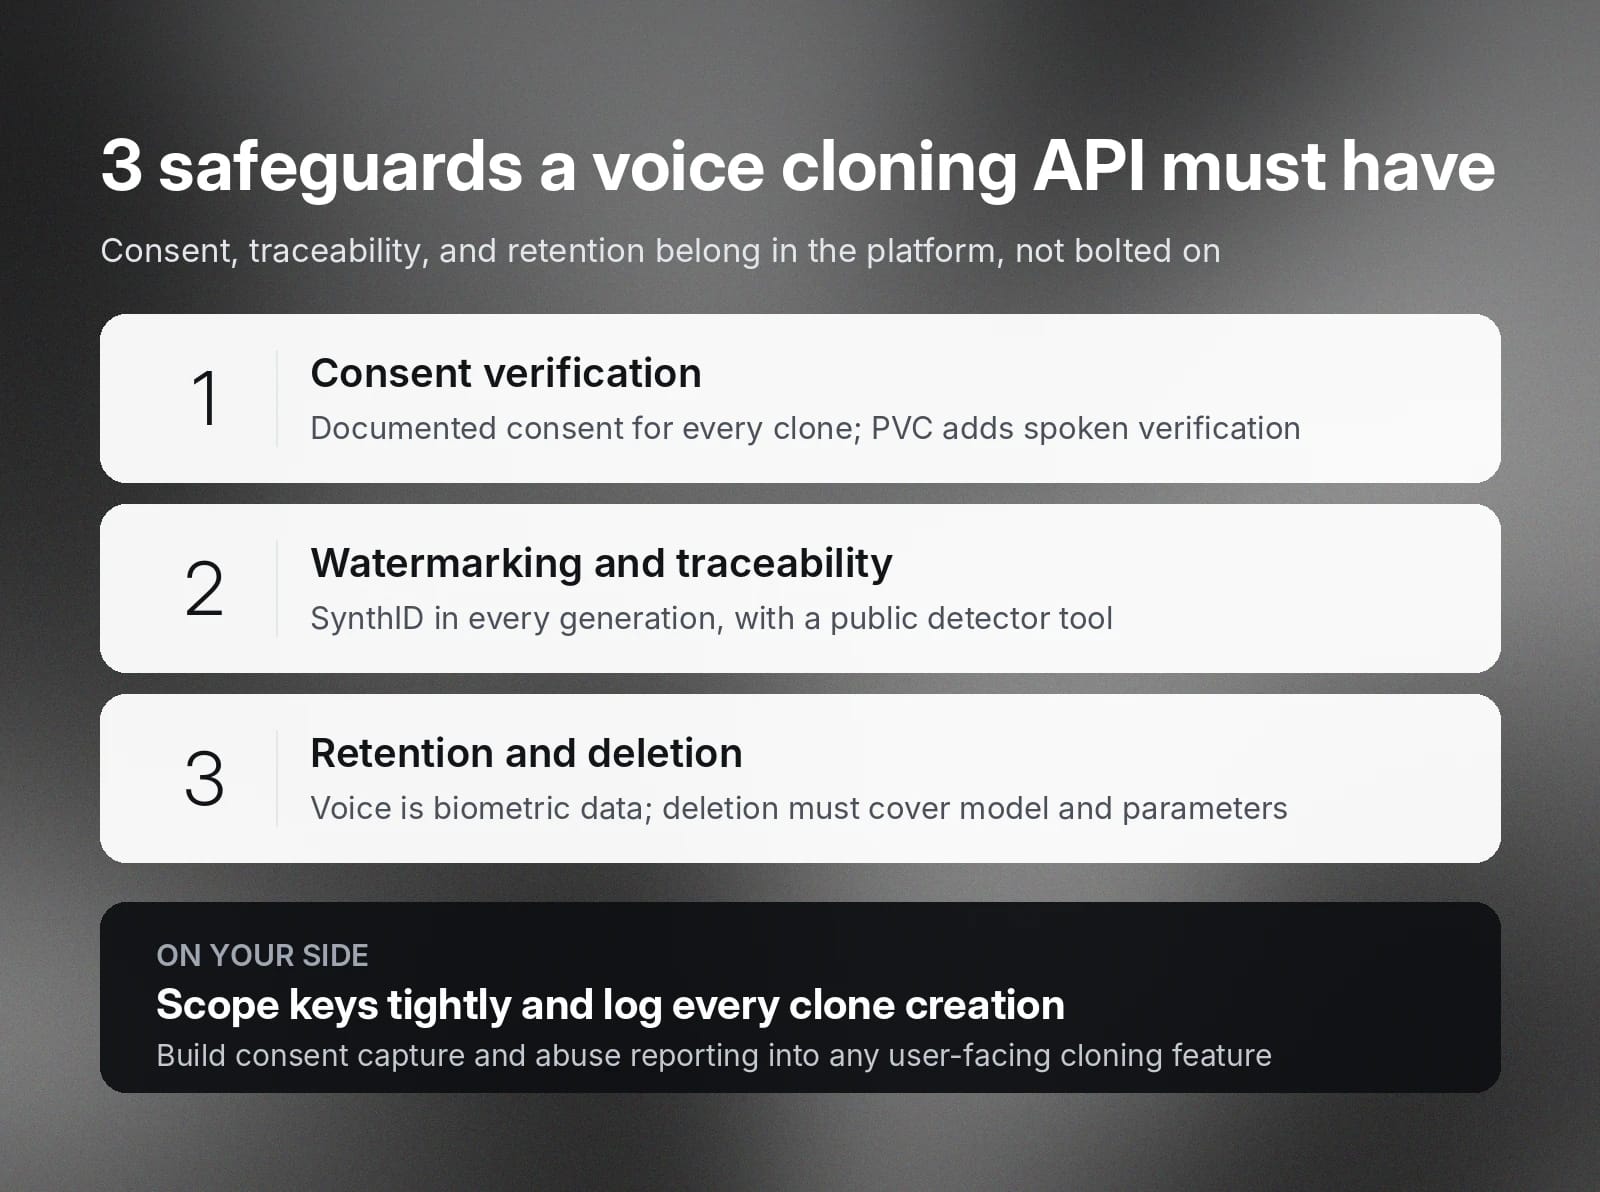
Weryfikacja zgody
Każdy klon powinien wymagać udokumentowanej zgody właściciela głosu. ElevenAPI wymaga poświadczenia zgody dla każdego klonu, a Professional Voice Cloning dodaje etap weryfikacji, podczas którego mówca nagrywa konkretne oświadczenie potwierdzające tożsamość.
W aplikacjach, które pozwalają użytkownikom końcowym klonować głosy, wbuduj pozyskiwanie zgody we własny proces. Traktuj słabe wymogi dotyczące zgody jako sygnał ostrzegawczy. Dostawca, który ułatwia klonowanie dowolnej osoby, może przyciągać nadużycia.
Znakowanie wodne i identyfikowalność
Wygenerowane audio powinno mieć możliwe do ustalenia pochodzenie. Oceniając dostawców, zapytaj konkretnie, jak wspierają przypisywanie pochodzenia po wygenerowaniu. ElevenAPI osadza SynthID, technologię cyfrowego znakowania wodnego opracowaną z Google DeepMind, w każdym wygenerowanym materiale i oferuje narzędzie wykrywające, które pozwala potwierdzić, że audio zostało wygenerowane przez ElevenLabs.
Można prześledzić nadużycia, zweryfikować sporne treści, a twoja firma ma dowód na wypadek zakwestionowania pochodzenia klonu.
Zasady retencji i usuwania
Dane głosowe są uznawane za dane biometryczne w wielu jurysdykcjach. Dostawcy bardzo różnią się sposobem zarządzania własnością, wykorzystaniem do trenowania i retencją. Przed integracją uzyskaj jasne odpowiedzi na te pytania:
- Kto jest właścicielem sklonowanego modelu głosu?
- Czy dostawca może wykorzystywać twoje dane głosowe do trenowania?
- Jaki jest czas usunięcia po zgłoszeniu żądania?
W przypadku aplikacji obsługujących użytkowników z Europy prawo do usunięcia danych wynikające z RODO obejmuje też modele głosu utworzone z nagrań. Dostawca potrzebuje procesów usuwania, które usuwają model głosu, dane treningowe i parametry pochodne.
ElevenAPI oferuje tryb Zero Retention Mode dla klientów enterprise, który zapobiega przechowywaniu danych żądań, a także opcje rezydencji danych, pozwalające wybrać miejsce ich przechowywania.
Odpowiedzialność obejmuje też własną integrację. Ściśle ogranicz zakres kluczy dostępu, rejestruj zdarzenia tworzenia klonów i dodaj zgłaszanie nadużyć do każdej funkcji klonowania dostępnej dla użytkowników. Szczegóły implementacji znajdziesz w najlepszych praktykach uwierzytelniania API i zarządzania kluczami.
Zacznij korzystać z klonowania głosu w ElevenAPI
Aby zacząć korzystać z ElevenAPI, utwórz klucz API, prześlij próbki głosu przez endpoint klonowania głosu i wyślij zwrócony identyfikator głosu wraz z żądaniami zamiany tekstu na mowę.
Oficjalne SDK dla Pythona i Node.js obsługują pełen zakres API, a Voice Library oferuje ponad 11 000 gotowych głosów do zastosowań, które nie wymagają klonowania.
Opisane w tym przewodniku funkcje zgodności są wbudowane w platformę, w tym poświadczenie zgody, weryfikacja, narzędzia wykrywające i procesy usuwania. Zespoły mogą przejść od prototypu do produkcji bez dodawania zabezpieczeń później. Aby oszacować użycie, skorzystaj z kalkulatora cen API, a szerszy przegląd dostępnych głosów znajdziesz w kompleksowym przewodniku po głosach.
Gdy wszystko jest gotowe, sklonowanie pierwszego głosu zajmuje tylko kilka minut. Pobierz klucz API i zacznij klonować albo najpierw przejrzyj dokumentację, aby dowiedzieć się więcej.
FAQ

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.